タグ: データセンター

  • AMD Helionが分けるAIの計算、モデル推論とエージェントの実行

    AMD Helionが分けるAIの計算、モデル推論とエージェントの実行

    AIエージェントは、文章を生成するだけでなく、ツールを呼び出したり、プログラムを動かしたりして作業を進めます。その計算を、すべて同じ装置に載せる必要があるのでしょうか。

    AMDが2026年10月12日に発表したHelionは、この問いにラック単位で答えようとする構成案です。AIモデルを動かす推論と、エージェントが選んだ行動を実行する処理を分け、用途に応じてCPUとGPUの置き方を変えます。

    簡単にまとめると?

    • Helionは、エージェントの実行処理を担うCPU中心のラックと、CPU・GPUをまとめたラックの構成例を示しています。
    • CPUだけの構成でもAIモデルの推論をなくすわけではなく、別の推論基盤へ接続します。
    • OCPへの仕様提供は計画で、発表時点ではパートナー構成も開発中です。提供予定は発表元や構成によって分けて確認します。

    モデルの判断と、決まった処理の実行は役割が違う

    たとえば、コードの修正を手伝うエージェントを考えます。モデルは依頼内容を読み、どのファイルを確認するか、どんな変更を加えるかを推論します。その後に、選んだファイルを読み込む処理や、テスト用プログラムを動かす処理が続きます。

    前者はAIモデルの計算で、後者には通常のソフトウェアの実行が含まれます。ひとまとまりの「AIの仕事」に見えても、使う計算資源、必要なメモリー、処理の待ち時間は同じではありません。この例は役割を説明するためのもので、Helion上での測定結果ではありません。

    Helionが示すのは、こうした実行処理とモデル推論を、必要に応じて別々の計算資源へ配置する考え方です。GPUを使う計算が重要であり続ける一方で、その前後を動かすCPU側の容量も計画の対象になります。

    CPUだけのラックと、一体型のラック

    AMDは構成例の一つとして、第6世代EPYCプロセッサーを使い、最大32,768 CPUコアを収めるCPU専用ラックを挙げています。大規模な事業者向けにエージェントの実行容量を用意し、モデル推論は別の基盤へ接続する設計です。

    このコア数は構成上の規模を表します。同時に処理できるエージェント数や、仕事が終わるまでの時間を直接示す数字ではありません。実行するプログラムの重さ、メモリーや入出力の条件、呼び出すモデルの応答などによって、処理全体のふるまいは変わるためです。

    もう一つは、EPYC CPUノード、Instinct MI350P GPUノード、汎用の計算資源を一つのプラットフォームに組み合わせる構成です。こちらは企業向けの一体型の案として説明されています。

    二つの構成は、CPUとGPUのどちらが優れているかを決めるものではありません。推論のための基盤をすでに持ち、実行側を増やしたいのか。それとも、実行と推論をまとめて計画したいのか。どこに既存の計算資源があり、どこを増強する必要があるかで、比較する条件が変わります。

    一体型でも、ラック内のGPUがすべて一つの大きな計算装置になるわけではありません。AMDの製品ページは、MI350Pを8基搭載するサーバーを2台使う構成を説明し、その2台は独立したノードで、両者をまとめるGPUのスケールアップ接続はないとしています。ここでいうスケールアップは、複数のGPUを密に結び、一つの計算領域として使うための接続です。

    名前の似たHeliosは、大規模な学習や推論を想定する別の設計です。Helionは企業向けのエージェント実行と推論を主眼とします。多数のGPUを一体として使う仕事を予定しているなら、GPUの台数だけでなく、どこまでが相互に接続された計算領域なのかを確かめる必要があります。

    モデルを選ぶ仕組みと、機器をつなぐ通信は別に見る

    AMDの発表は、モデル呼び出しを振り分けるトークンルーターにも触れています。ここでの対象は、エージェントがどのモデルを呼び出すかというソフトウェア側の処理です。ネットワーク機器がパケットの転送先を選ぶ仕組みと、そのまま同じものとして扱うことはできません。

    モデルの呼び出し先を変えられることと、そのモデルがある基盤へ必要な速さで接続できることは、両方とも確かめる必要があります。CPU側に十分な余裕があっても、推論待ちやデータの移動が全体の待ち時間になる場合があるからです。逆に、推論側だけを増強しても、実行側が混雑していれば仕事は進みません。

    開発中の構成を、どう判断材料にするか

    AMDの10月12日の発表では、Helionの仕様をOCPへ提供する計画と、パートナーと開発中の構成を2026年11月に提供する予定が示されています。一方、製造・設計パートナーであるSupermicroの公式案内は、同社のHelionラックの提供予定を2027年前半としています。

    この二つは、発表元と対象となる構成をそろえて確認したい情報です。今回確認した資料だけでは、両者の予定がどう対応するかまでは分かりません。Helion全体の提供開始を一つの月にまとめたり、計画が延期されたと判断したりせず、選ぶベンダーの具体的な機種と時期を確認する必要があります。資料は2026年10月27日に確認しました。

    空冷と液体冷却を含む柔軟な構成も想定されています。ただし、設計の選択肢があることは、すべての組み合わせがすでに提供され、同じ条件で検証済みだという意味ではありません。

    技術動向を追う段階では、「AIエージェント向けの計算基盤を、モデル推論と実行処理の両方から考え始めている」という変化を読むことができます。実際の導入を比べる段階では、提供される機種、メモリーや入出力、必要な電力と冷却、利用できるソフトウェアを、具体的な構成ごとに確認することになります。

    また、性能を比較するなら、コア数だけではなく、同じ仕事を同じ完了条件で動かした結果が必要です。推論を外部へ分けた構成では、その呼び出し先と通信条件も比較の範囲に入ります。Helionの発表は、配置を考えるための構成案として意味がありますが、特定の業務での速さや費用の優位を立証する独立した比較試験とは区別して読む必要があります。

    Helionをめぐる企業の役割を知りたい方は、CyclewaveのAMDの企業解説とSupermicroの企業解説も参考になります。半導体の設計とサーバーの提供、それぞれの事業の背景を紹介しています。

    出典

  • AIインフラはどう変わる? OCP 2026の計算機・通信・電力・冷却をつなぐ発表

    AIインフラはどう変わる? OCP 2026の計算機・通信・電力・冷却をつなぐ発表

    AI用の計算機を増やそうとすると、チップの性能だけでは決められないことが増えてきます。電気を届けられるか、熱を運び出せるか、計算機どうしを十分な速さでつなげられるか。これらの条件がそろって、初めて計算能力を使えるからです。

    2026年10月12〜15日に米サンノゼで開かれたOCP Global Summitでは、計算機、ネットワーク、電力、冷却を一緒に設計する流れが示されました。NVIDIAのラック設計、AMDのHelion、MetaのIcePackをつないで読むと、AIインフラで共有しようとしているものが見えてきます。

    簡単にまとめると?

    • 計算機を収めるラックから建物の設備まで、接続条件を合わせることがAIインフラの課題になっています。
    • 今回の発表には、設計を提供したもの、今後提供する計画、将来世代に向けた仕様が混在しています。
    • 導入を考えるときは、公開された対象と開発段階、電力・冷却・通信の条件を分けて確かめる必要があります。

    設計を共有する範囲が、ラックの外へ広がる

    OCPは、計算基盤の設計や仕様を共有するOpen Compute Projectです。部品を棚のようなラックに収めるだけでなく、機器を支える電源や冷却の仕組みも扱います。

    たとえば、同じ床面積により多くの計算機を置くと、そこへ届ける電力と取り除く熱も増えます。冷却能力が足りなければ、設置できる台数や運転条件を制限する必要があります。さらに、計算機間のデータ転送が追いつかなければ、計算できる側にも待ち時間が生まれます。

    このため、計算機の仕様が固まってから設備を考える進め方では、後から接続条件の不一致が見つかることがあります。ラックと設備の境目で、何をどの条件で受け渡すかを先に共有する意味は、こうした設計の手戻りを減らせるところにあります。

    三つの発表が扱う、それぞれの接続

    NVIDIA:計算機を支えるラック設計の共有

    NVIDIAは、Vera Rubinを対象とするラックと計算トレイの設計を、MGXの取り組みを通じてOCPへ提供したと発表しました。トレイは、計算に使う部品をまとめてラックに収める単位です。

    ここで注目したいのは、計算用チップ単体ではなく、それを収めて給電し、冷やす構成も共有の対象になることです。装置を作る側と、それを設置する側が、同じ設計情報を参照しやすくなります。ただし、設計の提供だけで、すべての組み合わせの互換性や運用性能が保証されるわけではありません。

    AMD:AIが考える計算と、行動を実行する計算を分ける

    AMDが発表したHelionは、AIエージェント向けのオープンなラック構成案です。AIエージェントがモデルで判断する処理に加え、ツールやプログラムを実行する処理にも注目しています。

    モデルの推論をGPUで行い、ツールの実行をCPU側へ分ける構成と、両方をまとめる構成を示しています。たとえば、AIが作業手順を考え、その結果に基づいてプログラムを動かす場合、二つの処理は同じ種類の計算ではありません。処理に応じて配置を考えることが、ラック設計にも関わります。

    HelionのOCPへの提供は計画として示されており、パートナー構成の開発も進行中です。発表された将来の構成を、すでに導入できる完成品と読み替えないことが大切です。

    Meta:通信機器も液体冷却の設計に入る

    Metaは、液体冷却を使うネットワークラックIcePackと、スイッチIceCubeを紹介しました。IceCubeは128本の800 Gb/sポートを持ち、102.4 Tb/sのノンブロッキング構成を掲げています。これは各ポートの能力を同時に扱えるようにする設計上の容量で、AIの処理がその速さで進むという意味ではありません。

    ネットワーク機器の原資料には、通信ポートだけでなく冷却液の入口・出口も示されています。通信の高速化を追うときにも、電力と熱をどこへ逃がすかを一緒に考える必要があることが分かります。計算用ラックだけを冷やせばよい、という設備計画では足りなくなる可能性があります。

    設備側の仕様は、将来の設計条件を示す

    この流れを建物側から見る資料が、OCPの「Open Data Center Spec」です。確認した版は0.7.0で、表紙の適用日は2026年8月27日。2027〜2028年の機器世代を見据え、ラックを並べる空間、給電、冷却などの条件をまとめています。

    資料には、通路やラックの寸法の表に加えて、ラック列の上に電力の配線と冷却用の配管を配置する概念図があります。機器を収める場所、熱を運ぶ経路、保守のために人や機材が通る場所を、同じ空間の中で調整する必要があるためです。

    この仕様は、10月のイベントで初めて生まれた構想ではありません。OCPのOpen Data Centerの構想自体は2025年10月に発表されています。今回のイベントは、以前からの設備設計の取り組みと、各社の新しい機器構成を結びつけて読む機会でもあります。

    「オープン」の中身と、確かめる順番

    これらの発表を比較するときは、まず何が共有されるのかを見ます。設計図、仕様書、ソフトウェアでは、利用できる内容も利用条件も違います。そのうえで、提供済みなのか、提供予定なのか、将来の設計目標なのかを確かめます。

    次に、自分が扱う設備との境目を確認します。ラックへの給電条件、冷却液の条件、接続する通信機器、保守の空間が合っているか。たとえば液体冷却の機器を採用するなら、機器側の接続部に加え、設備側で熱を受け取れるかまで確認が必要です。

    最後に、容量の数字と実際の処理性能を分けます。スイッチの転送容量、設備の受電能力、AI処理の速さは、別々の対象を測っています。一つの数字だけでシステム全体の優劣を決めず、対象と条件をそろえて比べるためです。

    今回の発表から読み取れるのは、AIインフラの設計が、計算機と周囲の設備をどう合わせるかという課題へ広がっていることです。公開された設計や仕様は、その相談を具体的にするための手掛かりになります。各社の発表は設計方針を知る一次資料として扱い、組み合わせたシステムの性能実証とは区別して読む必要があります。

    事業の背景も知りたい方は、CyclewaveのNVIDIAの企業解説、AMDの企業解説、Metaの企業解説も参照してください。

    出典

  • iA cloudのPrivate AI設計、電力・冷却とモデル互換性を配備前に確かめる

    iA cloudのPrivate AI設計、電力・冷却とモデル互換性を配備前に確かめる

    社内のAIサービスを増やすとき、空いているGPUやNPUが見つかれば、すぐに新しいモデルを動かせるのでしょうか。設備には電力と冷却の上限があり、モデルには対応する実行環境があります。この二つを別々に確認していると、機器は空いているのに配備できない、という状況が生まれます。

    iA cloudのDongHee Yang氏は、OCP Korea Tech Dayで、物理設備からAIサービスまでをまとめたPrivate AIの構成を示しました。ここでは、データやモデルを社内ネットワークに置くという方針を、実際の配備と更新の条件へどうつなげているかを見ていきます。[1]

    簡単にまとめると?

    • この設計は、GPU・NPUの空きだけでなく、電力・温度・冷却の情報も仮想マシンの配置判断へ渡します。
    • NPU側ではモデルを配備前にコンパイルし、モデル・コンパイラー・SDK・ランタイムの版を一組で管理します。
    • 社内に設備を置くことと、モデルを更新し続けられることは別の確認事項です。資料は構成案を示しており、処理性能や可用性の保証ではありません。

    施設の情報を、計算資源の割当てへ渡す

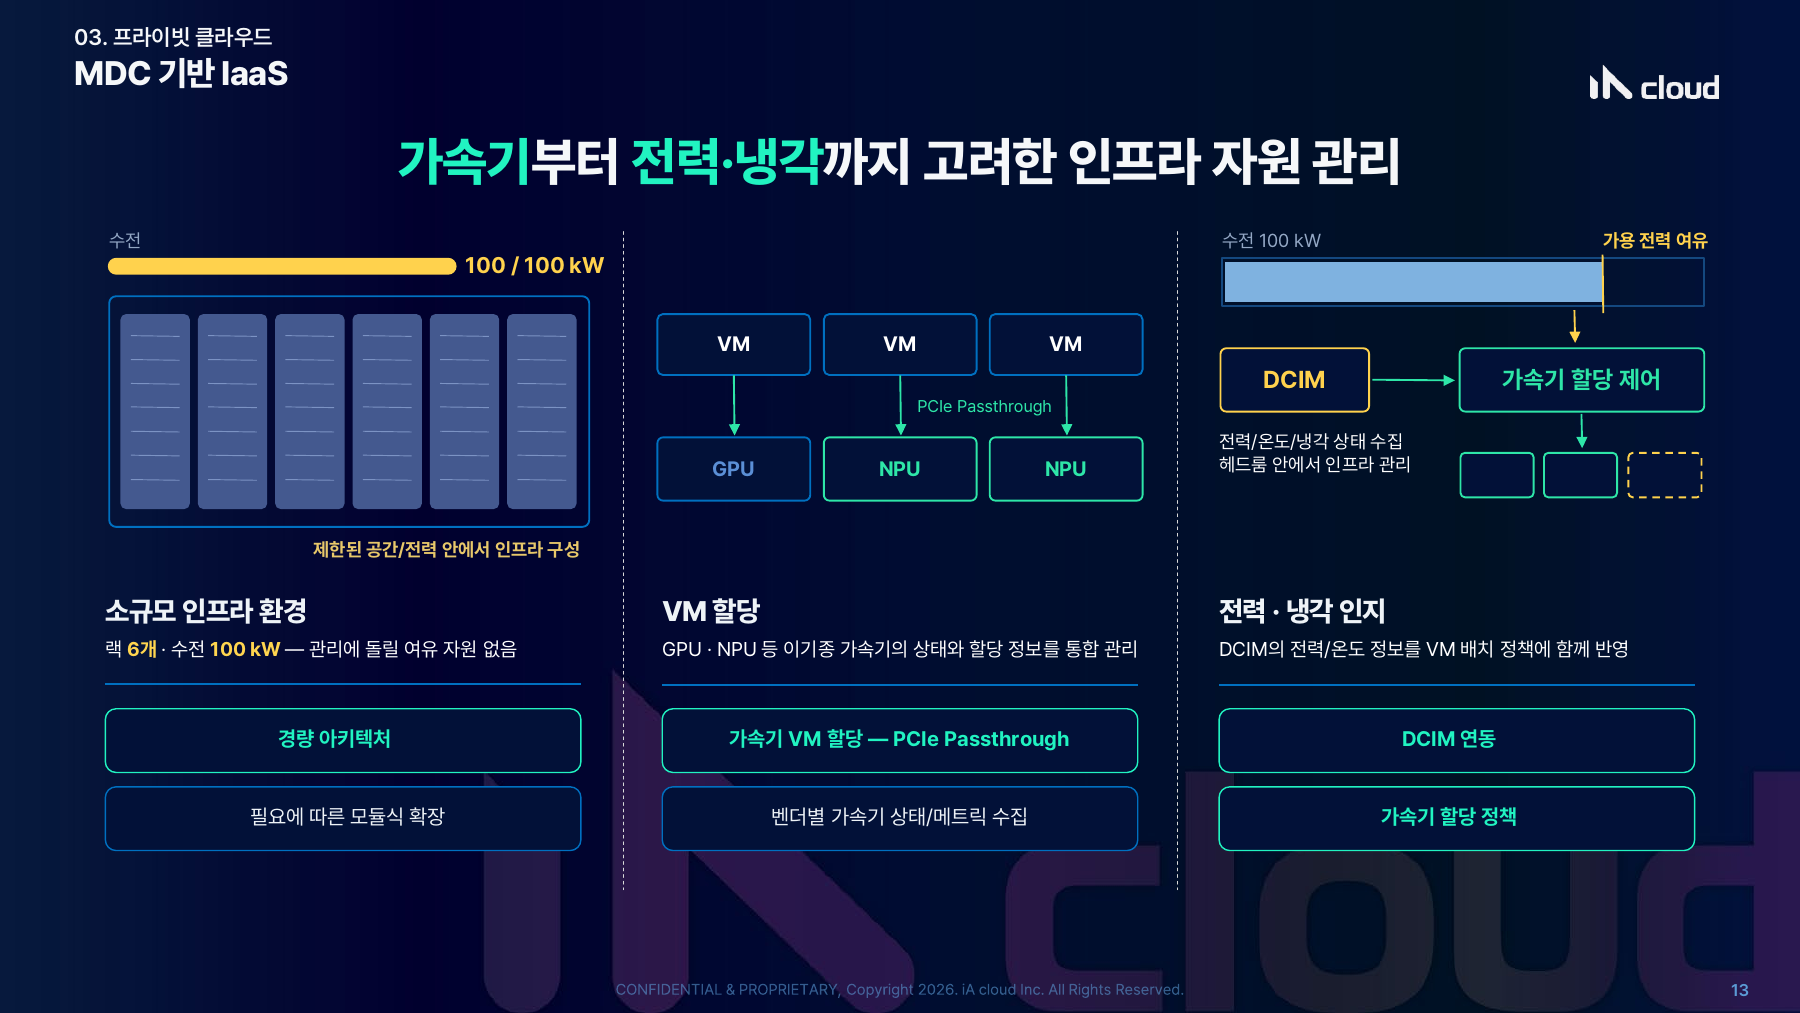
    資料の標準構成は、40フィートのコンテナーに6ラックを収め、受電容量を100 kWとしたMDC(モジュール型データセンター)です。電力や冷却の設備と、サーバーを置く区画をまとめて設計しています。この数字は同社の構成例であり、GPUだけが100 kWを使えるという意味ではありません。[1]

    この規模でAIサービスを増やすには、設備の残りの余力も把握する必要があります。資料では、設備を監視・管理するDCIM(Data Center Infrastructure Management)が集めた電力・温度・冷却の情報を、仮想マシンの配置方針へ反映します。仮想マシンは、一台の物理サーバー上に用意する仮想的な計算機です。GPU・NPUの状態や割当て状況と、施設側の条件を合わせて扱う構成になっています。[1]

    図は横にスクロールできます。原寸表示は図の下のリンクから開けます。

    iA cloudのMDC基盤設計。左に6ラックと受電100 kW、中央に仮想マシンとGPU・NPUの割当て、右にDCIMから電力・温度・冷却情報を割当て制御へ渡す関係を示す。
    図1 限られた電力・空間、仮想マシンへのアクセラレーター割当て、DCIMとの連携を並べた設計図。右側では電力・温度・冷却の情報を割当て制御へ渡している。出典:DongHee Yang(iA cloud)「Private AI Architecture for Data Sovereignty」、OCP Korea Tech Day 2026、13頁。原スライドを画像化。 原資料。図を拡大する

    図1の中央にあるPCIeパススルーは、PCIeで接続したアクセラレーターを仮想マシンから直接扱えるようにする方法です。一方、右側のDCIM連携は、その機器へ仕事を割り当ててよいかを施設の余力も含めて判断するための接続です。装置を仮想マシンへ渡す仕組みと、負荷を追加できる条件を決める仕組みは、役割が異なります。図の電力表示は構成の説明で、稼働設備の測定結果ではありません。[1]

    たとえば、NPUが一台空いていても、その設置場所の冷却に余裕がない場合があります。この設計から考えると、空き台数だけを配備の可否にしてはいけません。ただし資料は、何度になったら配置を止めるか、どの周期で温度を確認するか、といった具体的な制御値までは示していません。実装時には自分たちの設備に合う条件を決める必要があります。

    同じAPIでも、裏側の配備手順はそろわない

    利用者がモデルを呼び出す入口は、一つのAPIエンドポイントにまとめています。エンドポイントは、アプリケーションが処理を依頼する窓口です。その裏側でGPUとNPUへ処理を分け、機器ごとの違いを利用者側へそのまま持ち込まない狙いです。[1]

    ただし、入口をそろえても、あらゆるモデルをどちらの機器でも動かせるわけではありません。資料のNPU側の経路には、モデルを実行先に合う形へ変換するコンパイルがあります。コンパイルを通過したモデルを配備候補にし、対応できないものはサービスへ登録する前に止める流れです。これは、この資料が示すGPU・NPU構成の説明であり、全GPU・全NPUに共通する配備手順の分類ではありません。[1]

    ここで確かめるのは、モデル名だけでは不十分です。資料は、モデル、コンパイラー、SDK、ランタイムの版を同時に固定するとしています。SDKは開発に使う道具一式、ランタイムは実行時に必要なソフトウェアです。同じモデルでも、変換に使った道具と実行する環境の組み合わせが変われば、以前と同じように動くかを確かめ直す必要があります。[1]

    閉じたネットワークでは、更新する一式も持ち込む

    資料は、閉じたネットワークへモデル・コンパイル済みの成果物・ランタイムをまとめて持ち込む構成を示しています。モデルだけを受け取り、足りないソフトウェアを運用中に外部から取得する前提にはしていません。社内で処理を完結させるには、配備に必要なものをあらかじめそろえる段取りが含まれます。[1]

    更新時も、この組み合わせが判断の単位になります。たとえばモデルだけを新版に置き換えるなら、以前のコンパイル済み成果物を使えるのか、ランタイムも更新するのかを再確認します。実際の受入試験では、変換できることに加え、必要な入力に答えられることや、想定する同時利用で処理が間に合うことも確かめたいところです。これは資料の版管理と配備前判定から導く確認事項であり、同社の受入試験結果を示したものではありません。

    データの置き場所に、運用できる条件を重ねる

    iA cloudは、モデルの呼出しを社内ネットワーク内に収め、原データとモデルを内部に置くサービス構成を説明しています。設備を監視する層、計算資源を割り当てる層、モデルを配備する層をつないでいる点が、このPrivate AI設計の特徴です。[1]

    導入前には、施設の余力が配置判断へどう伝わるか、対象モデルがどのソフトウェアの組み合わせで動くか、その一式を閉じたネットワークへどう持ち込んで更新するか、という順に追うと具体的になります。データの保管場所を決めた先に、運用を続けるための条件があります。

    なお、資料の構成図からは、制御の反応時間、障害時の復旧手順、更新後の性能や可用性まで確認できません。社内完結の構成だけで、情報管理上の要件すべてを満たしたとも判断できません。ここで読み取れるのは、施設の制約とモデルの実行条件を、配備前に結び付ける設計です。

    参考資料

    [1]DongHee Yang(iA cloud)「Private AI Architecture for Data Sovereignty: From Modular Infrastructure to Accelerators and AI Services」、OCP Korea Tech Day、2026年8月21日。全27頁。主に6・8・13頁(設備と割当て)、16–17頁(モデル配備・版管理)、19・21・25頁(社内サービス構成)。OCP公式資料一覧に掲載。

    資料確認日:2026年10月12日。本文は公開スライドの設計内容を扱い、講演動画や質疑応答、導入先での動作試験は根拠に含めていません。

  • Watt-Bit連携、電力に合わせて計算の場所と時間を変える

    Watt-Bit連携、電力に合わせて計算の場所と時間を変える

    電力に余裕がある地域と、計算をたくさん使いたい地域は、必ずしも重なりません。電気を需要地へ送る設備を整えるだけでなく、通信網を使って計算処理を電力のある側へ動かせないか。Watt-Bit(ワット・ビット)連携は、データセンターをどこに置き、いつ動かすかを、電力と通信の両方から考える取り組みです。

    東京大学の江崎浩氏は、2026年8月のOCP APAC Summitで、日本のデジタルインフラを国土規模で設計する視点を示しました。発表の中心には、脱炭素電源、分散した計算拠点、光通信、そしてワークロードシフトがあります。ここでは、講演が示す設計上の方向性と、政府が公表した取り組みの段階を分けて見ていきます。[1]

    簡単にまとめると?

    • Watt-Bit連携は、電力網・通信網・データセンターの配置と運用を一緒に考える取り組みです。
    • ワークロードシフトは、条件の合う計算処理の場所や時間を変え、電力の使い方を調整する手段になります。
    • 光通信でも距離による遅れはなくならないため、移せる処理と利用者の近くに残す処理を分ける必要があります。
    • 政府の取りまとめや実証採択は進んでいますが、全国で計算が自在に移動できる仕組みが完成したことを示すものではありません。

    立地を決める前に、電力と通信をつなぐ

    データセンターは、サーバーを収める建物だけでは動きません。電力を受ける設備と、利用者やほかの拠点につながる通信回線が必要です。計算能力を大きくしても、必要な電力を届けられなかったり、通信の条件が合わなかったりすれば、その能力を使い切れません。

    経済産業省と総務省は2025年3月から官民懇談会を開き、同年6月12日に「ワット・ビット連携官民懇談会取りまとめ1.0」を公表しました。公表資料が重視するのは、電力・通信・データセンターの事業者が連携してインフラを整備することです。個々の施設の省エネだけに閉じず、電源と通信網を含めた配置を考える枠組みになっています。[2]

    江崎氏の発表では、大規模なデータセンター群、東京・大阪以外の戦略的な拠点、さらに分散した拠点へと、時間軸を分けて方向性を示しています。これは各地域に同じ設備を均等に置くという話ではありません。電力を供給できる場所と、計算を必要とする場所を、通信でどう結ぶかという設計です。[1]

    ワークロードシフトは、電気の使い方を動かす

    ワークロードは、計算機が実行する仕事や処理の負荷を指します。ワークロードシフト(Workload Shift、WLS)は、その仕事を実行する拠点や時間帯を変えることです。建物やサーバーを毎回移動するのではなく、処理の割り当てを変えます。

    たとえば、期限までに終わればよい計算に実行時刻の余地があり、別の拠点にも必要なデータと計算資源があるとします。その仕事を電力の条件が合う時間帯や拠点へ割り当てられれば、需要が集中する場所や時間を調整する選択肢になります。これは仕組みを説明する例であり、すべてのAI処理を同じように移せるという意味ではありません。

    発表はWLSを、デマンドレスポンス(Demand Response、DR)と組み合わせて扱います。DRは電力の需給などに応じて需要側の使い方を変える考え方です。WLSが調整するのは計算処理の配置であり、それを通じて電力需要を調整する道筋が生まれます。両者は関係しますが、同じ言葉ではありません。[1]

    この設計で確認したいのは、移動先に空きがあるかだけではありません。仕事を終える期限、データを送る時間、利用できるソフトウェア、処理を中断できるかといった条件も必要です。電力が余っている場所へ送れば自動的に得になるのではなく、計算とデータを移す負担も含めて判断することになります。

    計算を移しても、電力網の整備は残る

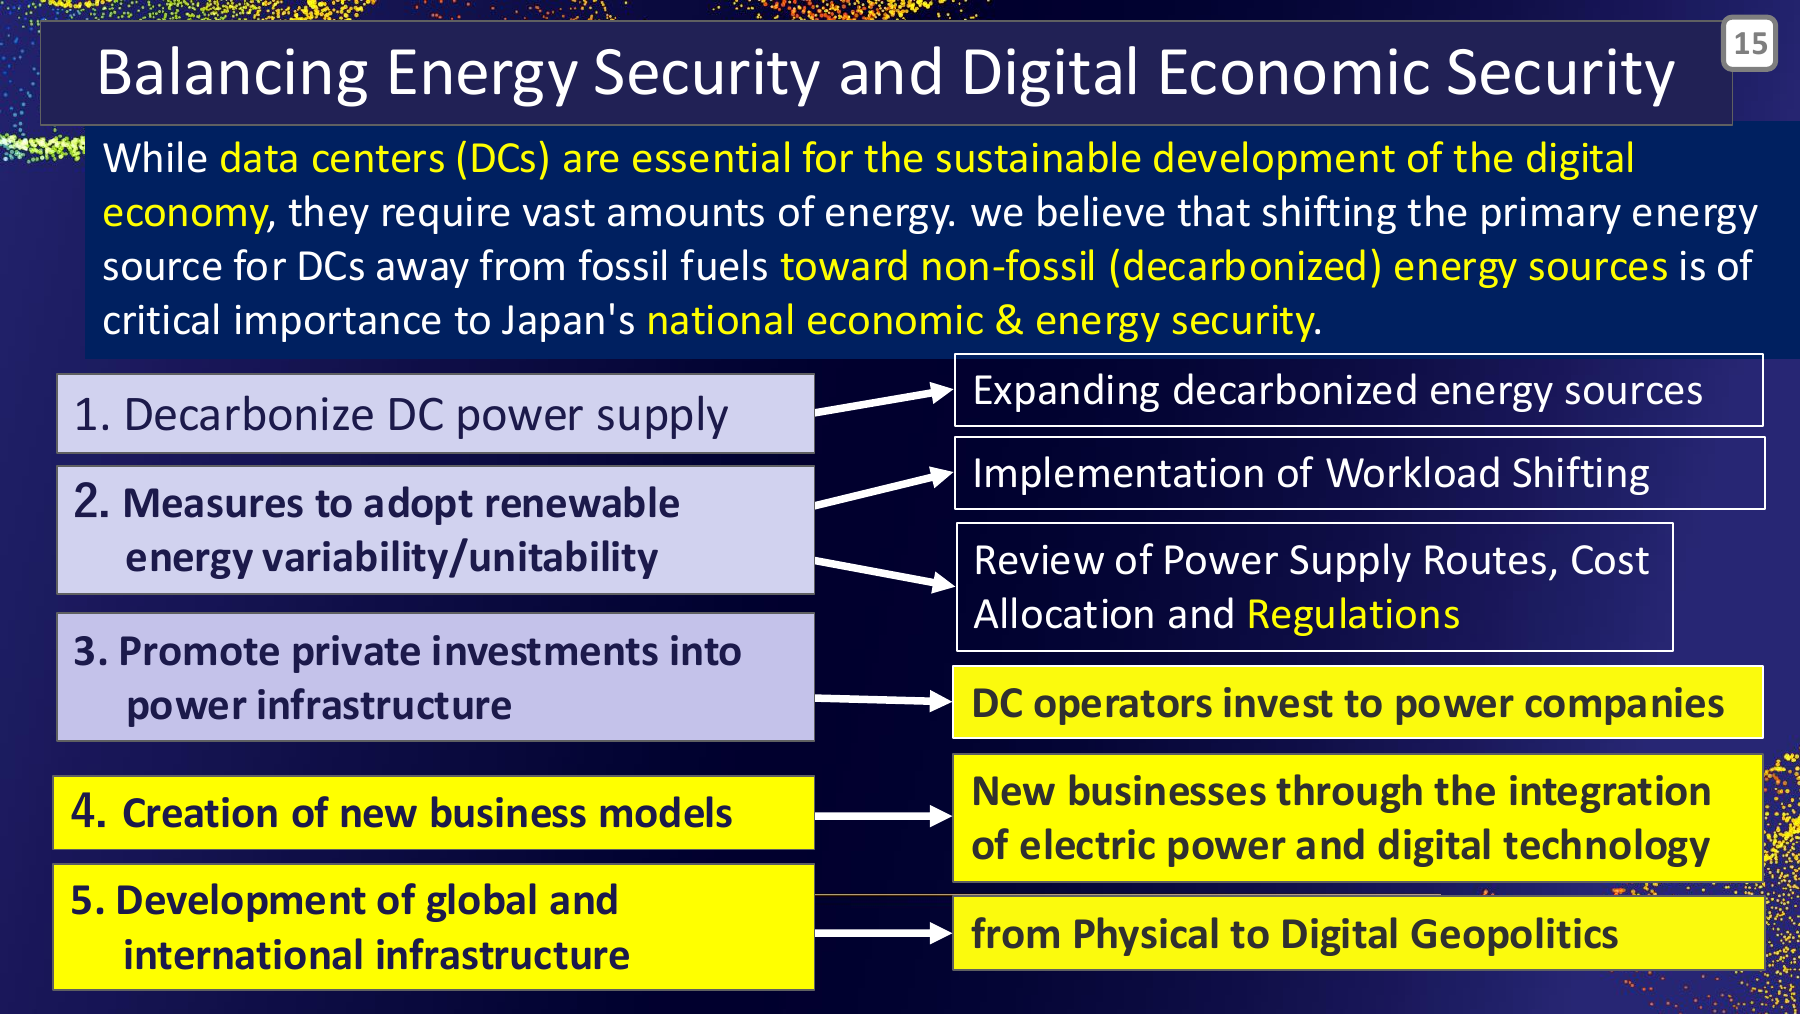
    発表15ページの図は、脱炭素電源への移行、再生可能エネルギーの変動への対応、電力インフラへの投資などを、複数の施策へ結びつけています。注目したいのは、再エネの変動への対応から、WLSだけでなく、電力供給経路・費用分担・規制の検討にも矢印が伸びていることです。計算の移動と電力側の整備を、組み合わせる課題として描いています。[1]

    江崎浩氏の発表15ページ。脱炭素電源、再生可能エネルギーの変動対応、電力インフラ投資などの課題を、ワークロードシフトや供給経路・費用分担の検討へ矢印で結んだ図
    図1 電力とデジタル基盤を組み合わせる施策の関係。Hiroshi Esaki「Watt-Bit Integration Government Strategy for the Design and Development of National Digital Infrastructure in Japan」、2026 OCP APAC Summit、15ページ「Balancing Energy Security and Digital Economic Security」。原資料。原スライドを画像化。図を拡大する

    図には、データセンター事業者による電力会社への投資、新しい事業モデル、国際的なインフラも並びます。発表者が示す広い検討課題として読む部分です。この図だけを根拠に、特定の投資制度が適用済みであるとか、費用分担のルールが全国で確定したと捉えることはできません。

    技術上の狙いも、消費電力の総量を必ず減らすことだけではありません。ある処理を別の場所や時間へ移しても、同じ計算を行うための電力は必要です。評価では、電力需要の集中をどの程度和らげられたか、利用できる電源がどう変わったか、通信や移動先を含む全体の負担がどうなったかを分けて見る必要があります。

    光通信でも、遠くへ送れる仕事には条件がある

    発表が挙げるAPN(All Photonic Network)は、光技術を活用して拠点間を結ぶネットワークです。江崎氏は光通信の小さな遅延の揺らぎなどを利点として挙げる一方、光の伝わる速さにも限界があることを強調しています。回線を高速化しても、遠くへ信号を届ける時間そのものはなくなりません。[1]

    そのため、計算量だけで配置を決めることはできません。完了時刻に余地のある処理と、利用者の操作や機械の動きへすぐ応答する処理では、許容できる待ち時間が異なります。後者では、利用者や装置の近くで処理するエッジの役割が残ります。さらに実際の応答時間には、回線上の移動だけでなく、混雑やサーバーでの処理時間も加わります。

    分散した拠点を結ぶことと、遠隔の設備を一台の計算機のように自由に使えることは別です。何を移動でき、どこにデータを置き、どの処理を近くに残すか。その切り分けが、電力と通信を一緒に設計する際の要点になります。

    政策の公表と、実証で確かめることを分ける

    取り組みは講演の構想だけにとどまりません。総務省の実証事業の事務局は2026年7月15日、APN等による分散データセンター運用と、高度なワークロードシフトを対象とする実証事業の選定を公表しています。選定結果には、電力情報に基づいてAIの処理先を変える検証や、発電予測・電力需給・計算資源の利用状況などを合わせてWLSの可能性を確かめる計画が含まれます。[3]

    この発表から確認できるのは、対象となる実証が選ばれたことです。採択の事実を、そのまま費用削減や排出削減の達成、全国への導入完了と読み替えることはできません。講演の方向性、政府の取りまとめ、個々の実証とその結果は、それぞれ別の証拠として確かめる必要があります。

    Watt-Bit連携を読むときは、データセンターがどこに増えるかに加えて、計算を動かす条件がどう整えられるかを見ると、技術の輪郭がつかみやすくなります。電源の条件、通信の遅れ、仕事の期限を一緒に扱い、動かせる計算を見極める。その積み重ねが、電力と計算基盤を国土規模で結ぶ設計につながります。

    参考資料

    [1]Hiroshi Esaki「Watt-Bit Integration Government Strategy for the Design and Development of National Digital Infrastructure in Japan」、2026 OCP APAC Summit、2026年8月11–12日。全35ページ。8・13–18ページ:電力と計算拠点、WLSとAPN、15ページ:施策の関係、25–26ページ:光通信と遅延。OCP公式資料一覧に掲載。

    [2]経済産業省・総務省「『ワット・ビット連携官民懇談会取りまとめ1.0』を公表します」、2025年6月12日。官民懇談会の目的と、電力・通信・データセンター事業者による連携の位置付け。

    [3]総務省「ワット・ビット連携関連実証」事務局(三菱総合研究所)「『ワット・ビット連携関連実証』における実証事業の選定について」および「選定結果」、2026年7月15日。実証区分と採択された検証内容。本文では採択時点の公表事実を扱っています。

    政策資料の確認日:2026年10月8日。

  • 電力・冷却・建物の接続条件をそろえる、Googleのデータセンター構想

    電力・冷却・建物の接続条件をそろえる、Googleのデータセンター構想

    新しいAIサーバーを導入するとき、機器がラックに収まれば準備が終わるわけではありません。必要な電力を届けられるか、熱を施設の外へ運べるか、保守のための場所が残るか。サーバーの世代交代は、建物側の設計にもつながっています。

    GoogleのGregory Moore氏が示したのは、こうした関係をまとめて考える「Fungible & Sustainable Data Center」という構想です。ここでのfungibleは、異なる機器や将来の構成へ対応しやすいこと。GPUを自由に差し替えられるという意味ではなく、設備の接続条件をそろえ、変更を受け入れられる施設を目指す考え方です。[1]

    簡単にまとめると?

    • Googleは電力・冷却・建物の接続条件をそろえ、将来の機器変更に対応しやすい施設を構想しています。
    • 蓄電は容量だけでなく、変動する時間幅と影響範囲に応じて役割を分けます。
    • CDUの公開仕様があっても、流量や接続条件、配置と保守の空間を施設ごとに合わせる必要があります。

    設備ごとの最適化から、つながりを決める設計へ

    発表の軸は、モジュール化、相互運用性、標準化を、電力・冷却・建物まで横断して進めることです。高性能なサーバー、効率のよい電源、大きな冷却能力があっても、それぞれの接続条件が合わなければ、一つの施設としては使えません。[1]

    OCPが進めるOpen Data Centerの取り組みも、電力、冷却、機械的な構造、計測情報を共有できる設計へ広げています。特定の機器だけに施設を合わせ込む度合いを減らし、次の構成を選べる余地を残す方向です。[2]

    電力は「何MWか」に加え、変化への応答を考える

    AIの処理では、消費電力が時間とともに変わります。その変動が、サーバー内部の問題で収まるのか、ラック列や施設、電力系統まで伝わるのかによって、備える設備も変わります。資料は、最大電力の容量だけでなく、負荷の急変や系統との相互作用を設計上の課題にしています。[1]

    そこで示されるのが、蓄電を三つの階層へ分ける考え方です。チップやラックの近くでは、コンデンサーやラック内のバッテリーバックアップで短い変動に応答する。ラック列では、列の端や側方に置く蓄電設備で電力をつなぎ、ピークを抑える。施設では、大きな蓄電システムを長時間のバックアップや系統への対応に使います。[1]

    これは、どのデータセンターにも同じ三段構成を必須にする説明ではありません。変動の時間幅と影響する範囲を分け、どこで受け止めるかを選ぶための整理です。容量の大きさだけで蓄電設備を選ぶと、その役割の違いが見えにくくなります。

    電源装置の標準化には、過渡応答と寸法も含まれる

    電力変換では、半導体による変換回路を用いるSST(Solid-State Transformer)が取り上げられています。資料が標準化の対象にしているのは、入力と出力の接続、配電構成だけではありません。定常時と過渡時の性能、機械寸法、物理的な接続部も含まれます。[1]

    同じ出力容量でも、負荷が変わった瞬間の応答や、設備との取り合いが違えば、そのまま置き換えられるとは限りません。「つながる」の中身を、電圧や容量だけでなく、動作条件と設置条件まで具体的にする必要があります。

    発表はv0.3のSST仕様を標準化の出発点として紹介しています。これは、すべてのSST製品が共通仕様へ統一済みという話ではなく、相互運用に必要な条件を固めていく段階です。[1]

    液冷設備は、公開仕様と建物内の配置を合わせて読む

    冷却では、CDU(Coolant Distribution Unit)のProject Deschutesが紹介されています。CDUは、サーバー側の冷却液の循環や、施設側との熱の受け渡しを担う装置です。Deschutesのv1.0は、OCPのCDUプロジェクトでも公開資料として扱われています。[1・3]

    CDUの仕様が共有されても、それだけで建物の冷却設計が決まるわけではありません。サーバーホールの検討図には、CDUやUPS(無停電電源装置)をラック列の中に置く案と、列の外へ分ける案が示されています。機器を置く場所が変われば、IT機器に使える空間や配管・配電の経路も変わります。[1]

    まず必要な熱負荷を見積もり、その流量と接続条件を受けられる設備を選び、保守のための空間まで配置へ戻す。公開仕様は、そのやりとりを具体的にするための共通の土台になります。

    環境負荷も、稼働中の電力だけで終わらせない

    持続可能性の章では、エネルギー、水、熱に加え、設備や建材のライフサイクルも扱っています。非常用電源については、燃料電池や長時間蓄電などを、特定の方式に固定せず性能で評価する方向が示されています。これは試験や評価の取り組みであり、全施設への導入実績を示すものではありません。[1]

    機器を更新しやすいことと、環境負荷が小さいことは同じではありません。更新の頻度、利用できる電力や水、バックアップに求める時間など、施設ごとの条件を合わせて評価する必要があります。

    世代交代の前に、変えられる範囲を決めておく

    この構想の要点は、次のサーバーのために大きな電源と冷却装置を用意することだけではありません。電力の変動を受け止める場所、熱を受け渡す接続、装置を置き換える寸法と動線を、共通の条件として整理することです。

    そうした条件が共有できれば、機器を変えるたびに、どこまで建物側を見直す必要があるかを判断しやすくなります。サーバーを選べる自由度は、その手前にある電源、冷却、空間の設計から生まれる。Googleの提案は、その範囲をデータセンター全体へ広げています。

    Googleの事業と親会社Alphabetの収益構造は、cyclewaveの企業解説にまとめています。

    参考資料

    2026年9月27日確認。

    [1]Google:The Fungible & Sustainable Data Center: A Blueprint for the AI Era — 2026 OCP APAC Summit公開スライド。構想p.10、電力p.12–18、冷却・配置p.20–24、環境負荷p.30–31。

    [2]Open Compute Project:Realizing the Open Data Center Ecosystem Vision — 2025年10月13日。Open Data Centerの背景。

    [3]Open Compute Project:Coolant Distribution Unit — CDUプロジェクトとProject Deschutes v1.0資料。

  • AIデータセンターの施設設計案、電力密度・液冷・床荷重をつなぐ

    AIデータセンターの施設設計案、電力密度・液冷・床荷重をつなぐ

    AIサーバーの性能が上がると、ラックに何台収められるかが気になります。でも、ラックを何列も並べて動かすには、電気を運ぶ場所、熱を逃がす設備、人が通って手入れする空間も必要です。機器だけを新しくしても、建物側にその余地がなければ使い続けられません。

    2026年8月25日のOCPオンラインワークショップでは、AI向けデータセンターの施設設計を、電力・冷却・寸法の三つをつなげて考える資料が公開されました。ここで示されたのは、2027年から2028年以降を見据えた設計目標です。ワークショップの時点で仕様は検討中であり、すべての施設にそのまま当てはまる確定規格ではありません。[1・2]

    簡単にまとめると?

    • AIデータセンターでは、電力・冷却・通路・天井・床荷重を、ラックと建物の設計でつなぐ必要があります。
    • 資料のkW/ftはラック列の長さ当たりの電力で、床面積やラック1台当たりの値とは異なります。
    • 示された数値は将来の高密度設備を見据えた設計目標で、すべての施設に適用できる確定規格ではありません。

    ラックの「何kW」から、列の「何kW」へ

    資料で目を引く単位は、kW/ftです。これは床面積1平方フィート当たりではなく、ラックが並ぶ列の長さ1フィート当たりの電力を表します。幅の違うラックや、計算機以外の機器を含む列を、施設側から考えるための物差しです。1フィートは約30cmです。[2]

    2028年以降の目標として、機器が混在する列の基準には25kW/ft、ML向け機器が集中する場所のピークには350kW/ftが並んでいます。二つは対象も意味も異なります。350kW/ftを建物全体の平均値や、ラック1台の仕様と読み替えることはできません。高密度の部分と、周辺のネットワーク・ストレージなどが混ざる部分を分けて設計する、という意図が見えてきます。[2]

    電気を届けた分だけ、熱の出口も考える

    電力密度が上がれば、冷却も同じ場所で考える必要があります。発表資料は、MLラックが集中する部分について、列の長さ1フィート当たり液冷335kW、空冷15kWを冷却設備の検討値として挙げています。これも将来の高密度部分を想定した設計上の目安で、一般的なラックの実測値ではありません。[2]

    液冷では、配管の太さだけで運べる熱量は決まりません。冷却液をどれだけ流し、入口と出口で何度温度が変わるかによって、運べる熱が変わります。資料が管径と流量、温度差を並べているのは、そのためです。流れを強めれば何でも解決するわけでもなく、配管内の流速には発表資料上の推奨値が置かれています。冷却能力を比べるときには、温度と流量の条件まで一緒に読みたいところです。[2]

    通路、天井、床までが設計条件になる

    大きく重いラックの周囲には、設置と保守のための空間が要ります。資料では、奥行き約1.8mのラック、対面するラック間の冷気通路約2.1m、二系統のバスウェイを通す場合の天井高約5.5mなどが、配置を考える境界として示されています。床荷重も無視できません。ラックと隣接する装置を合わせた重量の想定例は約6.8tです。[2]

    ここでいうバスウェイは、列に沿って大きな電力を配る設備です。天井の空間には、その経路に加えて通信ケーブルや冷却配管も収まります。資料には複数の配置例があり、天井高の制約で二系統か四系統かを変える案も出てきます。同じ形の建物を一律に作る話ではなく、共通の設計条件を押さえたうえで、現場の制約に合わせて組み立てる話です。[1・2]

    建物の余白は、あとから増やしにくい

    サーバーは世代が変われば入れ替えられます。一方、床が支える重量、天井の高さ、通路の幅、電力と冷却の通り道は、運用を始めてから広げるのが難しい部分です。

    今回の資料から見えてくるのは、将来のAIラックの数字を競うことよりも、そのラックを安全に設置し、冷やし、交換できる建物を先に考える姿勢です。新しい設備の仕様を見るときは「最大何kWか」に続けて、どの長さを基準にした値か、熱をどう運ぶか、人がどこから手入れできるかを確かめる。そうすると、数字の先にある設計の意味がつかみやすくなります。

    参考資料

    2026年9月23日確認。本文はOCPが公開した開催ページと13ページの発表スライドをもとにしています。音声での発言や質疑応答は本文の根拠に含めていません。

    1. Open Compute Project「OCP AI Next Generation: Open Data Center for AI Virtual Workshop」 — 2026年8月25日開催、仕様が検討中であることを含む開催記録。
    2. OCP公式掲載スライド「Next-Generation ML Infrastructure: The Open DC Architecture」 — pp.3–12。2027〜2028年以降の設計目標、電力・冷却・寸法と配置例。