タグ: AIエージェント

  • NHIとSPIFFE、AIエージェントの「誰か」と「何をしてよいか」を分ける

    NHIとSPIFFE、AIエージェントの「誰か」と「何をしてよいか」を分ける

    AIエージェントが社内の資料を読み、その内容を別のサービスへ送ろうとしています。接続してきたプログラムが正規のものだと確認できれば、送信まで許してよいのでしょうか。「誰からの要求か」と「その操作をしてよいか」は、別の問いです。

    2026年8月のOCP Korea Tech Dayで、Seokbin Yoon氏は、人以外の主体を識別するNHI(Non-Human Identity)を軸に、AI基盤の信頼を論じました。資料にはTrust Connector代表と西江大学AI・SW大学院特任教授の両肩書が記されています。本稿では、その講演が提起する操作前の認可を、NISTのゼロトラストの考え方とSPIFFEの公式資料に照らして読みます。[1]

    簡単にまとめると?

    • SPIFFEは、動いているソフトウェアに識別情報を持たせ、相手へ示すための仕組みです。
    • 認証情報が有効でも、資料の閲覧、外部送信、削除をすべて許されたことにはなりません。
    • 操作を許す判断と、実際に通す・止める役割を分けると、エージェントへ渡す権限の境目が見えます。

    SPIFFEは、動いているソフトウェアを見分ける

    人が操作する画面のログインだけでなく、ソフトウェアどうしの通信にも、相手を確かめる仕組みが必要です。SPIFFEでは、特定の設定と目的で動くソフトウェアをワークロードと呼びます。一つのサーバーそのものとは限らず、同じサーバー上の個々の処理を分けたり、複数のサーバーで動く同じ仕事をまとめたりする単位です。[2]

    ワークロードを表す名前がSPIFFE ID、その識別情報を相手が検証できる形にしたものがSVID(SPIFFE Verifiable Identity Document)です。たとえばX.509証明書の形式を使い、発行元を信頼する根拠に照らして確かめます。Workload APIは短い有効期間の証明書や鍵を渡し、自動更新を支えるため、アプリケーションと長く使う秘密情報を一緒に配る運用を減らせます。[2]

    ただし、その仕組みは、別のワークロードに認証情報を盗まれないよう実行環境が隔離されていることを前提にしています。SPIFFEを入れればプログラムの隔離まで完成する、という意味ではありません。[2]

    正規の相手でも、すべての操作を許すわけではない

    相手の識別情報を確かめる認証と、要求された操作を許す認可を、ここで分けて考えます。NIST SP 800-207は、資源へ接続する前に行う別々の機能として両者を扱っています。一つの資源へアクセスできたことが、別の資源へのアクセス許可にそのまま引き継がれるわけでもありません。[3]

    冒頭の例なら、資料を読む権限と、資料を社外へ送る権限は同じではありません。同じエージェントが、同じ有効な認証情報を使っていても、要求の対象と操作が変われば、許される範囲を確かめ直す必要があります。これは仕組みの違いを説明するための例で、特定の製品で行った実験結果ではありません。

    Yoon氏の講演は、実行する主体やコードの状態に加えて、誰からどの権限を委ねられたのかを問います。操作前の判断に、使えるツールやデータの範囲、回数などの上限、権限の有効期間を含める提案です。これらは講演者の設計上の整理であり、SVIDを一枚受け取るだけで、人間からの委任内容まで自動的に証明されるわけではありません。[1]

    判断する役割と、通す・止める役割

    NISTの原図では、要求を判断する側と、資源へ向かう通信を実際に制御する側が分かれています。図の上にあるPolicy Engine(PE)が、組織の方針や状態の情報から許可・拒否・許可の取り消しを決めます。その判断を受けて、Policy Administrator(PA)が通信経路を開く・閉じるための制御を行います。[3]
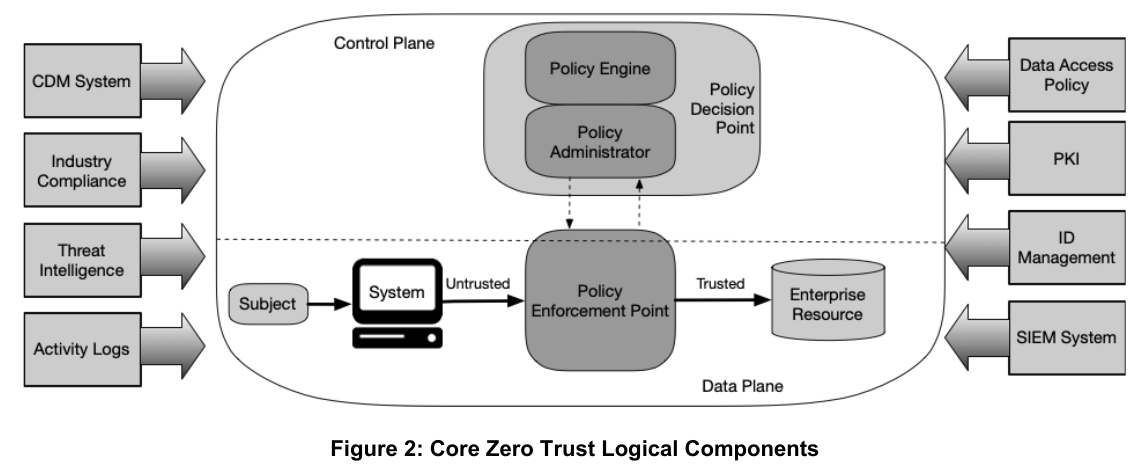
    NISTのゼロトラスト構成図。上部のPolicy EngineとPolicy Administratorが判断と制御を担い、下部のPolicy Enforcement Pointを通して資源へ接続する。識別管理やログなどが判断側へ情報を渡す。
    図1 認可の判断側と通信の制御側を分けた論理構成。NIST SP 800-207「Zero Trust Architecture」、2020年8月、p.9、Figure 2「Core Zero Trust Logical Components」の図部分。原資料。図を拡大する

    下部のPolicy Enforcement Point(PEP)は、要求する側と資源の間に置かれ、接続を通す、監視する、終了させる役割です。右側の識別管理や、左側のログ・機器状態などは、判断へ情報を渡す側にあります。相手のIDは判断材料の一つであり、それだけがすべての操作許可を決める構成ではありません。[3]

    この図は論理的な役割を示すもので、箱の数だけ製品やサーバーを用意する指示ではありません。NISTも、PEとPAを一つのサービスとして実装する場合を挙げています。AIエージェントへ当てはめるなら、モデルが提案した操作を、資源へ届く前に方針に照らして確かめ、許可された経路だけを通す、と読むことができます。この対応づけは本稿の説明で、NISTの図自体が特定のエージェント製品やツールを規定しているわけではありません。[3]

    組織をまたぐ認証にも、権限の判断は残る

    SPIFFEには、識別情報の発行と検証の基点をまとめるトラストドメインがあります。SPIREの公式資料は、異なるトラストドメインに属するワークロードどうしを認証するフェデレーションを説明しています。そのため、講演中の「SPIFFEだけでは組織を越える扱いが足りない」という論点を、「SPIFFEは組織間の認証ができない」と読み替えるのは正確ではありません。[1][4]

    相手の発行元を受け入れ、そのワークロードを認証できることと、こちらの資料へどこまでアクセスさせるかは、別に決めることです。短い有効期間の認証情報も、認める操作や対象の範囲を考えなくてよくするものではありません。

    AIエージェントへ仕事を任せるとき、まず見える形にしたいのは、どのソフトウェアが、どの資源へ、何を要求し、どの方針で通されたのかというつながりです。NHIの識別情報と操作の認可を分けておくと、「正規のプログラムだから任せてよい」という一段の判断を、確かめられるいくつかの役割へ分けられます。

    参考資料

    1. Seokbin Yoon(윤석빈、Trust Connector代表・西江大学AI・SW大学院特任教授)「The Trust Layer for Open AI Infrastructure: Non-Human Identity (NHI) and Machine Economy Standards」、2026年8月、全38ページ。四つの問いはPDF p.20、ワークロード識別はp.24、操作前の認可はp.26。頁はPDF先頭から数えています。OCP Korea Tech Day公式資料一覧。講演音声・質疑は対象外です。
    2. SPIFFE「SPIFFE Concepts」。ワークロード、SPIFFE ID、SVID、Workload API、実行環境の隔離に関する前提。2026年10月8日確認。
    3. Scott Roseほか、NIST SP 800-207「Zero Trust Architecture」、2020年8月。認証・認可と最小権限は本文pp.4–7、PE・PA・PEPとFigure 2はpp.9–10。AIエージェント専用の規格として扱っていません。
    4. SPIFFE/SPIRE「SPIRE Federation Example」。異なるトラストドメインでのワークロード認証と、検証に使う情報の共有。導入部分を参照し、構築手順の実行検証はしていません。2026年10月8日確認。
  • NVIDIA Isingで量子ビットの周波数を探す、中央研究院の校正実験

    NVIDIA Isingで量子ビットの周波数を探す、中央研究院の校正実験

    量子コンピューターに計算を任せるには、量子ビットへ適切な信号を送り、その応答を正しく読み取れる状態にしておく必要があります。回路図に同じゲート操作を書いても、実機で使う信号の周波数や振幅まで自動的に決まるわけではありません。

    台湾の中央研究院(Academia Sinica)のChiiDong Chen氏は、OCP APAC 2026の公開資料で、超伝導量子プロセッサーの立ち上げと校正を紹介しています。NVIDIA Isingを使う周波数同定の例では、弱い測定信号を受けて条件を調整し、ピークを見つけてから細かい探索へ進みます。AIの役割が見えてくるのは、この「測る、確かめる、次の測定を変える」という流れです。[1]

    簡単にまとめると?

    • 量子ビットの校正は、測定結果をもとに周波数や駆動・読み出し条件を繰り返し調整する工程です。
    • NVIDIA Isingの例では、測定を検査する役と装置を動かす役を分け、結果を次の探索条件へ戻します。
    • 資料の4試行は周波数同定の一例で、量子プロセッサー全体の校正が4回で完了した結果ではありません。

    ゲート操作を、実機で使えるパルスに合わせる

    超伝導量子ビットの制御では、短い電気信号であるパルスを使います。資料のゲート操作図には、XY駆動の振幅、周波数、位相、波形、継続時間と、Z制御の振幅、波形、継続時間が示されています。校正(キャリブレーション)は、こうした設定を測定結果に合わせて調整する工程です。[1]

    立ち上げでは、まず共振器や量子ビットがどの周波数に応答するかを調べます。続いて駆動条件や、状態を読み分けるための読み出し条件を合わせます。資料には、単一量子ビットの調整だけでなく、量子ビット間の影響や2量子ビットゲートを調べる工程も並びます。

    ここで大切なのは、一度決めた設定を順番に埋めれば終わる、という流れではないことです。資料の単一量子ビット校正例は、共振器の周波数、量子ビットの周波数、Zオフセット、XY駆動、読み出しを調べた後、ZオフセットやXY駆動の再調整へ戻ります。一つの測定結果が、次に使う条件を変えるのです。

    Chen氏は量子ビットが増えた際の課題として、全体の最適化、再校正の増加、見えにくい相関を挙げています。個々の設定を合わせる作業から、互いに影響する設定を繰り返し整える作業へ広がることが、自動化を考える背景にあります。

    計算機の判断を、量子制御装置へ戻す

    資料は、強化学習を使う校正の構成例として、NVIDIA Grace HopperとQuantum Machinesの制御装置OPX1000を示しています。計算側からパラメータを渡し、制御装置がパルスを送って、量子ハードウェアから読み出した情報を戻す構成です。[1]

    接続図にはNVQLink、OP-NICとともに、PCIe経由64Gb/s、往復遅延3.5µsという値が記されています。これは図に示された接続の値です。周波数を探索し、測定を評価して校正を終えるまでの所要時間を示すものではありません。

    この強化学習の構成例に続き、資料はNVIDIA Isingを使った周波数同定を紹介します。二つを同じ実験の結果としてまとめず、後者の判断の流れを見てみます。

    Isingが測定を検査し、次の探索条件につなぐ

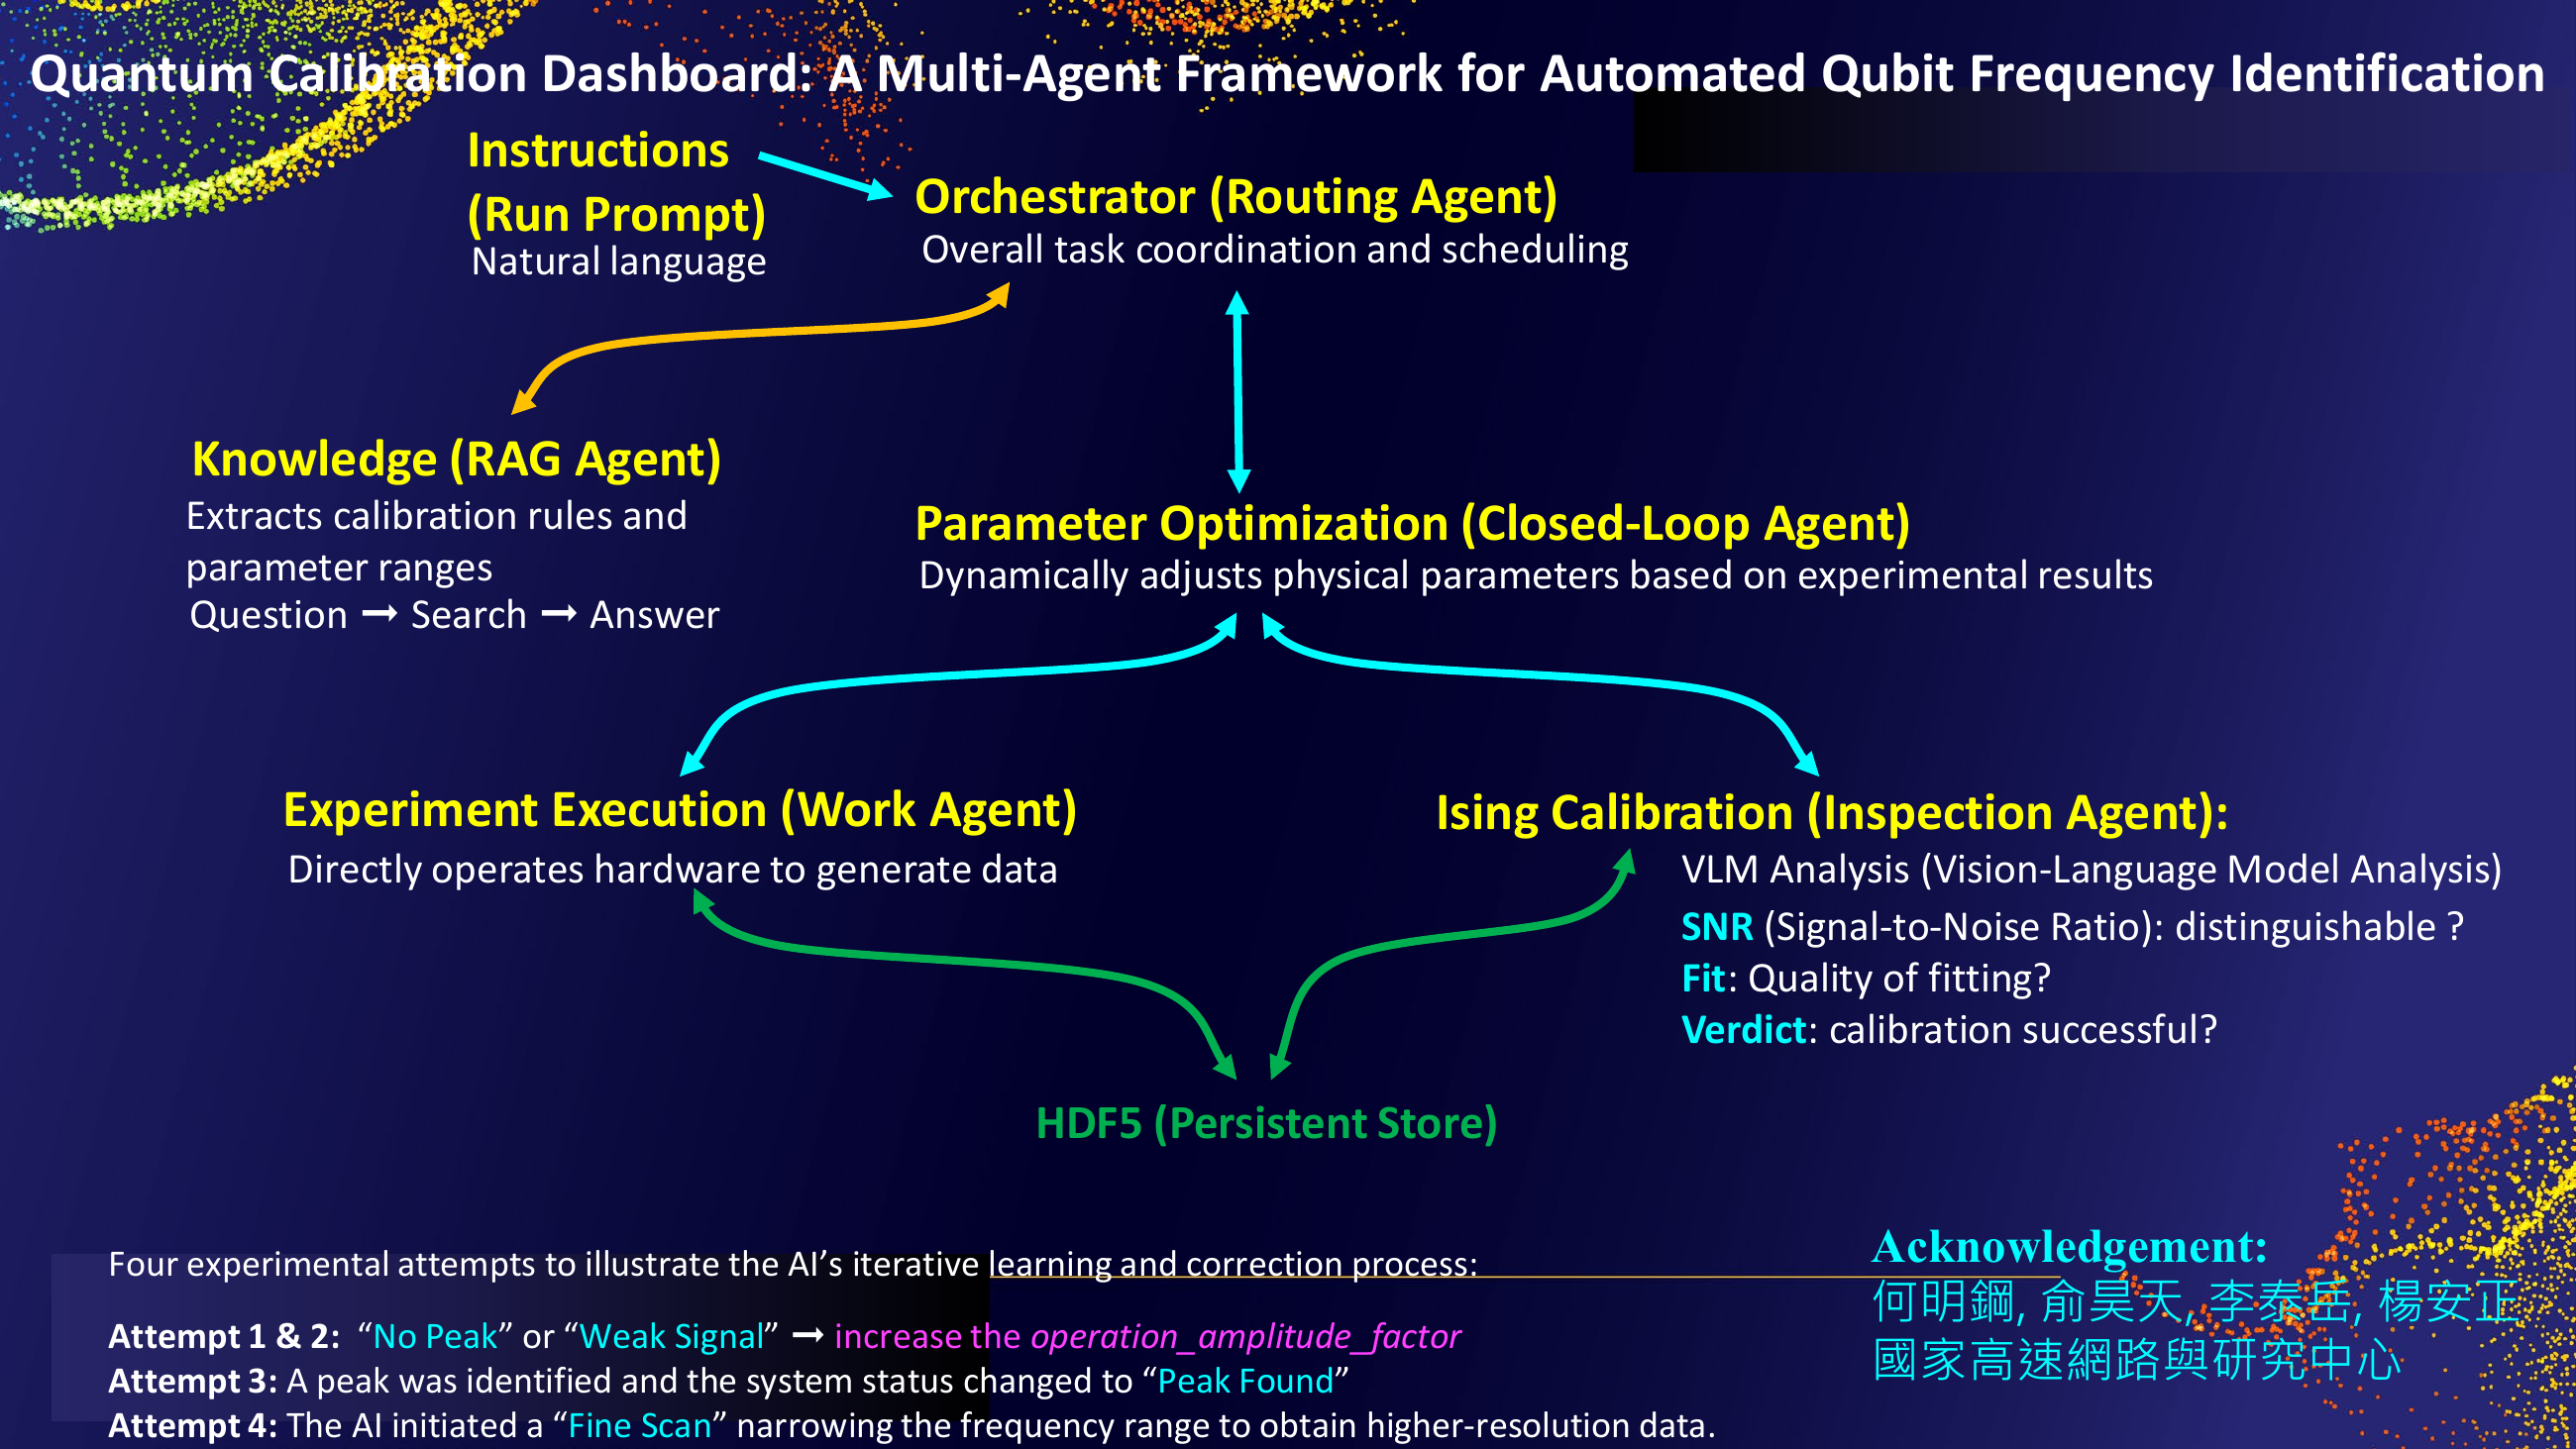
    図1は、周波数同定を複数のエージェントで進める構成です。全体の指示を振り分ける役、校正の規則やパラメータ範囲を参照する役、装置を動かしてデータを得る役、測定を検査する役、次の物理パラメータを調整する役を分けています。[1]

    Ising Calibrationは検査側に置かれています。画像と言語を扱うモデルによる分析で、信号を雑音から区別できるか、測定値への曲線の当てはまりがよいか、校正が成功したと判断できるかを調べます。実験結果を受けて条件を変える閉ループの役割と、実際に装置を動かす役割は別です。NVIDIAの公式説明でも、Ising Calibrationは量子ハードウェアの実験データを解釈し、エージェントと組み合わせて調整を支えるモデルと位置づけられています。[2]

    量子ビットの周波数同定で、指示の振り分け、規則の参照、実験、Isingによる検査、パラメータ調整を結ぶ構成図。下段には弱信号からピーク検出、細かい探索へ進む4試行の説明がある。
    図1 実験と検査を分け、結果を次のパラメータ調整へ戻す周波数同定の構成。狭い画面では図を横にスクロールできます。画像を開くとさらに拡大できます。ChiiDong Chen/Academia Sinica『Operating Superconducting Quantum Processors at Scale: Autonomous Bring-Up and Calibration』p.16。資料内の謝辞:何明鋼、俞昊天、李泰岳、楊安正、國家高速網路與研究中心。出典[1]。

    資料に示された4回の試行は、次のように進みます。

    試行 測定結果と次の動き
    1・2回目 ピークがない、または信号が弱い結果を受け、駆動振幅に関わる係数を増やす
    3回目 ピークを検出し、状態が「Peak Found」へ変わる
    4回目 周波数範囲を狭め、より細かいデータを得る探索へ進む

    資料[1]p.16の試行説明をもとにQuantum Seaが整理。

    周波数の候補がまだ見えない段階と、候補の近くを詳しく調べる段階では、次に必要な測定が変わります。この例の要点は、AIが一度の回答で設定値を決めることではなく、実験の応答を見て探索の進め方を変えることにあります。

    周波数同定の一例を、QPU全体の完成と分ける

    4試行は、この資料が示す周波数同定の例です。すべての量子ビットやゲートの校正が4回で終わるという結果ではありません。また、試行中に物理パラメータを調整したことと、AIモデル自体を追加学習したことも分けて読む必要があります。

    資料が今後の議論として挙げるのは、QPU設計、量子プログラム、誤り訂正へのAI支援です。周波数同定の実験から、そのすべてが自律化できたとは言えません。

    今回の例から見えるのは、判断を実際の測定につなぎ、得られた結果を検査してから次の操作へ戻す設計です。量子ビットを安定して使うための自動化では、AIの回答だけでなく、この往復をどこまで確かめながら進められるかが重要になります。

    関連企業を知る

    NVIDIAとQuantum Machinesの事業全体は、cyclewaveの企業解説で紹介しています。

    参考資料

    1. ChiiDong Chen/Academia Sinica『Operating Superconducting Quantum Processors at Scale: Autonomous Bring-Up and Calibration』、OCP APAC 2026公開スライド、全20頁。本文は主にpp.6、8–9、11、14–16、19を参照。PDF作成日は2026年9月8日で、会場投影版との同一性は未確認。スライドPDF/OCP公式資料一覧
    2. NVIDIA『NVIDIA Ising』。Ising Calibrationの役割を参照(2026年10月5日確認)。公式解説
  • MicrosoftのAIエージェントによるサーバー検証、試験生成から不具合分類へ

    MicrosoftのAIエージェントによるサーバー検証、試験生成から不具合分類へ

    サーバーの不具合は、ハードウェア、ファームウェア、ソフトウェアのどれか一つに、きれいに分かれて現れるとは限りません。温度の変化、装置側のログ、ソフトウェアのエラーを別々に見ていると、同じ問題を何度も調べたり、必要な試験へたどり着くまでに時間がかかったりします。

    MicrosoftがOCP APAC Summitで示したのは、テスト生成と不具合分類を、層をまたぐ計測情報でつなぐ検証AIです。試験項目を一度作って終えるのではなく、結果や過去の不具合を次の検証へ戻す仕組みとして、自律検証エージェントを位置付けています。[1・2]

    簡単にまとめると?

    • Microsoftの検証AIは、装置の計測情報やログを、試験の生成・実行・不具合分類へつなぐ仕組みです。
    • 過去の不具合と人の確認を次の試験へ戻しますが、似たログだけで原因を確定するわけではありません。
    • 重複試験の削減はサンプルデータでの結果で、検証全体の短縮は予測値として区別されています。

    ログを並べるだけでなく、次の試験へつなぐ

    資料の検証ループは、ソフトウェアの不具合情報、ファームウェアのログ、ハードウェアのテレメトリーを入力にします。異常を見つけたら、その装置の条件に合う試験を起動し、過去の似た故障と関連付けて、原因を絞っていく流れです。[2]

    例として、ハードウェアとファームウェアの情報にメモリーエラーが現れた場合、ストレステストを実行し、過去の類似障害と照合する構成が描かれています。「エラーが出た」と記録するだけでなく、次に何を確かめるかまでつなぐ点が特徴です。[2]

    もちろん、同じようなログが出ていても、原因が同じとは限りません。似た事例は調査の手がかりであって、それだけで原因が確定するわけではないため、試験結果と人の判断を戻す経路も必要になります。

    TestGen.AIとBugEval.AIの役割

    資料では、検証シナリオを作るTestGen.AIと、不具合を評価・分類するBugEval.AIが示されています。意味の近い情報を探す検索や、過去の不具合のまとまりを使い、その時点で優先すべき試験や問題を選ぶ考え方です。[2]

    ここで大事なのは、過去に用意した試験だけを引き継ぐのではなく、前の世代で見逃した不具合も、次の世代の試験へ反映することです。資料は、過去世代の故障パターンを調べ、試験と変更提案を作る流れを示しています。[2]

    Microsoftの関連ブログも、こうしたエージェントを社内の検証・プラットフォーム開発で使う仕組みとして説明しています。公開資料に名前が出ていることと、そのまま利用できる一般向け製品であることは別です。[3]

    CPUの温度保護を、生成から再試験までたどる

    具体例は、CPUのサーマルトリップ点、つまり温度保護が作動する条件の検証です。まずTestGen.AIが試験を生成し、実行を統括するオーケストレーターが対象のハードウェアへ割り当てます。装置で負荷を動かし、温度の計測情報を集めます。[2]

    次にBugEval.AIが、集まった情報を判定条件と照合し、合否と診断に役立つ情報を返します。不合格なら、その結果を使って試験を調整し、再試験へ進みます。試験生成、実行、計測、評価を、ひと続きに扱う構成です。[2]

    この資料には、具体的な温度閾値や負荷条件までは示されていません。ここで示されているのは検証の組み立て方であり、個々のCPUで保護機能を試すための操作手順ではありません。

    試験を減らすときは、見逃しを増やしていないかを見る

    資料は、サンプルデータセットで重複する試験の実行を30%減らしたとしています。一方、検証サイクル全体を40%短くするという数字には、予測値と明記されています。評価対象の規模や詳細な比較条件も、このスライドだけでは分かりません。[2]

    試験の数や時間が減るだけでは、品質が良くなったとは判断できません。必要な不具合を引き続き見つけられるか、過去に見逃した条件を追加できたか、誤った分類が増えていないかも合わせて見る必要があります。これは、資料の効率改善を実際の検証へ持ち込むときの確認点です。

    変わりやすいハードウェア構成やファームウェアの条件を、試験結果と一緒に残すことも欠かせません。前の環境で役立った試験が、次の環境でも同じ意味を持つとは限らないからです。

    人の判断を残しながら、検証のつながりを短くする

    資料のループには、人が結果を確認し、学習へ戻す段階が含まれています。AIが情報を集め、似た不具合を整理し、試験の候補を用意する。その先の設計判断まで、根拠が追える状態にしておく構成です。[2]

    検証AIの価値は、試験を自動で増やすことだけではありません。過去に分かったことを、いま必要な試験へ結び直すことにあります。ハードウェアとソフトウェアを一緒に設計するなら、検証もまた、それぞれの情報をつないで進める必要があります。

    Microsoftの事業をもう少し知る

    Azureを含むクラウド、業務ソフト、Windowsなど、Microsoft全体の事業についてはcyclewaveの企業解説にまとめています。

    参考資料

    2026年9月27日確認。講演の公開スライドをもとに構成しています。

    [1]Open Compute Project:2026 OCP APAC Summit 公式セッション一覧

    [2]Microsoft:Embedding Intelligence into Hardware-Software Co Design Through Autonomous Validation Agents(講演スライド)

    [3]Microsoft:Driving Efficiency in Modern System Engineering with AI Agents