AIの学習に使うGPUを増やすと、計算機を置く場所だけでなく、GPU同士をどう結ぶかも変わります。一つの建物に収まっていた通信を、別の建物やデータセンターまで広げると、距離による遅延や故障時の経路変更が学習に響いてきます。
MetaのJalpa Patel氏とAnkur Singh氏は、OCP APAC 2026の講演資料で、AI基盤を広域につなぐBAG(Backend Aggregation)を紹介しました。高速な回線を用意するだけでは足りず、ネットワークの制御と学習処理の両方を合わせる必要があることが見えてきます。[1]
一つの建物から、複数の拠点へ
資料では、Prometheusを1ギガワット級のクラスターとして説明し、通常のデータセンター棟に加え、屋外の耐候性テントや隣接するコロケーション施設も使う構成を示しています。この規模の説明はMetaの資料に基づくもので、ここから全設備の稼働状態まで分かるわけではありません。
資料がNSFと呼ぶネットワーク構成では、一つのIslandに72ラック、5,184基のGPUをまとめます。その内側にあるバックエンドのPodはノンブロッキングとされる一方、Islandをまたぐ部分には3対1のオーバーサブスクリプションがあります。接続された全GPUが、あらゆる相手へ同時に最大速度で通信できる構成ではない点に注意が必要です。
BAGは、その上位で複数のネットワークをつなぐ、Ethernetベースの集約層です。役割を分けて見ると、どこまでの通信を扱っているか整理しやすくなります。
図1の下段に並ぶ各Regionのネットワークは、上段のBAG集約層に接続されています。BAG同士を結ぶ線まで一緒に見ると、個々のネットワークを集約層を介して結ぶ構成だと分かります。図が表すのは接続関係であり、すべての組み合わせで同じ帯域が得られることを示すものではありません。
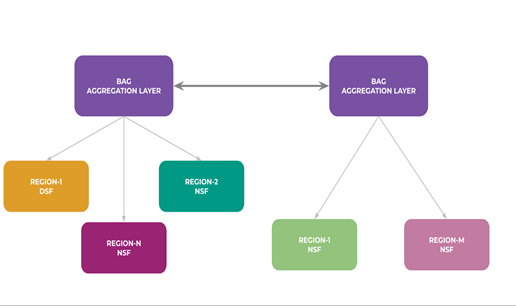
Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」、OCP APAC 2026、p.5。出典の講演資料。スライド内の図部分を掲載。
図は横にスクロールできます。図の画像を開く
| 範囲 | 資料で示される特徴 |
|---|---|
| バックエンドのPod内 | ノンブロッキングの接続 |
| Island間 | 3対1のオーバーサブスクリプション |
| BAGによる集約 | 複数のデータセンターや地域のネットワークを接続 |
距離が延びると、止めた後にもデータが届く
混雑した受信側から送信を一時停止するよう伝えても、その通知が届くまでには時間がかかります。その間に届くデータを受け止める余裕が必要です。優先度ごとに送信を抑えるPFC(Priority Flow Control)を使う場合、ケーブルが長いほど、この余裕として確保するバッファー量も大きくなります。
Metaは、FBOSSを使って信号の往復時間からケーブル長を推定し、最長距離を一律に仮定する代わりに、実際の長さに沿って余裕を割り当てる方法を示しました。距離の違いを測ることが、限られたメモリーの使い方にも関わります。
資料はさらに、複数のキューからDRAMへ同時にデータを移すと競合が起き、SRAM側の余裕がなくなり、PFCの影響が全ポートへ広がる危険も挙げています。容量が大きいメモリーを備えるだけで解決する問題ではなく、そこへデータを出し入れする過程も設計の対象です。[1]
故障後は、残った帯域に合わせて分ける
通信経路の一部が故障すると、経路ごとに残っている帯域が違ってきます。それでも均等にデータを流すと、細くなった経路に混雑が集まります。
BAGでは、BGPで経路の帯域情報を伝え、UCMPという、経路の能力に応じて割合を変える分散方法を使います。一方で、小さな帯域変化のたびにネットワーク全体の経路情報が揺れ続けないよう、更新を抑える仕組みも組み合わせています。故障に追従する速さと、制御を安定させることの両立が課題になります。
図2では、左側のリンク束の一つに「1 link down」とあり、経路ごとの帯域情報がLBWとして右側のBAGへ伝わる様子が描かれています。BAGへ入った通信は、青い矢印のように各経路の重みに応じて振り分けられます。故障で減った帯域を分配に反映する点が、この図の要点です。
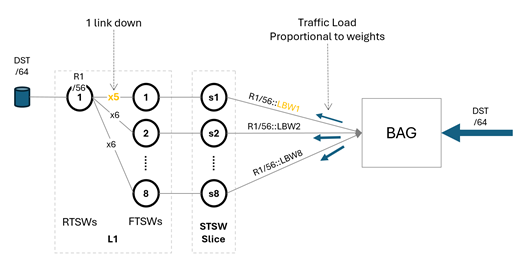
Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」、OCP APAC 2026、p.7。出典の講演資料。スライド内の図部分を掲載。
図は横にスクロールできます。図の画像を開く
回線の先にある学習処理まで合わせる
通信が届けば学習の効率も保たれる、とは限りません。資料では、一つのBAGを経由するL2ネットワーク間の遅延を、L2内のおよそ3倍としています。これは資料内の構成の比較であり、別の設備にもそのまま当てはまる値ではありません。
GPU間の集団通信に使うNCCLについても、プロトコルの選択がネットワーク遅延を考慮していないことを課題に挙げています。遠い相手との通信に合わせた調整に加え、BAG層を通る通信のうち、計算で隠せず待ち時間として現れる部分を小さくすることが求められます。
今後の課題として示されるのは、異なる構成のクラスターへの対応や、数十・数百・数千キロメートル離れた地域間での学習です。これらは講演時点の取り組みの方向で、すべてが実現済みという意味ではありません。Metaの事例が示すのは、AI基盤を広げる際には、回線、バッファー、経路制御、学習ソフトウェアを一続きで考える必要があるということです。
Metaを企業全体から見る
Metaのサービス事業やAI基盤への投資を含む企業全体の説明は、cyclewaveの記事にまとめています。