二つの値を続けて読んだとしても、それらが同じ更新に属するとは限りません。一方を読んだ直後に書き込みが始まれば、古い値と新しい値が混ざる可能性があります。Linuxのシーケンスカウンターは、読み取りの前後に番号を確かめ、この混在を含み得る試行を捨てて読み直すための仕組みです。
簡単にまとめると?
- seqcountは、読み始めの番号が偶数で、読み終わりにも同じ番号だったかを確認します。途中に更新を検出した読み取りは採用しません。
- 書き手は更新の開始と終了で番号を進めます。seqcount_t自体は複数の書き手を直列化しないため、書き手側の保護が別に必要です。
- 読んだ値がたまたま正しく見えても、番号が変われば再試行します。番号の確認だけでは、破棄されたポインター先の安全性や再試行回数の上限までは保証できません。
値を一つずつ読めても、組としては古さが混ざる
説明用に、二つの整数xとyを保存し、更新完了時には常にy=10xとなる小さなデータを考えます。古い組は(1,10)、新しい組は(2,20)です。読み手がx=1を読み、書き手が二つとも更新した後でy=20を読めば、手元には(1,20)が残ります。どちらも実在した値ですが、完了したどちらの組とも一致しません。
このモデルで困るのは、xやyの値だけを取り出せなかったことではありません。二つを一組として扱いたいのに、読み取りの途中で更新が挟まったことです。実際のデータでは常にy=10xのような簡単な検査式があるとは限らないため、値を見ただけで更新の混在を発見する方法には限界があります。
シーケンスカウンターは、データと一緒に更新の進行を示す番号を持ちます。Linuxの公式資料は、更新頻度が低く、読み手が変更時の再試行を許容できる用途として説明しています。[1、Introduction] 本稿ではLinux 6.12版の資料を使い、通常のseqcount読み取りの考え方に範囲を絞ります。
偶数は開始できる印、同じ番号は採用する条件
書き手は、更新を始めるときと終えるときに番号を一つずつ進めます。たとえば2から始めれば、更新中は3、完了後は4になります。読み手は、開始時に偶数の番号を得て、必要なデータを読み取り区間内で手元へコピーし、終了時の番号と照合します。開始と終了が同じ偶数なら、その試行を採用できます。[1]
この説明では、偶数かどうかと、同じかどうかの両方が必要です。2から4へ変わった場合、どちらも偶数ですが、間に更新が終わっています。終了時が偶数だったという理由だけでは、その間に読んだデータを採用できません。反対に、開始時が奇数なら、通常の読み取りは安定した開始点を待つ必要があります。
LinuxのAPIでは、read_seqcount_beginで開始値を受け取り、read_seqcount_retryで再試行の要否を確認する形になります。[1、Sequence counters] これは単なる二つの整数比較を任意のプログラムへ貼り付ければ完成する、という意味ではありません。実装にはメモリーアクセスの順序などの条件があり、ここで示す時系列モデルはその代替コードではありません。
三つの読み取りを、同じ更新で比べる
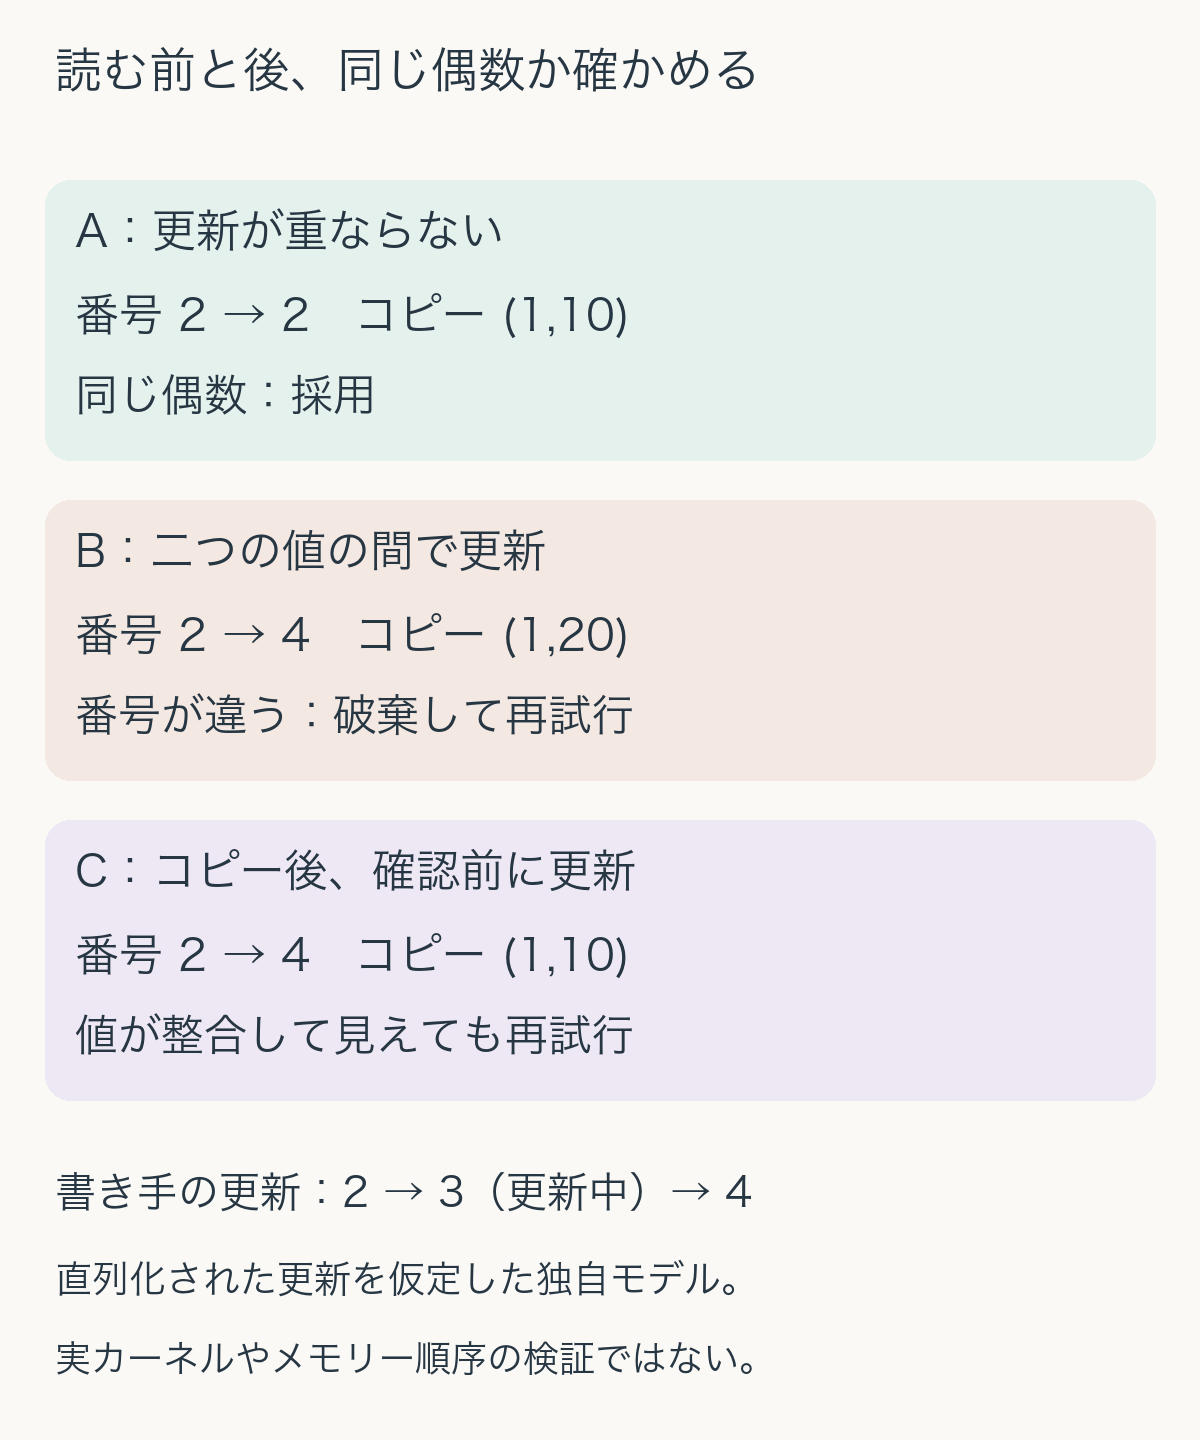
独自モデルの例Aでは、番号2のままx=1、y=10を読み、最後も2でした。この試行は採用され、古い組(1,10)を得ます。読み終わった直後に書き手が更新を始めたとしても、それは採用したコピーの中へ新しい値を混ぜることとは別です。整合した一組を得ることと、使用する瞬間まで永久に最新であることを分けます。
例Bでは、開始番号2を読み、x=1をコピーしたところで、書き手が番号を3へ進め、x=2、y=20を書き、番号4で終了します。その後、読み手はy=20と終了番号4を読みます。手元の組は(1,20)ですが、開始2と終了4が一致しないため、この試行を捨てます。安定後に読み直せば、4と4の間で(2,20)を得られます。
例Cでは、読み手がx=1とy=10を両方コピーした後、最後の番号を確認する前に更新が完了します。この場合、手元の値は古い整合した組です。それでも番号は2から4へ変わったため、再試行します。検査は「値が壊れていたと証明できたか」ではなく、「この読み取り区間を安全に採用する条件が成立したか」を判定するからです。
読み手がロックしないことと、書き手の保護は別
seqcount_tは、複数の書き手の同時進行を防ぐ機構を内蔵していません。書き手を外部のロックなどで直列化し、読み手によって更新区間が中断され続けない条件も整える必要があります。[1、Sequence counters] 読み手がロックを取らない設計でも、システム全体からロックがなくなったとは限りません。
書き手の直列化を省くと何が起きるか、悪い条件を意図的に与えたモデルも作れます。番号2から書き手Aが開始して3、Aの終了前に書き手Bまで開始して4にすると、更新が進行中なのに偶数へ戻ってしまいます。この例はLinuxの正しいAPI利用を再現したものではなく、直列化という前提を外すと番号の意味が崩れることを示すものです。
seqlock_tは、シーケンスカウンターに書き手側のスピンロックを組み合わせた型です。[1、Sequential locks] ただし、割り込みとの関係などに応じたAPIの選択は残ります。また同じ資料には、ロックを取る読み手や条件付きで切り替える読み手も記載されています。本稿の「読み手がロックしない」という説明は、通常の再試行型の読み取りについてです。
やり直せる読み取りに向く、という条件を守る
一度読んだ値を外へ送信してしまった後で、番号が違うからもう一度送る、という設計では、再試行が重複した副作用になります。試行中は必要な値を手元へコピーし、採用条件を満たした後に、その結果を使う処理へ進むと考えると役割を整理できます。これはモデルから導く設計上の読み方で、外部処理全体のトランザクションをseqcountが保証するという意味ではありません。
ポインターの先を追う場合には、さらに問題があります。書き手がその先のオブジェクトを無効にした後で読み手が参照すれば、終了時の番号検査を行う前に危険な参照が起き得ます。公式資料が通常の機構についてポインターを含むデータへの制約を挙げるのは、このためです。[1、Introduction] 番号の照合を、オブジェクトの寿命管理へ代用できません。
更新が多いほど、読み手は何度もやり直す可能性があります。本稿の例で一回のやり直しが成功したことは、実機での上限回数や所要時間の保証ではありません。データの更新頻度、コピーにかかる時間、書き手の保護、参照先の寿命を確認し、再試行を許容できる読み取りかどうかを判断することが重要です。
出典
- Linux Kernel documentation 6.12, Sequence counters and sequential locks。Introduction、Sequence counters (seqcount_t)、Sequential locks (seqlock_t)、read_seqcount_begin、read_seqcount_retry。2026年10月23日確認。二整数の例・図・時系列の照合は独自作成。実カーネルの並行実行、メモリーモデル、性能を検証したものではない。