タグ: BMC

  • M-PNPでサーバーの機種差を伝える、JSONと共通ファームウェアの役割

    M-PNPでサーバーの機種差を伝える、JSONと共通ファームウェアの役割

    サーバーの基板を交換するとき、コネクターが合うだけでは十分ではありません。管理用のソフトウェアが、新しい基板の構成や制御方法を知らなければ、状態を読み取ったり、正しい順番で起動したりするための作り込みが残ります。

    M-PNP(Modular Plug-and-Play)は、この機種ごとの情報をハードウェア側から渡し、共通のファームウェアで扱える範囲を広げようとする取り組みです。2026年8月のOCP APAC Summitでは、JabilのTodd Rosedahl、HPEのDavid Heinrich、IntelのDirk Blevinsが、自己記述型のJSONファイルと、それを利用する仕様群を説明しました。[1]

    簡単にまとめると?

    • M-PNPは、サーバーの機種ごとの構成や制御情報をJSONで伝え、共通ファームウェアの再利用を目指します。
    • 機器の発見・起動、FPGAの制御、相互運用の条件を、役割の異なる仕様でつなぎます。
    • JSONを用意するだけで互換性が完成するわけではなく、筐体全体の動作や適合条件までそろえる必要があります。
    • 2026年10月8日に確認した公式一覧は0.5のパッケージを掲載しています。講演で示された後続版の目標時期とは区別します。

    機種ごとの知識を、コードの外へ渡す

    サーバーをモジュールに分けるDC-MHS(Data Center Modular Hardware System)では、計算を担うHPM(Host Processor Module)と、管理・セキュリティ・制御を担うDC-SCMを組み合わせます。DC-SCM側には、サーバーの状態監視や制御を行うBMC(Baseboard Management Controller)があります。

    発表が指摘するのは、ハードウェアの接続条件をそろえても、BMCのファームウェアに機種固有の知識が必要になることです。HPMや筐体の違いをあらかじめコードへ組み込む方式は、資料中で「Plug-and-Code」と呼ばれています。新しい構成を扱うたびに、対応するコードを用意する仕事が生じます。[1]

    M-PNPの方向性は、ハードウェアを説明するファイルを用意し、共通のファームウェアに読み込ませることです。JSONは、項目名と値を組み合わせて情報を記述する形式です。ここでは、機器の情報を発見し、構成し、利用するためのデータを渡す役割を持ちます。ハードウェア供給側が共通のひな型や変換ツールを使ってファイルを作る想定です。

    ただし、JSONという形式を選べば、すべての動作が自動的に決まるわけではありません。どの項目が必要で、値をどう解釈し、どの制御先へ結び付けるかを共有して初めて、共通のコードが利用できます。形式をそろえることと、意味や動作をそろえることは別の仕事です。

    機器を見つける仕様と、制御する仕様

    発表では、M-PNPの仕様群を三つの役割で説明しています。

    一つ目のFRU Discovery & Bootは、BMCが構成部品を発見し、起動に必要な情報を扱うための仕様です。FRU(Field Replaceable Unit)は現場で交換可能な単位を指します。この仕様は、FRUの識別情報、構成部品を説明するJSONのスキーマ、プラグアンドプレイに必要な起動要件を扱います。スキーマは、ファイルにどんな項目をどの形式で記すかという約束です。[1]

    二つ目のHPM FPGAは、BMCがFPGAを扱う際のインターフェースや、内部の機能を表す方法をそろえる仕様です。FPGA(Field-Programmable Gate Array)は、書き込む構成によって論理回路を組み替えられるデバイスです。資料は、機能単位であるIPブロック、レジスターの配置、仮想配線などをJSONで説明する枠組みを挙げています。バスや通信手順に加え、セキュリティ上の考慮や版管理も対象です。

    三つ目のInteroperabilityは、何をもって相互運用できるとするかを定義する上位の仕様です。共通の用語や要求、適合の考え方を置き、発見・起動やFPGAなどの設計仕様につなげます。各社の部品が同じファイル形式を出せるだけでなく、組み合わせたときの条件まで一致しているかが論点になります。

    三つの仕様は、一方向に積み重なるだけではない

    原資料の図は、発見・起動とFPGAの仕様を双方向の矢印でつなぎ、その両方を相互運用仕様へ結んでいます。ここには、ファイルを上から順に読むだけでは説明できない依存関係があります。
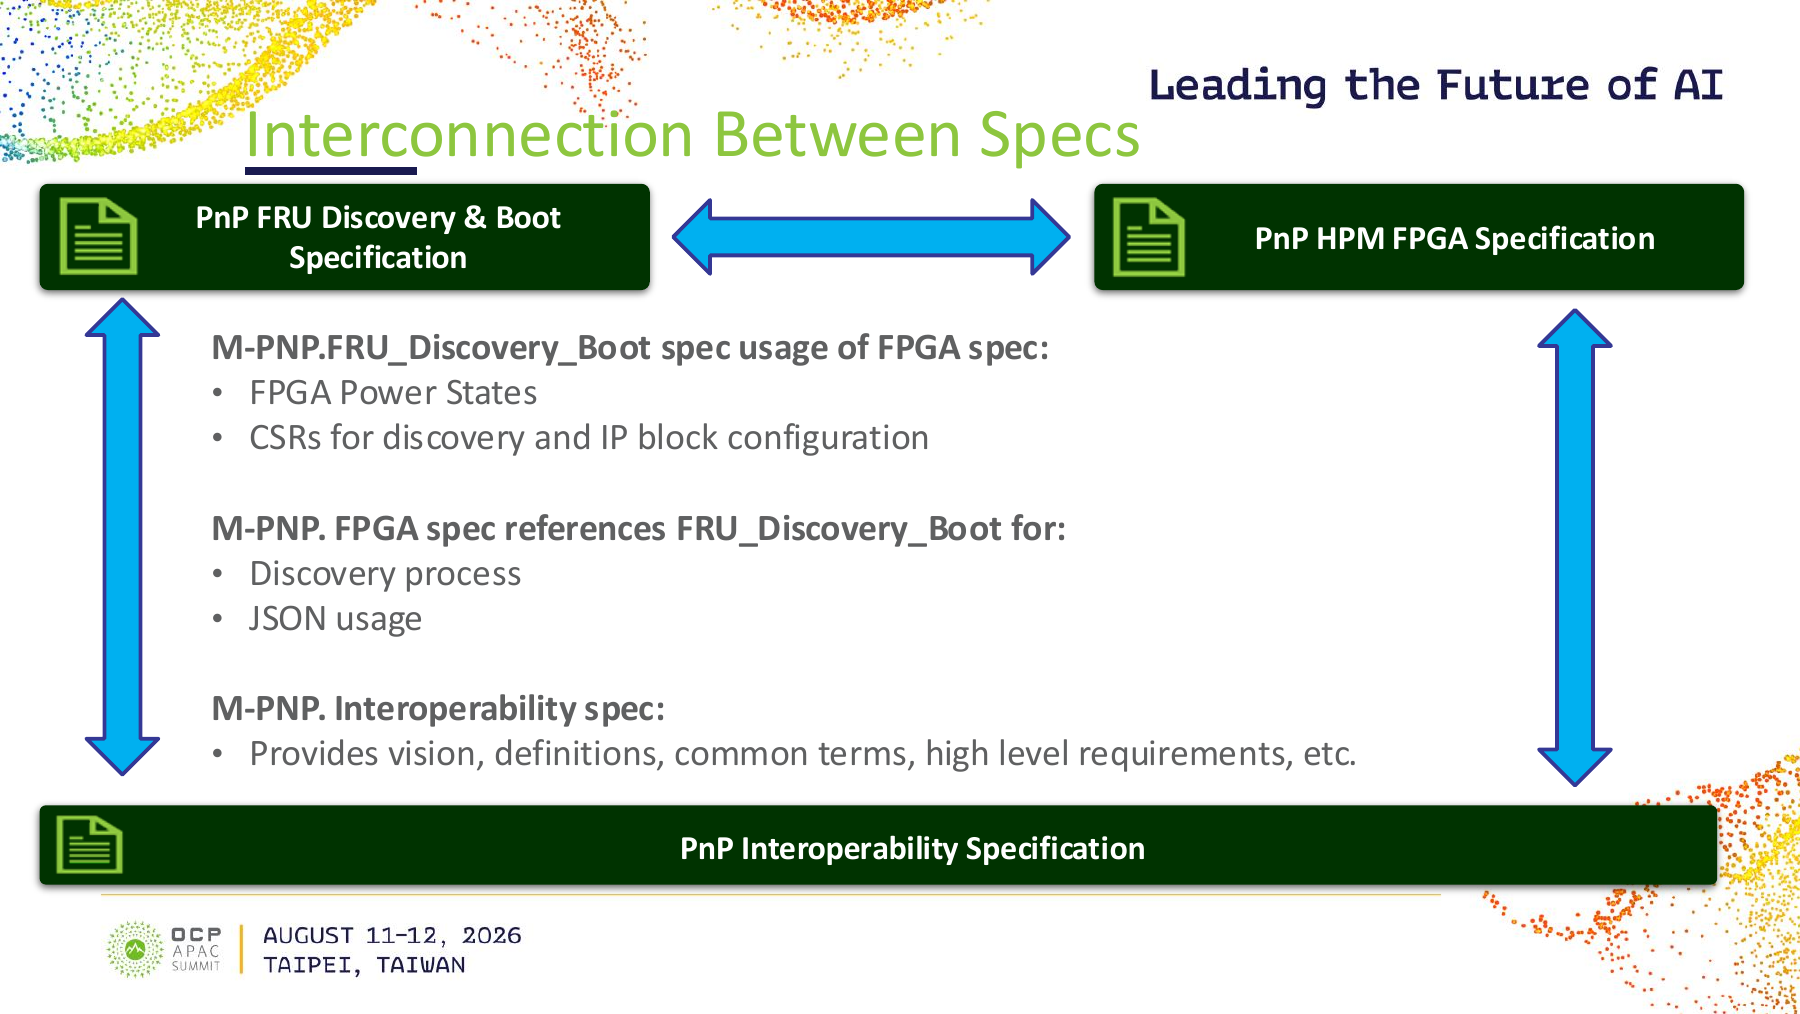
    M-PNPの仕様間の関係。FRU Discovery & BootとHPM FPGAが双方向につながり、両者が下段のInteroperability仕様とも双方向の矢印で結ばれている。
    図1:発見・起動、FPGA、相互運用の三つの仕様の関係。Todd Rosedahl、David Heinrich、Dirk Blevins「MHS Modular Plug-and-Play (M-PNP) Workstream Update and Guidelines for Adoption」、OCP APAC Summit 2026、12ページ。原資料。図を拡大する

    図の説明では、FRU Discovery & Boot側が、FPGAの電源状態や、発見・IPブロック設定に使うCSRを参照します。CSR(Control and Status Register)は、制御や状態を読み書きするレジスターです。一方、FPGA側の仕様も、機器の発見手順とJSONの使い方についてFRU Discovery & Bootを参照します。[1]

    つまり、「どんな部品が付いているか」を知る仕組みと、「その部品をどう制御するか」という約束を別々に完成させても、接点が食い違えば動作はそろいません。さらに下段の相互運用仕様が、共通の定義や要求を両方へ与えます。図は、部品情報、制御インターフェース、組み合わせの条件を一緒に設計する必要を示しています。

    まずは一部をファイル化し、残る機種差を見つける

    講演は、従来方式から完全なプラグアンドプレイへ一度に移ると説明していません。中間段階として「Plug & Play Lite」を置き、一部のJSONは事前に組み込むか、実行時に動的に読み込み、ほかの定義はまだコードへ組み込む状態を示しています。最終的な構想では、定義ファイルを実行時に読み込み、基本的な機能を共通のファームウェアで提供する方向です。[1]

    残る課題には、プラットフォームや筐体全体を説明するJSON、LEDの動作方針、筐体の熱に関する要求、情報の作成・読込み・保存方法が挙げられています。個々の部品の情報だけでは、サーバー全体の振る舞いを決め切れないためです。

    採用を検討するときは、どの情報が共通のファイルに移せて、どこに機種固有の処理が残るかを分けると、評価の対象が見えます。たとえば、部品を発見できること、制御対象の情報を解釈できること、筐体の動作条件に従えることは、それぞれ確かめる必要があります。これは仕様の要点から考えられる確認の順序であり、製品の適合性を判定済みという意味ではありません。

    公開されている道具と、まだ目標である段階

    具体的な道具として、OCPの公式GitHubではFRU Packaging Toolが公開されています。READMEは、M-PNP.FRU_Discovery_Boot 0.5に従い、EEPROMなどへ書き込むFRUイメージを生成するツールと説明しています。IPMI形式とDMTF形式のFRU情報を組み合わせたイメージを作るもので、サーバー全体のプラグアンドプレイ動作を単独で保証するものではありません。[3]

    2026年10月8日に確認したOCP公式の仕様一覧は、M-PnP v0.5 Release Packageを掲載しています。パッケージ内の文書には個別の版があり、FRU Discovery & BootとHPM FPGAは0.5.0 RC2、Interoperability Design Specは0.3.0と案内されています。束の版と、収録文書の版を分けて確認することが大切です。[2]

    一方、8月の講演資料は0.7を2026年9月の目標、0.9をGlobal Summit後の目標として示し、さらに1.0へ進む計画を述べています。目標の月を過ぎたことだけでは、公開や完成を確認したことにはなりません。本稿では、今回確認できた公式一覧の掲載内容と、講演中の開発計画を区別しています。[1]

    M-PNPが取り組むのは、機種ごとの知識を共通の仕組みに渡すための境界です。JSON、発見手順、FPGAの制御、筐体全体の要求がどこでつながるのかを見ると、「差し替えられるハードウェア」を「管理して動かせるシステム」へ近づけるための作業が見えてきます。

    参考資料

    2026年10月8日確認。講演資料と公式の公開案内を対象とし、仕様適合試験や実機の相互運用試験は行っていません。

    [1]Todd Rosedahl、David Heinrich、Dirk Blevins「MHS Modular Plug-and-Play (M-PNP) Workstream Update and Guidelines for Adoption」、OCP APAC Summit 2026、全17ページ。自己記述と段階は4〜7ページ、仕様群は8〜12ページ、計画・課題・ツールは13〜15ページ。公式発表一覧。

    [2]Open Compute Project「DC-MHS Specs and Designs」。M-PnP v0.5 Release Packageと収録文書の版、FRU Packaging Toolの案内。

    [3]Open Compute Project「OCP-SVR-MHS-M-PNP_FRUTool」、README。FRUイメージ生成ツールの対象と対応仕様。
  • ASPEEDが示すCaliptra、BMCの起動・更新・復旧をどう守るか

    ASPEEDが示すCaliptra、BMCの起動・更新・復旧をどう守るか

    サーバーの状態を見守り、離れた場所から管理するBMC。そのBMC自身が、正しいファームウェアで動いているかを確かめるには、どこを信頼の起点にすればよいのでしょう。起動するソフトウェアに、自分の正しさをすべて任せるわけにはいきません。

    ASPEEDのChiawei Wang氏とNeal Liu氏は、2026年8月のOCP APAC Summitで、Caliptraを組み込んだ管理用半導体の構成を紹介しました。資料は、起動時の検証から、更新、古い版への巻き戻し防止、復旧までをつなげています。[1]

    簡単にまとめると?

    • BMCの信頼を支えるには、起動するコードを段階ごとに検証し、次の処理へ引き渡す仕組みが必要です。
    • 更新データの署名確認と、古い版へ戻さないための確認は役割が異なり、復旧用のコードにも検証が必要です。
    • AST2700とAST1080は同じ用途のチップではありません。Caliptraの版や組込み方も分けて読む必要があります。

    起動する側より先に、確かめる側を動かす

    Caliptraは、半導体に組み込むRoot of Trust(信頼の起点)の仕組みです。ASPEEDの構成図では、ROMや記憶領域を土台に、iRoTと呼ぶ内部の信頼基盤、その中で暗号処理や検証を担うCaliptraが描かれています。BMCの通常の仕事と、起動や更新を確かめる仕事を分けた構成として読むことができます。[1]

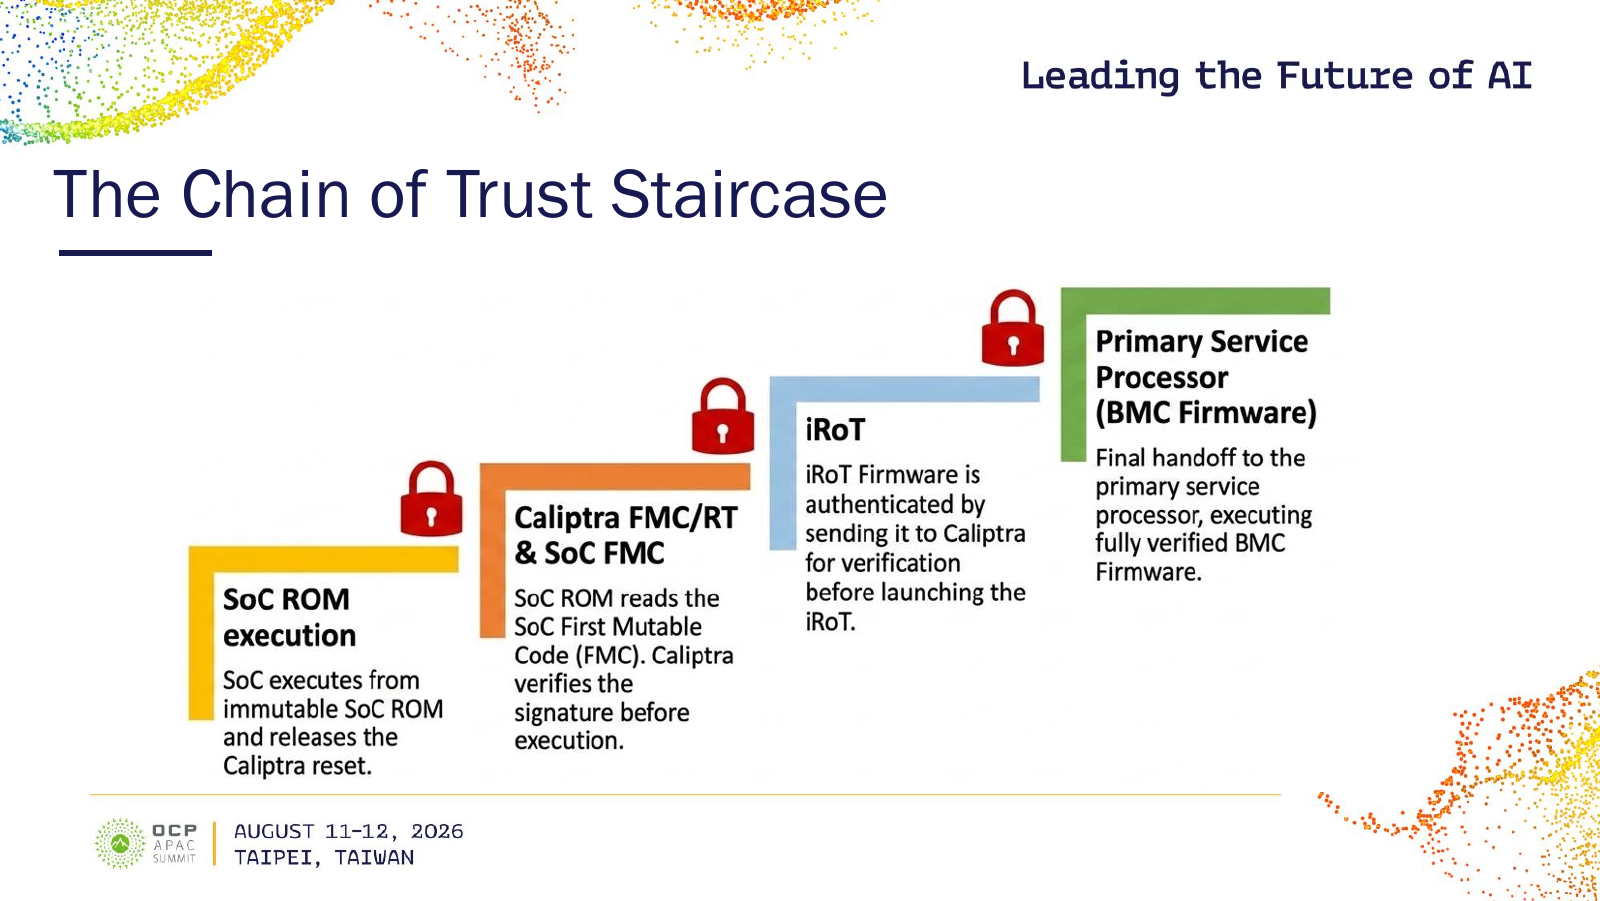
    起動の順序を示すのが図1です。最初に、書き換えられないSoCのROMから処理を始め、Caliptraのリセットを解除します。続いて、SoCで最初に書き換え可能なコードであるFMC(First Mutable Code)を読み、実行前に署名を検証する流れです。iRoTのファームウェアもCaliptraへ送って確認してから起動し、最後にBMCの通常の処理へ渡します。[1]

    図の階段は、チップの物理的な積層ではなく、検証しながら処理を引き渡す順序を表しています。最初の段階から次の段階を確かめ、その先へ信頼をつなぐ考え方です。

    SoCのROM、CaliptraとSoCの最初の書換え可能コード、iRoT、BMCファームウェアの順に、実行前の検証を経て処理を渡す四段階を示すASPEEDの図。物理的な積層ではなく起動の順序を表す。
    図1 ROMからBMCファームウェアへ、検証を経て処理を渡す順序。Chiawei Wang、Neal Liu(ASPEED Technology)「Caliptra Silicon Root of Trust in BMC SoCs」、OCP APAC Summit、2026年8月、p.6「The Chain of Trust Staircase」。原資料/図を拡大する

    署名が正しいことと、使ってよい版であること

    動き始めた後の更新にも、確認する場所が要ります。資料の更新フローでは、外部から届いたファームウェアを、まず隔離したDRAMの一時領域へ置きます。登録された公開鍵情報に基づく署名検証を経て、認められた内容をSPIフラッシュへ書く構成です。ネットワークから受け取ることと、起動に使う記憶領域へ書き込むことの間に、検証の段階を置いています。[1]

    ただし、署名が正しいだけでは、古い脆弱な版へ戻される問題は防げません。過去に正規の提供元が署名したファームウェアでも、現在の運用で受け入れてよいとは限らないためです。

    ASPEEDの資料は、OTPという一度の書込みを前提にした領域に支えられたSVN(Security Version Number)を使い、必要な値に届かないイメージを拒否する方式を説明しています。署名によって出所と内容を確かめる役割と、受け入れるセキュリティ上の版を制限する役割を組み合わせています。[1]

    外へ示す測定結果と、復旧するときの検証

    起動を認める判断とは別に、機器の状態を外部へ示す仕組みもあります。資料の遠隔証明の図では、外部ホストからのSPDM要求に対し、Caliptra側が測定値を扱い、暗号学的に署名した応答を返します。SPDMは、機器どうしが識別情報や測定情報をやり取りするための仕組みです。[1]

    ここで区別したいのは、コードの実行を認めることと、測定した状態を相手へ示すことです。署名された測定結果が得られても、その後のあらゆる動作や設定変更が安全だと証明されたわけではありません。今回のスライドには、運用中の全状態を網羅した検証結果は示されていません。

    通常の起動へ進めない場合に備えるのが、復旧の経路です。資料では、SoCのROMが復旧状態を検知し、外部ホストから復旧用ファームウェアを受け取ります。その署名を実行前に確認し、復旧用の処理から通常のA/Bイメージを戻す流れになっています。復旧のためだから確認を省くのではなく、戻すためのコードも確かめる設計です。[1]

    AST2700とAST1080は、役割を分けて読む

    発表は二つの製品を並べていますが、AST2700はサーバー管理用のBMC SoC、AST1080はPRoT(Platform Root of Trust、プラットフォームの信頼の起点)を担うSoCです。公式製品ページもこの用途を分けており、AST1080をAST2700と同じBMCとして扱うと構成を読み違えます。[2][3]

    講演資料の比較表では、AST2700のCaliptra IPは1.2で、BootMCUがCaliptraブロックへの主な仲介を担います。AST1080は2.1で、Subsystem方式を組み込み、iRoTがCaliptraのSSMCU上で動くと説明されています。同じCaliptraという名前でも、採用する版と周辺の制御構成は同一ではありません。[1]

    これらは2026年8月の発表で示された構成です。資料には攻撃への耐性試験の成功率、起動の所要時間、復旧時間を比較できる実測値はありません。「信頼の起点を搭載した」という情報から、どの製品でも同じ保護範囲や運用結果が得られるとは判断できません。

    BMCのセキュリティを見るときは、採用チップ名だけでなく、起動のどの段階を誰が確かめるか、更新をどこで止められるか、復旧用のコードをどう認めるかまで追うと、設計の役割が見えてきます。ASPEEDの発表は、その受け渡しを一つの管理用半導体の構成として読むための材料です。

    ASPEEDの事業を知る

    サーバー管理向け半導体を手がけるASPEEDの事業全体は、Cyclewaveの企業解説で紹介しています。

    参考資料

    1. Chiawei Wang、Neal Liu(ASPEED Technology)「Caliptra Silicon Root of Trust in BMC SoCs」、2026年8月、全16ページ。構成と起動はpp.4–6、遠隔証明・更新・版戻し防止・復旧はpp.7–10、製品の比較はp.12。OCP公式の資料一覧。講演音声・質疑は対象に含めていません。
    2. ASPEED「AST2700」公式製品情報。サーバー管理用プロセッサーとしての位置づけとCaliptraの採用。2026年10月7日確認。
    3. ASPEED「AST1080 PRoT」公式製品情報。PRoT向けSoCとしての位置づけ。2026年10月7日確認。
  • MicrosoftとNexthop AIが示すSONiC BMC、液冷漏れの監視と停止

    MicrosoftとNexthop AIが示すSONiC BMC、液冷漏れの監視と停止

    液冷のネットワークスイッチでは、冷却液を流す仕組みに加えて、漏れたときに誰が気づき、どこを止めるかも設計する必要があります。通信を制御する主CPUを停止したあとも、監視や遠隔操作の経路を残せるかが大切になります。

    2026年8月のOCP APAC SummitでGuohan Lu氏(Microsoft)とRyan Torres氏(Nexthop AI)が紹介したのは、機器の状態監視と遠隔管理を担うBMC(Baseboard Management Controller)でSONiCを動かす構成です。液漏れの程度や検知した場所に応じて、通知、主系の電源停止、ラック側との連携を分けています。[1]

    簡単にまとめると?

    • SONiC BMCは主CPUと監視・管理を分け、主系を止めた後も液漏れへの対応経路を残す設計です。
    • 漏れの重大度や場所に応じて、通知、主系の停止、ラック側や担当者との連携を使い分けます。
    • 発表は対応構成と展開計画を示すもので、停止のしきい値や全機種への対応、無停止運用を保証していません。

    主CPUを止めても、監視する側を残す

    BMCは、主CPUとは別の管理用プロセッサーです。資料では、主CPUの動作状態によらずBMCを動かし、液漏れセンサーを監視する設計が示されています。ここでいう常時監視は、主系と監視系の動作を分ける考え方であり、機器への給電が失われても動き続けるという意味ではありません。[1]

    スイッチ側の要件には、BMCから主系の電源を入れ直せること、BMC自身の再起動が主CPU側へ影響しないこと、管理ポートをBMCへ接続することが挙げられています。BMCと主CPUの間には、USBを使ったEthernetの管理通信経路を設けます。通信を転送する回路と、それを外側から管理する回路を分ける構成です。[1]

    軽微な漏れと重大な漏れで、対応を分ける

    漏れを検知したら、すべて同じ動作にするわけではありません。資料は、異なる重大度のセンサーを複数備えることに加え、センサー自身が正常かを確認すること、検知後の対応方針を決めることを要件にしています。[1]

    スイッチ内の軽微な漏れの例では、BMCがSyslogというログ通知を送り、担当者が機器を点検します。この図には、主系の自動停止は示されていません。一方、重大な漏れの例では、通知とともにスイッチの主系を電源停止し、担当者が隔離と点検に向かう流れです。[1]

    重大な漏れの図には、リンク切断を検知したあとに通信を別経路へ移す動作も描かれています。ただし、これは発表が示す対応の構成例です。通信の切り替え時間や、切り替え先の容量、無停止で運用できることを実証した数値は示されていません。[1]

    ラック側の異常も、同じ管理経路へつなぐ

    漏れがスイッチ内ではなく、ラック側で見つかる場合もあります。資料の構成では、ラック全体を管理するラックマネージャーとBMCが、機器管理用の標準インターフェースRedfishで連携します。ラック側の異常を、スイッチを止める判断へつなげるためです。[1]

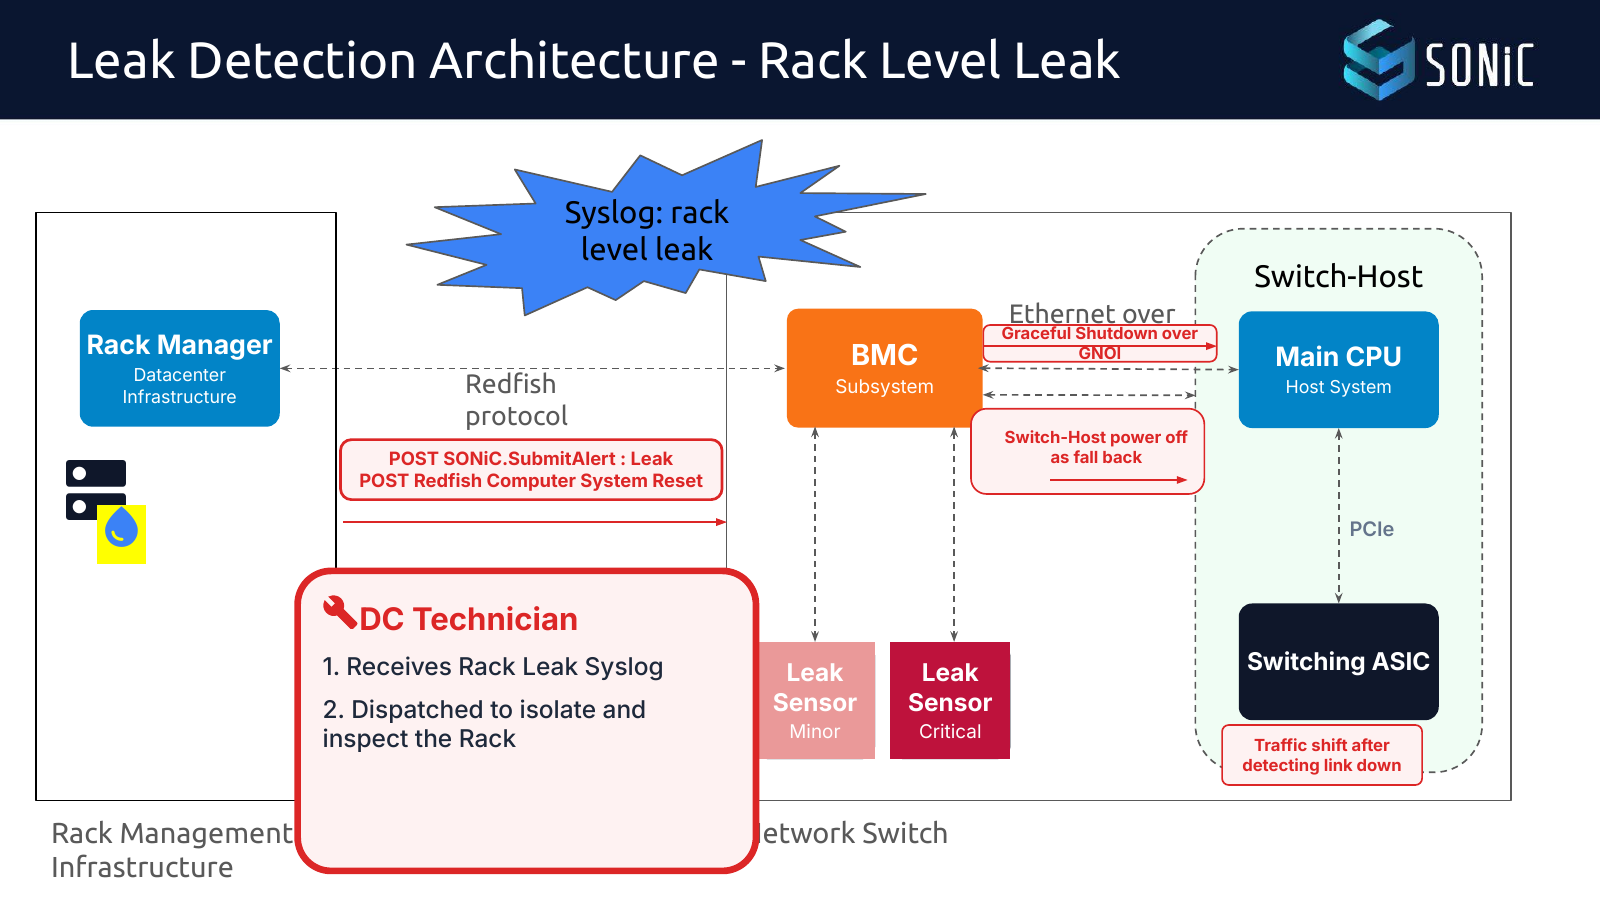
    ラック側の液漏れの例では、ラックマネージャーからBMCへ通知と停止要求が送られます。BMCは、運用操作を伝えるgNOIを使って主系へ正常な終了処理を求め、代替手段として主系の電源停止も備えます。同時に担当者へ知らせ、ラックの隔離と点検につなげます。[1]

    図1では、左側のラックマネージャーから中央のBMCへ、漏れの通知と停止要求が送られています。BMCから右側の主CPUへ向かう赤い経路は、gNOIによる正常な終了処理と、代替手段としての電源停止です。下部には担当者によるラックの隔離・点検と、リンク切断後の通信切り替えも並んでいます。機器の停止だけで完結せず、人とネットワーク側の対応までつなぐ構成です。

    ラックマネージャーがRedfishでBMCへ漏れを通知し停止を要求する構成図。BMCは主CPUへgNOIによる終了処理を求め、代替として主系の電源を切る。Syslog通知を受けた担当者のラック隔離・点検と、リンク切断後の通信切り替えも示す。具体的なしきい値・待ち時間は記載されていない。
    図1 ラック側の漏れを検知したあとの通知と停止経路(原図引用)
    Guohan Lu(Microsoft)、Ryan Torres(Nexthop AI)「SONiC BMC for Liquid-Cooled Switches」、2026年8月、p.20。講演資料[1]。
    図は横にスクロールできます。図の画像を開く

    この設計でそろえようとしているのは、センサーの検知から、人への通知、機器の停止までの受け渡しです。軽微と重大を分ける具体的なしきい値や、終了処理をどれだけ待つかは、今回のスライドには示されていません。図の流れと、個々の設備で決める運用条件を分けて読む必要があります。

    BMCでもSONiCを使う理由

    SONiCはネットワークスイッチ向けのOSです。BMC側でも同じソフトウェア基盤を使う狙いは、コンテナの管理、ソフトウェア更新、脆弱性への対応といった運用方法をそろえることにあります。ただし、主系とまったく同じ機能をBMCへ載せるわけではありません。[1]

    BMC側では、データベースや監視情報を扱う機能の一部を動かし、パケット転送用ASICを制御するsyncdやswssは動かしません。機器を監視するpmonコンテナには、液漏れやラックマネージャーの指示に応じて電源を制御するbmcctldを追加し、Redfish用のコンテナも設けます。BMCが引き受けるのは、通信を転送する主系を管理する役割です。[1]

    初期対応と、これからの機種展開を分ける

    資料が示すBMCのハードウェア要件は、ARM64、4GBのDDR5メモリー、8GB以上のeMMCストレージ、セキュアブートなどです。ソフトウェアの使用量としては、イメージ750MB、ディスク1.5GB、メモリー1GB未満が記載されています。後者は紹介された構成の使用量であり、搭載メモリーの要件を1GB未満へ置き換えるものではありません。[1]

    初期実装の範囲も具体的です。ロードマップの「202605」には、BMC向けチップであるAST2720のA1/A2対応と、sonic-aspeed-arm64.binという専用イメージ、Redfishが挙げられています。一方、空冷・液冷の最初のプラットフォーム対応は「202611」の項目です。これは2026年8月の発表時点の計画で、あらゆるBMCや液冷スイッチがすでに対応しているという説明ではありません。[1]

    液冷を運用へ入れるには、冷やす能力とともに、異常を見つけたあとに動く仕組みが必要です。SONiC BMCの取り組みは、主系から分けた監視と管理を土台に、漏れの重大度や場所に応じた対応を組み立てるものです。対応機種と運用条件を確かめながら、設備側とネットワーク側の管理をつなぐ設計として見ることができます。

    共同発表者が所属するMicrosoftの事業全体は、cyclewaveの企業解説にまとめています。

    BMC向け半導体を手がけるASPEEDの事業は、cyclewaveの企業解説で紹介しています。

    参考資料

    [1]Guohan Lu(Microsoft)、Ryan Torres(Nexthop AI)「SONiC BMC for Liquid-Cooled Switches」。2026年8月の公開スライド、全25ページ。7–14ページ:BMCの要件とSONiCの構成、15–20ページ:軽微・重大・ラック側の液漏れへの対応例、21–22ページ:使用量とロードマップ。本文は公開スライドに基づき、録画は未視聴です。

    [2]Open Compute Project「2026 OCP APAC Summit」。開催日、登壇者、公式公開資料の一覧。