タグ: HTTP

  • HTTP 429とRetry-After、待ち時間と再送の安全性を分けて考える

    HTTP 429とRetry-After、待ち時間と再送の安全性を分けて考える

    APIから429 Too Many Requestsが返ってきたとき、同じ要求をすぐ送り直すと、制限された理由を自分で増やしてしまうことがあります。一方、指定された時間だけ待てば、次は必ず成功するという意味でもありません。HTTPのRetry-Afterが伝える待ち時間と、再送してよいかという判断を分けると、回復処理を組み立てやすくなります。

    簡単にまとめると?

    • 429は、一定時間内の要求が多すぎることを表します。誰を単位に、どの範囲を数えるかまでは、この番号だけでは分かりません。
    • Retry-Afterは、応答を受け取ってから待つ秒数、またはHTTP形式の日時を伝えます。429への付与は任意なので、ない場合もあります。
    • 待機期限と、再送による二重処理の防止は別々に確認します。待ち終わったことは、成功や再送の安全性の保証ではありません。

    429から分かること、分からないこと

    RFC 6585で定義される429は、利用者が一定の時間内に送り過ぎた要求を制限する、レート制限の状態を表します。ただし、その利用者をどう識別するか、要求をどの範囲で数えるかは固定されていません。認証情報などで利用者を区別し、一つの対象、サーバー全体、複数のサーバーをまたぐ範囲などで数える設計があり得ます。

    このため、あるAPIへの429を見て、同じ認証情報を使う別の処理が無関係だと決めつけることはできません。逆に、すべての処理を一律に止める必要があるとも限りません。応答本文や、そのサービスの仕様から制限の単位を確認することが先になります。RFCは、応答内容に状態の説明を含めることを推奨しています。

    また、429にRetry-Afterを付けることは可能ですが、必須ではありません。ヘッダーがなければ「待ち時間ゼロ」とは解釈せず、サービスが定めた再試行規則や、実装側の回数・時間の上限へ戻ります。RFC 6585では429の応答をキャッシュに保存してはならないとも定めています。通常の応答キャッシュと、クライアント内部で待機期限を記録する制御は分けて考えます。

    秒数と日時では、待ち時間の求め方が違う

    RFC 9110のRetry-Afterには二つの形式があります。Retry-After: 120なら、応答を受け取ってから120秒待つ指定です。数値は、秒を表す0以上の十進整数です。日時形式なら、たとえばRetry-After: Fri, 23 Oct 2026 01:02:00 GMTのように、待機先の日時が示されます。

    説明用に、応答を受け取った日時を2026年10月23日1時0分30秒GMTとします。秒数120なら待機先は1時2分30秒です。同じ受信時点に、日時形式で1時2分0秒が示されていたら、差は90秒になります。ここでGMTの表示を日本時間として読み替えると9時間ずれるため、タイムゾーンを含めて解釈する必要があります。
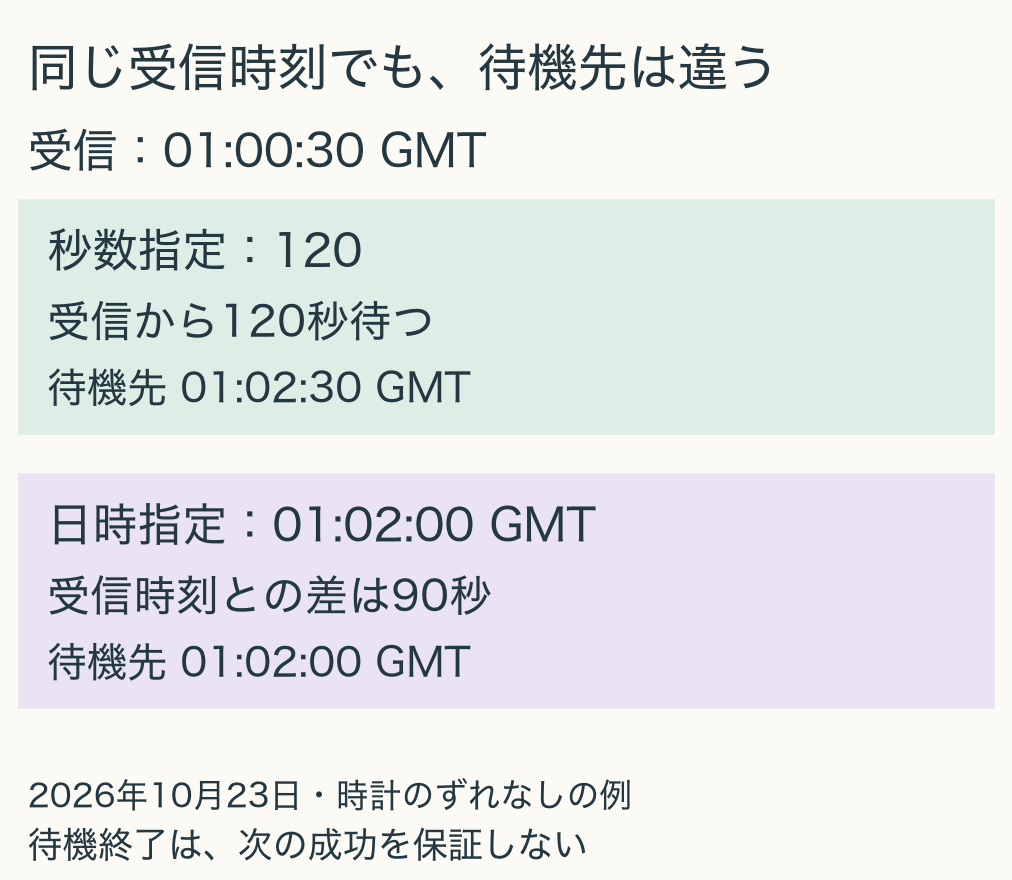
    受信時刻が1時0分30秒GMTの例。Retry-Afterが120なら待機120秒、日時指定が1時2分0秒GMTなら待機90秒。成功は保証されない。
    二つの形式を同じ受信時点で比較した計算例。日時形式では、比較に使う時計が合っていることを仮定している。

    日時形式では、受信側の時計のずれが差分に影響します。過去の日時、壊れた値、非常に長い待ち時間をどう扱うかは、サービスの規則と処理全体の締切を踏まえて決めます。たとえば、全体の残り時間が60秒しかないのに90秒の待機が必要なら、その処理の中で再送する余裕はありません。「制限を無視して60秒後に送る」こととは区別し、後続の実行へ延期するか、回復できない結果として返す設計になります。

    みんなが同時に再開すると、再び集中する

    待ち時間を守るだけでも、即座の再送より要求の集中を抑えられます。しかし、同じ時刻に失敗した多数のクライアントが同じ秒数を待てば、再開時刻もそろいます。これは、待機が正しいかと、再開が分散されるかが別であることを示します。

    ここから先はHTTP仕様が一律に定めるアルゴリズムではなく、実装上の選択です。たとえば、サービスが示す待機を短縮しない範囲で追加の小さな遅延をばらつかせる方法や、繰り返す失敗に応じて待ちを延ばす方法が考えられます。追加遅延はジッターと呼ばれます。いずれも、試行回数、待機の上限、処理全体の締切を決めておかないと、利用者に結果を返せないまま処理を続けてしまいます。

    たとえば120秒の待機指示に対して、三つの処理が追加で0秒・2秒・5秒待つ設計なら、再開候補は受信後120秒・122秒・125秒です。これは集中をずらす考え方の例であり、推奨する固定値や、制限を確実に解除する処方ではありません。共有する制限枠やサービスの負荷が変われば、再び429になる可能性があります。

    待ってよいことと、同じ操作を送り直してよいこと

    再試行では、待ち時間だけでなく、元の操作の性質を見ます。同じ要求を繰り返したとき、意図したサーバー側の効果が一回と同じである性質を、冪等性(べきとうせい)と呼びます。RFC 9110は、応答を読む前に通信が途切れた場合などの再試行で、この性質を区別しています。

    たとえば情報を取得するGETと、新しい処理を作るためのPOSTを、同じ再送規則へ無条件にまとめることはできません。特に応答が一切受け取れなかった場合、処理が適用されなかったのか、適用後に応答だけ失われたのかは別問題です。待つ時間を延ばしても、この不確実性はなくなりません。

    RFC 9110は、非冪等なメソッドを自動再送する場合、実際の意味が冪等であると分かる仕組みや、元の要求が適用されていないと分かる手段が必要だとしています。サービスが提供する重複防止の仕組みや、処理結果を照会できる識別子は、そのサービスの仕様に沿って利用します。単に独自の識別子を付ければ、相手が重複を防いでくれるわけではありません。

    実装では三つの判断を分けて記録する

    最初は「制限の対象」です。どの認証情報や要求範囲が制限されているかを調べ、共有する処理にも待機を反映する必要があるかを判断します。次は「待機先」です。秒数と日時を正しく読み、受信時点や締切と対応付けます。最後は「再送の可否」です。対象の操作を重ねてもよいか、前の結果を確認する必要があるかを決めます。

    この三つを分ければ、待機期限を過ぎても送り直さない理由や、別の独立した処理は続けられる理由を説明できます。Retry-Afterは、いつ次の要求を考えるかを助ける情報です。どの要求を、何回まで、どの条件で繰り返すかは、それと合わせて設計する必要があります。

    出典・参考資料

    • RFC 6585 — Additional HTTP Status Codes(2012年4月)、第4節:429の意味、識別・計数範囲、Retry-Afterの任意性、キャッシュの扱い。
    • RFC 9110 — HTTP Semantics(2022年6月)、第10.2.3節:Retry-Afterの二つの形式、第9.2.2節:冪等性と再試行。待機時間の数値例と追加遅延の例は、本稿の説明用条件で計算。
  • HTTPのRangeとIf-Range、途中からの取得で別の版を混ぜないために

    HTTPのRangeとIf-Range、途中からの取得で別の版を混ぜないために

    ダウンロードが途中で切れたとき、すでに受け取った分を残し、続きだけを取得できれば通信量を減らせます。ただし、同じURLに置かれた内容が再開までに更新されていたらどうなるでしょうか。前半は古い版、後半は新しい版という、どちらにも存在しない内容を作ってしまう可能性があります。HTTPのRangeとIf-Rangeは、取得する位置と、つなぎ合わせてよい版を分けて考えるための仕組みです。[1]

    簡単にまとめると?

    • Rangeは、選択された表現の一部分を要求します。バイト位置はゼロから数え、終端も範囲に含みます。
    • 続きの位置が合っていても、前半と後半の版が同じとは限りません。長さだけの確認では更新を見落とします。
    • 強いETagを使ったIf-Rangeが一致しなければ、サーバーはRangeを無視します。通常の全体応答を受けた側は、古い断片への追記ではなく置き換えを判断します。
    • 部分取得への対応は保証ではありません。206・200・416とContent-Rangeを確認し、実際に返った範囲を扱います。

    「400バイト目から」は、どの内容の400バイト目か

    HTTPでいう表現は、ある資源を特定の形式で表したデータです。同じURLでも、更新時刻や要求の条件によって返る表現が変わることがあります。Rangeは、その選択された表現の一部分だけを送るよう要求するフィールドです。本稿では、GETで一つの連続したバイト範囲を要求する場合に絞ります。

    全体が1,000バイトで、先頭の400バイトを保存済みなら、保存した位置は0から399です。残りは400から999なので、要求はRange: bytes=400-999と書けます。終端を含むため、長さは999−400+1で600バイトです。[1、14.1.2節] この位置計算が正しくても、再開先が同じ版かどうかは別の問題として残ります。

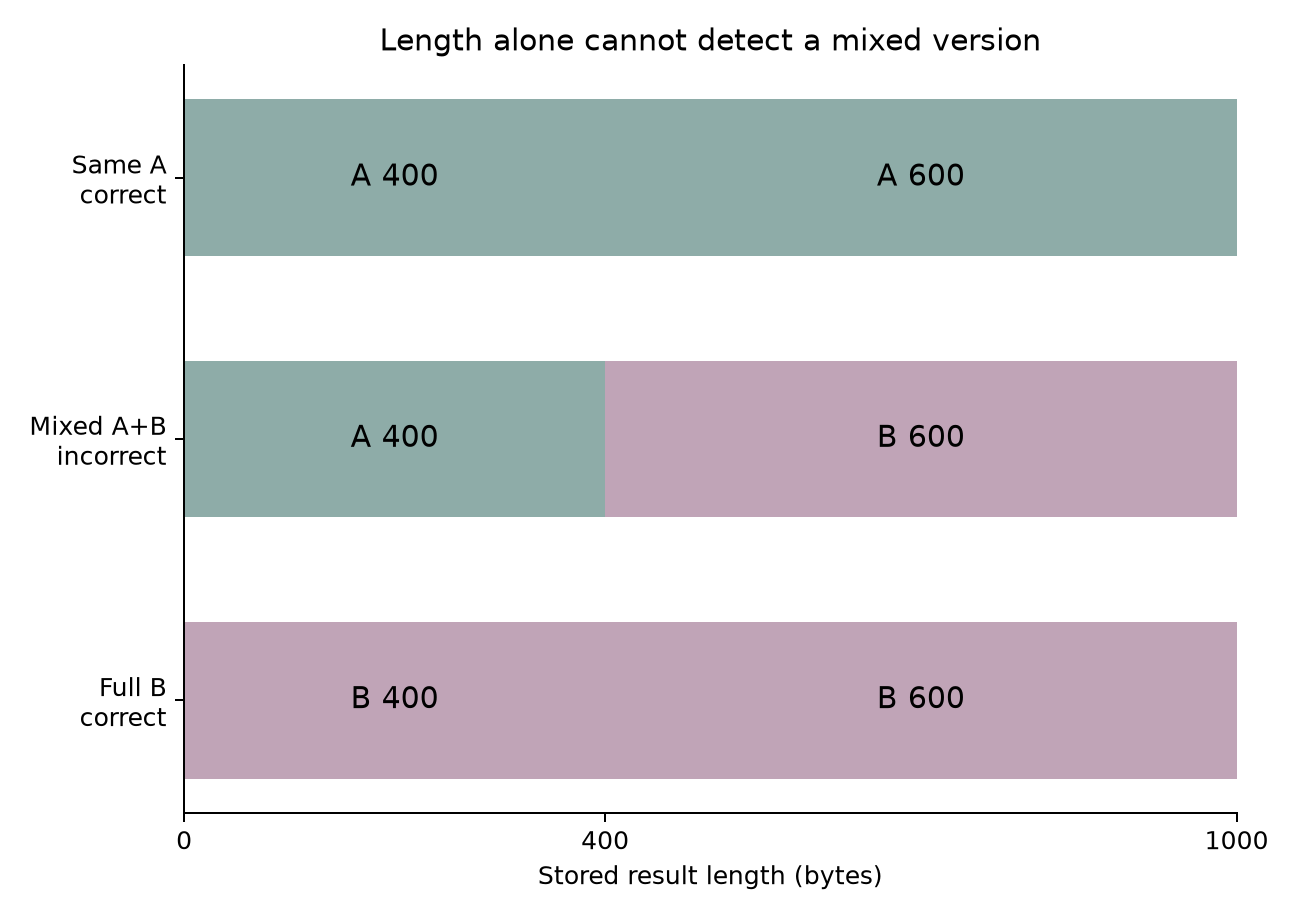
    たとえば、古い版Aも新しい版Bも1,000バイトだったとします。途中で内容だけが変わった場合、Aの先頭400バイトへBの残り600バイトを追加すれば、長さは正しく1,000になります。しかし、それだけではAともBとも一致しません。「予定の容量まで届いた」という確認は、同じ版の完成を意味しないのです。

    同じ長さでも、つなぎ合わせた結果が違う

    この違いを独自のバイト列モデルで確かめます。位置iに対して、版Aはi mod 251、版Bは(i+17) mod 251という値を入れ、それぞれ1,000バイトを作りました。ここでmodは割った余りです。実在ファイルの測定ではなく、版の混在を見えるようにした説明用のデータです。

    Aの先頭400バイトとAの残り600バイトを連結すれば、元のAと全バイトが一致します。一方、Aの先頭400バイトとBの残り600バイトを連結すると、長さは1,000のままでも、AにもBにも一致しません。計算ではバイト列そのものの比較とSHA-256の比較を行い、この三つを区別しました。以下の図の「正しい」は、対象にした版の全体と一致するという意味です。

    独自の1,000バイトモデル。同じ版Aの先頭400と残り600はAへ復元できる。Aの先頭400と版Bの残り600は長さ1,000でも混在する。版が変わった際にBの全体1,000を受け直すとBと一致する。
    位置と全体長だけでは版の一致を判定できない。図はバイト列の連結モデルであり、HTTPサーバーの動作試験や転送速度の測定ではない。

    この例では、同じ版を再開できれば新しく受け取るデータ本体は600バイトです。版が変わり、全体を受け直すなら1,000バイトになります。ここで比較しているのはデータ本体の長さだけで、ヘッダー、暗号化の付加情報、再送、圧縮や通信時間は含みません。少ない転送量と、正しい版の完成は、同じ判断ではありません。

    If-Rangeは、版が違うときにRangeを外す

    そこで、最初の応答で得た強いETagを保存しておきます。ETagはサーバーが表現へ付ける検証用の値で、ファイルの内容を利用者が勝手に推測して作る名前ではありません。ここでは版Aの値を"version-A"とした説明例を使います。再開時にRangeと併せてIf-Range: "version-A"を送ると、その検証値が現在の表現と一致する場合に範囲要求を扱う条件を付けられます。[1、13.1.5節]

    現在もAで、サーバーが範囲要求を処理できるなら、残りを206 Partial Contentで受け取る流れになります。現在がBへ変わっていて検証値が一致しなければ、サーバーはRangeを無視しなければなりません。ほかに条件がなく通常のGETが成功する例では、B全体を200 OKで返すことになります。If-Rangeの不一致それ自体を、必ず412で止める仕組みとして読むのは誤りです。

    受信側にも分岐が必要です。206で期待する範囲と同じ強い検証値を確認できたときは、保存済みの断片と結合できます。200で全体が返ったときに、その全体を古い400バイトの後ろへ機械的に追加してはいけません。この例なら、Aの断片を採用せず、返されたB全体を新しい結果として扱います。RFCは複数の部分応答を結合する際、同じ強い検証値を共有することを求めています。[1、15.3.7.3節]

    W/を伴う弱いETagは、If-Rangeへ指定できません。内容が意味の上では同等でも、バイト単位でそのまま接続できる保証とは違うためです。If-Rangeには日付を使う形式もありますが、利用できる条件が別にあるため、ここでは強いETagを保持する方式だけを扱います。

    応答コードと範囲を、セットで確認する

    一つの範囲を返す206では、Content-Range: bytes 400-999/1000のように、返した位置と全体長を示します。この例でContent-Lengthが600なら、それは今回の応答本体の長さであり、元の表現全体が600バイトという意味ではありません。要求した範囲を送ったはずだと思い込まず、返されたフィールドと保存位置を照合します。[1、14.4節・15.3.7節]

    一方、サーバーはRangeを無視することもできます。Accept-Ranges: bytesという案内を以前に受け取っていても、将来のすべての要求へ部分応答を約束するわけではありません。この案内がなくても範囲要求はできますが、どちらの場合も206だけを前提に実装しないことが大切です。[1、14.2節・14.3節]

    指定した範囲が現在の表現に存在しないときなどには、416 Range Not Satisfiableが返ることがあります。現在の長さが1,000なら、Content-Range: bytes */1000によってその長さが示される場合があります。ただし、416だけで「保存したデータは完成している」と結論してはいけません。保存断片の版と位置を調べ直す必要があります。また、Rangeを無視して200を返す実装もあるため、範囲外なら必ず416になるという保証でもありません。[1、15.5.17節]

    圧縮や更新の条件まで揃えて再開を判断する

    ここまでのモデルは、圧縮などの内容符号化を使わず、取得中には版が変わらない場合を一回ずつ比較しました。実際に内容符号化が施された表現では、バイト範囲は符号化後のバイト列を対象とします。展開したファイルの400バイト目を、圧縮された転送内容の400バイト目へそのまま読み替えることはできません。[1、14.1.2節]

    再開機能を評価するときは、取得した位置だけでなく、保存した表現の検証値、符号化の条件、返ってきた応答コードとContent-Rangeを確認します。更新された全体へ置き換える分岐、範囲が利用できない場合の再取得、検証値を失った場合の扱いも必要です。Rangeは通信量を減らせる道具ですが、「同じ版の続きだと確認できる条件」を併せて持つことで、部分取得を正しい完成につなげられます。

    出典

    1. RFC 9110「HTTP Semantics」、2022年6月、STD 97。13.1.5 If-Range、14.1.2 Byte Ranges、14.2 Range、14.3 Accept-Ranges、14.4 Content-Range、15.3.7 Partial Content、15.3.7.3 Combining Parts、15.5.17 Range Not Satisfiable。公式本文。数値例・バイト列の比較・図はQuantum Sea独自のモデル。複数範囲のmultipart応答、実サーバーの実装検証、速度測定は本稿の対象外。
  • HTTPのVary、同じURLの応答を取り違えないための照合条件

    HTTPのVary、同じURLの応答を取り違えないための照合条件

    同じURLへアクセスしても、日本語の本文と英語の本文、圧縮した本文と圧縮していない本文が返ることがあります。このとき、キャッシュがURLだけを手がかりに以前の応答を使うと、別の条件で選ばれた内容を渡してしまいかねません。HTTPのVaryは、応答を選ぶ際にどの要求ヘッダーが関係したかを伝え、保存した応答を次の要求へ使えるか判断するための情報です。[1][2]

    簡単にまとめると?

    • Varyは応答側のヘッダーです。そこに列挙するのは、応答の選択に関係する要求側のヘッダー名です。
    • Varyで指定された要求条件が合わなければ、保存済み応答をそのまま再利用できません。新鮮さや保存許可とは別の確認です。
    • 必要な条件を省くと別の表現を返す原因になり、不要な条件を増やすと再利用の機会を減らします。
    • Varyはアクセス制御や秘密保持の設定ではありません。認証、共有保存の可否、表現の選択条件を分けて点検します。

    応答に書くのは、要求側の条件の名前

    たとえば、サーバーが要求のAccept-Languageを見て言語を選び、Accept-Encodingを見て圧縮形式を選んだとします。応答に Vary: Accept-Language, Accept-Encoding を付けると、キャッシュはその二つの要求ヘッダーも照合に使います。Varyへ「日本語」や「gzip」という選択結果を書くのではなく、選択に関係した欄の名前を書く点が大切です。[1、12.5.5節]

    ここでの表現は、同じ対象を利用者へ渡す際の具体的な形です。案内ページという対象は同じでも、言語や符号化が違えば、送るバイト列や応答のメタデータは違います。キャッシュキーとは、保存した応答と新しい要求を対応づけるための手がかりです。Varyは、その照合条件を要求メソッドと対象URI以外にも広げます。

    保存済み応答にVaryがある場合、列挙された要求ヘッダーが、保存のきっかけになった要求と一致しなければ、再検証なしでその応答を使ってはいけません。一致する保存応答がなければ、通常は要求を元のサーバーへ転送します。保存済みの表現を示す条件を付けて問い合わせることもあります。[2、4.1節]

    八回の要求で、条件の不足と増やしすぎを比べる

    小さな独自モデルで違いを見ます。同じGET /guideに、日本語・英語と、gzip・identityを組み合わせた四種類の要求を順に送り、その並びをもう一度繰り返します。identityはこの例では圧縮しない表現を選ぶ指定です。要求の言語欄は単純なjaかenだけ、圧縮欄も単独の値とし、優先度や複数候補は扱いません。

    キャッシュは最初は空で、応答はすべて保存可能かつ新鮮、途中で内容は変わらず、追い出しもないと仮定します。元のサーバーが返す表現を「言語と圧縮形式の組」として表し、要求が期待する組と、実際にキャッシュから受け取った組を比較します。これはキー設計を理解する計算であり、実ブラウザーや配信サービスの性能測定ではありません。

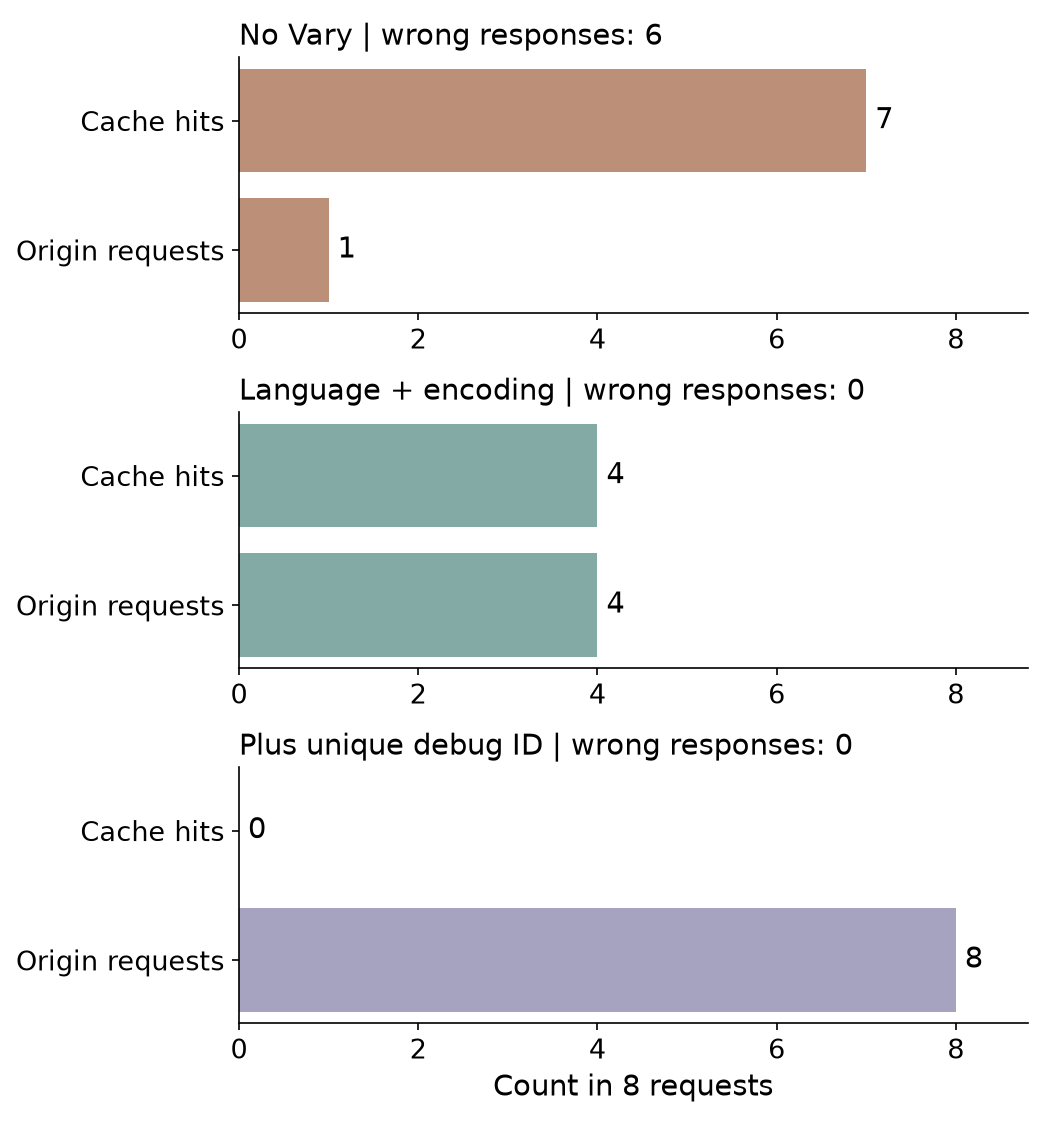
    Varyを省いた場合は、モデルが最初の日本語・gzipの応答を一つだけ保存します。次の七回はすべてキャッシュヒットですが、同じ条件が再び来る一回を除き、六回は要求と違う組を受け取ります。「ヒット率が高い」だけでは、正しく配れたとは判断できない例です。

    言語と圧縮形式を照合する場合は、最初の四回で四種類の応答を取得します。二巡目はそれぞれの保存応答を使えるため、元のサーバーへの要求は四回、キャッシュヒットも四回です。八回とも期待する組になります。

    さらに毎回異なる識別子までVaryに加える場合は、八回とも別のキーになります。この例のX-Debug-Idは、要求ごとに違う文字列を付ける架空の診断用ヘッダーで、本文の選択には使いません。それでもVaryで指定すると、このモデルでは前の応答と一致しなくなり、元のサーバーへ八回要求して、キャッシュヒットはゼロです。表現は正しくても、不要な条件が再利用を妨げます。

    八要求の独自モデル。Varyなしは取得1回・ヒット7回・誤った表現6回。言語と圧縮形式を指定すると取得4回・ヒット4回・誤り0回。毎回違う診断IDも加えると取得8回・ヒット0回・誤り0回。
    同じURLへ四種類の要求を二巡させた説明用モデル。保存応答はすべて新鮮とし、検証通信・容量制限・実際の圧縮量は含めていない。ヒット数だけでなく、正しい表現が返ったかを併せて見る。

    何を同じとみなすかは、ヘッダーの仕様に従う

    現実の照合は、すべてのヘッダーを単純な文字列として比べればよい、というものではありません。RFCは、各欄の構文で許される空白の調整、同名の複数行の結合、意味が同じと分かる正規化を認めています。値の順番を変えてよいか、大文字と小文字を同一視できるかは、そのヘッダーの定義に依存します。何でも並べ替えたり小文字にしたりする規則ではありません。[2、4.1節]

    また、要求にそのヘッダーがなかった場合は、同じく存在しない要求とだけ一致します。「指定なし」を勝手に特定の値へ置き換えると、元のサーバーが使った既定値の選択と食い違う可能性があります。前のモデルが単独の値だけを使ったのは、この問題とキーの数の問題を切り分けるためです。

    Vary: *にも注意が必要です。これは「あらゆる要求に一致する」という印ではなく、要求メッセージの外も含む選択条件が関係し得ることを示します。キャッシュの照合では常に不一致になり、保存応答を適切に使えるかは元のサーバーへ要求を転送しないと判断できません。保存そのものの禁止を意味するno-storeとは役割が異なります。[1][2]

    新しい応答でも、別の要求向けなら使えない

    max-ageのような新鮮さの条件は、「いつまで確認なしで使えるか」を扱います。Varyは「どの要求に対応する応答なのか」を扱います。日本語向けの保存応答がまだ新鮮でも、英語を指定した要求へそのまま使えるとは限りません。逆に要求条件が一致しても、古くなっていれば再検証など別の条件を満たす必要があります。

    設定を点検するときは、まず元のサーバーが実際に何を見て表現を選ぶかを洗い出します。次に、その違いをVaryや別のURL設計へどう反映するかを確認します。最後に、保存許可、新鮮さ、再検証の指示を照合します。期待する本文が同じ二つの要求を別キーへ分けていないか、違う本文が必要な二つの要求を同じキーへまとめていないか、対になるケースを用意すると確認しやすくなります。

    その際、認証や利用者別データをこの比較モデルに安易に含めてはいけません。Varyは、アクセス権の確認や共有キャッシュへの保存禁止の代わりにはなりません。本稿の例は利用者共通の案内ページであり、秘密情報の配信設計を検証したものではありません。実装ごとのキー設定やヘッダーの書換えも含め、最終的に返された本文・言語・符号化と、元のサーバーへ問い合わせた回数を一緒に観測することが必要です。

    出典

    1. RFC 9110「HTTP Semantics」(2022年6月、STD 97)、12.5.5節「Vary」。公式本文
    2. RFC 9111「HTTP Caching」(2022年6月、STD 98)、4.1節「Calculating Cache Keys with the Vary Header Field」、4.2節「Freshness」。公式本文。八要求の件数と比較図は、明示した仮定によるQuantum Seaの独自モデルです。
  • Cache-Control、no-cacheとno-storeで保存と再利用を分ける

    Cache-Control、no-cacheとno-storeで保存と再利用を分ける

    Webページや画像を一度受け取ったら、手元に保存して次の表示に使う。HTTPキャッシュは、この再利用で通信や待ち時間を減らします。ただし、保存しておいてよいことと、保存した内容をそのまま使ってよいことは別です。Cache-Controlのno-cacheとno-storeは、この違いが名前だけでは分かりにくい指示です。

    ここでは、サーバーが返す応答のCache-Controlを扱います。ヘッダー名を引数に取らない通常形を対象に、保存、再利用前の確認、共有キャッシュへの保存という三つの判断を分けます。[1]

    簡単にまとめると?

    • no-cacheは保存そのものを禁止しません。保存した応答を別の要求に使う前に、サーバーへ確認して成功する必要があります。
    • no-storeは、キャッシュへの保存と別の要求への再利用を禁止する指示です。利用者専用・複数利用者で共有するキャッシュの両方に適用されます。
    • must-revalidateが再検証を必須にするのは古くなった後です。まだ新鮮な応答でも確認が必要なno-cacheとは条件が違います。
    • privateは保存先を制限します。これらの指示だけで、ログや履歴も含めた秘密保持・完全削除が保証されるわけではありません。

    no-cacheは「取っておいても、使う前に確認」

    たとえば、案内ページを表示するたびにサーバー側の変更を確認したいとします。一方、内容が変わっていなければ、以前受け取った本文を使っても構いません。この二つを両立できるのが、引数なしのCache-Control: no-cacheです。

    キャッシュは他の保存条件を満たす応答を保存できます。しかし次の要求をその保存済み応答で満たすには、要求を検証のため転送し、成功する必要があります。単に保存時刻が新しいから、という理由で確認を省くことはできません。古い応答を出す設定があっても、この確認条件は残ります。[1、5.2.2.4節]

    検証に使えるETagなどがあれば、条件付きGETで変更の有無を問い合わせられます。内容が変わっていない場合、サーバーは304を返し、キャッシュは適切な保存済み応答を更新して再利用できます。確認の通信は発生しますが、本文を毎回送り直す必要があるとは限りません。ETagは内容の版を見分ける識別子であり、保存を許可する指示そのものではありません。[1、4.3節][2、13.1.2節]

    no-storeは保存済みの本文に頼らない

    Cache-Control: no-storeを応答に指定すると、キャッシュはその直近の要求・応答の一部も保存せず、その応答を別の要求に使ってはいけません。ブラウザーなどの利用者専用キャッシュだけでなく、複数利用者が共有するキャッシュにも適用されます。[1、5.2.2.5節]

    ここでの保存禁止は、情報を意図して不揮発性の記憶装置へ保存しないことと、転送後の揮発性メモリーからできるだけ速やかに取り除く努力をすることを含みます。通信中の一時的なバッファーまで一切存在しない、という意味ではありません。

    先ほどの案内ページをこの指示で返した場合、次の表示で、その応答の保存コピーをHTTPキャッシュから取り出す流れは使えません。以前の本文を保管して検証するno-cacheとは、出発点が違います。画面が同じように再表示されても、保存しているのか、問い合わせたのか、本文を再取得したのかを分けて観測する必要があります。

    10秒後と70秒後で、判断が変わる例

    違いを見るため、時刻0秒に応答を受け取り、他の条件は同じとして、10秒後と70秒後に同じ表現を要求するモデルを考えます。初回の応答の年齢は0秒、ETagがあり、応答は変化していないとします。70秒後だけサーバーに接続できません。実ブラウザーの測定ではなく、指示の条件を比較するための例です。

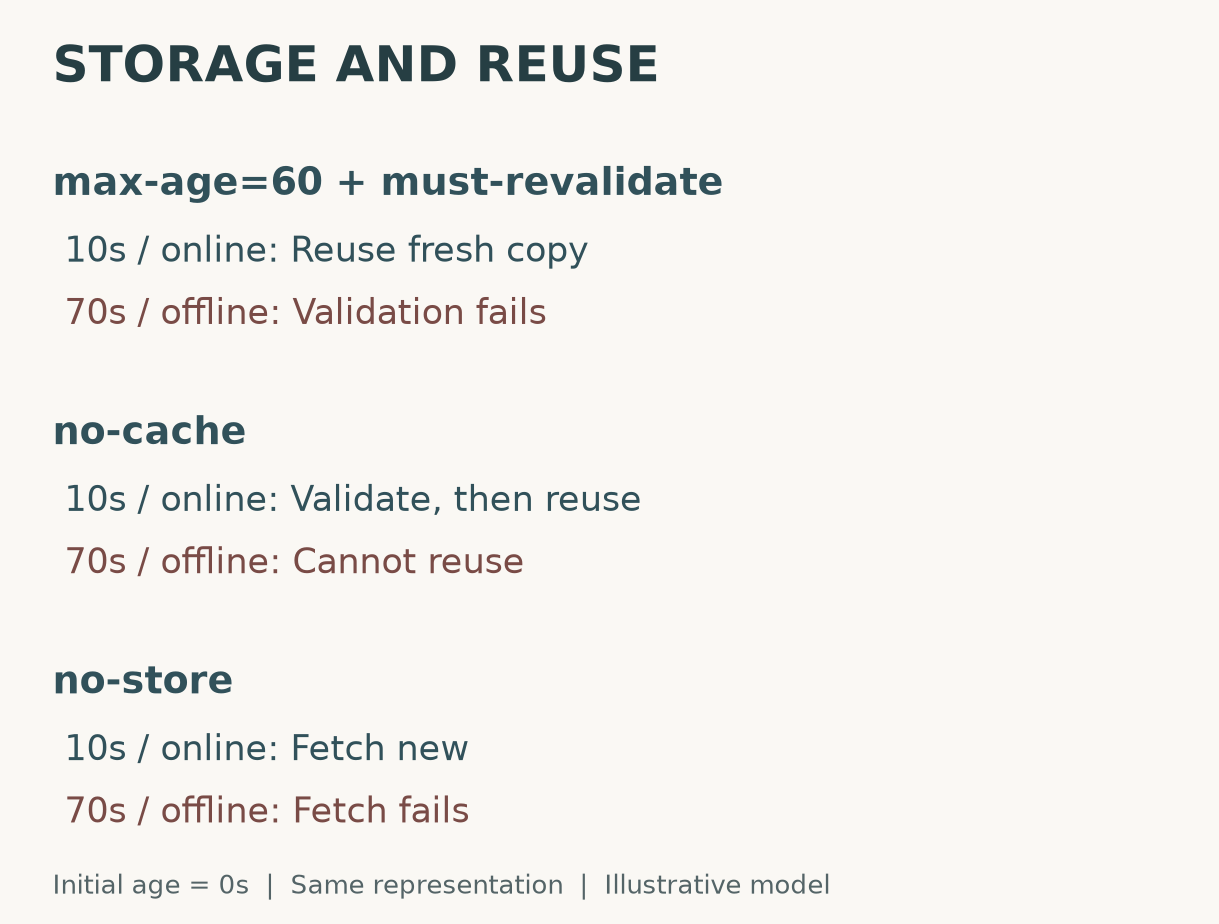
    max-age=60, must-revalidateの場合、10秒後は60秒の新鮮さの期間内なので、ほかの再利用条件も満たせば保存コピーを使えます。70秒後は古くなっており、再検証に成功するまで使えません。接続不能なら古いコピーで代用せず、エラーになります。仕様は、より適切なエラーがなければ504を推奨しています。[1、5.2.2.1〜2節]

    no-cacheでは10秒後でも確認が必要です。このモデルでは検証が成功してから保存コピーを使えます。70秒後は確認できないため、保存済みの応答だけで要求を満たすことはできません。一方、no-storeでは、この応答を後で使うためのキャッシュ保存がありません。10秒後も新しく取得し、70秒後はネットワーク取得が失敗します。似たエラー表示になっても、失敗に至る条件は同じではありません。

    三つの応答方針の独自モデル。max-age60とmust-revalidateは10秒後に保存コピーを使い、70秒後の接続不能時は再検証失敗。no-cacheは10秒後も確認後に再利用し、70秒後は確認できず再利用不可。no-storeは10秒後に新規取得し、70秒後は取得失敗。
    応答の年齢を0秒から数える比較例。ほかの再利用条件を満たすと仮定し、70秒後だけ接続不能とした。実装や通信時間の測定結果ではない。

    privateは、誰のキャッシュへ置けるかを決める

    利用者ごとに内容が違うページでは、鮮度だけでなく保存先の区別も必要です。引数なしのprivateは共有キャッシュによる保存を禁止し、ほかの条件を満たす利用者専用キャッシュには保存を許します。保存後にいつ確認するかは別なので、private, no-cacheなら「共有側には置かず、専用側で保存しても再利用前に確認する」という組合せになります。[1、5.2.2.7節]

    判断する順番は、まず保存してよいか、次にどこへ保存してよいか、最後に確認なしで使える期間があるか、です。内容が個別かどうか、変更確認を毎回求めるか、保存コピー自体を残さない方針かを先に決めると、名前の似た指示を選び分けやすくなります。no-cacheだけを指定しても「共有キャッシュには保存されない」とは言えません。

    この整理をそのまま広げられない範囲

    ここまでのno-cacheとprivateは、ヘッダー名を指定する引数を付けない形です。ヘッダー名付きの形には、その項目だけを再利用や保存の対象から外す別の規則があります。RFCは、その細かな扱いが広く実装されていない点も記しています。本稿の単純な三択図に混ぜず、対象のキャッシュが実際にどう扱うかを確認する必要があります。[1、5.2.2.4、5.2.2.7節]

    また、must-understandとの組合せでは、応答ステータスのキャッシュ要件を理解して実装するキャッシュがno-storeを無視すべき場合があります。この特殊な組合せは比較モデルから除いています。利用者が送る要求側のCache-Controlも、応答側と同じ役割だと決めつけず、対応する規則を読む必要があります。[1、5.2.1、5.2.2.3節]

    最後に、no-storeもprivateも、それだけで秘密保持を保証する仕組みではありません。指示に従わないキャッシュや通信の盗聴を防ぐわけではなく、サーバーログ、アプリ独自の保存、画面の記録などを一括して消す命令でもありません。HTTPキャッシュの方針と、認証・暗号化・データ保持の設計は、それぞれ確認する必要があります。

    出典

    1. RFC 9111「HTTP Caching」(2022年6月、STD 98)。3節、4節、5.2.1節、5.2.2.1〜7節。https://www.rfc-editor.org/rfc/rfc9111.html
    2. RFC 9110「HTTP Semantics」(2022年6月、STD 97)。13.1.2節(If-None-Match)、15.4.5節(304)。https://www.rfc-editor.org/rfc/rfc9110.html
  • HTTPの304応答、本文を送らない再検証で何が減るのか

    HTTPの304応答、本文を送らない再検証で何が減るのか

    同じ画像を何度も表示するとき、毎回すべてのデータを送り直す必要はあるのでしょうか。手元にある画像が今も使えるなら、本文をもう一度送らずに済みます。ただし、「通信しなかった」と「通信して変わっていないことを確かめた」は違います。

    HTTPの304 Not Modifiedは、条件付きの読み取りで、保存済みの表現を利用できることを知らせる応答です。[1] 画像を20回確認する小さな例から、何が減り、何が残るのかを考えます。

    簡単にまとめると?

    • 保存済みのETagをIf-None-Matchで送り、選ばれた表現と一致すれば、GETへの応答は本文なしの304になり得ます。
    • 例では20回の確認中に画像の版が4回登場すると、画像本文の転送は20回から4回へ減ります。確認のための要求と応答は残ります。
    • 304を使うには、対応する保存済み本文が必要です。新鮮なキャッシュを通信なしで使う場合や、更新競合を防ぐIf-Matchとは役割が違います。

    手元の版を伝えてから、同じ画像を尋ねる

    最初のGETで画像を受け取り、応答にETag: "image-a"が付いていたとします。クライアントは画像本文と、それに対応するETagを保存します。次に再検証が必要になったとき、要求へIf-None-Match: "image-a"を付けます。

    名前の通り、これは「指定したタグのどれとも一致しないなら」という条件です。サーバーが今回の要求に対して選んだ表現のETagと一致する場合、条件は偽になります。GETなら304を返し、画像本文を送り直しません。一致しなければ、この条件は画像の転送を妨げず、通常の取得処理へ進みます。[1] 認証失敗や対象不存在など、別の理由による応答まで200へ変える仕組みではありません。

    304は、画像が空になったという意味ではありません。新しい画像本文を運ぶ応答ではなく、対応する保存済みの画像を使うための応答です。本文を失ってETagだけが残っていると、304だけから画像を復元することはできません。保存データと検証用の情報を対応させて扱う必要があります。

    20回確認したとき、減るのはどの部分か

    説明用に、画像の大きさを各版とも1 MiB、1,048,576バイトとします。20回の読み取りのうち、1〜5回目は版A、6〜10回目は版B、11〜15回目は版C、16〜20回目は版Dです。最初は手元に画像がなく、毎回サーバーへ確認しに行く条件を置きます。再検証なしで使える新鮮なキャッシュの場面は、ここでは混ぜません。

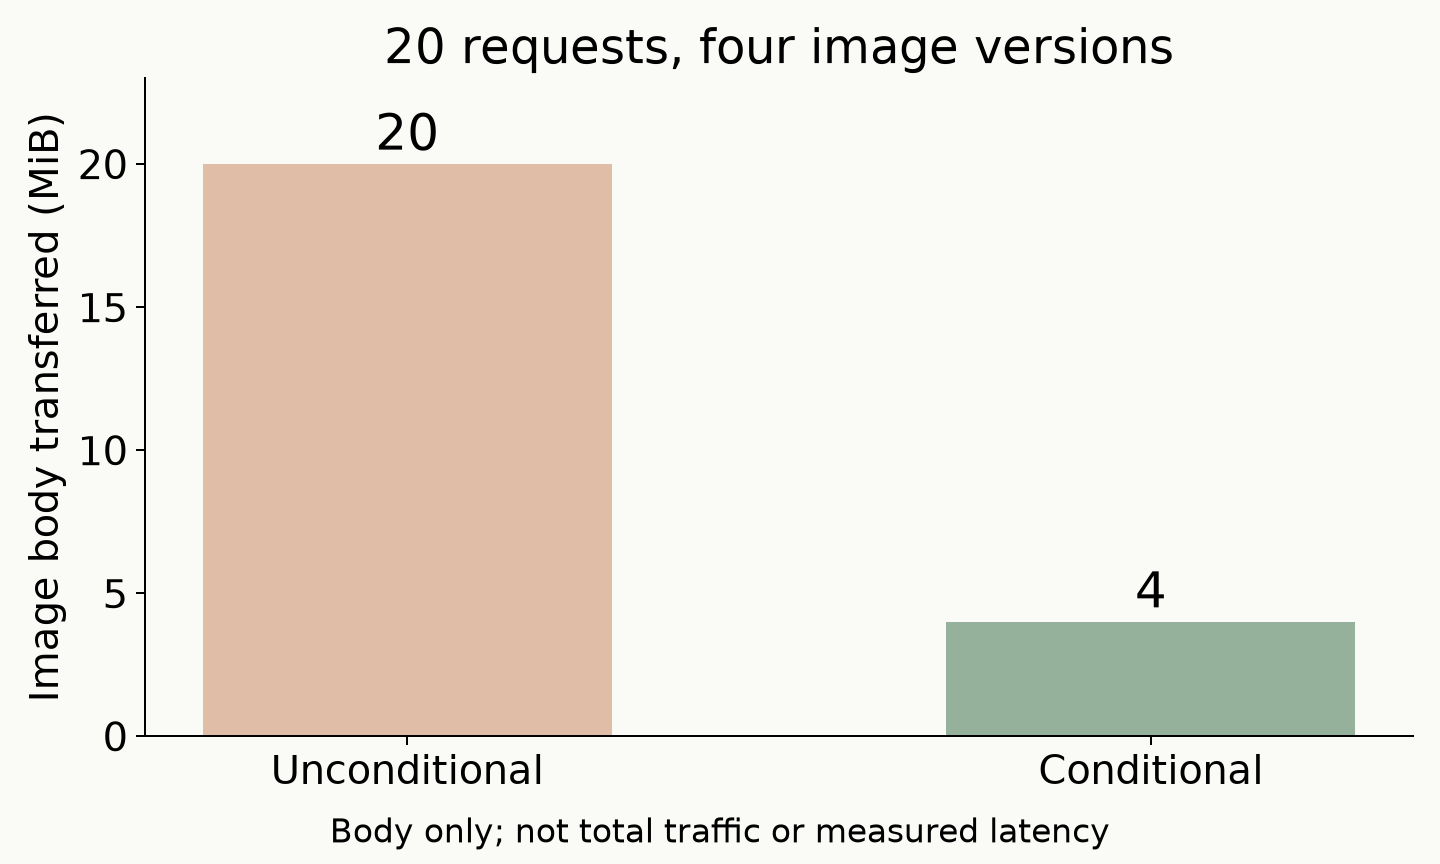
    毎回無条件で画像を取得する比較方式では、画像本文は20 MiBです。ETagを保存し、2回目以降を条件付きGETにする方式では、1・6・11・16回目に新しい版の本文を受け取り、そのほか16回は304となります。画像本文だけなら4 MiBで、差は16 MiB、80%です。これは設定した版の変化から計算した値であり、実サイトで測った削減率ではありません。

    独自モデルの20回取得。毎回無条件の方式は画像本文20MiB、条件付きGETは4MiB。どちらも要求20回で、条件付き方式では200が4回、304が16回。
    独自モデルの画像本文量。版の変化は6・11・16回目、各版は1 MiB。ヘッダー、暗号化・通信の付加情報、要求本文などは計算に含めていません。

    要求の回数は両方とも20回です。304でも要求と応答の往復はあるので、本文が80%減ったことから、待ち時間も80%短くなったとは言えません。小さな画像では往復時間やヘッダーの割合が大きくなるかもしれませんし、大きな画像では本文の転送を省く効果が目立つかもしれません。実測では、本文量、全転送量、要求数、応答時間を分けると理由を追いやすくなります。

    通信しないキャッシュ利用とは分けて考える

    HTTPキャッシュには、保存した応答を新鮮と判断して、毎回の再検証なしに使える場面があります。新鮮さは有効期間と現在の年齢などから判断されます。[2] この場合は、今回の20回確認モデルとは要求数から違います。

    例えば同じ画像を5回表示しても、最初に取得した応答をそのまま再利用できる設定と状況なら、表示のたびにネットワーク要求を出す設計にはなりません。一方、再検証を行って304を受け取る方式では、本文の送り直しを避けても確認の通信は残ります。「キャッシュが効いた」を一つの数字だけで扱うと、この二つを混同しやすくなります。

    運用上は、画像の内容が変わったときにどれだけ早く反映させたいか、再検証なしで使える期間をどう設けるか、保存容量や削除時にどう復旧するかを合わせて考えます。304を多くすること自体を目標にするより、必要な新しさを守りながら、不要な本文転送や要求を減らすという順序の方が判断しやすくなります。

    ETagが同じでも、何の一致かを確認する

    If-None-Matchは弱い比較を使います。W/"image-a"という弱いETagも再検証に利用でき、強いETagと弱いETagの接頭辞だけを違いとして不一致にはしません。[1] したがって、304を受け取ったことを、手元とサーバーの全バイトが同一であるという一般的な証明へ広げてはいけません。

    また、同じURLでも、要求によって異なる表現が選ばれることがあります。HTTPキャッシュは、Varyなどに基づく応答の選択条件も扱います。[2] 例えば表示言語ごとに本文が違う資源で、URLだけを見て別の言語の本文を再利用する独自実装は、ETagの比較以前に保存対象の選び方を誤っています。どの要求に対応する本文なのか、という対応付けを省けません。

    編集の競合を防ぐIf-Matchでは、強い比較で一致することを更新の条件にします。ここで扱うIf-None-Matchの再検証とは、条件の向きも目的も違います。似た名前を置き換えるのではなく、「古い編集による上書きを防ぐ」のか、「既に持っている表現の送り直しを避ける」のかを先に決めます。

    304の多さを成果へ読み替えない

    今回のモデルでは、版が全く変わらなければ本文は最初の1回だけ、毎回変われば20回とも必要になります。同じ条件付きGETでも、更新頻度によって結果が変わります。実装を確かめるときは、変化なし、途中で変化、保存済み本文なし、異なる表現の要求、というケースを分けると確認しやすくなります。

    304の件数だけでは、節約した量も、利用者が待った時間も分かりません。保存済み本文を正しく選べたことを前提に、何回の往復を行い、どれだけの本文を受け取り、必要な更新がいつ反映されたかまで追うと、再検証の役割を具体的に評価できます。

    参考資料

    • [1] R. Fielding, M. Nottingham, J. Reschke (eds.), RFC 9110: HTTP Semantics, June 2022, STD 97。8.8.3.2、13.1.2、15.4.5節を参照。
    • [2] R. Fielding, M. Nottingham, J. Reschke (eds.), RFC 9111: HTTP Caching, June 2022, STD 98。4.1節のVary、4.2節の新鮮さ、4.3.4節の304による保存済み応答の更新を参照。20回取得の版構成・計算・図は独自に作成しました。
  • HTTPのIf-Match、古い編集で新しい内容を上書きしない仕組み

    HTTPのIf-Match、古い編集で新しい内容を上書きしない仕組み

    二人が同じ予約情報を開き、一人は会議室を、もう一人は開始時刻を直したとします。後から保存した内容が、先に行われた変更を元へ戻してしまうことがあります。通信に成功していても、編集の結果は正しく残りません。

    HTTPのIf-Matchは、「読み取ったときの状態と一致する場合だけ、この変更を適用してほしい」と条件を付ける仕組みです。照合にはETagという識別値を使います。[1] 二人の編集例を通して、古い内容による上書きをどう防ぎ、どこからはアプリケーション側の判断になるのかを見ます。

    簡単にまとめると?

    • 読み取った表現のETagをIf-Matchへ付けると、現在のETagとの一致を更新条件にできます。
    • 例では、一人目の更新後に古いETagで保存しようとした二人目へ412を返し、先の変更を保持します。
    • 競合を見つける機能であって、自動で編集を統合する機能ではありません。最新内容を読み直し、変更の意図を確認してから次の更新を組み立てます。

    二人が同じ古い状態から編集すると

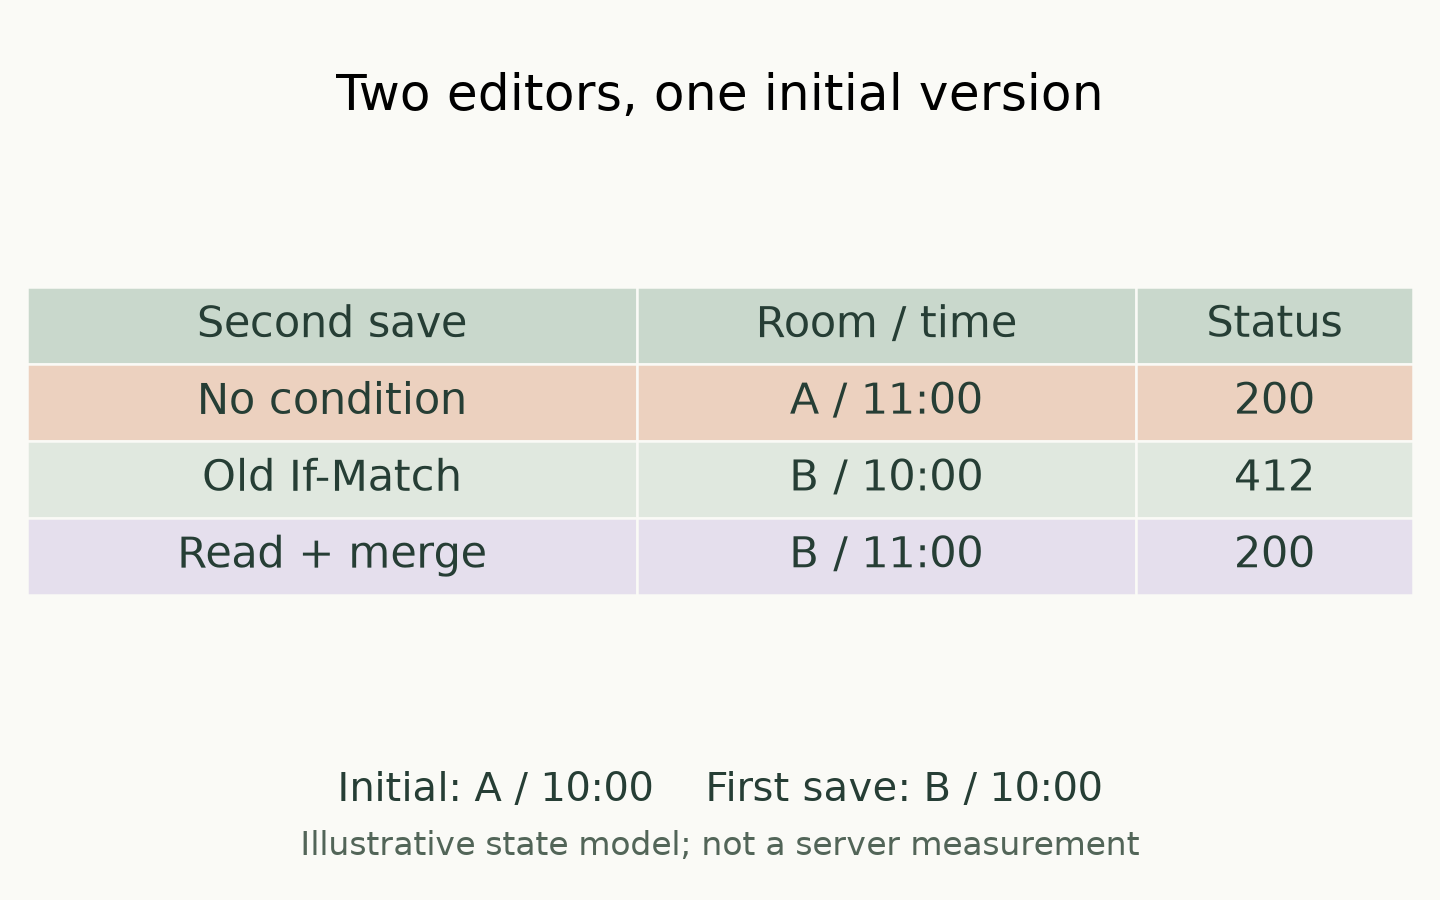
    説明用のデータを、会議室がA、開始時刻が10時の予約とします。二人とも同じデータを読みました。編集者1は会議室をBへ変え、編集者2は開始時刻を11時へ変えます。どちらも、読み取ったデータ全体を編集して置き換える方式の保存だとします。

    編集者1が先に保存すると、サーバー上は「B・10時」です。続いて編集者2が手元の全体を保存すると、その手元には会議室Aが残っているため、「A・11時」になります。編集者2は会議室を戻すつもりがなくても、編集者1の変更が失われました。これが、ここで扱うlost update、更新の消失です。

    差分だけを送る方式なら、この特定の例では衝突を避けられるかもしれません。しかし、二人が同じ項目を変える場合や、複数項目の関係を保つ必要がある場合には、それだけで競合がなくなるわけではありません。まず「何を単位として、どの状態に対して変更したのか」を明確にする必要があります。

    ETagを更新条件として返す

    ETagは、サーバーが表現へ付ける識別値です。例えば読み取り応答にETag: "r1"が含まれていたなら、保存要求へIf-Match: "r1"を付けます。r1という文字列は説明用であり、連番や時刻として解釈する必要はありません。利用側で中身の意味を推測せず、返された値を扱います。[1]

    例では、編集者1の保存が成功すると、サーバー上の内容は「B・10時」、ETagは”r2″へ変わります。編集者2が古い”r1″を条件に保存しようとしても、現在の”r2″とは一致しません。サーバーは変更を適用せず、この例では412 Precondition Failedを返します。「B・10時」が保持されるので、上書きによる変更の消失を避けられます。[1]

    同じ初期状態から二人が保存する例。条件なしでは会議室A・11時となって会議室Bへの変更が消える。If-Matchでは二人目に412を返しB・10時を保持。読み直して統合するとB・11時となる。
    独自の状態モデルで作った例。全体置換と、比較・更新を一つの不可分な処理として扱う条件付き置換を比較しました。実サーバーへの通信試験や性能測定ではありません。

    412の後は、何を読み直すのか

    編集者2は、手元の変更を捨てる必要があるとは限りません。まず最新データを読み、現在が「B・10時」であることを確認します。自分の意図が開始時刻だけを11時へ変えることなら、その変更を最新データへ適用して「B・11時」を作り、今度は読み直した”r2″を条件として保存できます。

    この間に第三者が更新すれば、再び条件が不一致になることもあります。読み直した値を条件として送るのは、読み取り後の変更も見逃さないためです。単に古い本文をそのまま使い、ETagだけ最新へ差し替えると、例では再び「A・11時」で上書きしてしまいます。条件を通過させることと、編集意図を正しく統合することは別です。

    二人とも開始時刻を変えていたなら、どちらを残すかは通信規格だけでは決まりません。利用者に差分を示す、編集時の前提を確認する、業務上の優先規則を適用する、といった判断が必要です。If-Matchは、その判断をせずに古い内容が入り込むのを止めるために使います。

    似ている条件を、同じものとして扱わない

    If-MatchのETag比較は強い比較です。例えばW/"r1"のような弱いETagは、見えている文字列が同じでもこの比較では一致しません。またIf-Match: *は対象の現在の表現が存在するかという条件であり、読み取った版から変わっていないかの確認にはなりません。[1]

    例の予約が存在し続けるなら、*では一人目の更新前後を区別できません。「存在していればよい」のか、「自分が読んだ状態のままであってほしい」のかを先に決めると、条件の選び間違いを減らせます。

    保存要求を送った後、応答が途切れる場面もあります。その場合、保存されなかったと即断して再送するのではなく、現在の内容と操作の記録を照合します。RFC 9110は、条件が不一致でも、要求された変更がすでに適用済みと見える場合に成功応答を返せる余地を定めています。したがって、412が返らなかったことだけを、初回の一回で新しく変更された証拠にはできません。[1]

    導入時に確かめたい三つの境界

    まず、クライアントが条件を付け、サーバーが対象の更新でその条件を評価しているかを確認します。次に、状態の比較と書き込みの間へ別の更新が割り込まないよう、実装上の不可分性を確かめます。最後に、不一致や応答不明のとき、最新内容と利用者の編集意図をどう照合するかを決めます。

    今回の小さなモデルは、条件なしの上書き、古い条件の拒否、最新内容へ意図した変更だけを統合する流れを検査したものです。ネットワーク越しの実装が同じ保証を備えることまでは示しません。If-Matchというヘッダーがあるかだけでなく、二人が同時に編集する試験と、保存後の読み戻しで確かめるのが実用上の確認点です。

    参考資料

    • [1] R. Fielding, M. Nottingham, J. Reschke (eds.), RFC 9110: HTTP Semantics, June 2022, STD 97。8.8.3節のETag、8.8.3.2節の比較、13.1.1節のIf-Match、15.5.13節の412を参照。予約情報の例と図、状態モデルは独自に作成しました。