タグ: Meta

  • Metaの表面筋電図(sEMG)インターフェース、手首の筋活動を入力に変える研究

    Metaの表面筋電図(sEMG)インターフェース、手首の筋活動を入力に変える研究

    画面を操作するとき、私たちは指でボタンを押したり、マウスを動かしたりします。その動作に伴う筋肉の電気的な活動を読み取れれば、手に入力機器を持たずに操作する道が開けます。

    MetaのReality Labsに属するCTRL-labsの研究チームは、手首に巻く装置で表面筋電図(sEMG)を測り、カーソル操作やジェスチャー、手書き文字の入力につなぐ研究を2025年のNatureに発表しました。焦点は、新しい利用者にも使えるモデルをどう作るかにあります。[1]

    簡単にまとめると?

    • 手首の皮膚に接する電極で筋活動を測り、その時間的・空間的なパターンを入力へ変えます。
    • 多数の参加者のデータで学習し、モデルの学習に含まれない人でも操作できるかを調べています。
    • モデルを個人ごとに再学習しなくても、入力範囲の調整や操作の練習は行われています。実験での成功と、あらゆる利用者・環境での使いやすさは別です。

    手首で測るのは、筋肉の電気的な活動

    筋肉を動かすときには、神経からの指令に応じて筋線維に電気的な活動が生じます。sEMGは、それらが重なった信号を皮膚の表面から測る方法です。この研究の装置は頭に電極を置くものではなく、考えている言葉をそのまま読む仕組みでもありません。手や指を動かす際の筋活動と、入力したい操作との対応を学習します。[1]

    研究用リストバンドは、手首の周囲に配置した電極から16の計測チャンネルを得ます。重要なのは、一つの信号が強くなったかどうかだけではありません。どの位置で、どのような時間変化が現れるかを組み合わせて、動作の違いを読み分けます。

    下の図では、aがデータを集める実験環境、bが装置と電極の位置、cが課題の例です。dには、指をつまむ動作や親指のスワイプに伴う複数チャンネルの信号が並びます。eの細い灰色線を見ると、同じ種類の動作を繰り返しても、信号が毎回ぴったり同じになるわけではないことが分かります。[1:図1]
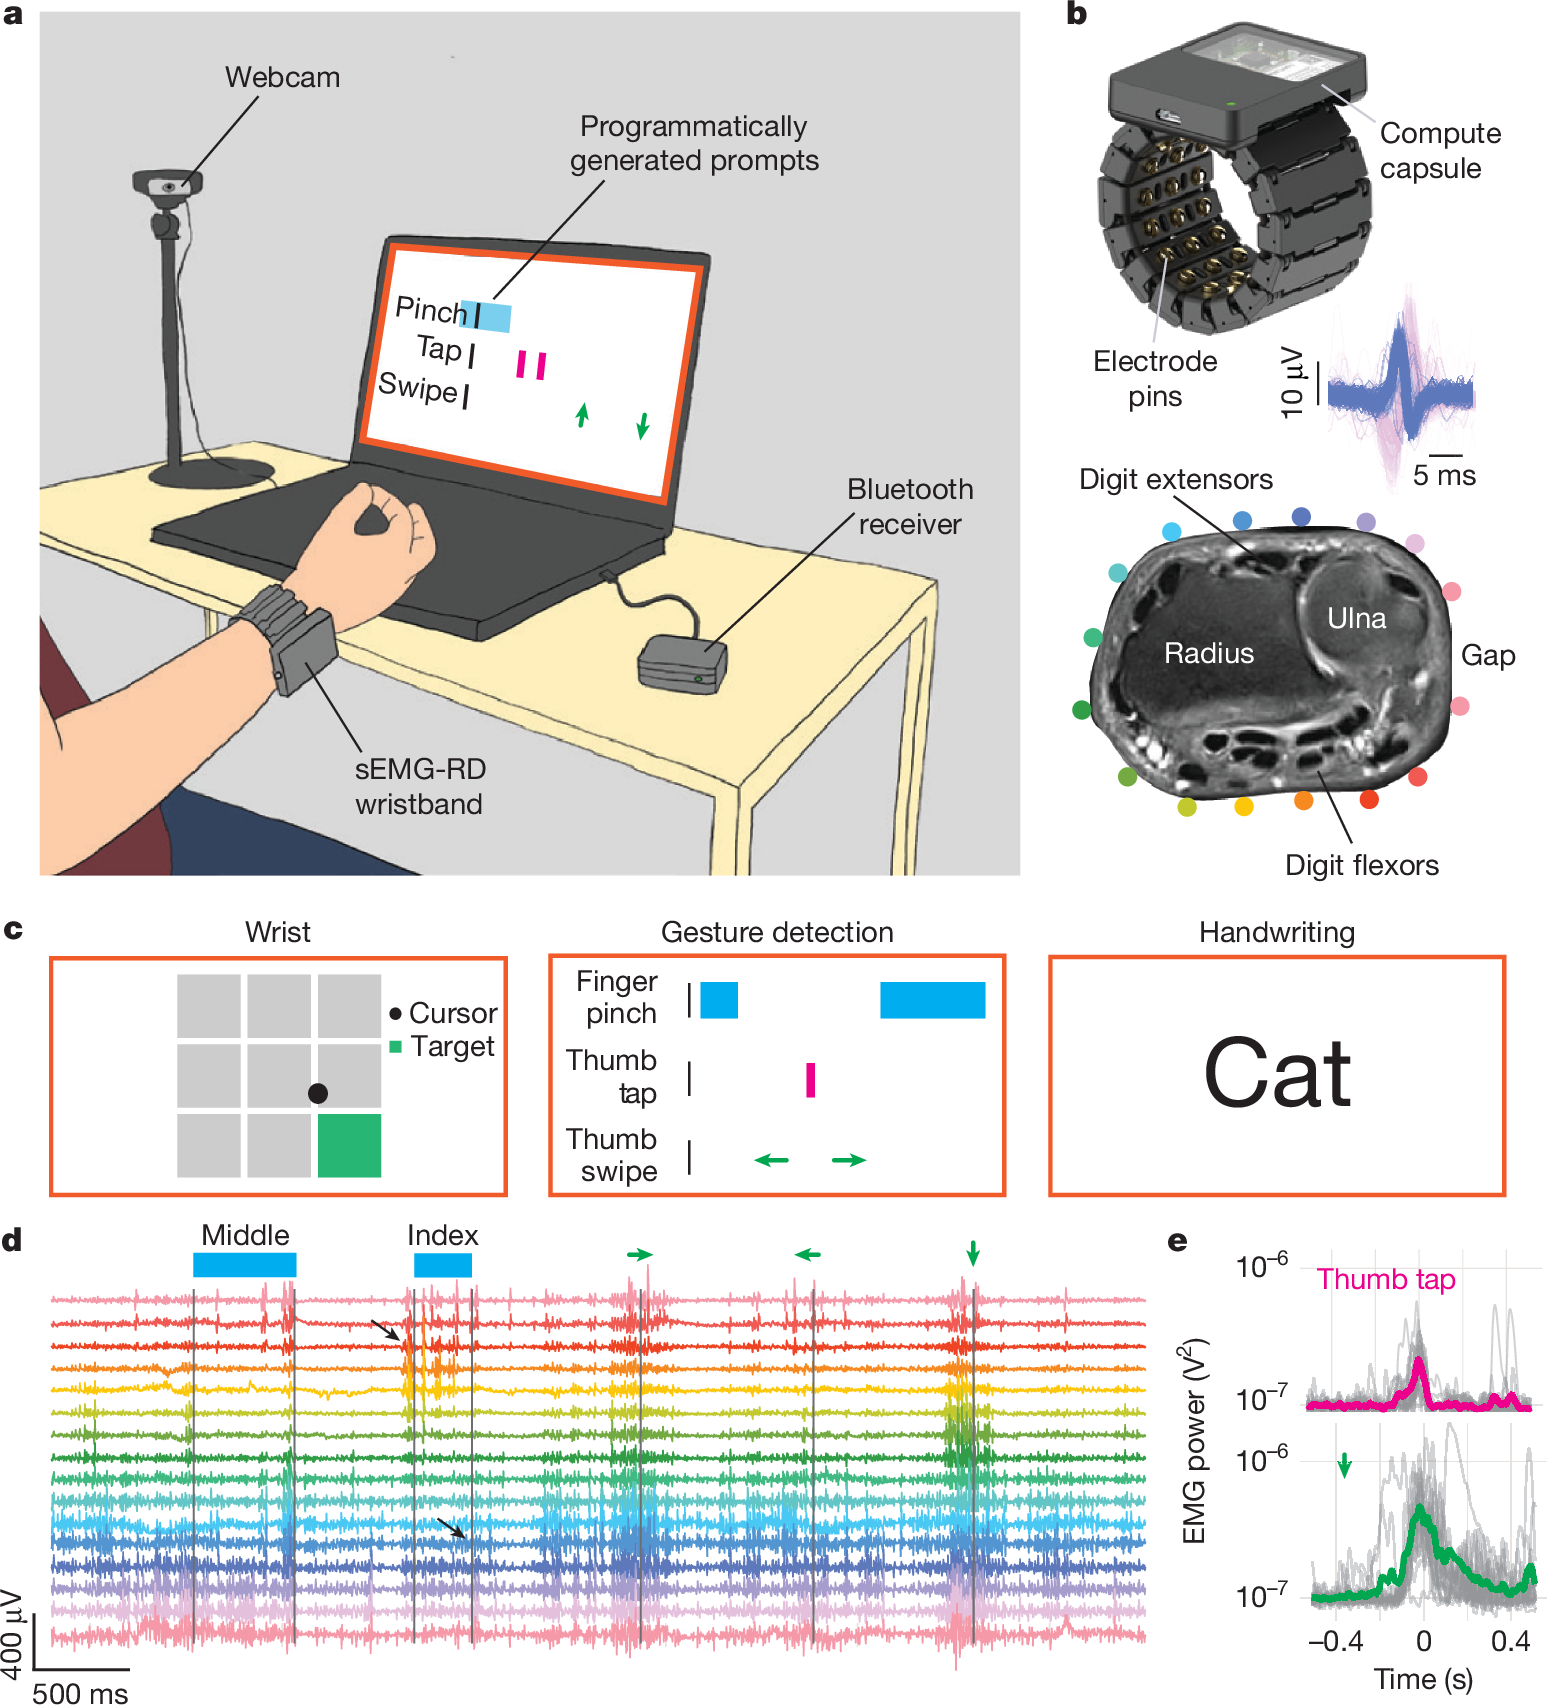
    手首のsEMG記録装置と実験環境、三つの課題、ジェスチャーに伴う複数チャンネルの信号、同じ動作を繰り返した際の信号の変動を示す原論文の図1。
    図1 手首での筋活動の記録と課題、信号の例。dの色はbの電極位置に対応し、eの太線は同じ動作を繰り返した信号の平均です。出典:Patrick Kaifosh、Thomas R. Reardon、CTRL-labs at Reality Labs「A generic non-invasive neuromotor interface for human-computer interaction」、Nature 645、704頁、Fig. 1(2025)、© The Author(s) 2025。原図/図を拡大する。

    同じ動作でも、人や装着位置で信号が変わる

    難しいのは、ある人の信号を覚えただけでは、別の人にそのまま通用しにくいことです。体のつくりや動かし方が違い、同じ人でもバンドの位置が変わります。論文では、一人のデータで学習したモデルを別の人へ使うと、性能が大きく下がる様子を確かめています。[1:図2]

    そこで研究チームは、課題ごとに多数の参加者からデータを集め、複数の人に共通して使うモデルを学習しました。装着位置を少しずつ変えた記録も含めています。モデルは、単に特定の人の波形を覚えるのではなく、ばらつきの中から入力に関係する特徴を捉える必要があります。

    試した入力には、手首を動かしてカーソルを左右へ動かす連続操作、指のつまみや親指のスワイプを使う離散的な操作、文字を書く動作からの文字入力があります。手書きの場合も、頭の中の文章を取り出すのではなく、提示された語句を指で書く動作に伴うsEMGを使います。[1]

    「すぐ使える」を、実験条件と一緒に読む

    新しい利用者が画面の結果を見ながら操作する評価では、課題ごとに17人、24人、20人が参加しました。手書き入力では、20人を対象とした練習後の最初の評価ブロックで、入力速度の中央値が毎分20.9語でした。この指標は空白を含む5文字を1語と数え、最初から最後の文字が出力されるまでの時間で計算しています。課題を読む時間や提出操作の時間は含まず、誤った文字はキーボードのBackspaceで消して書き直せました。提示された語句を入力する実験の値で、日本語入力や自由な長文作成の速さを示すものではありません。[1:図3]

    ここで、モデルの個人向け調整と、人が操作に慣れることは分けて考える必要があります。評価には最初に練習のブロックがあり、研究者が動かし方を助言しました。一部の参加者には評価中も助言が行われています。また、カーソル課題では開始時に手首を動かし、モデルが予測する速度の範囲を測って、出力を正規化しています。モデルを個人ごとに再学習しないことと、入力範囲の調整や練習が不要なことは別です。[1:Methods]

    比較したトラックパッドやゲームコントローラーなどは、それぞれの評価指標でsEMG入力を上回りました。研究の狙いは、既存の機器より速いと示すことだけではなく、手を入力機器でふさがずに操作できる可能性を調べることにあります。[1]

    使える人と場面を、さらに広げられるか

    記録は管理された環境で集められており、日常のあらゆる場面で同じ性能を確かめた研究ではありません。また、論文は、今回学習した汎用モデルが運動機能に障害のある人にもそのまま使えるかは不明だとしています。小さな筋活動を利用できることは将来の入力方法につながる可能性がありますが、この結果だけで医療上の効果が示されたわけではありません。[1]

    手首の筋活動を入力に使うには、信号を測る装置、動作を読み分けるモデル、人が覚えやすい操作を一緒に設計する必要があります。この研究は、その三つを結び、多くの人へ共通のモデルを広げる方法を検証したものとして読むと、到達点と残る課題が見えてきます。

    Metaの企業像を知る

    この研究を手がけるMetaの事業全体と、Reality Labsの位置づけは、Cyclewaveの企業解説で紹介しています。

    参考資料

    1. Patrick Kaifosh、Thomas R. Reardon、CTRL-labs at Reality Labs「A generic non-invasive neuromotor interface for human-computer interaction」。Nature 645、702–711頁。2025年7月23日公開。DOI: 10.1038/s41586-025-09255-w。
  • MetaのBAG、AIネットワークを建物間でつなぐ集約層の仕組み

    MetaのBAG、AIネットワークを建物間でつなぐ集約層の仕組み

    AIの学習に使うGPUを増やすと、計算機を置く場所だけでなく、GPU同士をどう結ぶかも変わります。一つの建物に収まっていた通信を、別の建物やデータセンターまで広げると、距離による遅延や故障時の経路変更が学習に響いてきます。

    MetaのJalpa Patel氏とAnkur Singh氏は、OCP APAC 2026の講演資料で、AI基盤を広域につなぐBAG(Backend Aggregation)を紹介しました。高速な回線を用意するだけでは足りず、ネットワークの制御と学習処理の両方を合わせる必要があることが見えてきます。[1]

    簡単にまとめると?

    • MetaのBAGは、複数のネットワークをEthernetでつなぐ集約層です。
    • 故障後の通信は、残った経路の帯域に応じて振り分けます。
    • 拠点間の遅延に合わせ、GPUの集団通信や学習側の調整も必要です。

    一つの建物から、複数の拠点へ

    資料では、Prometheusを1ギガワット級のクラスターとして説明し、通常のデータセンター棟に加え、屋外の耐候性テントや隣接するコロケーション施設も使う構成を示しています。この規模の説明はMetaの資料に基づくもので、ここから全設備の稼働状態まで分かるわけではありません。

    資料がNSFと呼ぶネットワーク構成では、一つのIslandに72ラック、5,184基のGPUをまとめます。その内側にあるバックエンドのPodはノンブロッキングとされる一方、Islandをまたぐ部分には3対1のオーバーサブスクリプションがあります。接続された全GPUが、あらゆる相手へ同時に最大速度で通信できる構成ではない点に注意が必要です。

    BAGは、その上位で複数のネットワークをつなぐ、Ethernetベースの集約層です。役割を分けて見ると、どこまでの通信を扱っているか整理しやすくなります。

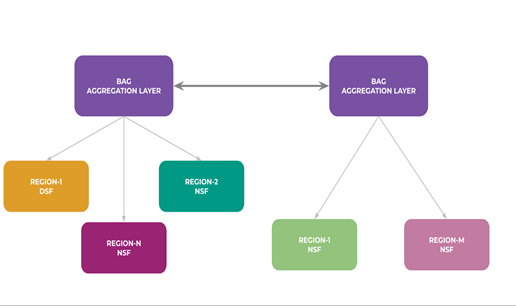
    図1の下段に並ぶ各Regionのネットワークは、上段のBAG集約層に接続されています。BAG同士を結ぶ線まで一緒に見ると、個々のネットワークを集約層を介して結ぶ構成だと分かります。図が表すのは接続関係であり、すべての組み合わせで同じ帯域が得られることを示すものではありません。

    上段の二つのBAG集約層が相互につながり、下段の各RegionのDSFまたはNSFネットワークがそれぞれのBAGへ接続する構成図。
    図1 BAGが複数のネットワークを結ぶ構成(原図引用)
    Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」、OCP APAC 2026、p.5。出典の講演資料。スライド内の図部分を掲載。
    図は横にスクロールできます。図の画像を開く
    表1 講演資料に基づく通信範囲の整理。資料[1]pp.4–5をもとにQuantum Sea作成。
    範囲 資料で示される特徴
    バックエンドのPod内 ノンブロッキングの接続
    Island間 3対1のオーバーサブスクリプション
    BAGによる集約 複数のデータセンターや地域のネットワークを接続

    距離が延びると、止めた後にもデータが届く

    混雑した受信側から送信を一時停止するよう伝えても、その通知が届くまでには時間がかかります。その間に届くデータを受け止める余裕が必要です。優先度ごとに送信を抑えるPFC(Priority Flow Control)を使う場合、ケーブルが長いほど、この余裕として確保するバッファー量も大きくなります。

    Metaは、FBOSSを使って信号の往復時間からケーブル長を推定し、最長距離を一律に仮定する代わりに、実際の長さに沿って余裕を割り当てる方法を示しました。距離の違いを測ることが、限られたメモリーの使い方にも関わります。

    資料はさらに、複数のキューからDRAMへ同時にデータを移すと競合が起き、SRAM側の余裕がなくなり、PFCの影響が全ポートへ広がる危険も挙げています。容量が大きいメモリーを備えるだけで解決する問題ではなく、そこへデータを出し入れする過程も設計の対象です。[1]

    故障後は、残った帯域に合わせて分ける

    通信経路の一部が故障すると、経路ごとに残っている帯域が違ってきます。それでも均等にデータを流すと、細くなった経路に混雑が集まります。

    BAGでは、BGPで経路の帯域情報を伝え、UCMPという、経路の能力に応じて割合を変える分散方法を使います。一方で、小さな帯域変化のたびにネットワーク全体の経路情報が揺れ続けないよう、更新を抑える仕組みも組み合わせています。故障に追従する速さと、制御を安定させることの両立が課題になります。

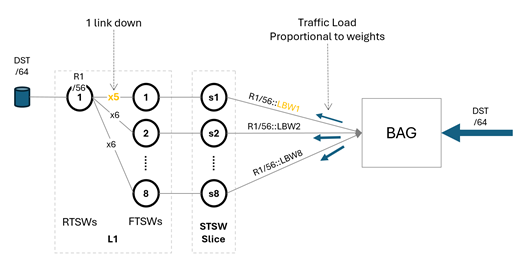
    図2では、左側のリンク束の一つに「1 link down」とあり、経路ごとの帯域情報がLBWとして右側のBAGへ伝わる様子が描かれています。BAGへ入った通信は、青い矢印のように各経路の重みに応じて振り分けられます。故障で減った帯域を分配に反映する点が、この図の要点です。

    左側のリンク束の一つに1 link downと×5の表示があり、経路の帯域情報LBWが右側のBAGへ伝わる。BAGへの入力通信は青い矢印で各経路の重みに応じて振り分けられる。
    図2 リンク故障後の帯域を反映するUCMP(原図引用)
    Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」、OCP APAC 2026、p.7。出典の講演資料。スライド内の図部分を掲載。
    図は横にスクロールできます。図の画像を開く

    回線の先にある学習処理まで合わせる

    通信が届けば学習の効率も保たれる、とは限りません。資料では、一つのBAGを経由するL2ネットワーク間の遅延を、L2内のおよそ3倍としています。これは資料内の構成の比較であり、別の設備にもそのまま当てはまる値ではありません。

    GPU間の集団通信に使うNCCLについても、プロトコルの選択がネットワーク遅延を考慮していないことを課題に挙げています。遠い相手との通信に合わせた調整に加え、BAG層を通る通信のうち、計算で隠せず待ち時間として現れる部分を小さくすることが求められます。

    今後の課題として示されるのは、異なる構成のクラスターへの対応や、数十・数百・数千キロメートル離れた地域間での学習です。これらは講演時点の取り組みの方向で、すべてが実現済みという意味ではありません。Metaの事例が示すのは、AI基盤を広げる際には、回線、バッファー、経路制御、学習ソフトウェアを一続きで考える必要があるということです。

    Metaを企業全体から見る

    Metaのサービス事業やAI基盤への投資を含む企業全体の説明は、cyclewaveの記事にまとめています。

    参考資料

    1. Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」。OCPの掲載題名は「Scaling AI Infrastructure Across DC and Beyond: Meta’s Journey with NSF and BAG」。OCP APAC 2026、pp.3–13。講演資料
    2. Open Compute Project「2026 OCP APAC Summit」公式資料一覧。公式カタログ
  • MetaのCPLD共通化案、サーバー制御回路の更新・復旧・診断をそろえる

    MetaのCPLD共通化案、サーバー制御回路の更新・復旧・診断をそろえる

    サーバーの電源が入らないとき、原因はCPUや電源装置だけにあるとは限りません。起動の順番を整えたり、異常を見張ったりする小さな制御回路が、システム全体の動きを左右することもあります。

    その一つがCPLD(Complex Programmable Logic Device)です。2026年8月のOCP APAC SummitでMetaが示したのは、機種ごとに分かれていたCPLDの開発・機能要件を共通化する枠組みでした。ファームウェア更新からの復旧、異常情報の読み方、診断の仕組みをそろえようとする提案です。[1・2]

    簡単にまとめると?

    • Metaは、機種ごとに異なるCPLDの更新・故障情報・診断の仕組みを共通化する案を示しています。
    • 更新データの検証と予備領域からの起動を組み合わせ、異常の検出と復旧を別々に備えます。
    • 発表時点では共通仕様のドラフトを議論する段階で、採択済みのOCP標準ではありません。

    機種ごとの違いが、復旧を難しくする

    CPLDは、用途に応じた論理回路を実装できるデバイスです。Metaの資料では、サーバーやスイッチ、GPUラックの電源投入順序、故障監視、ファームウェア更新、安全に関わる制御を担うものとして登場します。[2]

    発表では、更新が途中で失敗して現地での復旧が必要になった例、管理用のI²Cバスが応答しなくなった例、正常な状態が故障として扱われた例が挙げられています。これらはMetaが紹介した事例で、データセンター全体の一般的な故障率を示す統計ではありません。[2]

    背景として指摘されたのが、40を超える設計の間で、レジスター配置、故障を表すビット、バージョンの表し方、通信のタイムアウトや復旧経路が共通になっていないことでした。同じ種類の異常でも、機種が変わるたびに読み取り側の作り込みが必要になります。[2]

    書き込みの確認と、起動できる予備領域を分けて備える

    更新の失敗に対しては、三段階の保護が示されています。転送したデータをページ単位のCRCで確認すること、書き込み後のイメージ全体をハッシュで検証すること、主領域で起動できなければ予備領域から起動することです。資料の構成例では、ページ単位の転送は128バイトとされています。[2]

    CRCとハッシュの検証は、書き込むデータの異常を見つけるためのものです。一方、二つの起動領域を用意する仕組みは、主領域に問題が残っても復旧へ進めるための備えです。異常を検出することと、異常のあとに動き直せることは別の役割を持ちます。

    この例では、検証や起動先の切り替えをCPLD内部で行い、管理バスへの依存を抑えます。予備側から起動したあとで、サーバー管理用のBMCが主領域を遠隔で修復する構成です。Metaは、ODMとCPLDベンダーと共同で開発・検証した方式として説明しています。[2]

    異常の概要を、どの機種でも同じ場所から読む

    もう一つの柱が、共通レジスターヘッダーの提案です。レジスターは、制御状態や異常情報などをソフトウェアから読み書きするための領域です。機種ごとに場所が違うと、基本的な正常・異常の判定まで個別対応になります。

    資料では、アドレス0x00〜0x1Fを共通部分とし、バージョン、状態、故障の概要などを同じ位置で読める案を示しています。機種固有の情報はその後ろに分けます。共通化によって固有機能を消すのではなく、最初の入口をそろえる考え方です。[2]

    故障情報も二段階です。まず電源シーケンス、電源、温度、冷却、CPU/SoC、クロックの六つの分類から概要を読み、その後、どの電源系統や領域に問題があるかを機種固有の情報で追います。BMCは「概要を読む→分類を知る→必要な詳細を読む」という流れを共通にできます。[2]

    診断の本体を共有し、機種の違いはルールで持つ

    Metaが示す診断の構成は、共通レジスターを読む診断エンジンと、機種ごとのルールセットを分けるものです。ルール側にはコマンド、故障パターン、対処手順を持たせます。新しい機種ごとに診断ツールを一から作るのではなく、共通の仕組みに必要な違いを渡す方向です。[2]

    開発要件の確認には、仕様とRTLの対応を調べるAIによるコードレビューも紹介されています。五つの設計から141件の指摘を得たという数値は、このレビューでの検出結果です。すべてが実運用の故障だったことや、AIだけで設計の安全性を保証できることを意味しません。[2]

    OCP仕様に向けた、まだ議論中の枠組み

    発表時点では、共通仕様に向けたドラフトのレビューを呼びかける段階でした。資料上の計画は、2026年後半に作業部会と最初のコミュニティレビュー、2027年に初期OCP仕様を目指すというものです。完成・採択済みの標準とは区別して読む必要があります。[2]

    この提案の要点は、機器の性能を直接引き上げることより、更新と診断を機種の違いで途切れさせないことにあります。正常に起動すること、故障を正しく知らせること、遠隔で戻れること。その土台を共通の約束事として整える、運用を見据えた設計です。

    企業の事業もあわせて読む

    Metaの広告事業とAI投資の全体像は、cyclewaveの企業解説で整理しています。

    cyclewaveでMetaの企業解説を読む

    参考資料

    2026年9月27日確認。計画・提案の状態は講演資料の時点を示します。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧

    [2]Meta「From 40+ Fragmented CPLDs to a Common Standard」公式掲載スライド。問題と共通要件はpp.4–7、更新保護はp.8、レジスターと診断はpp.9–11、AIレビューと提案日程はpp.12–13。

  • MetaのORv3 HPR、高電力ラックを支える電源と冷却の設計

    MetaのORv3 HPR、高電力ラックを支える電源と冷却の設計

    Metaが開発した「Open Rack V3 High Power Rack (HPR)」とそのエコシステムについて解説します。HPRは、AIが牽引する電力需要の高まりに対応するため、従来のOpen Rack V3 (ORv3) を改良し、高出力設計を実現したものです。以下に主な特徴と進化点をまとめます。


    簡単にまとめると?

    • MetaのHPRは、AI向けの高出力化に合わせてORv3のラック構造と電源を改良した設計です。
    • 大容量のコンデンサーで、一時的な高負荷に対応します。
    • 冷却ではラック間のシーリングを保ち、マニフォールドの柔軟性を高める設計です。

    HPRの主な改良点

    ラック構造の改良

    • ラックの深さ: ORv3より6インチ深い構造。
    • バスバー容量: 最低18kWから最低92kWへ大幅に向上。
    • 安定性の向上: バランスウェイトを追加して重量増加による不安定性を解消。

    電力システムの強化

    • パワーシェルフ: 従来の3kWから5.5kWのモジュールを採用し、最大33kWの出力を実現。
    • ピークパワー: 大容量のコンデンサを搭載し、一時的な高負荷(136%や160%のピークパワー)に対応。
    • バックアップ電源ユニット(BBU): 最大90秒のフルロードバックアップと4分間の部分バックアップが可能。
    • 配線: 北米では20Aから30A ACウィップへ変更し、ヨーロッパでは従来の32Aプラグを維持。

    接地と安全性の改善

    • 接地ポイントの変更: バスバー側に接地ポイントを移動し、過電流のリスクを軽減。
    • 新しいグラウンドクリップ設計: ITギアとの接続部材を適切に選定し、信頼性を向上。

    冷却と拡張性

    • 冷却効率の維持: ラック間のシーリング効率を保ちつつ、冷却用マニフォールドの柔軟性を向上。
    • 将来の高容量冷却への対応: 深いマニフォールドをサポートする設計。

    テスト結果と性能

    HPRは厳しい性能テストを実施し、以下の結果が得られています。

    • 最大出力: 155kWの電力供給を達成。
    • バスバー設計: 厚みを増し、15kgから80kgへの重量増加で高出力に対応。
    • 熱制御: バスバー温度上昇を30℃に抑え、3段階の温度制限(90℃、110℃、120℃)を設定。

    エコシステムと開発への参加

    MetaはHPR設計に多くのパートナー企業と協力し、ケーブル、バスバー、ラックの設計を最適化しました。また、Open Compute Project (OCP)のWikiでスペックを公開予定で、コミュニティからの参加も歓迎しています。


    結論

    HPRは、AI主導の需要に対応するための革新的な電力設計を提供し、スケーラビリティ、効率性、安全性を大幅に向上させています。この取り組みは、今後の高負荷環境におけるデータセンター設計の新たな基準を築くことを目的としています。

    企業の事業もあわせて読む

    Metaの事業や収益構造は、cyclewaveの企業解説で紹介しています。

    cyclewaveでMetaの企業解説を読む

  • TE ConnectivityとMetaの液冷バスバー、ORv3 HPRの大電流を支える設計

    TE ConnectivityとMetaの液冷バスバー、ORv3 HPRの大電流を支える設計

    概要

    TE ConnectivityがMetaと共同で開発した次世代ラック用液冷バスバーについて説明。この技術は、AIワークロードや高性能コンピューティングの増加する電力需要を満たすことが目的。

    簡単にまとめると?

    • TE ConnectivityとMetaの液冷バスバーは、増えるラックの電力需要に対応するための給電部品です。
    • 大電流を扱うため、温度上昇と電圧降下を抑え、液体が銅に触れない構造や漏れの試験も検討しています。
    • 接続部やモジュール設計の改良を続け、電流容量の拡大とOCPでの規格化を目指す取り組みです。

    主なトピック

    1. 背景
      • 業界全体でラックレベルの電力要求が急速に増加中。
      • Metaの既存規格「ORv3 HPR」では、空冷で最大140kWをサポート。将来的にはラックごとに最大1.2MW(2029年予測)を目指す。
    2. 液冷バスバーの利点
      • 同じサイズで空冷バスバーの5倍の電流を供給可能。
      • 既存のラックインフラに簡単に統合可能。
      • 温度上昇を抑え、効率的な電力伝送を実現。
    3. 設計の考慮点
      • 温度管理:コネクタ間で30°C以下の温度上昇を目指す。
      • 電圧降下:0.1V以下に制限。
      • 安全性:液体が銅と接触しない構造、漏れ防止テストの実施。
      • モジュール性:ホースのクイックコネクト設計で保守性を向上。
    4. テストとシミュレーション結果
      • 最大750kWの液冷バスバーを開発・テスト。
      • 8000Aの電流負荷で、温度上昇と電圧降下が基準内。
      • 実使用に近い条件での試験でも良好な結果を確認。
    5. 次世代への展望
      • 電流容量のさらなる増加を目指し、設計を改良中。
      • TE ConnectivityのBB2000コネクタとの併用で効率的な電力伝送を実現。

    液冷バスバーの比較表

    項目空冷バスバー (36kW)空冷バスバー (140kW)液冷バスバー (200kW)液冷バスバー (750kW)
    電力容量36kW140kW200kW750kW
    重量同等同等同等同等
    温度上昇高い中程度低いやや高い
    電圧降下大きい中程度小さい小さい

    今後の展開

    • Metaと協力し、OCP(Open Compute Project)での規格化を進める。
    • 接続部分の改良やモジュール設計の最適化を継続。
    • 新しい液冷バスバーの開発により、さらなる電力容量の拡張を目指す。

    企業の事業もあわせて読む

    共同開発に関わるMetaの事業については、cyclewaveの企業解説で紹介しています。

    cyclewaveでMetaの企業解説を読む

  • Metaが目指す30°Cクーラント、チップと施設をつなぐ液冷設計

    Metaが目指す30°Cクーラント、チップと施設をつなぐ液冷設計

    データセンターの効率化と持続可能性を目指す中、Meta主導の「冷却環境プロジェクト」は、チップの冷却温度を最適化するための新たな方向性を打ち出しています。本記事では、プロジェクトの概要、取り組みの現状、そしてデータセンターやチップメーカー双方に有益な「30°Cの耐久性のあるクーラント温度」の目標について解説します。

    冷却環境プロジェクトは、データセンター内の冷却技術を包括的に研究し、効率性と持続可能性を重視したソリューションを開発する取り組みです。このプロジェクトは以下の5つのサブプロジェクトに分かれています:

    1. 冷却プレート(Cold Plate)
      冷却プレート、ホース、バルブ、マニホールドを含むラックレベルの冷却システムの設計と規格化。
    2. 液浸冷却(Immersion Cooling)
      新技術の発展や市場導入の障壁を克服するための仕様策定やホワイトペーパーの作成。
    3. リアドアヒートエクスチェンジャー
      冷却装置がラックの背面で発生する熱を排出する技術の開発。
    4. 高度冷却施設(Advanced Cooling Facilities)
      ラックレベルとデータセンターレベルのインターフェースを管理し、TCSループ(冷却液システム)を実現。
    5. 熱再利用(Heat Reuse)
      データセンターから排出される熱を有効活用するためのユースケース開発。

    簡単にまとめると?

    • Meta主導の冷却環境プロジェクトは、データセンター設計の基準として30°Cの冷却液温度を目標にしています。
    • チップの性能と施設側の効率を両立させるため、冷却温度を双方から考える提案です。
    • 実現に向けて、冷却設備の設計調整やチップの熱抵抗・熱密度への対応が課題になります。

    耐久性のある30°Cクーラント温度とは?

    プロジェクトの次なるステップは、データセンター設計の基準として「30°Cのクーラント温度」を定義することです。この温度設定には以下のような背景と利点があります:

    1. 技術的背景

    • チップの電力消費増加
      CPUやGPUの性能向上に伴い、電力消費が増加しています。例えば、GPUの消費電力は数百ワットから1,000ワット以上に達しています。
    • 冷却効率の課題
      高性能チップが生成する熱密度を管理するため、冷却液の温度を適切に保つ必要があります。

    2. 30°Cが選ばれた理由

    • チップ側の要件
      冷却温度が低いほどチップの性能は向上します。
    • データセンター側の要件
      高温のクーラントを使用する方がエネルギー効率が向上し、運用コストが削減されます。
    • 双方の妥協点としての30°C
      データセンターの長寿命化とチップ性能の両立を図るため、30°Cが合理的な妥協点として選ばれました。

    実現に向けた課題と次のステップ

    主な課題

    1. 冷却システムの設計と調整
      データセンターの設計基準を30°Cに適応させるには、設備の大規模な変更が必要です。
    2. 技術的制約の克服
      チップメーカーが直面する熱抵抗や熱密度の課題を解決する必要があります。

    次のステップ

    • ホワイトペーパーの作成
      詳細な分析結果を公開し、業界全体での議論を促進。
    • HBM(高帯域幅メモリ)の最適化
      HBMの熱管理性能を向上させ、冷却効率をさらに高める。

    データセンター設計への影響

    • コスト削減
      30°Cの冷却液は、チラー運用の削減を通じてエネルギー効率を向上させます。
    • 長期的な持続可能性
      データセンターの設計寿命を延ばし、将来のAIコンポーネント需要にも対応可能。

    まとめ

    冷却環境プロジェクトが提案する「30°Cの耐久性のあるクーラント温度」は、チップメーカーとデータセンター運営者双方にとって理想的な解決策です。この基準が広がることで、AIや高性能コンピューティングの急速な発展を支えるためのインフラが整備されるでしょう。

    企業の事業もあわせて読む

    Metaの事業や収益構造は、cyclewaveの企業解説で紹介しています。

    cyclewaveでMetaの企業解説を読む