GPUを増やすと、計算を分担する相手も増えます。その相手とデータを交換する道が複雑になれば、計算装置だけを速くしても待ち時間はなくなりません。AI向けネットワークでは、回線一本の速さに加え、一台のスイッチでいくつの接続先を受け持てるかが大切になります。
2026年7月28日のOCP Educational Webinarでは、この接続数を表す「radix」を大きくする方法が取り上げられました。Eriduが示した640基のGPUの比較例をもとに、スイッチの接続数とネットワークの階層がどう結びつくのかを見ていきます。[1・2]
簡単にまとめると?
- 同じ800Gの接続でも、スイッチのradixが大きいほど、一台で受け持てる接続先を増やせます。
- 640基のGPUをつなぐ講演の構成例では、64接続のスイッチを使う2層30台と、640接続を持つ単層1台が比較されています。
- 階層を減らすには半導体だけでなく、入出力・バッファ・電源・冷却・ソフトウェアを合わせた設計が必要です。電力や費用の削減値は、講演で示された条件付きの主張として読みます。
速さと接続数を分けて考える
スイッチは、入ってきたデータを必要な接続先へ送り分ける装置です。ここでいうradixは、一定の速度で使える接続数を指します。たとえば「64 × 800G」なら、800Gbpsの接続を64本持つ構成です。接続一本の速さが同じでも、本数が変われば直接つなげる範囲が変わります。[1、12–14頁]
ただし、すべての接続口をGPU向けに使えるとは限りません。複数のスイッチを組み合わせると、スイッチ同士を結ぶためにも接続口が必要になります。下位のリーフと上位のスパインという2層で組む場合、リーフの接続口をGPU側とスパイン側へ振り分けます。[1、12頁]
640基のGPUを、2層30台と単層1台で比べる
講演の比較例は、各GPUに800Gの接続を一本ずつ用意した640基の構成です。2層側は、51.2Tbps・64 × 800Gのスイッチを使います。リーフ20台はそれぞれ32接続をGPUへ、残る32接続を上位へ向け、スパイン10台と組み合わせます。GPU側の帯域合計は640 × 800Gbps=512Tbpsです。[1、12頁]
一方、図の右側は640 × 800Gを受け持つ512Tbpsの単一スイッチです。この構成なら、640基を収容するためのリーフとスパインの間の接続が不要になります。接続数は64から640へ10倍ですが、装置数は30台から1台へ変わります。上位へ集約するための装置も省けるため、接続数と装置数の倍率がそのまま一致しないのです。[1、13頁]
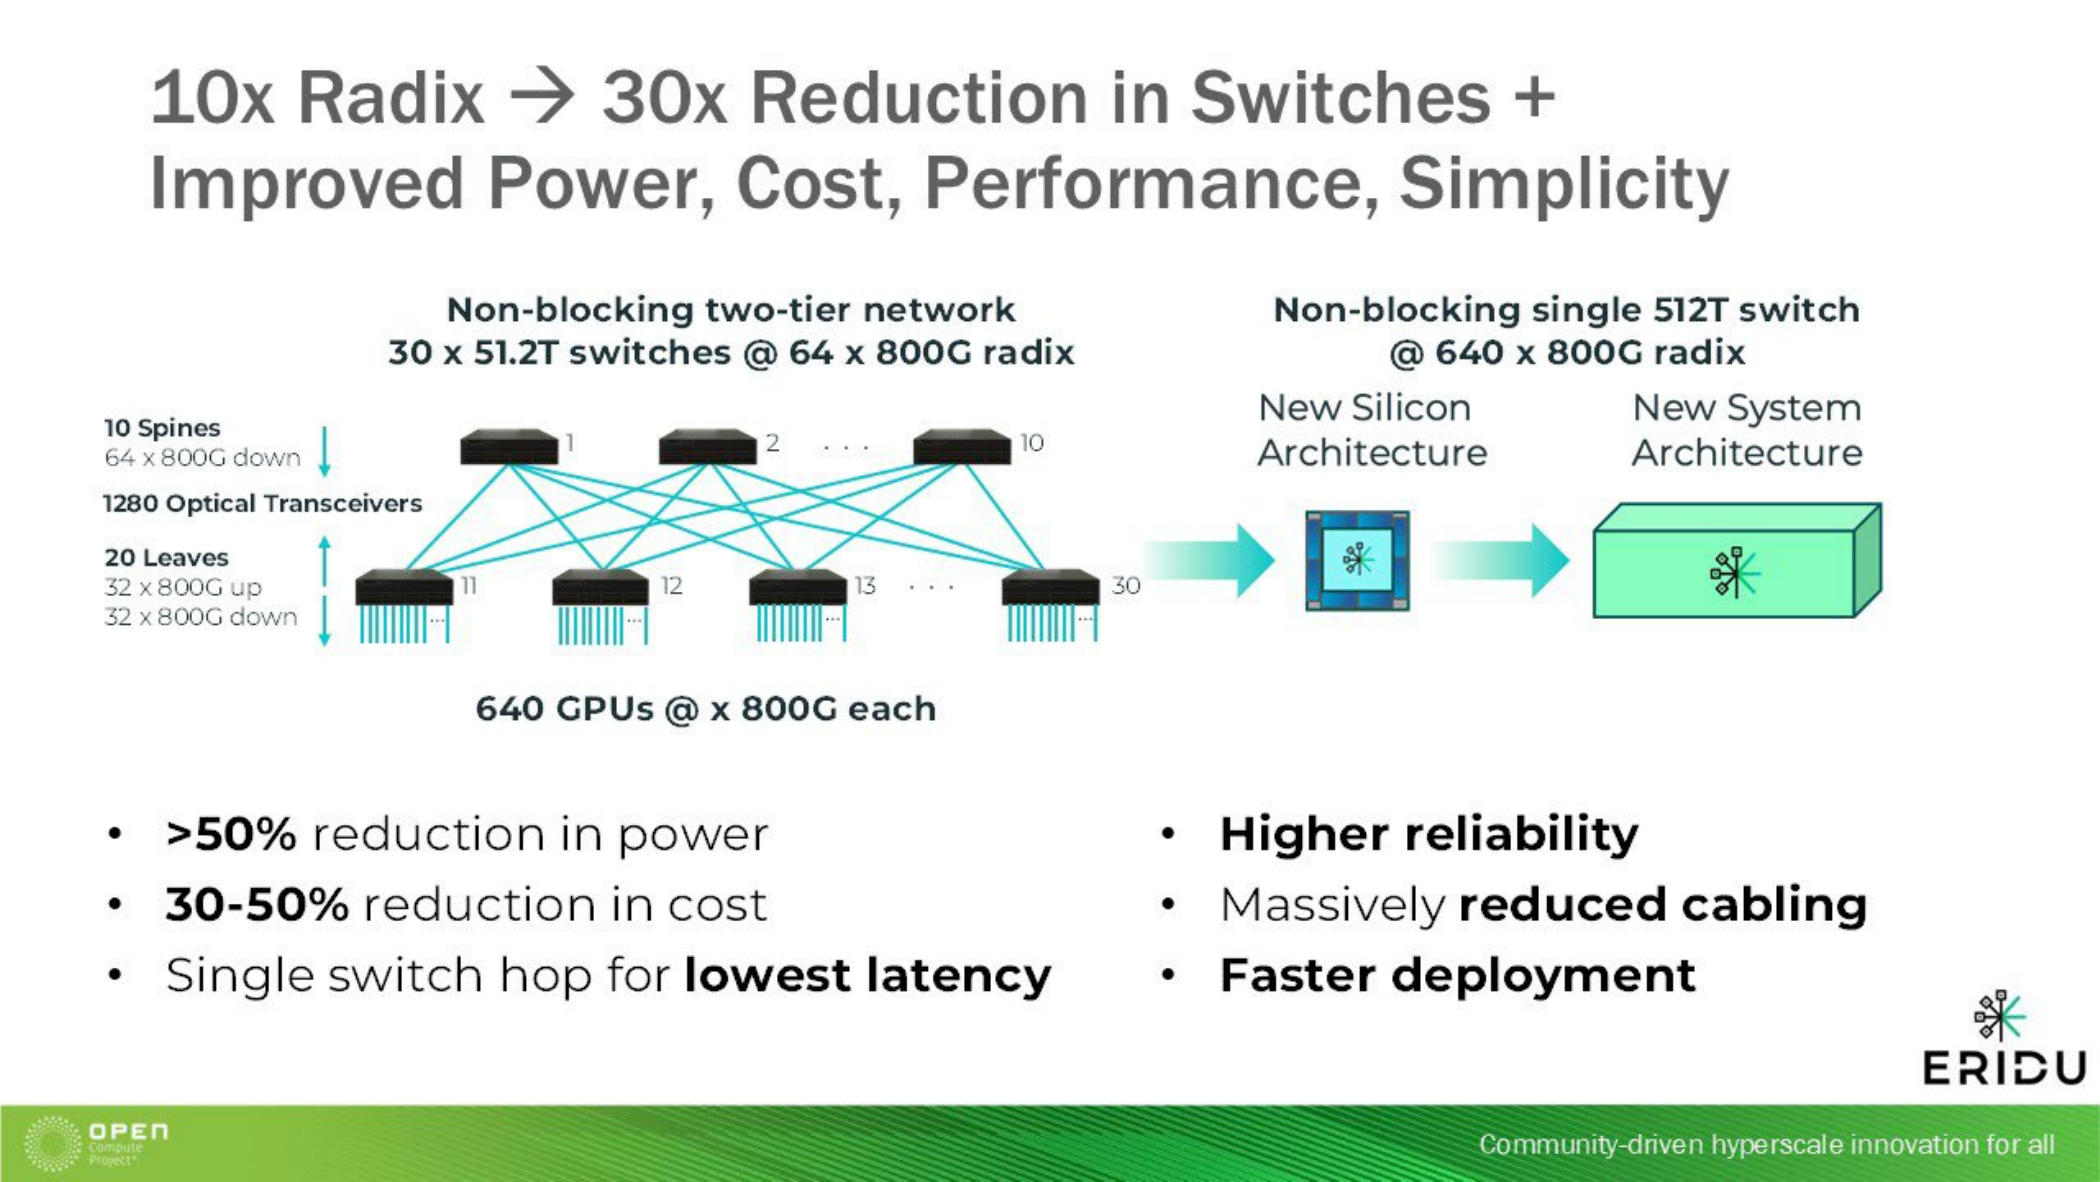
図1の左側ではGPU間の経路が同じリーフ内に収まる場合と、スパインを経由する場合があります。右側では、この例のGPU間通信を一台のスイッチで中継します。講演が狙うのは、接続数を増やしてネットワークを浅くし、装置間の配線や通過箇所を減らすことです。ここで比べているのは、いずれも接続帯域を確保するノンブロッキング構成です。どんな通信でも混雑や待ち時間が消える、という意味ではありません。[1、12–13頁]
大きなスイッチには、装置全体の設計が要る
接続先を増やすには、入口だけを増やせばよいわけではありません。多数のデータを送り分ける処理と、転送を待つデータを蓄えるバッファ、それらを結ぶ入出力が必要です。Eriduは半導体側の課題として、バッファ構成、I/O密度、接続技術、電力、冷却を挙げています。[1、16頁]
装置側にも、前面に多数の接続口を収める密度、内部の接続技術、システム全体の電源と冷却、ソフトウェアという課題があります。講演では、半導体・システム・ソフトウェアを一緒に設計する方針が示されています。高radix化は、チップの仕様表にある帯域の数字だけで完成するものではないのです。[1、16・28頁]
構成の効果と、実測された結果を混ぜない
図1には電力を50%超、費用を30–50%削減するという記載もあります。これはEriduがこの講演で掲げた効果です。この頁には測定環境や費用の明細が示されていないため、あらゆるクラスタで同じ削減率になる数値とは読めません。装置数の構成比較と、実際の消費電力・費用の評価は分ける必要があります。[1、13頁]
別の頁では、5,120基のGPUを想定した学習のシミュレーションも紹介されています。大きなscale-up領域と、72基単位のscale-upにscale-outを組み合わせた構成を比べたもので、資料はパケット単位のシミュレーションと明記しています。実機を測って得た結果ではなく、前提を置いた検討です。[1、25頁]
この講演の比較から考えられるのは、AIネットワークを見るときに「何Tbpsか」だけでなく、「その速度でいくつつながり、何層を通るのか」を確かめることです。radixを増やす価値は、その接続数を使ってネットワーク全体をどう組み直せるかにあります。
Eriduの事業や資金調達については、企業解説で紹介しています。
参考資料
- Cliff Grossner(OCP Foundation)、Alan Weckel(650 Group)、Promode Nedungadi・Jay Gill(Eridu)『Breaking Through the AI Network Wall with High-radix Switching』。OCP Educational Webinar Series、2026年7月28日。本文参照:12–16・25・28頁。
- Open Compute Project『OCP Educational Webinar: Breaking Through the AI Network Wall with High-radix Switching』。開催日・登壇者・公開スライド案内。