サーバーが「時間の80%で忙しい」とき、新しく到着した仕事も80%の確率で処理中のサーバーに出会うのでしょうか。直感的には一致しそうですが、到着のタイミングが規則的だったり、混雑に合わせて変わったりすると、同じ割合にはなりません。
二つの観察を結び付ける性質がPASTA(Poisson Arrivals See Time Averages)です。独立なポアソン到着が見る状態は、長い時間にわたって観察した状態の分布と一致する、という意味です。ここでは「いつ測るか」で混雑の見え方が変わる例から、その条件を整理します。
簡単にまとめると?
- 時間平均は、各状態が続いた時間の長さで数えます。到着時平均は、仕事が到着するたびに、その直前の状態を1回ずつ数えます。
- 独立なポアソン到着などPASTAの条件が成り立つと、この二つの状態分布は定常状態で一致します。到着を加えた後の仕事数を比べる話ではありません。
- 独自の周期到着例では、サーバーが忙しい時間は80%でも、到着した仕事が処理中のサーバーを見る割合は約66.7%です。到着の仕方を確かめず、二つの平均を置き換えることはできません。
時間で数えるか、到着のたびに数えるか
処理中も含めた系内の仕事数をNとします。例えばN=2なら、一つを処理し、もう一つが順番を待っている状態です。時間平均では、N=2の状態が合計何ミリ秒続いたかを、観察時間全体で割ります。
一方、到着時の観察では、新しい仕事が来るたびに、その仕事が加わる直前のNを記録します。N=2を見た到着回数を全到着回数で割れば、到着した仕事から見た割合になります。状態が続いた長さと、到着がその状態に何回出会ったかは、別の数え方です。
PASTAの条件下では、十分長く観察したとき、この二つの割合が各Nについて一致します。例えば時間の20%がN=0なら、到着の20%も直前に空の系を見ます。ただし、個々の短い測定区間の値がぴったり一致するという意味ではありません。
一致しない例を、15ミリ秒の周期で作る
処理担当は1台、各仕事の処理は必ず4ミリ秒で終わり、先着順とします。到着は15ミリ秒ごとの周期で、周期の開始から1、2、3ミリ秒の位置に3件。次の周期は16、17、18ミリ秒に到着する、という規則的な並びです。これはポアソン到着ではありません。
最初の仕事は1ミリ秒で処理を始め、5ミリ秒で終了します。次の仕事は5〜9ミリ秒、三つ目は9〜13ミリ秒に処理されます。次の到着は16ミリ秒なので、毎周期で空の状態へ戻り、同じ動きを繰り返します。
0〜15ミリ秒の一周期を見ると、空の時間は0〜1と13〜15の計3ミリ秒です。N=1は1〜2と9〜13の計5ミリ秒、N=2は2〜3と5〜9の計5ミリ秒、N=3は3〜5の2ミリ秒になります。
| 系内の仕事数 N | 一周期の時間 | 時間で見た割合 | 到着直前に見た割合 |
|---|---|---|---|
| 0 | 3 ms | 20% | 約33.3% |
| 1 | 5 ms | 約33.3% | 約33.3% |
| 2 | 5 ms | 約33.3% | 約33.3% |
| 3 | 2 ms | 約13.3% | 0% |
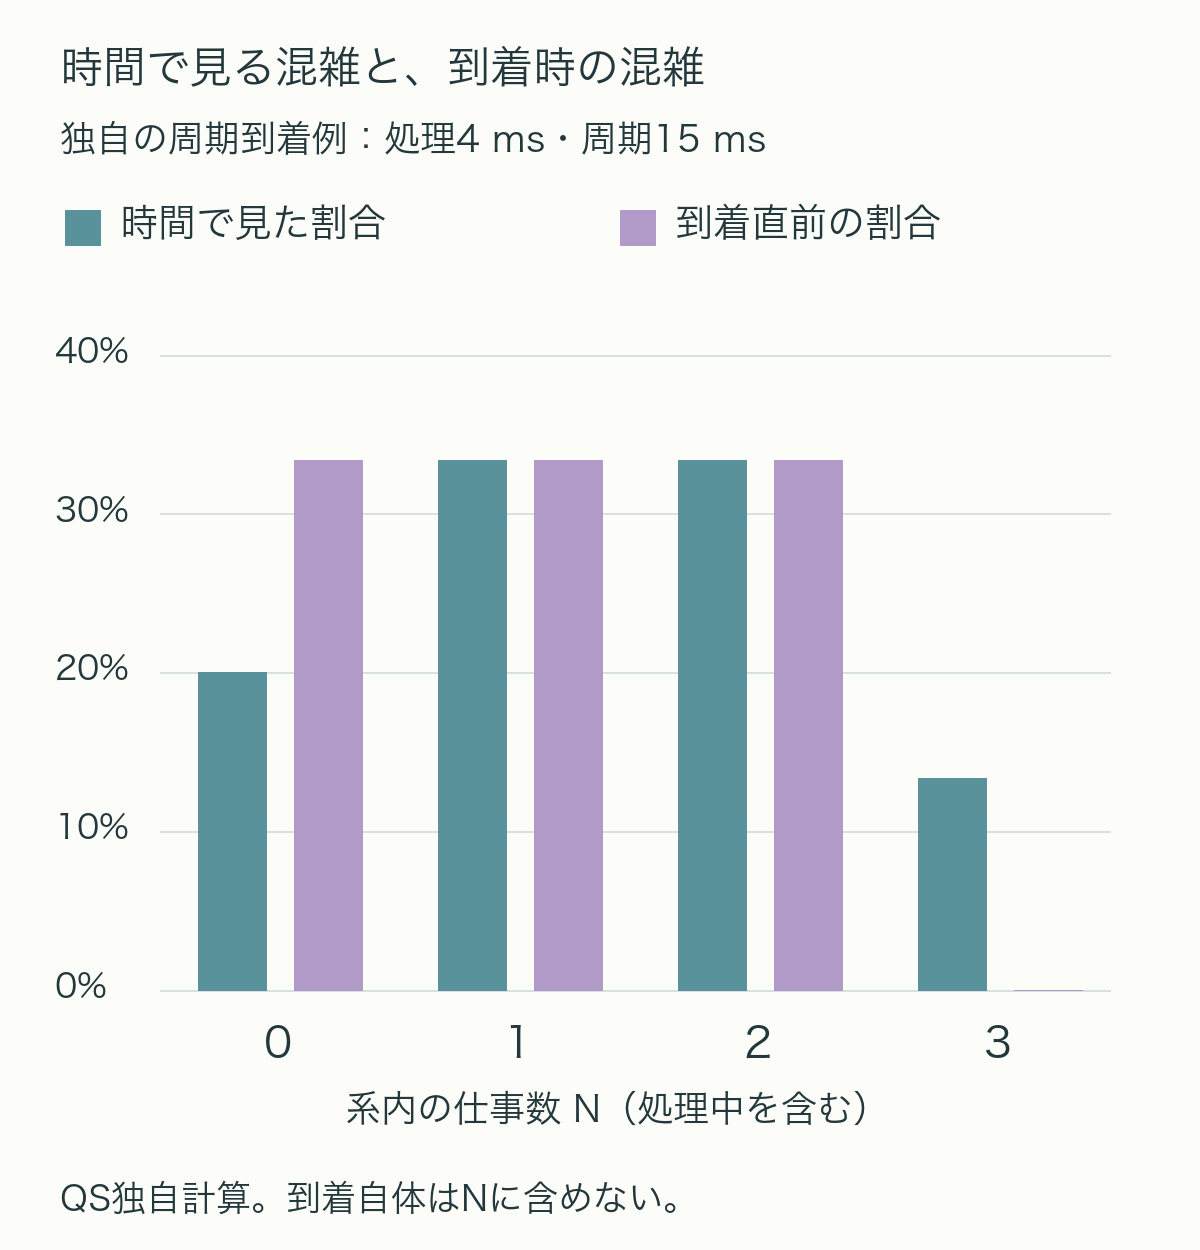
到着直前のNは、順に0、1、2です。N=3の状態は実際に存在するのに、その最中には新しい仕事が来ないため、到着時の観察には現れません。サーバーが忙しい時間は12/15=80%ですが、処理中のサーバーに出会う到着は3件中2件、約66.7%です。観測を長く続けても、この周期を繰り返す限り差は消えません。
ポアソン到着なら、何が変わるのか
一定の到着率を持つポアソン過程では、過去の到着や現在の混雑を手掛かりに、次の到着が特定の状態を選ぶことがありません。系が将来の到着を先読みしないことも前提になります。
この条件で到着時の状態を数えると、長く続く状態にはそれに応じた回数の到着が起きます。時間で観察した状態の重みと、到着が出会う状態の重みがそろうことが、PASTAの背景です。到着を等間隔にすることとは違い、ポアソン過程の到着間隔は指数分布に従ってランダムに変わります。
例えば、平均到着間隔を5ミリ秒、処理時間を一定の4ミリ秒とする1台の系でも、到着を独立なポアソン過程に変えれば、利用率は同じ80%のままです。しかし、先ほどの3件ずつ繰り返す到着とは状態分布が変わり、到着時に処理中のサーバーを見る長期的な割合も80%になります。
到着ログだけで混雑を測ってよい条件
仕事の到着ログに、その直前の処理中・待機中の件数を残せる場合、PASTAの条件が成立すれば、その観測から時間全体の状態分布を推定する道が開けます。逆に、利用率を時間ベースで測った値から、到着時に待ちが発生する割合を考える場合にも、条件の確認が必要です。
定期バッチ、時刻をそろえた送信、混雑時に送信を控える制御などでは、到着が状態を偏って観察する可能性があります。「ランダムな揺れが少しある」だけでポアソン過程とは言えません。到着間隔、集中の仕方、状態に応じた送信制御の有無を、モデルを選ぶ材料にします。
観察対象もそろえます。到着した仕事自身を含めた件数は、到着直前より1件多くなります。待ち行列だけの長さと、処理中を含む系内の長さを混ぜても比較がずれます。到着直前なのか直後なのか、何を件数に含むのかをログの定義に残すことが有効です。
PASTAが一致させるのは、測り方の条件がそろった分布
PASTAは、利用率が同じなら待ち時間も同じ、という主張ではありません。先ほどの周期例では各仕事の待ちは0、3、6ミリ秒ですが、ポアソン到着へ変えた系では別の待ち方になります。平均待ちや長い待ちの割合を求めるには、処理方式や処理時間など、さらに系の情報が必要です。
時間の80%が忙しい、到着の80%が忙しい状態を見る、80%の仕事がある時間以内に終わる。この三つは異なる量です。PASTAは最初の二つを特定の条件で結び付けますが、三つ目の完了時間の保証までは与えません。混雑を説明するときは、数値と一緒に「いつ、何を観察したか」を確かめることが大切です。
出典
- Stanford EE384X Handout 10: Packet Switch Architectures I:16〜18ページの時間平均・到着時平均、PASTAと条件付き確率による説明。版の日付は未確認。本文の4ミリ秒・15ミリ秒の例と図はQSが独自に構成・計算。