量子回路を普通のコンピューターで計算するとき、演算そのものより、大量のデータをメモリから運ぶことが難しくなる場合があります。計算機を増やしても、毎回みんなでデータを交換していては速くなりません。量子系を表す「パウリ列」の分け方を工夫し、この通信を小さな組の中に絞る手法が報告されました。
簡単にまとめると?
- 測りたい物理量をパウリ列の和で表す古典計算で、同じ列をまとめる際の大規模なデータ交換を減らします。
- 0と1の演算に対して線形なハッシュで列を分けると、パウリ回転での交換先を最大一つの相手に限定できます。一般のk量子ビット操作では最大4ᵏ個の区画を一組にします。
- 32ノードで最大1600億本の列を保持する計算を報告しています。ただし近似による打ち切りは残り、量子回路を何でも正確・効率的に計算できるという結果ではありません。
Alev Orfi氏らのプレプリント「Scalable Pauli propagation through F₂-linear partitioning」は、2026年11月12日に投稿されました。v1の本文・付録と公開実装paulistrings-rsを確認し、通信を減らす仕組みと、性能の数字を読む際の条件を整理します。
量子状態全体ではなく、知りたい物理量を動かす
量子系の時間変化を調べる方法には、状態を変化させて追いかける見方と、測りたい物理量を表す演算子の側を変化させる見方があります。後者がハイゼンベルク描像です。例えば、多数の量子ビットのうち一つの磁化を知りたいとき、その物理量が時間とともにどう変わるかを追います。
パウリ伝播では、この演算子をI、X、Y、Zという基本的な演算子の並びの和で表します。「XIZ」なら、一番目にはX、二番目には何もしないI、三番目にはZが作用するという並びです。この一本一本をパウリ列と呼び、それぞれに係数を付けます。
列をビットの並びで表せば、掛け算や交換関係の確認の多くを、ビット演算に落とし込めます。一本を処理する演算は軽くても、列が膨大になると、その列と係数を保存し、読み書きするメモリが制約になります。また、操作後に同じ列が複数できたら、係数を足して一本へまとめる必要があります。列を複数の計算機に配ると、この重複の照合が通信を増やします。
分け方に規則を持たせると、交換する相手が決まる
研究が使うのは、F₂という0と1の世界で線形なハッシュです。ハッシュは、長いデータに短い区画番号を割り当てる規則です。ここでの足し算はXOR、つまり同じビット同士なら0、違えば1になる演算です。データにXORを施してから番号を計算しても、先に計算した番号同士をXORしても、結果が同じになる規則を選びます。
この性質によって、ある固定のパウリ列を掛けたとき、同じ区画の列は全部、同じ相手の区画へ移ります。元の区画番号をb、操作から決まる番号のずれをδとすると、移動先はb XOR δです。例えばδが01なら、00と01、10と11がそれぞれペアになります。列を一本ずつ調べて全員へ送り先を問い合わせる必要がなくなります。
パウリ回転では、元の列と、固定の列を掛けた列の組み合わせが生まれます。そのため、各区画は自分自身と最大一つの相手だけを扱えばよく、重複の統合もそのペアの中で行えます。ずれが0なら区画間の交換も要りません。ただし、相手は操作ごとに変わります。同じ二台が最初から最後まで組み続けるという意味ではありません。
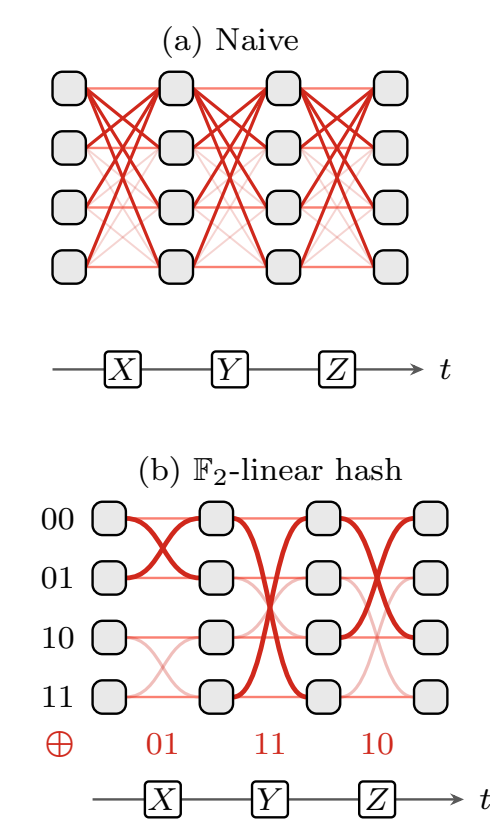
より一般にk個の量子ビットに作用する操作では、一つの独立した作業が扱う区画を最大4ᵏ個に抑えられます。これは、計算全体の列数や通信量が一定になるという主張ではありません。一回の操作で、どの区画同士が連絡を取り得るかという範囲の上限です。
すべての同期が消えるわけでもありません。ゲートごとの処理の区切りや、測定値を足し合わせる場面には調整が残ります。論文は、列の全体的な再配分を避け、必要な相手との交換や小さな集計に置き換えることを狙っています。
32ノード・1600億本は、どのような比較か
論文の大規模な例は、16×16の格子上の横磁場イジング模型です。AMD EPYC 9474Fを使う96コア・メモリ1.47 TiBのノードを増やし、各ノードが保持する列の予算を固定して比較しています。最大の設定は1ノード当たり50億本、32ノードで合計1600億本です。
ここで報告された68〜74%は「弱スケーリング効率」です。ノード数を増やすと同時に、保持できる列の総数も増やし、一ステップにかかる時間がどれだけ一定に近く保たれるかを見ています。同じ仕事が32倍速くなったという数字ではありません。仕事の総量を固定して速さを比べる強スケーリングの測定とは、条件を分けて読む必要があります。
最大設定で重複をまとめ、打ち切りを行った後の保存量は約10.5 TiBですが、実行中のピークは約28.8 TiBでした。利用可能なメモリ全体は約47 TiBです。保存後の列だけを見て、必要なメモリを見積もると小さく見積もりすぎる場合があります。計算途中の配列や通信にも余裕が必要です。
残す列を増やすと、精度を確かめられる範囲も広がる
パウリ列は時間発展によって増えるため、実際の計算では、係数が小さい列を捨てたり、保持する本数に上限を設けたりします。今回の分割法自体は通信の構造を変えるものですが、ベンチマークで使う打ち切りは近似です。列を多く保持できることと、結果が厳密に正しいことは同じではありません。
別の14×14格子の例では、打ち切りのしきい値を小さくして列を増やすと、磁化の値が収束する時間範囲が延びました。最小のしきい値では約1640億本に達し、64ノードへ分散しています。これは先ほどの32ノードによる弱スケーリングの実験とは別の設定です。
他のテンソルネットワーク法との比較でも、それぞれの収束を確かめられる範囲では値が合っています。しかし、その先の時間では手法ごとの近似の違いから予測が分かれ、参照計算も正確さを保証する基準ではなくなります。長い時間の曲線を描けたことを、その全区間で正確さを実証したことと取り違えない点が大切です。
公開コードを使うときは、版と計算条件をそろえる
実装paulistrings-rsは、Rustの計算部分とPythonのインターフェースを持ち、MITまたはApache 2.0のライセンスで公開されています。これは研究の仕組みを調べたり、自分の問題へ適用する入口になります。一方、コードの公開と、大規模ベンチマークの第三者による再現は別です。本記事で報告値を再計算したわけではありません。
2026年11月14日に確認したREADMEにはCUDAバックエンドの記述もあります。論文v1ではGPUへの拡張を今後の方向として論じているため、現在のリポジトリの機能を、そのまま論文のCPUベンチマークで検証済みの結果へ加えることはできません。試す際には、コードの版、CPU・GPUの構成、残す列の基準、ピークメモリ、比較する物理量を記録する必要があります。
通信を最小にする区画の分け方が、必ずしも最速とも限りません。分け方を偏らせすぎると、一部の計算機だけに列が集まってしまいます。通信の少なさと、仕事の均等さを両立することが重要です。今回の成果は、量子系の近似計算を支えるメモリと通信の使い方を改善し、より大きな計算と精度の比較を可能にするものと位置付けられます。
実験で使われたCPUのメーカーについては、CyclewaveのAMDの事業とデータセンター向け製品の解説も参考になります。
出典
- A. Orfiほか, Scalable Pauli propagation through F₂-linear partitioning, arXiv:2611.17262v1, 2026年11月12日投稿。本文・Appendix A–C。PDF内の日付は11月13日。プレプリント、CC BY 4.0。
- paulistrings-rs公式リポジトリ、README・LICENSE-MIT・LICENSE-APACHE、2026年11月14日確認。READMEのGit blob SHAはca5fbeaf502b4a54acdd37ab5e9977abf9bc2485。公開実装の状態の確認に使用し、性能値の独立再現には使用していません。