量子誤り訂正の方式を比べるには、たくさんの誤りの例を作り、それぞれをどこまで正しく推定できるか調べる必要があります。GPUを増やせば計算は速くなりそうですが、CPUが入力を準備し、結果を回収する部分が順番待ちになると、GPUを十分に働かせられません。
AMDとIBM Researchの研究者が2026年11月12日に公開したプレプリント「Pêlagos」は、量子誤り訂正の復号評価を複数のAMD GPUへ振り分ける方法を扱います。中心となる変更は、1台のGPU内の計算そのものよりも、その前後を含む処理の組み立て方です。8 GPUの評価では、条件によって1 GPU時の約7倍の処理能力を報告しています。ただし、これは多数の例を処理する速度の話であり、量子計算機の誤りを実時間で直す実証とは区別が必要です。
簡単にまとめると?
- Pêlagosは、量子誤り訂正の復号を大量に評価するための実装です。GPUごとの常駐プロセスとCPU側の並列準備で、入力と結果回収の待ち時間を減らします。
- MI355Xの8 GPUでは、大きい方の符号で処理全体のスループットが1 GPU時の7.01倍。GPUの計算部分だけを測った7.45倍とは、測定範囲が異なります。
- 公開コードはありますが、評価は特定の符号・誤りモデル・装置構成での結果です。1件の復号遅延、実機の量子誤り訂正、別方式への優位性をまとめて示したものではありません。
復号の大量評価では、何を繰り返し計算するのか
量子誤り訂正では、量子情報を直接読み出す代わりに、誤りの手がかりとなる測定結果を集めます。この手がかりをシンドロームと呼び、そこから起きた誤りを推定する計算が復号です。候補が測定結果とつじつまを合わせられても、守りたい論理情報まで正しく復元できるとは限りません。したがって、復号が終了した数と、論理的に正しく復号できた数は別に確かめます。
本研究が使うRelay-BPは、誤りの候補と検査の関係を表すグラフ上で、確からしさの情報をやり取りする方式です。BPはbelief propagationの略で、少ない反復で解ける例もあれば、別の条件でやり直す必要がある例もあります。Pêlagosは、この既存の復号方法を使って多数の独立した例を処理します。復号アルゴリズムを新しく考案した、という位置づけではありません。
GPUごとに担当を固定し、CPUの準備も分担する
複数GPUへ仕事を渡す前には、CPUで入力を整え、データを移し、計算後には結果を取り出す処理があります。これらを1つずつ進めると、GPUの台数に合わせてCPUの仕事が増え、全体の速さを制限します。
Pêlagosでは、GPU1台につき1つのプロセスを常駐させます。各プロセスは担当GPUと復号に使うグラフを保ち、何度も仕事を受け取ります。CPU側のスレッドは、GPUごとに分けた入力を並行して準備します。大きな出力は共有メモリーの決められた領域へ書き込み、小さな制御情報だけを別の通信経路で渡して、最後にCPUが順序をそろえます。
この構成では、各GPUが独立した入力群を処理します。1件の復号を8台に分割して、その途中結果をGPU間で交換する構成ではありません。各GPUに同じ件数を割り当てても、難しい例が多い担当は長くかかるため、全体の完了は最も遅い担当にも左右されます。
また、GPU内の計算カーネルやデータ配置は、この複数GPU化のために作り直していません。同じ計算を運ぶ仕組みを変えることで、どこまで全体を速くできるかを調べています。
「8 GPUで約7倍」の分母をそろえて読む
評価対象は、qLDPC符号の一種であるbivariate bicycle符号です。小さい方の[[144,12,12]]は、144のデータ量子ビットで12の論理量子ビットを符号化し、符号距離が12。大きい方は[[288,12,18]]です。この表記は、補助量子ビットを含めた実機全体の規模を表す数字ではありません。
論文では、物理誤り率0.003の回路レベルのPauli誤りモデルを使い、相関したX・Y・Z誤りを扱います。GPU1台あたりのシンドロームを1,024件に固定し、1台から8台へ増やすと、総件数も1,024件から8,192件へ増やします。つまり、同じ総件数を8分の1の時間で解けるかという試験ではなく、仕事量も増やしたときの処理能力を測っています。
| MI355X、8 GPUの指標 | 小さい符号 | 大きい符号 |
|---|---|---|
| 処理全体:最適化後の1 GPU比 | 6.23倍 | 7.01倍 |
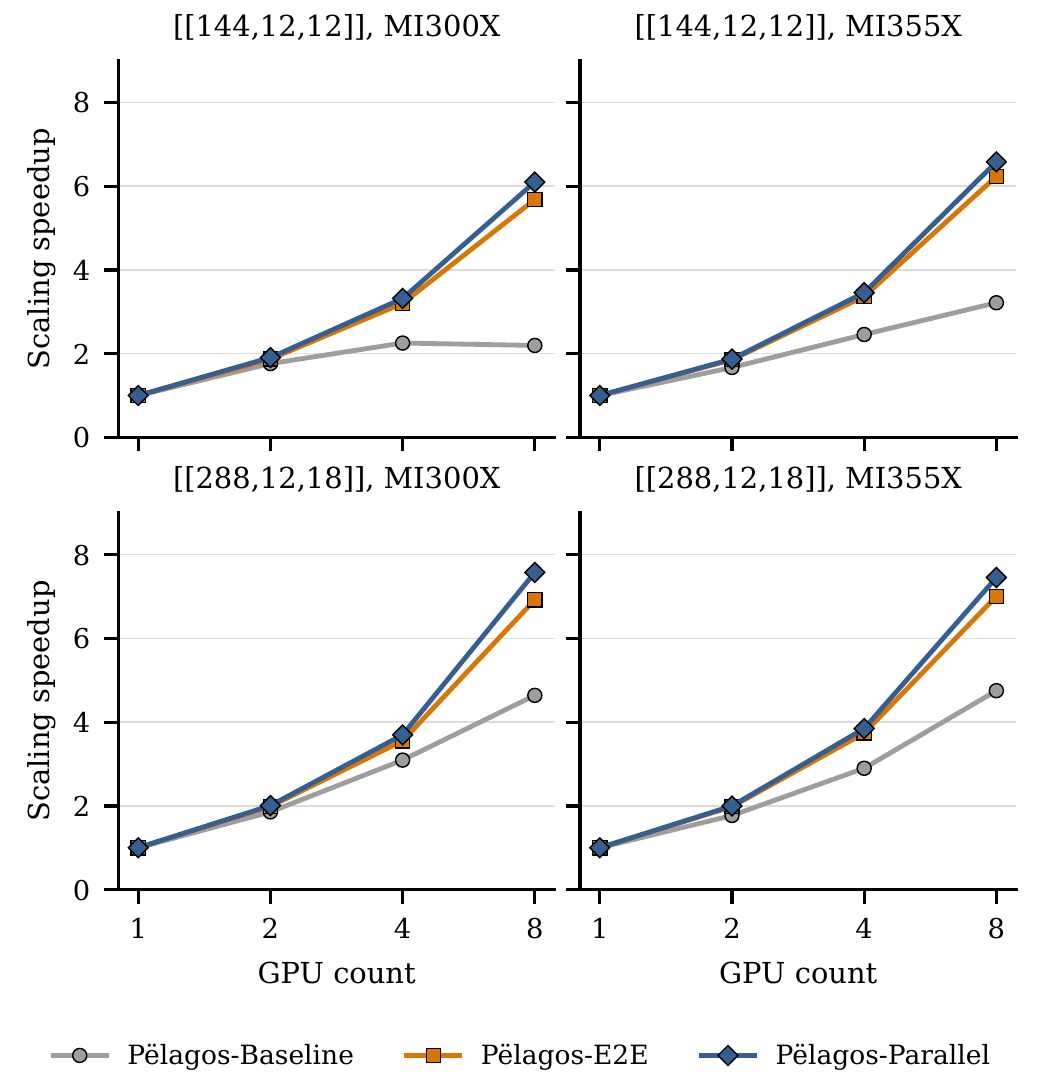
| GPUの計算部分:同じ指標の1 GPU比 | 約6.6倍(図2) | 7.45倍 |
| 処理全体:従来実装の8 GPU比 | 2.07倍 | 1.36倍 |
「処理全体」は、CPUの準備、仕事の振り分け、GPUの復号、出力の処理を含む計測です。一方、GPUの計算部分だけの指標は、複数の担当のうち最も長い復号時間を分母にします。後者が速くても、CPU側に待ちが残れば、利用者が仕事を投入して結果を受け取るまでの改善は小さくなります。
たとえばMI355Xで小さい符号を処理すると、従来実装のCPU前処理は1 GPU時の0.129秒から8 GPU時の0.974秒へ増えます。最適化後は0.132秒から0.222秒でした。仕事量は8倍になっているのに、準備時間の増加を小さくできたことが、GPUを増やした効果を全体へつなげています。
まとめて渡す件数にも、上限と効き方がある
GPUへ一度に渡す件数を増やすと、並行して動く仕事が増え、装置を使いやすくなります。しかし、入力や中間データも大きくなり、高速なキャッシュに収まりにくくなります。論文の別の評価でも、件数を増やしたときの改善は次第に緩やかになりました。著者らはメモリー帯域の影響を説明に挙げていますが、これだけであらゆる条件の律速原因が確定したとはいえません。
今回の実装には、GPUメモリーの総容量とは別に、符号付き32ビットのインデックスに由来する上限もあります。グラフの辺の数をE、1 GPUに渡す件数をBとすると、E×Bを表現できる範囲に収める必要があります。論文での上限は小さい符号が5,114件、大きい符号が1,707件でした。メモリーが空いていても、扱う番号の形式が先に制約になる例です。
公開コードで確かめられること、測り直す必要があること
コードはApache License 2.0で公開されており、論文が示す版はコミット0127224です。その版の説明では、プロセスを使う実行方式は選択可能な追加機能で、標準の実行方式はスレッドです。Linux/POSIX、CPU上の入力と結果などの前提も示されています。単に最新版を入れれば論文と同じ構成になる、と読み替えないことが大切です。
測定では常駐プロセスを使い、ウォームアップ1回の後、3回の測定の中央値を取っています。起動や初回コンパイルを含む待ち時間ではありません。また、MI300XとMI355Xの計算機はCPUの機種・コア数も異なるため、両者の差をGPUだけの効果として分離することはできません。
論理誤りについても、大きい方の符号で失敗が観測されなかった条件は、誤り率が厳密にゼロという意味ではありません。小さい符号では失敗数が少なく、GPU台数ごとの誤り率の細かな比較に十分な統計とはされていません。速度と精度は、同じ入力条件と十分な試行数をそろえて確認する必要があります。
Pêlagosが示す価値は、量子誤り訂正の方式や設定を大量の例で評価するとき、GPUの外にある準備と回収まで見直すと、複数GPUの能力を使いやすくなることです。1件ごとの実時間復号に使うなら、平均的な処理能力に加えて、最も遅い応答、初回起動、測定装置との接続を別に調べる必要があります。ここで紹介したのは著者らの評価結果であり、公開コードを用いた独立した性能再現ではありません。
今回の共同研究を企業の取り組みから知りたい方には、CyclewaveのAMDの企業解説とIBMの企業解説も参考になります。
出典
- Xulong Tangほか「Scaling Pêlagos: Multi-GPU Orchestration for Relay Belief-Propagation Decoding」、arXiv:2611.16285v1、2026年11月12日公開。AMD・IBM Researchによる共同プレプリント。数値・条件・図はこの1報に基づきます。
- Pêlagos公開コード:論文が示すコミット0127224。同版のREADME、docs/process-backend.md、LICENSEを参照。2026年11月14日確認。