読み書きを許可したメモリ領域なのに、その中へのアクセスが拒否される。RISC-VのPMP(Physical Memory Protection、物理メモリ保護)では、権限のビットだけを見ても、この理由が分からないことがあります。複数の領域が重なるときの優先順位と、一度のメモリ操作が触れる範囲も判定に入るためです。
PMPは、プロセッサの実行単位であるhartごとに、物理アドレスの領域へ読み取り・書き込み・命令実行の権限を設定する仕組みです。ここでは基本のPMPを扱い、二つの領域と小さなアクセス例から、設定を読む順序を整理します。[1]
簡単にまとめると?
- アクセス範囲のどれか1バイトに一致する設定のうち、番号が最も小さいPMPエントリーが判定を担当します。広い領域の許可を足し合わせる仕組みではありません。
- 選ばれたエントリーが、そのメモリ操作の全バイトを覆う必要があります。一部しか覆わなければ、権限ビットやMモードの条件を見る前に失敗します。
- 一つの命令が複数のメモリ操作へ分かれる場合は、それぞれを検査します。例外が起きても、先に通った書き込みまで元に戻るとは限りません。
PMPで組み合わせるのは、領域とアクセス権限
PMPの設定単位をエントリーと呼びます。エントリーにはアドレス範囲を指定する情報と、読み取りのR、書き込みのW、命令実行のXなどを持たせます。たとえばR=1、W=0、X=0なら、その権限が適用されるアクセスに対して、読み取りを許し、書き込みと命令実行を拒否します。[1]
領域の指定にも方式があります。NAPOTは、サイズが8バイト以上の2のべき乗で、開始位置もそのサイズの境界にそろった領域を表します。TORは、前のエントリーのアドレス設定を下端、現在の設定を上端として範囲を表します。OFFにしたエントリーはアドレスに一致しません。今回の例は、二つの領域を独立に指定しやすいNAPOTを使います。[2]
以下のアドレスは説明用で、特定の機器のメモリ配置ではありません。例の大きさを表現できる粒度のPMPが実装され、使用する二つ以外のエントリーはOFFとします。まずは通常のユーザー側のUモード、またはOS側のSモードを実効権限とするアクセスを考えます。ここで実効権限とは、実行中のモード名だけでなく、そのメモリアクセスの検査に使われる権限です。
| エントリー | 物理アドレスの範囲 | 大きさ | R / W / X | L |
|---|---|---|---|---|
| 0:小さい領域 | 0x1800〜0x1BFF | 1,024バイト | 1 / 0 / 0 | 0 |
| 1:広い領域 | 0x1000〜0x1FFF | 4,096バイト | 1 / 1 / 0 | 0 |
小さい領域は、広い領域の内側にあります。広い領域を読み書きできるようにしつつ、その一部を読み取りだけにしたい、という配置です。Lは後で扱うロックのビットで、ここでは両方0にしています。
重なった領域では、番号の小さい設定が先に決まる
PMPは、メモリ操作が触れるどれか1バイトに一致するエントリーを探し、その中で番号が最も小さいものを選びます。小さい領域が自動的に優先されるのではなく、番号が優先順位を決める点が大切です。[3]
たとえば0x1800〜0x1803へ4バイトを書き込む場合、エントリー0と1の両方が全体に一致します。選ばれるのは0です。そこでW=0を確認するため、この書き込みは拒否されます。後ろにあるエントリー1のW=1へ判定をやり直すことはありません。
この配置で二つの設定の番号を入れ替えると、広い領域が先に選ばれます。すると内側も書き込み可能となり、小さい領域の読み取り専用設定はそのアクセスを止められません。例外となる領域を重ねる設計では、範囲だけでなく並び順まで確認する必要があります。
境界をまたぐと、権限があっても通らない
優先エントリーが決まった後には、もう一つの条件があります。そのエントリーが、一つのメモリ操作の全バイトに一致しなければなりません。先頭アドレスだけが入っていればよいわけではありません。[3]
0x17FCから8バイト、つまり0x17FC〜0x1803を一つのメモリ操作として検査する場合を見ます。前半4バイトは小さい領域の外、後半4バイトは内側です。後半に一致するエントリー0が最優先になりますが、エントリー0は前半を覆えません。このため操作全体が失敗します。エントリー1が8バイトすべてを覆っていても、この結果は変わりません。
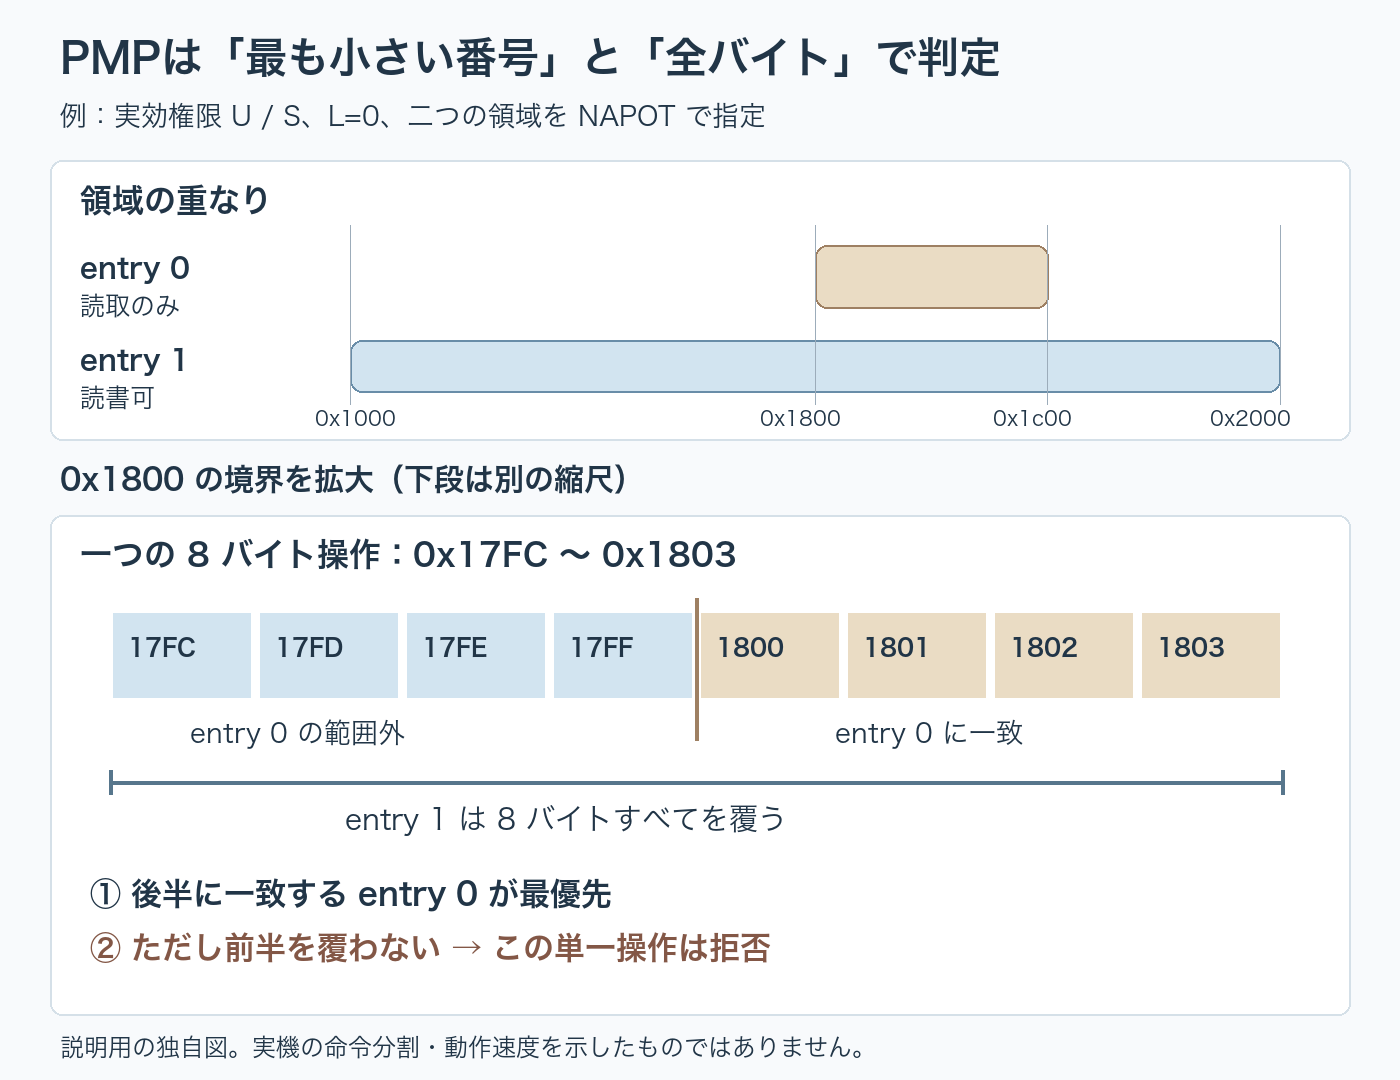
この全バイト一致の条件は、L、R、W、Xの値にかかわらず適用されます。したがって同じ8バイトの単一操作なら、読み取りでも失敗し、実効権限がMでL=0の場合も失敗します。Mモードの権限上の扱いを先に当てはめて、境界の検査を省くことはできません。
| アクセスするバイト | 種類 | 優先エントリー | PMPの判定 |
|---|---|---|---|
| 0x17FC〜0x17FF(4バイト) | 書き込み | 1 | 許可。全体が一致し、W=1 |
| 0x1800〜0x1803(4バイト) | 読み取り | 0 | 許可。全体が一致し、R=1 |
| 0x1800〜0x1803(4バイト) | 書き込み | 0 | 拒否。W=0 |
| 0x17FC〜0x1803(8バイト) | 読み取り/書き込み | 0 | 拒否。全体を覆わない |
| 0x1C00〜0x1C03(4バイト) | 書き込み | 1 | 許可。小さい領域の外で、W=1 |
| 0x2000〜0x2003(4バイト) | 読み取り | 一致なし | 拒否。PMPが実装されていて、許可する領域がない |
ここでの「許可」はPMP検査についての結果です。実際のアクセスには物理メモリ属性(PMA)などの条件も関わるので、PMPを通ったことだけで命令全体の成功が保証されるわけではありません。[1]
MモードとLビットは、全バイトが一致した後で読む
Mモードは、PMPの制御レジスターを操作する機械モードです。ただしPMPの判定では、M、S、Uをすべて同じ扱いにはしません。全バイトが一致したエントリーについて、実効権限がMでL=0なら、R/W/Xによる制限を受けずに通ります。L=1ならMにもその権限を適用します。実効権限がSまたはUの場合は、Lが0でも1でもR/W/Xを適用します。[4]
表1のエントリー0へ収まる4バイトの書き込みなら、実効M・L=0では通り、実効U/SではW=0により拒否されます。エントリー0をL=1にした場合は、実効Mの書き込みも拒否されます。この違いと、先ほどの「全体を覆わないために拒否」を分けると、設定を読み違えにくくなります。
Lには、設定を固定する役割もあります。L=1にすると、そのエントリーの設定と対応するアドレスレジスターへの書き込みは無視され、hartをリセットするまでロックが続きます。TORのエントリーをロックした場合は、下端を決める一つ前のアドレスレジスターも変更できなくなります。OFFのエントリーでもLによるロックは成立します。領域の形と、後で変更する必要がある設定を確認してから使うビットです。[4]
どのエントリーにも一致しない場合は、実効Mのメモリ操作はPMP上は成功します。一方、PMPエントリーが少なくとも一つ実装されていれば、実効S/Uの操作は失敗します。全エントリーをOFFにすることは、S/Uへ全面的な許可を与えることにはなりません。PMP自体を実装しない場合とは区別が必要です。[3]
また、「Mモードでコードを実行中だから、データアクセスも実効M」とは限りません。mstatusのMPRV=1かつMPP=S/Uなら、MモードからのデータアクセスにもそのS/UのPMP検査が適用されます。仮想アドレス変換に伴うページテーブルへのアクセスは、実効Sとして検査されます。命令フェッチとデータアクセスを一括りにせず、検査されるアクセス側の権限を確認します。[1]
一つの命令が失敗しても、書き込みの全部が取り消されるとは限らない
これまでの表は、一つのメモリ操作ごとの判定です。プログラム中の一つの命令が、常に一つのメモリ操作になるとは限りません。仕様は、実装によって非整列のロード・ストア・命令フェッチが複数の操作へ分かれ、それぞれにPMP検査が行われる場合を定めています。[3]
先ほどの0x17FCからの8バイト書き込みについて、ある実装が0x17FC〜0x17FFと0x1800〜0x1803の二つの4バイト操作へ分け、実効U/Sで検査したと仮定します。前半はエントリー1により許可され、後半はエントリー0のW=0で拒否されます。失敗した側がアクセスフォールトを起こしても、通った側の書き込みが既に見える状態になっている可能性があります。
これは、どの実装もこの分割や順序で動くという意味ではありません。0x17FCは8バイト境界に整列していないため、実機では非整列アクセスの例外処理も関わります。上の例は、指定した単一操作または分割操作がPMP検査へ渡った場合を比べたものです。また、XLENより広いストアでは、自然に整列していても一部だけが成功する同様の状況があり得ると仕様は説明しています。[3]
そのため、エラー処理を考える際に「例外が出たので、メモリは必ず書き込み前のまま」と置くことはできません。境界をまたがないデータ配置を検討することに加え、対象実装がどのアクセスを分割し、何を原子的に扱うかを確認する必要があります。
設定を確認するときは、範囲・順序・権限・実装条件を分ける
アクセスが意図どおりに制限されないときは、まず物理アドレスとバイト数を取り出し、一部でも一致するエントリーを番号順に見ます。次に、最初に一致した領域が全体を覆うかを確かめます。その後で実効権限、L、R/W/Xを読むと、「範囲の失敗」と「権限の失敗」を切り分けられます。
実機の設定へ進む際は、PMPの実装有無、エントリー数、粒度、書き込み後に読み戻される値も別に確認します。標準の符号化に4バイト領域があることは、すべてのプラットフォームでその粒度が使えるという意味ではありません。ページ方式の仮想メモリを実装するhartでは、PMP設定変更後にSFENCE.VMAなど必要な同期も確認します。仮想メモリをその時点で有効にしているかだけで、省略を判断しないことが大切です。[2][5]
本記事の図と表は、固定版の仕様に基づく説明用の判定です。実機・エミュレーターの試験結果ではありません。Smepmpによる追加規則、DMAやIOMMUを含む機器全体の保護は範囲に含めていません。PMPを読む際の要点は、許可ビットを探すだけで終えず、どの領域が判定を担当し、どこまでを一つの操作として覆っているかを確かめることです。
参考資料
- RISC-V International, The RISC-V Instruction Set Manual, Volume II: Privileged Architecture — Physical Memory Protection。公式ドキュメントv20260120、§2.1.7および§2.1.7.1。PMPの対象、実効権限、制御レジスターとR/W/X。
- 同、Address Matching、§2.1.7.1.1、表13・14。OFF、TOR、NA4、NAPOTと実装粒度。
- 同、Priority and Matching Logic、§2.1.7.1.3。最小番号の優先、全バイト一致、不一致時の扱い、分割アクセスの副作用。
- 同、Locking and Privilege Mode、§2.1.7.1.2。Lによる固定とMモードへの権限適用。
- 同、Physical Memory Protection and Paging、§2.1.7.2、およびPrefaceのVersion 1.12の変更説明。ページテーブルアクセスとPMP変更後の同期。各参照は同一仕様内の関連節であり、別々の実装実証ではありません。