センサーから測定値が一つずつ届くとき、知りたいのは平均だけとは限りません。値がどれくらい揺れているかも、その場で追いたくなります。過去の測定値をすべて保存して毎回計算し直す代わりに、件数・平均・ばらつきの集計値を更新していく方法がWelford法です。大きな値のまわりにある小さな変化を計算するときにも、この更新の仕方が役立ちます。
簡単にまとめると?
- Welford法は、新しい値と現在の平均との差を使い、件数・平均・偏差平方和を一つずつ更新します。
- 「二乗の合計」から大きな数を引く式は、数学的には正しくても丸め誤差で分散を失うことがあります。
- 集めたデータ自体の分散なら件数で割り、母集団の分散を不偏推定するなら、条件を満たす標本について件数から1を引いた数で割ります。
平均の近くにある、わずかな違いを測る
分散は、値が平均からどれだけ離れているかを表す量です。それぞれの値から平均を引き、その差を二乗して足したものを偏差平方和と呼びます。ここでは、この合計を M2 と書きます。測定値の単位が秒なら、M2や分散の単位は秒の二乗です。平方根を取った標準偏差は、元と同じ秒で読めます。
たとえば、説明用の3点を 100000001、100000002、100000003 とします。平均は 100000002 で、平均との差は −1、0、1。したがって M2 は 1+0+1=2 です。全体に大きな一定値が加わっていても、この3点の間の広がりは変わりません。
この3点そのものの分散は M2/3=2/3 です。一方、独立に同じ分布から得た標本を使って、有限な母分散を不偏推定する場合は M2/(3−1)=1 を使います。「分散が2/3か1か」という違いは、ここでは計算の失敗ではなく、何を求めるかによる分母の違いです。
同じ式のはずなのに、答えが0になる
M2は、各値の二乗を足した後、「値の合計の二乗を件数で割ったもの」を引いても求められます。
M2 = Σx² − (Σx)²/n
この形なら合計と二乗の合計を覚えておくだけで済みます。ただし、例のように平均が大きく、ばらつきが小さいデータでは、二つの大きな数を引いて小さな差を取り出す計算になります。コンピューターが途中の値を有限の桁数へ丸めると、残したい差に対して誤差が大きくなることがあります。Chan・Golub・LeVequeの論文は、この計算方法の問題と代わりの方法を比較しています。[1]
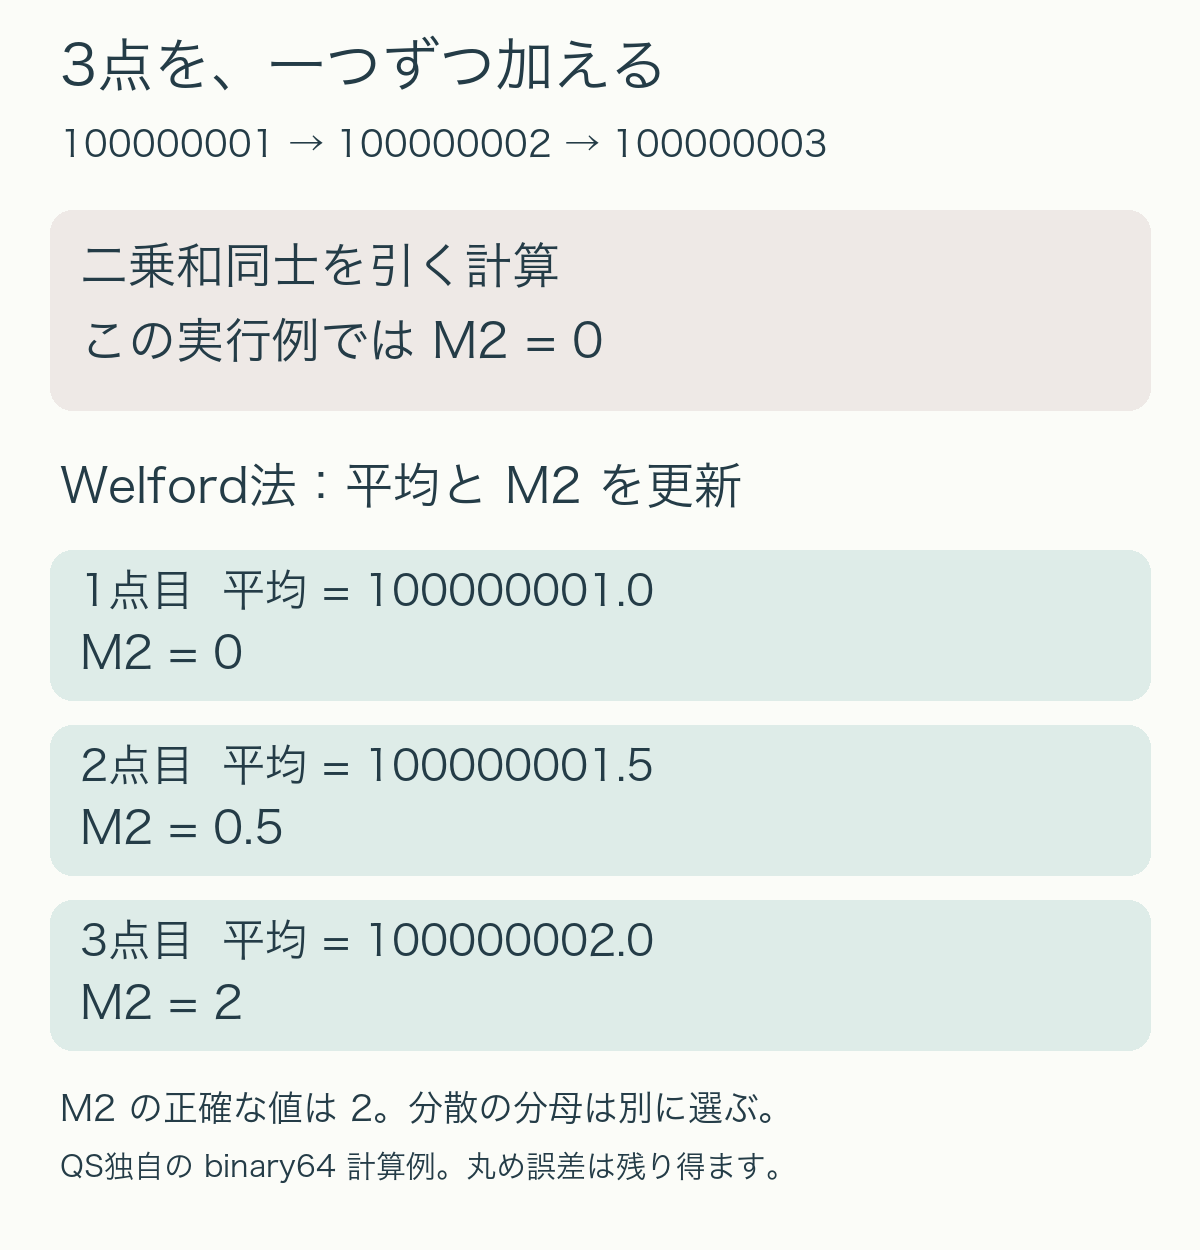
上の3点をPythonのbinary64浮動小数点で順に足して計算した独自例では、この式のM2は0になりました。入力した整数自体は正確に表せていても、二乗と合計の段階で丸めが生じます。同じデータで、平均との差を二乗して足す方法とWelford法ではM2=2が得られました。これはこの入力と計算順での結果で、あらゆるデータで同じ誤差になるという意味ではありません。
新しい値が来たら、平均と広がりを一緒に直す
Welford法で持ち続けるのは、件数 n、平均 m、偏差平方和 M2 です。次の値 x を受け取ったら、まず「いまの平均からどれだけ離れているか」を δ=x−m と置きます。件数を1増やして、新しい平均を m′=m+δ/(n+1) にします。
次に、M2へ δ×(x−m′) を加えます。最初の差δは更新前の平均から測り、後の差は更新後の平均から測るところがポイントです。平均が動くと、過去の点が新しい平均からどれだけ離れているかも変わります。この補正まで含めた合計を、過去の点を読み直さずに更新できます。[1, 3]
最初の点だけなら平均はその値、M2は0です。例の2点目では、古い平均との差が1、新しい平均との差が0.5なので、M2へ0.5を加えます。3点目では差が1.5と1になり、さらに1.5を加えてM2=2。平均と小さな差を中心に計算するため、先ほどの巨大な二乗和同士の引き算を避けられます。
3点を処理し終えた状態は、n=3、m=100000002、M2=2です。次の測定値が届いても、この三つから更新を続けられます。GNU Scientific LibraryのRunning Statisticsも、一度に一つの値を加えて統計量を更新する機能を提供しています。GSL 2.8の実装では、同じ偏差平方和の更新を代数的に等価な形で計算し、分散はM2/(n−1)で返します。[2, 3]
保存する量を減らしても、失われた精度までは戻せない
Welford法は、到着するデータ全体の平均と分散を更新したい場面に向きます。件数に比例する配列を持たず、一定量の集計用メモリーで続けられるためです。ただし、残るのは集計値なので、後から「昨日の3番目の測定値」を取り出すことはできません。元データの追跡が必要なら、保存の仕組みは別に用意します。
また、これは全データを同じ重みで集計する更新です。「直近100点だけ」や「最近の値ほど重くする」という要求には、その範囲や重みに対応する別の更新則が必要です。データが2点未満なら、n−1で割る標本分散も定義できません。ライブラリが返す0などの規約と、測定のばらつきが0だったという意味は分けて扱います。
丸め誤差がなくなるわけでもありません。処理順や数値の大きさによって結果は変わり得ますし、入力時点で別の測定値が同じ浮動小数点数へ丸められていれば、更新式だけでは元の差を復元できません。保存済みの全データを読み直せるなら、平均を求めてから偏差を計算する二段階の方法も選択肢です。まず、逐次処理が必要なのか、どの分母の分散が欲しいのか、入力に必要な精度が残っているか。この三点をそろえると、ばらつきの値を読み違えにくくなります。
参考資料
- Tony F. Chan, Gene H. Golub, Randall J. LeVeque, Algorithms for Computing the Sample Variance: Analysis and Recommendations, The American Statistician 37(3), 242–247, 1983。式(1.1)〜(1.3)、計算誤差と方法の比較。
- GNU Scientific Library 2.8, Running Statistics。逐次統計量のAPIと分散の定義。
- GNU Scientific Library, rstat/rstat.c — release-2-8。gsl_rstat_addとgsl_rstat_varianceの実装。原資料・公開実装の確認日:2026年10月25日。