投稿者: SB-admin

  • 光周波数コムで時刻とデータを運ぶ:100 kmファイバーでCV-QKDとの共存を検証

    光周波数コムで時刻とデータを運ぶ:100 kmファイバーでCV-QKDとの共存を検証

    量子ネットワークを動かすには、弱い量子信号を送る道だけでは足りません。離れた装置の動作をそろえる時刻の基準と、制御や結果の照合に使う通常のデータ通信も必要です。それぞれを別に用意すると、配線や機器、運用の負担が増えていきます。

    北京大学、北京理工大学、北京郵電大学、中国科学院の研究チームは、光周波数コムを使って時刻情報と通常のデータを同じ光に載せ、量子鍵配送の信号と同じファイバーで共存させる実験を報告しました。2026年11月12日公開のプレプリントで、長さ100 kmの巻いたファイバーを使った研究です。都市間ネットワークへの配備や、独立した遠隔時計同士の絶対精度を実証した段階ではありません。[1]

    簡単にまとめると?

    • 規則正しく届く光パルスで時刻を伝え、パルスの強弱に通常のデータを載せます。量子信号は別の波長に置き、同じファイバーを共有します。
    • 100 Mbit/sのデータ伝送時に、平均化時間1秒で0.85 fsの時間偏差を報告しました。共通の時計基準を使い、測定雑音を処理した条件での安定度です。
    • 光の強さ・波長配置・伝送方向を調整し、CV-QKDの追加雑音を0.0037 SNU、計算した秘密鍵生成率の低下を6.7%に抑えています。

    光の「到着時刻」と「強さ」を使い分ける

    光周波数コムは、時間で見ると短い光パルスが等間隔に並び、周波数で見ると櫛の歯のように等間隔の成分が並ぶ光です。この規則性を利用すると、離れた場所へ時間や周波数の基準を渡せます。

    今回の方法では、パルスが届くタイミングを時刻情報に使い、光の強さを変える強度変調で通常のデータを載せます。音楽の拍を一定に保ちながら、音の大きさに別の情報を持たせるような考え方です。ただし実際の受信機では、光の強弱が変わると時刻の読み取りも揺らぎます。二つの役割を割り当てるだけで、干渉がなくなるわけではありません。

    受信側は、届いたコムと少し繰り返し周波数の違う局所的なコムを重ねます。その干渉を使い、非常に短い時間差を、電子回路で扱えるゆっくりした波形へ引き伸ばして読みます。これがデュアルコムによる線形光サンプリングです。実験では時計用コムが100 MHz、読み取り用コムが100.001 MHzで動作します。

    両方向に光を送り、往路と復路の時間情報を組み合わせると、双方に共通する伝送遅延の変動を打ち消せます。一方、往路と復路で異なる遅延は残ります。この非対称性も、遠隔の時計を本当に合わせるときには確認が必要です。

    通信が時刻の読み取りを揺らさないようにする

    強度変調を加えると、光コムの成分の周囲に通信由来の周波数成分が生じます。それが時刻を読み取る成分に重なると、読み取る波形の重心が動き、余分な時間の揺らぎになります。

    研究チームは、データの符号化方法、変調の深さ、変調しないシンボルの割合、通信速度を変えて、この重なりを調べました。たとえば変調を弱くすると時刻への影響は減らせますが、通信の0と1を区別しにくくなります。時間計測だけが良くなる設定を選べばよい、という問題ではありません。

    実験では、NRZという符号化を使い、変調しないシンボルの割合を50%、変調の深さを1とした条件で、100 Mbit/sのデータ通信と、平均化時間1秒で0.85 fsの時間偏差(TDEV)を同時に得ています。fsはフェムト秒で、10⁻¹⁵秒です。通信側は、前方誤り訂正を使わず、受信光電力−46 dBmでビット誤り率10⁻⁶の基準を満たしました。

    ここでTDEVは、指定した時間尺度で時間差がどれほど安定しているかを表す量です。論文は装置自身の揺らぎを取り出すため、比較する信号を同じ周波数基準につなぐ共通時計構成を使っています。さらに時間差の系列をカルマンフィルターで処理しています。したがって0.85 fsは、「離れた二つの独立時計が、標準時から0.85 fs以内に合った」という意味ではありません。

    量子信号は別の波長に置く

    時刻と通常のデータは同じコム光を利用しますが、量子信号をその強い光に直接載せるわけではありません。波長分割多重(WDM)で別の波長の弱い量子信号を合流させ、伝送するファイバーを共有します。

    検証した量子通信は、CV-QKD(連続変数量子鍵配送)です。弱い光の連続的な振幅・位相の情報を使い、送信側と受信側が秘密鍵を共有する方式です。今回の量子チャネルはC34、波長1550.12 nmに置かれています。通常の通信が強い光を使うのに対して、量子チャネルは余分な雑音に敏感です。

    波長を分けても、影響は完全には消えません。強いコム光がファイバーの屈折率を変えると、量子信号の位相が揺れます。また、ラマン散乱や四光波混合によって、量子側の受信帯域に余分な光子が生じることもあります。受信帯域の中に入った光子は、波長フィルターだけでは取り除けません。

    研究では、この追加雑音をコム光の平均電力に対するモデルで表し、波長の組合せと伝送方向ごとに実測値へ当てはめています。光を強くすれば通常の通信には有利でも、量子側には不利になる。その妥協点を探すためのモデルです。
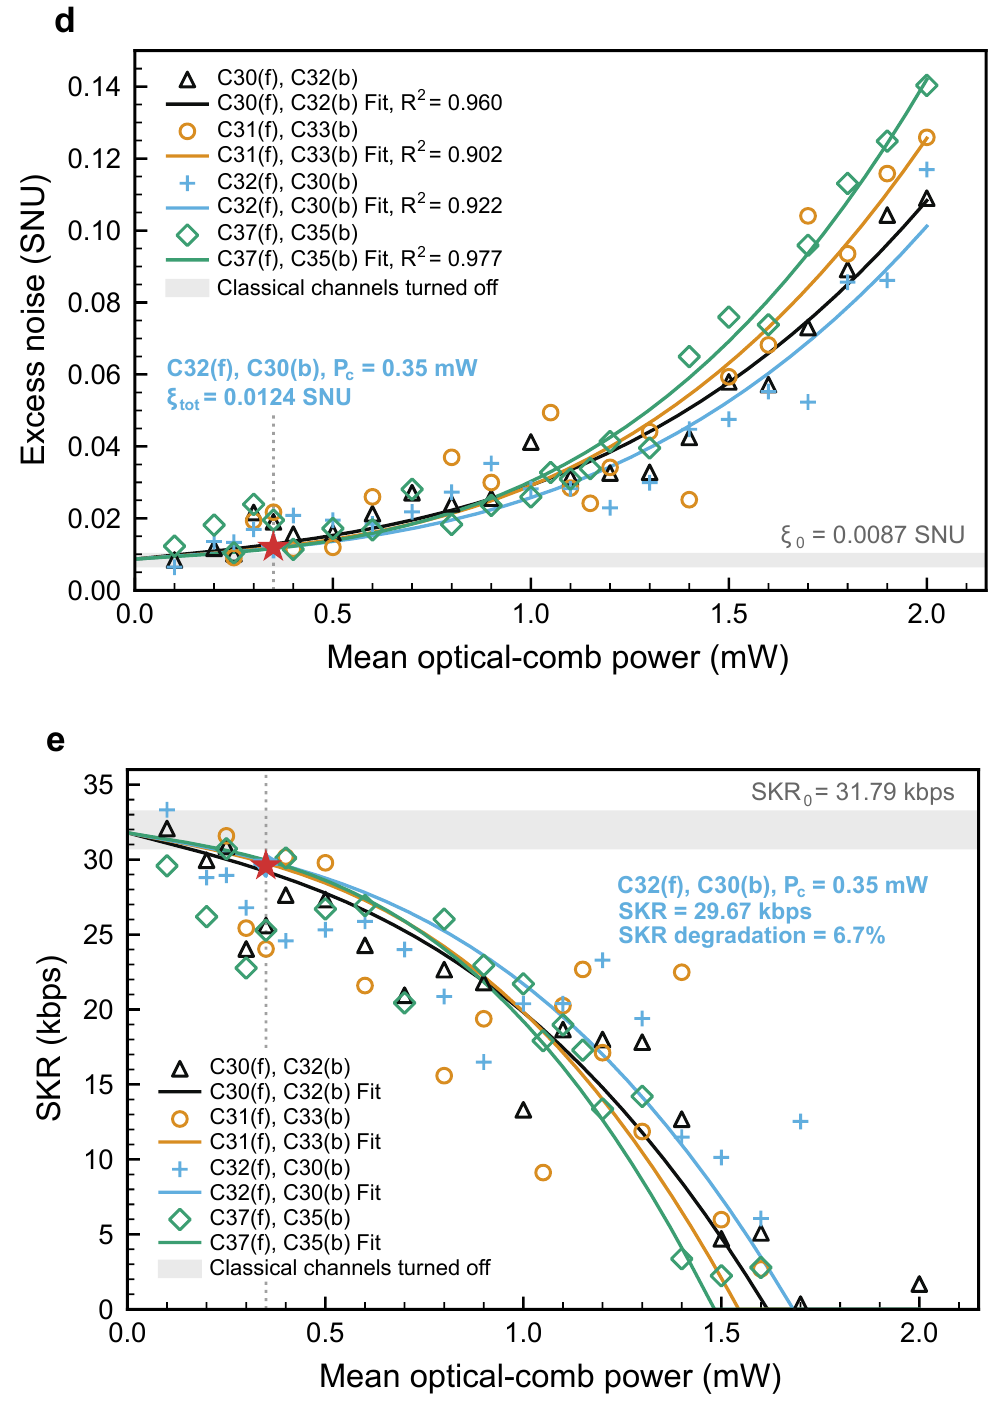
    原論文図3のd・e。上段はコム平均電力と過剰雑音、下段は平均電力と秘密鍵生成率。
    原論文の図3d・eを縦に配置しています。上段は過剰雑音、下段は秘密鍵生成率(SKR)で、横軸はコムの平均光電力です。fとbは量子信号に対する順方向と逆方向を表し、色ごとに波長配置が異なります。赤い星は採用した0.35 mWの条件。Yiting Linほか、arXiv:2611.16349v1、図3d・e、CC BY 4.0。PDFから2パネルを抜き出し、配置を変更しています。画像を開くと拡大できます。

    光の強さ、波長、向きを組み合わせて鍵への影響を減らす

    この100 kmの構成では、量子信号と逆向きに進むコムによるラマン散乱の影響が、同じ向きに進む場合より大きくなります。そのため、逆方向のコムを量子チャネルから波長的に遠く置くことが有効でした。単に「隣の波長を空ける」だけでなく、どちら向きに流れる光なのかまで含めて設計しています。

    採用した条件は、コムの平均光電力0.35 mW、順方向C32、逆方向C30です。量子チャネルの過剰雑音は、通常の通信側を止めたときの0.0087 SNUから0.0124 SNUとなり、追加分は0.0037 SNUでした。SNUは、ショット雑音を基準に規格化した雑音の単位です。

    この測定雑音を使った秘密鍵生成率は、単独動作時の31.79 kbit/sから29.67 kbit/sへ下がり、低下率は約6.7%でした。論文の計算は、十分に長いデータ列を扱う漸近的な条件に基づきます。実際の有限長データを含むすべての安全性条件や、どのネットワークでも同じ鍵速度が得られることを示す値ではありません。

    0.26 fsの結果は、短い時刻パケットを送った別の条件

    研究チームは、QKDで得た鍵を使って時刻データを保護し、そのデータをコム光へ載せる実験も行いました。コムによる細かな相対時間の測定に、「何秒に対応するか」という時刻ラベルを組み合わせる狙いです。

    この実験では、1秒ごとに76ビットのパケットを一つ送ります。12ビットがパケットの先頭を見つけるための目印で、64ビットが保護された時刻情報です。100 Mbit/sで送るため、一つのパケットは760 nsで終わり、平均の伝送量は76 bit/sにすぎません。

    このように通信が時間のごく一部しか占めない条件で、平均化時間1秒のTDEVは約0.26 fsでした。時刻パケットの有無で短時間の安定度がほぼ変わらなかった結果です。100 Mbit/sのデータを継続して流した0.85 fsの条件と、同じ測定として比較することはできません。

    時刻情報の保護には、量子鍵との排他的論理和によるワンタイムパッド暗号を使っています。ただし、この実験を、通信路の遅延操作を含むあらゆる攻撃への耐性や、時刻認証全体の完成を証明したものとは読めません。情報の秘匿と、届いた時刻の正しさは別に確かめる必要があります。

    共有するほど、雑音と運用条件の設計が重要になる

    今回の成果は、時刻同期、通常の通信、量子鍵配送を、同じ伝送路で扱う具体的な条件を示したことです。一方、実証したのは巻いたファイバーによる二地点間のリンクです。多数の拠点が接続されるネットワークへの拡張、光コム装置の小型化、現場の変動や波長管理への対応は今後の課題として残ります。

    論文の実験データとコードは、著者への合理的な依頼によって提供される扱いで、公開済みの実装として自由に再現できる状態は確認できません。共有によって機器を減らせる可能性と、現場で安定して運用できるかどうかを分けて見ることが、この方式を評価する出発点になります。

    出典

    1. Yiting Linほか、An optical-frequency-comb-enabled unified infrastructure for quantum networks, arXiv:2611.16349v1, 2026年11月12日。本文、図1〜5、Methods、Supplementary Notes 1〜3。査読前のプレプリント。資料版は2026年11月14日に確認。
  • 量子化学計算の測定回数を減らすVGMC:一緒に測る項目の組合せを見直す

    量子化学計算の測定回数を減らすVGMC:一緒に測る項目の組合せを見直す

    量子コンピューターで分子のエネルギーを求めるとき、計算回路を一度動かすだけでは答えが決まりません。同じ状態を何度も用意して測定し、ばらつく結果を平均する必要があります。その繰り返しを減らすには、何を一緒に測り、どの測定に回数を振り分けるかが重要です。

    東南大学のTaotao Zhao氏らが2026年11月11日に公開したプレプリントは、VGMC(分散を手掛かりにした測定グループの構成法)を提案しています。既存の測り方を十分に使い切ったうえで、別の組合せを追加する価値を判断する方法です。小規模な分子の数値計算では、同じ統計精度に必要な測定回数を減らせる可能性を示しました。量子実機での実行時間短縮を報告したものではありません。[1]

    簡単にまとめると?

    • VGMCは、すでに選んだ測定への回数配分だけでなく、一緒に測る項目の組合せも見直します。
    • 新しい組合せに回数を回す利益と、従来の測定から回数を減らす損失を比べます。測り方を増やせば必ず有利、という考え方ではありません。
    • 4分子のシミュレーションでは改善が見られ、厳密な共分散を使った設計で、所定の精度に必要な測定回数を約9.8〜23.9%削減できると推定されました。別の水素分子の例では改善していません。

    一回の測定結果から、いくつの情報を取り出せるか

    研究が対象とするのは、VQE(変分量子固有値ソルバー)などで使うエネルギー測定です。VQEでは、量子回路で用意した状態のエネルギーを調べ、その値を手掛かりに古典コンピューターが回路の設定を調整します。今回の研究は、その途中の一つの状態を固定したときのエネルギー推定を扱います。最適化の全過程が同じ割合で速くなる、という結果ではありません。

    分子のエネルギーを表すハミルトニアンは、量子ビットを特定の向きから調べる「パウリ演算子」の項と、それぞれの重みの和へ変換できます。すべての項を別々に測ると、同じ状態を用意する回数が膨らみます。一緒に測れる項をまとめれば、一回の結果から複数の項の情報を取り出せます。

    たとえば2量子ビットを両方ともZ方向から測ると、1番目だけの結果、2番目だけの結果、両者の結果の積を同じ記録から計算できます。演算子ではZ⊗I、I⊗Z、Z⊗Zに相当します。Iは、その量子ビットの結果を使わないことを表します。1番目をX方向、2番目をZ方向から測る別の設定なら、X⊗I、I⊗Z、X⊗Zを取り出せます。I⊗Zは両方の設定で得られる情報です。

    この例のように、各量子ビットで測定方向が衝突しない組合せを、QWC(量子ビットごとに可換なグループ)と呼びます。論文はこの範囲に対象を絞っています。測定前に各量子ビットの向きを個別に回転する操作で済む一方、追加の量子ビット間操作を使えば一緒に測れる、より広い組合せまでは含みません。

    測定回数と、結果に掛ける重みを一緒に決める

    同じ項を複数の設定で測れる場合、得られた平均値をどう使うかにも自由度があります。先ほどのI⊗Zなら、別々の測定バッチから得た二つの平均値へ、エネルギー式の重みを分けられます。分けた重みの合計を元の値に保てば、平均的には本来のエネルギーを推定する性質を維持できます。

    ただし、測った項目を単純に数えるだけでは、推定値のばらつきは分かりません。同じ一回の測定から得る複数の項は、一緒に増減することがあります。この連動を表すのが共分散です。重みを掛けて足し合わせたときに、揺らぎが強まる場合も、打ち消し合う場合もあります。

    そこで研究では、まず選んだ各測定設定に、その設定で測れるハミルトニアンの項を漏れなく含めます。そのうえで、結果に掛ける重みと、各設定への測定回数の配分を同時に最適化します。重みを固定した場合の最適な回数配分は、各グループの重み付き結果の標準偏差に比例します。すべての設定を同じ回数ずつ測る配分が、いつも最適とは限りません。

    新しい測り方を加えると、何が変わるのか

    既存の設定だけで重みと回数を最適化しても、一緒に測れる項の組合せは変わりません。VGMCはそこから先へ進み、新しいQWCグループを候補として作ります。

    ここで測定の総回数は固定です。新しい設定に回数を割り当てれば、古い設定のどこかを減らさなければなりません。VGMCは、候補がもたらす改善だけでなく、その振り替えによる不利益も含めて候補を評価します。有望なグループを追加した後は、重みと回数を再び全体で最適化します。

    論文の理論では、固定した共分散が正定値で、従来の設計が厳密に最適化されているなどの条件の下で、少量の回数を候補へ移すと分散が減る条件を導いています。実際の構成法は、有望な組合せを順に選ぶ貪欲法です。可能なすべての測定設定を探索して、最良の組合せを保証する方法ではありません。

    4分子では改善し、水素分子では変化しなかった

    評価には、水素H₂、水素化リチウムLiH、水素化ベリリウムBeH₂、水H₂O、アンモニアNH₃の5分子を用いています。STO-3Gという基底関数系で分子を表し、Bravyi–Kitaev変換で4〜16量子ビットの問題へ写しています。ここでいう分子計算の「基底関数系」と、量子ビットをどの方向から測るかという「測定基底」は別のものです。

    比較対象のSOCP法は、既存の測定設定を固定したまま、重みと回数を同時に最適化した設計です。厳密な共分散を使った条件では、VGMCが新たな設定を追加したLiH、BeH₂、H₂O、NH₃で、推定値の分散がSOCPより18.19〜23.38%小さくなりました。H₂では設定の追加も改善も起きていません。

    この「分散の低下率」は、そのまま実機で節約できた時間ではありません。論文はさらに、割り当てを整数の測定回数へ直し、有限回の測定結果をシミュレーションしました。各評価点は、独立に得た300個のエネルギー推定値から誤差を調べています。

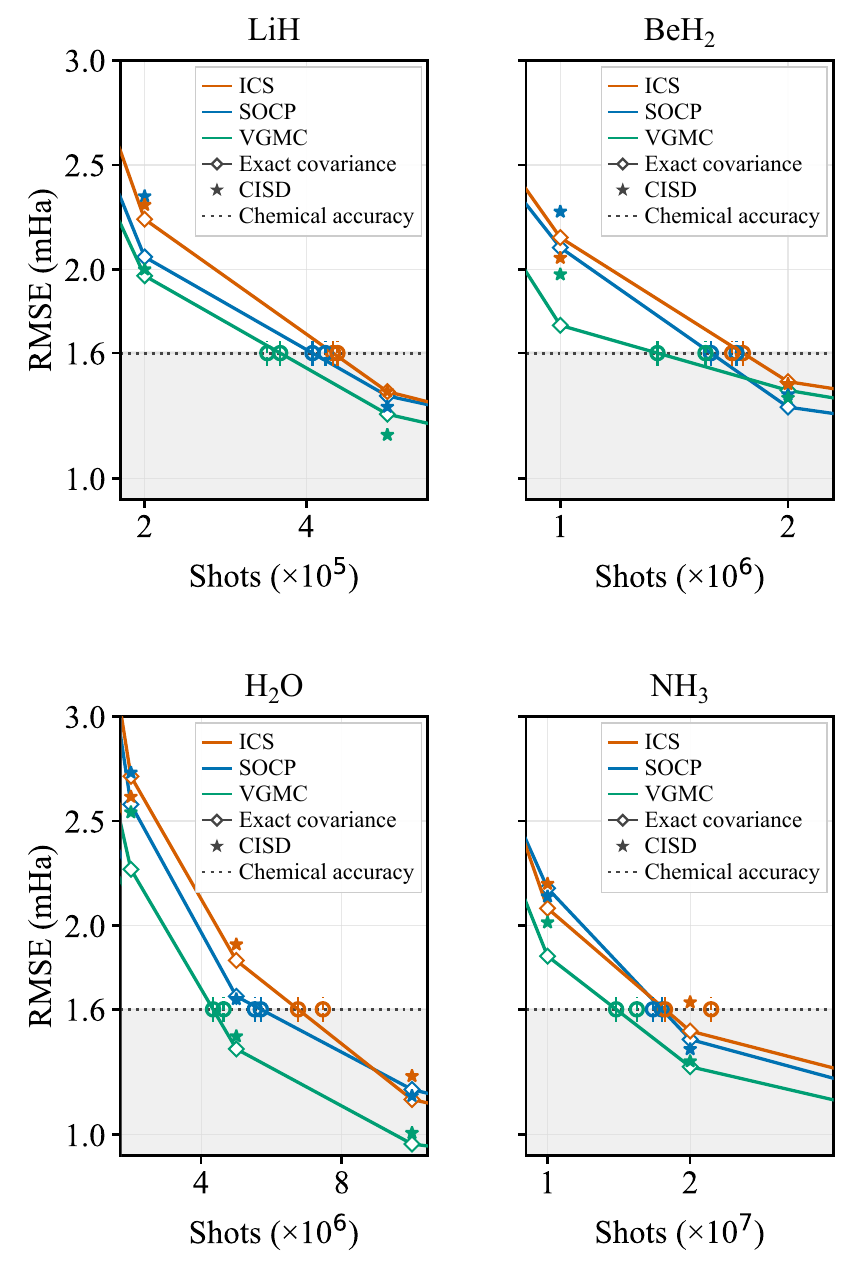
    原論文図2。LiH、BeH2、H2O、NH3の4分子について、測定回数とエネルギー推定のRMSEを比較。緑のVGMC、青のSOCP、橙のICSを示す。
    原論文の図2。横軸は測定回数で、分子ごとに10⁵〜10⁷の倍率が異なります。縦軸は推定誤差のRMSE(二乗平均平方根誤差)、単位はmHa(ミリハートリー)です。点線の1.6 mHaを目標精度として比較しています。菱形は厳密な共分散、星はCISDによる近似共分散で設計した場合。中抜きの丸は、測定した評価点の間を補間した目標到達回数です。Taotao Zhaoほか、arXiv:2611.14986v1、図2、CC BY 4.0。PDFから図部分を抜き出しています。画像を開くと拡大できます。

    化学計算で目安に用いられる1.6 mHaの誤差付近では、厳密な共分散を使ったVGMCの必要回数は、SOCPより約9.8〜23.9%少ないと推定されました。これは図の評価点の間を補間した結果です。装置上でその回数を実測し、化学的な予測精度全体を保証した値ではありません。

    厳密な共分散の代わりに、CISD(単一・二重励起配置間相互作用)という近似計算から得た共分散で設計した場合も調べています。同じ近似を使うSOCPとの比較では、必要回数の削減は約6.5〜16.9%でした。近似でも利益が残る例ですが、分子や比較方法を問わず常に優れることまで示してはいません。

    実機で役立つかを考えるときの確認点

    共分散は、今回の評価では古典計算で求めた状態ベクトルから計算しています。大きな問題で同じ情報をどう安く得るかは、実用上の重要な条件です。事前測定で推定するなら、そのために使う回数も総費用に入れる必要があります。

    また、この設計では一回の測定に掛かる費用を同じとみなしています。実際には、状態の準備、方向を変える操作、読み出し、設定の切り替えに掛かる時間や誤差が異なります。グループを作る古典計算の時間も含めなければ、利用者が待つ時間の短縮率は分かりません。

    VGMCの成果は、限られた測定結果を上手に平均する工夫と、「どの情報を同じ一回から得るか」を選ぶ工夫をつないだ点にあります。測定設定の数を減らすことだけを目標にせず、組合せと回数配分が、最終的なエネルギーの揺らぎへどう効くかを確かめる。その見方が、量子化学計算の測定費用を比較する手掛かりになります。

    出典

    1. Taotao Zhao, Qianjun Yao, Mengdi Sun, He Li, From optimization to construction: Expanding quantum measurement designs, arXiv:2611.14986v1, 2026年11月11日。本文・表I・図1〜2・付録A〜C。査読前のプレプリント。資料版は2026年11月14日に確認。
  • 中性原子の誤り訂正、撮影後0.76ミリ秒の処理予算をどう読むか

    中性原子の誤り訂正、撮影後0.76ミリ秒の処理予算をどう読むか

    量子誤り訂正では、誤りを推定する計算が速いだけでは足りません。計算に必要な測定結果が届くまで待っていれば、その分だけ次の操作も遅れます。原子の並びをカメラで撮る中性原子方式では、画像をどの順序で取り出し、処理へ渡すかが重要になります。

    2026年11月11日公開のプレプリントは、カメラ、FPGA、GPUを協調させ、画像全体がそろう前から必要な部分を処理する構成を報告しました。研究にはShanghai Zhongqi Wuliang Quantum Technology、China Mobile (Suzhou) Software Technology、China Electronics Technology Corporationの第32研究所、上海交通大学、上海光機所の研究者が参加しています。小さい表面符号の例で示す約0.76ミリ秒は、各段階を別々に測った値を組み合わせた、露光終了後の処理予算です。実際の量子状態を訂正するところまで閉じた実験は、今後の段階とされています。

    簡単にまとめると?

    • FPGAはカメラの行データが届くたびに処理し、GPUは1つの論理ブロックのデータがそろえば、次のブロックの読出し中に復号します。
    • 約0.76ミリ秒は、符号距離7の表面符号に対する特定の処理条件の予算。露光時間や、量子装置へ訂正を実行する時間は含みません。
    • 復号の評価には模擬シンドロームを使っています。平均時間だけでなく、遅い例のばらつき、長い測定履歴、実測した誤りとの接続を確かめることが次の課題です。

    画像全体を待たず、必要な部分から進める

    中性原子の量子計算機では、光で並べた原子からの蛍光を撮影し、場所ごとの状態を読み分けます。そこから誤りの手がかりとなるシンドロームを作り、どんな誤りが起きたかを復号器が推定します。量子情報そのものを直接読み尽くすのではなく、補助原子の測定を使って論理情報を守る仕組みです。

    一般的なCMOSカメラの画像は、行ごとに読み出されます。ある論理量子ビットに必要な行がすでに届いていても、無関係な領域まで含めた全フレームを待つ設計なら、その待ち時間は復号計算を速くしても消えません。

    研究の構成は、二つの大きさで処理を重ねます。小さい単位では、FPGAが到着した行の処理を進めながら、次の行を受け取ります。大きい単位では、GPUがデータのそろった論理ブロックを復号し、その間にカメラが次のブロックを読み出します。読み出す領域をROI(関心領域)として必要な原子の周囲に絞ることも、余分な待ちを減らします。

    FPGAは、入力に合わせた処理をハードウェアとして構成できる回路です。一方、GPUは復号方式をソフトウェアで替えやすい点を生かします。画像から情報を取り出す部分と、誤りを推定する部分を、それぞれに受け持たせています。

    0.76ミリ秒には、どこからどこまでが入るのか

    符号距離7の回転表面符号では、49のデータ量子ビットと48の補助量子ビットを使います。論文は、研究装置の原子間隔と撮像倍率では、補助原子48個の読出しに90×90画素のROIを用いる条件を示しています。任意の装置で同じ画素数になるわけではありません。

    この条件では、ROIの読出しが約326.7マイクロ秒、カメラ側の前処理・転送に相当する部分が約64.9マイクロ秒です。FPGAのバッファリングは約3.8マイクロ秒、占有状態の画像解析は約0.1マイクロ秒。GPUへの転送は約1.8マイクロ秒、戻りの転送は約1.0マイクロ秒とされています。読み出しと処理が重なる区間は、同じ時間を二重に足さないよう扱います。

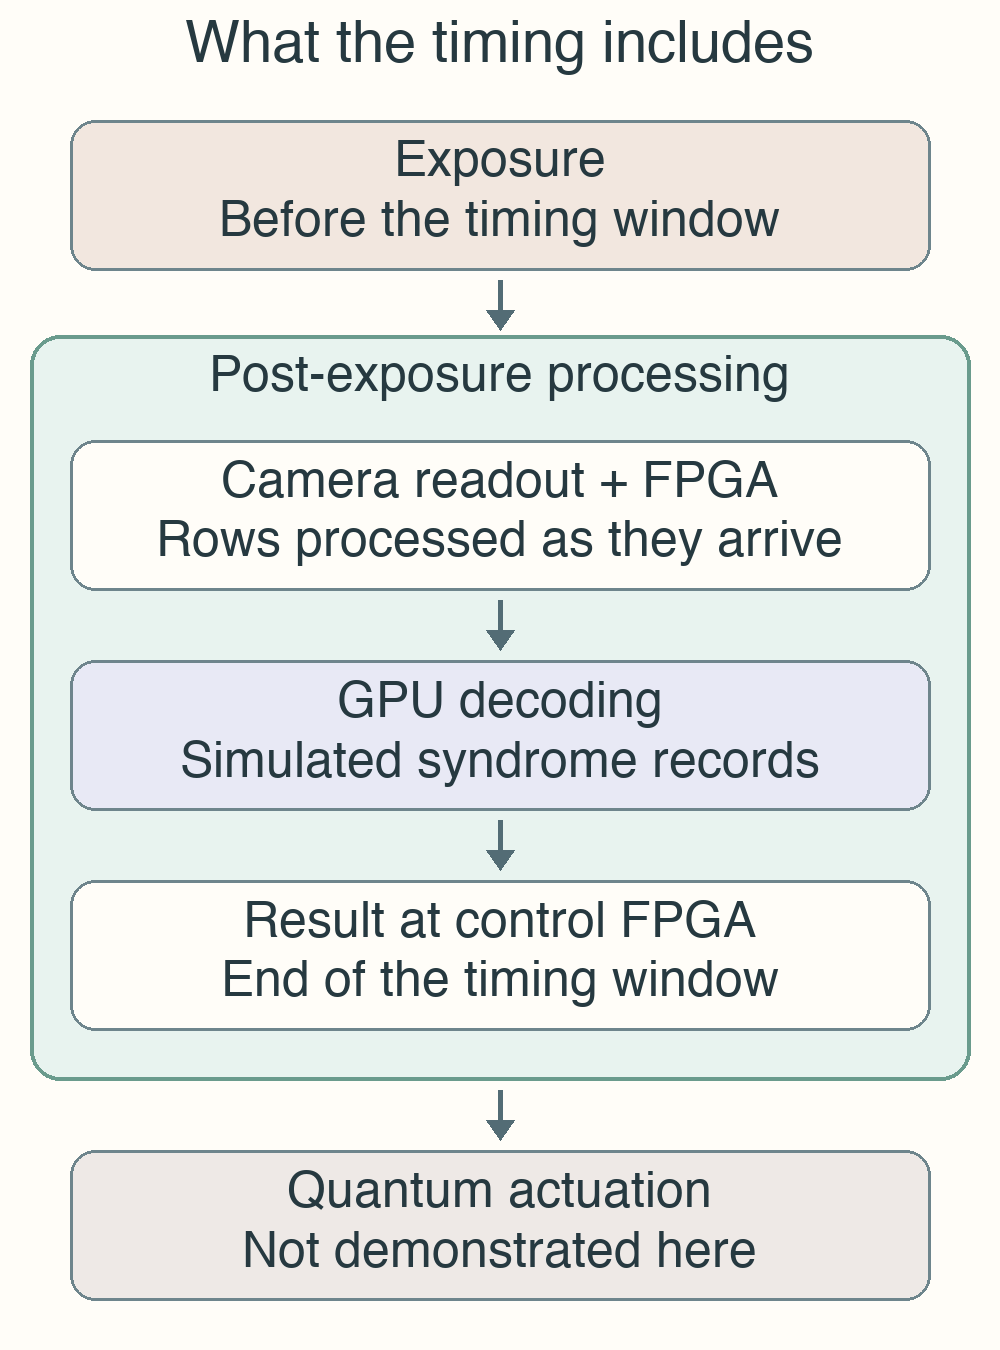
    これらに、選んだ小さい符号のAI復号処理を組み合わせ、露光終了から制御側FPGAの入力に復号結果が届くまでを約0.76ミリ秒としています。論文の比較表は、この値を別々に計測した各段階の合計として説明しています。蛍光を集める露光そのものも、届いた結果をもとに原子へ訂正を実行する動作も、この数字の外です。

    処理時間の範囲を示す独自概念図。露光は測定予算の前、カメラ読出しとFPGA処理、GPU復号、制御FPGAへの結果到着が処理範囲で、その後の量子装置への実行は今回未実証。
    露光終了後の処理予算と、その前後の段階を分けた概念図。Quantum Sea作成。arXiv:2611.15104v1の本文、式(1)〜(3)、表IIに基づく。箱の幅や矢印の長さは所要時間を表しません。

    通信だけを測った別の結果では、32バイトのデータを往復させる平均時間が2.72マイクロ秒、1キロバイトでは3.55マイクロ秒でした。小さいデータの受け渡しが短く済むことは有利ですが、この数字にカメラの待ちや復号計算は含まれません。通信時間と処理全体の時間を同じ性能値として並べないことが大切です。

    復号方式によって、待ち方も変わる

    論文は、反復符号の表引き、カラー符号のBP-OSD、表面符号の再帰型Transformerという三つの組み合わせを評価しています。すべて同じ符号を異なる方式で解いた比較ではないため、数値だけで方式の優劣を順位づけることはできません。

    表引きは、あらかじめ用意したシンドロームと訂正候補の対応を探します。今回の小さい反復符号では約82マイクロ秒でしたが、計測時間は固定的なソフトウェアの負担が支配的と説明されています。表には重み3までの誤りしか列挙しておらず、大きい符号や複雑な誤りに、そのまま同じ方法を広げられるわけではありません。

    BP-OSDは、まず確からしさをグラフ上で伝えるBPで推定し、それで解けない場合に候補を整理する追加処理を行います。入力によって反復や追加処理の量が変わるため、平均の所要時間だけでなく、遅い例がどれほどあるかが重要です。符号距離や測定履歴が増えると、平均でも1ミリ秒の目安を超える条件が示されています。

    再帰型Transformerは、測定結果の時間的・空間的な関係を学習した復号器です。今回の評価は、測定履歴をそろえて1回の推論に渡しています。6ラウンドずつを1群にまとめる構造により、履歴が長くなると処理時間が段階的に増えます。符号距離7では、追加の1群あたり約360マイクロ秒です。「何ラウンド分でも360マイクロ秒で終わる」という意味ではなく、長い記録の合計時間は1ミリ秒を超えます。

    また、誤り率の比較に使った最小重み完全マッチングには、誤りの相関を反映した重みの更新を入れていません。この基準よりAI復号器の論理誤り率が低かったことを、あらゆるマッチング実装に勝るという結論へ広げることはできません。

    「間に合う」を決めるのは、次の操作の期限

    誤りを推定したら、毎回すぐに物理的な訂正をかけなければならないとは限りません。Pauli frameと呼ぶ古典的な記録に誤りの情報を持たせ、その情報を踏まえて後の測定を解釈できる場合があります。ただし、測定結果に応じて次の操作を選ぶ場面では、判断に必要な復号結果が期限までに届く必要があります。

    たとえば、次の操作に向けた原子の移動が独立に進められるなら、その間に古典側の計算を済ませられます。原子側の準備が先に終われば、残った古典処理が待ち時間になります。この研究はその関係を、古典側の結果と命令の準備時間から、量子側が独立に準備できる時間を差し引くモデルで説明しています。すべての装置で処理時間の全量が追加の停止時間になる、というモデルではありません。

    一方、処理する測定結果の平均的な量が、次々に発生する量へ追いつかなければ、未処理の仕事がたまります。1件の判断が期限に間に合うことと、長時間運転で仕事がたまらないことは、両方を確かめる必要があります。

    次は、実際の測定と訂正までつなぐ

    装置の撮像・通信の評価と、復号の精度評価は区別して読む必要があります。復号へ入れたシンドロームは、回路レベルの雑音を使ってStimで生成した模擬データです。今回の結果だけで、実際の原子配列から得たスタビライザー測定を連続して復号し、その判断で量子装置へ訂正を実行できたとはいえません。

    実装を判断する際には、符号距離だけでなく、何ラウンドの履歴をまとめるか、誤りの種類、平均と遅い例の分布、装置間の転送範囲をそろえて比較します。異なる装置の「1件あたりの平均時間」と「測定終了から返答までの時間」も、同じ量ではありません。

    この研究は、復号器だけを速くする視点から一歩広げ、画像が届く順序と古典処理を一緒に設計する手がかりを示しています。実測シンドロームとの統合、大きい符号や条件付き操作に固有の評価、そして訂正を装置へ実行する閉ループ実証が、処理予算を実際の量子計算の速さへ結びつける次の段階です。

    研究に参加したShanghai Zhongqi Wuliang Quantum Technology(上海中器无量)の事業については、Cyclewaveの中性原子量子計算機「清河一号」の開発を扱う企業解説で紹介しています。同じ研究に参加したChina Mobile (Suzhou) Software Technology(中国移動蘇州)については、クラウド・ソフトウェア事業の企業解説をご覧ください。著者の所属先であるCETC第32研究所については、CETCグループの事業と第32研究所の位置づけを扱う解説で、組織のつながりを紹介しています。

    出典

    • X. Wangほか「An Architecture for Real-Time Quantum Error Correction with Neutral Atoms」、arXiv:2611.15104v1、2026年11月11日公開(PDF本文の日付は11月13日)。本文、図1〜7、表I・II、付録A〜Fを参照。単一の共同プレプリントに基づく紹介です。
  • AMD・IBMのPêlagos、8 GPUで量子誤り訂正の評価を高速化:CPUの準備と回収も並列に

    AMD・IBMのPêlagos、8 GPUで量子誤り訂正の評価を高速化:CPUの準備と回収も並列に

    量子誤り訂正の方式を比べるには、たくさんの誤りの例を作り、それぞれをどこまで正しく推定できるか調べる必要があります。GPUを増やせば計算は速くなりそうですが、CPUが入力を準備し、結果を回収する部分が順番待ちになると、GPUを十分に働かせられません。

    AMDとIBM Researchの研究者が2026年11月12日に公開したプレプリント「Pêlagos」は、量子誤り訂正の復号評価を複数のAMD GPUへ振り分ける方法を扱います。中心となる変更は、1台のGPU内の計算そのものよりも、その前後を含む処理の組み立て方です。8 GPUの評価では、条件によって1 GPU時の約7倍の処理能力を報告しています。ただし、これは多数の例を処理する速度の話であり、量子計算機の誤りを実時間で直す実証とは区別が必要です。

    簡単にまとめると?

    • Pêlagosは、量子誤り訂正の復号を大量に評価するための実装です。GPUごとの常駐プロセスとCPU側の並列準備で、入力と結果回収の待ち時間を減らします。
    • MI355Xの8 GPUでは、大きい方の符号で処理全体のスループットが1 GPU時の7.01倍。GPUの計算部分だけを測った7.45倍とは、測定範囲が異なります。
    • 公開コードはありますが、評価は特定の符号・誤りモデル・装置構成での結果です。1件の復号遅延、実機の量子誤り訂正、別方式への優位性をまとめて示したものではありません。

    復号の大量評価では、何を繰り返し計算するのか

    量子誤り訂正では、量子情報を直接読み出す代わりに、誤りの手がかりとなる測定結果を集めます。この手がかりをシンドロームと呼び、そこから起きた誤りを推定する計算が復号です。候補が測定結果とつじつまを合わせられても、守りたい論理情報まで正しく復元できるとは限りません。したがって、復号が終了した数と、論理的に正しく復号できた数は別に確かめます。

    本研究が使うRelay-BPは、誤りの候補と検査の関係を表すグラフ上で、確からしさの情報をやり取りする方式です。BPはbelief propagationの略で、少ない反復で解ける例もあれば、別の条件でやり直す必要がある例もあります。Pêlagosは、この既存の復号方法を使って多数の独立した例を処理します。復号アルゴリズムを新しく考案した、という位置づけではありません。

    GPUごとに担当を固定し、CPUの準備も分担する

    複数GPUへ仕事を渡す前には、CPUで入力を整え、データを移し、計算後には結果を取り出す処理があります。これらを1つずつ進めると、GPUの台数に合わせてCPUの仕事が増え、全体の速さを制限します。

    Pêlagosでは、GPU1台につき1つのプロセスを常駐させます。各プロセスは担当GPUと復号に使うグラフを保ち、何度も仕事を受け取ります。CPU側のスレッドは、GPUごとに分けた入力を並行して準備します。大きな出力は共有メモリーの決められた領域へ書き込み、小さな制御情報だけを別の通信経路で渡して、最後にCPUが順序をそろえます。

    この構成では、各GPUが独立した入力群を処理します。1件の復号を8台に分割して、その途中結果をGPU間で交換する構成ではありません。各GPUに同じ件数を割り当てても、難しい例が多い担当は長くかかるため、全体の完了は最も遅い担当にも左右されます。

    また、GPU内の計算カーネルやデータ配置は、この複数GPU化のために作り直していません。同じ計算を運ぶ仕組みを変えることで、どこまで全体を速くできるかを調べています。

    「8 GPUで約7倍」の分母をそろえて読む

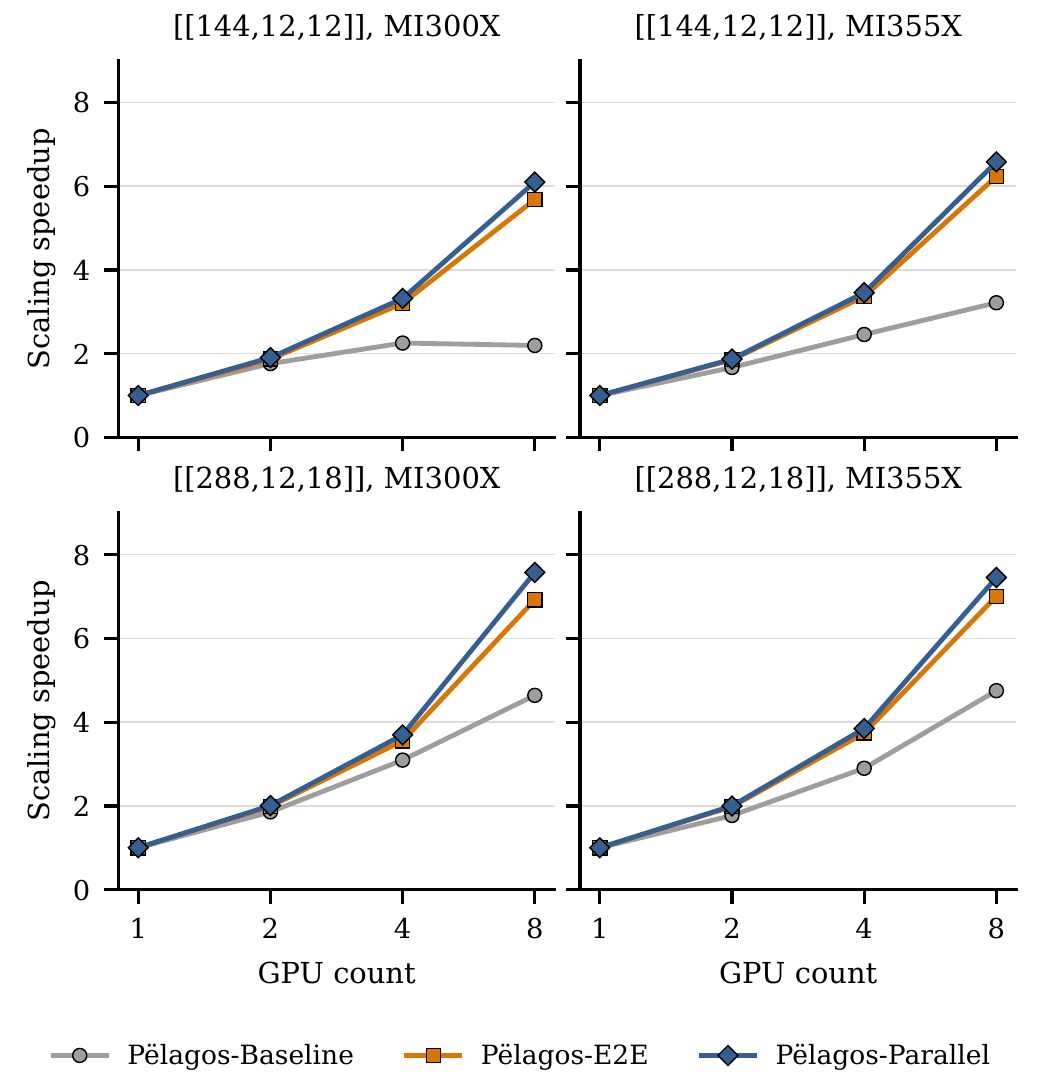
    評価対象は、qLDPC符号の一種であるbivariate bicycle符号です。小さい方の[[144,12,12]]は、144のデータ量子ビットで12の論理量子ビットを符号化し、符号距離が12。大きい方は[[288,12,18]]です。この表記は、補助量子ビットを含めた実機全体の規模を表す数字ではありません。

    論文では、物理誤り率0.003の回路レベルのPauli誤りモデルを使い、相関したX・Y・Z誤りを扱います。GPU1台あたりのシンドロームを1,024件に固定し、1台から8台へ増やすと、総件数も1,024件から8,192件へ増やします。つまり、同じ総件数を8分の1の時間で解けるかという試験ではなく、仕事量も増やしたときの処理能力を測っています。

    MI355X、8 GPUの指標 小さい符号 大きい符号
    処理全体:最適化後の1 GPU比 6.23倍 7.01倍
    GPUの計算部分:同じ指標の1 GPU比 約6.6倍(図2) 7.45倍
    処理全体:従来実装の8 GPU比 2.07倍 1.36倍
    原論文の図2・表III・本文に基づく。Relay-BPのrelay set上限R=50。速度の指標は1秒あたりのBP反復数。上2行と最下行では比較対象が異なる。

    「処理全体」は、CPUの準備、仕事の振り分け、GPUの復号、出力の処理を含む計測です。一方、GPUの計算部分だけの指標は、複数の担当のうち最も長い復号時間を分母にします。後者が速くても、CPU側に待ちが残れば、利用者が仕事を投入して結果を受け取るまでの改善は小さくなります。

    原論文図2。2種類の符号と2種類のAMD GPUで、GPU台数に対するスループットの伸びを比較。従来実装、最適化後の処理全体、GPU計算部分を別々に表示。
    図2:各系列は、それぞれの1 GPU時を1として正規化。橙色が最適化後の処理全体、青がGPUの計算部分、灰色が従来実装。上段は小さい符号、下段は大きい符号です。Xulong Tangほか、arXiv:2611.16285v1、図2、CC BY 4.0。PDFから図部分を抜き出し、軸・凡例・全4パネルを保持。

    たとえばMI355Xで小さい符号を処理すると、従来実装のCPU前処理は1 GPU時の0.129秒から8 GPU時の0.974秒へ増えます。最適化後は0.132秒から0.222秒でした。仕事量は8倍になっているのに、準備時間の増加を小さくできたことが、GPUを増やした効果を全体へつなげています。

    まとめて渡す件数にも、上限と効き方がある

    GPUへ一度に渡す件数を増やすと、並行して動く仕事が増え、装置を使いやすくなります。しかし、入力や中間データも大きくなり、高速なキャッシュに収まりにくくなります。論文の別の評価でも、件数を増やしたときの改善は次第に緩やかになりました。著者らはメモリー帯域の影響を説明に挙げていますが、これだけであらゆる条件の律速原因が確定したとはいえません。

    今回の実装には、GPUメモリーの総容量とは別に、符号付き32ビットのインデックスに由来する上限もあります。グラフの辺の数をE、1 GPUに渡す件数をBとすると、E×Bを表現できる範囲に収める必要があります。論文での上限は小さい符号が5,114件、大きい符号が1,707件でした。メモリーが空いていても、扱う番号の形式が先に制約になる例です。

    公開コードで確かめられること、測り直す必要があること

    コードはApache License 2.0で公開されており、論文が示す版はコミット0127224です。その版の説明では、プロセスを使う実行方式は選択可能な追加機能で、標準の実行方式はスレッドです。Linux/POSIX、CPU上の入力と結果などの前提も示されています。単に最新版を入れれば論文と同じ構成になる、と読み替えないことが大切です。

    測定では常駐プロセスを使い、ウォームアップ1回の後、3回の測定の中央値を取っています。起動や初回コンパイルを含む待ち時間ではありません。また、MI300XとMI355Xの計算機はCPUの機種・コア数も異なるため、両者の差をGPUだけの効果として分離することはできません。

    論理誤りについても、大きい方の符号で失敗が観測されなかった条件は、誤り率が厳密にゼロという意味ではありません。小さい符号では失敗数が少なく、GPU台数ごとの誤り率の細かな比較に十分な統計とはされていません。速度と精度は、同じ入力条件と十分な試行数をそろえて確認する必要があります。

    Pêlagosが示す価値は、量子誤り訂正の方式や設定を大量の例で評価するとき、GPUの外にある準備と回収まで見直すと、複数GPUの能力を使いやすくなることです。1件ごとの実時間復号に使うなら、平均的な処理能力に加えて、最も遅い応答、初回起動、測定装置との接続を別に調べる必要があります。ここで紹介したのは著者らの評価結果であり、公開コードを用いた独立した性能再現ではありません。

    今回の共同研究を企業の取り組みから知りたい方には、CyclewaveのAMDの企業解説とIBMの企業解説も参考になります。

    出典

    • Xulong Tangほか「Scaling Pêlagos: Multi-GPU Orchestration for Relay Belief-Propagation Decoding」、arXiv:2611.16285v1、2026年11月12日公開。AMD・IBM Researchによる共同プレプリント。数値・条件・図はこの1報に基づきます。
    • Pêlagos公開コード:論文が示すコミット0127224。同版のREADME、docs/process-backend.md、LICENSEを参照。2026年11月14日確認。
  • GKP状態を作る経路設計:速さと光子損失を両方見る

    GKP状態を作る経路設計:速さと光子損失を両方見る

    量子情報を電磁場の振動に持たせるとき、目的の状態に早く到着することと、途中で光子を失いにくくすることは、必ずしも同じ問題ではありません。光子が多い状態に長くとどまれば、それだけ損失が起こる機会も増えます。少し遠回りしてでも、光子の少ない状態を通るほうが有利な場合があります。

    2026年11月11日に公開されたDartmouthの研究チームのプレプリントは、GKP(Gottesman–Kitaev–Preskill)状態を作る経路を、この二つの尺度で比較しました。さらに、補助量子ビットの状態に応じて振動の広がりを変える「条件付きスクイージング」で、理想の経路にどこまで近づけるかを計算しています。実機の新記録ではなく、理論と制御シミュレーションの研究です。

    簡単にまとめると?

    • GKP状態の準備では、最短経路より約7%長い経路を選ぶことで、光子損失に関係する累積量を約8%減らせる計算例が示されました。
    • 条件付きスクイージングは、今回のモデルでは、比較した二つの制御方法より理想の準備経路に近づきました。ただし、必要な制御機能と雑音条件を実機でそろえられるかは別の課題です。
    • 既知の一つの状態を移す操作と、どんな量子情報にも正しく作用する論理ゲートは区別が必要です。真空を通る経路の利点を、そのまま論理ゲートの性能には読み替えられません。

    GKP状態では、到着点だけでなく途中の光子数も効く

    GKP符号は、一つの振動子の中に論理量子ビットを埋め込む方法です。位置と運動量に相当する二つの量を使って状態を描くと、格子状の構造が現れます。その構造を手がかりに、小さなずれを誤りとして見つけ、補正することを狙います。

    理想的な格子を作るには無限のエネルギーが必要なため、研究では有限の広がりを持つ近似状態を使います。今回の中心となる比較は、その形を決めるパラメータをΔ=0.4に固定したものです。格子をさらに鋭くした場合まで、同じ時間で準備できるという意味ではありません。

    最短時間の経路を決める際には、状態が変化できる速さにも上限が必要です。論文はまず、ハミルトニアンのエネルギー不確かさを一定にした理想的な条件で、二つの状態を最も短く結ぶ経路を求めます。一方、光子損失を考える経路では、各瞬間の平均光子数を時間に沿って積み上げた量、∫ n̄(t) dtを小さくします。

    たとえば、平均光子数が2の状態を100ナノ秒保つと、この量は200光子・ナノ秒です。同じ時間でも平均光子数が1なら半分になります。損失率が一定で小さい今回の条件では、この累積量が光子損失による誤りの一次の寄与に関係します。補助量子ビットの誤りや位相の乱れまで、この一つの量で評価できるわけではありません。

    少し長い経路で、光子損失への露出を減らす

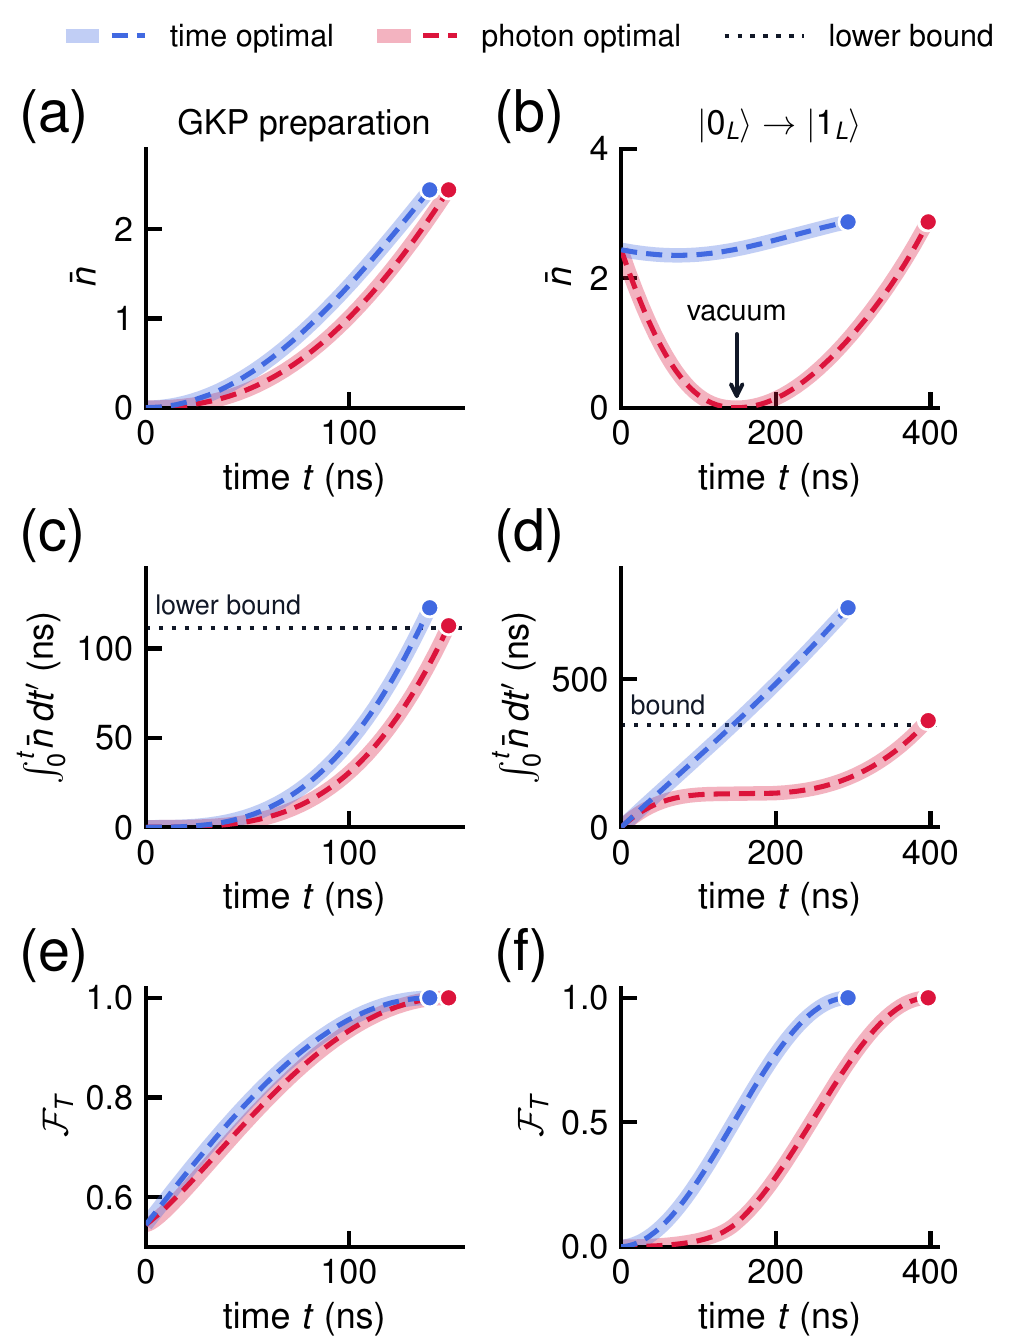
    真空、つまり光子を含まない状態から論理状態0を準備する例では、理想の最短経路は約140ナノ秒です。光子数の累積量を小さくする経路では約149ナノ秒になり、時間は約6.7%増えますが、累積量は122.7から112.6光子・ナノ秒へ約8.2%減ります。これはエネルギー不確かさに対応する速さをω=5.3 μs⁻¹とした理想経路同士の比較です。

    論文の図2。左列はGKP状態の準備、右列は既知の論理状態0から1への移送。青は時間最適、赤は光子数の累積量を最小化する経路で、平均光子数、累積量、到着状態への忠実度を上下に示す。
    Aidan Curtis、Juan Salcedo-Galloほか、arXiv:2611.15018v1、図2(CC BY 4.0)。図部分を原PDFから抜き出し。青は時間最適、赤は光子数の累積量を小さくする経路です。左列は準備、右列は一つの既知入力の移送で、横軸は時間、上段は平均光子数、中段は累積量、下段は目標状態への忠実度です。画像を開くと拡大できます。

    準備では節約幅は比較的小さくても、すでにある論理状態0を論理状態1へ移す問題では差が大きくなります。最短経路の約294ナノ秒に対し、一度真空の近くを通る経路は約397ナノ秒です。時間は長くなりますが、光子数の累積量は約半分になります。光子の少ない領域を通ることが効いています。

    ただし、長い経路では補助量子ビットの誤りが積み重なる時間も増えます。実際の設計では、時間と光子数のどちらか一方だけを最小にするのでなく、装置の損失率や位相雑音を使って、その間の経路を選ぶ必要があります。

    条件付きスクイージングが準備経路に近づく理由

    スクイージングは、振動の一方の量のばらつきを狭め、もう一方を広げる操作です。条件付きスクイージングでは、その作用を補助量子ビットの状態に応じて変えます。光子数を2ずつ変える作用なので、光子数が偶数であるというGKP状態の性質を保ちながら動かせる点が、今回の経路とよく合います。

    ただし、スクイージングを単純に繰り返すだけで格子状のGKP状態ができるわけではありません。補助量子ビットの回転と組み合わせ、振動子との量子もつれを途中で利用することで、単純なガウス形を超える構造を作ります。論文の理想経路を生む相互作用は、実機にそのまま搭載できる有限個の操作とは異なるため、最適化したパルスで近づけるという考え方です。

    比較したのは、条件付きスクイージング(CS)、補助量子ビットに応じて状態をずらす条件付き変位(CD)、光子数ごとに位相を変えるSNAPと変位の組み合わせです。経路を追う計算では、最後に目標状態へどれだけ近づいたかという忠実度と、途中で基準経路からどれだけ離れたかを、別々に評価しています。

    824ナノ秒の準備では、CSの最終忠実度は約0.990、途中の経路への重なりの最小値は平均約0.90でした。CDではそれぞれ約0.979と0.51、SNAPでは約0.83と0.19です。これは各方式20通りの初期値から最適化した結果の平均で、図中の代表的な一本のパルスの値とは区別します。

    また、0.990は性能の天井ではありません。この比較では、最終忠実度0.99以上を満たす範囲で経路への近さを重視する選択をしています。経路を追う条件を外して到着点だけを最適化した別計算では、CSは412ナノ秒で約0.998に達します。どの目的でパルスを選んだかによって、比べる数字も変わります。

    一つの状態の移送と、論理ゲートを混同しない

    論理ゲートは、入力が0か1かを知っているときだけ動けばよい装置ではありません。0と1の重ね合わせも含めて、入力された量子情報に正しく作用する必要があります。ところが、先ほどの光子数を節約する経路を、そのまま逆側の論理状態に適用しても、期待する状態へ移す忠実度は約0.60にとどまります。一つの入力に対してよい経路が、任意入力へのよいゲートになるとは限りません。

    研究はさらに、操作中ずっと同じ符号空間にとどまる論理反転に限ると、入力全体で平均した光子数の累積量が所要時間に比例し、最短の操作が光子損失の点でも有利になることを示しています。ここで符号空間とは、論理0と1、およびそれらの重ね合わせを表す状態の範囲です。

    この条件は省けません。途中で符号空間を出て最後に戻るゲートまで含めれば、より長くても平均の光子数の累積量を減らせる理想経路の例が、補足資料に示されています。したがって、「論理ゲートは常に最速なら最も損失が少ない」と一般化することはできません。

    実機で比べるために必要な条件

    今回のCSモデルは、補助量子ビットの二つの状態それぞれに応じたスクイージングを独立に制御できると仮定しています。また、振動子の寿命606マイクロ秒、補助量子ビットの寿命280マイクロ秒など、別の実験文献に基づくコヒーレンス時間を使っています。条件付きスクイージングの提案装置について想定された、より厳しい雑音条件で評価すると、同じパルスでも忠実度0.99には達しません。

    各方式の駆動振幅には共通の上限を置いていますが、操作中のエネルギー不確かさまで常に同じという比較ではありません。ポンプによる加熱や追加の位相雑音、実装の余分な時間も、すべてはモデル化されていません。有限個の初期値から得た局所的な最適化結果なので、他方式にもっとよいパルスが存在しないと証明したものでもありません。

    この研究から得られる設計上の手がかりは、到着時の忠実度だけでなく、途中の光子数、経路からのずれ、補助量子ビットとのもつれ、操作が任意入力へ作用するかを一緒に見ることです。状態準備に向く方法を論理ゲートへ広げる際にも、まず何を最適化するのかを明確にする必要があります。

    出典

  • 強磁場で単一光子検出器を使うには:向きが変える電流と読み出しの余裕

    強磁場で単一光子検出器を使うには:向きが変える電流と読み出しの余裕

    光を一粒ずつ検出する超伝導ナノワイヤー単一光子検出器(SNSPD)は、量子光学の実験で使われています。ところが、スピンを調べる測定などでは、検出器を強い磁場の近くへ置きたい場合があります。超伝導を利用する装置は、その磁場にどこまで耐えられるのでしょうか。

    オークリッジ国立研究所とSingle Quantumの研究チームは、検出器の向きを変えながら、最大14テスラ(T)の磁場で応答を調べました。2026年11月11日公開のプレプリントが示すのは、磁場の強さだけでなく、検出器の面に対する角度が重要だという結果です。ただし、14Tで暗計数を測れたことと、その磁場で単一光子の検出性能を確かめたことは分けて読む必要があります。

    簡単にまとめると?

    • 磁場が検出器の面に垂直だと、暗計数が増え始める電流が下がり、使える電流範囲が狭くなりました。面にほぼ平行にすると、強い磁場でも余裕を保ちやすくなります。
    • 12Tでの電流の余裕は、低磁場で測った光子検出の開始電流を基準にした条件付きの推定です。14Tでは暗計数の応答を測れましたが、その基準を下回っています。
    • 磁場で使える電流が減ると、読み出す電圧パルスも小さくなります。素子の向きに加え、読み出し回路のしきい値まで含めた設計が必要です。

    光を数える下限と、暗計数を抑える上限

    SNSPDでは、細い超伝導線にバイアス電流を流して待ち受けます。光子を吸収して局所的に状態が変わると、電流の流れ方が変化し、電圧パルスとして読み出せます。入力電流が小さすぎると光子を検出しにくくなり、大きすぎると光を入れていないのに数えてしまう「暗計数」が問題になります。

    そのため、使いやすさを見るには二つの境界が必要です。一方は光子を数え始める電流、もう一方は暗計数が許容値に達する電流です。この間に余裕があれば、検出しやすさと雑音を両立させる設定を選べます。暗計数の許容値を毎秒10回にするか200回にするかでも、境界は変わります。

    今回使った検出器は、厚さ10nm、幅100nmの窒化ニオブチタン(NbTiN)の細線を折り返して並べた構造です。超伝導への転移は約8Kから始まります。研究では、光を照らす測定と、高い磁場で暗計数を調べる測定を、別の低温装置で行っています。

    光子検出を測った磁場と、暗計数を測った磁場は違う

    光子検出側では、波長500nmの光を照らし、検出器面に垂直な磁場を約0.5Tまで変えて測りました。5Kで比較すると、光子を数え始める電流はあまり変わらない一方、暗計数が一定値へ達する電流は磁場とともに下がりました。上側の境界が下側へ近付き、利用できる電流範囲が狭くなる関係です。

    高磁場側では、光を照らした際の検出効率を同じ範囲で測ったのではなく、暗計数を角度と磁場の関数として調べています。温度は4Kと6Kで、比較の指標には暗計数が毎秒200回になる電流を使いました。この指標は、超伝導の熱力学的な臨界電流そのものを直接測った値ではありません。

    こうした条件を明記するのは、装置の最大磁場をそのまま性能保証へ置き換えないためです。「14Tまで測った」という数字から、検出効率、時間分解能、暗計数、出力信号が全て通常どおり保たれたとはいえません。

    強い磁場でも、面を貫く成分を小さくする

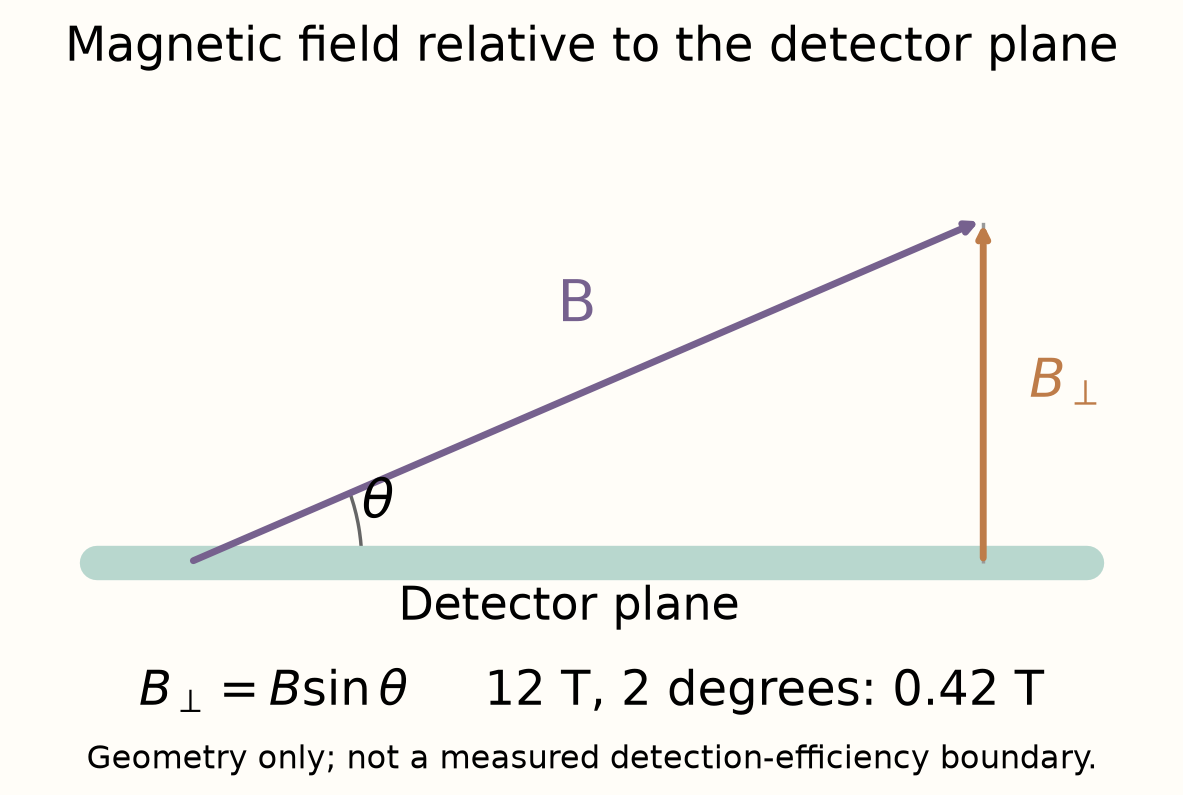
    角度は、磁場が検出器の面に平行なときを0度、垂直なときを90度としています。磁場の大きさをB、角度をθとすると、面を貫く成分はB sin θです。ほぼ平行に置けば、全体の磁場が大きくても垂直成分を小さくできます。

    検出器の面と磁場の角度を示す模式図。平行に近い磁場を面に沿う成分と垂直成分に分ける。12Tで2度なら垂直成分は約0.42T。検出可能範囲のグラフではない。
    Quantum Sea作成。角度の定義を説明する模式図で、角度は見やすく誇張しています。12T×sin 2度≒0.42Tは幾何学的な計算例であり、その磁場での検出効率を表すものではありません。

    例えば12Tでも、角度が2度なら垂直成分は約0.42Tです。2度は小さなずれに見えますが、強い磁場では無視できない成分になります。研究でも、面に最も近い向きの測定ほど、高い全磁場まで大きな電流を保てました。

    著者らは、垂直成分によって超伝導体中の磁束の渦が入りやすくなることと、観測された変化が整合すると解釈しています。渦の配置や侵入条件が変われば、暗計数や流せる電流も変化します。ただし、今回の測定で個々の渦を直接撮影したわけではありません。

    また、単純に垂直成分だけをそろえれば全てのデータが一致するわけでもありません。全磁場の影響を経験的な補正として含むモデルを用いており、ほぼ平行な測定にはそのモデルからのずれも残ります。角度の誤差と、高磁場そのものによる超伝導への影響を分けて調べる余地があります。

    12Tの「余裕」は条件付き、14Tではその基準を下回る

    最も平行に近い約2度の測定では、12Tでも暗計数のしきい電流が一定の大きさを保ちました。著者らは、低磁場で得た光子検出の開始電流、約9µAを参照すると、数µA程度の差が残るとしています。

    ここには、光子検出の開始電流が、高磁場・ほぼ平行な配置でも大きく変わらないという仮定があります。低磁場で変化が小さかったことは手がかりですが、高磁場で同じ光子測定をした結果の代わりにはなりません。12Tでの動作の余地を示す比較として読むのが適切です。

    14Tでも暗計数が毎秒200回になる電流は測れましたが、その値は参照した光子検出の開始電流より低くなりました。したがって、「14Tで応答が残った」を「14Tで単一光子を良好に検出できた」へ言い換えることはできません。

    超伝導が残っても、パルスを読み出せるとは限らない

    もう一つの制約は、出力パルスの高さです。測定では、磁場が強くなるにつれて、暗計数から決める電流の尺度と電圧パルスの振幅がともに低下しました。温度を上げたときにも、似た関係が見られます。

    読み出し回路は、一定の電圧を超える信号を検出イベントとして数えます。今回のイベント判定には100mVのしきい値を使っています。一方、磁場と角度の地図に示された250mVの線は、読み出しの余裕を見るための別の代表的な目安です。この二つを同じ判定条件として扱うべきではありません。

    利用できるバイアス電流が下がると、電流の変化から作られる電圧信号も小さくなります。素子が超伝導状態にあるだけでは、後段の回路が十分な余裕で信号を読めるとは限りません。磁場、温度、電流設定、増幅としきい値を組み合わせて考える必要があります。

    装置へ組み込むときに比較したい条件

    この研究は、一種類のNbTiN検出器について、磁場と角度に対する応答を整理したものです。線の幅、厚さ、折り返し形状、材料、温度が変われば、そのまま同じ境界になるとは限りません。14Tという上限の数字より、どの量を、どの向きで測ったかが判断材料になります。

    高磁場で使う検出器を評価するなら、暗計数で決まる電流範囲に加え、実際の光を入れた検出効率や開始電流、読み出しパルス、角度の安定性を同じ条件で確かめたいところです。今回の結果は、その比較に必要な項目を結び付けています。面に沿わせる配置は有効な工夫ですが、光子検出と読み出しを含めた確認が次の段階です。

    今回の研究に参加したSingle Quantumの事業については、Cyclewaveの光子検出器と冷却システムを開発する企業としての解説で紹介しています。

    出典

    • Harshit Agarwalほか、Mapping the High-Field Response of Superconducting Nanowire Single-Photon Detectors、arXiv:2611.16071v1、2026年11月11日公開。本文と図1〜4を参照。2026年11月14日に第1版を確認。PDF内の日付は11月13日。査読済み最終版ではなくプレプリントです。別の補足資料の独立検証や公開データの再解析を行った記事ではありません。
  • シリコンTセンターを400か所で測定:個別調整を省く広帯域共振器

    シリコンTセンターを400か所で測定:個別調整を省く広帯域共振器

    シリコンの中に作った発光点を、量子ネットワークの接点として使う研究が進んでいます。その候補がTセンターです。ただし、役立つ光が弱いと、一つの場所を調べるだけで時間がかかります。材料や製造工程を比較するには、優れた一例だけでなく、多数の場所を測れることも大切です。

    デルフト工科大学とQuTechの研究チームは、波長を個別に調整せずに測定できる、広帯域の光共振器を開発しました。2026年11月11日公開のプレプリントでは、400個の共振器を測定し、Tセンターから集めた光の信号が中央値で6.5倍に増えています。ここで示された「42倍の高速化」がどの時間を指すのか、共振器の設計と合わせて見ていきます。

    簡単にまとめると?

    • 高いQ値を追うだけでなく、製造時の波長のばらつきを受け入れる広帯域の共振器を使い、400個を個別の波長調整なしで測定しました。
    • 信号は中央値で6.5倍。背景雑音が支配的な条件では、同じ信号対雑音比に必要な積算時間を約42分の1にできます。装置の移動や位置合わせを含む全作業が42倍速くなったわけではありません。
    • 信号のばらつきとシミュレーションを比較して、試料内のTセンター密度も推定しました。400個の量子ビットを制御した実験とは異なります。

    光を強くするだけでなく、多数の場所で測りやすくする

    Tセンターはシリコン中の発光欠陥で、光と電子・核のスピンを結び付ける候補です。通信で使うOバンドに光の遷移を持つため、固体中に保つ量子情報と、離れた場所へ運ぶ光をつなぐ研究で注目されています。今回の実験は、そのための材料評価を効率よく行う段階にあります。

    発光には、結晶の振動を伴う成分と、振動を伴わない成分があります。後者がゼロフォノン線(ZPL)です。量子情報を光へ結び付ける用途で重要ですが、Tセンターから出る光の全てをこの成分として取り出せるわけではありません。さらに、シリコン内部から外へ集める際にも光が失われます。

    光共振器は、特定の波長の光を閉じ込めて発光を強めたり、取り出す方向を整えたりする構造です。光を閉じ込める度合いを表すQ値が高いほど、有利になる場面があります。しかし、その代わり、よく働く波長の幅が狭くなります。発光点と共振器の波長が少しずれるだけで、期待した増強が得られなくなるのです。

    一つの素子なら、波長を後から合わせる方法もあります。多数の素子を比較する場合には、その調整を一つずつ行う時間が課題になります。今回の考え方は、製造で避けられないずれを見積もり、初めから一定の幅を持つ共振器にすることです。

    同心円の共振器と、波長のずれを受け入れる幅

    採用したのは、中心の円盤を同心円の溝で囲む「ブルズアイ共振器」です。周囲の周期構造は弱い鏡として光を中心へ閉じ込める一方、面の外へ光を取り出し、対物レンズで集めやすくします。発光速度を変えるパーセル効果と、光を集める効率の改善を組み合わせています。

    著者らは、共振器と発光点の波長の重なりを含めて性能を評価しました。ある一定の波長ずれに対しては、共振器の線幅をそのずれの約2倍にすると、Q値と波長の重なりの積が最大になります。多数の素子では、製造ばらつきの標準偏差を基準に線幅を選ぶという設計の目安を提案しています。あらゆる共振器に共通する最適値を確定したものではありません。

    測定した400個では、発光波長からのずれは平均0.0nm、標準偏差1.1nmでした。共振器の線幅は平均4.7nm、標準偏差1.0nmで、Q値は平均298、標準偏差78です。「低Q」とは光を使えないという意味ではなく、狭い波長だけを強く選ぶ代わりに、多くの素子で発光と重なりやすくした選択です。

    「個別調整なし」の前に、製造工程を校正している

    この成果は、設計した形をそのまま作れば調整が一切いらない、という意味ではありません。研究チームはまず中心円盤の半径を変えた配列を作り、計算と実測の共振波長を比べました。そこでは約29.5nmの系統的な波長のずれが見つかっています。

    その結果を設計へ戻し、露光や加工の影響も含めて補正しました。最終的には設計上の半径562.5nmの配列がよく一致し、電子顕微鏡で調べた実際の半径は約535nmでした。計算が想定した形と、加工のために描く形を分けて扱っています。

    こうして工程を校正した上で、20×20の配列に並ぶ400個を調べました。個々の共振器の波長を測定中に調整する工程を省けたことが成果です。一方、配列の内側と外側には波長の傾向が残っており、露光時に周囲のパターンが影響する近接効果など、製造側にも改善の余地があります。

    信号6.5倍から「積算時間42分の1」になる条件

    試料を4Kまで冷却し、緑色レーザーで励起して発光を測りました。弱い励起の測定ではレーザー出力10µW、1個につき15秒の積算を用いています。比較対象は同じ試料・同じ冷却時に測った、共振器加工をしていない九つの場所です。

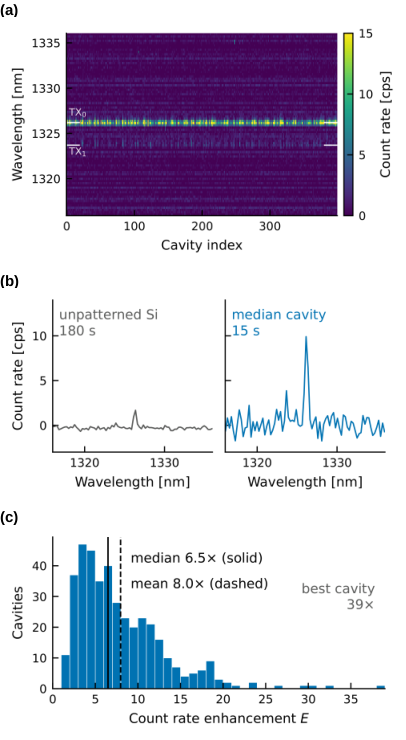
    400個の信号増強率には幅があり、中央値は6.5倍でした。この測定では背景雑音が支配的で、信号対雑音比は、増強率に積算時間の平方根を掛けた量に比例します。同じ信号対雑音比を目指すなら、必要時間は増強率の二乗に反比例します。6.5×6.5は約42なので、積算時間を約42分の1にできるという関係です。

    原論文の図3。400個の共振器の発光スペクトル、未加工領域と中央値の共振器の比較、信号増強率の分布を示す。中央値6.5倍に対して個々の増強率はばらつく。
    原論文の図3。(a)400個の発光、(b)未加工領域と中央値の共振器、(c)増強率の分布。比較スペクトルの実際の積算時間は未加工180秒・共振器15秒で、同じ雑音水準にそろえた測定ではありません。出典:C. F. Primaveraほか「Large-scale characterisation of silicon T centres with tuning-free broadband cavities」、arXiv:2611.15412v1、図3、CC BY 4.0。原図を変更せず掲載。画像を開くと拡大できます。

    ただし、この二乗の関係は、今回の背景雑音が支配的な条件に基づきます。光子そのものの揺らぎが支配的な別の測定にも、同じ42倍をそのまま適用することはできません。また、原図の180秒対15秒という比較と、同じ信号対雑音比を仮定した42倍という見積もりは、別の数字です。

    全体の測定時間も区別が必要です。400個の測定には約5.5時間かかり、そのうちスペクトルの積算は1時間40分でした。残りには検出器の確認、試料上の移動、位置の最適化が含まれ、1個につき約35秒の固定的な時間がかかります。光の信号を強くしたことで、時間の制約が積算から装置の動作へ移ったといえます。

    ばらつきから、発光点がどれくらい存在するかを推定

    信号の強さは共振器の性能だけで決まりません。内部にTセンターが何個あるか、どの位置にあり、発光の向きがどうなっているかにも依存します。少数しか存在しない場合には、たまたま中心にあるかどうかが大きく効きます。多数なら、位置や向きの偶然性が平均化され、共振器側の性能と信号の対応が強くなるはずです。

    研究チームはこの考えをモンテカルロシミュレーションで調べました。実測した共振器の波長と線幅を使い、仮定した密度に応じてTセンターの位置や向きをランダムに配置して、信号のばらつきを計算します。実測の弱い相関を再現する密度として、1平方µm当たり4.2個、推定幅は−0.8〜+1.3個という値を得ました。

    この方法の利点は、装置が光を何割集めているかという効率の絶対値を、別途仮定せずに推定できる点です。ただし、発光点を一個ずつ直接数えた結果ではありません。層の深さ方向への分布や発光の向きなどのモデルに基づいています。補足資料では分布や飽和条件を変えた比較も示されていますが、全ての製造条件で同じ推定が成立すると確認したわけではありません。

    量子ネットワークを作る前の、材料評価の足場

    今回の400個は、Tセンターの集団からの光を調べた共振器の数です。400量子ビットの演算や、400点を結ぶ量子もつれ配送を実証した数ではありません。また、試料ごとの製造ばらつきまで校正が不要になったわけでもありません。

    それでも、多数の場所を同じ方法で測れることには意味があります。加工や熱処理を変えたときに、最も明るい一例だけでなく、平均的な振る舞いやばらつきがどう変わったかを比較しやすくなるからです。共振器を選ぶ際には、最高のQ値とともに、波長合わせの手間、得られる信号の分布、測定の総所要時間を見る必要があります。

    次の改善点は、位置合わせなどの固定時間を減らすことと、製造ばらつきをさらに抑えることです。広い帯域で多くの素子を測る設計は、個々の発光点を詳しく調べる研究や、製造工程の比較へつながる手段として位置付けられます。

    出典

  • Google Quantum AIのCSS回路シミュレーション:1ゲートの処理を一定にする仕組みと限界

    Google Quantum AIのCSS回路シミュレーション:1ゲートの処理を一定にする仕組みと限界

    量子回路の誤り訂正を調べるときは、同じ回路を何度もシミュレーションし、どのくらいの頻度で失敗するかを数えます。回路が大きくなり、試行回数も増えるほど、一つの操作を処理する小さな負担が積み重なります。

    Google Quantum AIのCraig Gidney氏とCody Jones氏は、使う操作を絞った「CSS回路」なら、1ゲート当たり一定の処理量で測定結果をサンプリングできる方法を示しました。2026年11月11日公開のプレプリントです。量子計算全般を安く模擬する万能な方法ではありませんが、原子が失われる誤りを含む回路評価に役立つ可能性があります。

    簡単にまとめると?

    • 対象はX、Z、X基底測定、Z基底測定、CNOTからなるCSS回路です。測定結果に応じて次の操作を変える場合も扱えます。
    • 各量子ビットに対応する二つの古典ビットを更新し、測定結果を生成します。1ゲート当たりO(1)というのは、量子ビット数が増えても基本操作数が増えないという意味です。
    • Hadamard、CZ、Sなどを同じ仕組みへ素直に加えることはできません。原子損失への応用や、コンパイル後の回路を見分ける問題は、範囲と限界を分けて読む必要があります。

    なぜ原子が一つ抜けると、模擬計算が難しくなるのか

    誤り訂正の評価では、理想的な測定結果から、誤りによってどの結果が反転するかだけを追う方法がよく使われます。全ての量子状態の情報を毎回計算し直すより、必要な差分に絞れるためです。

    この方法が得意とするのは、ビット反転や位相反転として表せるパウリ誤りです。しかし、中性原子を使う装置で原子そのものが失われると、そこへ作用するはずだったゲートが実行されなくなります。「操作した後に反転が加わる」場合と、「操作自体が抜ける」場合は同じではありません。

    たとえば、二つの量子ビットを結ぶCNOTが抜けると、その後の相関の作られ方も変わります。通常の反転だけを追う計算では扱いにくく、より多くの状態情報を追う必要が生じます。今回の論文は、操作が抜けても簡単な計算の枠内にとどまる回路の種類を選ぶ、という方向からこの問題を見ています。

    CSS回路で使えるのは五つの基本操作

    論文でいうCSS回路は、Xゲート、Zゲート、X基底の測定MX、Z基底の測定MZ、CNOTで構成されます。Xは0と1を入れ替える操作、Zは状態の成分間の位相を反転する操作です。測定の基底は、量子ビットのどの性質を読み出すかに対応します。CNOTは、制御側に応じて標的側を反転する二量子ビット操作です。

    使える操作は少なくても、測定結果に応じた制御を組み合わせれば、|0⟩や|+⟩などの状態を準備できます。三つのCNOTで二量子ビットの状態を交換するSWAPを作ることも可能です。誤り訂正や、もつれを利用する通信手順の一部も、この範囲で表せます。

    一方、Hadamard(H)、CZ、S、Tなどは基本操作に含まれません。CSSはウェブの見た目を整えるスタイルシートの意味ではなく、X型とZ型の構造を分けて扱う量子回路の呼び名です。また、同じ「CSS」という名の符号を使っていても、その全ての実装回路が今回の五つの操作だけで構成されるとは限りません。

    「全て0」の基準を使えることが、計算を簡単にする

    通常の反転シミュレーションでは、まず誤りのない回路で可能な測定結果を一つ用意し、それを基準にします。実際の試行で誤りが加わったときは、その基準からどこが反転するかを計算します。

    今回の鍵は、CNOTとX・Z基底測定だけからなる回路について、全ての測定結果が0になる経路が必ず可能であることです。論文ではこれを証明し、最初の基準結果を別の重い計算で求める工程を省けるようにしています。

    もちろん、全ての試行で結果が0になるという意味ではありません。0は計算上の基準です。実際のランダムな測定結果は、後で説明する古典ビットの更新から生成します。意図して加えるX・Zゲートも反転として追うことで、五つの操作からなるCSS回路全体を扱えます。

    この基準は、どのゲートを確率的に実行するか、測定結果を受けてどの操作を選ぶかが変わっても使えます。原子損失によって一部のゲートを飛ばす場合にも、残る回路がCSSの範囲内なら同じ考え方を保てます。

    二つの古典ビットで、測定結果を更新する

    シミュレーターは、各量子ビットqに対し、ビット反転を追うxqと位相反転を追うzqの二つの古典ビットを持ちます。|0⟩から始める場合はxを0にし、zをランダムにします。Xゲートならxを、Zゲートならzを反転します。

    Z基底測定ではxを結果として読み、zにランダムな反転を加えます。X基底測定では逆にzを読み、xをランダムに反転します。測定していない側の情報をそのまま固定せず、乱数で更新することが、次の測定結果の統計を再現するために必要です。

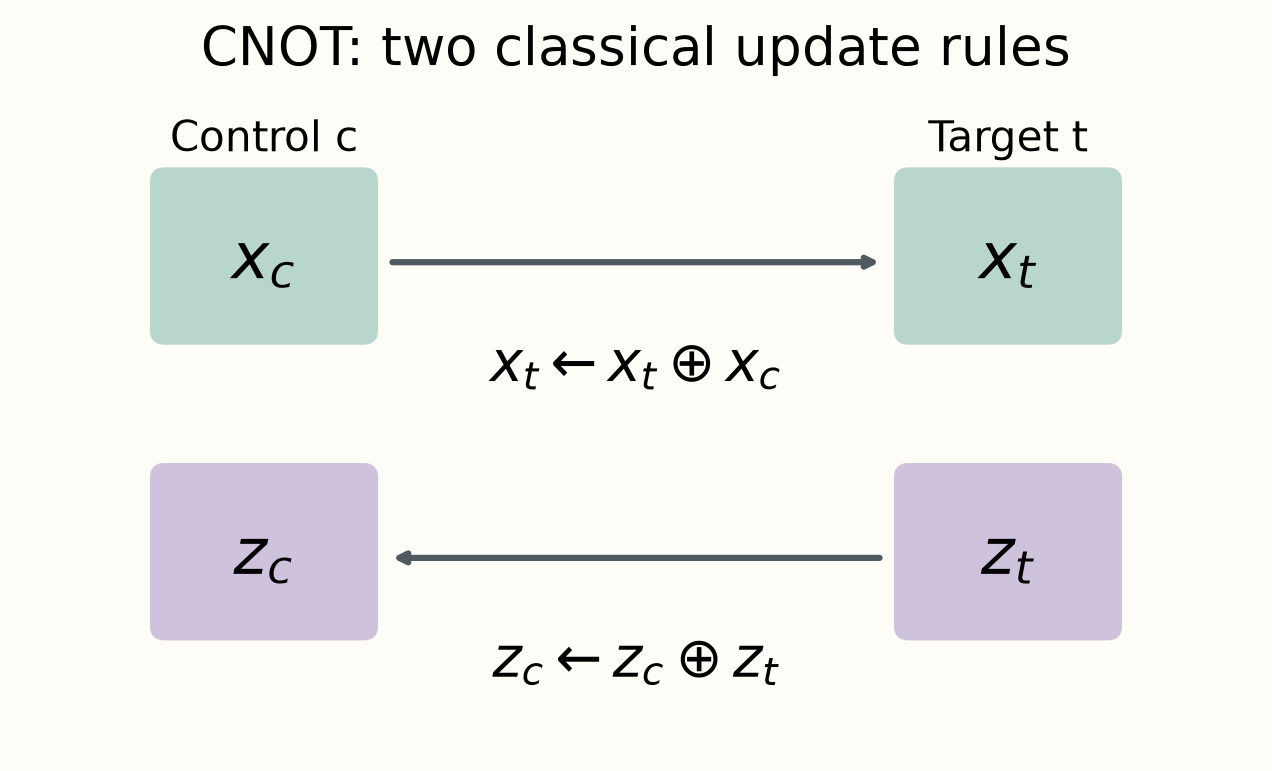
    CNOTの更新も短く、制御側cのxを標的側tのxへ排他的論理和(XOR)で加え、標的側tのzを制御側cのzへXORで加えます。XORは二つのビットが異なれば1、同じなら0になる計算です。xの影響とzの影響が、互いに逆向きに伝わります。

    CSSシミュレーターのCNOT更新規則。xの情報は制御側cから標的側tへ、zの情報は標的側tから制御側cへXORで加えられる。
    Quantum Sea作成。原論文第2.3節と図1の更新規則を説明する図です。上段はxtをxt XOR xcへ、下段はzcをzc XOR ztへ更新します。量子状態一般を二つのビットへ圧縮できるという意味ではなく、この制限された回路の測定統計を生成する規則です。

    どの基本操作も、一定個数のビットに一定個数の更新を行います。これが1ゲート当たりO(1)となる理由です。論文には、その仕組みを示す短いPythonコードも掲載されています。

    ただし、回路全体の時間が一定になるわけではありません。ゲート数が増えれば更新回数は増え、試行を何度も繰り返せばその分の処理が必要です。保存するビット数も量子ビット数に比例します。また、この理論的な処理量の議論は、特定の実機で何倍速く動いたというベンチマークとは区別されます。

    Hadamardを足すだけでは済まない

    HadamardはXとZの役割を入れ替えるため、xとzを交換すれば対応できそうに見えます。しかし、論文はそれでは正しい量子回路の振る舞いにならない例を示しています。

    理由は、今回のシミュレーターが局所的な隠れた変数のモデルになっていることです。各量子ビットの二つのビットが、その場所で可能な測定結果を決めます。この種類のモデルは、離れた系の相関について、ベル不等式を破る結果を生成できません。

    一方、CSS回路へH、S、CZのいずれかを加えると、ベル不等式を破る相関を作る回路を構成できます。論文は三者が参加するGHZテストを例に挙げています。テストでは、入力を受け取った後に互いに通信できない三者へ、条件を満たす入力を配り、出力の組み合わせが指定の規則に従うかを調べます。局所的な古典モデルでは少なくとも4分の1の確率で失敗する条件でも、理想的な量子相関なら全て成功できます。

    したがって、同じ局所モデルのままHなどを付け足すことはできません。ただし、これは「あらゆる別の計算方法でも1ゲートO(1)は不可能」と証明した結果ではありません。論文が示すのは、この仕組みを広げる際に越える必要のある具体的な制約です。

    評価したい回路が、本当にCSSの範囲にあるか

    実際に使う前には、理論上の回路名だけでなく、実行する操作列を確認する必要があります。たとえば、CSS回路中のCNOTを、装置向けにCZとHadamardへ分解すると、見かけ上は今回の基本操作の集合から外れます。著者らは、このように内部にCSS構造を持つ回路を見分け、安全かつ効率的に模擬する問題を今後の課題としています。

    また、原子損失を含む誤り訂正の評価に適していそうだという見通しと、具体的な装置の全ての雑音を再現したという実証は別です。対象のゲート、失われた原子への処理、初期状態、測定の種類をそろえた上で、どこまで同じモデルに収まるかを確認する必要があります。

    今回の価値は、制限のある回路でも、誤り訂正や通信で役立つ処理が残ることを明確にした点です。模擬したい現象に必要な操作を見極めることで、全状態の情報を追わずに済む領域が見えてきます。

    研究チームの所属するGoogleと親会社の事業の関係は、CyclewaveのAlphabetの企業解説にまとめています。ここで扱った回路シミュレーションの研究と、会社全体の事業は分けて読むと位置付けがつかみやすくなります。

    出典

  • 固体ネオン処理で超伝導共振器のTLS損失を低減:表面残渣の移動を調べる

    固体ネオン処理で超伝導共振器のTLS損失を低減:表面残渣の移動を調べる

    超伝導回路を低温に冷やしても、電磁波のエネルギーが少しずつ失われることがあります。その一因が、材料や表面にあるTLS(二準位系)です。微細加工で残った物質も損失に関わるため、回路を傷めずに表面を整える方法が求められています。

    ニューサウスウェールズ大学とシドニー大学の研究チームは、超伝導共振器の上でネオンを凍らせ、取り除く処理を調べました。2026年11月11日公開のプレプリントでは、一部の共振器でエネルギーの保ちやすさが改善し、ネオンを除いた後も効果が残っています。表面の残留物が移動することが、その理由ではないかと考えられています。

    簡単にまとめると?

    • NbTiN製の超伝導共振器にネオンを堆積し、凍結・蒸発させる実験です。ネオンを取り除いた後にも、損失の低減が見られました。
    • 平均光子数が約10万の条件では、内部品質係数Qが初期値の平均4.3倍、別チップでは2.4倍になりました。ただし、改善しない共振器もあります。
    • 別のhBN試料では表面の高分子残渣が集まって移動する様子を観察。損失低減の仕組みを支持する結果ですが、量子ビットの寿命向上を直接示した実験ではありません。

    TLSは、回路からエネルギーを受け取る小さな自由度

    TLSは、二つの状態を取り得る原子や電子の配置などを表すモデルです。共振器の電場からエネルギーを受け取り、その後、周囲へ放出すると、回路から見れば損失になります。基板内部の欠陥、表面の酸化物、吸着した分子、加工に使ったレジストの残りなど、起源は一つではありません。

    共振器は、特定の周波数の電磁波を保つ素子です。今回使った内部品質係数Qiは、共振器内部でどれほどエネルギーが失われにくいかを表し、大きいほど損失が小さい指標です。外部の測定線へ出ていく分と、共振器内部で失われる分を分けて評価します。

    表面を酸やプラズマで洗浄したり、高温で処理したりする方法もあります。しかし、材料や構造によっては使いにくい場合があります。そこで研究チームが着目したのが、化学的に反応しにくい希ガスであるネオンです。今回はネオンを永久的な保護膜として残すだけでなく、付けてから取り除く過程を比較しています。

    凍らせる前後、取り除いた後を同じ回路で比較

    主な試料は、シリコン基板上の窒化ニオブチタン(NbTiN)薄膜から作ったチップです。一つの測定線に八つの共振器を接続し、周波数は約5.75〜6.49GHzに分かれています。超低温の20mK付近で測定し、入力するマイクロ波の強さや温度を変えて応答を調べました。

    ネオンを付けるときは装置を約26Kまで温めます。これはネオンの三重点24.556Kより高い温度です。導入したネオンを液体として試料上へ届け、その後の冷却で固体にします。処理の前後に共振周波数が変わることから、チップ上にネオンが存在することも確かめています。

    研究では、最初の冷却、ネオンを付けた状態、室温まで戻してネオンを除いた後、再びネオンを付けた状態を追いました。単に別々のチップを一度ずつ比べるのではなく、同じ共振器が処理を経てどう変わるかを見ています。一方、室温への昇温や試料の取り出しも含む工程なので、ネオンの有無だけを切り替えた完全に同一条件の比較とは分けて考える必要があります。

    高い入力での平均改善と、単一光子付近の改善を分ける

    20mK、共振器内の平均光子数が約10万という条件では、主試料の内部Q値は最初から最後の測定までに平均4.3倍になりました。別の冷凍機で測った第二の試料でも、平均2.4倍の改善が報告されています。第二の試料はサファイア基板と厚さ12nmのNbTiN薄膜を使い、主試料のシリコン基板・40nm薄膜とは異なります。

    この平均値だけで、全ての共振器が同じように良くなったとはいえません。主試料ではネオン除去後に明確に改善したのは八つのうち四つで、ほかはほぼ変わらないか少し低下しました。第二の試料でも改善したのは八つのうち六つです。初回のネオン堆積だけでは改善が小さく、除去した後に大きく変わる共振器がある点が重要です。

    量子情報の用途では、電磁波を強く入れたときだけでなく、平均光子数が1付近の弱い入力でも損失が小さい必要があります。本文で示された共振器1では、この領域の内部Q値が4.7×10⁵から1.4×10⁶へ改善しました。約3倍という個別の結果であり、先ほどの高入力時の平均4.3倍とは条件が異なります。

    また、内部Q値の向上と、量子ビットの計算性能や寿命の向上は同じ測定ではありません。今回の実験対象は共振器です。量子ビットへ適用した際にどの損失が支配的になるかは、別の検証が必要です。

    温度と入力の変化から、損失の内訳を探る

    TLSによる損失は、入力の強さや温度に応じて変わります。エネルギーを受け取るTLSが飽和すれば、さらに電磁波を入れたときの吸収の仕方も変わるためです。研究チームはこの依存性を使い、全損失をTLS、準粒子、そのほかの寄与に分けるモデルで解析しました。

    ネオンの除去後には、TLSに対応する損失が小さくなったと解釈できる変化が見られます。ただし、これは個々のTLSを数えた結果ではなく、測定値をモデルへ当てはめた推定です。内部Q値が改善しない共振器でも、TLSに割り当てた寄与だけは改善する場合がありました。別の損失が残れば、全体のQ値は上がらないからです。

    温度を4Kまで上げて、準粒子による損失が支配的になる条件も調べています。その比較は、ネオン膜が放射線を遮ることで改善したという説明を支持しませんでした。また、ネオンを除去しても改善が残ることから、膜が電場の分布を変えただけという説明でも不十分です。こうした比較を通じて、表面の残留物の変化へ候補を絞っています。

    表面の残渣が移動する様子を、別の試料で観察

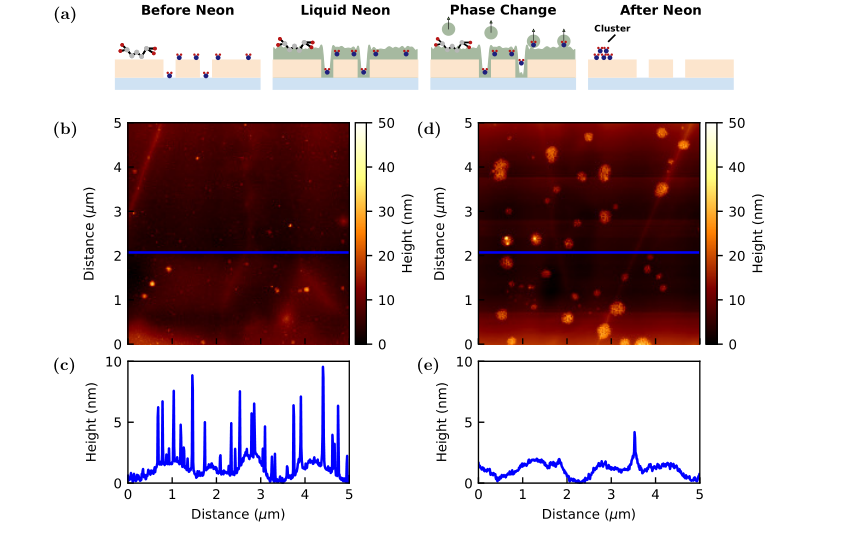
    仕組みの手がかりを得るため、研究チームは高分子の残渣が付いた六方晶窒化ホウ素(hBN)の薄片にもネオン処理を行いました。原子間力顕微鏡(AFM)で表面の高さを測ると、処理前に散らばっていた小さな残渣が、処理後にはより大きな集まりとなり、マイクロメートル程度の距離を移動していました。

    原論文の図6。上段は残渣が移動する仕組みの仮説。下段左はネオン処理前、右は処理後のhBN表面のAFM像と高さ断面で、処理後は残渣が集まり、間に平らな領域が見える。
    原論文の図6。上段(a)は提案された仕組みの模式図で、直接撮影した過程ではありません。(b)(c)は処理前、(d)(e)は処理後のhBN表面と、青線に沿う高さの断面です。共振器表面そのものの観察とは区別してください。出典:A. Palmerほか「Reducing TLS Losses in Superconducting Circuits Using Solid Neon」、arXiv:2611.15021v1、図6、CC BY 4.0。原図を変更せず掲載。画像を開くと拡大できます。

    残渣が移動して集まれば、表面の広い部分が空いたり、共振器の電場と強く結び付く位置から離れたりする可能性があります。著者らは、液体ネオンが凍る、あるいは蒸発する際の境界の移動が残渣を運ぶ仕組みを提案しています。ただし、その過程を直接追跡して確認したわけではありません。

    hBNと共振器表面では、形状も化学的性質も異なります。この観察は残渣の移動が起こり得ることを示す定性的な根拠です。共振器で失われたエネルギーのどれだけが、どの残渣に対応していたかを一対一で特定した結果ではありません。

    次に確かめたいのは、工程の再現性と素子ごとの差

    今回の結果は、材料を強く反応させる洗浄以外にも、表面を整える余地があることを示しています。一方で、全ての共振器が改善したわけではなく、ネオン処理が残渣を均一に除去する工程とも限りません。残渣が移動して別の場所へ集まるなら、元の汚れ方や回路配置によって効果が変わる可能性があります。

    解析にも範囲があります。元の1,934測定から、不確かさが大きいものや温度情報に問題のあるものなどを除き、1,572測定を使っています。第二の試料では、時間上の制約から温度と入力の全範囲の解析を行っていません。二つの試料で改善が見られたことと、あらゆる材料・製造工程で再現できることは別です。

    今後の比較では、単一光子付近の改善が安定して得られるか、繰り返す処理で何が移動するか、量子ビットを含む回路で別の損失を増やさないかが重要になります。固体ネオンを使う意義は「覆って守る」だけにとどまらず、付けて取り除く過程が表面をどう変えるかにあります。

    出典

  • 格子手術のバースト誤り対策:守る補助量子ビットを回路の測定に合わせる

    格子手術のバースト誤り対策:守る補助量子ビットを回路の測定に合わせる

    量子コンピューターでは、小さな誤りを何度も調べて訂正しながら計算を進めます。ただ、宇宙線などによる高エネルギーの衝撃がチップに入ると、多くの量子ビットが一度に影響を受けることがあります。こうしたバースト誤りに備えて一部の素子を強く保護するなら、どこを選ぶのがよいのでしょうか。

    2026年11月10日に公開されたJaebum Kim氏のプレプリントは、格子手術という論理演算の進み方に合わせて、守る補助量子ビットを選ぶ方法を調べています。同じ数を保護するシミュレーションでも、単に演算領域の境界に近いものを選ぶ配置より、そこで測定する種類に合わせた配置のリスクが低くなる条件がありました。ポイントは、量子ビットの位置と、回路の中で果たす役割を一緒に見ることです。

    簡単にまとめると?

    • 表面符号の領域をつなぐ格子手術では、途中で測定内容が変わります。境界付近でも、どの種類の測定を担う補助量子ビットかによって、誤りの影響が違います。
    • 符号距離9の特定条件では、測定の種類に合わせた保護で、衝撃による超過リスクが約38%低下しました。実機の総誤り率を38%下げた結果ではありません。
    • 短いバーストでは配置の優劣が逆転する場合もあります。実機の誤りの続き方、復号器の知識、保護の製造コストまで含めた確認が必要です。

    格子手術では、測定の切り替わりも境界になる

    表面符号は、複数の物理量子ビットを使って一つの論理量子ビットを守る方式です。計算情報を持つデータ量子ビットの周囲に、誤りの兆候を調べる補助量子ビットを配置します。補助量子ビットの測定結果を時系列で比べ、どこで誤りが起きたかを推定します。この推定と訂正の選択を担うのが復号器です。

    格子手術は、表面符号の領域を測定によってつなぎ合わせたり切り離したりして、論理演算を行います。今回の計算では、制御、補助、標的の三つの領域をL字に並べ、ZZの共同測定、待機、XXの共同測定を経てCNOTという論理ゲートを実行します。ZZとXXは、異なる種類の共同の性質を調べる測定です。

    演算中に測定の内容が切り替わると、直前や直後の同じ測定結果と比較できない場所が生じます。これが時間方向の境界です。たとえば、最後の読み出しで測定系列が終われば、その後の結果と照合する機会はありません。同じ距離にある補助量子ビットでも、こうした境界にどう関わるかによって、測定を誤ったときの影響が変わります。

    同じ保護数で、選ぶ基準を比べる

    研究では三つの静的な配置を比べています。一つは領域をつなぐ継ぎ目の近くを浅く守る配置、もう一つは同じ予算で可能な限り深く守る配置です。これらは幾何学的な距離を基準に選びます。三つ目のtyped配置は、ZZの継ぎ目ならZ型、XXの継ぎ目ならX型というように、その場で測る種類の補助量子ビットを優先します。

    公平に比べるため、保護する補助量子ビットの総数だけでなく、X型とZ型の内訳もそろえています。データ量子ビットと、領域をつなぐ間だけ使う測定用素子は、どの配置でも強く保護します。typed配置だけが、チップ全体に多くの保護を追加したわけではありません。また、保護の配置は演算中に切り替えず、最初から固定しています。

    ここでいう保護は、衝撃に対する応答の強さを変えるモデルです。超伝導体のエネルギーギャップを調整するgap engineeringが背景にありますが、この論文の配置比較は数値シミュレーションです。提案通りの素子を製造し、同じ改善を実測した報告ではありません。

    38%が表すのは、衝撃による超過リスク

    主な比較は符号距離9の回路です。符号距離は、符号がどれだけの誤りに耐えられるかに関わる尺度で、9量子ビットだけを使うという意味ではありません。研究では3,200通りの衝撃を用意し、位置、エネルギー、発生時刻から各素子の誤りを生成しました。

    指標は、衝撃が起きた場合の論理演算の失敗確率から、衝撃のない基準値を引いた超過リスクです。二つの入力条件を試し、悪い方を指標に使っています。衝撃自体が一日に何回起きるかを含む、運転全体の失敗確率とは分けて読む必要があります。

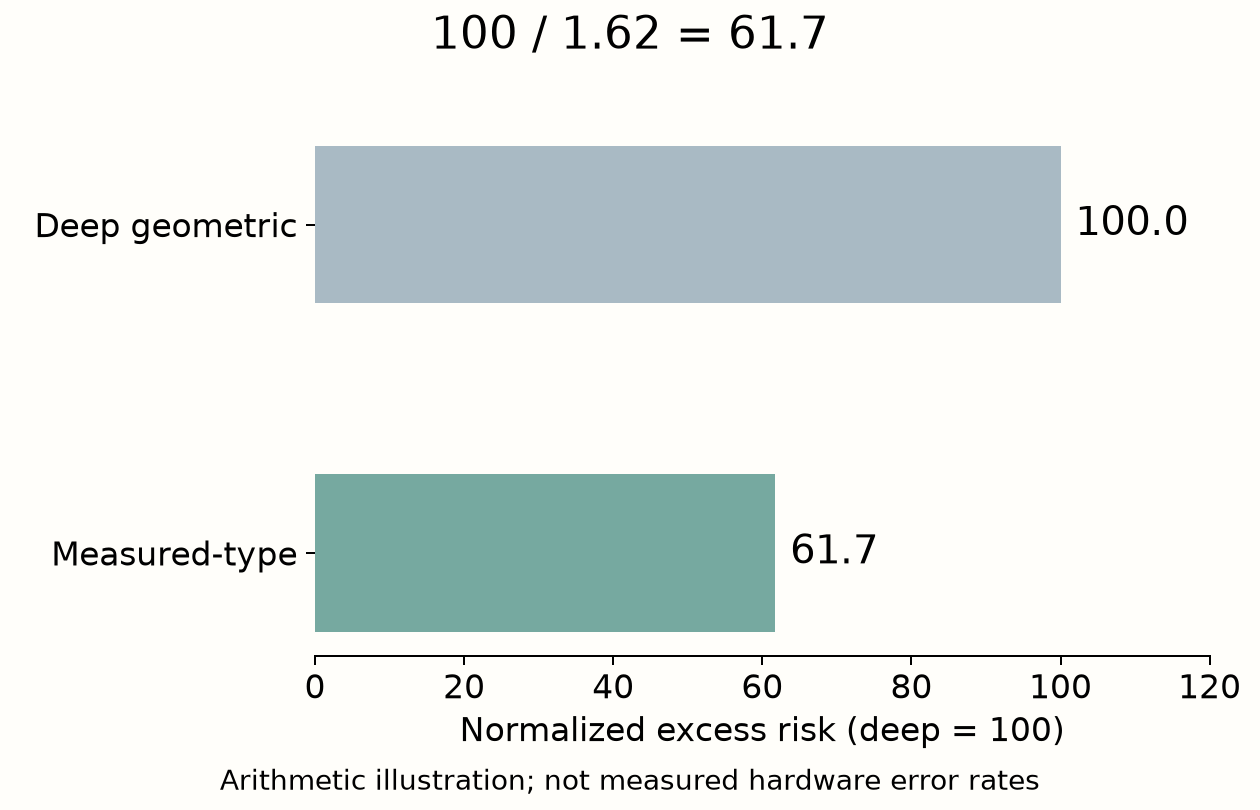
    衝撃の情報を与えず、平常時の雑音モデルと検出事象の相関を使う復号器では、深い幾何学的配置の超過リスクがtyped配置の1.62倍でした。逆に、深い配置を100としたときtyped配置は約62となり、低下は約38%です。95%のブートストラップ区間で示した低下幅は33〜44%。この区間は、採用したモデルと標本に基づく不確かさで、実機に移した際の誤差まで保証するものではありません。

    深い幾何学的配置の超過リスクを100と置いた計算例。比1.62から求めると、測定種類に合わせた配置は約61.7となり、約38.3%低い。
    Quantum Sea作成。論文の符号距離9・相関を使う平常時復号の比1.62を使い、深い配置を100として換算した図です。100÷1.62≒61.7、低下率は1−1÷1.62≒38.3%。絶対的な失敗確率や、実機の測定値を示すグラフではありません。原資料の図2に示された比の意味を説明しています。

    測定の誤りと、データへ伝わる誤りが重なる

    保護する位置だけで差が出る理由を調べるため、研究は誤りをいくつかの種類に分けます。補助量子ビットの読み出し値が間違う誤り、補助量子ビット自体に生じてゲートを通じデータへ伝わる誤り、リセット時の誤りです。

    シミュレーションで衝撃に伴う読み出し誤りを取り除くと、浅い配置とtyped配置の差は明確でなくなりました。補助量子ビットに生じるパウリ誤り(ビット反転や位相反転として表す誤り)を取り除く場合も、差はおよそ半分になります。つまり、結果を誤って読むことと、データ側へ誤りが伝わることが一緒に働いています。

    単に継ぎ目から何マス離れているかを見るだけでは、測定の終端やゲートの向きを取り込めません。回路がその補助量子ビットをいつ、何の測定に使うかを見ることで、守る優先順位を変えられる、という因果関係です。

    「49個少なく守る」は、補間による見積もり

    別の計算では、168個を守る浅い配置と同じ超過リスクへ、typed配置なら何個の保護で届くかを調べました。600通りの衝撃を共通に使い、保護数を117、123、132などと変えています。

    計算した点の間を、超過リスクの対数で直線補間すると、同じ基準へ届く保護数は約118.8個となりました。168個との差がおよそ49個です。実際に計算した123個の点では、保護数の差は45個となります。118.8個の素子を作った、あるいはチップから49量子ビットを減らした、という意味ではありません。

    さらに、今回の選択規則では117個未満の構成を作れず、補間にもその下限が影響します。保護する素子を減らせば製造がどれだけ簡単になるかは、一素子当たりの工程や配置制約を別に調べて初めて評価できます。

    誤りの長さや復号器が変わると、結論も変わる

    符号距離13では、衝撃の実現した条件を復号器へ知らせる比較で、typed配置と深い配置の優劣は明確になりませんでした。この復号器が知るのは衝撃のパラメーターであり、実際に生成された全誤りの履歴ではありません。復号器へどの情報を渡すかは、比較の大切な条件です。

    バーストを5回の測定ラウンド、モデル上の5.5マイクロ秒で打ち切ると、相関を使わない平常時復号の比較では、浅い配置の方が低リスクになる例もありました。長く続く誤りへの有効性を、そのまま短い誤りへ当てはめることはできません。

    研究自身が挙げる限界もあります。誤りの応答は実機で校正されておらず、長く続く周波数変化を確率的なパウリ誤りとして扱う近似の妥当性には検証が必要です。また、相関を使う復号は、今回の実装では相関を使わない場合の約7〜8倍の実行時間を要しました。衝撃を推定する別の復号方法では、衝撃のないときの誤警報が増えるため、衝撃時の改善だけでは全体の得を判断できません。

    資料には、少数の固定乱数条件の確認で以前の軌道ヒストグラムを再現できず、原因が未特定である点も記されています。保護数の細かな比較は改めて共通条件で計算されていますが、この制約を含めて、現時点では実機で確立した設計指針より一段手前の研究として読むのが適切です。

    今回の価値は、守る位置を回路の測定内容へ結び付けたことにあります。今後は、実機で衝撃に伴う誤りの強さと長さを測り、使える保護の差と復号方法をそろえた上で、同じ優先順位が有効かを確かめる必要があります。回路、素子、復号器を一緒に比べるための具体的な問いを示した結果です。

    出典