投稿者: SB-admin

  • OCP APAC 2026 | NVIDIA Isingで量子ビットの周波数を探す、中央研究院の校正実験

    OCP APAC 2026 | NVIDIA Isingで量子ビットの周波数を探す、中央研究院の校正実験

    量子コンピューターに計算を任せるには、量子ビットへ適切な信号を送り、その応答を正しく読み取れる状態にしておく必要があります。回路図に同じゲート操作を書いても、実機で使う信号の周波数や振幅まで自動的に決まるわけではありません。

    台湾の中央研究院(Academia Sinica)のChiiDong Chen氏は、OCP APAC 2026の公開資料で、超伝導量子プロセッサーの立ち上げと校正を紹介しています。NVIDIA Isingを使う周波数同定の例では、弱い測定信号を受けて条件を調整し、ピークを見つけてから細かい探索へ進みます。AIの役割が見えてくるのは、この「測る、確かめる、次の測定を変える」という流れです。[1]

    簡単にまとめると?

    • 量子ビットの校正は、測定結果をもとに周波数や駆動・読み出し条件を繰り返し調整する工程です。
    • NVIDIA Isingの例では、測定を検査する役と装置を動かす役を分け、結果を次の探索条件へ戻します。
    • 資料の4試行は周波数同定の一例で、量子プロセッサー全体の校正が4回で完了した結果ではありません。

    ゲート操作を、実機で使えるパルスに合わせる

    超伝導量子ビットの制御では、短い電気信号であるパルスを使います。資料のゲート操作図には、XY駆動の振幅、周波数、位相、波形、継続時間と、Z制御の振幅、波形、継続時間が示されています。校正(キャリブレーション)は、こうした設定を測定結果に合わせて調整する工程です。[1]

    立ち上げでは、まず共振器や量子ビットがどの周波数に応答するかを調べます。続いて駆動条件や、状態を読み分けるための読み出し条件を合わせます。資料には、単一量子ビットの調整だけでなく、量子ビット間の影響や2量子ビットゲートを調べる工程も並びます。

    ここで大切なのは、一度決めた設定を順番に埋めれば終わる、という流れではないことです。資料の単一量子ビット校正例は、共振器の周波数、量子ビットの周波数、Zオフセット、XY駆動、読み出しを調べた後、ZオフセットやXY駆動の再調整へ戻ります。一つの測定結果が、次に使う条件を変えるのです。

    Chen氏は量子ビットが増えた際の課題として、全体の最適化、再校正の増加、見えにくい相関を挙げています。個々の設定を合わせる作業から、互いに影響する設定を繰り返し整える作業へ広がることが、自動化を考える背景にあります。

    計算機の判断を、量子制御装置へ戻す

    資料は、強化学習を使う校正の構成例として、NVIDIA Grace HopperとQuantum Machinesの制御装置OPX1000を示しています。計算側からパラメータを渡し、制御装置がパルスを送って、量子ハードウェアから読み出した情報を戻す構成です。[1]

    接続図にはNVQLink、OP-NICとともに、PCIe経由64Gb/s、往復遅延3.5µsという値が記されています。これは図に示された接続の値です。周波数を探索し、測定を評価して校正を終えるまでの所要時間を示すものではありません。

    この強化学習の構成例に続き、資料はNVIDIA Isingを使った周波数同定を紹介します。二つを同じ実験の結果としてまとめず、後者の判断の流れを見てみます。

    Isingが測定を検査し、次の探索条件につなぐ

    図1は、周波数同定を複数のエージェントで進める構成です。全体の指示を振り分ける役、校正の規則やパラメータ範囲を参照する役、装置を動かしてデータを得る役、測定を検査する役、次の物理パラメータを調整する役を分けています。[1]

    Ising Calibrationは検査側に置かれています。画像と言語を扱うモデルによる分析で、信号を雑音から区別できるか、測定値への曲線の当てはまりがよいか、校正が成功したと判断できるかを調べます。実験結果を受けて条件を変える閉ループの役割と、実際に装置を動かす役割は別です。NVIDIAの公式説明でも、Ising Calibrationは量子ハードウェアの実験データを解釈し、エージェントと組み合わせて調整を支えるモデルと位置づけられています。[2]
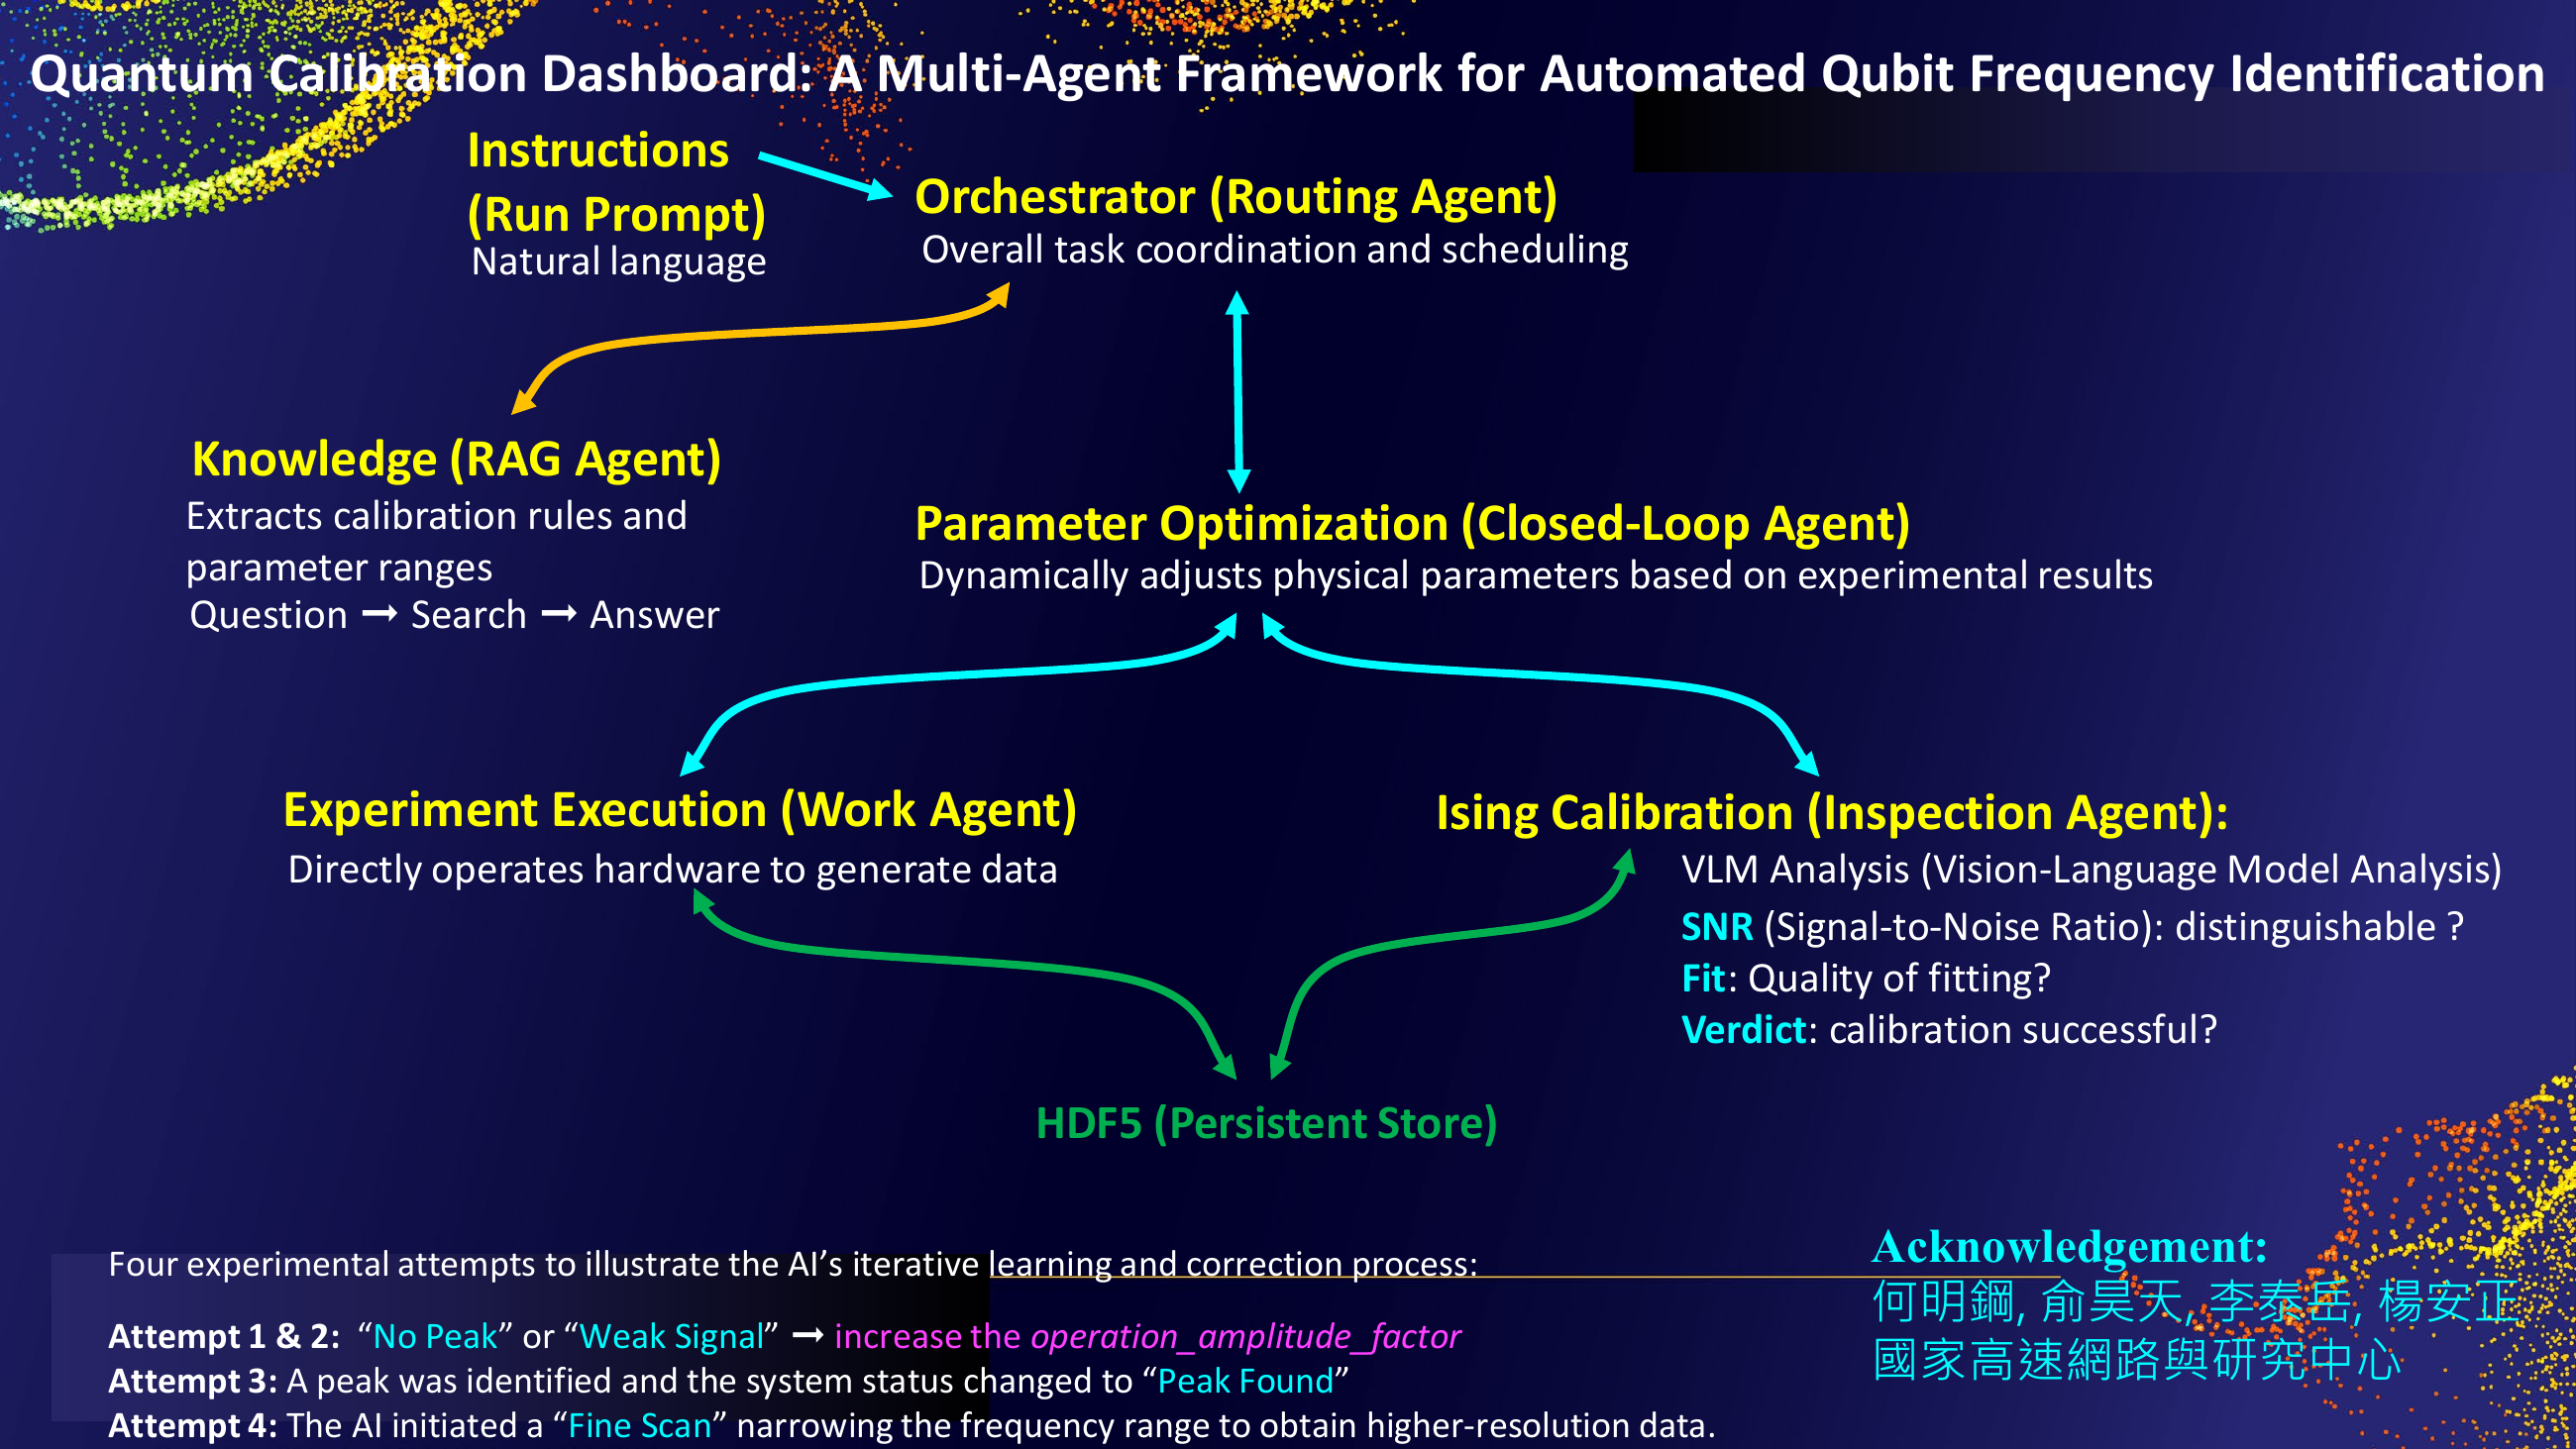
    量子ビットの周波数同定で、指示の振り分け、規則の参照、実験、Isingによる検査、パラメータ調整を結ぶ構成図。下段には弱信号からピーク検出、細かい探索へ進む4試行の説明がある。
    図1 実験と検査を分け、結果を次のパラメータ調整へ戻す周波数同定の構成。狭い画面では図を横にスクロールできます。画像を開くとさらに拡大できます。ChiiDong Chen/Academia Sinica『Operating Superconducting Quantum Processors at Scale: Autonomous Bring-Up and Calibration』p.16。資料内の謝辞:何明鋼、俞昊天、李泰岳、楊安正、國家高速網路與研究中心。出典[1]。

    資料に示された4回の試行は、次のように進みます。

    試行 測定結果と次の動き
    1・2回目 ピークがない、または信号が弱い結果を受け、駆動振幅に関わる係数を増やす
    3回目 ピークを検出し、状態が「Peak Found」へ変わる
    4回目 周波数範囲を狭め、より細かいデータを得る探索へ進む

    資料[1]p.16の試行説明をもとにQuantum Seaが整理。

    周波数の候補がまだ見えない段階と、候補の近くを詳しく調べる段階では、次に必要な測定が変わります。この例の要点は、AIが一度の回答で設定値を決めることではなく、実験の応答を見て探索の進め方を変えることにあります。

    周波数同定の一例を、QPU全体の完成と分ける

    4試行は、この資料が示す周波数同定の例です。すべての量子ビットやゲートの校正が4回で終わるという結果ではありません。また、試行中に物理パラメータを調整したことと、AIモデル自体を追加学習したことも分けて読む必要があります。

    資料が今後の議論として挙げるのは、QPU設計、量子プログラム、誤り訂正へのAI支援です。周波数同定の実験から、そのすべてが自律化できたとは言えません。

    今回の例から見えるのは、判断を実際の測定につなぎ、得られた結果を検査してから次の操作へ戻す設計です。量子ビットを安定して使うための自動化では、AIの回答だけでなく、この往復をどこまで確かめながら進められるかが重要になります。

    関連企業を知る

    NVIDIAとQuantum Machinesの事業全体は、cyclewaveの企業解説で紹介しています。
    参考資料

    1. ChiiDong Chen/Academia Sinica『Operating Superconducting Quantum Processors at Scale: Autonomous Bring-Up and Calibration』、OCP APAC 2026公開スライド、全20頁。本文は主にpp.6、8–9、11、14–16、19を参照。PDF作成日は2026年9月8日で、会場投影版との同一性は未確認。スライドPDF/OCP公式資料一覧
    2. NVIDIA『NVIDIA Ising』。Ising Calibrationの役割を参照(2026年10月5日確認)。公式解説
  • OCP APAC 2026 | Cyntecが示すモールドインダクタ、AI向け電源の小型化と飽和の課題

    OCP APAC 2026 | Cyntecが示すモールドインダクタ、AI向け電源の小型化と飽和の課題

    AI向けの半導体へ電力を届ける回路には、小さなインダクタが並びます。インダクタは磁界にエネルギーを蓄え、スイッチのオン・オフを使って電圧を変換する回路で、電流の変化を支える部品です。半導体が大きな電流を短時間に要求するほど、部品の小ささと電流への対応を両立しにくくなります。

    CyntecのShuenChang Hung氏は、OCP APAC 2026で、金属粉末を使うモールドインダクタの開発を紹介しました。焦点は、AI向けASICの周囲に限られた空間で、必要な電流を扱える電源部品をどう収めるかです。[1]

    簡単にまとめると?

    • AI向け電源の小型化では、部品の寸法だけでなく、大電流で磁性材料が飽和する振る舞いも重要です。
    • Cyntecのモールド型は比較例で小型化されていますが、その差を基板全体やあらゆる回路の性能には広げられません。
    • 巻線を一体化するには、磁気的な結合と電気的な絶縁を、材料・形状・成形工程で両立させる必要があります。

    小さくする前に、飽和の仕方を見る

    インダクタの大きさを考えるときは、外形寸法だけでなく、磁性材料がどのように飽和するかも関わります。電流を増やして磁気飽和に近づくと、電流の変化を抑える性質であるインダクタンスが低下します。

    講演資料では、フェライトを急激に飽和する材料、金属粉末を比較的緩やかに飽和する材料として対比しています。負荷が急に増えたときに、定格の目安を超えて電流が流れると、波形が大きく変わり、過電流保護や電流の検出にも影響します。ここで資料に出てくる「OCP」は過電流保護の略で、イベントを主催するOpen Compute Projectとは別の意味です。

    飽和を考慮せずに部品を縮めると、必要なときに想定どおりの電流波形を保てない可能性があります。小型化は、磁性材料とコイル、回路の動作条件を合わせて検討する課題になります。[1]

    同じ100nHでも、寸法と電流の指標が違う

    資料はTLVR(Trans-Inductor Voltage Regulator)向けの部品を比較しています。TLVRは、一次・二次の巻線を持つ部品を使う電圧調整方式です。ここでは単相の二つの設計例に絞ると、比較の条件が見やすくなります。

    表1 単相TLVR向け部品の公表比較例。資料[1]p.8の数値をもとにQuantum Sea作成。
    項目 フェライト型 モールド型
    寸法 12 × 6 × 12 mm 10 × 5 × 10 mm
    インダクタンス 100 nH 100 nH
    100℃でのIsat 112 A 130 A

    外形寸法の積で比べると、864立方ミリメートルに対して500立方ミリメートルとなり、モールド型は約42%小さくなります。これは寸法から計算した外形体積の比較です。部品の間隔や周辺回路まで含めた基板面積が同じ割合で減る、という意味ではありません。

    表のIsatは飽和電流の指標で、資料では100℃の値として示されています。ただし、この比較表には、Isatを決めるインダクタンスの低下率までは記されていません。値の大小だけから、あらゆる電源回路で使える電流や優劣を決めることはできません。

    損失の比較にも条件があります。同じ資料では入力13.5V、出力1.83Vとし、スイッチング周波数を800kHzと1.2MHzに分けています。小型化と効率を評価するときも、こうした電圧や周波数をそろえて読む必要があります。[1]

    複数の巻線をまとめると、製造精度も効いてくる

    部品を一体化すると、磁性材料の性質だけでなく、巻線をどこに置くかが重要になります。Cyntecは、相と相の結合の強さを安定させるために、区画ごとの成形と、加熱・加圧した後の寸法を見込む設計を挙げています。

    同じ相の一次巻線と二次巻線では、密着の仕方や曲げ半径、組み立て時の位置合わせが課題です。さらに耐電圧を確保するには、端子や巻線の間隔も必要になります。資料では、溝の形状を使って間隔を保つ方法を紹介しています。

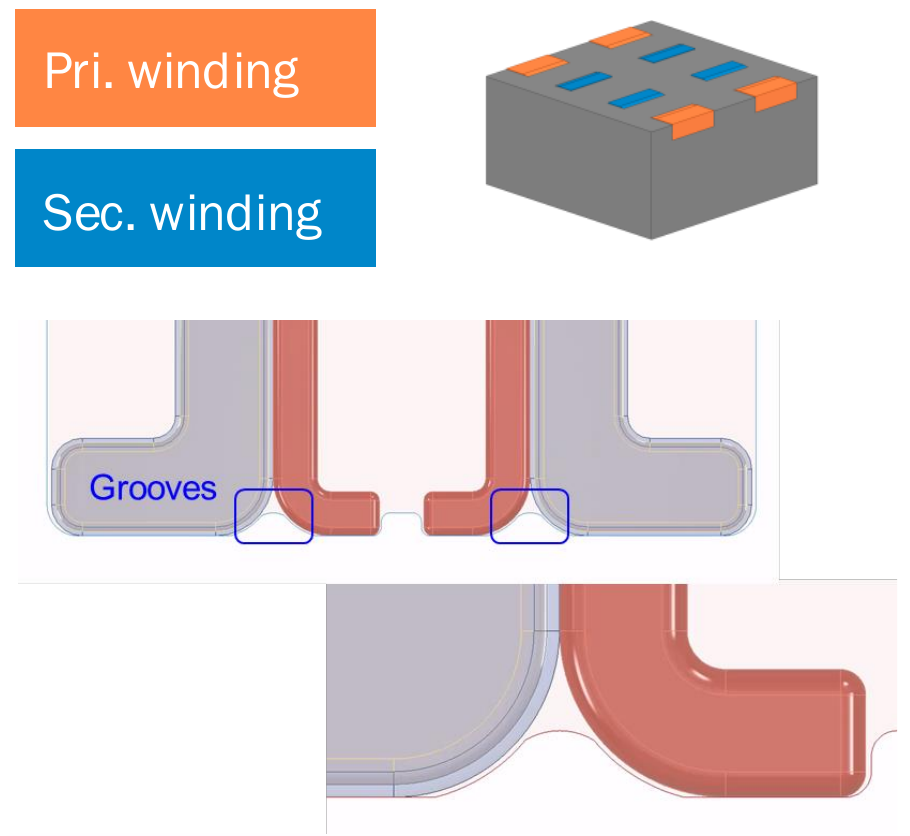
    図1の「Grooves」が示すのは、巻線が曲がる部分の近くに設けた溝です。拡大図は、巻線を密に収めながら互いの間隔を保つための形状を示しています。ただし、必要な間隔や耐電圧の値は図に記されていません。この形状だけで設計条件を決めることはできません。

    Cyntec資料p.10の溝形状。一次・二次巻線の凡例、端子付近にあるGroovesの指示、曲がり部で巻線間の間隔を保つ形状の拡大図。寸法・耐電圧の数値は示されていない。
    図1 一次・二次巻線の間隔を保つ溝形状。ShuenChang Hung(Cyntec)「Empowering AI Ecosystems: The Evolution of Molded Inductors for Next-Generation ASICs」、OCP APAC 2026、p.10左図を引用(図の領域を切り出し、拡縮。色・図中文字は変更なし)。講演資料[1]

    つまり、電流を扱える材料へ置き換えるだけで完成するわけではありません。小さな体積の中で、磁気的な結合と電気的な絶縁を両立するために、材料、巻線、成形工程を合わせて設計しています。[1]

    半導体の近くに収めるための選択肢

    Cyntecは、こうした小型部品をVPD(Vertical Power Delivery、垂直方向からの給電)や、電源のモジュール化に使う候補として示しています。VPDでは部品の高さや置き場所が制約になるため、体積だけでなく、どの方向をどこまで小さくできるかが関わります。

    講演で示されたのは、特定の比較条件における部品設計と、集積化に向けた課題です。モールド型を選べばいつでも効率が上がる、と一般化するのは適切ではありません。必要な電流変化、許される高さ、損失、巻線間の結合や絶縁を一緒に見ていくことが、AI向け電源の小型化につながります。

    CyntecとDeltaの関係

    CyntecはDelta Electronicsの完全子会社です。技術の発表主体はCyntecであり、親会社を含む事業全体についてはcyclewaveのDeltaの解説から読むことができます。[2]

    参考資料

    1. ShuenChang Hung(Cyntec)「Empowering AI Ecosystems: The Evolution of Molded Inductors for Next-Generation ASICs」。OCP APAC 2026、pp.4–11。講演資料
    2. Cyntec「Milestones」。2010年のDelta Electronics完全子会社化を記載。公式沿革
    3. Open Compute Project「2026 OCP APAC Summit」公式資料一覧。公式カタログ
  • OCP APAC 2026 | MetaのBAGがつなぐAI基盤、建物を越える通信の難しさ

    OCP APAC 2026 | MetaのBAGがつなぐAI基盤、建物を越える通信の難しさ

    AIの学習に使うGPUを増やすと、計算機を置く場所だけでなく、GPU同士をどう結ぶかも変わります。一つの建物に収まっていた通信を、別の建物やデータセンターまで広げると、距離による遅延や故障時の経路変更が学習に響いてきます。

    MetaのJalpa Patel氏とAnkur Singh氏は、OCP APAC 2026の講演資料で、AI基盤を広域につなぐBAG(Backend Aggregation)を紹介しました。高速な回線を用意するだけでは足りず、ネットワークの制御と学習処理の両方を合わせる必要があることが見えてきます。[1]

    簡単にまとめると?

    • MetaのBAGは、複数のネットワークをEthernetでつなぐ集約層です。
    • 故障後の通信は、残った経路の帯域に応じて振り分けます。
    • 拠点間の遅延に合わせ、GPUの集団通信や学習側の調整も必要です。

    一つの建物から、複数の拠点へ

    資料では、Prometheusを1ギガワット級のクラスターとして説明し、通常のデータセンター棟に加え、屋外の耐候性テントや隣接するコロケーション施設も使う構成を示しています。この規模の説明はMetaの資料に基づくもので、ここから全設備の稼働状態まで分かるわけではありません。

    資料がNSFと呼ぶネットワーク構成では、一つのIslandに72ラック、5,184基のGPUをまとめます。その内側にあるバックエンドのPodはノンブロッキングとされる一方、Islandをまたぐ部分には3対1のオーバーサブスクリプションがあります。接続された全GPUが、あらゆる相手へ同時に最大速度で通信できる構成ではない点に注意が必要です。

    BAGは、その上位で複数のネットワークをつなぐ、Ethernetベースの集約層です。役割を分けて見ると、どこまでの通信を扱っているか整理しやすくなります。

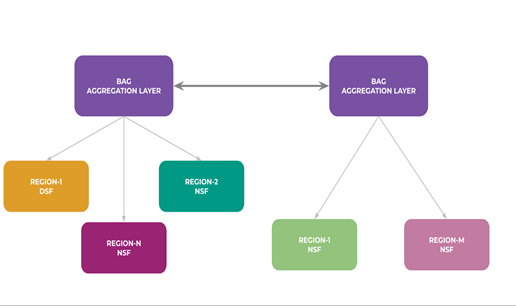
    図1の下段に並ぶ各Regionのネットワークは、上段のBAG集約層に接続されています。BAG同士を結ぶ線まで一緒に見ると、個々のネットワークを集約層を介して結ぶ構成だと分かります。図が表すのは接続関係であり、すべての組み合わせで同じ帯域が得られることを示すものではありません。

    上段の二つのBAG集約層が相互につながり、下段の各RegionのDSFまたはNSFネットワークがそれぞれのBAGへ接続する構成図。
    図1 BAGが複数のネットワークを結ぶ構成(原図引用)
    Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」、OCP APAC 2026、p.5。出典の講演資料。スライド内の図部分を掲載。
    図は横にスクロールできます。図の画像を開く
    表1 講演資料に基づく通信範囲の整理。資料[1]pp.4–5をもとにQuantum Sea作成。
    範囲 資料で示される特徴
    バックエンドのPod内 ノンブロッキングの接続
    Island間 3対1のオーバーサブスクリプション
    BAGによる集約 複数のデータセンターや地域のネットワークを接続

    距離が延びると、止めた後にもデータが届く

    混雑した受信側から送信を一時停止するよう伝えても、その通知が届くまでには時間がかかります。その間に届くデータを受け止める余裕が必要です。優先度ごとに送信を抑えるPFC(Priority Flow Control)を使う場合、ケーブルが長いほど、この余裕として確保するバッファー量も大きくなります。

    Metaは、FBOSSを使って信号の往復時間からケーブル長を推定し、最長距離を一律に仮定する代わりに、実際の長さに沿って余裕を割り当てる方法を示しました。距離の違いを測ることが、限られたメモリーの使い方にも関わります。

    資料はさらに、複数のキューからDRAMへ同時にデータを移すと競合が起き、SRAM側の余裕がなくなり、PFCの影響が全ポートへ広がる危険も挙げています。容量が大きいメモリーを備えるだけで解決する問題ではなく、そこへデータを出し入れする過程も設計の対象です。[1]

    故障後は、残った帯域に合わせて分ける

    通信経路の一部が故障すると、経路ごとに残っている帯域が違ってきます。それでも均等にデータを流すと、細くなった経路に混雑が集まります。

    BAGでは、BGPで経路の帯域情報を伝え、UCMPという、経路の能力に応じて割合を変える分散方法を使います。一方で、小さな帯域変化のたびにネットワーク全体の経路情報が揺れ続けないよう、更新を抑える仕組みも組み合わせています。故障に追従する速さと、制御を安定させることの両立が課題になります。

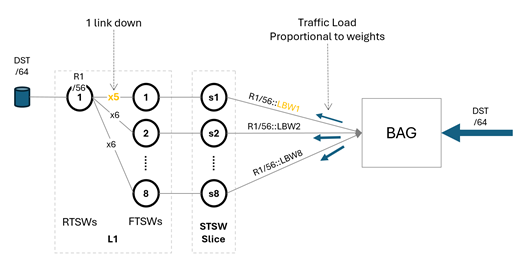
    図2では、左側のリンク束の一つに「1 link down」とあり、経路ごとの帯域情報がLBWとして右側のBAGへ伝わる様子が描かれています。BAGへ入った通信は、青い矢印のように各経路の重みに応じて振り分けられます。故障で減った帯域を分配に反映する点が、この図の要点です。

    左側のリンク束の一つに1 link downと×5の表示があり、経路の帯域情報LBWが右側のBAGへ伝わる。BAGへの入力通信は青い矢印で各経路の重みに応じて振り分けられる。
    図2 リンク故障後の帯域を反映するUCMP(原図引用)
    Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」、OCP APAC 2026、p.7。出典の講演資料。スライド内の図部分を掲載。
    図は横にスクロールできます。図の画像を開く

    回線の先にある学習処理まで合わせる

    通信が届けば学習の効率も保たれる、とは限りません。資料では、一つのBAGを経由するL2ネットワーク間の遅延を、L2内のおよそ3倍としています。これは資料内の構成の比較であり、別の設備にもそのまま当てはまる値ではありません。

    GPU間の集団通信に使うNCCLについても、プロトコルの選択がネットワーク遅延を考慮していないことを課題に挙げています。遠い相手との通信に合わせた調整に加え、BAG層を通る通信のうち、計算で隠せず待ち時間として現れる部分を小さくすることが求められます。

    今後の課題として示されるのは、異なる構成のクラスターへの対応や、数十・数百・数千キロメートル離れた地域間での学習です。これらは講演時点の取り組みの方向で、すべてが実現済みという意味ではありません。Metaの事例が示すのは、AI基盤を広げる際には、回線、バッファー、経路制御、学習ソフトウェアを一続きで考える必要があるということです。

    Metaを企業全体から見る

    Metaのサービス事業やAI基盤への投資を含む企業全体の説明は、cyclewaveの記事にまとめています。

    参考資料

    1. Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」。OCPの掲載題名は「Scaling AI Infrastructure Across DC and Beyond: Meta’s Journey with NSF and BAG」。OCP APAC 2026、pp.3–13。講演資料
    2. Open Compute Project「2026 OCP APAC Summit」公式資料一覧。公式カタログ
  • OCP APAC 2026 | 高電力DCと液冷の安全設計、危険源と保護手段を結ぶHBSE

    OCP APAC 2026 | 高電力DCと液冷の安全設計、危険源と保護手段を結ぶHBSE

    液冷の話では、まず「どれだけ熱を運べるか」に目が向きます。けれども、高い電力を扱うラックでは、冷却液の通り道と電源の近さも設計の一部です。冷却がよく効く配置でも、漏れや故障、保守の場面まで考えなければ、安全な配置とは言えません。

    2026年のOCP APAC Summitで、Googleの安全設計エンジニアは、この組み合わせをHBSE(Hazard-Based Safety Engineering、ハザードベースの安全設計)から考える発表をしました。新しい製品の安全性を実証した報告ではなく、危険源と保護手段をどう結びつけて評価するかという提案です。[1・2]

    簡単にまとめると?

    • HBSEは、危険なエネルギー源と人へ届く経路を捉え、その間の保護手段を評価する考え方です。
    • 液冷と高電力を組み合わせる際は、漏れが起きた後や保守中にも保護が働くかを確認します。
    • 発表は安全評価の提案であり、特定製品の安全性の実証や、必要な絶縁距離を一律に決めるものではありません。

    危険源から、届く経路まで見る

    HBSEでは、電気や熱、動く部品などのエネルギー源を見つけ、そこから人や可燃物へエネルギーがどう届くかを考えます。そして、その間に置く絶縁、覆い、隔離などの保護手段(safeguard)を確かめます。IEC 62368-1:2023も、情報通信機器などについてエネルギー源を分類し、保護手段を定める製品安全規格です。考え方だけで細かな要求事項の代わりになるわけではありません。[2・3]

    たとえば高電力の直流配電では、電圧の数字だけを見ても、触れ得る場所や故障時の電流、アークが起こる条件までは分かりません。アークフラッシュは電気的な放電が熱や光を一気に放つ現象です。発表資料は、作業者が近づく保守の場面も含めて、電気エネルギーがどこへ届き得るかを評価するよう促しています。[2]

    冷却液が加わると、何を見直すのか

    冷却液は、それ自体を電気の危険源と同一視するものではありません。ただ、液体が漏れれば、絶縁物や通電部との関係が変わります。発表資料は、液体が電気的な異常につながる故障の連鎖を想定し、電源部の近くに置くコールドプレートの配置と絶縁の境界を一緒に考えています。漏れれば必ずアークが起きる、という意味ではありません。[2]

    もう一つは、液が触れる部材との相性です。配管やシールなどの接液材(wetted materials)は、冷却液と組み合わせて評価する必要があります。UL SolutionsのCDU(冷却液分配装置)向け資料も、液体を使う部品や絶縁液の適合性を安全評価の項目に挙げています。冷却性能だけよくても、長く使う間に部材が傷み、漏れを招いては設計が成り立ちません。[2・4]

    電気の側では、空間距離(clearance)と沿面距離(creepage distance)も論点になります。前者は導電部の間などの空気中の距離、後者は絶縁物の表面に沿う距離です。Googleの資料は、冷却液が近くにある電源部で、こうした絶縁の条件と機械的な隔壁を併せて考えるよう示しています。ただし、必要な距離をこの記事から一律に決めることはできません。[2・5]

    故障が一つ起きたあとも、守れるか

    安全設計を日常の正常な状態だけで終わらせないことも、発表の要点です。たとえば、液体の漏れが起きたとき、電気的な異常へ進む経路をどこで遮れるか。さらに保守で覆いを開けるとき、作業者とエネルギー源の間に何が残るか。漏れ、電気、作業の三つを別々に確認するだけでは、このつながりが見えにくくなります。[2・3]

    資料は±400V DCや800V DCを例に挙げていますが、その数字だけで装置全体に適用する規格や試験方法は決まりません。IEC 62368-1は製品安全の規格であり、CDUについても冷媒を含むかなどの構成によって評価する規格が変わるとUL Solutionsは説明しています。ラック全体、冷却装置、保守作業を一つの規格名だけで片づけず、対象を分けて確かめる必要があります。[2・3・4]

    液冷と高電力を両立させる鍵は、冷却液と電気を単に遠ざけることではなく、何が危険源になり、どの経路を通り、どの保護手段で止めるかを設備の境界ごとに描くことです。性能を伸ばす設計と、故障後も守る設計を、最初から同じ図面に載せる。今回の発表は、その順序を思い出させてくれます。

    UL Solutionsの事業を知る

    CDUの安全評価資料を公開しているUL Solutionsは、試験・検査・認証と関連ソフトウェアを提供する企業です。事業の構成や、認証後も続くサービスの仕組みは、cyclewaveでまとめています。

    Googleを含むAlphabetの事業を知る

    Googleは、検索やYouTube、企業向けクラウドなどを手がけるAlphabet傘下の企業です。cyclewaveでは、広告が生む収益と、クラウドや計算基盤への投資を、会社全体の数字から整理しています。

    参考資料

    2026年9月26日確認。本文は公開スライドと規格・認証機関の公開説明に基づきます。発表動画の発言・質疑は確認対象に含めていません。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧。イベントと資料の掲載元。

    [2]Yulianti (Dessy) Darmanto「Hazard Based Safety Engineering (HBSE) Concept with Coolant and High Power」公式掲載スライド。全12頁。HBSEはpp.3–5、直流と保守はpp.6–7、冷却液と電源の統合はpp.8–9。

    [3]IEC「IEC 62368-1:2023」公開説明。対象分野、エネルギー源と保護手段の考え方。

    [4]UL Solutions「Certification of Coolant Distribution Units」。CDUの構成、液体・接液材と適用規格の説明。

    [5]UL Solutions「How Insulation Is Coordinated: Clearances, Creepages and Distances Through Insulation」。空間距離・沿面距離の用語定義。

  • OCP APAC 2026 | GoogleのeRoT提案、制御機器の起動を外部の信頼基点で確かめる

    OCP APAC 2026 | GoogleのeRoT提案、制御機器の起動を外部の信頼基点で確かめる

    データセンターの電源や冷却を制御する機器は、表示が正常でも、起動に使ったファームウェアまで正しいとは限りません。長く使われる設備ほど、機器の設計や更新方法もそろっていないことがあります。では、制御機器が信頼できる状態で起動したかを、どこで確かめればよいのでしょう。

    2026年8月のOCP APAC Summitで、GoogleのMiguel Osorio氏は、電源・冷却・建物制御などのOT(Operational Technology)機器に外付けの信頼の起点を加える設計案を示しました。ポイントは、起動する機器自身に確認を任せきりにせず、別の部品が起動コードを測定し、その結果を運用側でも照合できるようにすることです。[1・2]

    簡単にまとめると?

    • GoogleのeRoT案は、CPUとは別の信頼基点で、CPUを動かす前に最初の起動コードを測定します。
    • 起動状態を遠隔で照合できても、その後の設定変更や動作中の侵害まで安全と証明するものではありません。
    • 更新は未使用の記憶領域へ準備して切り替える提案で、無停止や必ず復旧できることを保証していません。

    CPUが動き出す前に、最初のコードを測る

    講演が提案するのは、CPUとは別に置くeRoT(external Root of Trust)です。Root of Trustは、鍵や測定値をより信頼できる場所に置き、ほかの確認を始めるための基点を指します。スライドの構成例では、eRoTが起動用のA/B二つのEEPROM、切り替え回路、CPUのリセット信号につながります。これはすべてのOT機器が同じ配線になるという意味ではなく、外付け部品を使う一つの設計です。[2]

    この構成では、まずeRoTが使うEEPROMを選び、CPUの最初に書き換え可能なコード(First Mutable Code)を測定します。その値をTPMのPCR(Platform Configuration Register)へ取り込んでから、CPUのリセットを解除します。CPU自身が動いたあとで初めて測る方式と比べ、最初の書き換え可能な段階を測定に含めやすいのが狙いです。スライドはこの順序を示していますが、機器に実装した際の測定範囲は構成ごとに確かめる必要があります。[2]

    ここで二つの働きを分けておくと、話が追いやすくなります。検証起動(verified boot)は、署名や許可された鍵・版を調べ、認められないコードを起動させないための仕組み。測定起動(measured boot)は、起動時に使ったコードの測定値を後から照合できるように残す仕組みです。Googleの資料は、鍵や許容するファームウェア版を記したプラットフォーム・マニフェストと、この二つの働きを組み合わせる案を示しています。[2]

    測定値は、離れた運用側でも照合する

    起動時に値を記録するだけでは、その値が期待どおりか分かりません。講演は、OpenConfigのAttestZを遠隔証明の例に挙げます。機器がTPM内の鍵で署名したquoteとPCRの値を送り、運用側のサービスが証明書と署名を検査し、あらかじめ登録した期待値と比べる流れです。OpenConfigの公開文書はネットワークスイッチの管理を対象にしています。講演が示したOT機器への適用案そのものが、すべての設備で実装済みというわけではありません。[2・3]

    証明できる範囲にも線があります。講演スライドには「ランタイムの完全性」を示唆する記述がありますが、AttestZの公開文書が勧める測定範囲は、最初の命令から静的なルートファイルシステムまでの起動状態で、動作中の変化は対象外です。したがって、起動状態の照合に成功しても、その後の設定変更や実行中の侵害まで安全だと証明されたことにはなりません。[2・3]

    更新は、使っていないEEPROMに先に書く

    起動を測れても、ファームウェアの更新で動いている領域を直接書き換えると、途中で失敗したときに戻しにくくなります。発表資料の更新案では、ホスト側から専用のUSB経路でeRoTへ新しいデータを送り、使用中ではないEEPROMに新しい内容を準備します。暗号学的な検証を経て、次の起動でA/Bの選択を切り替え、起動が成功した後に新しい側を確定する手順です。使用中の領域を保ったまま準備する考え方ですが、更新中も停止が一切ないことや、失敗から必ず復旧できることを保証するものではありません。[2]

    共通の接続口は、提案を使いやすくするために

    eRoTをさまざまな制御機器へ広げるには、チップだけでなく接続の仕方も大切です。スライドは、DC-SCM基板とRoT Add-In Moduleをつなぐ公開済み設計に触れ、複数のRoT実装を受け入れられる接続を目指すと説明しています。機器のたびに基板を設計し直す負担を減らす、という方向です。ただし、この講演は個々のOT機器での互換性試験や運用実績を示したものではありません。[2]

    OpenPRoTのコードは公開されていますが、講演が掲げる参照スタックの提供時期は、2026年第4四半期の初期版と2027年第2四半期の広い利用を目指す予定です。すでに完成した製品や、すべてのOT機器で使える確定仕様として読むのは早いでしょう。実際の導入では、どの起動段階を測り、誰が期待値を管理し、更新失敗時にどこへ戻るかを、対象機器ごとに確認することになります。[2・4]

    今回の提案が見せるのは、「安全なチップを追加する」だけではない設計の順序です。起動前に測る。測った結果を離れた場所で確かめる。更新は別の領域に準備してから切り替える。この三つをつなぐことで、長く使う制御機器の信頼を、運用の中で確かめ続ける道が開けます。

    Googleを含むAlphabetの事業を知る

    Googleは、検索やYouTube、企業向けクラウドなどを手がけるAlphabet傘下の企業です。cyclewaveでは、広告が生む収益と、クラウドや計算基盤への投資を、会社全体の数字から整理しています。

    参考資料

    2026年9月26日確認。講演スライド全26ページと公開文書を照合しました。講演動画の音声・質疑は確認対象に含めていません。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧。演題、登壇者、資料掲載。

    [2]Google「Composable Security Architecture: Raising the Security Bar for Datacenter Operational Technology Appliances」公式掲載スライド。OTの対象はpp.3–6、eRoT・起動測定はpp.11–20、更新はpp.21–23、接続案と予定はpp.24–25。

    [3]OpenConfig「AttestZ」公開文書。ネットワーク機器のTPM登録・遠隔証明と、静的な起動状態を中心とする測定範囲。

    [4]CHIPS Alliance OpenPRoT 公開リポジトリ。プロジェクトの公開状況を参照。講演中の将来提供日程とは区別しています。

  • OCP Korea 2026 | OpenStackで資源を用意し、Kubernetesでコンテナを動かす

    OCP Korea 2026 | OpenStackで資源を用意し、Kubernetesでコンテナを動かす

    たとえば、すでにOpenStackでサーバーやストレージを運用しているところへ、AI推論用のコンテナを増やしたいとします。そのとき、基盤を丸ごとKubernetesに置き換える必要はあるのでしょうか。答えを考える鍵は、二つに同じ仕事をさせないことです。

    2026年8月のOCP Korea Tech Dayで、AWS Koreaの講演はOpenStack、Ceph、Kubernetesが共存する三つの接点を示しました。発表の中心は、GPUを載せる計算資源、データを置くストレージ、コンテナの運用をどう組み合わせるか。個々の構成要素は公開されていますが、スライドは三つを組み合わせた特定環境の性能試験ではありません。[1・2]

    簡単にまとめると?

    • OpenStackは計算・通信・保存の資源を用意し、Kubernetesはコンテナの配置や更新を担います。
    • 両方でCephを使っても、同じデータへ自動でアクセスできるわけではありません。
    • EKS Hybrid Nodesは管理プレーンがAWS側にあり、オンプレミスとの安定した接続が必要です。

    OpenStackは資源を用意し、Kubernetesは仕事を配置する

    OpenStackは仮想マシン、ネットワーク、ストレージを払い出す基盤です。必要ならIronicでベアメタルのマシンも扱えます。その上にKubernetesのクラスタを置けば、Kubernetesはコンテナ化したサービスをどのノードで動かし、どう更新するかを管理します。発表は、この上下関係を「OpenStack上のKubernetes」として示しています。[2]

    クラスタを作る接点の一つがCluster API Provider OpenStackです。Cluster APIはKubernetesのクラスタ作成と更新を宣言的に扱う仕組みで、このプロバイダーがOpenStackの資源を使ったクラスタ管理を担います。発表にはMagnumも別の選択肢として並びます。どちらを選ぶかで作成・更新の手順は変わりますが、KubernetesがOpenStackの役割をそのまま引き受けるわけではありません。[2・3]

    保存先はCSI、外への入口は別の接続でつなぐ

    コンテナの中身を作り直しても、学習データや設定を残したい。その保存先をKubernetesから使えるようにするのがCSI(Container Storage Interface)という接続方式です。OpenStackのCinder CSIはブロックストレージを永続ボリュームとして渡し、Manila CSIは共有ファイルシステムを扱います。一方、外部にサービスを公開する負荷分散には、OpenStackのクラウドコントローラーとOctaviaを使う経路があります。保存先と通信の入口は、別々の接続点です。[2・4]

    Cephを保存基盤に選ぶ構成なら、ここにも分かれ道があります。RookはKubernetes上でCephクラスタの配置や運用を助けるオペレーターです。ceph-csiは、CephのRBD(ブロック)やCephFS(共有ファイルシステム)をKubernetesのボリュームとして渡します。CephをOpenStack側でも利用できますが、「両方でCephを使う」だけで同じデータへ自動的にアクセスできるわけではありません。接続先、権限、ネットワーク、データの扱いは構成ごとに決めます。[2・5・6]

    EKS Hybrid Nodesは、管理する場所が異なる

    発表は、既存のオンプレミス資源を使う別の選択肢としてAmazon EKS Hybrid Nodesも挙げています。OpenStack上の仮想マシンやベアメタルをノードに使えますが、Kubernetesの管理プレーンはAWSリージョンにあります。オンプレミスだけで完結するクラスタではなく、AWS側の管理プレーンとノードを結ぶ安定したネットワークが必要です。OpenStack上に自分たちでKubernetesクラスタを管理する構成とは、運用責任と接続の前提が違います。[2・7]

    三つの技術を重ねるとき、まず決めたいのは「何をどこが管理するか」です。サーバーとネットワークを用意する層、コンテナを動かす層、データを残す層。その接点に必要なドライバーと運用主体が見えていれば、既存の基盤を生かしたままAI用の仕事を増やす道筋を描けます。

    AWSを支えるAmazonの事業を知る

    AWSは、Amazon.comの企業向けクラウド事業です。Amazon全体には通販、出店者向けサービス、広告などもあり、それぞれ収益の仕組みが異なります。cyclewaveでは、AWSの位置づけを全社の売上と利益からたどっています。

    参考資料

    2026年9月26日確認。講演スライドと各プロジェクトの公式資料を照合しました。個別構成の性能・費用を測定した記事ではありません。講演動画の質疑は確認対象に含めていません。

    [1]Open Compute Project「2026 OCP Korea Tech Day」発表一覧。演題、登壇者、資料掲載。

    [2]AWS Korea「The New Normal of Infrastructure in the AI Era: Accelerating Innovation with Kubernetes」公式掲載スライド。全31頁。基盤の役割はpp.8–11、EKSの配置はp.22。市場予測や導入率、個別企業の節約率は本文に転用していません。

    [3]Kubernetes Cluster API Provider OpenStack 公式文書。OpenStack上のKubernetesクラスタ作成・管理。

    [4]Kubernetes Cloud Provider OpenStack。Cinder CSI、Manila CSI、OpenStack Cloud Controller Managerなどの役割。

    [5]Rook Ceph 公式文書。RookオペレーターによるCephの配置・運用。

    [6]Ceph「Container Storage Interface」。RBDとCephFSをKubernetesボリュームへ接続するCeph-CSIの役割。

    [7]AWS「Deploy Amazon EKS clusters across cloud and on-premises environments」。EKS Hybrid Nodesの管理プレーン、ノード配置、接続要件。

  • OCP APAC 2026 | PhisonのΔPBAエントロピー提案、SSDの物理配置を測る

    OCP APAC 2026 | PhisonのΔPBAエントロピー提案、SSDの物理配置を測る

    SSDでは、パソコンやサーバーから見えるデータの並びと、実際に記録された場所の並びは同じとは限りません。書き換えを重ねたあと、その違いを一つの数値で見られるでしょうか。

    2026年のOCP APAC Summitに公式掲載された資料で、Phison Electronics(群聯電子)のAndrew Lin氏は、SSD内部の配置を読む「ΔPBAエントロピー」を提案しました。SSDのデータそのものの乱雑さを測る話ではありません。論理アドレスが隣り合うデータについて、物理的な保存先がどのように変わるかを調べる方法です。[1・2・5]

    簡単にまとめると?

    • PhisonのΔPBAエントロピーは、隣り合う論理アドレスの物理的な保存先の差から、配置の特徴を読む提案です。
    • TRIM後に値が下がる例には数え方の変更が含まれ、物理配置が整理された証拠とは限りません。
    • この値だけでSSDの速度や寿命は判断できず、書き込み増幅率への単純な換算にも使えません。

    隣のデータは、SSDの中でも隣にある?

    ホストが指定するLBA(Logical Block Address、論理ブロックアドレス)は、読み書きする場所を表す番号です。一方、発表資料のPBA(Physical Block Address、物理アドレス)は、SSD内の保存先を表します。両者の対応はFTL(Flash Translation Layer)という変換の仕組みが管理します。データを書き直すと、同じLBAでも別の物理位置を指すことがあります。[2・3]

    Lin氏の指標は、隣り合うLBAの物理アドレスの差をΔPBA=PBA(i+1)−PBA(i)として記録します。たとえばLBAを順にたどったとき、PBAも毎回1ずつ増えれば、差はすべて「+1」。保存先の飛び方が不規則になれば、差として現れる値もさまざまになります。[2]

    飛び先の「種類」がどれほど散らばるか

    次に、ΔPBAの各値が何回出たかを数えます。その出現割合にShannonの情報エントロピーを適用したものが、今回のHです。式で書けば H=−Σp(k)log₂p(k)。Hは、差の種類だけでなく、その出現割合の偏りも表します。一種類だけなら0で、同じ種類数なら均等に現れるときに最も大きくなります。単位は情報量のbitで、熱や消費電力の単位ではありません。[2]

    資料にある小さな例では、五つのLBAの間にある四つの差がすべて「+1」ならHは0。四つがそれぞれ異なる値ならHは2bitになります。Boltzmannの式は「配置の候補が増えるほど散らばる」という発想の入口ですが、SSDの評価値として実際に計算しているのは、この差分の頻度分布から求める情報量です。[2]

    ここには大切な限界があります。Hは差の大きさをそのまま足す値ではありません。仮に差がいつも「+100」でも、一種類しか現れなければHは0です。低いHだけで「データが必ず隣接している」とは言えず、高いHだけで読み取りの遅さや製品寿命を決めることもできません。これは発表資料の式から分かる、指標の読み方です。[2]

    TRIMで値が下がるのは、数え方にもよる

    TRIMは、不要になった論理ブロックをSSDに知らせる操作です。NVMeではdeallocate(割り当て解除)として扱われます。通知した瞬間にデータの物理配置がきれいに並び直る、という意味ではありません。[2・3]

    発表資料の例は、TRIMされたLBAをまたぐ二組の差を計算せず、両方を同じ「TRIM」という分類に入れます。先ほどの四組を数える枠はそのままにすると、Hは2bitから1.5bitへ下がります。ここで起きたのは数える対象と分類の変更です。この例だけを、SSDが物理的に整理された証拠として読まないほうが正確です。

    一方、資料の別ページは「隣り合う有効なLBA」を測ると説明しています。TRIMをまたぐ組を飛ばすのか、「TRIM」分類として数えるのか。その方法と分母をそろえなければ、二つのHを比べることはできません。[2]

    書き込みの負担を、この数値だけでは決められない

    SSDは、使わなくなった領域を再利用するためにガベージコレクション(GC)を行います。その過程で、ホストが書いた量よりも多くのデータが記録媒体へ書かれることがあります。WAF(Write Amplification Factor、書き込み増幅率)は、記録媒体への総書き込み量をホストからの書き込み量で割った比です。[3・4]

    Lin氏はHを、先のGC負担を見積もるファームウェア向けの手がかりにしたいと考えています。ただし、資料のシミュレーションでも、SSDの構成や余剰領域を変えるとHがほぼ同じでもWAFは変わります。資料ではGCによる再配置をHに対して中立と扱うモデルも示しますが、実際のPBA対応が変わる装置でどう見えるかは、測定時点や実装をそろえて検証する必要があります。HをWAFの換算表のようには使えません。[2・4]

    ドライブ全体の数値より、乱れが集まる場所を見る

    資料の後半では、ドライブ全体の差分分布から求めたHが小さくても、一部の領域にばらつきが集まる例を示しています。全域の集約値だけでは、GCを先に行いたい場所を見逃すかもしれません。そこで提案されるのが、論理アドレスの範囲を区切って計算する領域別のHです。どの範囲を切り出すか、実際のファームウェアが何を動かしたかも一緒に見ることが大切になります。[2]

    発表は「GetEntropy」という値をコントローラーから取得し、実機トレースで共同検証することも呼びかけています。2026年9月時点で、この発表資料だけからOCPやNVMeが採択した共通の標準指標だとは言えません。もし将来、SSDの状態表示にこうした数値が現れたら、差分の定義、TRIMの数え方、領域の切り方、WAFとの実測関係を一緒に確かめる。その読み方まで含めて、今回の提案は興味深いと思います。[2]

    Phisonの事業を知る

    この発表を行ったPhison Electronics(群聯電子)は、NANDフラッシュを制御するコントローラーを設計し、SSDやモジュールも手がけています。cyclewaveでは、製品構成と在庫、利益と現金の動きから会社全体を見ています。

    参考資料

    2026年9月26日確認。本文は公開スライドを中心に構成しました。講演動画の発言や質疑は確認していません。資料のシミュレーションは、特定条件での発表者の結果として扱っています。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧。演題、登壇者、資料への導線。

    [2]Andrew Lin「Applying Thermodynamics to Storage: Defining Entropy Metrics for Next-Gen SSDs」公式掲載スライド。全18頁。指標の定義はpp.3–7、モデルとシミュレーションはpp.9–15、提案はp.16。

    [3]NVM Express「NVMe Namespaces」。ホストから見えるLBA、deallocateとTRIM、GCの説明。

    [4]NVM Express「Overcoming the Write Amplification Problem with NVM Express Flexible Data Placement」。WAFの定義と物理配置・GCの関係。

    [5]群聯電子「公司概況」。Phison Electronicsの正式名称を確認。

  • OCP APAC 2026 | MicrosoftのPCIeカセット案、アクセラレータ交換とホストの境界

    OCP APAC 2026 | MicrosoftのPCIeカセット案、アクセラレータ交換とホストの境界

    GPUを新しい世代に替えるたび、サーバーの筐体や電源、冷却まで設計し直すのでは、更新の負担が大きくなります。そんな負担を減らすには、交換する部分の形だけでなく、どこまでを交換し、どこからを使い続けるかを決めておく必要があります。

    2026年8月のOCP APAC Summitで、Microsoftはアクセラレータを「PCIeカセット」という交換単位にまとめる設計案を示しました。狙いは、GPUなどの種類が変わっても、ホスト側の再設計をできるだけ抑えること。現時点では、発表資料で示された構想です。[1・2]

    簡単にまとめると?

    • MicrosoftのPCIeカセット案は、アクセラレータ側を交換単位にまとめ、ホストの再設計を抑える構想です。
    • 交換性を成立させるには、形状だけでなく電力・冷却・制御・保守の接点をそろえる必要があります。
    • 発表図だけで仕様の批准や他社製品との互換性が確認されたとは言えません。

    カセットとホストの間に、境界を引く

    この案では、アクセラレータごとに変わりやすい形状、固定方法、熱の逃がし方、制御信号をカセット側の設計範囲に置きます。一方のホスト側には、筐体、ホストプロセッサーモジュール(HPM)、管理・制御を担うDC-SCM、電力供給や保守の仕組みを残し、可能な範囲で使い続けます。DC-SCMは、OCPが仕様を定めるサーバーの管理・セキュリティ・制御用モジュールです。[2・3]

    カセットは、単なる「GPUを入れる箱」ではありません。発表資料は、現場交換可能ユニット(Field Replaceable Unit、FRU)として捉え、差し込む経路、重さ、固定具まで検討対象に挙げています。PCIeの接続に加えて、電源コネクターの電流容量、冷却、サイドバンドの制御信号、状態を伝えるテレメトリーも境界をまたぎます。ホットプラグや出力制御を扱うなら、その対応範囲も合わせて決めなければなりません。[2]

    冷却と電力は、境界をまたいで決まる

    液冷なら、カセット内のコールドプレートだけを決めても足りません。接続先のCDU(冷却液分配装置)と合わせて、流量、圧力、冷却液の種類、漏れの検知を考える必要があります。空冷なら、ヒートシンクやファンだけでなく、筐体内で使える風量や音響条件が関わります。電力も同様です。新しいアクセラレータが要求する電流や瞬間的な電力変動を、ホストの配線と電源が受け止められるかを確認します。[2]

    つまり、カセットを交換できる形にしても、ホストの冷却能力や給電の余裕を超えれば、ホスト側の変更は避けられません。資料も、インターフェースの選び方がホストへ複雑さを持ち込み、電力と冷却の境界調整を後回しにすると再利用が難しくなると振り返っています。[2]

    「差し替え可能」を実現するために残る仕事

    資料の次の課題は、カセットの寸法や重量だけではありません。熱・電力の許容範囲、制御インターフェース、侵入検知、ホットプラグ、保守の手順まで含めた共通の接点を、早い段階で定義することです。新しいカセットを差し込むたびに何を再評価するかも、そこで明らかになります。[2]

    発表の図には「OCP Cassette Specificationに準拠」と書かれていますが、末尾はカセットの形状や電力範囲をこれから検討する呼びかけです。この一枚の図だけで、批准済みの仕様や、異なるメーカーの製品をそのまま挿し替えられる互換性があるとは言えません。市場投入までの時間を短くするという狙いも、発表内で削減率が実測されたわけではありません。[2]

    この提案が教えてくれるのは、交換性を部品の形だけで判断しないことです。機械、電力、冷却、制御、保守の接点を一緒に決め、ホストが使い続けられる条件を明確にする。その境界が見えて初めて、新しいアクセラレータを迎える準備ができます。

    Microsoftの事業や収益の仕組みは、cyclewaveの企業解説にまとめています。

    参考資料

    2026年9月26日確認。本文は公開スライドを中心に構成しています。発表動画の発言・質疑は確認対象に含めていません。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧。演題、登壇者、資料と動画の掲載。

    [2]George Asirvatharaj、Hardik Shah、Niharica Sohal「Modular PCIe Cassette Architecture for Scalable AI Systems」公式掲載スライド。全13頁。課題と構成はpp.5–6、カセットとホストの条件はpp.7–9、残る課題と提案はpp.10–11。

    [3]Open Compute Project「DC-SCM 2.2 Specification」。DC-SCMとHPMの用語と役割の確認。

  • OCP APAC 2026 | Vertivが示す800V DC、AIサーバーへの給電はどう変わる?

    OCP APAC 2026 | Vertivが示す800V DC、AIサーバーへの給電はどう変わる?

    AIサーバーを増やすとき、必要になるのは計算用のチップや冷却装置だけではありません。電気を届ける配線と電源装置にも、もう少し余裕がほしくなります。

    そこで進んでいるのが、ラックへ電気を送る直流の電圧を高める設計です。2026年8月、台北で開かれたOCP APAC Summitで、VertivのHenrik Nilén氏は800V DCへの移行を、電源の置き場所や変換の仕方まで含めて紹介しました。[1・2]

    この発表を読むと、電圧だけでなく、どこで変換し、どの区間を高い電圧のまま運ぶかが大切だと分かります。

    簡単にまとめると?

    • 同じ電力なら電圧を上げるほど電流を減らせますが、配線の太さを同じ比率で減らせるわけではありません。
    • 800Vをチップへ直接加えず、ラックやサーバー側のDC/DC変換で必要な低電圧へ下げます。
    • 全体の効率は電圧だけでは決まらず、変換段と、どこからどこまでを測るかが重要です。

    電圧を上げると、配線にはどんな余裕が生まれる?

    直流の電力は、電圧と電流を掛けた値です。同じ電力を届けるなら、電圧を上げるほど必要な電流を減らせます。

    たとえば300kWを送る場合、変換損失をいったん除いて計算すると、50Vでは6,000A、800Vでは375Aになります。電圧が16倍になるので、電流は16分の1です。

    300kWを送るときの電圧単純計算した合計電流
    50V DC6,000A
    800V DC375A

    これは電圧と電流の関係をつかむための計算です。実機では複数の経路に分けて配電するため、この値がそのままケーブル1本を流れるわけではありません。

    配線の抵抗が同じなら、そこで熱になる電力は電流の2乗に比例します。電流を減らせると、発熱や電圧降下を抑えやすくなり、太い銅の導体をどれだけ使うかにも選択の余地が生まれます。高電圧の直流配電が、ラック内のスペースや銅の使用量と一緒に議論される理由です。[3]

    もちろん、ケーブルの太さを16分の1にできる、という意味ではありません。温度、接続部、保護装置、絶縁などの条件も満たす必要があります。

    電源をラックの外へ移す、その先に800Vがある

    もう一つ変わるのが、電源装置の置き場所です。

    発表では、サーバーと同じラックに置いていた電源や蓄電装置を、隣の専用ラックへ移す構成が示されています。この隣接する電源ラックが「サイドカー」です。まず50Vのまま電源を外へ出し、その後、ラック間の配電を800Vへ変える流れとして描かれています。[2]

    ラックの中を計算用の機器に使いやすくすることと、ラックへ電気を運びやすくすること。二つの課題を、配置と電圧の両方から解いていくわけです。

    ただし、800Vをそのままチップへ加えるわけではありません。ラックやサーバー側で、直流の電圧を変えるDC/DC変換を行い、チップが使う低い電圧へ段階的に下げます。800V対応サーバーになっても、この役割は残ります。[3]

    同じ「800V」でも、接地の仕方が違う

    資料では、0〜800V DCと±400V DCが分けて扱われています。±400Vは、接地した中点に対して片側がプラス400V、もう片側がマイナス400Vとなる構成です。両端の差は800Vでも、負極を接地する0〜800Vの構成とは、接地に対する電圧が異なります。[2]

    受け取る機器から見れば、端子間の電圧だけが合っていればよい、とは限りません。どこを接地の基準にするのかによって、絶縁や保護の設計も変わります。「800V対応」という表示を読むときは、その電源方式までそろえて見る必要があります。

    効率は「800Vだから高い」とは決められない

    発表の比較例には、少し立ち止まって見たい数字があります。

    交流の配電幹線から受電する構成で、ラック内に50V電源と蓄電装置を置く例の電力供給経路の効率は約96.5%。一方、800Vのサイドカーから送り、ITラック側にDC/DC変換器を置く例は約96%です。800Vを受け取るサーバーまで含めた構成では、96.5%超が示されています。[2]

    いずれも発表中の構成例の値で、負荷率や細かな測定条件はスライドに示されていません。それでも、電圧を上げるだけで全体の効率が決まらないことは読み取れます。

    配線で減らせる損失があっても、途中で電圧を変える装置にも損失はあります。電源単体の効率、ラックへ届くまでの効率、チップが使える電圧まで含めた効率は、同じ指標ではありません。

    新しい構成を比べるときには、「何Vか」に続けて、どこからどこまでを測り、間にどんな変換を挟んでいるかを見る。そうすると、数字の意味がずっとつかみやすくなります。

    電気の通り道を、ラック全体から見直す

    800V化で得たいのは、大きな電力を無理なく届けるための余裕です。電流を減らし、電源の置き場所を変え、必要な変換を整理する。その組み合わせで、サーバーを収める場所と電気の通り道を整えていきます。

    今回の発表から見えてくるのは、電源装置だけを高性能にする発想から、ラックへ届くまでの仕組みをまとめて考える設計への広がりです。配線、接地、変換段、効率の測定範囲を一緒に眺めると、800Vという数字の先にある工夫が見えてきます。

    発表したVertivの事業全体は、cyclewaveの企業記事にまとめています。

    参考資料

    2026年9月22日確認。発表の解説は公開スライドをもとにしています。動画内の発言や質疑応答は、本記事の根拠には含めていません。

    1. Open Compute Project「2026 OCP APAC Summit」発表一覧 — 「800V DC Power Trends」、Henrik Nilén(Vertiv)。
    2. Henrik Nilén「800V DC Power Trends」公式掲載スライド — pp.7–9。接地方式、配置の変化、電力供給経路の効率。
    3. NVIDIA Technical Blog「NVIDIA 800 VDC Architecture Will Power the Next Generation of AI Factories」 — 2025年5月20日。高電圧配電とラック内DC/DC変換の背景説明に使用。
  • OCP APAC 2026 | ラックから建物へ、液冷を広げるCDUと配管の設計

    OCP APAC 2026 | ラックから建物へ、液冷を広げるCDUと配管の設計

    サーバーラックをもう一列増やしたい。置く場所と電源には余裕があっても、冷却液を届ける配管まで、そのまま使えるとは限りません。

    一つのラックを冷やす設計と、何列ものラックを動かし続ける設計。その間には、冷却装置の台数だけでは埋まらない違いがあります。

    2026年8月のOCP APAC Summitで、nVentのMing Tien氏が取り上げたのは、この規模の広がりです。公開スライドをもとに、冷却液を循環・調整する装置「CDU」と配管を、建物側の設備までつなげて見ていきます。[1・2]

    簡単にまとめると?

    • CDUは施設側とサーバー側の回路を分け、液体を混ぜずに熱を受け渡します。
    • 液冷の増設は冷却能力の合計だけでなく、各ラックへ必要な圧力と流量を届けられるかで考えます。
    • 予備の装置を持つことと、故障した配管を切り離して運転を続けられることは別です。

    ラックごとに置くか、何台かで共有するか

    CDUの置き方には、ラックの中へ組み込む「インラック」と、ラック列のそばに置いて複数ラックを受け持つ「インロー」があります。発表では、複数ラックをひとまとまりにしたPODへ液冷を広げるとき、後者の集約しやすさに注目しています。[2]

    ラックごとにCDUを置けば、IT機器側の冷却回路をラック単位で分けられます。一方、ラックを増やすたびに、装置の設置や建物側の配管接続、監視・保守の対象も増えていきます。複数ラックでCDUを共有する構成なら、こうした運用をまとめやすくなります。[2]

    ただ、共有するほど、どこまでが一つの冷却系統なのかをはっきりさせる必要があります。まとめると運用しやすい部分と、分けておくと不具合を閉じ込めやすい部分。その両方から配置を考えると、装置の大きさだけでは見えなかった違いが分かります。

    発表の比較は、大きなAIクラスタを念頭に置いたものです。インローならいつでも安く、信頼性も高いと決まるわけではなく、既存設備や増設の単位に合わせて選ぶ必要があります。

    二つの回路を分けて、熱を渡す

    ここで、液体の通り道を整理しておきます。今回扱う液体同士で熱を交換するCDUでは、建物側を流れる一次回路と、サーバー側を巡る二次回路が分かれています。資料にあるFWSは建物側の水系統、TCSはIT機器側の冷却系統を指します。[2・3]

    サーバーで温まった二次側の冷却液は、CDUへ戻り、熱交換器を通じて一次側へ熱を渡します。二つの液体を混ぜずに熱を受け渡すことで、サーバーへ送る液体の品質や圧力を、建物側と分けて管理できます。[2・3]

    回路を分けても、建物側に頼らず冷やせるわけではありません。一次側がどの温度で、どれだけの流量を供給できるかは、CDUの働きに関わります。発表では、建物側からCDUへ供給温度・流量・差圧などを伝え、CDUからは戻り温度や受け渡す熱量、異常の状態を返す関係が示されています。[2]

    配管の接続位置だけでなく、互いに何を伝え、どちらが調整するかまで決める。設備担当とIT担当の境目に、CDUが置かれる意味はここにもあります。

    冷却能力の合計より、必要な場所へ流れるか

    ラックの数が増えると、冷却液の行き先も増えます。CDUの冷却能力を足し合わせて十分な値になっていても、それぞれのラックへ必要な流量を届けられるかは、もう一つの問題です。

    資料では、必要な冷却能力と流量から台数を考えたうえで、系統に必要な圧力と流量の組み合わせ、つまり「P-Qの運転点」でCDUを選ぶと説明しています。Pは圧力、Qは流量です。配管やサーバーを通る際の圧力損失を補いながら、必要な量を流せるかを確かめます。[2]

    nVentが示した構成例では、配管を環状につなぎ、CDUを分散して配置しています。狙いは流量と圧力の偏りを抑えることです。ただし、輪にしただけで均等になるわけではありません。実際の配管寸法、接続するラック、装置の運転条件を合わせて検討する必要があります。[2]

    増設の相談で大切なのは、「あと何kW冷やせるか」に加えて、「追加したラックまで、どの経路で必要な流量を届けるか」です。冷却能力と液体の通り道を別々に見ないことが、拡張の出発点になります。

    予備を持つことと、切り離せることは別

    故障に備えて、必要な能力を担うN台に予備の1台を加える。これがN+1という冗長化の考え方です。発表でも、CDUの配置と一緒に冗長性が取り上げられています。[2]

    ここで確かめたいのは、何を予備にしているかです。たとえばポンプに予備があっても、共有配管を修理する間の別経路まで自動で用意されるわけではありません。装置の台数に続けて、故障した部分をどこで切り離せるかを見ていきます。

    資料が重視するのも、一次・二次回路の分離、弁の位置、保守する範囲の決め方です。正常に流れている状態だけでなく、漏れや停止が起きたときに影響がどこまで及ぶかを、配管の構成として考えます。[2]

    監視にも同じ視点が必要です。発表では、ネットワークが途切れた場合にも機器側の制御でIT機器を守れること、センサー故障やポンプ停止時の動作をあらかじめ決めることが挙げられています。画面で状態が見えることと、通信がなくても安全に対処できることは、分けて設計したい部分です。[2]

    増設しやすさは、配管を作る前に決まる

    将来のラック追加に備えるなら、空きスペースを残すだけでは足りません。配管の取り出し位置やCDUを運び込む通路、床が支えられる重さも、後の工事に関わります。

    発表では、ラック配置と接続寸法を先に固め、配管を工場で組み立ててから搬入する方法が紹介されています。現場での切断や溶接を減らし、出荷前には耐圧・清浄度・溶接の検査を行う。設置後には、現地で改めて確認する流れです。[2]

    事前に作る範囲が広がるほど、最初に決める寸法や接続位置の確かさが大切になります。後からラックの並びを変えると、あらかじめ用意した配管が合わなくなるかもしれません。増設の単位を決めることは、建物とIT機器の計画を早い段階で合わせることでもあります。

    また、将来の余裕は熱を受け取る能力だけでなく、流量や圧力にも必要です。主配管の大きさや系統の分け方を先に考えておけば、増設のたびに大きな配管工事や床の改修へ戻る事態を避けやすくなります。[2]

    冷却を広げるなら、止まったときから考えてみる

    新しいラックを加えたとき。CDUを一台点検するとき。配管の一部で不具合が起きたとき。それぞれの場面で、どこから液体を送り、どこを切り離し、誰が調整するのかをたどると、設備のつながりが具体的になります。

    液冷を大きくする設計は、高性能な装置を並べるだけでは完結しません。必要な流れを届け、影響を小さく区切り、次の増設を受け止められること。ラックから建物へ視野を広げると、この三つを一緒に整える大切さが見えてきます。

    nVentの事業について

    nVentは冷却だけでなく、電気をつなぐ部品や、機器を保護する筐体なども手がけています。会社全体の事業と収益のしくみは、cyclewaveにまとめています。[4]

    参考資料

    2026年9月23日確認。講演の公開スライドをもとに、設備を広げる際の考え方を整理しました。配置の比較や構成例はnVentの発表によるもので、設備ごとの条件に合わせた検討が必要です。

    [1]Open Compute Project:2026 OCP APAC Summit 発表・資料一覧。台北、2026年8月11〜12日開催。Ming Tien(nVent)の講演を収録。

    [2]nVent「From Rack to Facility: Designing Scalable CDU-Based Liquid Cooling System」公開スライド。4〜7ページ:拡張と配置、9ページ:配管と運転点、10〜13ページ:施工・保守・制御、15ページ:将来の余裕。

    [3]nVent「Rack Level High Density Liquid Cooling」。6ページ:一次・二次回路と、液体を混ぜずに行う熱交換の説明。

    [4]cyclewave:nVentはどんな会社? 電気設備を支える事業と収益のしくみ。公開本文を確認して参照。