投稿者: SB-admin

  • 忠実度とトレース距離、量子状態の違いを二つの指標で読む

    忠実度とトレース距離、量子状態の違いを二つの指標で読む

    量子状態が目標にどれほど近いかを表すとき、「忠実度」という数値がよく使われます。しかし、同じ目標への忠実度が等しくても、状態が同じとは限りません。測り方を変えると、一方では出やすく、もう一方では出にくい結果が見つかることもあります。

    この違いを、忠実度とトレース距離という二つの指標で見てみます。量子計算用ソフトウェアQuTiPの定義を手がかりに、1量子ビットの小さな行列だけで計算できる例を使います。

    簡単にまとめると?

    • 忠実度は、平方根を取る定義と、その二乗を使う定義を区別します。同じ名前でも数値をそのまま比較できるとは限りません。
    • 目標への忠実度が同じ二つの状態でも、別の測定で得られる確率や、目標までのトレース距離は変わります。
    • 純粋状態同士で使える関係式を、混合状態を含む比較へ広げないことが大切です。

    最初に「何を忠実度と呼ぶか」をそろえる

    量子状態をまとめて表す道具が、密度行列です。1量子ビットなら2×2の行列で、どの測定からどの結果が得られるかという確率を計算できます。特定の状態ベクトルで表せる純粋状態も、複数の状態を確率的に混ぜた混合状態も扱えます。

    二つの密度行列をρとσと書くと、この記事では忠実度を次のFで表します。

    F(ρ, σ) = Tr √(√ρ σ √ρ)

    Trは行列の対角成分を足す操作です。√ρは、各成分を別々に平方根にするのではなく、行列としての平方根を意味します。ここで使うのは、正しく正規化された、同じ次元・同じ基底で表された密度行列です。

    QuTiP 5.1.1の固定版で確認したfidelityは、この平方根を取る側の定義です。一方、F²を忠実度と呼ぶ文献もあります。例えばFが約0.9487ならF²は0.9です。定義が違うだけの二つの数値を見て、「0.9の方が品質が低い」とは判断できません。[1][2]

    また、ここで比較するのは量子状態です。量子操作を比べるプロセス忠実度や平均ゲート忠実度とは対象が異なるため、それらの数値との換算には踏み込みません。

    目標への重なりが同じ二つの状態

    目標を|0〉とし、基底の順序を|0〉、|1〉に固定します。目標の密度行列はσ=[[1, 0], [0, 0]]です。これと比較する二つの状態を用意します。

    Aは、|0〉を90%、|1〉を10%の確率で混ぜた状態です。その密度行列は次のようになります。

    ρA = [ 0.9   0   ]
         [ 0     0.1 ]

    Bは、√0.9|0〉+√0.1|1〉という一つの純粋状態です。行列にすると、対角以外にも0.3が現れます。

    ρB = [ 0.9   0.3 ]
         [ 0.3   0.1 ]

    AとBの対角成分は同じです。|0〉か|1〉かを区別する測定、いわゆるZ基底での測定なら、どちらも|0〉が出る確率は0.9になります。

    今回のように目標が純粋状態|0〉であるとき、忠実度の二乗はF² = 〈0|ρ|0〉です。この例では行列の左上を読めばよく、AもBもF²=0.9、F=√0.9≒0.9487です。ただし、F²をこの測定確率として読めるのは、指定した純粋な目標への射影という条件があるからです。一般の忠実度を、そのまま装置の成功率と呼ぶことはできません。

    二つの行列の違いは、対角以外の成分にあります。Bの0.3は、この基底での重ね合わせに関わるコヒーレンスを表します。Aではその成分が0です。対角の確率だけをそろえても、行列全体まではそろいません。
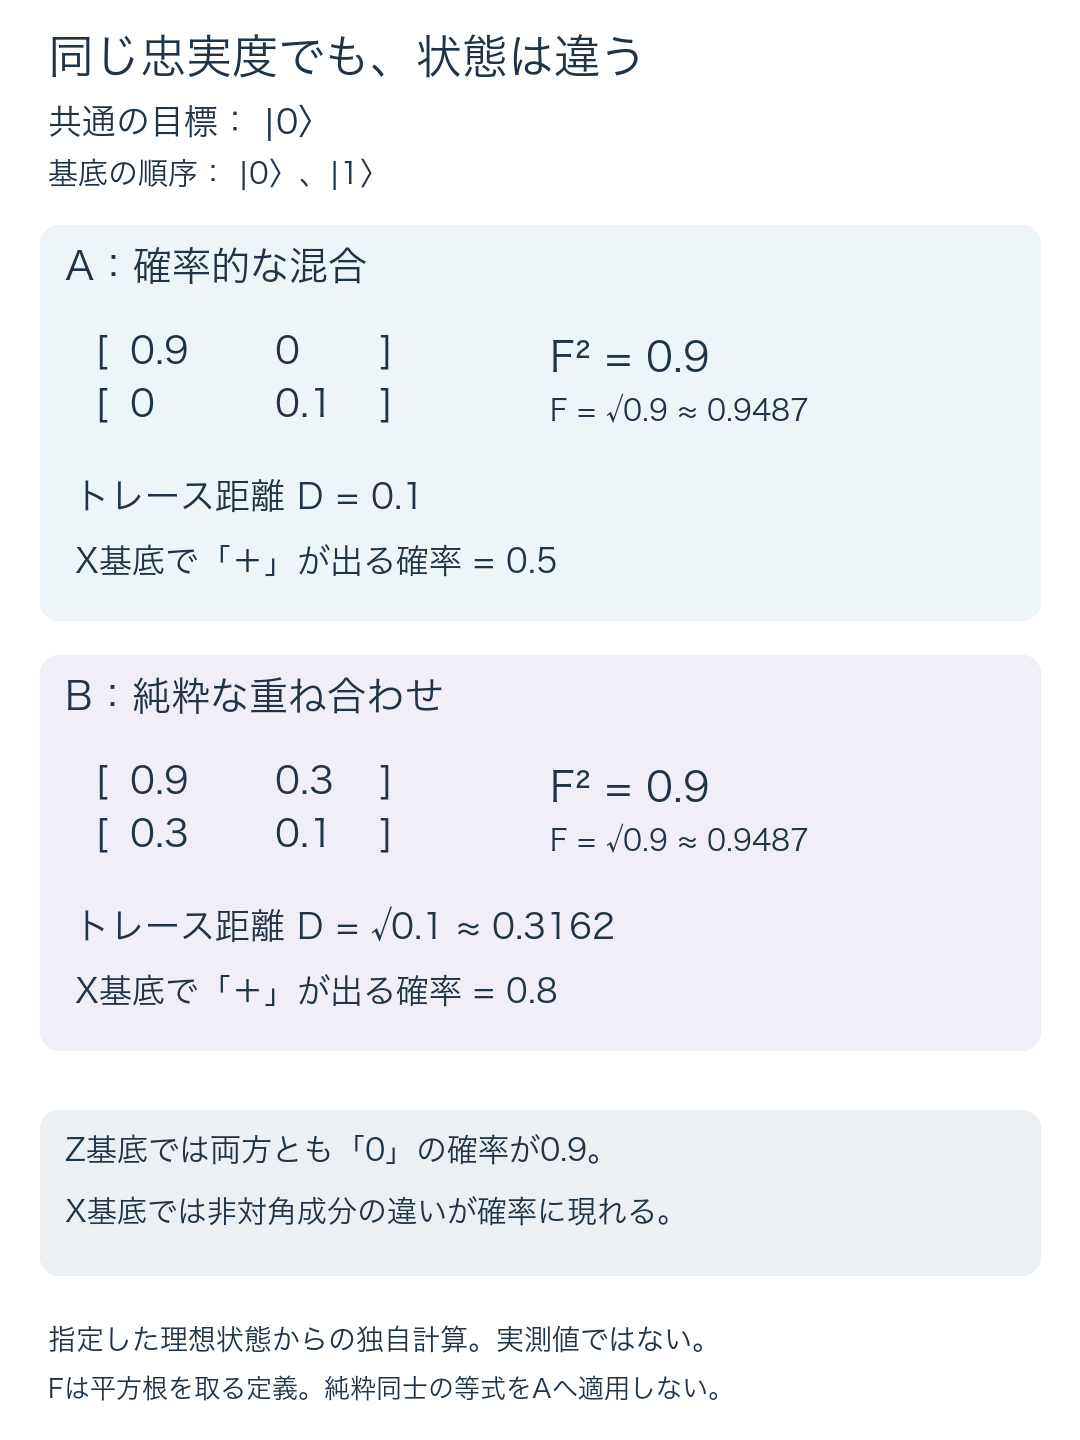
    目標は|0〉。Aは対角0.9、0.1の混合状態、Bは同じ対角と非対角0.3の純粋状態。どちらもFの二乗は0.9だが、トレース距離はAが0.1、Bが約0.3162。X基底でプラスが出る確率はAが0.5、Bが0.8。
    図1 目標への忠実度が同じでも、状態全体は同じにならない例。指定した理想的な密度行列からの独自計算で、実機の測定値ではありません。原寸画像を開けます。

    測り方を変えると、違いが確率に現れる

    次は、|+〉=(|0〉+|1〉)/√2と、その直交する|−〉を区別するX基底で測ります。|+〉が出る確率は〈+|ρ|+〉です。今回の実数の行列では、四つの成分を足して2で割る計算になります。

    Aでは(0.9+0+0+0.1)/2=0.5です。Bでは非対角成分も寄与して、(0.9+0.3+0.3+0.1)/2=0.8になります。Z基底では見分けられなかった違いが、X基底の予測には現れました。

    これは、実際に何回測っても必ず50%や80%になるという意味ではありません。指定した状態から計算した理想的な確率です。有限回の測定結果にはばらつきがあり、状態を実験データから推定するには、その不確かさを別に扱う必要があります。

    トレース距離は、目標との差を行列全体で計算する

    トレース距離Dは、二つの行列の差Δ=ρ−σから計算します。QuTiPのtracedistに対応する定義は次のとおりです。[2]

    D(ρ, σ) = ½ Tr √(Δ†Δ)

    †は複素共役を取って転置する操作です。密度行列の差Δはエルミート行列なので、この式はΔの固有値の絶対値を足し、2で割る計算にもなります。各成分の差をただ足す方法とは異なります。

    Aと目標の差は対角成分が−0.1と0.1で、固有値もこの二つです。その絶対値を足して2で割ると、D=0.1になります。

    Bと目標の差は[[−0.1, 0.3], [0.3, 0.1]]です。この行列を二乗すると、対角成分が0.1、非対角成分が0になります。固有値は−√0.1と√0.1なので、D=√0.1≒0.3162です。同じ忠実度だった二つの状態に、異なる距離が得られました。

    目標|0〉との比較 A:確率的な混合 B:純粋な重ね合わせ
    F² 0.9 0.9
    F √0.9 ≒ 0.9487 √0.9 ≒ 0.9487
    トレース距離D 0.1 √0.1 ≒ 0.3162
    Z基底で|0〉が出る確率 0.9 0.9
    X基底で|+〉が出る確率 0.5 0.8

    この表から「混合状態の方が常によい」とは言えません。Aは、この目標に対するトレース距離ではBより近い状態です。一方、Bの重ね合わせを利用したい用途で、非対角成分を失ったAをそのまま代わりにできるとは限りません。比較する目標と、必要な性質を決めてから指標を読みます。

    純粋状態同士の関係式には、使える範囲がある

    二つとも純粋状態なら、この記事のFの定義でD=√(1−F²)が成り立ちます。QuTiPのガイドも、純粋状態同士の条件を付けてこの関係を示しています。[1]

    Bと目標はどちらも純粋状態なので、F²=0.9からD=√0.1を得られます。しかし、Aは混合状態です。同じ式を当てはめると約0.3162となり、直接計算した0.1と一致しません。忠実度だけからこの等式で距離を求める前に、両方の状態が純粋かを確かめる必要があります。

    数値の横に、比較条件を残す

    量子状態を比較する報告や計算では、まず忠実度がFとF²のどちらかを確認します。次に、比較対象の状態、基底と次元、純粋状態か混合状態かをそろえます。そのうえで、目的に関係する測定の予測や別の指標を併記すれば、同じ数字の裏にある違いを読み取りやすくなります。

    今回の例は、正規化された理想的な1量子ビット状態の代数計算です。QuTiPの実行速度や量子装置の性能を試験したものではなく、測定誤差を含む密度行列の推定・修復も扱っていません。忠実度という一つの値から、状態の全情報や実用上の優劣を決めないことが、比較の出発点になります。

    図表・数値例は、上記の定義に従って作成した独自の説明です。

    出典

    1. QuTiP 5.1 User Guide — States and operators / Density matrices。密度行列と距離指標、純粋状態同士の関係式を参照。2026年10月16日UTC取得の保存版を使用。
    2. QuTiP 5.1.1 — qutip/core/metrics.py。固定コミット7accc77a70a08f965a29fdd13515f79cdcab9703のfidelityとtracedistの定義・実装を確認。ガイドの5.1系スナップショットと固定実装を区別し、最新版であるとは主張していません。
  • 量子リピーター、もつれ交換で離れた量子ビットをつなぐ

    量子リピーター、もつれ交換で離れた量子ビットをつなぐ

    遠くまで通信するとき、途中で弱くなった信号を整えて送り直せれば便利です。しかし、量子ビットが持つ未知の状態は、そのままコピーして予備を作ることができません。量子リピーターはこの制約の中で、離れた場所に「もつれ」という通信資源を用意するための中継点です。

    鍵になるのは、中継点で量子状態を増幅することではなく、短い区間で作ったもつれを、測定によって長い区間へつなぐ操作です。もつれ交換(エンタングルメント・スワッピング)で何が残り、何が消費されるのかを、二つの端点と一つの中継点で見ていきます。

    簡単にまとめると?

    • もつれ交換は、中継点の二つの量子ビットを共同で測定し、離れた二つの端点にもつれを作る操作です。元の二組は消費されます。
    • 測定結果を知らせる古典通信が必要です。遠くの状態が関係づけられても、光より速く情報を送れるわけではありません。
    • 理想的な計算で交換できることと、実際に十分な品質のもつれを速く届けられることは別です。生成、測定、待ち時間、量子メモリを組み合わせて考えます。

    未知の状態をコピーせず、もつれを準備する

    量子通信で問題になる「複製できない」は、何も複製できないという意味ではありません。任意の未知の量子状態を、元の状態を保ったまま完全に複製する操作は作れない、という複製不可能定理(no-cloning theorem)の制約です。したがって、未知の量子ビットを普通のデジタル信号と同じように読み取り、同じ状態を何個も作って送り直す中継にはできません。

    そこで、送りたい未知の状態とは別に、通信の両側で使うもつれを先に用意します。代表的なのが、二つの量子ビットで一組になるベル対です。二つを別々の状態として扱えず、共同の量子状態として記述する必要があります。作りたいベル対の種類が決まっていれば、生成に失敗した試行を捨てて作り直すことはできます。これは、手元に一つしかない未知の状態を複製する操作とは異なります。

    光子を量子通信路で送り、局所の量子ビットともつれを作るなど、生成の構成には複数の方式があります。成功したことを知らせる通知はヘラルドと呼ばれます。単に光が届いたというだけでなく、その手順で使えるもつれが用意できたかを、次の操作と対応づけるための情報です。

    中継点の二つを測定すると、両端の組が残る

    端点をA、B、中継点をRとします。まず、AとRの間でもつれた一組を作り、RとBの間でもう一組を作ります。中継点には、A側の組に属するR1と、B側の組に属するR2という、別々の量子ビットがあります。

    次に、R1とR2をベル測定にかけます。これは二つの量子ビットを一緒に扱い、四つのベル状態のどれに対応するかを調べる共同測定です。理想的な条件では、結果に応じてAとBの量子ビットがベル対になります。AとBの量子ビット同士が直接やり取りしていなくても、二つの区間のもつれを使って両端を結びつけられます。

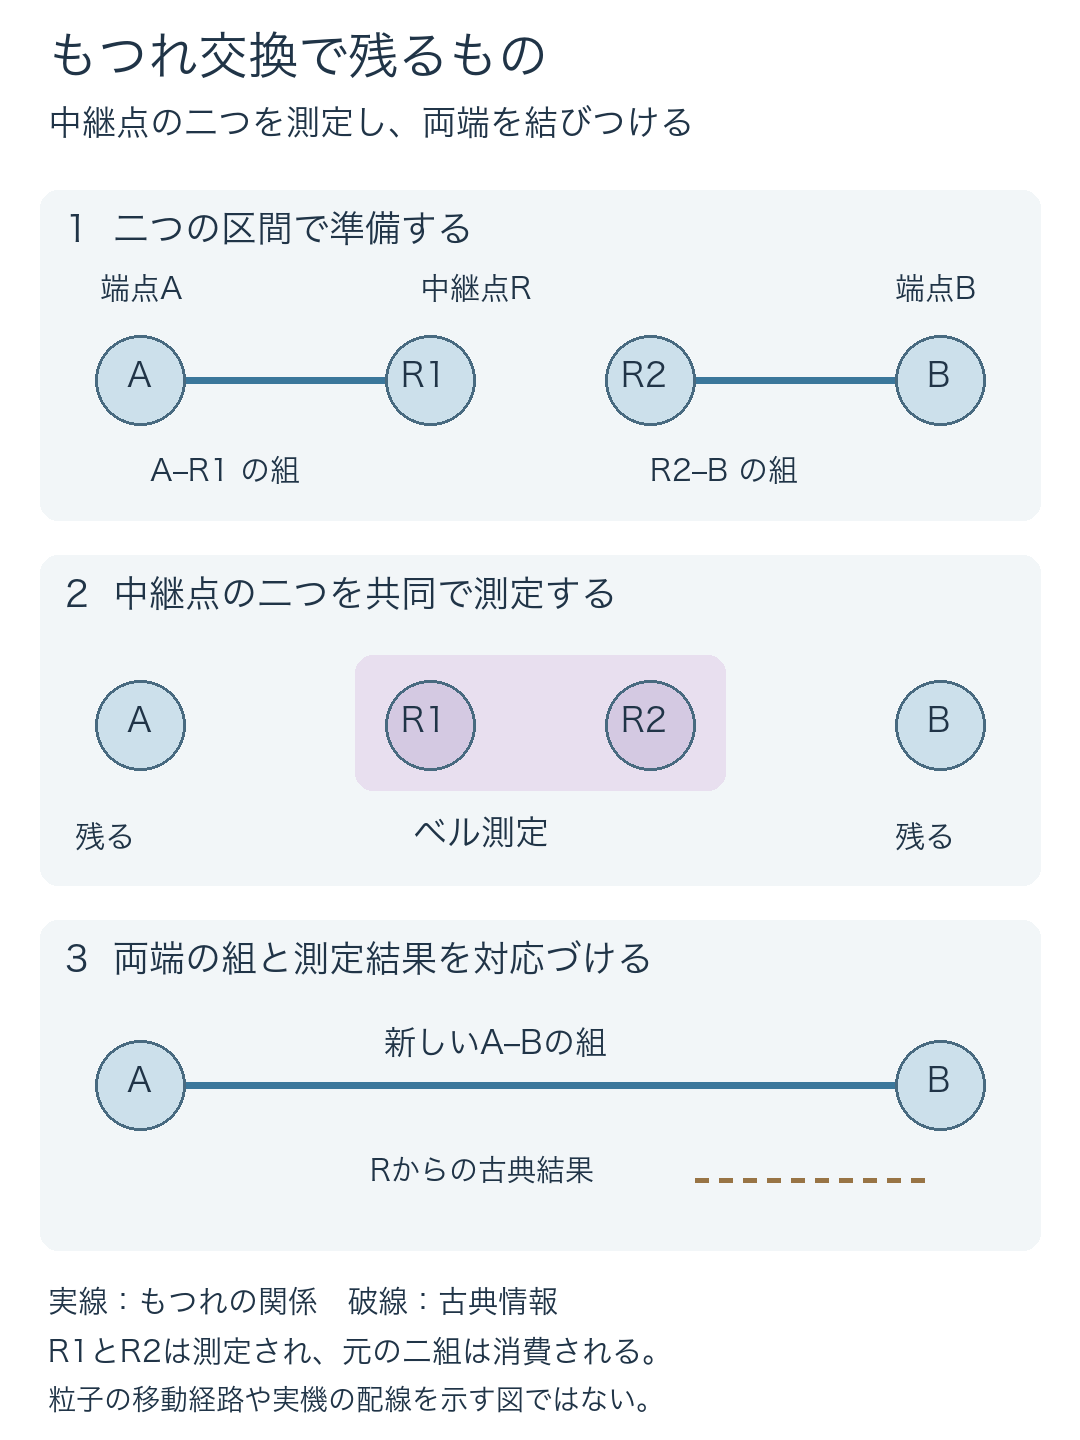
    AとR1、R2とBの二組を準備し、中継点のR1とR2をベル測定する。測定後はAとBの組が残り、中継点からの古典結果を対応づけて利用する。R1とR2は測定され元の二組は消費される。
    図1 もつれ交換で準備するもの、測定するもの、残るもの。実線はもつれの関係、破線は測定結果を伝える古典通信を表す独自説明図です。粒子の移動経路や実装の配線図ではありません。原寸画像を開けます。

    ここで、二組を残したまま三組目を増やしたわけではありません。R1とR2は測定され、最初の二組は消費されています。両端の量子ビットも、中継点から新しく飛んできた粒子に置き換わるわけではありません。変わるのは、残った二つの量子ビットの共同の状態です。

    四つの測定結果と、二ビットの知らせ

    少しだけ式で確かめます。最初の二組を、どちらも同じベル状態Φ+ = (|00〉+|11〉)/√2に準備したとします。|00〉は一組の二つが0、|11〉は二つが1という基底を表し、その足し合わせを量子状態として扱います。AとR1、R2とBの組が、それぞれこの状態です。

    雑音も損失もなく、四つを完全に識別できる理想的なベル測定をR1、R2に行うと、各結果の確率は1/4です。この例では、結果の名前と、A、Bに残るベル状態の名前が対応します。下表の状態はA、Bの順に書いています。

    中継点の測定結果 A、Bに残る状態 この理想例の確率 Φ+へそろえるB側の操作
    Φ+ (|00〉+|11〉)/√2 1/4 何もしない(I)
    Φ− (|00〉−|11〉)/√2 1/4 Z:|1〉側の符号を反転
    Ψ+ (|01〉+|10〉)/√2 1/4 X:0と1を入れ替える
    Ψ− (|01〉−|10〉)/√2 1/4 Zの後にX(全体の符号差は同じ状態と扱う)

    1/4は「交換の成功率が25%」という意味ではありません。この理想例では四つとも利用できる結果です。実際の装置で四つをどこまで識別できるか、検出されない事象がどれだけあるかは別の条件です。表はベル状態の代数を確かめたもので、装置の成功率や通信速度を測った結果ではありません。

    四通りの結果を区別するのに必要なのが二ビットの古典情報です。どの結果だったかが分かれば、上のような操作で同じベル状態へそろえられます。実装によっては直ちに物理的な補正をせず、結果を記録し、後の操作や測定の解釈に反映できます。それでも、どの組にどの結果が対応するかという情報は必要です。

    結果を知らない側は、欲しいベル状態が得られたと勝手に決められません。この理想例でも、結果を区別せずに平均すると、A、Bの状態は四つの基底を等しく混ぜた状態になります。中継点の測定で利用可能なメッセージが瞬時に届くわけではなく、結果を伝える古典通信には通常の因果関係と伝搬時間の制約があります。

    「交換できる」だけでは、遠距離通信は完成しない

    一方の区間で先にもつれができても、もう一方が準備できるまで待つことがあります。その間、量子メモリに保持した状態は、周囲との相互作用などによって劣化し得ます。量子メモリは、成功した状態を時間無制限に凍結する箱ではありません。隣の区間の生成を待つ時間、成功通知や測定結果が届く時間、次の操作までの時間を合わせて考える必要があります。

    そのため、構成を比較するときは距離や中継点の数だけでなく、次の条件を見ると判断しやすくなります。

    • 短い区間での生成:一試行にどのくらい時間がかかり、成功をどの情報で判定するか。試行回数と、利用可能な組の供給速度を分けます。
    • 交換の測定:どの結果を識別でき、失敗を検出できるか。理想的な四結果の表と、実際の測定器の能力を混同しません。
    • 保持と同期:相手の準備や通知を待つ間に、必要な状態の品質を保てるか。生成だけを速くしても、別の待ち時間が支配することがあります。
    • 届けた組の品質:目的の状態にどの程度近いかを示す忠実度と、使える組が届く速度を一緒に見ます。用途や手順が求める品質を省いて、速度だけを比較しません。

    品質を上げる方法にも費用が伴います。例えば、もつれ蒸留は、複数の組を使ってよりよい組を得る手順で、組の消費や古典的な連絡が必要です。量子誤り訂正を組み込む構成もあり、すべてのリピーターが同じ装置や同じ手順を採用するわけではありません。

    もつれの配布と、未知の状態の転送を分けて考える

    ここまでで準備したのは、A、Bが共有するもつれです。これを使う応用の一つが量子テレポーテーションで、送りたい未知の状態と、手元のベル対の片側を測定し、古典結果を相手へ伝えます。受け手は結果に応じた処理を行います。元の未知の状態はそのまま残らず、転送先と元の場所にコピーが二つできるわけではありません。

    量子リピーターを見るときは、もつれを作る、つなぐ、結果を対応づける、用途で使うという段階を分けると理解しやすくなります。本稿が参照したRFC 9340は、2023年3月公開のIRTFの研究成果をまとめたInformational文書です。インターネットの標準仕様や、現在の全装置の性能を保証する文書ではありません。ここでは構成を理解する原理を取り出し、特定の距離・成功率・商用化時期を断定していません。

    出典

    • W. Kozlowskiほか、RFC 9340: Architectural Principles for a Quantum Internet、2023年3月。4.1.2(複製不可能定理)、4.2(もつれ)、4.3(テレポーテーション)、4.4.1〜4.4.3(生成・交換・誤り管理)、5.2(古典通信)、5.4.1(量子メモリ)。表の理想ベル測定は、同文書の状態と手順に基づく独自の代数計算です。
    • RFC Editor、RFC 9340の文書情報、正誤表検索。2026年10月17日確認時点で該当する正誤表なし。
  • 部分トレース、量子状態の一部だけを見ると何が残るか

    部分トレース、量子状態の一部だけを見ると何が残るか

    二つの量子ビットを合わせた状態は分かっている。でも、知りたいのは片方を測ったときに何が起こるかだけ。量子の計算では、こうした「全体から一部分へ」という見方が必要になります。装置の一部だけを観測するときや、周囲の環境を細かく追わず対象の変化を調べるときに使う考え方です。

    そのための操作が部分トレースです。全体の状態から、残したい部分の観測を予測できる状態を取り出します。ただし、全体の表から不要な行や列を削る操作でも、測定結果を一つ選ぶ操作でもありません。何を残し、何を区別しなくなるのかを、二つの量子ビットA、Bで確かめます。

    簡単にまとめると?

    • 部分トレースは、見ない部分の自由度を足し合わせ、残した部分だけの観測を予測する密度行列を作ります。
    • 全体が純粋な状態でも、もつれた一部分は混合状態になることがあります。一方、部分トレースの結果が必ず混合になるわけではありません。
    • 同じ部分の状態から、元の全体を一意に復元することはできません。測定結果で条件を絞る操作との違いも確認します。

    状態ベクトルと密度行列は、表す範囲が違う

    まず、状態の書き方を整理します。量子ビットの純粋状態は、例えば|0〉、|1〉、あるいはその重ね合わせとして、一つの状態ベクトルで表せます。ここでは、|+〉=(|0〉+|1〉)/√2という等しい重みの重ね合わせも使います。

    一方、|0〉を半分、|1〉を半分の確率で準備し、どちらを準備したかの情報を持たない場合は、その確率的な混合として扱います。こうした混合状態も純粋状態も、一緒に表せるのが密度行列です。密度行列を使っているというだけで、状態が混合だとは限りません。

    0、1の順を基底に選んだ一つの量子ビットでは、密度行列は2行2列です。対角成分には、この基底で0、1を測る確率が入ります。非対角成分には、両成分の位相に関わる情報が含まれます。同じ基底での結果の割合だけでは、密度行列全体は決まりません。

    見ないBの添字をそろえて、足し合わせる

    AとBを合わせた密度行列は、基底を|00〉、|01〉、|10〉、|11〉の順にすると4行4列です。各ラベルの左側をA、右側をBと決めます。ここからAだけを残すと、結果は2行2列の縮約密度行列になります。「縮約」は、残した部分に必要な形へまとめたという意味です。

    Aの状態をρA、全体をρABと書くと、部分トレースは次のように計算できます。a、cはAの行・列を指定する0か1、bは見ないBの0か1です。

    ρA[a,c]=ρAB[(a,0),(c,0)]+ρAB[(a,1),(c,1)]

    Bの行側と列側の値を同じにして、二通りを足し合わせます。例えば、Aが0である確率は、全体で00が出る確率と01が出る確率の和です。Aの非対角成分も同じ規則で求め、00と10を結ぶ成分に、01と11を結ぶ成分を加えます。単に左上の2行2列を抜き出す方法では、後者を落としてしまいます。

    この操作で残したいのは、Aだけへ作用する観測をしたときの予測です。全体の状態を使ってAの観測量を計算しても、縮約密度行列から同じ観測量を計算しても、結果が一致するように情報をまとめています。Bとの共同測定で初めて分かる情報まで、Aの表へ残るわけではありません。

    純粋な全体から、異なる二つの結果が出る

    最初の例は、Aが|+〉、Bが|0〉という積状態です。全体は|+〉⊗|0〉で、A、Bがもつれていません。Bを部分トレースしても、Aには元の|+〉の状態が残ります。密度行列の四つの成分がすべて1/2ですが、これは純粋状態です。

    二つ目は、ベル状態Φ+=(|00〉+|11〉)/√2です。こちらも全体としては一つの状態ベクトルで表せる純粋状態ですが、AとBはもつれています。Bを部分トレースすると、Aの密度行列は対角成分が1/2、非対角成分が0になります。これをI/2と書きます。Iは2行2列の単位行列です。

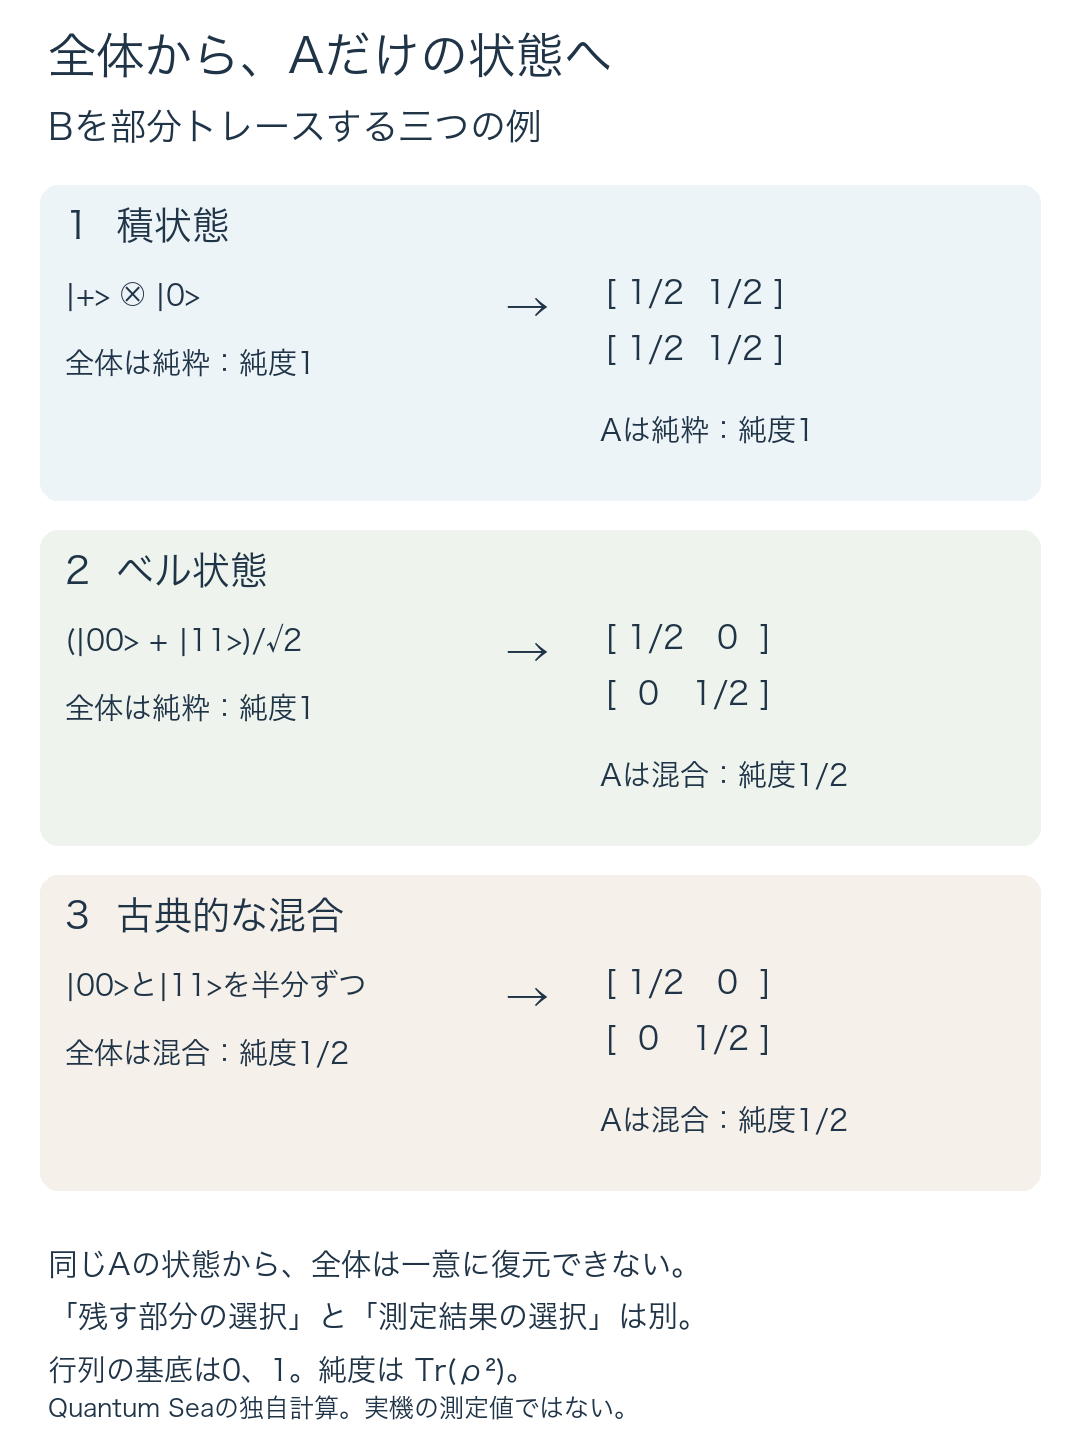
    AとBの三つの全体状態からBを部分トレースする比較。積状態ではAに純粋なプラス状態が残る。ベル状態と00・11の古典混合では、どちらもAに対角成分が二分の一の混合状態が残る。全体の違いは同じ局所状態にまとめられることがある。
    図1 Bを区別せず、Aだけの状態を残す三つの例。基底はA、Bの順。行列と純度は説明用の独自計算で、実機の測定結果ではありません。原寸画像を開けます。

    両者を数値でも区別してみます。密度行列ρを二回掛けて、その対角成分を足したTr(ρ²)を純度と呼びます。正しく規格化された状態では、純粋状態の純度は1です。一つの量子ビットのI/2では1/2になります。

    A、Bの全体 全体の純度 Bを部分トレースしたA Aの純度
    積状態 |+〉⊗|0〉 1 対角・非対角とも1/2の |+〉の密度行列 1
    ベル状態 Φ+ 1 I/2 1/2
    |00〉と|11〉を半分ずつ混ぜた状態 1/2 I/2 1/2

    全体が純粋であるという条件の下では、一部分の状態が混合になることが、もつれの存在を示します。ただし、全体が混合でもよい場合まで、この判断を広げることはできません。表の三つ目では、00と11を半分ずつ選んで準備しただけで、A、Bの間にもつれはありません。それでもAだけを見ると、ベル状態と同じI/2になります。

    つまり、局所の混合には、もつれた相手を見ていない場合も、古典的にどの準備だったかを知らない場合も含まれます。Aだけの状態が同じだからといって、A、Bの共同の状態や相関まで同じとは言えません。

    部分トレースは、測定結果を選ぶ操作ではない

    ベル状態Φ+で、今度はBを0、1の基底で測ったとします。結果が0だった試行だけを選べば、対応するAの状態は|0〉です。結果が1だった試行だけを選べば、Aは|1〉です。このように、得られた結果を条件にして試行を絞る扱いは、Bを区別せずまとめたI/2とは違います。

    結果を使わず、二通りをそれぞれの確率で平均すれば、AはI/2になります。この例では、結果を捨てた測定から求めたAの状態と、元の全体からBを部分トレースした状態が一致します。しかし、部分トレースの計算自体が、実際にBを測定したことを意味するわけではありません。Bを観測できない場合でも、Aだけの予測を作るために計算できます。

    この区別は、条件付きの実験データを比較するときに役立ちます。「Bが0だった回のA」と「Bの結果をまとめたA」では、比較する集団が違います。前者の結果を、部分トレースで得た無条件の予測とそのまま照合すると、別の問いへの答えを比べることになります。

    QuTiPでは「残す部分」を指定する

    QuTiPのQobj.ptrace(sel)では、selに残したい成分系の番号を渡します。消したい番号ではありません。A、Bの順に構成した二量子ビットなら、ptrace(0)はAを残し、ptrace(1)はBを残します。

    ここで0、1は、測定値の0、1を選ぶ引数ではなく、全体を構成する部分の番号です。また、単に4行4列であるという情報だけで、二量子ビットの構成が決まるわけではありません。QuTiPではdimsが部分ごとの次元を保持するので、その並びを確認してから残す番号を指定します。

    確認した5.1.1の実装は、状態ベクトルを受け取った場合に、対応する外積を作ってから部分トレースの処理へ渡します。その結果を密度行列として受け取ることと、その状態が混合かどうかは別の判断です。本稿はQuTiP 5.1の公式解説と5.1.1の固定コードを参照したもので、最新版や実機の性能評価ではありません。表の数値も、QuTiPを実行した結果ではなく、有理数を使った独立の行列計算です。

    部分だけの予測に必要な情報を残す

    部分トレースを使う前には、対象の分け方、残す部分、条件付きの結果かどうかをそろえます。Aだけの観測を予測したいなら縮約密度行列で足りますが、A、Bの共同の関係を知りたいなら全体の状態や追加の観測が必要です。

    部分トレースは、全体を組み立てるテンソル積を機械的に逆向きへ戻す操作ではありません。同じAの状態へまとまる異なる全体があるため、残った表だけから元の全体を復元することはできません。必要な部分の予測を保つことと、全体の情報をすべて保つことを分けて考えるのが、この操作を使う出発点になります。

    出典

  • OQDのテンソル積、量子ビットを組み合わせる式と行列積の違い

    OQDのテンソル積、量子ビットを組み合わせる式と行列積の違い

    量子プログラムの式に、掛け算らしい記号が二つ出てきます。Open Quantum Design(OQD)のAnalogインターフェースでは、演算子どうしを * でつなぐ場合と、@ でつなぐ場合で意味が変わります。同じ量子ビットへの作用を重ねるのか、別々の量子ビットを一つの系として扱うのか。この違いを見失うと、式の見た目が似ていても、表している対象まで変わってしまいます。[1、2]

    手がかりになるのが、テンソル積です。二つの量子ビットを組み合わせるとき、何を掛け、何の順番を保っているのでしょうか。OQDの記法を、手で追える小さな行列から見ていきます。

    簡単にまとめると?

    • OQDの演算子では * が演算子の積、@ がテンソル積です。同じ空間で作用を重ねることと、別々の空間を組み合わせることを分けます。
    • 1量子ビットの2×2行列を二つテンソル積にすると、2量子ビットを表す4×4行列になります。どちらの量子ビットへ作用するかは、因子の並び順で決まります。
    • 式を作ること、数値として計算すること、実機で実行することは別です。積の記号だけで、量子もつれや計算性能を判断することもできません。

    まず「どの空間の演算か」をそろえる

    1量子ビットの状態は、|0> と |1> を基準にした二つの複素数の成分で表せます。この基準を基底と呼びます。状態を変換する演算子は、この二つの成分を受け取り、別の二つの成分へ写す2×2行列として表せます。

    ここではパウリ演算子のXとZ、何も変えない恒等演算子Iを使います。Xは基底状態0と1を入れ替え、Zは0をそのままにして1の成分の符号を反転します。Zは、1を0へ変える演算ではありません。

    X = [0  1]    Z = [1   0]    I = [1  0]
        [1  0]        [0  -1]        [0  1]

    以下では状態を列ベクトルで書き、行列は左から掛けます。この約束では、積XZは右側のZを先に、左側のXを後に作用させる式です。二つとも同じ1量子ビットの空間で働くので、結果も2×2行列になります。

    行列積は、同じ対象に作用を重ねる

    実際に掛けると、XZとZXは次のようになります。

    XZ = [0  -1]    ZX = [ 0  1]
         [1   0]         [-1  0]

    二つは同じ行列ではなく、XZ = −ZX です。演算の順番を交換しても同じになることを「可換」といいますが、このXとZは可換ではありません。OQDの PauliX() * PauliZ() は、このような演算子の積を表す式として読めます。[2、3]

    ただし、この例の符号差を、そのまま「順番を変えると測定結果が変わる」と説明するのは正確ではありません。XZとZXをそれぞれ同じ状態へ単独で適用した結果は、状態全体に−1が掛かった違いになります。これは全体位相の差で、この二つの出力だけを比べても測定確率は変わりません。ここで確かめているのは、行列としての積と順序の関係です。

    テンソル積は、二つの対象を一緒に扱う

    今度は量子ビットを二つ用意します。基底は |00>、|01>、|10>、|11> の四つです。左の数字を第1量子ビット、右を第2量子ビットとします。一般の状態は、この四つに対応する複素数の成分で表すので、演算子の行列は4×4になります。

    この空間を組み立てるのがテンソル積です。行列で書いたテンソル積はクロネッカー積とも呼ばれます。X⊗Zなら、Xの各要素を、その数を掛けたZという2×2の塊に置き換えます。Xの0と1に合わせて、ゼロの塊とZの塊が並ぶため、次の4×4行列になります。

              [ 0  0 │ 1   0 ]
    X ⊗ Z =  [ 0  0 │ 0  -1 ]
              [──────┼───────]
              [ 1  0 │ 0   0 ]
              [ 0 -1 │ 0   0 ]

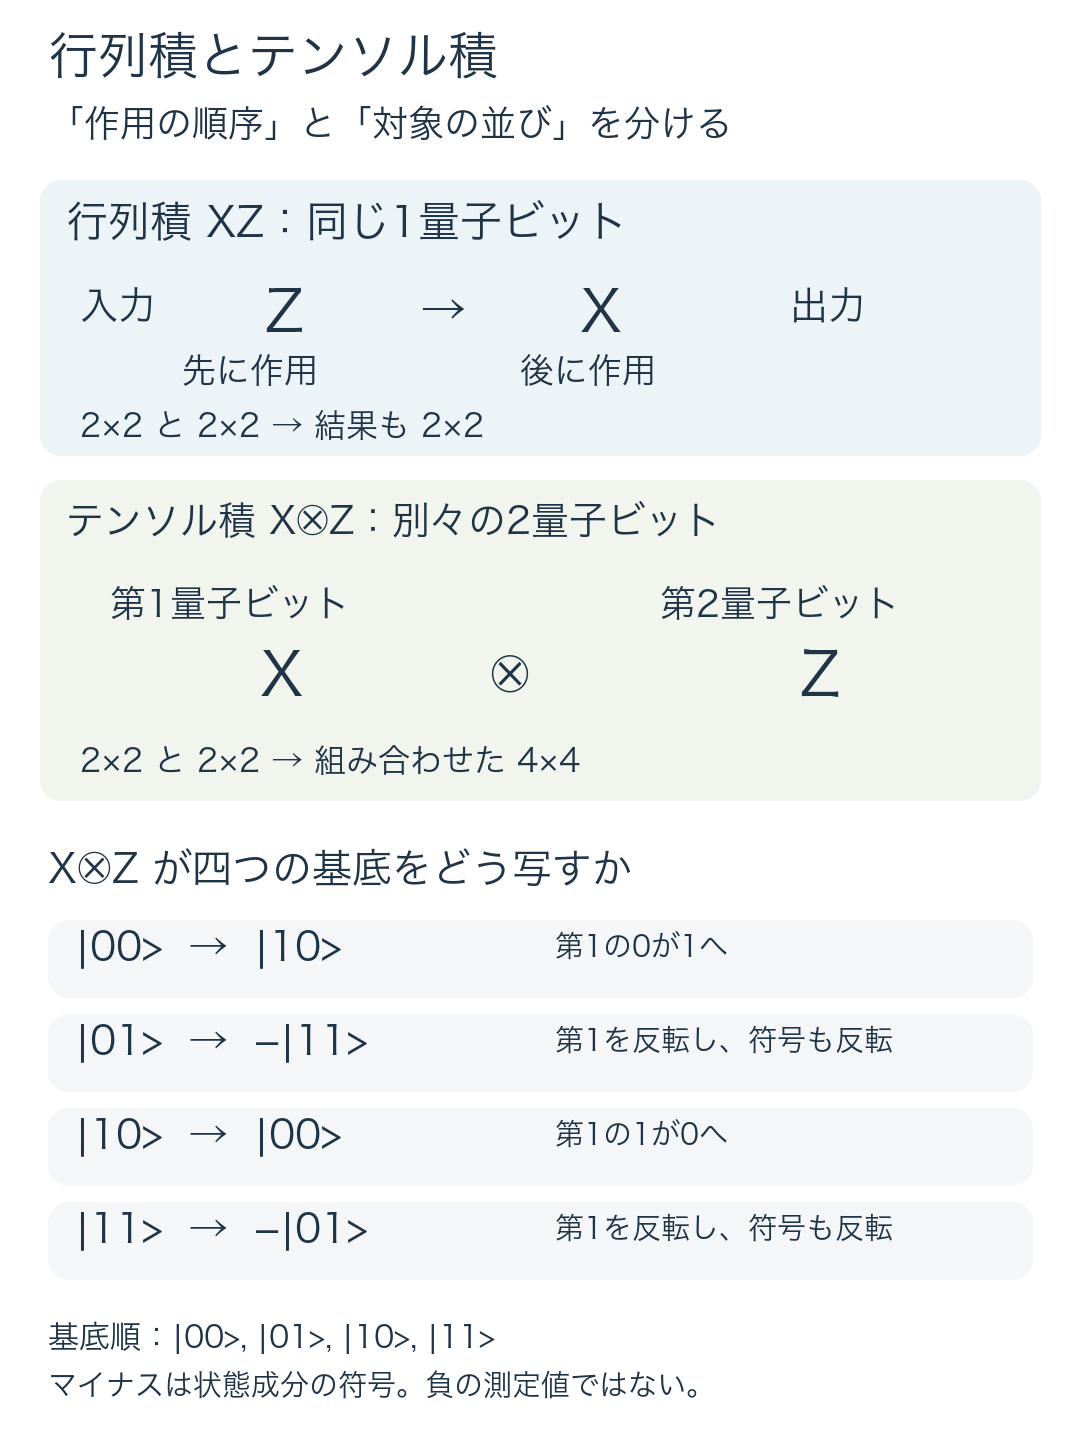
    OQDではこれを PauliX() @ PauliZ() と書きます。左のXは第1量子ビット、右のZは第2量子ビットへの作用です。この左右は、先ほどの行列積の「先に・後に」とは異なり、どの対象を担当するかを示しています。[1–3]

    上段は同じ1量子ビットにZ、Xの順で作用するXZと、別々の量子ビットにXとZを対応させるXテンソルZの比較。下段は基底00、01、10、11がそれぞれ10、マイナス11、00、マイナス01に写る対応を示す。
    図1 行列積の順序と、テンソル積の対象の並びを分けて読む。基底順は |00>、|01>、|10>、|11>。上段の大きさは行列の次元を示す。下段の符号は状態成分の符号で、測定値が負になる意味ではない。OQDの演算子の定義[1–3]を手がかりに、上記の行列から作成した説明図。画像を選ぶと原寸で表示できます。

    たとえば |01> なら、Xが第1量子ビットの0を1へ写し、Zが第2量子ビットの1に−1を掛けるので、−|11> になります。一方、|00> は |10> です。符号の有無は第2量子ビットに依存します。入力の四つの基底すべてを調べると、行列の各列も確かめられます。

    何もしないIにも、対象を指定する役割がある

    2量子ビットのうち一つだけへXを作用させたいときも、全体を表す式には二つ分の場所が必要です。第1だけならX⊗I、第2だけならI⊗Xと書きます。Iは値を変えませんが、「ここにある量子ビットはそのままにする」という指定を保ちます。

    式 対象 |00>への作用 行列の大きさ
    XZ 同じ1量子ビット 2量子ビットの基底には直接対応しない 2×2
    X⊗I 第1を反転、第2は維持 |10> 4×4
    I⊗X 第1は維持、第2を反転 |01> 4×4
    X⊗Z 第1を反転、第2の1成分の符号を反転 |10> 4×4

    テンソル因子の位置を入れ替えて、X⊗IをI⊗Xに変えると、同じ入力 |00> からでも異なる基底状態へ写ります。テンソル積の因子を並べ替えるときには、量子ビットの対応まで変えていないか確認が必要です。なお、別々の対象へ働くX⊗IとI⊗Zを行列積で順に作用させる場合は、どちらの順でもX⊗Zになります。同じ「順番」でも、対象の配置と作用の順序では意味が違います。

    OQDでこのIを使うときは、量子ビット用の PauliI() を選びます。同じソースにある Identity() は、ボソンという別の自由度のFock空間に対する恒等演算子です。名前の印象だけで置き換えず、式がどの種類の対象を表すかをそろえます。[2、3]

    OQDの式は、まず演算の構造を記録する

    OQDの公開実装では、演算子どうしの * は OperatorMul、@ は OperatorKron という節を作ります。数を掛ける 2 * PauliX() は OperatorScalarMul です。掛けた値や左右の演算子を保持する、抽象構文木(AST)という構造になっています。数との掛け算まで、量子ビットを増やす操作になるわけではありません。[3]

    つまり、ここでの @ の意味はOQDの演算子型が定めています。別の数値配列の記法をそのまま持ち込んで読まず、「何の型の、どの演算か」を確認すると混乱を減らせます。本記事の行列は、明示した基底とパウリ行列から独立に計算したものです。OQDを実行した数値出力や、量子実機の測定結果ではありません。

    式が組めることと、目的に合う物理モデルになっていることも別です。たとえば、エネルギーや相互作用を記述するハミルトニアンと、それによる時間発展で状態を変える演算は役割が異なります。積の記法だけから、どの実機で動くか、誤差がどれほどか、計算が速いかまでは分かりません。

    積の記号から量子もつれを決めつけない

    X⊗Zを見て「二つの量子ビットが結び付くから、必ずもつれが生じる」と考えるのも早計です。X⊗Zそのものを状態への演算として使うなら、それぞれの対象へXとZを別々に作用させたものです。最初の状態が |a>⊗|b> のように二つに分けて書けるなら、出力も (X|a>)⊗(Z|b>) と分けて書けます。この作用だけで、もつれていない純粋状態がもつれた状態になるわけではありません。

    一方で、同じX⊗Zという式をハミルトニアンの一項に使う場合、調べるべき対象は、そのモデルと時間発展を含む全体です。「積作用素をそのまま適用した話」と混ぜないことが大切です。式を読むときは、まず対象の数と種類、次に基底と因子の並び、最後に式の役割を確かめる。この三つをそろえると、短い * と @ の違いが、何を計算しようとしているかの違いとして見えてきます。

    出典

    1. Open Quantum Design, Analog interface — Explanation(2026年10月17日JSTに取得した保存版)。量子自由度と演算の種類。
    2. Open Quantum Design, Analog interface — API Reference(同日取得)。Pauli、Ladder、Operatorの定義。
    3. Open Quantum Design, oqd-core / operator.py(commit 4f34f34e に版を固定)。演算子の構文木と各記号の実装。Web解説は取得時の内容、コードはこの固定版を参照しています。
  • WCAGのフォーカス遮蔽、固定表示の裏に操作対象を隠さない

    WCAGのフォーカス遮蔽、固定表示の裏に操作対象を隠さない

    ページをキーボードで操作していると、Tabキーを押したのに、次に選ばれたリンクやボタンが見当たらないことがあります。画面の上に固定されたヘッダーや、下から重なる通知の裏へ、操作対象が入り込んでいるかもしれません。画面上の位置が分からなくなると、次のキーで何を操作するのかも確かめにくくなります。

    この問題を扱うのが、ウェブのアクセシビリティ指針WCAG 2.2の「Focus Not Obscured」、フォーカスを隠さないための達成基準です。最小条件では、対象の一部が見えている状態を認めています。ただし、それだけで操作対象も、その周囲の目印も十分に見えるとは限りません。何を見て判断する条件なのかを、固定フッターの例から整理します。[1、2]

    簡単にまとめると?

    • WCAG 2.2の2.4.11は、キーボードフォーカスを受け取った部品が、制作者のコンテンツで完全に隠れないことを求めます。一部分の遮蔽も認めない2.4.12とは条件が異なります。
    • 判断する中心はリンクやボタンなどの部品本体です。外側のフォーカス枠が見えるかどうかは、別の達成基準も合わせて確認します。
    • 重なる領域を確保する、内容を押し下げる、開いたパネルを適切に閉じるなど、表示の重なりとキーボード操作を一緒に設計する必要があります。

    フォーカスは、次に操作する場所を示す

    キーボードフォーカスとは、キー入力や操作の対象になっている場所です。たとえばリンクにフォーカスがあるときには、通常Enterキーでそのリンクを開けます。マウスのポインターを動かさずにページを進む人にとって、現在のフォーカスが見えることは、操作を続ける手がかりになります。

    多くの画面では、ボタンやリンクの周囲に枠を出す、背景を変えるなどしてフォーカスを示します。ところが、フォーカスそのものが移っていても、対象が別の表示の裏に隠れていれば、その変化は見えません。「キーを押しても反応しない」と感じたり、見えていない対象を操作してしまったりする原因になります。W3Cの解説は、キーボードだけでなく、その操作方式を利用するスイッチや音声入力などの利用者にも関わる問題として説明しています。[2]

    特に起こりやすいのが、画面端に残り続ける固定ヘッダーやフッター、上に重なる非モーダルのパネルです。ページの内容がスクロールしても固定領域は動かないため、本文中のリンクがそこへ入り込むと、表示上は別の層に覆われます。フォーカスの移動順が正しくても、重なり方まで正しいとは限らないのです。

    「全部隠れない」と「一部も隠れない」を分ける

    WCAG 2.2の達成基準2.4.11「Focus Not Obscured (Minimum)」はレベルAAの条件です。キーボードフォーカスを受け取ったユーザーインターフェース部品が、制作者の作ったコンテンツによって完全には隠れないことを求めています。ここでいう部品は、利用者が一つの機能を持つ操作対象として受け取るものです。HTMLの要素一つと、必ずしも一対一にはなりません。[1、2]

    一方、2.4.12「Focus Not Obscured (Enhanced)」はレベルAAAの条件で、部品のどの部分も隠れないことを求めます。AAの最小条件とAAAの強化条件は、同じ判定を別名で呼んだものではありません。なお、一つの達成基準を満たすことと、ページ全体がWCAGのAAやAAAに適合することも別です。

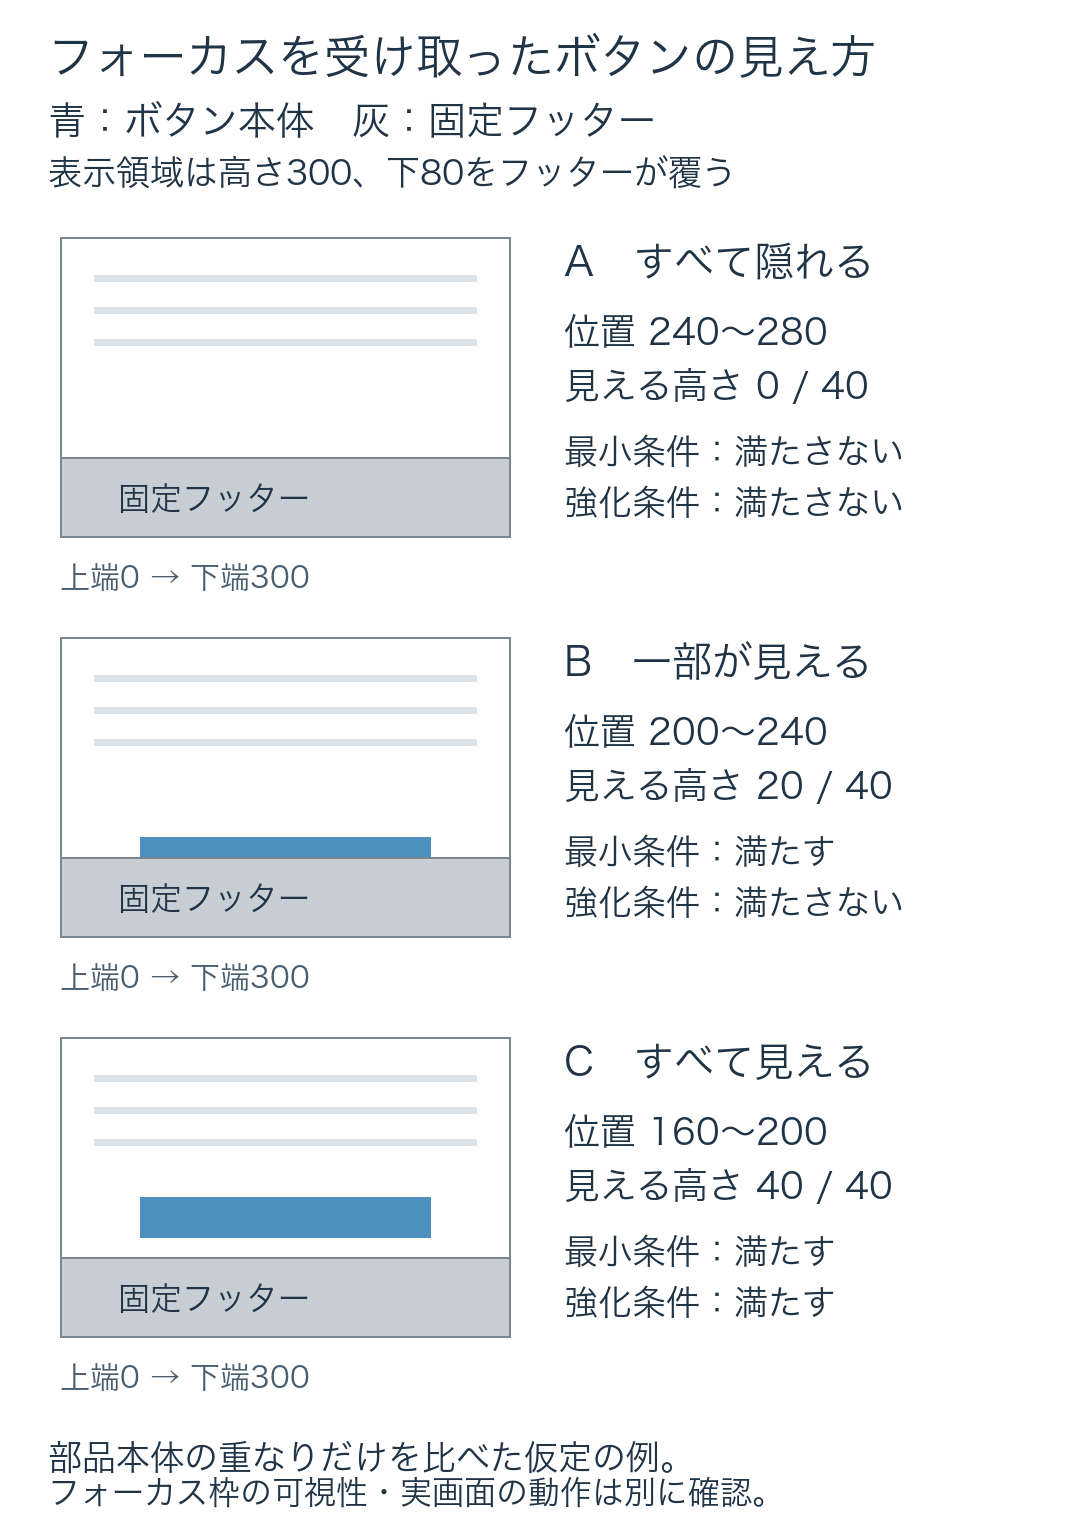
    たとえば、高さ300の表示領域の下80を、不透明な固定フッターが覆うと考えます。上端を0とすると、フッターは220から300の範囲です。同じ高さ40のボタンでも、上下の位置によって次のように見え方が変わります。単位や値は説明用で、実際のブラウザーの自動スクロールを測ったものではありません。

    不透明な固定フッターと、フォーカスを受け取ったボタンの位置
    ボタンの範囲 見える高さ この重なり方だけの判定
    240〜280 0/40 全部隠れるため、2.4.11の最小条件を満たさない
    200〜240 20/40 一部が見えるため2.4.11の最小条件は満たすが、2.4.12は満たさない
    160〜200 40/40 このフッターによる遮蔽はなく、両基準の遮蔽条件を満たす
    同じ高さ40のボタンを固定フッターに対して三つの位置へ置いた説明図。240から280では全体が隠れ、200から240では上半分の20が見え、160から200では40すべてが見える。固定フッターは表示領域の220から300を覆う。
    図1 部品本体の位置だけを変えた独自の説明図。枠線などのフォーカス表示は省略し、灰色の帯を制作者による不透明な固定フッターとしています。値は矩形の重なりを説明するための仮定で、画面の実測値ではありません。画像を開くと拡大できます。

    一部が見えるケースでは、残った部分だけでボタンの内容が読めるかどうかは、文字の位置や大きさにもよります。したがって、2.4.11の最低条件を満たしたからといって、その見え方を設計上の目標にする必要はありません。W3Cの解説も、部分的に隠れる程度と頻度を減らし、できるだけ全体が見えるようにすることを勧めています。[2]

    ボタン本体と、外側のフォーカス枠は別に見る

    2.4.11で評価するのは、基本的にフォーカスを受け取った部品本体です。その外側に描かれたフォーカス枠は、部品が完全に隠れているかを判断するときの本体には含めません。枠が部品の内側にある場合や、本体の見た目の変化でフォーカスを示す場合は、その表示も本体の一部になります。[2]

    この区別が必要なのは、「ボタンは見えるが、フォーカスの目印が分からない」という状態があるためです。部品の一部が見えていて2.4.11を満たしても、外側の枠が完全に覆われれば、フォーカス表示の可視性を扱う2.4.7「Focus Visible」の問題が残り得ます。また、半透明の幕で本体が透けて見える場合も、色の差が弱まり、非テキストのコントラストを扱う1.4.11の条件を満たさないことがあります。[1、2]

    確認するときは、「対象そのものがどこにあるか」と「今そこを操作していると分かるか」を続けて見ます。前者だけ、あるいは目立つ枠の色だけを点検しても、もう一方の問題は見落とせます。

    自動で現れる通知と、自分で開いたパネル

    重なる内容がどのように現れたかも、条件を読むうえで重要です。ページ側が初めから置いた固定フッターや、利用者の直接の操作なしに現れた通知は、フォーカスを受け取った部品を完全に隠してはいけません。「スクロールすれば見えるはず」と考えるだけでは、利用者が開いた内容に関する次の扱いを適用できません。

    2.4.11の注記では、利用者が開いた内容について、フォーカスを先へ進めずに対象を再び表示できるなら、制作者のコンテンツで視覚的に隠れた状態とは扱わないと説明しています。たとえば自分で開いたチャットパネルがリンクを覆ったとき、フォーカスをそのリンクに残したままEscapeキーでパネルを閉じられる仕組みです。閉じるボタンを探すために別の部品へフォーカスを移さなければならない状態とは、条件が違います。[1、2]

    また、利用者がツールパネルなどを自由に動かせる画面では、可動コンテンツの初期位置を評価するという注記があります。これは、利用者によるどの配置でも絶対に重ならないよう保証する条件とは異なります。ただし、初期位置から操作対象を覆ってよいという意味ではありません。

    重ねる前に、表示領域と操作の戻り方を決める

    修正の考え方は、上にかぶさるものをすべて消すことだけではありません。固定領域のぶんを見越してスクロール後の位置を調整する、パネルを開いたら本文を押し下げる、横の領域を確保して本文を折り返す、といった方法があります。W3Cの解説はCSSのscroll-paddingも対応方法の一つとして挙げていますが、どのスクロール領域に何が重なるかを確かめて使う必要があります。[2]

    画面の手前で操作を完結させるモーダルダイアログにも、別の条件があります。表示したときにフォーカスをその中へ移し、閉じるまでは背後の操作対象へ進まない、適切なモーダルの動作なら、背後に見えないフォーカスが残る問題を避けられます。見た目だけをダイアログ風にして、フォーカスが背後へ抜ける実装では同じ効果になりません。常にモーダルへ変えるのが最善とも限らないため、通知の必要性と操作の流れを合わせて選びます。

    実際の点検では、ヘッダーやフッターを表示したまま、Tabキーで進み、Shift+Tabキーでも戻ってみます。狭い画面、文字を大きくした状態、開いたパネルがある状態でも、操作対象とフォーカスの表示を追えるか確かめます。固定領域の高さや本文の折り返しが変わるため、通常の幅で一度見えただけでは足りません。これは動作を探るための点検例で、WCAG全体の適合評価を置き換えるものではありません。

    フォーカスを隠さない設計は、枠を描く処理に加えて、その枠と操作対象をどこへ表示するかまで扱います。固定表示の便利さを保ちながら、利用者が今どこを操作しているのかを見失わずに済む。その関係を、表示の重なりとキーボードの動きの両方から整えていきます。

    参考資料

    1. W3C — Web Content Accessibility Guidelines (WCAG) 2.2。W3C Recommendation、2024年12月12日固定版。達成基準2.4.11、2.4.12、2.4.7、1.4.11、適合要件5.2.1を参照。達成基準の要件と説明用の注記を区別して使用。
    2. W3C WAI — Understanding Success Criterion 2.4.11: Focus Not Obscured (Minimum)。2026年6月15日更新、2026年10月16日取得版。規定を補足する解説文書。部品とフォーカス表示、利用者が開いた内容、モーダルダイアログ等の説明を参照。

    出典:W3C / World Wide Web Consortium。原資料の著作権表示は各文書を参照。図1と位置の比較表は、上記の条件を説明するために作成した例です。

  • WCAGの文字コントラスト、背景との明暗差を数値で確かめる

    WCAGの文字コントラスト、背景との明暗差を数値で確かめる

    薄い灰色の文字は画面に静かになじみますが、背景との明暗差が小さいと、読むための手掛かりも弱くなります。では、どの程度の差があればよいのでしょうか。Webのアクセシビリティ指針であるWCAGは、文字と背景の組合せを「コントラスト比」という数値で確かめる方法を定めています。

    ここではW3CのWCAG 2.2、2024年12月12日勧告版の達成基準1.4.3「コントラスト(最低限)」を中心に、数値の成り立ちと配色を見直す手順を整理します。見た目がよく似た二つの灰色が、基準の境界で違う判定になる例から見ていきます。[1]

    簡単にまとめると?

    • WCAG 2.2の達成基準1.4.3では、通常の文字は4.5:1以上、大きな文字は条件を満たす場合に3:1以上のコントラスト比が必要です。
    • 比率は文字色と背景色の相対輝度から計算し、基準との比較前には丸めません。同じ文字色でも、背景を替えると結果が変わります。
    • 比率を満たすことと、実際に読みやすいことは同じではありません。文字の大きさ・太さ・表示状態も一緒に確認します。

    4.5:1は、文字と背景の組合せに対する基準

    達成基準1.4.3はレベルAAに位置付けられ、原則として文字と文字画像に4.5:1以上を求めます。大きな文字には3:1以上という条件があります。文字を画像にしても、文章として読ませるためのものなら、この確認から外れるわけではありません。[1]

    ここでいう比率は、「この灰色なら常に使える」という色単体の評価ではありません。白い背景で十分な差があっても、薄い灰色の背景へ移せば差は縮まります。本文、カード、入力欄など、実際に接する背景との組合せを確認する必要があります。

    同じ1.4.3には、操作できない状態の部品に含まれる文字、純粋な装飾、ほかの視覚情報を含む写真に偶然写った文字、ロゴやブランド名の一部などの例外があります。ただし「ブランドで決めた色だから」という理由で、通常の説明文まで例外になるわけではありません。入力欄のプレースホルダーや、ホバー・キーボードフォーカス時に表示する文字も対象です。[1、2]

    相対輝度は、RGBの数字をそのまま平均しない

    コントラスト比の計算には、色を明暗の量へ置き換える「相対輝度」を使います。最も暗い黒を0、最も明るい白を1とする比較用の値です。画面から出る光を実測した値ではなく、ここで扱う例ではsRGBの色指定から求めます。色相が違うかどうかより、文字と背景の明暗差に着目する仕組みです。[1、2]

    Webでよく使う#777777のような色は、赤・緑・青をそれぞれ0〜255の8ビット値で表しています。ただし、その値は光の量に対して直線的に増える尺度ではありません。各成分を光の量に対応する値へ変換してから、重みを付けて合計します。緑の係数は赤や青より大きく、単純なRGBの平均とは異なります。[1]

    1. 各成分を0〜1へ。赤・緑・青それぞれの8ビット値を255で割り、その値をcとします。
    2. 光の量に対応する値へ変換。c ≤ 0.04045ならc / 12.92、それより大きければ((c + 0.055) / 1.055)2.4とします。
    3. 相対輝度Lを計算。変換後の赤・緑・青をR・G・Bとして、L = 0.2126R + 0.7152G + 0.0722Bを求めます。

    次に、文字と背景のうち明るい方の相対輝度をL1、暗い方をL2とし、コントラスト比 = (L1 + 0.05) / (L2 + 0.05)と計算します。白と黒なら(1 + 0.05) / (0 + 0.05) = 21で21:1、同じ色同士なら1:1です。暗い背景に明るい文字を置く場合も、明るい方を分子へ置く計算は変わりません。[1]

    4.48を「4.5」と表示しても、基準は満たさない

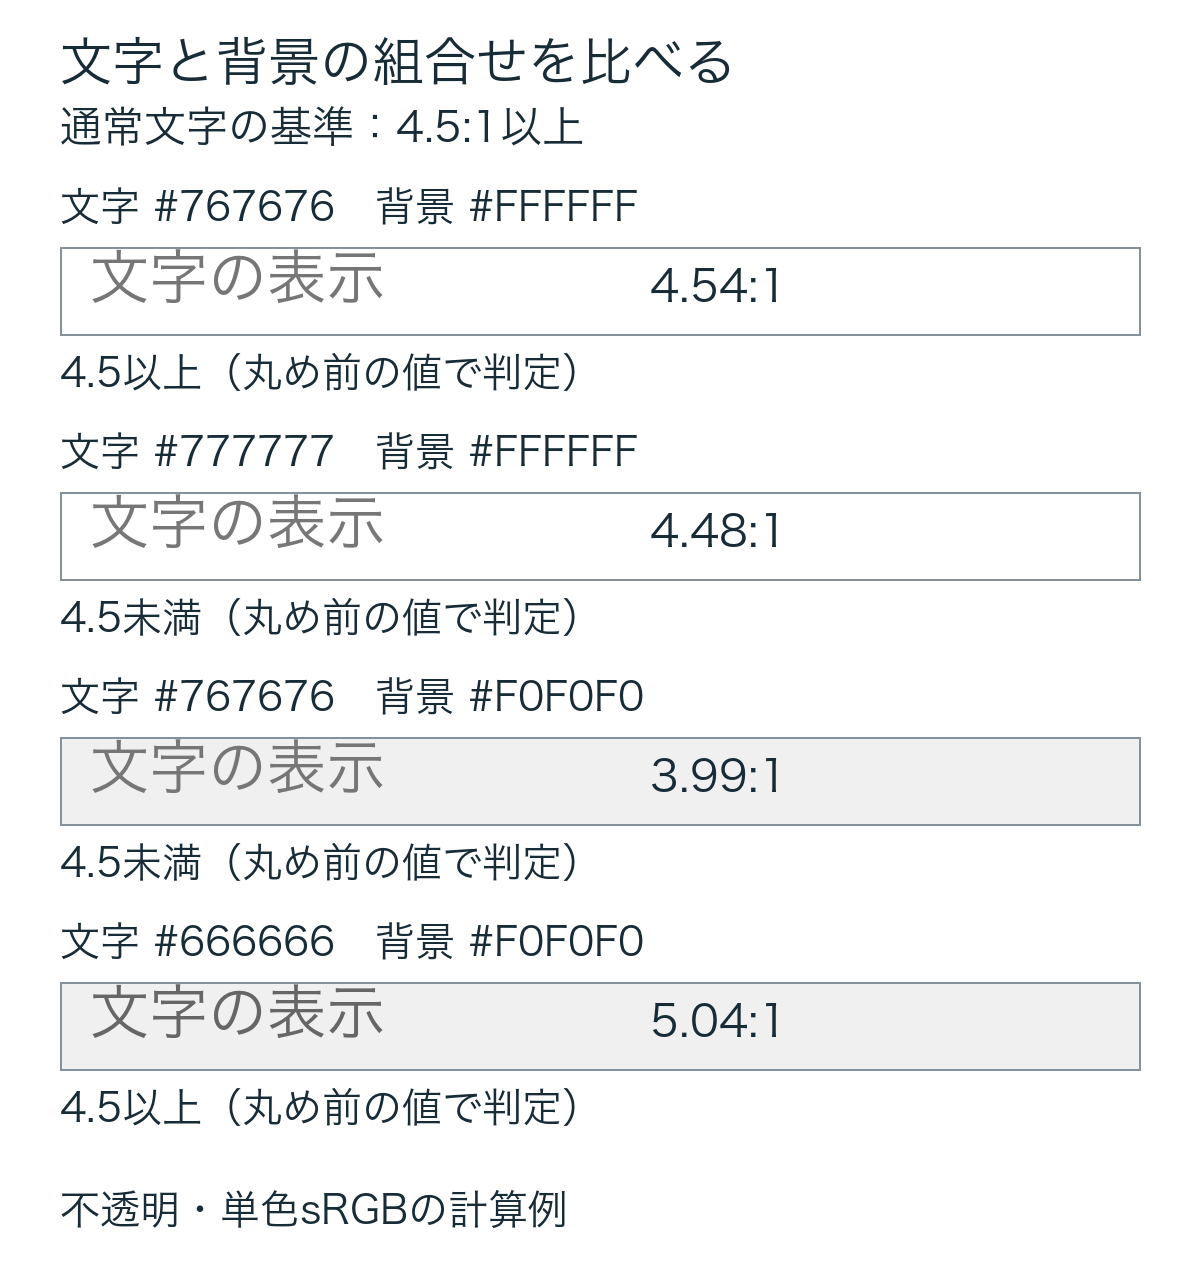
    白背景の#777777を計算してみます。16進数の77は10進数で119なので、各成分は119 / 255、約0.4667です。上の変換を行うと相対輝度は約0.184475。白の相対輝度1と組み合わせた比率は、約4.478089:1となります。

    この値は通常文字の4.5:1をわずかに下回ります。表示を小数1桁へ丸めれば「4.5」に見えますが、合格にはできません。W3Cの解説は、4.499:1も4.5:1の条件を満たさない例として挙げ、丸める前の計算値で比較するよう説明しています。[2]

    一方、少し暗い#767676は各成分が118で、白背景との比率は約4.542225:1です。こちらは4.5:1以上になります。わずかな色指定の差でも、しきい値のどちら側にあるかは変わります。「目で違いが分からないほど近い」ことは、同じ判定にする理由にはなりません。

    以下は不透明な単色のsRGBを前提に計算した例です。表の比率は読みやすさのため小数2桁にしていますが、判定には丸める前の値を使っています。画面や読者による見え方の実測ではありません。

    文字色と背景色を変えた場合の計算例
    文字色 背景色 比率 通常文字の4.5:1
    #767676 #FFFFFF 4.54:1 満たす
    #777777 #FFFFFF 4.48:1 満たさない
    #767676 #F0F0F0 3.99:1 満たさない
    #666666 #F0F0F0 5.04:1 満たす

    3行目では文字色を変えず、背景だけを白から薄い灰色にしています。それだけで比率は約3.99:1へ下がります。そこで4行目のように文字を暗くすると、薄い灰色の背景でも約5.04:1を確保できます。背景を残して文字を変えるのか、文字を残して背景を変えるのか。比率を見ると、配色のどちらを調整するかを具体的に考えられます。

    同じ灰色の文字でも背景との組合せでコントラスト比が変わる比較図。白背景の#767676は4.54、#777777は4.48。薄い灰色#F0F0F0の背景では#767676が3.99となり、文字を#666666へ暗くすると5.04になる。判定は丸める前の値を使う。
    図1 文字色と背景色の組合せを、WCAG 2.2の相対輝度・コントラスト比の式で計算して比較。数値と判定は上の表と同じ。配色の説明用に作成した図で、表示中の文字サイズや端末での見え方を適合判定するものではない。画像を選ぶと拡大できます。

    「大きな文字なら3:1」の前に、サイズ条件を見る

    大きな文字では、字の形をとらえる手掛かりが増えるため、最低限の比率が緩和されます。ただし、見出しという名前や太字の指定だけで、すべて3:1へ切り替わるわけではありません。[2]

    WCAGの定義は、18ポイント以上、または14ポイント以上の太字、あるいは中国語・日本語・韓国語のフォントでそれらに相当する大きさを挙げています。注記では、英字の18・14ポイントが大きな印刷文字のサイズをもとにしていること、CJKの相当サイズも各言語で使われる大きな印刷文字のサイズに基づくことを説明しています。[1]

    そのため、日本語の見出しを英字の数値やピクセル換算だけで自動的に「大きな文字」と決めるのは避けたいところです。使う書体と実際の表示サイズを確認し、該当する根拠が曖昧なら、通常文字と同じ4.5:1以上で設計する方が判断を保守的にできます。利用者があとから拡大したサイズを、配信時点の大きな文字の判定へ持ち込むこともできません。

    また、3:1は「あらゆる薄い文字を許す値」ではありません。例えば白背景の#999999は約2.85:1なので、大きな文字の3:1にも届きません。文字を大きくする案と配色を変える案は、それぞれ条件を確かめる必要があります。

    比率の確認と、実際の読みやすさの確認をつなぐ

    配色を点検するときは、まず通常表示で隣り合う文字色と背景色を特定します。明るいテーマと暗いテーマ、通常時とホバー時など、実装が切り替える組合せも別々に確認します。背景画像やグラデーションがある場所へ、単色背景で通った比率をそのまま持ち込むことはできません。文字が重なる位置に応じて、十分な明暗差が保たれるかを見る必要があります。[1、2]

    文字の縁をなめらかにするアンチエイリアスでは、途中の色の画素が生まれます。1.4.3の評価では、その縁の画素をスクリーンショットから一つ拾うのではなく、ブラウザーやHTML・CSSから得られる前景色と背景色を参照します。一方、細い書体では、指定色の比率が基準を満たしていても実際には薄く見えることがあります。W3Cの解説は、より太い線を持つ書体を選ぶことや、最低限より余裕のある比率を目指すことも勧めています。[2]

    数値を確かめたあとには、実際の文字サイズ、太さ、画面幅で文章を読んでみる工程が残ります。比率は配色の問題を共有できる物差しですが、読みやすさのすべてを表す点数ではありません。1.4.3を満たしたことだけで、ページ全体がWCAGのレベルAAに適合したとも言えません。文字以外の部品や図のコントラストは、別の達成基準1.4.11などの確認対象です。[1、2]

    参考資料

    1. W3C, Web Content Accessibility Guidelines (WCAG) 2.2 — 2024年12月12日勧告。達成基準1.4.3、5.1、5.2.1、用語定義「contrast ratio」「large scale」「relative luminance」。規範本文と情報提供の注記・例を区別して参照。Copyright © 2020–2024 World Wide Web Consortium.
    2. W3C WAI, Understanding Success Criterion 1.4.3: Contrast (Minimum) — 規範とは別の解説資料。保存版の更新表示は2026年9月6日。非丸め判定、文字サイズ、アンチエイリアス、例外と適用対象を参照。Copyright © 2026 World Wide Web Consortium.
  • 量子ネットワークの性能、計算と時計同期で変わる条件

    量子ネットワークの性能、計算と時計同期で変わる条件

    量子ネットワークの紹介で「遠くまで届いた」「転送が速くなった」と聞いても、それだけで使い道が分かるわけではありません。同じ建物にある量子コンピューターをつなぐ場合と、離れた時計の時刻を精密にそろえる場合とでは、通信に求める条件が変わります。

    QED-Cとアリゾナ大学のCenter for Quantum Networks(CQN)が共同でまとめた『Quantum Networking Applications Roadmap』は、こうした用途から必要な性能を整理した報告です。ここでは2026年7月に一般公開された版を使い、計算と時計同期の二つを比べます。これは用途別の要求を読むための道筋であり、個々の装置の実測成績や製品選びの順位表ではありません。[1][2]

    簡単にまとめると?

    • 距離や転送率に加え、量子状態の品質、同期、接続先の数とつなぎ方、装置の大きさを見る必要があります。
    • 同じデータセンター内の量子計算でも、状態の品質や同期への要求は高くなります。近距離であることだけでは容易になりません。
    • 時計の同期では、時計の台数、距離、伝送環境を定めて初めて必要な構成を比較できます。
    • 報告の段階評価は専門家の推定です。平均値を実測性能や、そのままの商用化年数に読み替えることはできません。

    何を届け、どの状態で使えるようにするのか

    量子ネットワークは、量子コンピューターや量子センサーなどの拠点を結び、量子状態を伝えたり、拠点間で量子もつれを共有したりする仕組みです。量子もつれとは、複数の量子系を、それぞれ独立した状態としては表せない結び付きです。つないだ機器がその結び付きを計算や測定に使うため、届いた情報の量だけでなく、状態がどの程度保たれているかが問題になります。[1][3]

    その品質を見る指標が忠実度(fidelity)です。狙った量子状態に実際の状態がどれだけ近いかを表します。例えば、二つの拠点で共有する量子もつれが途中の雑音で劣化すれば、回線がつながっていても、その用途が必要とする状態としては使えなくなり得ます。忠実度の百分率を、計算全体が正解する確率と同一視することもできません。[3]

    報告は性能を七つの軸に分けています。次の表では、測る項目を「利用する側が確認すること」に置き換えました。[1]

    量子ネットワークの七つの指標を、用途の条件へ結び付ける
    指標 確認したいこと
    忠実度 端から端まで届けた量子状態が、用途に必要な品質を満たすか。
    同期 離れた拠点の時刻や処理のタイミングを、どれほど精密にそろえる必要があるか。
    転送率 端点間で、1秒あたりにどれほどの量子ビットを伝える必要があるか。
    伝送距離 つなぐ範囲は建物・データセンター内か、都市内か、さらに広い地域か。
    ノード数 ネットワークの端点となる機器や拠点を、いくつ参加させるか。
    装置の大きさ 各拠点にどれだけの機材を置けるか。冷却や電力などの負担も確認できるか。
    接続性 決まった二地点だけを結ぶのか、接続先を切り替えるのか、多数の相手と結ぶのか。

    七つは独立に改善すれば済むものでもありません。例えばもつれ蒸留では、品質の低い複数のもつれ対を資源として使い、より高い品質の対を得ます。その分だけ対を消費するため、生成した数と、用途に渡せる品質を満たす数は一致しません。「品質を上げた後に、どれだけ供給できるか」を見る必要があります。[1][3]

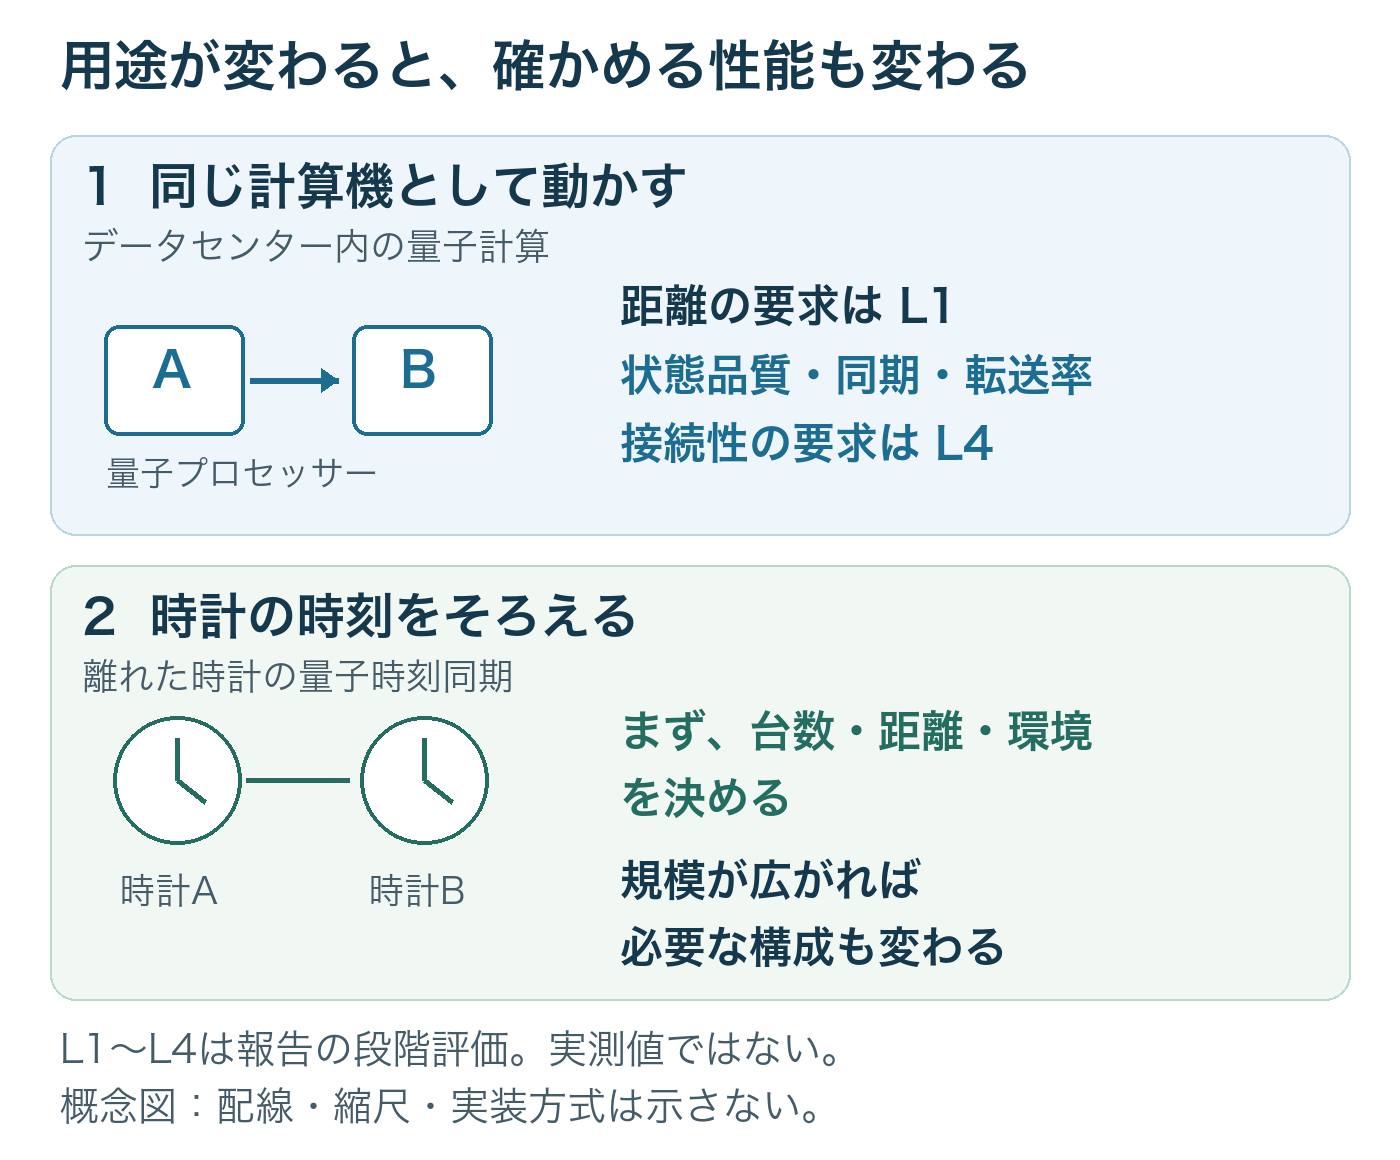
    用途1:近くの量子プロセッサーを、一つの計算に使う

    報告のクラスター型量子計算(CQC)は、同じデータセンター内にある複数の量子コンピューターや構成要素を結び、より大きな計算機として使う考え方です。地理的な広さは小さくても、装置間のつながりを計算の一部として働かせる必要があります。[1]

    例えば、量子プロセッサーAとBを使う一つの計算で、両者にまたがる量子操作が必要になった場面を考えます。計算を進めるには、必要な品質の量子資源を適切なタイミングで利用できなければなりません。通信待ちが長くなれば保存中の状態の劣化を考える必要があり、雑音が大きければ誤りへの対処も増えます。量子メモリー、機器間の操作、誤り訂正を合わせて設計する理由がここにあります。[1][3]

    報告の評価では、CQCの距離はデータセンター規模を表すL1ですが、忠実度、同期、量子ビット転送率、接続性は最高段階のL4です。短い距離と高い性能要求が同時に現れています。これは報告が想定した用途の評価であり、すべての量子計算方式に共通する設計仕様という意味ではありません。[1]

    必要な部品を見ると、状態を保持する量子メモリー、量子情報を運ぶ光を作る光源、光と装置内の量子系をつなぐインターフェースなどが関わります。一方、遠距離用の衛星を不要と評価していても、それで装置間接続の課題が消えるわけではありません。報告自身、CQCの光スイッチを必要度ゼロとした調査結果には、拡張性や効率の面から再検討の余地があるとしています。図の低い点数を、その部品はどの構成でも不要だという断定に使わないことが大切です。[1]

    用途2:離れた時計の時刻を、精密にそろえる

    量子技術を使う時刻同期(QETS)は、時計の間で量子資源を共有し、離れた場所でも時刻を精密にそろえることを目指します。報告は、あらかじめ共有した量子もつれを利用する方向を挙げ、精密な時刻管理や航法、科学計測への応用を想定しています。時計を結べば、それだけで精度向上が実証されるという話ではありません。[1]

    具体的には、同じ建物の二つの時計を結ぶ構成と、距離の離れた多数の時計を結ぶ構成を分けて考えます。管理された建物内では、光源・検出器・従来の計算処理を中心に検討できる場合があります。距離が延び、伝送路で失われる光が増えれば、送り出す光源の性能と弱い信号を捉える検出器の能力が、より厳しく問われます。参加する時計が増えれば、誰と誰を結ぶかを切り替える仕組みも問題になります。[1]

    報告は、規模が広がる場合に量子スイッチ、距離を延ばす量子中継器、もつれ蒸留などの必要性が増すと説明しています。ただし、必要な構成は方式や伝送環境によって変わります。「時計同期ができた」という結果を見るときは、二つの時計なのか多数なのか、同じ建物なのか広域なのか、どの環境でどれだけの同期精度を得たのかを合わせて確かめたいところです。[1]

    また、量子資源を使うネットワークでも、制御情報や測定結果をやり取りする従来の通信は重要です。量子状態の品質だけを取り出して比べず、装置と通信、処理を組み合わせた結果として用途の要求を満たすかを見ます。[3]

    上段は同じデータセンター内の二つの量子プロセッサーで、距離が短くても状態品質・同期・転送率が重要。下段は離れた時計で、台数・距離・伝送環境によって同期のための構成が変わることを示す概念図。
    図1 同じ量子ネットワークでも、何を一緒に動かすかによって確認すべき条件が変わる。QED-C/CQN報告のCQC・QETSの説明を踏まえて作成した概念図。実測値、実装配線、縮尺を示すものではない。

    段階評価は、実測値や年数へ読み替えない

    報告のL1〜L4は、異なる指標を並べて検討するための段階です。例えば同期のL1はナノ秒、L2はピコ秒、L3はフェムト秒の水準を表します。1ピコ秒は1ナノ秒の1,000分の1、1フェムト秒はさらに1,000分の1です。一段上がることは、どの指標でも同じ量の改善を意味しません。忠実度の段階と距離の段階を足しても、その合計が費用や開発期間を直接表すわけではありません。[1]

    商用化までの時間には別の尺度が使われています。1は「5年未満」、2は「5〜10年」、3は「10年超」です。CQCとQETSに付いた平均1.5を「1.5年で商用化」と読むのは誤りであり、平均から特定の実現年を求めることもできません。[1]

    この報告は50人を超える専門家から得た情報を土台にしていますが、段階評価を求める詳細調査の回答者は7人です。「現在の水準」として載る数値も、同じ条件で装置を一斉測定した結果ではなく、専門家が示した評価の平均です。調査は2025年7月のワークショップと、その後の会合・アンケートに基づきます。記事を読む時点の最新到達記録として扱うことはできません。[1]

    さらに報告は、必要な費用や実現後の経済価値を見積もっていません。技術的な隔たりを見つける材料にはなりますが、製造費や運用費まで含めた採算性、商用サービスの開始時期を保証する資料ではありません。[1]

    用途と条件をそろえると、比較すべき点が見える

    量子ネットワークの成果を読むときは、まず「何を一緒に動かすのか」を確かめます。計算機を一体として使うのか、時計の時刻をそろえるのか。その上で、距離と参加台数、つなぎ方をそろえ、必要な状態品質や同期精度、転送率を確認します。

    次に、示された数値が目標、専門家の推定、実験で測った値のどれなのかを分けます。部品単体の性能なのか、端から端まで動かした結果なのかも確認します。例えば高い忠実度を報告していても、その状態をどの頻度で用途に渡せるのかが分からなければ、計算に使える速さまでは判断できません。

    この二つの用途から得られるのは、「遠くまで届くほど優れている」という一列の順位ではありません。短距離でも厳しい条件があり、広域化すると別の課題が加わるという見方です。用途と動作条件をそろえることで、次に改善すべき性能と、まだ確かめられていない点を具体的に読めるようになります。

    出典

    1. QED-C / Center for Quantum Networks, Quantum Networking Applications Roadmap(2.0公開PDF)。表紙はMay 2026。参照箇所は本文pp.7–12(共同研究・指標・技術)、pp.14–15(評価尺度)、pp.24–28(CQC・QETS)、pp.30–31(蒸留・分析上の制約)、p.36(結論)、p.40(調査方法)。ページ番号はPDF内の印刷番号。
    2. QED-C, 報告の公式案内。2026年5月4日に会員向け初版、7月9日に会員向け更新版、7月28日に一般公開した旨を記載。本文はこの公開版を参照。
    3. Kozlowskiほか, RFC 9340: Architectural Principles for a Quantum Internet(2023年3月)。§§2.3、4.1.3、4.4.3.1、5.2、5.4.1を、量子もつれ・忠実度・蒸留・従来通信・保存中の劣化の基礎説明に使用。IRTFのInformational文書であり、インターネット標準規格ではない。
  • RISC-VのPMP、メモリ領域の境界と優先順位でアクセスを守る

    RISC-VのPMP、メモリ領域の境界と優先順位でアクセスを守る

    読み書きを許可したメモリ領域なのに、その中へのアクセスが拒否される。RISC-VのPMP(Physical Memory Protection、物理メモリ保護)では、権限のビットだけを見ても、この理由が分からないことがあります。複数の領域が重なるときの優先順位と、一度のメモリ操作が触れる範囲も判定に入るためです。

    PMPは、プロセッサの実行単位であるhartごとに、物理アドレスの領域へ読み取り・書き込み・命令実行の権限を設定する仕組みです。ここでは基本のPMPを扱い、二つの領域と小さなアクセス例から、設定を読む順序を整理します。[1]

    簡単にまとめると?

    • アクセス範囲のどれか1バイトに一致する設定のうち、番号が最も小さいPMPエントリーが判定を担当します。広い領域の許可を足し合わせる仕組みではありません。
    • 選ばれたエントリーが、そのメモリ操作の全バイトを覆う必要があります。一部しか覆わなければ、権限ビットやMモードの条件を見る前に失敗します。
    • 一つの命令が複数のメモリ操作へ分かれる場合は、それぞれを検査します。例外が起きても、先に通った書き込みまで元に戻るとは限りません。

    PMPで組み合わせるのは、領域とアクセス権限

    PMPの設定単位をエントリーと呼びます。エントリーにはアドレス範囲を指定する情報と、読み取りのR、書き込みのW、命令実行のXなどを持たせます。たとえばR=1、W=0、X=0なら、その権限が適用されるアクセスに対して、読み取りを許し、書き込みと命令実行を拒否します。[1]

    領域の指定にも方式があります。NAPOTは、サイズが8バイト以上の2のべき乗で、開始位置もそのサイズの境界にそろった領域を表します。TORは、前のエントリーのアドレス設定を下端、現在の設定を上端として範囲を表します。OFFにしたエントリーはアドレスに一致しません。今回の例は、二つの領域を独立に指定しやすいNAPOTを使います。[2]

    以下のアドレスは説明用で、特定の機器のメモリ配置ではありません。例の大きさを表現できる粒度のPMPが実装され、使用する二つ以外のエントリーはOFFとします。まずは通常のユーザー側のUモード、またはOS側のSモードを実効権限とするアクセスを考えます。ここで実効権限とは、実行中のモード名だけでなく、そのメモリアクセスの検査に使われる権限です。

    表1 説明に使う二つの領域。上端の次のアドレスは範囲に含めません。
    エントリー 物理アドレスの範囲 大きさ R / W / X L
    0:小さい領域 0x1800〜0x1BFF 1,024バイト 1 / 0 / 0 0
    1:広い領域 0x1000〜0x1FFF 4,096バイト 1 / 1 / 0 0

    小さい領域は、広い領域の内側にあります。広い領域を読み書きできるようにしつつ、その一部を読み取りだけにしたい、という配置です。Lは後で扱うロックのビットで、ここでは両方0にしています。

    重なった領域では、番号の小さい設定が先に決まる

    PMPは、メモリ操作が触れるどれか1バイトに一致するエントリーを探し、その中で番号が最も小さいものを選びます。小さい領域が自動的に優先されるのではなく、番号が優先順位を決める点が大切です。[3]

    たとえば0x1800〜0x1803へ4バイトを書き込む場合、エントリー0と1の両方が全体に一致します。選ばれるのは0です。そこでW=0を確認するため、この書き込みは拒否されます。後ろにあるエントリー1のW=1へ判定をやり直すことはありません。

    この配置で二つの設定の番号を入れ替えると、広い領域が先に選ばれます。すると内側も書き込み可能となり、小さい領域の読み取り専用設定はそのアクセスを止められません。例外となる領域を重ねる設計では、範囲だけでなく並び順まで確認する必要があります。

    境界をまたぐと、権限があっても通らない

    優先エントリーが決まった後には、もう一つの条件があります。そのエントリーが、一つのメモリ操作の全バイトに一致しなければなりません。先頭アドレスだけが入っていればよいわけではありません。[3]

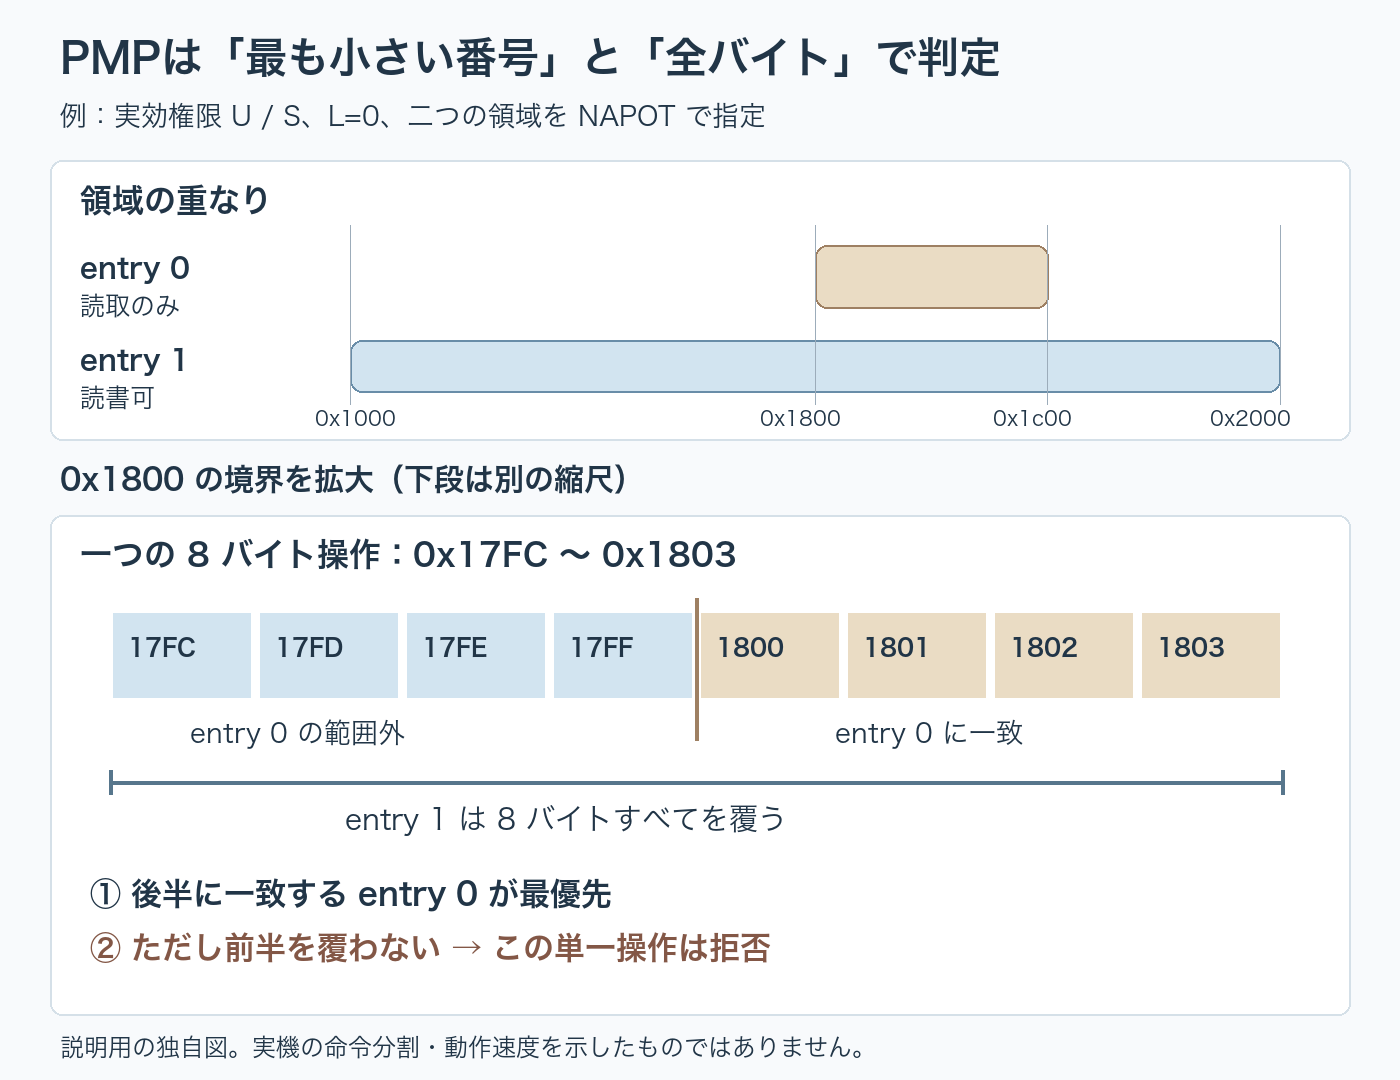
    0x17FCから8バイト、つまり0x17FC〜0x1803を一つのメモリ操作として検査する場合を見ます。前半4バイトは小さい領域の外、後半4バイトは内側です。後半に一致するエントリー0が最優先になりますが、エントリー0は前半を覆えません。このため操作全体が失敗します。エントリー1が8バイトすべてを覆っていても、この結果は変わりません。

    上段はエントリー1の0x1000から0x1FFFに、番号が小さいエントリー0の0x1800から0x1BFFが重なる配置。下段は0x17FCから0x1803の8バイトを拡大し、後半4バイトだけに一致するエントリー0が優先され、全バイトを覆えないため一つのメモリ操作は拒否されることを示す。
    図1 重なりの全体像と、0x1800の境界を拡大した図。RISC-V特権仕様のPMP判定規則に基づく説明用の独自図。上段の右端は範囲に含まれない上端で、上段と下段の縮尺は異なります。画像を開くと拡大できます。

    この全バイト一致の条件は、L、R、W、Xの値にかかわらず適用されます。したがって同じ8バイトの単一操作なら、読み取りでも失敗し、実効権限がMでL=0の場合も失敗します。Mモードの権限上の扱いを先に当てはめて、境界の検査を省くことはできません。

    表2 実効権限がUまたはSの場合。各行を一つのメモリ操作としてPMPが検査する、という条件での判定です。
    アクセスするバイト 種類 優先エントリー PMPの判定
    0x17FC〜0x17FF(4バイト) 書き込み 1 許可。全体が一致し、W=1
    0x1800〜0x1803(4バイト) 読み取り 0 許可。全体が一致し、R=1
    0x1800〜0x1803(4バイト) 書き込み 0 拒否。W=0
    0x17FC〜0x1803(8バイト) 読み取り/書き込み 0 拒否。全体を覆わない
    0x1C00〜0x1C03(4バイト) 書き込み 1 許可。小さい領域の外で、W=1
    0x2000〜0x2003(4バイト) 読み取り 一致なし 拒否。PMPが実装されていて、許可する領域がない

    ここでの「許可」はPMP検査についての結果です。実際のアクセスには物理メモリ属性(PMA)などの条件も関わるので、PMPを通ったことだけで命令全体の成功が保証されるわけではありません。[1]

    MモードとLビットは、全バイトが一致した後で読む

    Mモードは、PMPの制御レジスターを操作する機械モードです。ただしPMPの判定では、M、S、Uをすべて同じ扱いにはしません。全バイトが一致したエントリーについて、実効権限がMでL=0なら、R/W/Xによる制限を受けずに通ります。L=1ならMにもその権限を適用します。実効権限がSまたはUの場合は、Lが0でも1でもR/W/Xを適用します。[4]

    表1のエントリー0へ収まる4バイトの書き込みなら、実効M・L=0では通り、実効U/SではW=0により拒否されます。エントリー0をL=1にした場合は、実効Mの書き込みも拒否されます。この違いと、先ほどの「全体を覆わないために拒否」を分けると、設定を読み違えにくくなります。

    Lには、設定を固定する役割もあります。L=1にすると、そのエントリーの設定と対応するアドレスレジスターへの書き込みは無視され、hartをリセットするまでロックが続きます。TORのエントリーをロックした場合は、下端を決める一つ前のアドレスレジスターも変更できなくなります。OFFのエントリーでもLによるロックは成立します。領域の形と、後で変更する必要がある設定を確認してから使うビットです。[4]

    どのエントリーにも一致しない場合は、実効Mのメモリ操作はPMP上は成功します。一方、PMPエントリーが少なくとも一つ実装されていれば、実効S/Uの操作は失敗します。全エントリーをOFFにすることは、S/Uへ全面的な許可を与えることにはなりません。PMP自体を実装しない場合とは区別が必要です。[3]

    また、「Mモードでコードを実行中だから、データアクセスも実効M」とは限りません。mstatusのMPRV=1かつMPP=S/Uなら、MモードからのデータアクセスにもそのS/UのPMP検査が適用されます。仮想アドレス変換に伴うページテーブルへのアクセスは、実効Sとして検査されます。命令フェッチとデータアクセスを一括りにせず、検査されるアクセス側の権限を確認します。[1]

    一つの命令が失敗しても、書き込みの全部が取り消されるとは限らない

    これまでの表は、一つのメモリ操作ごとの判定です。プログラム中の一つの命令が、常に一つのメモリ操作になるとは限りません。仕様は、実装によって非整列のロード・ストア・命令フェッチが複数の操作へ分かれ、それぞれにPMP検査が行われる場合を定めています。[3]

    先ほどの0x17FCからの8バイト書き込みについて、ある実装が0x17FC〜0x17FFと0x1800〜0x1803の二つの4バイト操作へ分け、実効U/Sで検査したと仮定します。前半はエントリー1により許可され、後半はエントリー0のW=0で拒否されます。失敗した側がアクセスフォールトを起こしても、通った側の書き込みが既に見える状態になっている可能性があります。

    これは、どの実装もこの分割や順序で動くという意味ではありません。0x17FCは8バイト境界に整列していないため、実機では非整列アクセスの例外処理も関わります。上の例は、指定した単一操作または分割操作がPMP検査へ渡った場合を比べたものです。また、XLENより広いストアでは、自然に整列していても一部だけが成功する同様の状況があり得ると仕様は説明しています。[3]

    そのため、エラー処理を考える際に「例外が出たので、メモリは必ず書き込み前のまま」と置くことはできません。境界をまたがないデータ配置を検討することに加え、対象実装がどのアクセスを分割し、何を原子的に扱うかを確認する必要があります。

    設定を確認するときは、範囲・順序・権限・実装条件を分ける

    アクセスが意図どおりに制限されないときは、まず物理アドレスとバイト数を取り出し、一部でも一致するエントリーを番号順に見ます。次に、最初に一致した領域が全体を覆うかを確かめます。その後で実効権限、L、R/W/Xを読むと、「範囲の失敗」と「権限の失敗」を切り分けられます。

    実機の設定へ進む際は、PMPの実装有無、エントリー数、粒度、書き込み後に読み戻される値も別に確認します。標準の符号化に4バイト領域があることは、すべてのプラットフォームでその粒度が使えるという意味ではありません。ページ方式の仮想メモリを実装するhartでは、PMP設定変更後にSFENCE.VMAなど必要な同期も確認します。仮想メモリをその時点で有効にしているかだけで、省略を判断しないことが大切です。[2][5]

    本記事の図と表は、固定版の仕様に基づく説明用の判定です。実機・エミュレーターの試験結果ではありません。Smepmpによる追加規則、DMAやIOMMUを含む機器全体の保護は範囲に含めていません。PMPを読む際の要点は、許可ビットを探すだけで終えず、どの領域が判定を担当し、どこまでを一つの操作として覆っているかを確かめることです。

    参考資料

    1. RISC-V International, The RISC-V Instruction Set Manual, Volume II: Privileged Architecture — Physical Memory Protection。公式ドキュメントv20260120、§2.1.7および§2.1.7.1。PMPの対象、実効権限、制御レジスターとR/W/X。
    2. 同、Address Matching、§2.1.7.1.1、表13・14。OFF、TOR、NA4、NAPOTと実装粒度。
    3. 同、Priority and Matching Logic、§2.1.7.1.3。最小番号の優先、全バイト一致、不一致時の扱い、分割アクセスの副作用。
    4. 同、Locking and Privilege Mode、§2.1.7.1.2。Lによる固定とMモードへの権限適用。
    5. 同、Physical Memory Protection and Paging、§2.1.7.2、およびPrefaceのVersion 1.12の変更説明。ページテーブルアクセスとPMP変更後の同期。各参照は同一仕様内の関連節であり、別々の実装実証ではありません。
  • OQDの抽象構文木、式を変える規則とたどる順序を分ける

    OQDの抽象構文木、式を変える規則とたどる順序を分ける

    式の一部を書き換える処理が正しくても、その処理をかける順序が合わなければ、必要な値がまだそろっていないことがあります。プログラムを別の表し方へ変換するコンパイラーでは、「何をするか」と「どこから処理するか」の両方を設計します。

    非営利団体Open Quantum Design(OQD)が公開するコンパイラー基盤は、この二つを規則(Rule)と走査(Walk)に分けています。量子計算のソフトウェアを支える仕組みですが、その関係は小さな足し算と掛け算でも理解できます。ここでは抽象構文木(AST)をたどる例から、変換の順序を選ぶ理由と、動作確認で分かる範囲を見ていきます。[1、5]

    簡単にまとめると?

    • 抽象構文木は、式を演算とその引数の親子関係で表します。OQDは、各要素で行う処理と、要素をたどる順序を分けています。
    • 子の変換結果を使って親を変換するなら、子を先に処理するPostが必要です。親から見るPreとは用途が異なります。
    • 複数の処理をつなぐ順序や繰返しの停止条件も、変換規則とは別に確認します。構文木を処理できたことだけでは、量子ハードウェアの性能は分かりません。

    式のまとまりを、抽象構文木で表す

    1 + 2 × 3という式を考えてみましょう。掛け算のまとまりは2 × 3で、その結果を1に足します。これを木の形で表すと、一番上の「+」から「1」と「×」へ枝が分かれ、「×」の下に「2」と「3」がつながります。

    このように、演算と引数の関係を表すのが抽象構文木です。木の一つひとつの要素をノードと呼びます。たとえば「×」は「2」と「3」の親であり、「+」の子でもあります。式の見た目の文字列を左から読むだけでなく、どの演算が何を受け取るのかを明示できます。

    OQDの電卓チュートリアルも、整数、加算、乗算、累乗をそれぞれの型で表します。ここで使う小例は、その構造を足し算と掛け算だけに絞ったものです。量子状態や量子ビットの配置を表す図ではありません。[2]

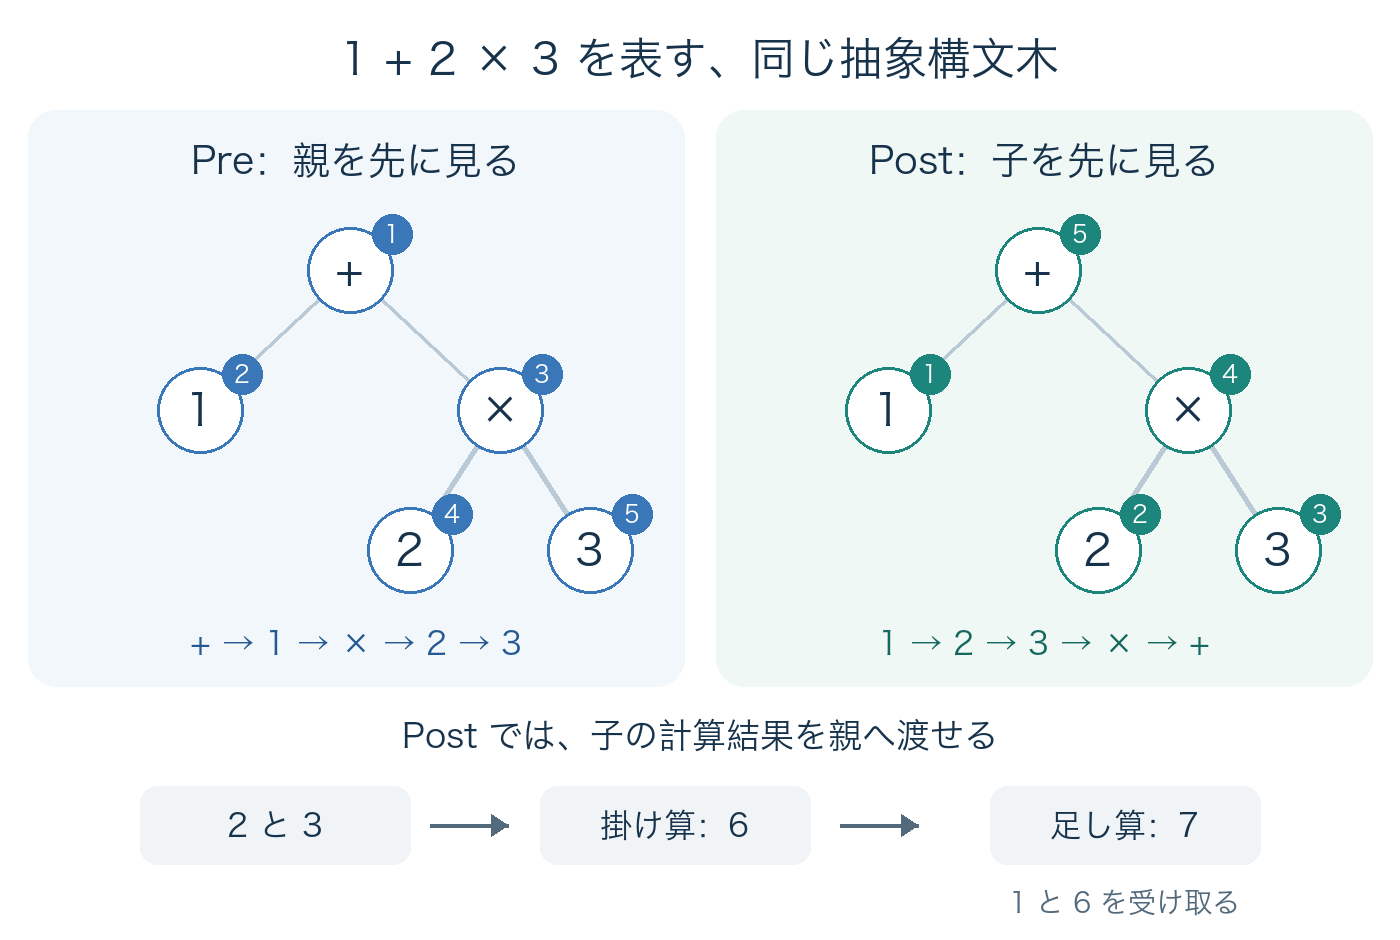
    1+2×3を表す同じ抽象構文木。Preは+、1、×、2、3の順、Postは1、2、3、×、+の順にノードを見る。Postでは2と3を先に処理して6を得てから、1との加算で7を得られる。
    図1 同じ式でも、ノードを見る順序は異なる。番号は訪問順で、式の計算結果ではない。下段はPostで子の計算結果を親へ渡す関係を示す。OQDのWalkと電卓の説明に基づく模式図。[1、2]

    Ruleは処理内容、Walkはたどる順序

    Ruleは、ある種類のノードを見つけたときに行う処理です。「掛け算のノードなら左右の値を掛ける」「特定の形の式なら別の形に書き換える」といった内容を持ちます。一方のWalkは、木のどのノードへ、どの順序でRuleを適用するかを受け持ちます。

    図1のPre(前順)は、親を先に見てから子へ進みます。左の枝からたどると、訪問順は「+ → 1 → × → 2 → 3」です。Post(後順)では、子を先に見てから親へ戻るため、「1 → 2 → 3 → × → +」になります。これは訪問順の違いであり、Preを選んだから足し算を掛け算より先に計算する、という意味ではありません。実際に何をするかはRuleによって決まります。

    OQDのreverse指定は、兄弟にあたる要素を右から左へたどるためのものです。Postに指定した場合、この小例の順序は「3 → 2 → × → 1 → +」になります。子を先にする性質は保たれ、PostがPreへ切り替わるわけではありません。[1、3]

    子の結果が必要な変換には、Postを使う

    この違いが効くのが、式を整数の値へ変換するときです。「×」のノードから整数6を得るには、まず左右の子から2と3を得る必要があります。その後で「+」へ1と6を渡せば、整数7を得られます。

    OQDでは、同じ構文木の互換性のあるノードへ書き換えるRewriteRuleと、異なる型や表現へ変換するConversionRuleを分けています。後者のPost実装は、元のノードに加えて、先に変換した子の結果をoperandsとして規則へ渡します。電卓の加算なら、左右の結果を足す処理です。この受渡しがあるため、子の結果を使う変換にはPostが必要になります。[2、3]

    対して、2 × (3 + 4)を(2 × 3) + (2 × 4)へ展開する処理は、式の値をその場で整数にせず、式の形を変えます。チュートリアルでは、この分配法則による変形をRewriteRuleで定義しています。整数だけのこの例では、変形前後とも値は14です。

    ただし、規則を記述できることと、その規則があらゆる入力で意味を保つことは別です。ここで確かめたのは整数の小例です。浮動小数点数では演算の順序によって丸めの結果が変わり得るため、同じ変形をそのまま一般化できません。どの値や演算を扱う言語なのかも、規則の正しさの条件になります。[6]

    処理をつなぐ順序と、止まる条件も分けて考える

    構文木全体に対して行う一つの処理をパス(Pass)と呼びます。OQDでは、複数のパスを指定した順に実行するChainと、同じパスを繰り返すFixedPointが用意されています。たとえば、式の形をそろえる処理を先に行い、その後で値へ変換する、といった組合せを表せます。[4]

    FixedPointは、結果が変わらなくなるまで処理を繰り返すための仕組みです。ただし、確認した実装には繰返しを打ち切る上限もあります。上限に達した場合も結果を返すため、戻り値を得ただけで「変換が落ち着いた」とは判断できません。規則が行き来を繰り返さないか、比較方法が適切か、どこで打ち切られたかを別に調べる必要があります。

    使い分けを考えるときは、まず処理が必要とする情報を整理すると分かりやすくなります。

    行いたいこと 見る組合せ 確認する条件
    親の形を見てから、その中へ進む Preと適切なRule 書換え後の子へどう処理が進むか
    子の変換結果をまとめて親を変換する PostとConversionRule 左右などの子の結果を、規則へ正しく渡せるか
    複数の処理を段階的に行う Chain 前のパスの出力が、次のパスの入力条件を満たすか
    形が変わらなくなるまで整える FixedPoint 収束を判定できるか、上限で打ち切られていないか

    OQDにはInやLevelという走査もありますが、公式説明では、これらを構文木を変更しない解析・検査向けに位置づけています。名前や見やすさだけで順序を選ぶのではなく、その規則が必要とする情報と、走査が結果を受け渡す方法を合わせて見ることが大切です。[1、3]

    公開実装から確かめられること

    今回の説明では、OQDのコンパイラー基盤の2026年10月8日付コミットを参照しました。同じ版の電卓Notebookと、Rule・Walk・Rewriterに関わる実装部品をローカルで実行し、Notebookの例が163になること、小例の訪問順と計算結果が説明に一致することを確認しています。パッケージ全体の動作保証や、処理速度の比較を行ったものではありません。[2〜4]

    この確認で分かるのは、選んだ規則と順序が小さな式をどう処理するかです。量子プログラムを実機へ接続するには、変換先の命令や装置の制約を満たすことを、さらに確かめる必要があります。構文木の検査に通ること、意図した計算を保つこと、実機で精度よく実行できることは、それぞれ確認する対象が異なります。

    OQDの分離設計は、変換がうまくいかないときに「規則の内容」「子と親を処理する順序」「パスの組合せ」のどこを見直すかを考える手掛かりになります。公開されたコードを読む価値は、結果の数値だけでなく、その結果ができるまでの条件を追えるところにもあります。

    参考資料

    1. Open Quantum Design — Compiler Infrastructure。Rule、Walk、Pass、Rewriterの説明。
    2. Open Quantum Design — Calculator Notebook。関連するWebチュートリアルも参照。実行確認にはNotebookを使用。
    3. Open Quantum Design — walk.py、rule.py。子の処理結果と元のノードの受渡しを確認。
    4. Open Quantum Design — rewriter.py。ChainとFixedPointの実装。コード資料[2〜4]はコミット1e861eda(2026年10月8日)。
    5. Open Quantum Design — About。団体の位置づけ。
    6. Python Documentation — Floating-Point Arithmetic: Issues and Limitations。丸め誤差と演算の扱い。資料確認日:2026年10月16日。
  • 測定値の「±」をどう読むか、標準不確かさと拡張不確かさ

    測定値の「±」をどう読むか、標準不確かさと拡張不確かさ

    測定結果に「10.00 ± 0.10 mm」と書いてあると、真の値が必ず9.90〜10.10 mmに入る、あるいは測定器が最大0.10 mmずれる、と読みたくなります。しかし、「±」だけでは、どちらも分かりません。その幅が何を表し、どのような情報から求められたかが必要です。

    幅の小さい報告が、いつも優れた測定を意味するわけでもありません。同じ測定結果を、異なる範囲の広さで表している場合があるからです。米国国立標準技術研究所(NIST)の技術ノートTN 1297を手がかりに、標準不確かさ、合成標準不確かさ、拡張不確かさをつなぎ、「±」を比較できる形で読み解きます。ここで参照するのは1994年版の解説資料であり、現在の個別分野の規格や契約上の判定手順を置き換えるものではありません。[1]

    簡単にまとめると?

    • 標準不確かさは標準偏差に相当する形で表した不確かさで、実際の誤差や最大誤差そのものではありません。
    • 拡張不確かさは、複数の成分を合わせた合成標準不確かさに包含係数kを掛けた幅です。比較には幅だけでなくkも必要です。
    • k=2を約95%の範囲と読めるのは、分布を正規分布で近似でき、不確かさの推定自体が十分確かである、といった条件がある場合です。

    誤差が分からないから、不確かさを評価する

    測定で知りたい量を測定対象量と呼びます。例えば、ある温度条件における部品の長さです。測定結果はその量の値の推定であり、測定器の表示を読めた時点で、その値を完全に知ったことにはなりません。

    誤差は、測定結果と測定対象量の値との差です。一方、不確かさは、利用できる情報に基づき、その測定結果にどの程度の不確かさが残るかを評価したものです。偶然にも結果が対象量の値にとても近く、実際の誤差が小さかったとしても、知識やデータが十分でなければ不確かさは大きくなり得ます。したがって、「不確かさ0.10 mm」を「実際に0.10 mm間違っている」とは読み替えられません。[1]§2.3

    既知の偏りを、不確かさの幅へ入れて済ませることにも注意が必要です。TN 1297は、結果に有意な影響を与える既知の系統的効果には補正を適用することを前提にしています。補正した後も、その補正量を完全には知らないために残る不確かさは、別に評価します。「ずれを補正すること」と「補正の確かさを見積もること」は二つの仕事です。[1]§5.2

    Type AとType Bは、評価の方法を分ける名前

    標準不確かさuは、不確かさを標準偏差に相当する形で表したものです。成分ごとに違う情報を、その形へそろえると組み合わせやすくなります。その数値をどう求めたかを区別するのが、Type A評価とType B評価です。

    Type A評価は、一連の観測値を統計的に解析して求めます。例えば、同じ条件で独立に繰り返し測定し、その平均値を結果として報告する場合です。1回ごとの値の標本標準偏差をs、測定回数をnとすると、平均値の標準不確かさはs/√nで評価できます。これは個々の測定値の散らばりsと、平均値の不確かさが同じではないことも示します。[1]§3、附録A

    Type B評価は、それ以外の利用可能な情報から求めます。校正証明書、機器の仕様、過去の知見などが材料です。校正証明書が拡張不確かさとその倍率を示していれば、その倍率で割って標準不確かさに戻せます。また、ある量が上下限の間で等しくあり得るとモデル化する場合、半幅aの長方形分布なら標準不確かさはa/√3です。上下限が書かれているだけで、分布を確かめずに同じ換算を使えるわけではありません。[1]§4.1–4.6

    ここで、Type Aを「偶然誤差」、Type Bを「系統誤差」と対応させてはいけません。区別しているのは原因の種類ではなく、不確かさを評価した方法です。系統的効果に関わる補正の不確かさを、繰り返し観測によってType A評価することもあります。Type Bだから大まか、Type Aだから必ず信頼性が高い、という序列でもありません。少数の観測による評価より、十分な根拠を備えたType B評価の方が確かである場合があります。[1]§2.2–2.7、§4.7

    二つの成分から「±0.10 mm」を組み立てる

    ここからは実測データではなく、計算方法を示すための仮想例です。既知の効果を補正した長さの推定値を10.00 mmとし、考慮すべき成分が次の二つだけだったと仮定します。繰り返し測定の平均値に由来する標準不確かさが0.03 mm、校正情報に由来する標準不確かさが0.04 mmです。

    さらに、二つの成分に相関がなく、どちらも長さの結果へそのまま加わる、つまり感度係数が1であるとします。この場合は、各成分を二乗して足し、平方根を取ります。

    合成標準不確かさ uc=√(0.03²+0.04²)=0.05 mm

    単純に0.03+0.04=0.07 mmと足す計算ではありません。ここで組み合わせているのは、それぞれの標準不確かさだからです。ただし、この二乗和の形を、あらゆる測定へそのまま当てはめることもできません。例えば共通の基準器に由来する成分には相関があり得ます。結果への効き方が異なる場合は感度係数を掛け、相関がある場合は共分散の項も含めます。TN 1297の不確かさの伝播則は、測定モデルを一次近似できる範囲でこれらを扱っています。[1]§5.1、附録A

    次に、結果をある広さの区間で示すため、包含係数(coverage factor)kを選びます。合成標準不確かさucにkを掛けたものが拡張不確かさUです。k=2を選ぶなら、U=2×0.05=0.10 mmとなります。

    長さ:10.00 mm、U=0.10 mm(k=2、uc=0.05 mm)

    これで「10.00 ± 0.10 mm」の幅が何かを説明できました。ただし、この算術だけから「約95%」という包含確率まで証明できたわけではありません。そこには分布や推定の条件がもう一段必要です。

    k=2が、いつでも95%を意味するわけではない

    正規分布を、その平均から標準偏差の2倍ずつ左右へ区切ると、分布の約95.45%がその区間に入ります。TN 1297では、測定結果を表す分布がほぼ正規分布で、uc自体の推定の不確かさを無視できる場合、k=2を約95%の区間に対応させています。正規分布で中央95%を厳密に指定した場合の係数約1.960と、2.000の区別もあります。[1]§5.4、§6.2

    繰り返し回数が少ないと、散らばりを見積もるための情報自体が少なくなります。このような場合には自由度が関係します。自由度は、この推定を支える独立な情報の量を表す指標です。同条件の独立な観測n個から平均と標本標準偏差を求める単純な場合、標準偏差の推定の自由度はn−1になります。

    原表B.1の95%の列を見ると、自由度9では係数は2.26です。例えば、正規分布からの独立な10回の観測だけで平均値の不確かさを評価し、ほかの成分がない場合、t分布を用いた中央95%の区間には約2.26を使います。uc=0.05 mmなら、その幅は約0.113 mmです。これは先ほどの二成分の例とは別の仮定です。複数成分を組み合わせた測定では、測定回数から直接n−1を当てるのではなく、有効自由度などを検討する必要があります。[1]附録B

    NIST TN1297の原表B.1。自由度を行、区間に含まれる割合を列としてt分布の係数を示す。95%の列は自由度9で2.26、自由度が無限大の行で1.960。95.45%の列の無限大の行は2.000。
    図1 NIST TN 1297(1994年版)の原表B.1(印刷p.10、PDF15頁)。同じ95%の列でも自由度によって係数が変わる。最下段は正規分布に対応する極限。出典:Barry N. Taylor and Chris E. Kuyatt / NIST。[1]

    原表が示すのは、指定した分布と自由度に対する係数です。複雑な測定の出力分布が強く非対称である場合などに、表から数字を選ぶだけで適切な区間が得られる、という意味ではありません。附録B自身も、複数成分の有効自由度を使う手順を、適用条件のある近似として説明しています。

    「±」の大きさを比べる前に、そろえる条件

    次の表は、U=k ucを読むための独自の比較例です。どの行も長さの推定値は10.00 mmで、数値は仮定です。包含確率は別途評価するものとし、ここでは指定しません。

    報告の形 幅の意味 ucにそろえると 読み取れること
    10.00 mm、uc=0.05 mm 合成標準不確かさ 0.05 mm 標準偏差に相当する尺度で報告している。
    10.00 ± 0.10 mm、U、k=2 拡張不確かさ 0.10÷2=0.05 mm 1行目と同じuc。幅が倍でも測定が悪くなったわけではない。
    10.00 ± 0.15 mm、U、k=3 拡張不確かさ 0.15÷3=0.05 mm 同じ尺度の不確かさを、異なる包含係数で表している。
    10.00 ± 0.10 mmのみ 説明が不足 換算できない Uなのか、標準偏差なのか、上下限なのかを先に確認する。

    ucをそろえても、比較はそこで終わりません。同じ対象量を、同じ温度・時間・手順などの条件で測っているか、必要な成分を評価へ含めているかを確かめます。校正時の不確かさに、輸送後の変化や使用場所の環境差まで含まれているとは限りません。TN 1297も、校正先での結果と、その後の利用によって加わる不確かさを区別しています。[1]§7.5–7.6

    報告を書く側なら、測定値と単位に加えて、ucなのかUなのか、Uならkはいくつか、確率を記すならどの分布・自由度・根拠に基づくかを添えます。さらに、成分と評価方法を追える説明へつなぎます。報告を受け取る側は、その順序で読むと、数字の大小だけで測定の質を取り違えにくくなります。

    部品の合否や規格への適合は、許容範囲と、測定不確かさをどう扱うかという判定規則も必要です。この稿の計算例から、特定の製品が合格するとは決められません。「±」の幅と意味をそろえることが、そうした判断へ進むための土台になります。

    参考資料

    1. Barry N. Taylor and Chris E. Kuyatt, Guidelines for Evaluating and Expressing the Uncertainty of NIST Measurement Results, NIST Technical Note 1297, 1994 Edition(1994年9月)。§2–7、附録A・B、Table B.1を参照。本文の計算例・比較表は、この資料の方法に基づく説明用の仮定であり、NISTの実測結果ではない。