平均では1秒に100件を処理できる仕組みに、1秒に90件の依頼が来る。数字だけを見ると、まだ10件分の余裕があります。それでも、依頼が到着してから処理を終えるまでの平均時間は、1件の処理にかかる時間よりずっと長くなることがあります。空いている瞬間があることと、到着した依頼がすぐ処理されることは、同じではありません。
この違いを調べる基本的な道具が、M/M/1待ち行列です。処理窓口が一つで、到着間隔と処理時間がそれぞれランダムに変わるモデルを使い、「処理能力を使い切る直前」に何が起きるかを見ていきます。
簡単にまとめると?
- M/M/1では、到着の平均頻度が処理能力より低くても、到着や処理時間のばらつきから待ちが生じます。
- 平均処理時間を10ミリ秒に固定した例では、利用率が90%から99%へ上がると、処理を含む平均時間は100ミリ秒から1秒へ増えます。
- この値は特定の仮定が成り立つ定常状態の平均です。実際のCPU使用率を代入して遅延を予測したり、最長待ち時間を保証したりする式ではありません。
「平均100件」と「等間隔に100件」は違う
まず、到着の頻度をλ(ラムダ)、窓口が動き続けたときの平均処理能力をμ(ミュー)と書きます。単位はいずれも件/秒です。μ=100件/秒なら、1件の平均処理時間は1/μ=10ミリ秒です。各依頼を必ず10ミリ秒で処理する、という意味ではありません。
M/M/1の最初のMは、到着間隔を指数分布で表すことを示します。一定の平均頻度で、互いに独立に到着するポアソン過程に対応します。二つ目のMは処理時間も指数分布、最後の1は同時に処理する窓口が一つ、という意味です。ここでは到着間隔と処理時間が互いに独立で、来た順に処理し、待つ場所に上限がなく、途中であきらめる依頼もないものとします。
λ=50件/秒でも、20ミリ秒ごとにきれいに一件ずつ来るわけではありません。短い間隔で続けて来ることも、処理が長引くこともあります。そうした偶然の重なりで列ができ、後から来る依頼が待つことになります。
待ち時間と、処理を含めた時間を分ける
利用率ρ(ロー)はρ=λ/μです。このモデルの定常状態では、窓口が処理中である時間の割合に対応します。定常状態とは、初期の状態の影響が薄れ、長い時間で見た人数や時間の統計が落ち着いた状態です。ここで扱う、容量に上限のないM/M/1で有限な平均を得るには、λ<μ、つまりρ<1が必要です。
依頼が到着してから処理を終えるまでの平均をW、処理を始める前に列で待つ時間の平均をWqとすると、次のようになります。
W=1/(μ−λ)
Wq=W−1/μ
Wには待ちと処理の両方が入り、Wqには処理時間が入りません。たとえばμ=100、λ=90なら、W=1/10秒=100ミリ秒です。そのうち平均10ミリ秒が処理で、残る平均90ミリ秒が待ちになります。長くなるのは、窓口そのものの処理時間だけとは限らないのです。
利用率90%から99%へ、時間は十倍になる
平均処理能力を100件/秒に固定して、到着頻度だけを変えました。次の表と図は、このモデルの式に数値を代入した独自計算で、実機や実サービスを測定した結果ではありません。
| 到着頻度λ | 利用率ρ | 平均の待ち Wq | 処理を含む平均 W |
|---|---|---|---|
| 50件/秒 | 50% | 10 ms | 20 ms |
| 80件/秒 | 80% | 40 ms | 50 ms |
| 90件/秒 | 90% | 90 ms | 100 ms |
| 95件/秒 | 95% | 190 ms | 200 ms |
| 99件/秒 | 99% | 990 ms | 1,000 ms |
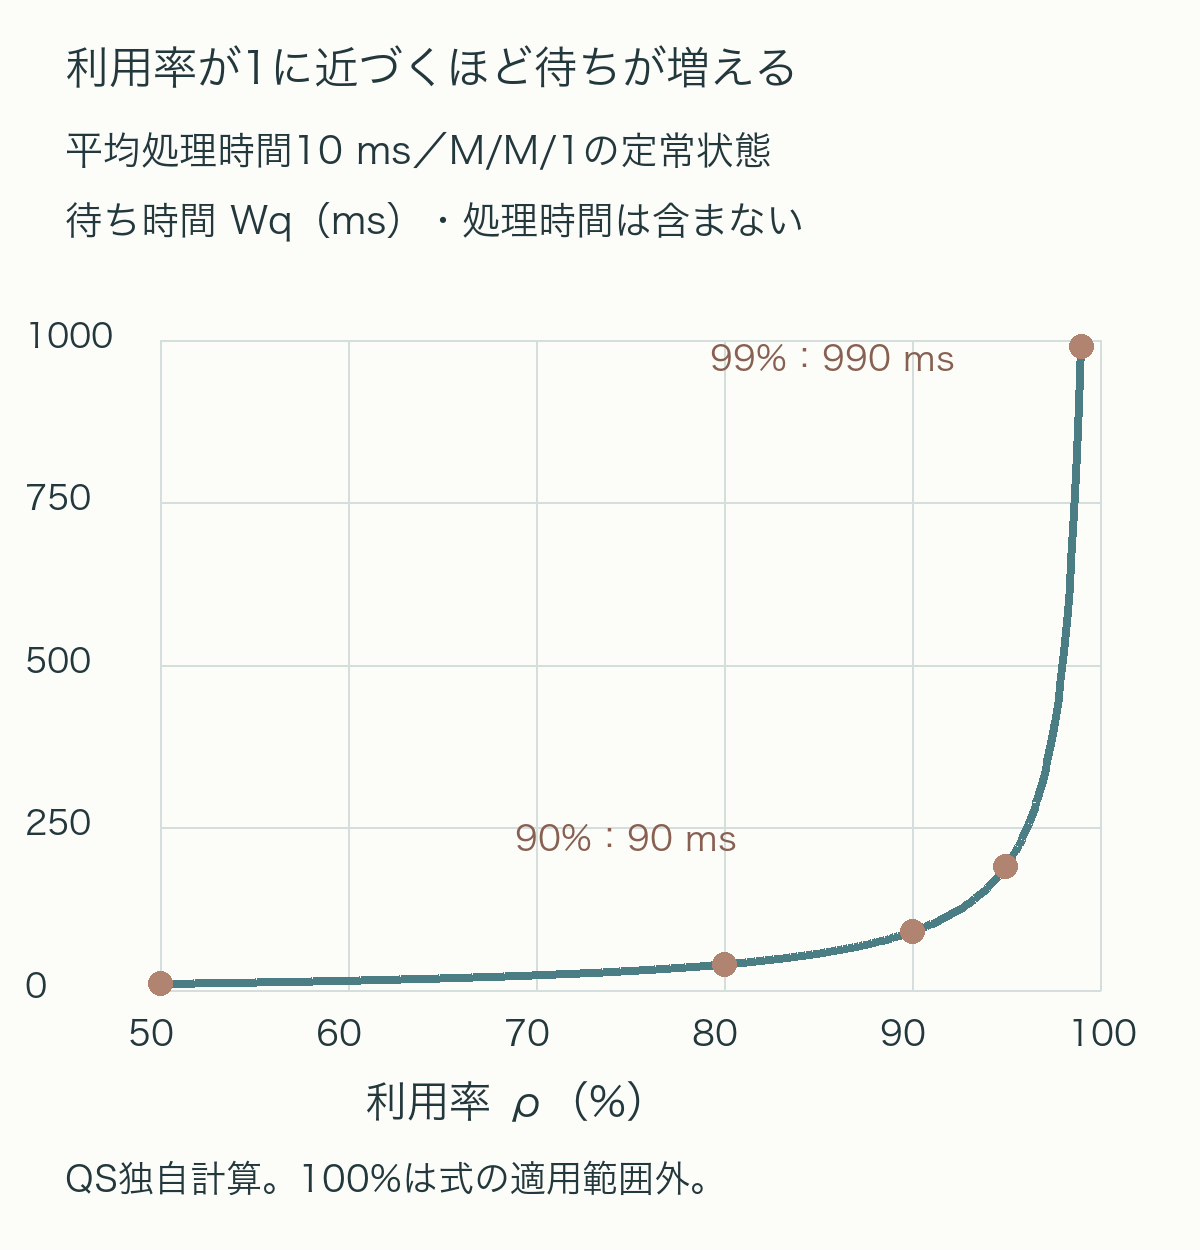
90件から99件への増加は1割ですが、処理能力との差μ−λは10件/秒から1件/秒へ縮まります。Wはこの差の逆数なので、100ミリ秒から1秒へ十倍になります。Wqは90ミリ秒から990ミリ秒へ十一倍です。比較する時間の定義によって倍率も違います。
平均の能力差は、いつでも使える固定の「空き枠」ではありません。ランダムにできた列を解消している間にも、新しい依頼が来ます。到着頻度が処理能力に近いほど、列を減らす余地が小さくなり、長い列が残りやすくなります。100%で単に時間が少し延びるのではなく、このモデルでは有限な定常平均を置けなくなることが重要です。これは100%になった瞬間、有限の列が突然無限になる、という意味ではありません。
同じ平均頻度でも、ばらつきが変われば別の列になる
ここで比較として、依頼が正確に20ミリ秒ごとに到着し、各処理が必ず10ミリ秒で終わり、最初は空いている窓口を考えます。毎回、次の到着より先に処理が終わるため、待ちはゼロです。平均の到着頻度50件/秒と処理能力100件/秒は表の一行目と同じでも、待ち時間は一致しません。この等間隔・一定時間の例はM/M/1の仮定から外れます。
逆に、まとめて届く依頼、極端に長い処理、複数窓口、優先順位、待ち場所の上限がある場合も、別のモデルが必要です。平均CPU使用率は、ここでいう「一つの窓口が動いている時間の割合」と同じとは限りません。CPU以外の待ちや並列処理を含むシステムへ、そのまま式を当てはめることはできません。
遅延を比較するときは、まず到着から完了までを測るのか、処理開始までを測るのかを決めます。そのうえで、到着間隔・処理時間の分布、窓口の数、処理順、待ち場所の上限を確認します。また、ここで計算した平均から、99%の依頼が終わるまでの時間や最長待ち時間は直接は分かりません。高い利用率と短い応答時間の両立を考えるには、平均の処理能力だけでなく、依頼のばらつきと待ち方まで見る必要があります。
出典
- MIT OpenCourseWare — M/M/1 Queue(2.854 / 2.853、Fall 2016):PDF 1–2ページ、系内時間と待ち時間の区別。
- Cathy Wu — Queuing models(MIT 1.041/1.200、Spring 2026):PDF 8–9、14–18、21–26ページ、記法・定常状態・M/M/1の導出。