量子コンピューターで測定を丁寧に行うと、読み間違いは減ります。その間、情報を保持する別の量子ビットは待ち続けます。待ち時間が長いほど状態が崩れるなら、一つの測定の正確さを高めることが、計算全体を守る最善の方法とは限りません。
2026年11月3日(日本時間4日)に公開されたプレプリントでは、テキサス大学オースティン校とジョージア工科大学の研究者らが、この違いに着目した測定時間の選択方式「DynaMite」を提案しています。表面符号による誤り訂正を対象に、直前までの検査信号から次の測定時間を変えます。現時点の中心的な根拠は、装置の公表値を使ったモデルと数値シミュレーションです。GoogleやIBMの量子プロセッサーで、この動的制御を実行した報告ではありません。
簡単にまとめると?
- 測定を長くすると読み取りやすくなりますが、待機する量子ビットの誤りは増えます。両方を含む誤り訂正全体で時間を選びます。
- エラーの兆候が少ない局面では測定を短くし、増えた局面では事前に決めた時間へ戻します。兆候の数は、実際の誤り数を完全に表すものではありません。
- 数値計算では、基準方式に対して平均1.69倍の高速化と、平均0.46倍の論理誤り率を報告しています。装置の校正、雑音モデル、復号処理の条件を含む結果です。
測定だけを正確にしても、守る情報は待たされる
表面符号は、多数の物理量子ビットで一つの論理量子ビットを守る方式です。情報を保持するデータ量子ビットの周りで、検査用の量子ビットを繰り返し測り、誤りの兆候を集めます。その信号から訂正方法を推定する処理が復号です。
この研究では、符号距離をdとして、d回の検査ラウンドを一つの論理サイクルとして評価します。符号距離は誤りへの耐性に関わる量です。距離を大きくすると、使う量子ビットと検査回数も増えます。比較する指標は、一サイクルの時間と、保護した論理情報が誤る確率の二つです。
超伝導量子ビットの読み出しでは、弱い信号を一定時間集めて0と1を見分けます。短すぎると、二つの信号の分布が重なって読み間違えやすくなります。一方、測定中にデータ量子ビットが待たされる時間も、量子状態が環境との相互作用で崩れる機会になります。
論文のGoogle Sycamoreを想定した距離7の計算例では、測定単体の基準時間500ナノ秒より、200ナノ秒のほうが論理誤り率を小さくできました。検査一回の時間は921ナノ秒から621ナノ秒へ短くなります。ここでの200ナノ秒は、この装置モデルと符号の条件に対応する値で、すべての量子コンピューターに共通する推奨値ではありません。
まず一定時間を選び、そのうえで毎回の測定を調整する
DynaMiteには二つの段階があります。第一段階のOpt-1では、測定時間ごとの読み取り誤りと待機中の誤りを調べ、論理誤り率を最小にする時間を選びます。この時間を全ラウンドで使うだけでも、測定単体の正確さを基準にした方式から改善できます。
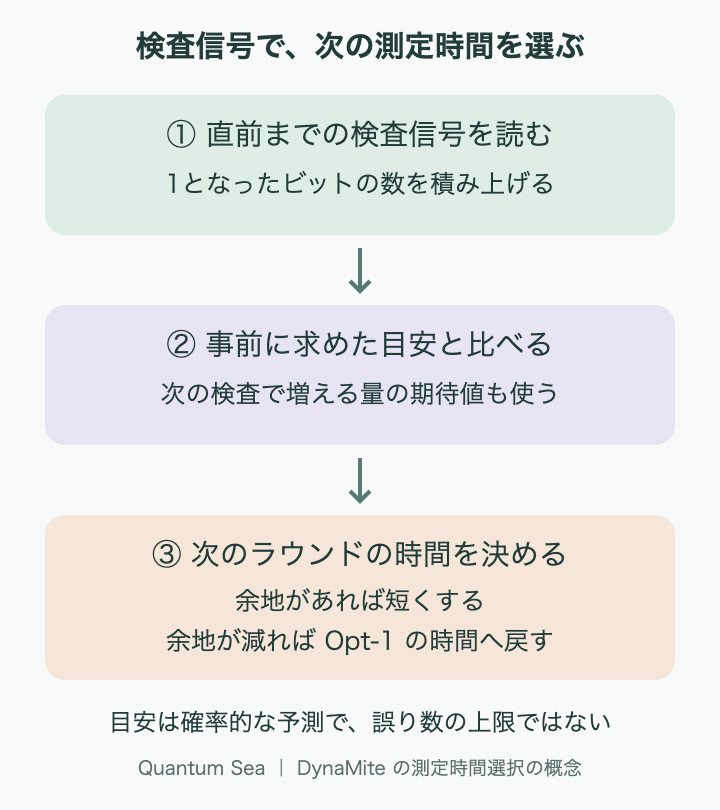
第二段階のOpt-2では、検査信号の中で1となったビットの累積数を見ます。これはハミング重みと呼ばれる指標です。誤りが連なった場合は、その両端だけが検出されることもあるため、ビット数をそのまま物理的な誤りの個数とは読めません。それでも、この研究の条件では、値が大きいサイクルほど論理誤りを起こしやすい傾向があります。
方式は、ラウンドごとに事前計算した目安と累積値を比べます。余地があれば、次の測定を短くします。余地が小さくなれば、Opt-1で選んだ時間に戻します。論文の距離7の例では、残る目安が3で、100ナノ秒の測定による次の検査信号の期待値が約2.66なら、その短い測定を選べます。その後に兆候が増えれば、次のラウンドは200ナノ秒に戻す、という流れです。
ここで使うのは、過去のシミュレーションから求めた確率的な目安です。「残りが3だから、誤りは必ず3以内に収まる」という上限保証ではありません。復号器にも各ラウンドの測定時間を伝え、時間によって変わる誤り確率を使って推定させます。
高速化の追加分には、小さな誤り率の差もある
主要な評価は、Google Sycamore、Google Willow、IBM Miami、IBM Berlinの公表値を参考にした四つのモデルを使っています。物理誤り率の基準を0.1%、符号距離を3、5、7、9、11、13とし、量子情報を保持する数値実験を1億試行で評価しました。次の値はいずれも、各モデルの基準測定時間を全ラウンドで使う方式との比較です。
| 方式 | 論理サイクルの平均高速化率 | 平均の相対論理誤り率 |
|---|---|---|
| 基準方式 | 1倍 | 1倍 |
| Opt-1:全体の誤り率から一定時間を選ぶ | 1.56倍 | 0.44倍 |
| Opt-1+Opt-2:検査信号を見て時間を変える | 1.69倍 | 0.46倍 |
相対論理誤り率は小さいほどよく、高速化率は大きいほど速いことを表します。動的な第二段階を加えると時間はさらに短くなりますが、論理誤り率もOpt-1よりわずかに高くなっています。Sycamoreモデルの距離7では、論理誤り率が約0.00249から約0.00270へ変わりました。動的調整がすべての指標を同時に最良にするわけではなく、追加の速度と誤り率を併せて比べる必要があります。
最大2.29倍という高速化率も報告されていますが、装置モデルや距離によって差があります。もともとの測定時間がサイクルの大部分を占めるモデルほど、短縮できる余地が大きくなります。
実装へ進むときに確認したい条件
著者らは、測定時間ごとの誤り率を実機ですべて校正できる低水準のアクセスを持たないため、信号の分離しにくさと状態の緩和を表す解析モデルを使っています。未公表のリセット時間には、別のプロセッサーの値を仮定した箇所もあります。したがって、装置名が登場しても、現在の実機性能をそのまま比較した表ではありません。
過去に公開されたWillowの実機データでも、検査信号の重みと失敗しやすさの関係を確認しています。ただし、そのデータの検査回数や誤り率は主要シミュレーションと異なります。実機データによる傾向の確認と、DynaMiteの動作実証は分けて読む必要があります。
制御回路については、距離13を対象としたFPGA合成で、次の時間を選ぶ処理が200MHzのクロック2周期、合計10ナノ秒に収まると報告しています。これは回路設計の資源量とタイミングの評価です。実際の装置では、信号の判定、転送、復号までを短くなった検査周期に収められるかも確認しなければなりません。
校正値の変化も重要です。信号対雑音比に関わるパラメーターが変わったのに、最初の測定時間を固定したままだと、論理誤り率が基準方式より悪くなる計算例があります。時間の選び直しを含む校正手順が、改善を維持する条件になります。
この提案を比較する際は、測定の短さだけでなく、同じ雑音条件での論理誤り率、待機時間、復号の時間制約を見ると、改善がどこから生まれるかを整理できます。各部品の精度と、計算全体で情報を守る設計を結び直す研究として注目できます。
装置開発に取り組む企業の背景は、CyclewaveのIBMの事業解説と、Googleを傘下に持つAlphabetの事業解説で紹介しています。