つながり方は分かっているネットワークで、印の付いた二つの点が隣り合っているかを調べる。これが「グラフ衝突問題(Graph Collision)」です。答えが「ある」なら、その一組を示すだけで確かめられます。しかし、大きなネットワークからその組を探すために、どれだけ情報を取り出す必要があるかは別の問題です。
2026年11月3日に公開されたArjan Cornelissen氏らのプレプリントは、この問題を量子計算で解く際の問い合わせ回数について、上限と下限の両方を更新する結果を示しました。分かったのは、入力が大きくなるときの理論的な回数の増え方です。量子コンピューターの実測時間を比較した研究ではありません。
簡単にまとめると?
- グラフの辺は既知で、各頂点に印があるかどうかだけを問い合わせます。印のある頂点が二つ存在しても、その間に辺がなければ「衝突」にはなりません。
- 新しい量子アルゴリズムの上限はÕ(n11/17)。従来のO(n2/3)より小さい指数です。一方、難しいグラフ族では少なくともΩ(√(n log n))回が必要だと示しています。
- 上限と下限の間にはまだ隔たりがあります。グラフを処理する計算や量子回路の実装費用は、この問い合わせ回数には含まれません。
「二つ見つかる」と「隣同士が見つかる」の違い
点を頂点、点どうしのつながりを辺と呼びます。ここでは、向きのない辺で結ばれたグラフがあらかじめ与えられています。未知なのは各頂点の0または1という値で、1を「印あり」と読みます。調べたい条件は、ある辺の両端がともに1になっていることです。
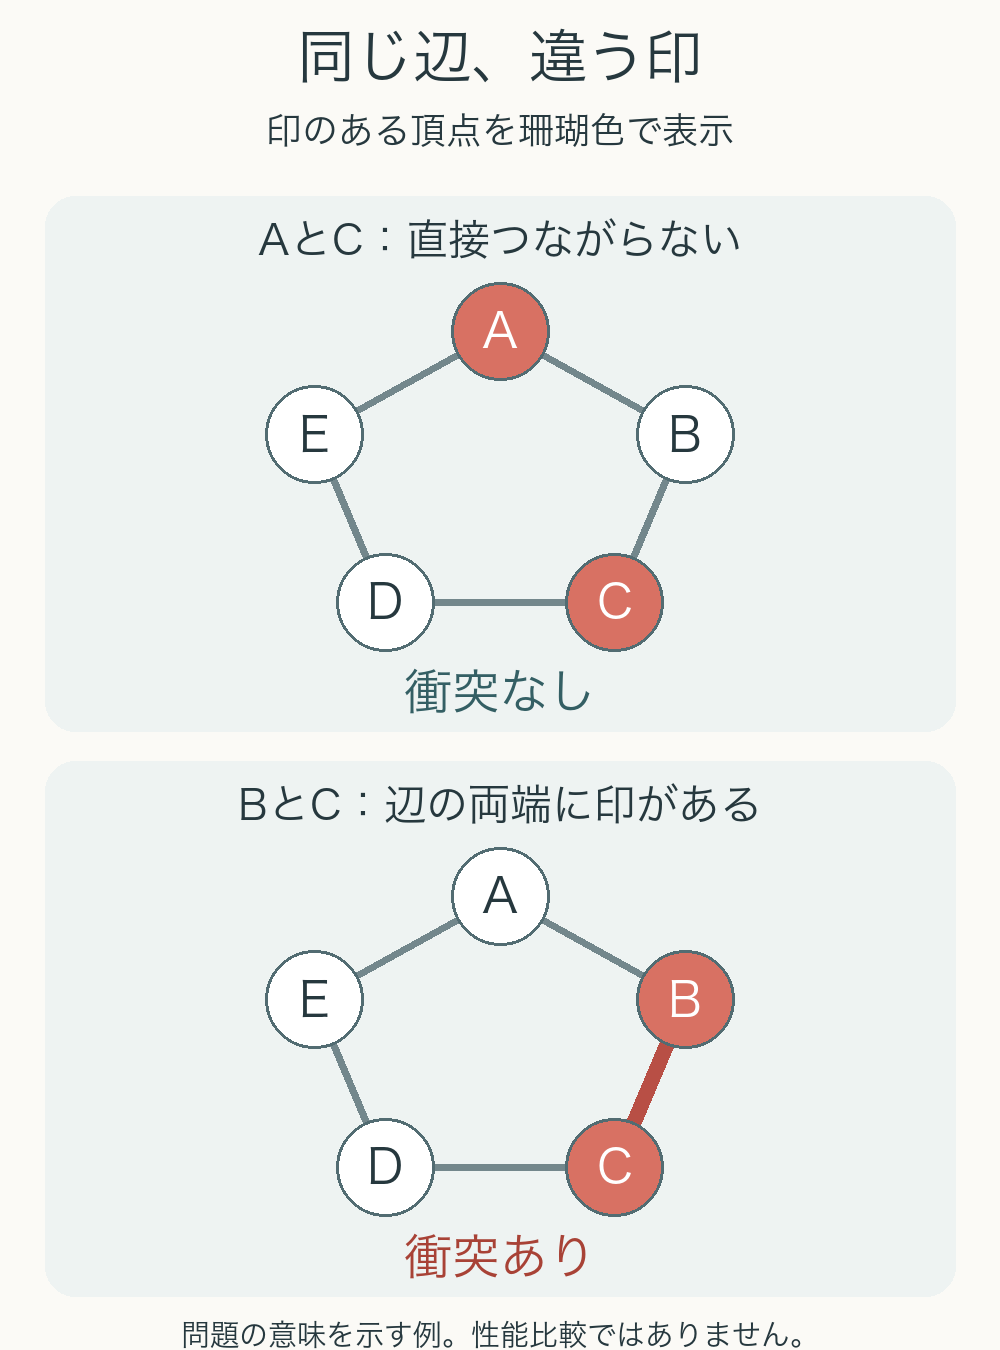
例えば、A、B、C、D、Eが輪になってつながっているとします。AとCに印があっても、この二点は直接つながっていないので答えは「なし」です。BとCに印があれば、辺BCがあるため「あり」になります。この小さな例は問題の意味を示すもので、論文の新しい計算量を実証する例ではありません。
問いに対する「あり」の証拠が二頂点で足りることを、計算量の言葉では小さな正の証明書があるといいます。証拠を確認する容易さと、証拠を見つける容易さは同じではありません。この違いが、今回の研究の出発点です。
量子クエリが数えているもの
論文で数えるのは、未知の入力値を与える仕組みへの問い合わせ、つまりクエリです。量子アルゴリズムでは、頂点の番号を重ね合わせた状態に対して、この入力の仕組みを量子的に呼び出せると仮定します。一度の呼び出しから全頂点の値を読み出せるという意味ではありません。
このモデルでは、既知のグラフを調べる計算は無料として扱います。例えば、どの二頂点が何個の共通の隣接点を持つかを計算しても、未知の0/1を新たに尋ねなければクエリ数は増えません。反対に、現実の装置では、こうした情報を準備する時間や量子回路を動かす費用も必要です。クエリ数の改善から、そのまま実行時間の短縮率を出すことはできません。
どこまで減らせて、どこから減らせないのか
nを頂点数とすると、任意のグラフを扱う従来の量子アルゴリズムにはO(n2/3)という上限が知られていました。新論文では、まずÕ(n92/139)を得てから、手法を改良してÕ(n11/17)へ進めています。11/17は約0.6471で、2/3の約0.6667を下回ります。
| 比較する量 | 論文が示す位置 | 読み方 |
|---|---|---|
| 任意のグラフに使える上限 | Õ(n11/17) | このオーダーの問い合わせで解く手順がある |
| 難しいグラフ族での下限 | Ω(√(n log n)) | どの量子手順でも、一定の正答率を満たすにはこのオーダーが必要 |
| 今も残る隔たり | 下限と上限は一致しない | 任意のグラフに対する最良の回数はまだ確定していない |
Oは増え方の上側、Ωは下側を表す記号です。Õの波線は、log nの多項式因子を省いていることを表します。論文は各入力について誤り確率を3分の1以下にする計算量を基準とし、繰り返しによってさらに高い正答率にできます。このため、指数だけを使って有限サイズでの速度差を見積もると、隠れた定数や対数因子を取り落とします。
下限の√(n log n)には、log nも平方根の内側に入ります。この結果は、任意のグラフをO(√n)回で解ける可能性を退けます。一方、対数因子を許したÕ(√n)まで退けたわけではありません。ここを分けて読むと、二つの結果がどこまで問題を狭めたのかが分かります。
全ての印を知る代わりに、隣の印の数を推定する
上限を改善する中心的な工夫は、各頂点の周囲に印付きの頂点がいくつあるかを推定することです。もしこの数が正確に分かれば、「印付きの隣がある頂点」の中から、その頂点自身にも印があるものを量子探索すればよくなります。ただし、全ての数を正確に求めていては、問い合わせを減らせません。
そこで研究者らは、一部の入力値をサンプリングし、既知のグラフ構造を使って近隣の数をまとめて推定します。推定結果がばらばらにならないよう、一つの頂点集合から生じる近隣の数として整合させる点も特徴です。この集合が、本当の印付き頂点の集合と一致する必要はありません。次の探索に使う近隣の数の誤差を抑えることが目的です。
推定した数が小さい頂点を集めた部分と、その外に触れる辺を分けると、異なる理由で探索の負担を抑えられます。特に「衝突なし」の入力では、印付きの頂点の隣には印がありません。それなのに隣の印を多く見積もった頂点がたくさんあれば、推定誤差が大きくなるはずです。誤差の上限を使うことで、そうした頂点が多くは存在できないと分かります。
改良版は、辺を多く持つ頂点の処理と、残ったグラフの段階的な絞り込みを組み合わせます。印付き頂点につながる辺の総数を抑え、推定と検査を繰り返すことで、最後の探索を軽くします。途中で除く辺も先に検査するため、単に調べる対象を捨てて正答率を上げているわけではありません。
下限は「探しにくい入力」を作って示す
下限の証明では、有限体という有限個の数の体系上の点と直線から、特殊な二部グラフを作ります。点と直線をそれぞれ頂点とし、点がその直線上にあるときに辺で結びます。衝突のない印の配置から、一つの直線とその上の点の印だけを変更し、衝突する辺がちょうど一本ある配置を作るのが基本の構成です。
この二種類の入力を見分ける難しさを、負の重みも許す一般敵対者法(general adversary method)で評価しています。正の重みだけを使う従来の方法では、二頂点で確認できるという証明書の小ささが障害になり、O(√n)を超える下限を示せませんでした。今回の下限は、問題の難しさだけでなく、それを証明する方法の限界を越えた結果でもあります。
実装を判断するには、まだ別の費用を見る必要がある
今回の前進は、既知のネットワークと未知の印を分けたモデルで、量子アルゴリズムの可能性を絞り込んだことにあります。小さな証拠を探す問題でも、ネットワークの構造をまとめて利用すると、問い合わせ回数の見通しが変わると分かります。
実際の用途へ進むには、入力を量子的に問い合わせられる形へ準備する方法、既知のグラフを処理する計算、必要な量子ビット数や回路の深さも評価する必要があります。論文には集合上の最小化など、クエリ以外の計算が重くなり得る処理も含まれます。査読前の理論結果として、回数の上限が改善したことと、実機で有利に動くことを分けて見るのが適切です。