粒子加速器で陽子同士を衝突させると、細い束になった粒子の流れ「ジェット」が生まれます。その出発点がボトム(b、ビューティー)クォークだったのか、チャーム(c)クォークだったのかを見分けることは、素粒子の性質を調べる手がかりになります。ただ、両者が残す崩壊の跡は似ており、単純な条件だけでは分けにくい問題です。
2026年11月12日に公開された研究では、この分類を、IQM製の5量子ビット装置「Lagrange」で学習から評価まで試しました。実機に合わせた最終構成で使ったのは4量子ビット。LHCb実験のシミュレーションデータを入力し、量子回路を繰り返し動かす学習を、43分のQPU使用時間で実行しています。量子計算の優位性を示した段階ではありませんが、限られた実機時間で学習を成立させる設計と、その限界が具体的に見える報告です。
簡単にまとめると?
- IQMのLagrange上で、4量子ビットの変分量子分類器を学習・評価。損失の計算やパラメータ更新は通常のCPUが担当します。
- 入力数・回路層数・測定回数・学習件数を減らし、性能との兼ね合いを見ながらQPU時間を抑えました。
- 実機のAUCは0.761。対応するシミュレーションに近い値ですが、最先端の古典的分類器を上回る実証ではありません。
粒子の崩壊の跡を、量子回路への入力にする
bやcを含む粒子は、陽子が衝突した点から少し離れた場所で崩壊します。研究では、そこで複数の粒子の飛跡が集まる「二次頂点」に着目しました。二次頂点に由来する質量、その補正値、ジェット全体に対する横方向の運動量の割合などを使い、b由来とc由来を区別します。
元データは、LHCbのRun 2に相当する13 TeVの陽子衝突と検出器応答を模擬した公開データです。実際の衝突観測データを量子装置で解析した、という報告ではありません。また、二次頂点などの条件で選んだジェットが対象で、あらゆる粒子の流れをそのまま二分類しているわけでもありません。
今回の入力方式は角度埋込みです。一つの特徴量を一つの量子ビットの回転角に対応させます。まず学習用データだけから平均とばらつきを求めて値をそろえ、回転角へ変換します。同じ変換を評価用データにも適用するため、評価データの情報を前処理の学習に混ぜません。この方式では、使える量子ビット数が、そのまま一度に渡せる特徴量の数を制約します。
「実機で学習」の中で、量子装置とCPUは何をするか
変分量子分類器(VQC)は、入力を受け取る量子回路に、調整できる回転ゲートや量子ビット同士を結ぶゲートを重ねたモデルです。回路を何度も実行して測定結果を平均し、分類のスコアにします。一回の測定で、確定した答えが得られる仕組みではありません。
CPUはスコアと正解の違いから損失を計算し、回路のパラメータを更新します。更新の方向を知るために、各パラメータを正負にずらした回路も評価します。これは「パラメータシフト則」と呼ばれ、学習項目やパラメータが増えるほど、実機を呼ぶ回数が増えます。
したがって本研究の「学習から評価まで実機で実行」は、学習中も評価中も量子回路の計算をLagrangeで行った、という意味です。入力の前処理、損失計算、最適化まで量子装置だけで済ませたわけではありません。実機の雑音がスコアをずらしても、その結果を含めてCPUが更新するため、雑音のある装置に合ったパラメータへ調整できる可能性があります。ただし、学習中に雑音の傾向が変わる場合まで補償できるとは限りません。
精度を少し譲って、実行回数を大きく減らす
研究チームは、まず装置雑音を入れないシミュレーションで構成を比較しました。このシミュレーションでも、有限回の測定に相当する統計的な揺らぎは残します。比較の指標はROC曲線の面積、AUCです。分類のしきい値を動かしたとき、二つの種類をどの程度区別できるかを表し、ここでは大きいほど良好です。AUC 0.76を「正答率76%」と読み替えることはできません。
| 項目 | 基準構成 | 実機向け構成 |
|---|---|---|
| 入力/量子ビット | 5特徴/5個 | 4特徴/4個 |
| 変分層 | 2層 | 1層 |
| 1回の回路評価の測定数 | 1,024回 | 256回 |
| 学習用ジェット数 | 1,000 | 100 |
| シミュレーションのAUC | 0.826 ± 0.013 | 0.763 ± 0.015 |
| 学習のQPU時間見積り | 4,700分 | 48分 |
両構成とも学習は10周、評価には別の1,000ジェットを使います。原論文のTable 1から主要条件を抜き出した比較です。AUCの相対低下は約7.5%ですが、指標をGini係数に変えると相対低下は約19%になります。「性能をほぼ保った」という表現も、どの指標を使うかで印象が変わります。
4,700分から48分への短縮は、同じ分類器を単に高速化した結果ではありません。入力や学習データ、回路、測定回数を減らした別構成の見積りです。一回のゲート動作だけを速くするより、学習全体で何回の回路評価が必要かを見直す効果が大きかったと読めます。
雑音のある実機でもAUCは近かった
実機向け構成をLagrangeで学習した結果、AUCは0.761でした。対応するシミュレーションの0.763 ± 0.015に近く、学習の損失も回数とともに下がっています。一方で、個々のスコアの分布やROC曲線の形まで同じではありません。
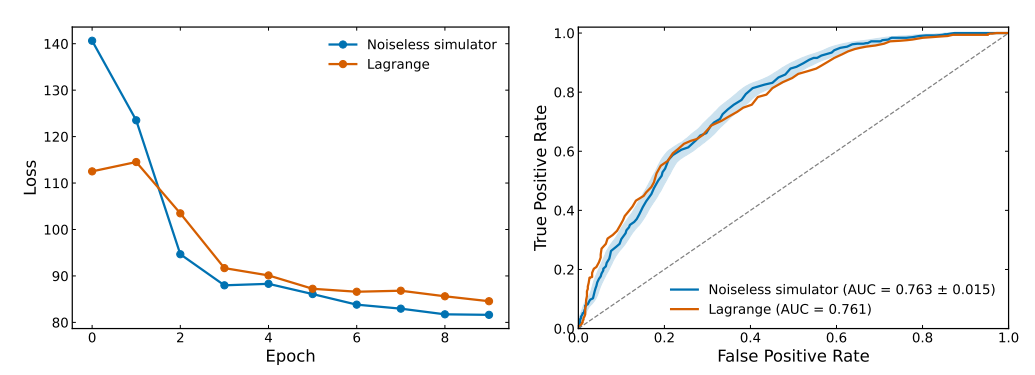
実測した学習のQPU使用時間は43分で、48分という見積りとの差は約10%でした。ただしQPU時間は、装置が量子回路を実行するために使われた時間です。待ち行列、通信、前後処理を含む利用者の総待ち時間とは異なります。本研究でもQPU時間は経過時間の約20〜50%で、一定倍率で換算できる関係ではありません。
また、実験は二回の校正の間にまとめて実行され、読み出し誤りの軽減やゼロノイズ外挿といった追加の処理は使っていません。この条件の小さな回路で得た結果を、長時間の運用や大規模な回路全体の雑音耐性へ広げることはできません。
次の比較で見るべきもの
今回の到達点は、限られた実機時間の中で、分類問題の学習と評価を最後まで回せたことです。小さな古典ニューラルネットワークとの比較もありますが、量子側はシミュレーションでの評価で、古典側の初期値によるばらつきを考慮すると、量子方式の優越性は結論できません。多数の特徴量を使う最新のジェット分類器に勝った、という結果でもありません。
大きなモデルへ進むときは、量子ビット数だけでなく、入力情報を何個保つか、学習件数をどこまで増やすか、勾配の推定に何回実機を呼ぶかが効いてきます。論文が示す大規模化の時間予測は、Lagrangeで測った関係を引き延ばした試算です。より大きな装置で同じ精度や学習時間が実証されたものではありません。
この研究はEPJ Quantum Technologyへの投稿中のプレプリントです。公開データを使う一方、結果を作成したコードは著者への合理的な請求により提供されると記載されており、公開リポジトリから自由に取得できる実装が示されたわけではありません。今後は実機の規模を増やすだけでなく、十分な古典手法との比較と、学習・評価条件をそろえた再現検証が重要になります。
実験に使われた量子プロセッサーの開発企業については、CyclewaveのIQMの事業と研究施設向け量子コンピューターの解説も参考になります。
出典
- Lucio Anderliniほか「Beauty and charm jet identification with end-to-end training on a superconducting quantum processor」、arXiv:2611.16607v1、2026年11月12日。本文§2〜5、Table 1、Figs.1〜11。論文PDF。