タグ: AIアクセラレーター

  • TenstorrentのTensixが計算とデータ転送を並行させる仕組み

    TenstorrentのTensixが計算とデータ転送を並行させる仕組み

    AIアクセラレーターは、計算器が速くても、必要なデータが届くまで計算を進められません。TenstorrentはOCP Korea Tech Day 2026の講演でSRAMとGDDR6を組み合わせる構成を紹介しています。その内側で、データを運ぶ処理と計算をどう組み合わせるのか。公式のTT-Metalium文書をたどると、Tensixコアの役割分担が見えてきます。[1][2]

    簡単にまとめると?

    • TensixのL1 SRAMは、データの置き方をソフトウェアで決める作業領域です。
    • 読込み・計算・書込みを分担し、循環バッファを介して処理を重ねます。
    • 効果を判断するには、計算速度だけでなく、データ量・配置・転送の待ち時間も見る必要があります。

    SRAMは計算の手元に置く作業領域

    Tensixは、行列やベクトルを処理する演算器と、近くにあるSRAMなどを組み合わせたコアです。ホストのCPU側からデータをデバイスのDRAMへ渡し、Tensixは必要な部分をSRAMへ運んで計算します。DRAMや他のコアとの移動には、チップ内ネットワークであるNoCを使います。[2]

    このSRAMはL1とも呼ばれますが、CPUでよく使われる、データを自動的に出し入れするキャッシュとは役割が異なります。TT-Metaliumでは、どのデータをどこへ運ぶかを明示します。小さく区切ったデータを手元に置き、次の演算へ渡せるように準備する場所です。[2]

    読み込み・計算・書き戻しを分担する

    たとえば、二つの配列の対応する値を足す処理を考えます。公式教材は、このような要素ごとの加算を使って、三種類のカーネルを説明しています。カーネルとは、ここではデバイス上で担当する処理を記したプログラムです。[2]

    Readerは二つの入力をDRAMから読み、SRAM上のバッファへ置きます。Computeは準備された入力を受け取って加算し、結果を別のバッファへ渡します。Writerは結果を受け取り、出力先へ書き戻します。[2]
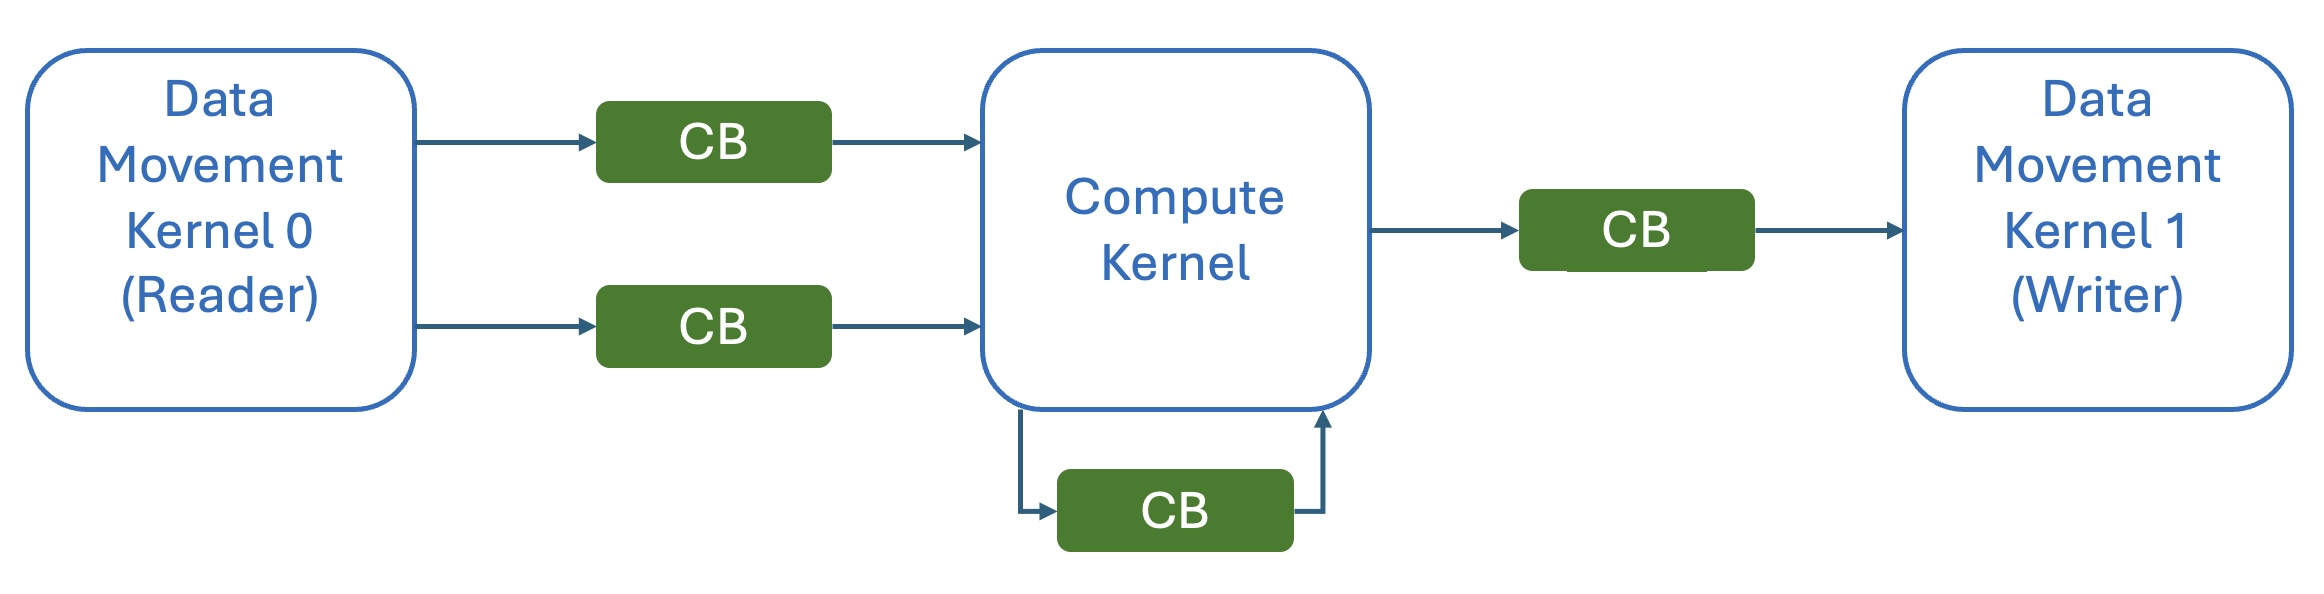
    Readerから二つの循環バッファを経てComputeへ入力が渡り、計算結果が別の循環バッファを経てWriterへ渡る。Compute自身へ戻るバッファも描かれている。
    図1 循環バッファ(CB)を介したデータの受け渡し。Tenstorrent「Lab 1: Single Core Matrix Multiplication」Fig. 4、原図。CC BY 4.0。JPEGからPNGへ形式変換、内容は無改変。図を拡大する

    CBはCircular Buffer、循環バッファの略です。データを受け取った順に処理し、使い終わった場所を再利用します。Readerが次の小片を用意する間に、Computeは一つ前の小片を計算できます。計算済みの結果はWriterへ渡せるため、全データの読込みが終わるまで計算を待つ構成にする必要はありません。これが処理を重ねるパイプラインです。[3]

    ただし、役割を分ければ待ち時間がなくなるわけではありません。Computeは入力がそろうまで待ち、Writerも結果ができるまで待ちます。さらに、バッファは全データを収める大きな箱ではなく、少数の小片を置く有限の領域です。書く前に空きを確保し、読み終えた場所を解放します。[2]

    たとえばWriterの書き戻しが遅く、出力バッファが埋まると、Computeも次の結果を置けずに待ちます。その状態が続けば、入力側の消費も進まずReaderまで空き待ちになります。データの到着だけでなく、次の受け渡し先に空きがあるかも、流れを左右するのです。[2]

    容量を増やすだけでは決まらない

    SRAMは頻繁に使う中間データを置く候補になりますが、容量には限りがあります。また、多くのコアが同じNoCの経路を同時に使えば、転送が競合します。公式のメモリー文書も、データの配置は処理内容とアクセスの仕方に依存するとしています。[4]

    そのため、導入を考える際には、ひとまとまりの入力がどれだけあるか、同じデータを何度使うか、どのコアへ渡すかを分けて見ると役立ちます。手元のSRAMを使う設計でも、データの置き方が合わなければ、転送の待ちを十分に減らせるとは限りません。[4]

    TT-Metaliumはこうした低い層の制御を担います。上位には、よく使う機械学習の演算を提供し、カーネルを自動選択するTTNNがあります。利用者全員がReaderなどを直接書く、という意味ではありません。[3]

    この仕組みから分かるのは、Tensixが計算と転送をどう組み合わせるかです。特定のAIモデルの速度や費用まで、この構造だけで決まるわけではありません。モデルの対応状況、数値形式、入力の長さ、ホストとの転送を含む測定範囲をそろえて、用途に合うかを確かめる必要があります。

    参考資料

    1. Hyunggi Chang(Tenstorrent)「Accelerating Industrial AI Transformation with Ultra-Fast AI Inference on Tenstorrent AI Accelerators」、OCP Korea Tech Day 2026。公式講演一覧/講演資料、14頁。
    2. Tenstorrent「Lab 1: Single Core Matrix Multiplication」、Introduction to Tenstorrent Architecture/Kernel Types and Data Flow。図の利用条件はtutorial-assets LICENSE。
    3. Tenstorrent「TT-Metalium Getting Started」、Key Concepts/Software Stack Overview/Next Steps。
    4. Tenstorrent「Memory from a kernel developer’s perspective」、Memory placement/SRAM buffers/Sharded tensor。公式ウェブ文書は2026年10月10日取得版。
  • MicrosoftのMaia・Cobalt・Boost DPU、AI処理を支える三つの役割

    MicrosoftのMaia・Cobalt・Boost DPU、AI処理を支える三つの役割

    たとえば、AIが必要なデータを探し、外部の処理を呼び出し、その結果を使って答えを作るとします。モデルの推論を速くするだけでなく、データを取り出す処理や、次の仕事へ進める処理にも時間がかかります。AI基盤を考えるときは、どの計算器が速いかと一緒に、どの仕事をどこへ任せるかを見る必要があります。

    2026 OCP APAC Summitの公式一覧に掲載されたMicrosoftの資料は、半導体からサーバー、ネットワーク、データセンターまでを一緒に設計する考え方を示しています。その中から、推論向けのMaia 200、CPUのCobalt 200、データ処理向けのBoost DPUという、役割の異なる三つに注目します。[1・2]

    簡単にまとめると?

    • Microsoftは、推論・CPU処理・データ入出力を、役割の異なる半導体へ分担する設計を示しています。
    • Boost DPUは、ストレージやネットワークの基盤処理をホストCPUから引き受けます。
    • 三つの性能指標は対象が異なり、改善率を組み合わせてサービス全体の高速化とは評価できません。

    AIの処理が変わると、待ち時間の場所も変わる

    資料は「ボトルネックは移り続ける」という見出しで、モデルの規模、計算能力、メモリー、ストレージを並べています。モデルを動かすには演算だけでなく、必要なデータを保持し、読み書きする能力も要るからです。グラフは異なる指標の伸びを2019年基準で示したもので、線同士の差を、そのまま実際の処理時間の差として読むことはできません。[1]

    さらに資料は、AIエージェントの処理を背景に、CPUとGPUの役割へ目を向けています。たとえば、複数の処理を進める順番や結果の受け渡しを整える時間が長ければ、推論部分だけを速くしても、全体の待ち時間は同じ割合では短くなりません。どこが処理の進行を妨げているかによって、強化したい部分も変わります。

    Maia、Cobalt、Boost DPUで見る三つの役割

    Microsoftは、対象となる処理に応じて自社の半導体を紹介しています。資料と同社の補足記事に沿うと、役割は次のように整理できます。これは製品群の役割分担であり、三つを同じサーバーへ搭載する配線図ではありません。[1・3]

    半導体資料で示す主な対象注目する点
    Maia 200AIモデルの推論処理するモデルとチップを合わせて設計し、費用や電力あたりの推論処理を考える
    Cobalt 200クラウド向けのCPU処理、AIエージェントに関わる処理複数の仕事の並行処理と進行管理、呼び出しの待ち時間を考える
    Boost DPUストレージやネットワークの基盤処理ホストCPUから専用の半導体へ処理を移す

    Maia 200は、推論を担うアクセラレーターとして位置づけられています。資料が挙げるのは、チップとモデルの協調設計です。チップ単体の演算能力だけで評価を終えず、動かすモデルと組み合わせて、電力や費用に対してどれだけ推論を進められるかを見ます。[1]

    Cobalt 200はCPUです。補足記事では、並行処理や、複数の処理の進行をまとめるオーケストレーションに向けた設計と説明されています。モデルの推論を担う部分と、仕事を進めるCPU側の処理を分けて考えると、AI基盤に求める性能を捉えやすくなります。[1・3]

    Boost DPUは、CPUが担っていた基盤処理を引き受ける

    DPU(Data Processing Unit)は、ここではデータの入出力に関わる処理を受け持つ専用プロセッサーです。MicrosoftはBoost DPUについて、ストレージやネットワークの基盤処理をホストCPUから移す、オフロードの役割を説明しています。OCP資料でも、クラウドのストレージ処理が主な対象として挙がっています。[1・3]

    この役割は、アプリケーションの計算を速くすることとは分けて考えられます。たとえば、CPUがアプリケーションとデータ入出力の両方を担っているなら、入出力側の仕事を別の処理器へ移すことで、CPUに任せる仕事の範囲が変わります。ここでいうI/Oは、データの入力と出力のことです。効果を見る際には、移した処理の速さだけでなく、CPU側と合わせた待ち時間や消費電力を確認します。

    違う性能指標を、一つの倍率にまとめない

    資料に出てくる性能指標も、三つで異なります。Maia 200では費用・電力あたりの推論性能、Cobalt 200ではエージェント呼び出しの遅延や一定時間に処理できる量、Boost DPUではストレージ処理の性能と電力です。対象の仕事が違うため、それぞれの改善率を足したり掛けたりして、AIサービス全体の高速化を求めることはできません。[1]

    掲載スライドだけでは、比較した構成や測定条件の詳細までは分かりません。この記事では改善率を一般的な性能値として使わず、何を測る指標なのかに注目しています。推論の処理量、呼び出しの待ち時間、入出力の負荷を分けて見ることで、必要な改善を選びやすくなります。

    処理の分担を、サーバーと施設の設計へつなぐ

    資料の全体図では、半導体、プラットフォーム、ネットワーク、データセンターの協調設計を重ね、その周囲にセキュリティと持続可能性を置いています。処理を専用化する方針を、部品一つの効率で終わらせず、組み合わせたシステムとして考える構成です。電力や冷却も同じ資料で扱われています。[1]

    AI基盤を選ぶときは、「最も速いチップはどれか」に加え、「推論、CPU処理、データ入出力のどこに時間を使っているか」を確かめる。Maia、Cobalt、Boost DPUの役割を並べると、専用の半導体を作る意味が、仕事の分担として見えてきます。その分担をソフトウェアやサーバー構成までつなげることが、今回の資料を読む一つの軸になります。

    Microsoftの事業を知る

    Azureを含むMicrosoft全体の事業は、cyclewaveの企業解説にまとめています。

    参考資料

    公式一覧から公開された18ページのPDFと、Microsoftの補足記事をもとに構成しました。PDFの作成日は2026年9月8日です。開催当日の版との同一性は未確認のため、公開資料に示された設計として紹介しています。

    [1]Gohar Waqar、Sushant Gupta(Microsoft)「From Silicon to Systems: Driving Innovation for Azure Compute & AI」。8ページ:処理の制約、10–14ページ:全体設計と各半導体の役割・評価指標、15–18ページ:セキュリティ、電力・冷却、ネットワーク、協調設計。

    [2]Open Compute Project「2026 OCP APAC Summit」。講演と公開資料の公式案内。

    [3]Microsoft「From Silicon to Systems: Bending the Cost and Complexity Curves of AI」(2026年8月)。Cobaltの並行処理・オーケストレーションと、Boost DPUへの基盤処理のオフロードを補足。