AIアクセラレーターは、計算器が速くても、必要なデータが届くまで計算を進められません。TenstorrentはOCP Korea Tech Day 2026の講演でSRAMとGDDR6を組み合わせる構成を紹介しています。その内側で、データを運ぶ処理と計算をどう組み合わせるのか。公式のTT-Metalium文書をたどると、Tensixコアの役割分担が見えてきます。[1][2]
簡単にまとめると?
- TensixのL1 SRAMは、データの置き方をソフトウェアで決める作業領域です。
- 読込み・計算・書込みを分担し、循環バッファを介して処理を重ねます。
- 効果を判断するには、計算速度だけでなく、データ量・配置・転送の待ち時間も見る必要があります。
SRAMは計算の手元に置く作業領域
Tensixは、行列やベクトルを処理する演算器と、近くにあるSRAMなどを組み合わせたコアです。ホストのCPU側からデータをデバイスのDRAMへ渡し、Tensixは必要な部分をSRAMへ運んで計算します。DRAMや他のコアとの移動には、チップ内ネットワークであるNoCを使います。[2]
このSRAMはL1とも呼ばれますが、CPUでよく使われる、データを自動的に出し入れするキャッシュとは役割が異なります。TT-Metaliumでは、どのデータをどこへ運ぶかを明示します。小さく区切ったデータを手元に置き、次の演算へ渡せるように準備する場所です。[2]
読み込み・計算・書き戻しを分担する
たとえば、二つの配列の対応する値を足す処理を考えます。公式教材は、このような要素ごとの加算を使って、三種類のカーネルを説明しています。カーネルとは、ここではデバイス上で担当する処理を記したプログラムです。[2]
Readerは二つの入力をDRAMから読み、SRAM上のバッファへ置きます。Computeは準備された入力を受け取って加算し、結果を別のバッファへ渡します。Writerは結果を受け取り、出力先へ書き戻します。[2]
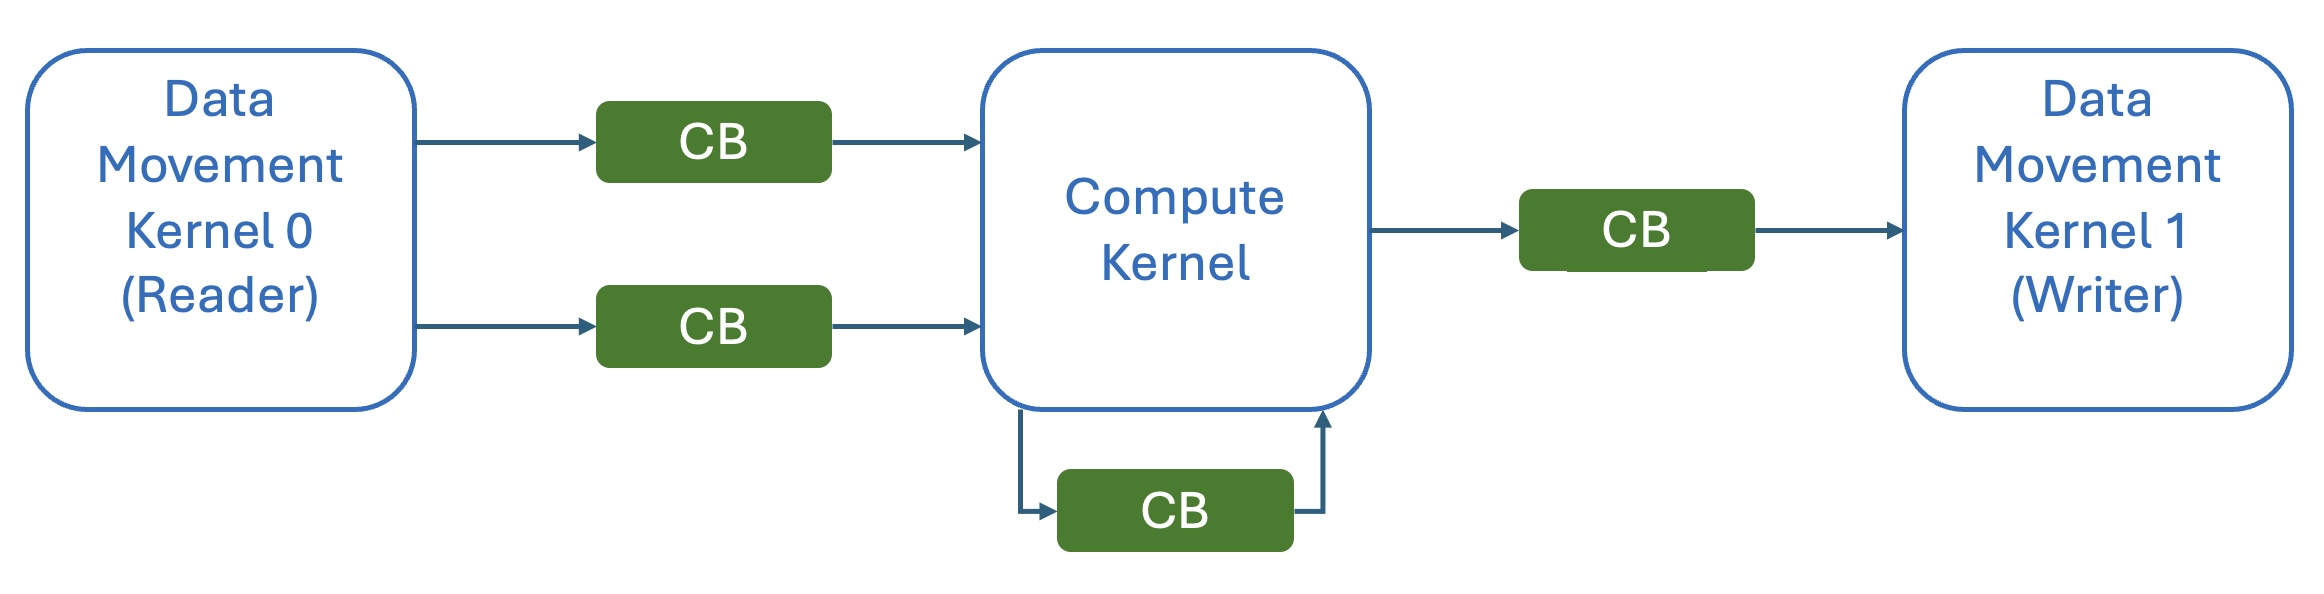

CBはCircular Buffer、循環バッファの略です。データを受け取った順に処理し、使い終わった場所を再利用します。Readerが次の小片を用意する間に、Computeは一つ前の小片を計算できます。計算済みの結果はWriterへ渡せるため、全データの読込みが終わるまで計算を待つ構成にする必要はありません。これが処理を重ねるパイプラインです。[3]
ただし、役割を分ければ待ち時間がなくなるわけではありません。Computeは入力がそろうまで待ち、Writerも結果ができるまで待ちます。さらに、バッファは全データを収める大きな箱ではなく、少数の小片を置く有限の領域です。書く前に空きを確保し、読み終えた場所を解放します。[2]
たとえばWriterの書き戻しが遅く、出力バッファが埋まると、Computeも次の結果を置けずに待ちます。その状態が続けば、入力側の消費も進まずReaderまで空き待ちになります。データの到着だけでなく、次の受け渡し先に空きがあるかも、流れを左右するのです。[2]
容量を増やすだけでは決まらない
SRAMは頻繁に使う中間データを置く候補になりますが、容量には限りがあります。また、多くのコアが同じNoCの経路を同時に使えば、転送が競合します。公式のメモリー文書も、データの配置は処理内容とアクセスの仕方に依存するとしています。[4]
そのため、導入を考える際には、ひとまとまりの入力がどれだけあるか、同じデータを何度使うか、どのコアへ渡すかを分けて見ると役立ちます。手元のSRAMを使う設計でも、データの置き方が合わなければ、転送の待ちを十分に減らせるとは限りません。[4]
TT-Metaliumはこうした低い層の制御を担います。上位には、よく使う機械学習の演算を提供し、カーネルを自動選択するTTNNがあります。利用者全員がReaderなどを直接書く、という意味ではありません。[3]
この仕組みから分かるのは、Tensixが計算と転送をどう組み合わせるかです。特定のAIモデルの速度や費用まで、この構造だけで決まるわけではありません。モデルの対応状況、数値形式、入力の長さ、ホストとの転送を含む測定範囲をそろえて、用途に合うかを確かめる必要があります。
参考資料
- Hyunggi Chang(Tenstorrent)「Accelerating Industrial AI Transformation with Ultra-Fast AI Inference on Tenstorrent AI Accelerators」、OCP Korea Tech Day 2026。公式講演一覧/講演資料、14頁。
- Tenstorrent「Lab 1: Single Core Matrix Multiplication」、Introduction to Tenstorrent Architecture/Kernel Types and Data Flow。図の利用条件はtutorial-assets LICENSE。
- Tenstorrent「TT-Metalium Getting Started」、Key Concepts/Software Stack Overview/Next Steps。
- Tenstorrent「Memory from a kernel developer’s perspective」、Memory placement/SRAM buffers/Sharded tensor。公式ウェブ文書は2026年10月10日取得版。