タグ: コンパイラー

  • 量子回路をデータベースで組み立てる、数十億ゲートを扱うPandora

    量子回路をデータベースで組み立てる、数十億ゲートを扱うPandora

    量子コンピューターで大きな問題を解くには、その前段階で、膨大な計算手順を普通のコンピューター上で組み立てる必要があります。アールト大学の研究チームが開発したPandoraは、この準備をデータベースに担わせる量子回路の書き換えエンジンです。2026年10月30日にnpj Quantum Informationで早期公開された論文では、数十億個の量子ゲートを含む回路の構築や分割を報告しています。

    簡単にまとめると?

    • 量子回路の各操作をデータベースの行として保存し、条件に合う部分を検索して書き換えます。
    • 大量の回路を小分けに取り込み、複数の処理を並行して動かすことで、メモリーと検索時間の負担を抑えます。
    • 成果は量子計算の準備を行うソフトウェアの性能です。約77億ゲートの回路を扱ったことと、量子コンピューターでその計算を実行したことは区別する必要があります。

    計算を始める前に、計算手順が大きくなる

    量子回路は、量子ビットに加える操作を並べたものです。一つ一つの操作を量子ゲートと呼びます。アルゴリズムを説明する段階では「足し算」や「掛け算」とひとまとめにできても、装置で使える基本操作へ分解すると、ゲートの数は大きく増えます。

    たとえば、足し算を何度も使う計算では、同じ形の小回路が繰り返し現れます。その小回路を一度作って保存しておけば、毎回最初から分解し直す負担を減らせます。一方で、組み上がった巨大な回路から不要な操作を探すときは、目的の組み合わせを見つけるだけでも時間がかかります。

    Pandoraが扱うのは、この保存、検索、置換、分割といった作業です。量子状態そのものをデータベースに保存するわけではありません。量子コンピューターへ渡す操作の記述を、古典コンピューター上で管理します。

    量子ゲートを一行ずつ保存する

    一般的な回路処理では、操作同士を結んだグラフなどをメモリー上に置きます。Pandoraも操作の前後関係を保ちますが、その情報を関係データベースの表へ移します。論文の実装はPostgreSQL 14を使い、ゲートの種類やパラメーター、同じ量子ビット上で前後にあるゲートへの参照を各行に記録します。

    単に表の上から順番に操作する仕組みではありません。前後への参照をたどって回路を復元できるため、データベース内で行が並ぶ順序と、量子回路の操作順序を分けられます。複雑な操作を基本ゲートへ分解するときは、対応する行を複数の行に置き換え、周囲とのつながりも更新します。

    書き換えの一例は、同じ向きに連続する二つのCNOTゲートを打ち消す操作です。CNOTは、片方の量子ビットの状態に応じて、もう片方を反転させるゲートです。同じ組に対して同じ操作を続けて二回行えば元へ戻るので、その部分を取り除けます。ただし、間に別の作用がある場合まで無条件に消せるわけではありません。ゲートの種類と接続関係を確認する検索が必要です。

    並列化だけでなく、探す時間を減らす

    研究チームは、書き換えにかかる時間を、候補を探す時間、実際に変更する時間、並列処理を調整する時間に分けています。変更できる場所が少ない回路では、ほとんどの時間を「消せる場所がないか」と探すことに費やしかねません。

    データベースの索引は、条件に合う行へ到達するための手掛かりです。Pandoraはこの検索機構を使い、ゲートの種類などの条件から候補を絞ります。比較実験では、1万を超えるCNOTゲートを含む人工回路で、特定の書き換え対象が少ない場合に、QiskitやTKETより速い処理を示しました。この結果は、その回路と書き換え規則での比較です。あらゆる量子アルゴリズムで同じ差が出ることを示したものではありません。

    複数の処理が同じゲートを同時に変更すると、接続情報が食い違うおそれがあります。そこで、対象となる行をロックし、一まとまりの変更をトランザクションとして実行します。検索、ロック、変更の設計をデータベースの機能と組み合わせることで、並列の書き換えを支えます。データベースを使うだけで任意の書き換えが正しくなるわけではなく、回路の等価性を保つ規則と、適切なロック範囲が必要です。
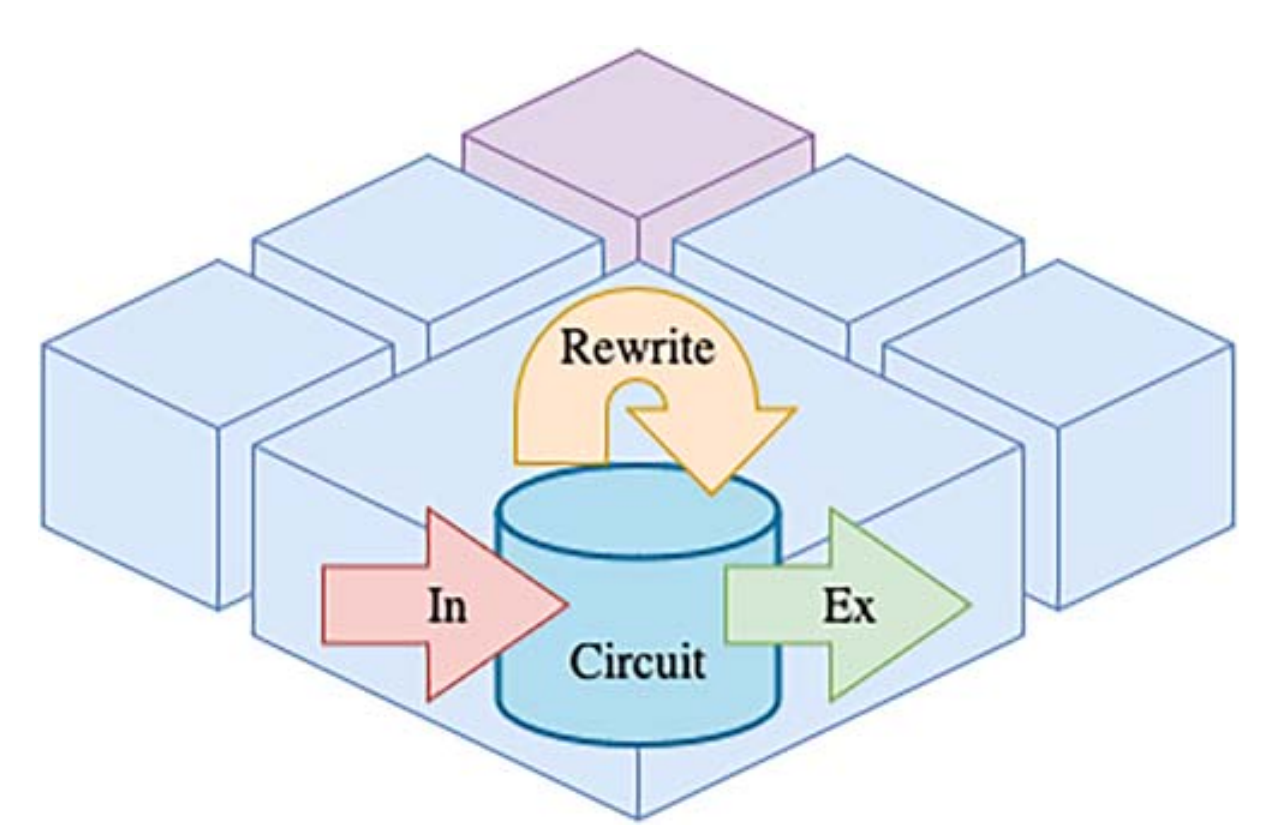
    青い処理用と紫の制御用コンテナーを並べ、回路の取り込み、書き換え、取り出しを示すPandoraの構成図。
    Pandoraの構成。青い箱は回路を処理する独立したコンテナー、紫の箱はその実行を制御します。Inは取り込み、Rewriteは書き換え、Exは取り出しです。Moflic and Paler, npj Quantum Information, Article in Press(2026年10月30日), Fig. 6, DOI: 10.1038/s41534-026-01402-z, CC BY 4.0。PDFから図を抜き出してPNGへ形式変換。図中の内容変更なし。画像を押すと拡大できます。

    約77億ゲートは、どの段階の数字か

    論文では、電子の相互作用を考えるフェルミ・ハバード模型の100×100の問題から、約77億個のClifford+Tゲートを含む回路を構築しました。Clifford+Tは、量子計算の基本操作を表すゲート集合の一つです。この数値は、回路を基本操作へ分解した後の規模を示しています。

    別の50×50の例では約5億1400万ゲートを扱い、16コア使用時の保存速度として最大約27万ゲート毎秒を報告しています。一般のベンチマークには24コア、256GBメモリーの計算機を使い、大規模な構築や分割の実験にはLUMIスーパーコンピューターを使っています。個々の速度は、どの機械で、回路処理のどの工程を測ったものかと一緒に読む必要があります。

    大きな回路を一度にメモリーへ載せず、一定数のゲートをまとめたバッチごとに変換、取り込み、取り出しを行うことも特徴です。処理済みのバッチに使ったメモリーを解放し、次のバッチへ進みます。必要な保存領域が消えるわけではありませんが、回路全体の大きさが、そのまま一度に保持するメモリー量になる状況を避けられます。

    Shorのアルゴリズムについても、1024ビットの問題に対応する回路の構築を報告しています。ただし、論文で説明されるベンチマークには、算術部品をCNOT、Toffoli、CSWAP、一量子ビットのCliffordゲートへ分解して保存する工程が含まれます。フェルミ・ハバード模型のClifford+T回路とは分解先を分けて捉える必要があります。1024ビットの整数を量子コンピューターで実際に因数分解した報告ではありません。

    速い工程だけで、全体の速さは決まらない

    Pandoraは、保存した回路を小回路へ分け、外部へ順に渡すこともできます。小回路のゲート数や深さ、Tゲート数に上限を設ければ、計算資源の制約に合わせて区切れます。回路の深さは、同時に行える操作をまとめたときに必要な段数です。

    分割と取り出しは高速でも、その手前にある高水準のアルゴリズムの分解や、データベースへの取り込みが時間を使います。論文でも、pyLIQTRによる分解と取り込みが重い工程として残りました。回路をすでに保存して再利用する場合と、最初から作る場合では、全体の待ち時間が変わります。

    利用を検討するときは、回路の規模に加えて、書き換え対象がどれくらいあるか、同じ部品を再利用できるか、取り込みや取り出しが全体の何割を占めるかを比べると、方式の向き不向きが見えやすくなります。検索を短くしても、データを運ぶ時間や並列処理の調整時間が次の制約になり得ます。

    回路が正しいかを調べる実験にも、範囲がある

    書き換えの前後で計算内容が同じかを確認することも重要です。研究では、ランダムなCNOT回路をそのまま複製した場合と、そこからゲートを一つ取り除いた場合を比較しました。これは、書き換えに基づく等価性検査を高速化する可能性を調べる実験です。

    任意の量子回路を完全に判定する一般的な検査器を完成させたわけではありません。回路の構造や使える書き換え規則によって難しさが変わり、今回の比較には特に処理しやすい構造が含まれます。単一の量子ビット数を境に、すべての検査が速くなるとは読めません。

    Pandoraが示すのは、量子計算の準備にも、成熟したデータ管理技術を持ち込めるという方向です。量子ハードウェアの性能と、回路を用意する古典側の能力を分けて見ることで、大規模な量子計算へ向けて何が改善され、何が課題として残るのかを具体的に比べられます。

    出典

  • IBMのQiskit 2.6、C APIで量子回路の変換と保存を組み込む

    IBMのQiskit 2.6、C APIで量子回路の変換と保存を組み込む

    量子コンピューターで計算するときも、実機へ渡す回路を作り、装置に合う形へ変換する仕事は通常のコンピューターが担います。研究施設の計算システムにこの前処理を組み込むには、量子向けのソフトウェアを、すでに動いているプログラムから呼び出せることが大切です。

    2026年10月16日に公開されたQiskit 2.6では、C言語から利用する窓口であるC APIが拡充されました。IBMが10月22日に紹介した今回の変更では、回路を変換する手順を組み立てる機能と、回路をファイルへ保存・復元する機能が加わっています。高性能計算、HPCの処理の中へ量子回路の前処理を置きやすくする更新です。[1、2]

    簡単にまとめると?

    • Qiskit 2.6のC APIでは、回路の検査や変換を行う処理を、自分で選んで順番につなげられます。
    • 回路を保存するQPY形式にも対応しました。ただし、古いソフトで新しい形式を開けるとは限らず、Pythonに依存する内容にも制約があります。
    • 単独で使うC APIは実行時にPythonの処理系を起動しませんが、2.6ではPythonのインストール自体はまだ必要です。APIも実験段階です。

    装置へ渡す前の回路を、どこで整えるか

    量子回路は、量子ビットにどの操作をどの順番で施すかを表すものです。考えた通りの回路を、そのままどの装置でも実行できるわけではありません。装置が扱える基本操作や、量子ビット同士の接続に合わせて、回路を書き換える必要があります。この変換をトランスパイルと呼びます。

    Qiskitは、こうした回路の作成や変換に使うオープンソースの開発基盤です。Pythonから扱う方法に加えて、内部のRust実装をCから呼び出すAPIの整備が進んでいます。Cを呼べるC++などのプログラムからも利用できるため、既存の計算処理へ接続する選択肢になります。[1、3]

    たとえば、材料の状態を調べる計算で、通常のコンピューターが候補となる回路を何度も作り直す場面を考えてみます。これは利用方法を説明する仮想例です。回路の準備を既存のHPCプログラムから直接呼べれば、量子向けの処理だけを別のアプリケーションとして切り離さず、一連の計算手順として組み立てやすくなります。

    回路の変換手順を、自分で組み立てる

    従来のC APIでも、用意された変換手順を使うことはできました。2.6で加わったカスタム・パスマネージャーは、その中の処理をより細かく選ぶための仕組みです。パスとは、回路の状態を調べたり、回路を書き換えたりする一つの処理を指します。パスマネージャーが、それらを指定した順に実行します。[1、4]

    たとえば、回路の情報を調べる段階と、特定の基本操作へ変換する段階を分け、必要な処理を順に並べる、といった使い方です。用意された設定を選ぶだけで足りない研究や、独自の変換手順を比較したい開発では、この組み立て方が役立ちます。

    処理の途中では、回路をプログラムが扱いやすい内部の形にします。これが中間表現、IRです。C APIのパスマネージャーは、前の処理が出すIRの種類と、次の処理が受け取る種類が合うかを調べます。受け渡しの不一致を見つける仕組みであり、変換後の回路が特定の実機で高い精度を出せることまで保証するものではありません。[4]

    なお、C側のトランスパイラーが想定するのは、C APIで作られた回路です。Python側の機能を混ぜた回路をそのまま渡すと、十分な結果を得られない可能性があります。Pythonと組み合わせる場合はPython側の変換入口を使う、という境界も公式文書に示されています。[3]

    QPYで保存しても、読み手の版はそろえる

    回路を毎回作り直す代わりに、準備した回路を保存して次の処理へ渡したいこともあります。QPYはQiskitの回路を記録するバイナリー形式です。2.6ではC APIからも保存と読み込みを行えるようになり、対応する内容ならPython側との受け渡しにも使えます。[1、5]

    ただし、ファイルを渡すだけで、どの環境でも同じように開けるわけではありません。Qiskit 2.6の既定のQPY形式はバージョン18です。古いQiskitが新しい形式を読めるとは限らないため、受け取る側の対応版を先に確かめる必要があります。保存時に形式の版を選ぶ場合も、そのAPIが書き出せる範囲で選びます。[5、6]

    もう一つの境界は、保存する内容がPythonの処理系を必要とするかどうかです。C APIのQPY機能は、そのような内容を扱おうとするとエラーを返します。Python上で作れた回路や付随情報を、すべてそのままC側へ移せると考えるのは早計です。実際に使う回路の種類と付随情報で、保存・復元できる範囲を確かめることになります。[5]

    保存した回路を後から再利用するなら、QPYファイルに加えて、使ったQiskitの版や変換先の装置条件も記録しておくと、何を前提に準備した回路かを追いやすくなります。回路の保存と、実験環境や実機の測定結果まで含めた再現性は、分けて考える必要があります。

    Pythonを起動しないことと、不要になることの違い

    今回の変更を読むうえで紛らわしいのが、「Pythonなしで動く」という表現です。単独で使うC APIは、実行時にPythonインタープリターを起動しません。一方、2.6の内部にはPythonの型への依存が残り、プログラムをリンクするときに必要なシンボルをそろえるため、Pythonをインストールしておく必要があります。[1、3]

    つまり、実行中の処理をC側で進める道は広がりましたが、配備する環境からPythonを完全に取り除ける段階にはまだ達していません。IBMの紹介では依存を減らす今後の方針にも触れていますが、将来の予定を2.6で完了した機能とは扱えません。

    C API自体も実験段階です。組み込む側はQiskitの版を固定し、更新時には自分の変換手順と保存データを読み戻せるかを検証する必要があります。今回の意義は、量子回路の準備を既存の計算システムへ組み込むための部品が増えたことにあります。量子計算そのものの速度や精度が、この更新だけで向上したという発表ではありません。

    Qiskitを開発するIBMの事業や、量子計算への取り組みの位置づけは、CyclewaveのIBMの企業解説で紹介しています。

    参考資料

    1. IBM Quantum — Qiskit 2.6 release summary(2026年10月22日)。
    2. Qiskit — Release 2.6.0(2026年10月16日、commit 65094a0)。
    3. Qiskit 2.6.0 — C APIの構成と利用形態(リリース版ソース)。
    4. Qiskit 2.6.0 — C API PassManager(リリース版ソース)。
    5. Qiskit 2.6.0 — C API QPY(保存・読み込みと制約)。
    6. Qiskit 2.6.0 — QPY形式の版定義。資料確認:2026年10月27日。未固定の最新版文書ではなく、2.6.0の内容を参照しています。
  • OQDのデータフロー解析、変化した先だけを調べ直す仕組み

    OQDのデータフロー解析、変化した先だけを調べ直す仕組み

    処理が一本道なら、手前から順に調べれば済みそうです。けれども、途中で道が分かれ、再び合流したり、前の処理へ戻ったりするとどうでしょう。後から届いた情報によって、一度調べた場所の答えが変わることがあります。

    このとき、何をもう一度調べるかを管理するのが、データフロー解析のワークリスト法です。Open Quantum Design(OQD)の公開コンパイラー基盤には、その仕組みを汎用のグラフへ適用する実装があります。保存されたコードの具体例から、情報が合流する方法、ループで調べ直す理由、計算を終えてよい条件を見ていきます。

    簡単にまとめると?

    • ワークリストは「これから調べる場所」の一覧です。OQDの対象実装は最初に全ての点を入れ、その後は出力が変わった点の影響先を再登録します。
    • 合流では、何を知りたいかに合わせて情報をまとめます。「どれかの経路から届く」なら和集合、「全ての経路に共通する」なら共通部分、という違いがあります。
    • 同じ計算をしても値が変わらない状態が固定点です。単調性や有限の高さなどの条件が収束を支えますが、反復上限へ達してエラーになったことは、答えが確定した意味ではありません。

    データフロー解析で流すのは、処理についての情報

    データフロー解析は、処理のつながりに沿って情報を伝え、各地点で何が分かるかを調べる方法です。例えば、「この場所まで、どの処理からたどり着けるか」「この変数の値は、この先で使われるか」といった問いがあります。ここで流すのは解析用の集合や状態であり、量子ビットを物理的に運ぶ話ではありません。

    OQDの対象実装では、グラフの各点について、入ってきた情報を表す in_states と、その点で計算した後の情報を表す out_states を持ちます。複数の相手から届く情報をまとめる merge と、その点で情報を変換する transfer は、解析を作る側が定義します。グラフの点と前後の隣接関係があれば使えるため、特定の量子回路専用の解析には固定されていません。[1]

    この記事で扱うのは、OQD Compiler Infrastructureのコミット 1e861edacd25773df3b678c6002c5439b0691c37 です。保存版の宣言バージョンは0.1.0、開発状態はAlphaです。公開実装の読み取りと小さなソフトウェア例の検証であり、量子実機の性能向上を示すものではありません。[1、3]

    合流とループがあると、一度の順番では足りない

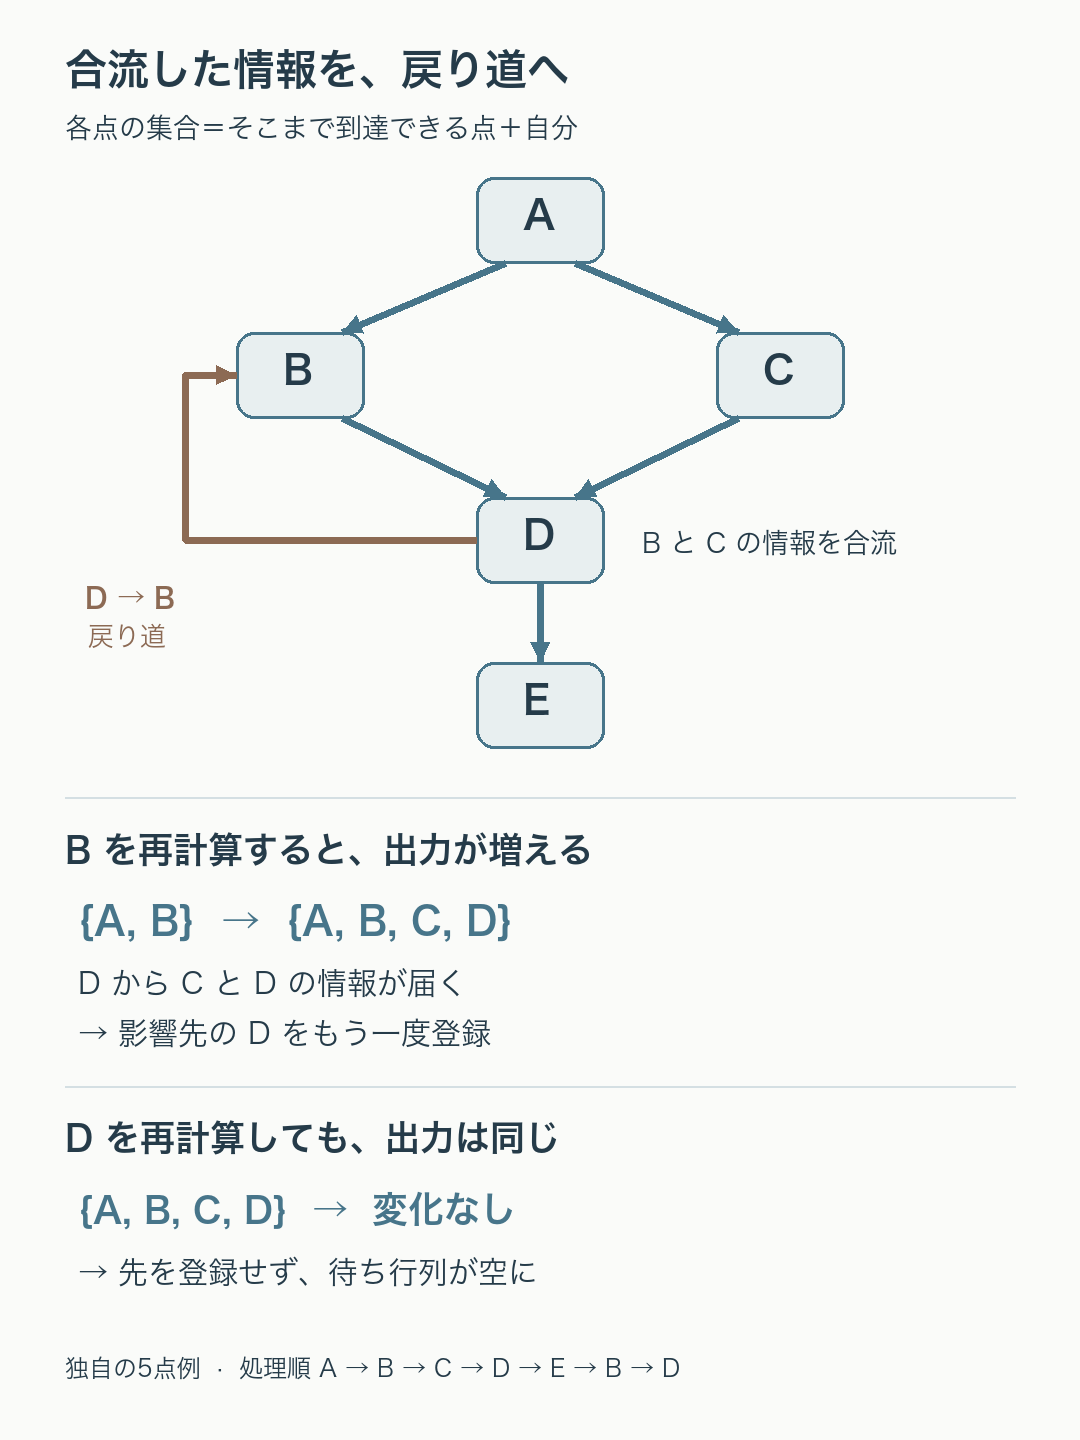
    例として、AからBとCへ分かれ、Dで合流してEへ進むグラフを考えます。さらに、DからBへ戻る道も一本あります。各点に持たせるのは、その点までたどり着ける点の集合です。自分自身も含めます。

    最初は全て空集合にし、前の点から届いた集合を和集合で合わせ、そこへ自分の名前を加えます。これは、OQDの上流テストにある到達関係の解析を、合流とループを含む独自の例へ適用したものです。集合に入った名前は「そこから到達できる」という可能性を表し、実際のプログラムが全ての道を一度に通った、という意味ではありません。[2]

    AからBとCへ分岐しDで合流、Eへ進むグラフ。DからBへの帰還でBの集合が増え、Dを再計算して変化がなければ再登録が止まる。
    図1 合流で得た情報が、戻り道を通ってBへ届きます。下段はBとDを調べ直したときの出力の変化。クリックすると拡大できます。OQDの保存版実装による独自の検証例をもとに作図。

    A、B、C、D、Eの順に最初の計算をすると、Aの出力は{A}、Bは{A, B}、Cは{A, C}です。DではBとCから来た情報を合わせ、自分のDも加えるので、{A, B, C, D}になります。

    ここでDの出力が増えたため、その影響先であるBとEを調べる必要が生まれます。Eはまだワークリストにいるので追加せず、既に一度調べ終えたBだけを末尾へ戻します。残る順番はE、Bです。

    Eを調べた後にBへ戻ると、今度はAだけでなくDからも情報が来ます。Bの出力は{A, B}から{A, B, C, D}へ増えます。そこで、Bの影響先であるDをもう一度登録します。

    Dを調べ直しても、出力は既に{A, B, C, D}です。入力は更新されますが、出力には新しい情報が加わりません。このため、BやEをさらに登録せず、ワークリストが空になります。今回の初期順序と隣接関係の順序では、点を取り出す回数は7回でした。グラフ全体を7周した数でも、他の方法との速度比較でもありません。

    出力が変わらなければ、先へ通知しない

    対象のOQD実装は、待ち行列の先頭から点を取り出し、入力をまとめ、変換後の出力を前回と比べます。出力が同じなら、その点の処理はそこで終わります。変わったときだけ影響先を末尾へ追加し、既に待ち行列にある点を重ねて追加しません。[1]

    大事なのは、途中で入力が変わったかだけでなく、その点から先へ渡す出力が変わったかで判断することです。今回のDのように、入力が増えても、出力に新しい情報がなければ先の計算は増やさずに済みます。ただし、この仕組みだけから、任意のグラフで何倍速くなるとまでは言えません。

    なお、この到達集合の例では初期値を空集合へ明示的に変更しています。基底クラスの既定値はラティスの最上位値 top() です。「OQDの全ての解析が空集合から始まる」と読むと、別の解析を組むときに意味が変わってしまいます。

    前向きと後向きは、知りたいことから選ぶ

    過去の処理から現在へ届く情報を調べるなら、前向き解析が自然です。OQDの ForwardDataflowAnalysis は前の点から情報を受け取り、出力が変わると次の点を登録します。

    一方、「この値がこの先で使われるか」のように、将来の必要性を現在へ伝えたい場合は後向き解析を考えます。BackwardDataflowAnalysis は次の点から情報を受け取り、前の点を登録します。ただし、方向を替えるだけで変数の生存解析が完成するわけではありません。何を使用・定義として扱うか、どの情報を残すかも別に定めます。[1、4]

    この実装の in_states と out_states は、解析の情報が入る側・変換後の側の名前です。後向き解析ではプログラムの実行方向と逆になるので、コード上の名前をそのまま実行前・実行後と読み替えないことも大切です。

    合流の方法も、問いと一緒に選びます。今回のように「どれかの経路で到達できる」を集めるなら和集合です。「どの経路を通っても必ず成り立つ」を調べるなら、各経路の情報の共通部分を残す設計が考えられます。和集合か共通部分かを替えれば済むとは限らず、状態の順序、初期値、入口や出口の条件も、その意味に合わせる必要があります。

    固定点に着くことと、上限で止めることは違う

    同じ関係式をもう一度計算しても値が変わらない状態を、固定点と呼びます。有限のグラフで、状態の変化が定めた順序を保つこと、異なる値がその順序に沿って際限なく続かないこと、適切な初期値と境界条件から始めることが、収束を考えるうえで重要です。順序を保つ性質が「単調性」、順序に沿う変化の段数が有限であることが「有限の高さ」です。[4]

    今回の例は、A〜Eの有限個の名前を、空集合から和集合で増やしていきます。一度得た名前を消さず、追加できる名前も有限なので、ずっと新しい情報が増え続けることはありません。

    けれども、解析を作る側が任意の変換を与えられる以上、フレームワークだけで全ての解析の収束が保証されるわけではありません。例えば、自分へ戻る点で「空なら名前を入れ、入っていれば空にする」と変換すれば、二つの状態を往復します。この非単調な独自例では、反復上限を4にして実行すると、結果を返す代わりに上限超過のエラーになりました。

    OQDの対象版の max_iterations は、既定で1,000,000です。この数はワークリストから点を処理する回数の上限であり、実行時間の保証でも、正しい答えへ近づいた度合いでもありません。上限を超えたときは、単に値を大きくする前に、変換が収束する設計か、初期値や合流の意味が合っているかを確認する必要があります。[1]

    この実装を読むときは、「何を知りたいか」「どちら向きに情報を伝えるか」「合流で何を残すか」「なぜ変化が止まるか」を一組で見ると、ワークリストの役割がはっきりします。待ち行列は調べ直す順番を管理しますが、何を答えとするかは、解析の設計に残されています。

    参考資料

    1. Open Quantum Design — dataflow.py(対象コミットの実装)。グラフの契約は同版のinterface.py、順序・合流・等値比較はlattice.pyを参照。
    2. Open Quantum Design — test_dataflow.py。前向き・後向きの到達集合の上流テスト。本文の合流・ループ・上限例は、この保存版に対する独自のソフトウェア検証です。
    3. Open Quantum Design — pyproject.toml。宣言バージョン0.1.0、Alpha分類、Python要件など。コミット日時は2026年10月8日。最新の全機能や実機性能を確認したという意味ではありません。
    4. Cornell University, CS 4120(2023年春)— Iterative solving。固定点、単調性、有限高さと反復解析。講義の上から下へ進む順序と、本文の空集合から増やす例は順序の取り方が異なります。
  • OQDの抽象構文木、式を変える規則とたどる順序を分ける

    OQDの抽象構文木、式を変える規則とたどる順序を分ける

    式の一部を書き換える処理が正しくても、その処理をかける順序が合わなければ、必要な値がまだそろっていないことがあります。プログラムを別の表し方へ変換するコンパイラーでは、「何をするか」と「どこから処理するか」の両方を設計します。

    非営利団体Open Quantum Design(OQD)が公開するコンパイラー基盤は、この二つを規則(Rule)と走査(Walk)に分けています。量子計算のソフトウェアを支える仕組みですが、その関係は小さな足し算と掛け算でも理解できます。ここでは抽象構文木(AST)をたどる例から、変換の順序を選ぶ理由と、動作確認で分かる範囲を見ていきます。[1、5]

    簡単にまとめると?

    • 抽象構文木は、式を演算とその引数の親子関係で表します。OQDは、各要素で行う処理と、要素をたどる順序を分けています。
    • 子の変換結果を使って親を変換するなら、子を先に処理するPostが必要です。親から見るPreとは用途が異なります。
    • 複数の処理をつなぐ順序や繰返しの停止条件も、変換規則とは別に確認します。構文木を処理できたことだけでは、量子ハードウェアの性能は分かりません。

    式のまとまりを、抽象構文木で表す

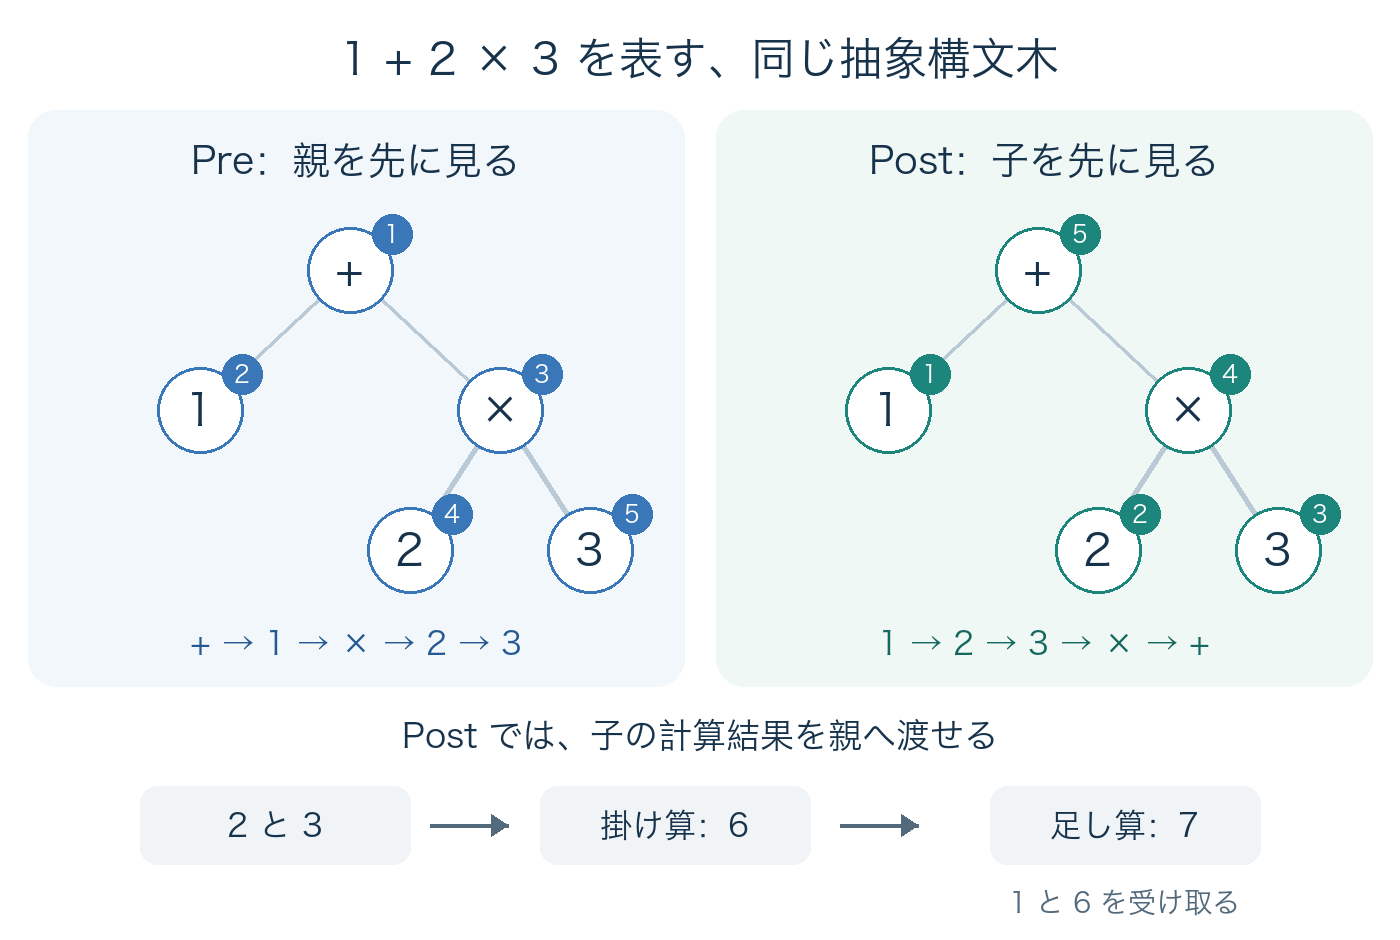
    1 + 2 × 3という式を考えてみましょう。掛け算のまとまりは2 × 3で、その結果を1に足します。これを木の形で表すと、一番上の「+」から「1」と「×」へ枝が分かれ、「×」の下に「2」と「3」がつながります。

    このように、演算と引数の関係を表すのが抽象構文木です。木の一つひとつの要素をノードと呼びます。たとえば「×」は「2」と「3」の親であり、「+」の子でもあります。式の見た目の文字列を左から読むだけでなく、どの演算が何を受け取るのかを明示できます。

    OQDの電卓チュートリアルも、整数、加算、乗算、累乗をそれぞれの型で表します。ここで使う小例は、その構造を足し算と掛け算だけに絞ったものです。量子状態や量子ビットの配置を表す図ではありません。[2]

    1+2×3を表す同じ抽象構文木。Preは+、1、×、2、3の順、Postは1、2、3、×、+の順にノードを見る。Postでは2と3を先に処理して6を得てから、1との加算で7を得られる。
    図1 同じ式でも、ノードを見る順序は異なる。番号は訪問順で、式の計算結果ではない。下段はPostで子の計算結果を親へ渡す関係を示す。OQDのWalkと電卓の説明に基づく模式図。[1、2]

    Ruleは処理内容、Walkはたどる順序

    Ruleは、ある種類のノードを見つけたときに行う処理です。「掛け算のノードなら左右の値を掛ける」「特定の形の式なら別の形に書き換える」といった内容を持ちます。一方のWalkは、木のどのノードへ、どの順序でRuleを適用するかを受け持ちます。

    図1のPre(前順)は、親を先に見てから子へ進みます。左の枝からたどると、訪問順は「+ → 1 → × → 2 → 3」です。Post(後順)では、子を先に見てから親へ戻るため、「1 → 2 → 3 → × → +」になります。これは訪問順の違いであり、Preを選んだから足し算を掛け算より先に計算する、という意味ではありません。実際に何をするかはRuleによって決まります。

    OQDのreverse指定は、兄弟にあたる要素を右から左へたどるためのものです。Postに指定した場合、この小例の順序は「3 → 2 → × → 1 → +」になります。子を先にする性質は保たれ、PostがPreへ切り替わるわけではありません。[1、3]

    子の結果が必要な変換には、Postを使う

    この違いが効くのが、式を整数の値へ変換するときです。「×」のノードから整数6を得るには、まず左右の子から2と3を得る必要があります。その後で「+」へ1と6を渡せば、整数7を得られます。

    OQDでは、同じ構文木の互換性のあるノードへ書き換えるRewriteRuleと、異なる型や表現へ変換するConversionRuleを分けています。後者のPost実装は、元のノードに加えて、先に変換した子の結果をoperandsとして規則へ渡します。電卓の加算なら、左右の結果を足す処理です。この受渡しがあるため、子の結果を使う変換にはPostが必要になります。[2、3]

    対して、2 × (3 + 4)を(2 × 3) + (2 × 4)へ展開する処理は、式の値をその場で整数にせず、式の形を変えます。チュートリアルでは、この分配法則による変形をRewriteRuleで定義しています。整数だけのこの例では、変形前後とも値は14です。

    ただし、規則を記述できることと、その規則があらゆる入力で意味を保つことは別です。ここで確かめたのは整数の小例です。浮動小数点数では演算の順序によって丸めの結果が変わり得るため、同じ変形をそのまま一般化できません。どの値や演算を扱う言語なのかも、規則の正しさの条件になります。[6]

    処理をつなぐ順序と、止まる条件も分けて考える

    構文木全体に対して行う一つの処理をパス(Pass)と呼びます。OQDでは、複数のパスを指定した順に実行するChainと、同じパスを繰り返すFixedPointが用意されています。たとえば、式の形をそろえる処理を先に行い、その後で値へ変換する、といった組合せを表せます。[4]

    FixedPointは、結果が変わらなくなるまで処理を繰り返すための仕組みです。ただし、確認した実装には繰返しを打ち切る上限もあります。上限に達した場合も結果を返すため、戻り値を得ただけで「変換が落ち着いた」とは判断できません。規則が行き来を繰り返さないか、比較方法が適切か、どこで打ち切られたかを別に調べる必要があります。

    使い分けを考えるときは、まず処理が必要とする情報を整理すると分かりやすくなります。

    行いたいこと 見る組合せ 確認する条件
    親の形を見てから、その中へ進む Preと適切なRule 書換え後の子へどう処理が進むか
    子の変換結果をまとめて親を変換する PostとConversionRule 左右などの子の結果を、規則へ正しく渡せるか
    複数の処理を段階的に行う Chain 前のパスの出力が、次のパスの入力条件を満たすか
    形が変わらなくなるまで整える FixedPoint 収束を判定できるか、上限で打ち切られていないか

    OQDにはInやLevelという走査もありますが、公式説明では、これらを構文木を変更しない解析・検査向けに位置づけています。名前や見やすさだけで順序を選ぶのではなく、その規則が必要とする情報と、走査が結果を受け渡す方法を合わせて見ることが大切です。[1、3]

    公開実装から確かめられること

    今回の説明では、OQDのコンパイラー基盤の2026年10月8日付コミットを参照しました。同じ版の電卓Notebookと、Rule・Walk・Rewriterに関わる実装部品をローカルで実行し、Notebookの例が163になること、小例の訪問順と計算結果が説明に一致することを確認しています。パッケージ全体の動作保証や、処理速度の比較を行ったものではありません。[2〜4]

    この確認で分かるのは、選んだ規則と順序が小さな式をどう処理するかです。量子プログラムを実機へ接続するには、変換先の命令や装置の制約を満たすことを、さらに確かめる必要があります。構文木の検査に通ること、意図した計算を保つこと、実機で精度よく実行できることは、それぞれ確認する対象が異なります。

    OQDの分離設計は、変換がうまくいかないときに「規則の内容」「子と親を処理する順序」「パスの組合せ」のどこを見直すかを考える手掛かりになります。公開されたコードを読む価値は、結果の数値だけでなく、その結果ができるまでの条件を追えるところにもあります。

    参考資料

    1. Open Quantum Design — Compiler Infrastructure。Rule、Walk、Pass、Rewriterの説明。
    2. Open Quantum Design — Calculator Notebook。関連するWebチュートリアルも参照。実行確認にはNotebookを使用。
    3. Open Quantum Design — walk.py、rule.py。子の処理結果と元のノードの受渡しを確認。
    4. Open Quantum Design — rewriter.py。ChainとFixedPointの実装。コード資料[2〜4]はコミット1e861eda(2026年10月8日)。
    5. Open Quantum Design — About。団体の位置づけ。
    6. Python Documentation — Floating-Point Arithmetic: Issues and Limitations。丸め誤差と演算の扱い。資料確認日:2026年10月16日。