タグ: データセンター運用

  • UNIWIDEのモジュール型データセンター、工場で作っても現地に残る工程

    UNIWIDEのモジュール型データセンター、工場で作っても現地に残る工程

    データセンターを短期間で用意したいとき、設備を工場で作り、現地で組み立てる方法が候補になります。ただし、完成したモジュールが届くことと、そこでサービスを始められることは同じではありません。UNIWIDEの講演資料は、工場での先行製作と現地の工事・検査をそれぞれ示しています。両方をつなぐと、発注前に確かめたい工程が見えてきます。[1]

    簡単にまとめると?

    • モジュール型は、電力・冷却・ラックなどを工場で先行製作し、現地で組み立てる方式です。
    • 現地調査、関係機関との協議、インフラ工事や検査まで不要になるわけではありません。
    • 納期を比べる際は、工場出荷・設置・利用開始のどこを完了とするかと、含まれる設備の範囲をそろえる必要があります。

    工場へ前倒しするのは、設備を作る工程

    モジュールとは、あらかじめまとまった単位にした設備です。UNIWIDEは、データセンターに必要な電力、冷却、サーバーラックなどを標準化されたモジュールとして工場で先行製作し、現地で組み立てる方式を説明しています。[1]

    具体例が、20フィート型の内部構成です。電源の安定化や冷却を担うインフラ区画と、サーバーやネットワーク機器を置くIT区画に分けています。前者には、停電時の給電を補うUPSや冷却設備などが含まれます。電源・冷却・IT機器の置き場を一つのまとまりとして準備する、という考え方です。[1]

    ただし、工場製作という説明だけでは、出荷前に何を試験し、何を合格条件にしたかまでは分かりません。講演資料には工場内の試験項目や判定基準の詳細がなく、先行製作と試験済みの範囲は分けて確認する必要があります。

    モジュールが届く前後にも、現地の仕事がある

    資料33頁の工程表示には、事前検討・現地測量、許認可書類の作成、関係機関との協議・書類提出が並びます。さらに、着工の届出とインフラ工事、電気設備の使用前検査、竣工図の作成、データセンターの設置と内部インフラ工事、特別検査・使用承認も挙げられています。これは韓国での講演に示された工程で、日本の案件にそのまま適用できる法令上の手続き一覧ではありません。[1]

    ここから読み取れるのは、工場で設備を作る工程と、設置先を使える状態にする工程が別にあることです。例えば、モジュール本体の製作が終わっていても、設置先のインフラ工事や必要な検査が未完了なら、資料が示す一連の工程は終わっていません。製作期間だけを、利用開始までの期間と読み替えないことが大切です。

    必要な工事は構成によっても変わります。AI向け構成を比べる表では、液冷型の予定期間にCDUと配管の工事を含むと注記しています。CDUは、IT機器側の冷却液と設備側の熱交換を仲立ちする装置です。液冷を選ぶなら、計算機の性能だけでなく、その冷却設備と配管をどこまで準備するかも工程に入ります。[1]

    納期と「含まれるもの」を同じ範囲で比べる

    資料21頁の構成表は、クラウドサービス開始までの期間を、空冷型では最短10週前後、液冷型では最短12〜13週前後と示しています。液冷型にはCDU・配管工事を含むと明記されています。一方、何を起点に数えるか、現地の準備や手続きにどんな前提を置くかの詳細は分かりません。「10週」という訴求だけを切り出さず、構成と作業範囲を確認する必要があります。[1]

    見積もりを読む際は、工場出荷までなのか、設置と接続までなのか、検査や利用開始までなのかを分けると比較しやすくなります。現地工程と工場製作の工程を並べ、それぞれの完了条件と担当を確認するための整理です。

    設備の範囲も同様です。UNIWIDEのパッケージ説明は、含まれるITハードウェアを最低限の仕様とし、構築後に目的のサービスを提供するには追加機器が必要な場合があると注記しています。建物や設備がそろうことと、必要なサービス構成がそろうことも区別できます。[1]

    モジュール型を選ぶ判断材料は、短い製作期間だけではありません。工場へ前倒しできる仕事、設置先で残る仕事、サービスのために追加するものを分けることで、納期の比較と準備の抜けを確かめやすくなります。
    参考資料

    1. Hyunjun Ju(UNIWIDE)「From Construction to Assembly: The New Data Center Paradigm」2026 OCP Korea Tech Day、全34頁。本文は6、14、16、20、21、33頁を参照。講演資料/OCP公式講演一覧
  • Synology PAS7700のActive-Active、片側故障時も読み書きを続ける条件

    Synology PAS7700のActive-Active、片側故障時も読み書きを続ける条件

    仮想マシンの保存先を二重化していても、サーバーからそこへ届く道が一本しかなければ、その道の故障で読み書きは止まります。ストレージに二つのコントローラーがあることと、利用中の仕事が続くことの間には、いくつかの条件があります。

    Synology PAS7700は、二つのコントローラーが同時に働くActive-Active構成のNVMeストレージです。OCP Korea Tech DayでABLESTORのYUNWON HAN氏が紹介した資料を、Synologyの運用ガイドと照らすと、「何を引き継ぎ、どの経路で使い続けるか」が見えてきます。[1][4]

    簡単にまとめると?

    • PAS7700は、故障した側の保存領域や通信の役割を、もう一方のコントローラーへ引き継ぎます。
    • 利用側にも複数の経路と適切な設定が必要で、二重に配線するだけでは十分ではありません。
    • 切替中の待ち時間、片側での処理能力、復帰後の状態を確かめ、バックアップは別に備えます。

    二つが働いていても、保存領域には担当がある

    コントローラーは、サーバーから届く要求を受けてストレージの読み書きを管理する部分です。PAS7700ではDual Poolという保存領域を二つのコントローラーへ分け、ボリュームを作る際に担当を選びます。Active-Activeは、一つのボリュームの全要求を常に半分ずつ処理する、という意味ではありません。[2]

    片側が利用できなくなると、保存領域などの管理を相手側へ移します。この切替がfailoverです。元の側が復旧した後、役割を戻して二つが働く状態へ戻す処理をgivebackと呼びます。[3]

    たとえば、仮想マシン用の保存領域をA側、別の業務の保存領域をB側が担当する構成を考えます。A側の保守中には、B側が元の仕事に加えてA側の分も受け持ちます。平常時に両方を使い切る設計では、この引き継ぎ先に余裕がありません。最高速度を比べる前に、片側だけになったときに必要な仕事を処理できるかを見る理由です。

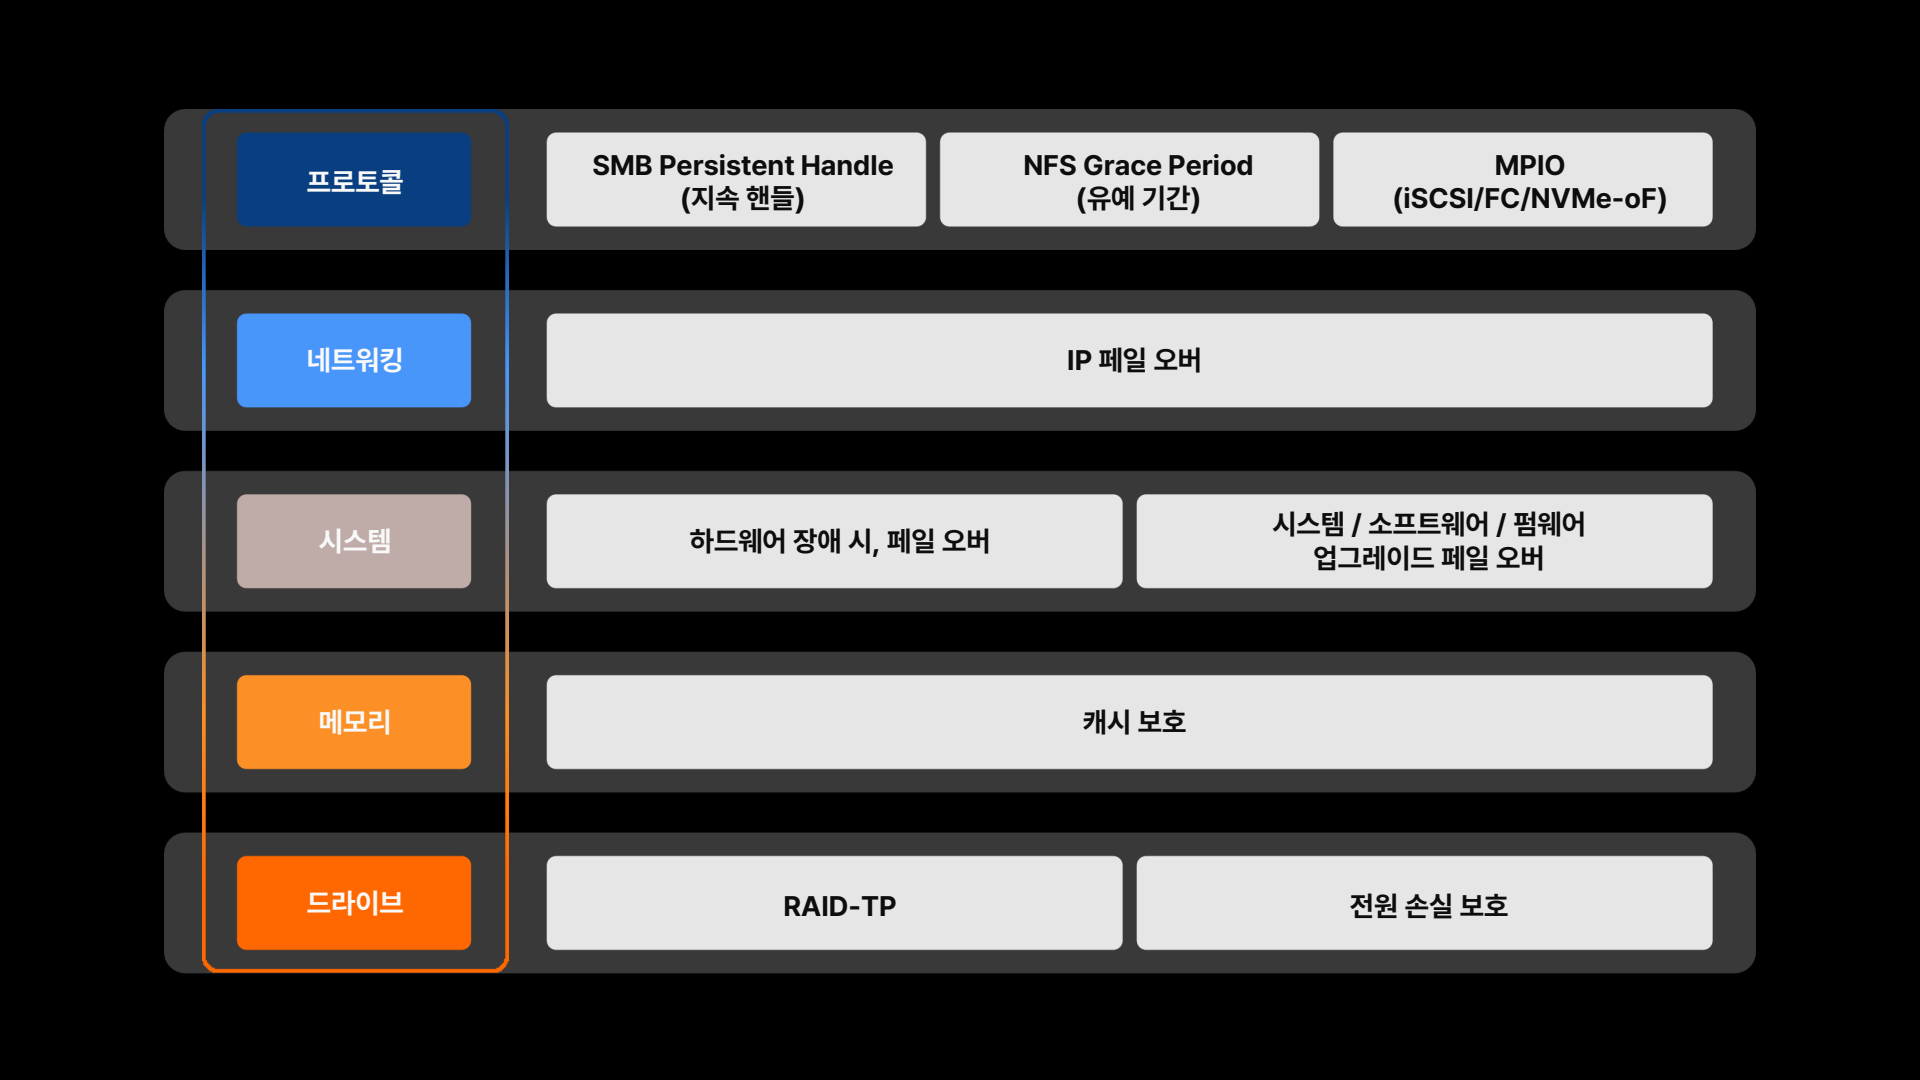
    PAS7700の継続利用を5層で整理した原図。プロトコル層のSMB persistent handle、NFS grace period、MPIO、ネットワーク層のIP切替、システム切替、キャッシュ保護、ドライブ保護を別の層に置く。
    図1 PAS7700の可用性を、上からプロトコル、ネットワーク、システム、メモリー、ドライブに分けた登壇資料。上段のMPIOやファイル共有の再開条件は、装置内部の切替とは別に整える必要があります。出典:ABLESTOR、YUNWON HAN、OCP Korea Tech Day 2026 登壇資料 p.19。原資料 / 図を拡大する

    保存先の引き継ぎと、そこへ届く経路を分ける

    図1では、システムの切替より上に、通信とプロトコルの層が置かれています。保存領域をB側が引き継いでも、利用側がA側への接続しか持たなければ、新しい担当へ要求を届けられないからです。

    IPネットワークでは、両側のインターフェースをfailover groupにまとめ、必要なときにサービス用IPアドレスを移せるようにします。一方、ストレージの所有者の移転とIPの移転は、常に一組ではありません。公式ガイドは、ネットワークの問題ならIPだけ、保存領域の問題ならストレージ側だけを切り替える場合も説明しています。[3]

    iSCSI、Fibre Channel、NVMe-oFのブロックストレージでは、MPIO(Multipath I/O)が、利用側から保存先への複数の道を扱います。Synologyが挙げる条件は、両コントローラーへの冗長な接続、異なるポートなどを使った複数の接続経路、そしてホスト側でのMPIO有効化と動作方針の確認です。[2]

    「ケーブルは二本ある」という見方を、実際の故障へ置き換えてみます。二本とも同じスイッチを通るなら、そのスイッチが止まる場合をカバーできません。違うスイッチを通っていても、ホストが残った道を使える設定になっているかは別に確かめます。試験では、抜いたケーブルの本数ではなく、どの故障を再現し、どの道で読み書きが続いたかを記録すると判断しやすくなります。

    自動で再開することと、待ち時間がないことは違う

    ファイル共有では、装置の切替後にクライアントが処理を続けられるかも重要です。公式ガイドのSMB更新時の表では、Continuous Availabilityを有効にし、クライアントがpersistent handleに対応している場合、転送は一時停止してから自動再開します。どちらかが欠ける場合は、手動で再開する必要があると説明されています。[2]

    ここから読めるのは、「自動再開」と「一度も待たない」を同じにしないことです。仮想マシンやデータベースを評価するなら、ストレージの管理画面が正常に戻った時刻だけでは足りません。アプリケーション側で処理が失敗していないか、待ち時間が許容範囲か、再試行の後もデータが整合しているかまで観察します。

    切替時間は負荷、管理対象の数、影響するサービスによって変わると、Synologyは記しています。本記事では固定の秒数を約束する値として扱いません。[3]

    「片側で動いた」の次に、元へ戻るところまで見る

    片側でサービスが続いている間は、冗長性が元どおりに戻ったわけではありません。公式ガイドでは、復旧したコントローラーへのgivebackは自動で始まり、移行中に性能へ影響する場合があるため、復帰の作業は利用が少ない時間帯に行うよう勧めています。[3]

    導入時の試験を「故障を起こして、応答が返った」で終えず、復帰後に負荷が両側へ戻るかまで追うと、運用手順になります。平常時、片側運転、復帰中の三つを同じ負荷で比べれば、可用性のためにどれだけ余裕を残すかも考えやすくなります。これは製品の測定結果ではなく、公開された切替の仕組みから導く評価の進め方です。

    二重化で守る範囲と、バックアップで戻す範囲

    登壇資料はキャッシュ保護も別の層に置いていますが、その内部同期方式や、書き込み完了を返す時点までは説明していません。図の一項目から、あらゆる電源断で未保存データを失わないと広げて読むことはできません。[1]

    また、コントローラーを切り替える仕組みは、誤って消したファイルを過去の状態へ戻す仕組みとは役割が違います。講演も、装置内の可用性とは別に、複製と外部バックアップの構成を示しています。[1]

    PAS7700を検討するときは、何が止まっても残したい処理を先に決めます。そのうえで、引き継ぐ保存領域、利用側からの道、片側の処理余力、復帰、過去へ戻す手段を対応させる。Active-Activeという構成名が、実際の仕事を続けられる設計へつながるのは、その条件がそろったときです。

    参考資料

    2026年10月10日確認。公開登壇資料の全26ページと、Synologyの下記公式ガイドを照合しました。製品の実機試験や講演動画の質疑を行った記事ではありません。ガイドのページ番号はPDFの先頭を1ページと数えています。

    1. YUNWON HAN(ABLESTOR)「A New Standard for Virtualization Infrastructure: Synology PAS7700」 — OCP公式掲載スライド、全26ページ。構成はpp.9、12、可用性の層はp.19、保護の構成はpp.21–22。
    2. Synology「PAS7700 Best Practices Guide」 — 2026年9月21日版、全48ページ。Dual Poolとボリュームはpp.15–17、片側運転の余力はpp.25、29、MPIOはp.32、SMB更新時の再開条件はpp.35–36。
    3. Synology「PAS Failover Guide」 — 2026年5月8日版、全11ページ。切替対象と条件はpp.3–5、復旧と確認はpp.6–7。
    4. Open Compute Project「2026 OCP Korea Tech Day」 — 演題、登壇者、公式配布資料へのリンク。
  • SK Broadbandのデータセンター運用案、テレメトリーで電力と冷却をつなぐ

    SK Broadbandのデータセンター運用案、テレメトリーで電力と冷却をつなぐ

    たとえば、稼働中のデータセンターで、ラックの消費電力と冷却液の温度が近い時間帯に上がったとします。記録の時計がずれていると、どちらが先に変わったかも分かりません。AIデータセンターの運用では、設備を増やす前に、判断に使えるデータをそろえることが欠かせなくなっています。[1]

    2026年8月のOCP Korea Tech Dayで、SK BroadbandのPark Jaewook氏は、運用を四つの仕事に分けました。①データの品質、②手順と知識、③電力と冷却の連携、④運用者の役割です。発表は構想と例を交えた提案で、示された時間や精度の目標が、すべての施設で達成済みという意味ではありません。[1・2]

    簡単にまとめると?

    • 電力と冷却を一緒に見るには、測定値の単位・周期・欠損の扱いと時刻をそろえる必要があります。
    • 電力の変化を冷却の先行信号に使う案ですが、制御条件は自施設の遅れや安全装置と合わせて確かめます。
    • AIは検証しやすい作業から段階的に使い、専門家の判断を残す提案で、自律制御の完成報告ではありません。

    まず、同じ出来事を同じ時刻で見る

    センサーの値は、届くだけでは十分ではありません。記録が抜けていないか、測定器のずれはないか、同じ「流量」が機器ごとに別の単位や周期で届いていないか。さらに、設備の時計がずれていれば、障害の前後関係まで曖昧になります。発表資料は、この四つをデータ品質の問題として並べています。[1]

    そこで必要なのが、集める項目と単位、収集周期、欠損の扱いを先に決め、計測網と時刻同期を設計することです。時刻をそろえれば「電力の変化が冷却の異常より先だったか」は確かめやすくなります。ただし、順番が分かっても、それだけで因果関係は決まりません。現場の構成や他の記録と突き合わせる工程は残ります。[1]

    次に、経験を点検できる手順へ移す

    運用者の頭の中にだけある判断を、設備図、過去の事例、手順書、警報の条件と結びつける。資料は、その最初の題材にイベントログを選びます。たとえば冷却液の流量が下がり、フィルターの前後で圧力差が増えたとき、システムが「詰まりの可能性」を示し、運用者が値と条件を確かめる形です。発表スライドの数値入り事例は説明用の例であり、導入施設の実績とは読みません。[1]

    AIエージェントを使うとしても、まずはログの要約や候補の提示から始め、誤りを測れるようにする。資料も、専門家が最終判断する形と、簡単で検証しやすい作業から段階的に広げる考え方を示しています。液冷装置や電源の自動制御まで完成した、という発表ではありません。[1]

    電力を、冷却の少し先にある手がかりにする

    GPUの仕事量が変わると電力が先に動き、その熱が冷却液の計測点に届くまでには時間差が生じます。温度が上がってからポンプを動かすだけでは、対応が遅れる場合があります。発表は、まずラックの電力変化を先行する信号として使い、将来は仕事量の情報まで組み合わせる案を示しました。[1]

    ここで大事なのは、資料にある秒数をそのまま制御設定へ写さないことです。熱が伝わる時間は、チップ、配管、流量、センサーの位置で変わります。自施設で遅れを測り、冷却の能力や安全装置との関係を確かめてから、予測や制御の条件にします。電力と冷却をつなぐ発想は有用ですが、早く反応させれば必ず安全、とは言えません。[1]

    運用する人を、設計の初めから入れる

    計測点や配線が固まった後で運用者が参加しても、必要なデータを後から取りにくくなります。資料は、名称や単位、判断条件を設計段階から合わせ、試運転で実際に読めるか確かめる役割を運用者に求めています。複数の施設を一画面にまとめるときも、画面を作る前に共通の項目と時刻の基準が必要です。[1]

    OCPにも、施設の電力・温度などのテレメトリーを扱う取り組みと、IT機器と施設側の管理を近づける「Open Data Centers for AI」があります。ただし、発表スライドに並ぶすべての文書や数値が、そのまま確定した統一規格ではありません。今回の資料は、既存の公開資料を確かめつつ、現場で足りない定義を探す入口として読むのがよさそうです。[1・3・4]

    AIデータセンターを安定して動かす道筋は、派手な自律制御から始まるわけではありません。欠損のない計測、同じ時刻、説明できる判断条件、そして運用者が止められる手順。その土台があって初めて、電力と冷却を一緒に見守れるようになります。

    SK Broadbandの通信・メディア事業とデータセンター事業は、cyclewaveの企業記事で整理しています。

    参考資料

    2026年9月23日確認。発表資料に含まれる対応時間・損害額・精度目標は、一般施設の実測値やOCPの一律要件として用いていません。講演動画・質疑応答は根拠に含めていません。

    [1]SK Broadband / Park Jaewook「F1-Style AI DC Operations: 4 Core Pillars」OCP掲載スライド(27頁。四つの仕事はp.7、データ品質はpp.8–9、運用知識はpp.11–12、電力と冷却はpp.14–15、運用者はpp.17–18)。

    [2]Open Compute Project「2026 OCP Korea Tech Day」発表一覧(開催日・登壇者・資料の掲載)。

    [3]Open Compute Project「Data Center Telemetry」(施設の電力・熱・機械系データを扱う取り組み)。

    [4]Open Compute Project「Open Data Centers for AI」(施設側とIT側のテレメトリーおよび管理の方向)。