投稿者: SB-admin

  • HTTPのAge、受け取った直後でも応答が新しいとは限らない

    HTTPのAge、受け取った直後でも応答が新しいとは限らない

    同じ案内ページを何度も配信するとき、HTTPのキャッシュは保存済みの応答を再利用して、通信とサーバーの仕事を減らします。応答にCache-Control: max-age=60とあれば、受け取ってから60秒間はそのまま使えるようにも見えます。しかし、途中のキャッシュで既に時間が経っているなら、受信した側に残る時間は60秒より短くなります。

    その経過を読み取る手がかりがAgeです。HTTPのキャッシュ規格RFC 9111に沿って、応答の年齢と有効期間を分け、上流で40秒経過した応答が届く例を計算します。

    簡単にまとめると?

    • Ageは、元のサーバーで応答が生成または検証されてからの経過時間の推定値です。ファイルを最後に編集してからの時間とは違います。
    • 受信時の年齢には、上流で過ごした時間や通信の遅れを反映します。保存先が変わっても、有効期間が毎回最初から始まるわけではありません。
    • 有効期間60秒、現在の年齢52秒なら、鮮度の境界まで残るのは8秒です。鮮度が残っていることだけで、あらゆる要求に再利用できるとは限りません。

    有効期間と年齢は、比べるための別の値

    HTTPの「fresh」は、応答の本文が世界の最新情報と必ず一致している、という意味ではありません。キャッシュ規則に基づいて、鮮度が保たれていると判断される状態です。生成後に元のデータが変わっていても、有効期間の途中では保存済みの応答を使う場合があります。

    判断には二つの値を使います。一つはfreshness lifetime、つまり鮮度を保つと定められた期間。もう一つはcurrent age、つまり保存中の応答について見積もった現在の年齢です。期間が年齢より長い間はfreshで、同じ値に達するとstaleになります。staleは、この鮮度の条件を満たさなくなった状態を指します。[1]

    以下では、対象のキャッシュに適用される有効期間がmax-ageで指定された60秒であり、保存や要求との照合に関するほかの条件も満たしていると仮定します。共有キャッシュ向けのs-maxageなど、別の指定が優先される場面はこの例に含めません。

    受け取ったAgeに、通信と保存中の時間を加える

    あるキャッシュが上流へ要求を送り、応答を受け取る場面を考えます。計算を見やすくするため、時刻は同じ基準から測った秒数とし、時計のずれはないものとします。実際の通信では、Dateは日時、Ageは秒数として表されます。

    • 要求を送った時刻:100秒
    • 応答を受け取った時刻:102秒
    • 応答のDateが示す時刻:95秒
    • 受け取ったAge:40秒

    Dateだけを見れば、受信時には102−95=7秒が過ぎています。一方、Ageには上流のキャッシュなどでの経過が反映されています。要求から受信までの2秒をAgeに加えた補正値は、40+2=42秒です。Dateからの7秒だけを使うと、上流から伝わった経過時間を過小評価することになります。

    RFC 9111は、Ageに応答の遅れを加えた値を受信時の年齢として使うことを認めています。また、Ageを正しく挿入しない古いキャッシュが混じる場合には、Dateから求めた値と比べて大きい方を取る、より保守的な計算を示しています。すべての実装が常に大きい方を取らなければならない、という規定ではありません。この例ではどちらの方法でも42秒になります。[1]

    さらに、その応答を受信後10秒間保存し、時刻112秒で使うとします。現在の年齢は42+10=52秒です。max-age=60なら、鮮度の境界に達するまで残る時間は60−52=8秒になります。
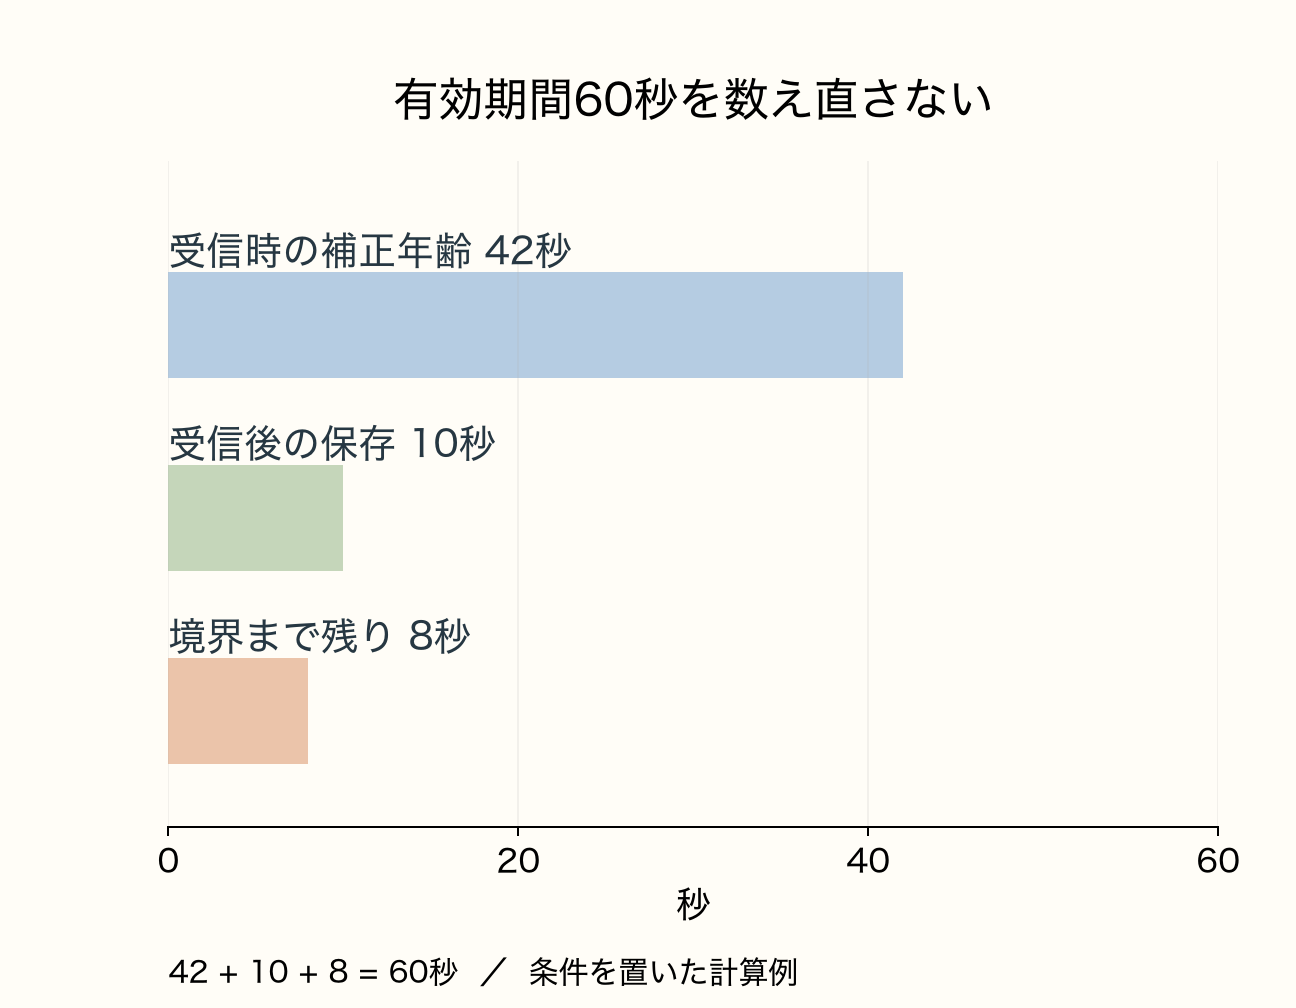
    有効期間60秒のうち、受信時の補正年齢42秒と受信後の保存10秒を消費し、残りは8秒。受信時から60秒を数え直すと上流で経過した時間を見落とす。
    同じ時刻基準を仮定した独自の計算例。上流から受け取ったAgeを使って有効期間の残りを求めています。通信の実測値ではありません。

    受信した時点をゼロとして数え直すと、時刻112秒では10秒しか経っていないように見え、残りを50秒と誤認します。途中にキャッシュが増えるたびに期間を延ばさないよう、上流まで含めた年齢を引き継ぐことが必要です。

    Ageがないときも、受信直後だから新しいとは決めない

    Ageが欠けている場合、規格の計算では受け取ったAgeの値を0として扱います。ただし、それだけで現在の年齢が常に0になるわけではありません。応答の遅れやDateを使った見積もり、受信後に保存していた時間は別にあります。

    たとえば同じ時刻条件でAgeだけがなければ、Ageに応答の遅れを加えた値は2秒、Dateからの値は7秒です。先ほどの保守的な方法なら受信時の年齢は7秒になります。これは「Ageがないなら必ず7秒」という一般則ではなく、示した条件と計算方法による結果です。

    RFC 9111は、Ageが存在しないことから、今回の要求が元のサーバーまで到達したとは判断できない、と説明しています。逆にAgeの値を見ても、それをファイルの最終更新からの経過時間へ読み替えることはできません。応答の生成・検証と、資源そのものの編集は別の出来事です。[1]

    境界を越えた後は、別の規則を確認する

    例の年齢が60秒に達すると、freshness lifetimeより小さいという条件を満たさなくなります。しかし、staleになった瞬間に本文を必ず削除する、という意味ではありません。再検証に使うため保存を続けることもありますし、古い応答の提供が明示的に許可される場合もあります。その可否には、再利用を禁じる指定や切断状態など、別の規則が関わります。

    反対に、年齢が52秒でfreshでも、それだけで再利用が確定するわけではありません。要求と保存済み応答が対応するか、Varyで分けられた条件が一致するか、no-cacheによる検証が必要か、といった点を確認します。鮮度の計算は、キャッシュ判断を構成する一段階です。

    調査するときは、「60秒という設定を見た」だけで終わらず、どのキャッシュに適用される期間なのか、受信したAgeはいくつか、要求と応答の時刻をどう記録したか、受信後どれだけ保存したかを分けて残します。数値を同じ基準で比べることで、保存の効果と、古い内容を使い続ける時間の上限を読み違えにくくなります。

    出典

    • [1] RFC 9111: HTTP Caching(2022年6月) — 第4.2節の鮮度モデル、第4.2.1節の有効期間、第4.2.3節の年齢計算、第4.2.4節の古い応答の提供条件、第5.1節のAge。本文の秒数と図は、条件を明記した独自の計算例です。
  • Linuxのinotify、変更通知があふれた後に一覧を正しく戻すには

    Linuxのinotify、変更通知があふれた後に一覧を正しく戻すには

    フォルダーの変更を見つけたら、画面の一覧や検索用の索引を更新する。Linuxのinotifyを使うと、毎回すべてのファイルを調べる代わりに、変更通知をきっかけに作業できます。しかし、その通知を完全な履歴として扱うと、負荷が高まったときに一覧が実物からずれることがあります。

    問題の境目になるのがIN_Q_OVERFLOWです。イベントの待ち行列があふれたことを示すこの通知を受けたら、「何件か処理が遅れた」だけでなく、「手元の状態を作る材料が欠けたかもしれない」と考える必要があります。

    簡単にまとめると?

    • inotifyはファイルやディレクトリの変化を通知しますが、完全な操作履歴や正確な発生回数を保証する仕組みではありません。
    • イベントキューがあふれると通知が失われ、IN_Q_OVERFLOWが発生します。どのファイルのどの変化を失ったかまでは、この通知から復元できません。
    • 変更通知で更新するキャッシュには、実ファイルを再走査して整合性を戻す経路が必要です。容量を増やすことと、欠落後に正しく復旧できることを分けて設計します。

    通知を使う一覧は、実物の写しを持っている

    例として、監視対象フォルダーにあるファイル名をメモリー上の集合に保存する一覧アプリを考えます。起動時にフォルダーを走査し、その後は作成の通知で名前を足し、削除の通知で名前を消します。この集合が、実ファイルの状態を写したキャッシュです。

    変更が少ない間は、毎回フォルダー全体を読み直さずに済みます。ところが、この仕組みの正しさは、必要な通知を受け取り、適切に処理できることに依存しています。通知を読み出す処理で重い変換や遠隔通信まで行うと、その間も別のプロセスがファイルを変更し、未処理の通知が積み上がります。

    inotifyの一つのインスタンスには、複数の監視対象を登録できます。読み取るイベントには、監視対象を示すwd、変更の種類を示すmask、場合によってファイル名などが入ります。通知の順序は保たれますが、それだけで通知が欠けないことまで保証されるわけではありません。

    欠けた通知を後から処理し続けても、元には戻らない

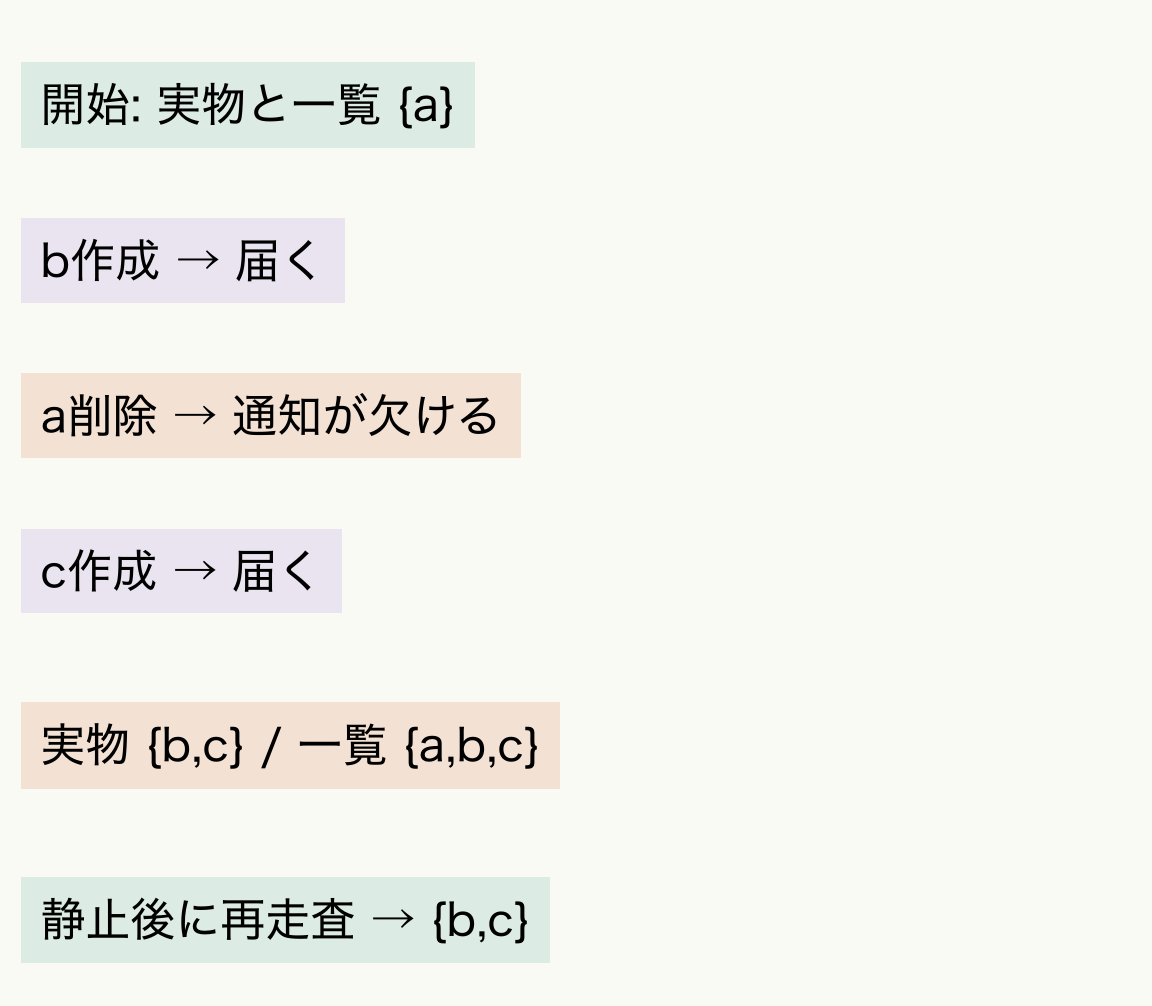
    最初の実フォルダーとキャッシュが、どちらも{a}だったとします。その後、次の三つの変化が起きたと考えます。

    1. bを作成し、その通知は一覧アプリへ届いた。
    2. aを削除したが、その通知はキューあふれにより失われた。
    3. cを作成し、キューの空きが戻った後、その通知は届いた。

    受け取れた作成通知だけを順に処理すると、キャッシュは{a, b, c}になります。しかし、実フォルダーは{b, c}です。順番どおりに処理していても、欠けた削除の情報は戻りません。以後aに変化がなければ、表示には存在しないaが残り続けます。

    実フォルダーはaからb,cへ変化。aの削除通知を失うとキャッシュにはa,b,cが残る。変化が止まった状態で再走査するとb,cへ一致する。
    通知が一つ欠けた場合の独自の集合モデル。実際のキュー容量や、Linuxで必ずこの順序の欠落が起きることを示す実測ではありません。

    この例で必要なのは、次の通知を待ち続けることではなく、キャッシュをいったん信用できない状態として扱い、実際のフォルダーを確認することです。変化が止まった後に再走査すれば、{b, c}を取得して一致を取り戻せます。ただし、これは現在の状態を回復したのであって、失った削除の時刻や実行者まで取り戻したわけではありません。

    あふれた場所を、一つのファイルに決めつけない

    IN_Q_OVERFLOWのイベントではwdは−1です。通常の監視対象の番号ではないため、「このファイルだけを再読込みすればよい」と通知自身から決めることはできません。同じインスタンスから通知を受けている範囲について、どこまで再確認が必要かを設計します。

    マニュアルは、必要に応じてキャッシュの一部または全体を再構築する方法を挙げています。一つの単純な方法は、inotifyのインスタンスを閉じ、キャッシュを空にして、新しいインスタンスと監視対象を作り直すことです。ただし、対象が多ければ再構築の負担も増えます。

    実際のフォルダーが更新され続ける場合には、再走査も一瞬で完了する完全なスナップショットではありません。監視の追加、走査、届いた変更との突合せが重なる場面を考え、走査中にも再度あふれた場合に完了扱いにしないことが必要です。上の静止した集合の例だけでは、この並行処理の正しさまでは検証できません。

    三つの上限を、同じ問題として扱わない

    inotifyには、キューに保持するイベント数の上限であるmax_queued_events、実ユーザーID当たりのインスタンス数の上限であるmax_user_instances、監視対象数の上限であるmax_user_watchesがあります。

    監視対象を追加できない問題と、追加済みの対象から来た通知をため切れない問題では、確認する上限が異なります。イベントキューの上限値はインスタンス作成時に使われるため、設定値を書き換えたことと、すでにあるインスタンスの挙動が変わったことも同一視できません。

    キューを大きくすれば、短い集中に耐える余地は増やせます。しかし、生産される通知が読み取り側の処理を長期間上回れば、容量だけで解決するとは限りません。読み取り経路を軽くすること、重い作業を別に渡すこと、重複した再計算をまとめること、欠落後の再照合を用意することを、別々の対策として評価します。

    変更検知と監査の役割を分ける

    通知の欠落がなくても、未読の連続イベントが同じ内容なら一つにまとめられる場合があります。そのため、通知の個数を「書込み回数」として集計する設計には向きません。また、inotifyは、その操作を行ったユーザーやプロセスの情報を提供しません。

    監視対象のディレクトリの下も自動的にすべて監視されるわけではありません。サブディレクトリには別の監視が必要で、監視を追加する前に中身が作られる可能性もあります。対象の範囲が漏れている問題と、キューがあふれた問題も分けて点検します。

    画面の一覧や索引を現在の状態へ追いつかせたいなら、inotifyを「再確認が必要になった」という入口として利用できます。一方、誰がいつ何回操作したかを欠落なく残したいなら、別の記録方式が必要です。まず保持したいものが現在の状態なのか、過去の全履歴なのかを決めることが、復旧設計の出発点になります。

    出典

    • Linux man-pages 6.19: inotify(7) — IN_Q_OVERFLOW、/procの各上限、イベントの合流、監視範囲とキャッシュの再構築。図とファイル集合の例は、本文に示した欠落条件を使った独自モデルです。
  • HTTPのキャッシュ無効化、更新したページと一覧が同時に変わるとは限らない

    HTTPのキャッシュ無効化、更新したページと一覧が同時に変わるとは限らない

    商品の名前を変更し、保存は成功したのに、一覧画面には古い名前が残る。HTTPのキャッシュがあるシステムでは、更新の成功と、関連するすべての表示が新しくなることを分けて考える必要があります。詳細ページと一覧ページでは、保存されている応答のURLも、応答を持っているキャッシュも違うかもしれません。

    RFC 9111のキャッシュ無効化の規則は、更新に伴って何を再利用できなくするかを定めています。ただし、アプリケーションのデータ間の関係をすべて理解して、世界中のキャッシュへ変更を伝える仕組みではありません。対象のURL、関連URL、要求が通った経路の三つを分けて、その範囲を見ます。

    簡単にまとめると?

    • 状態を変え得る要求に対して2xxまたは3xxの応答を受けたキャッシュは、要求対象のURIを無効化します。
    • 無効化は、保存内容を取り除くか、次に送る前の検証を必須にすることです。更新済みの本文をその場で全キャッシュへ配ることではありません。
    • 関連する一覧や、別経路のキャッシュまで自動的に無効化される保証はありません。更新対象と表示の依存関係を、アプリケーション側でも設計します。

    更新の成功から分かるのは、どの範囲か

    HTTPでは、PUT、POST、DELETEのように、元のサーバーの状態を変え得るメソッドをunsafeと呼びます。ここでの「安全でない」は、通信が暗号化されていない、という意味ではありません。要求に状態変更の可能性があるかどうかの区別です。

    キャッシュがこうした要求に対してエラーではない応答を受け取ると、要求対象のURIを無効化しなければなりません。安全性が分からないメソッドも、この規則に含まれます。RFC 9111でいうエラーではない応答は2xxまたは3xxです。200だけに限定した規則ではありません。[1]

    ただし、応答コードを受けたことから、業務上の処理がすべて完了したと推定するわけではありません。ここで定めているのは、キャッシュが保存済み応答を無効化する契機です。アプリケーションの処理完了や、その後の読み取り結果の確認とは分けて扱います。

    同じデータを表示していても、URIは別のことがある

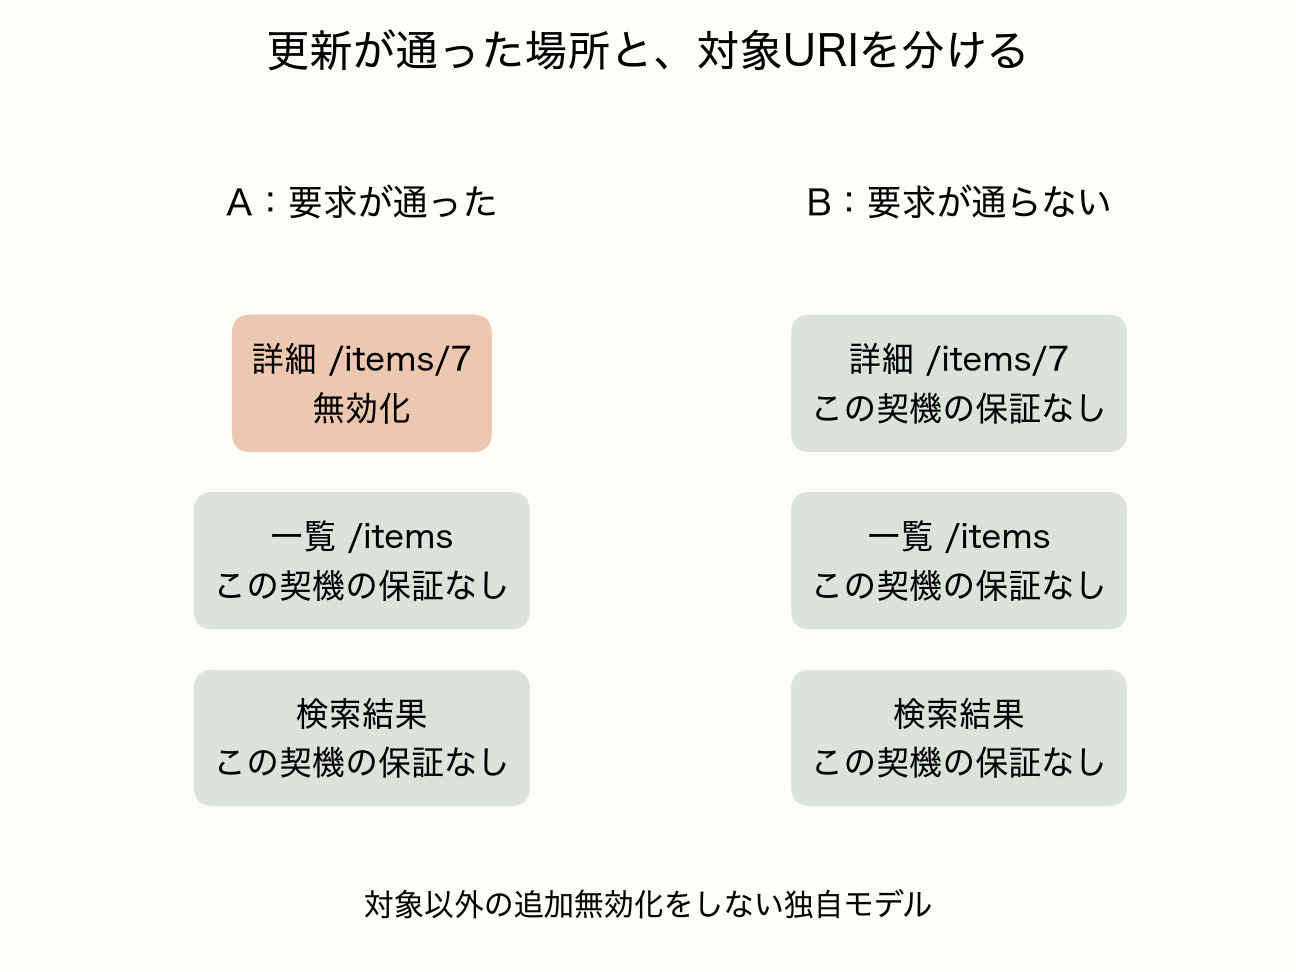
    例として、詳細の/items/7、一覧の/items、検索結果の/search?q=lampという三つのURIがあるとします。どれも商品7の名前を含みますが、HTTPから見れば別の応答です。

    キャッシュAを通してPUT /items/7を送り、2xxの応答が戻ったとします。この経路にあるAは、/items/7について保存していた応答を無効化します。同じ対象URIに複数の保存済み応答がある場合も、無効化の対象になります。[1]

    一方、この規則だけから、/itemsや検索結果まで必ず無効化されるとは言えません。HTTPのキャッシュが、一覧の中に商品7の名前が含まれているという依存関係を、当然に知っているわけではないからです。詳細を読み直したら新しい名前になり、一覧では古い応答が再利用される、という組合せが残り得ます。

    さらに別の利用者がキャッシュBを通っていた場合、更新要求がBを通らなければ、Bには今回の無効化の契機が届きません。RFC 9111も、状態変更の要求が無効化するのは、その要求が通るキャッシュ内の応答であり、世界全体で適切な応答がすべて無効化される保証ではない、と注意しています。

    更新要求が通ったキャッシュAでは詳細URIだけが無効化対象。一覧と検索はこの規則だけでは保証されず、要求が通らないキャッシュBの三つの応答にも今回の契機は届かない。
    要求対象のURIだけを無効化する独自モデル。追加の無効化、検証、期限切れが起きない条件で、規則が保証する範囲を示しています。

    無効化は、新しい内容への置き換えとは違う

    無効化には、対象URIの保存済み応答を取り除く方法と、「次に送る前には必ず検証する必要がある」と印を付ける方法があります。必ずディスクから物理的に削除するという意味ではありません。

    また、PUTへの応答が成功しても、それが次のGETで返す完全な本文と同じとは限りません。キャッシュ無効化は、古い応答をそのまま再利用してしまうことに歯止めをかける規則です。関連する表示へ新しい本文を一斉に複製する処理とは別です。

    設計や試験では、単にキャッシュのファイルが残っているかどうかを見るだけでは不十分です。次の要求に対して、保存済みの応答を検証せず返したのか、検証したうえで使ったのか、取得し直したのかを区別します。

    Locationがあっても、関連先すべての更新を約束しない

    規格は、エラーではない応答を受けたキャッシュが、要求対象以外のURIも無効化することを認めています。応答のLocationやContent-LocationにあるURIは、その候補です。ただし、対象URIの無効化が必須であるのに対し、こうした追加の無効化は任意です。[1]

    そのため、応答にLocationを付けたという事実だけで、そこをすべてのキャッシュが必ず無効化すると扱うことはできません。実際に使うキャッシュの挙動や、別途定めた連携方式を確認する必要があります。

    この規則による追加の無効化では、要求対象と異なるオリジンのURIを無効化してはいけません。別サイトの保存内容を無関係な応答から消させるような、サービス妨害を防ぐための制約です。単にリンク先だから、同じ画面に載るから、という理由で無効化の範囲が広がるわけではありません。

    読者に見せたい整合性から、試験範囲を決める

    更新後の表示を確かめるなら、少なくとも三つの問いを分けます。更新対象そのものは次の読み取りでどうなるか。同じデータを含む一覧や検索結果はどうなるか。別の利用者や経路のキャッシュには、いつ変更が伝わるか、です。

    一覧の古さを一定時間許容する設計も、保存直後には本人だけ必ず最新の表示を読む設計もあります。どちらが必要かは用途によります。HTTPの対象URIに関する規則だけで、その要件が満たされたとは言えません。関連URIを明示して無効化する仕組みや、適切な再検証方針などを選ぶ場合も、その範囲と失敗時の挙動を確認します。

    今回の模型では、Aの詳細だけが無効化対象になり、ほかの五つにはこの契機による無効化を適用していません。これは、あらゆる製品が必ず五つを古いまま返すという予測ではありません。追加の機能を使わず、要求経路と対象URIだけを見たときに、何を保証できるかを分けるための例です。保存成功の表示から全画面の更新を推定せず、読者が実際にたどる表示と経路に沿って確かめることが大切です。

    出典

    • [1] RFC 9111: HTTP Caching(2022年6月) — 第4.4節「Invalidating Stored Responses」。要求対象の必須無効化、ほかのURIの任意無効化、異なるオリジンの制約、2xx・3xx、経路を通らないキャッシュの限界を参照。三つのURIと二つのキャッシュの図は独自モデルです。
  • Linuxのpidfd、PIDが再利用されても別のプロセスを指さない仕組み

    Linuxのpidfd、PIDが再利用されても別のプロセスを指さない仕組み

    停止したいプロセスのPIDを調べ、少し後でその番号へシグナルを送る。この短い間にも、相手が終了し、同じPIDが別のプロセスに割り当てられる可能性があります。番号が同じでも、相手まで同じとは限りません。

    Linuxのpidfdは、特定のプロセスを指すファイルディスクリプタです。PIDという番号で相手を探し直す代わりに、取得した参照を使い続けます。ただし、いつ・どの相手の参照を取得したかという問題まで、自動で解決するわけではありません。

    簡単にまとめると?

    • 数値のPIDは、元のプロセスが終了して回収された後に再利用されることがあります。古い番号だけを頼りにすると、別の相手へ操作する危険があります。
    • pidfdは取得した特定のプロセスへの安定した参照です。pidfd_send_signalは、同じPIDを後で使う別のプロセスへ参照を切り替えません。
    • 取得前の相手の取り違え、シグナルを送る権限、子プロセスの回収は別に考えます。「終了を監視できる」と「そのプロセスをwaitできる」も同じではありません。

    番号を覚えることと、相手を参照すること

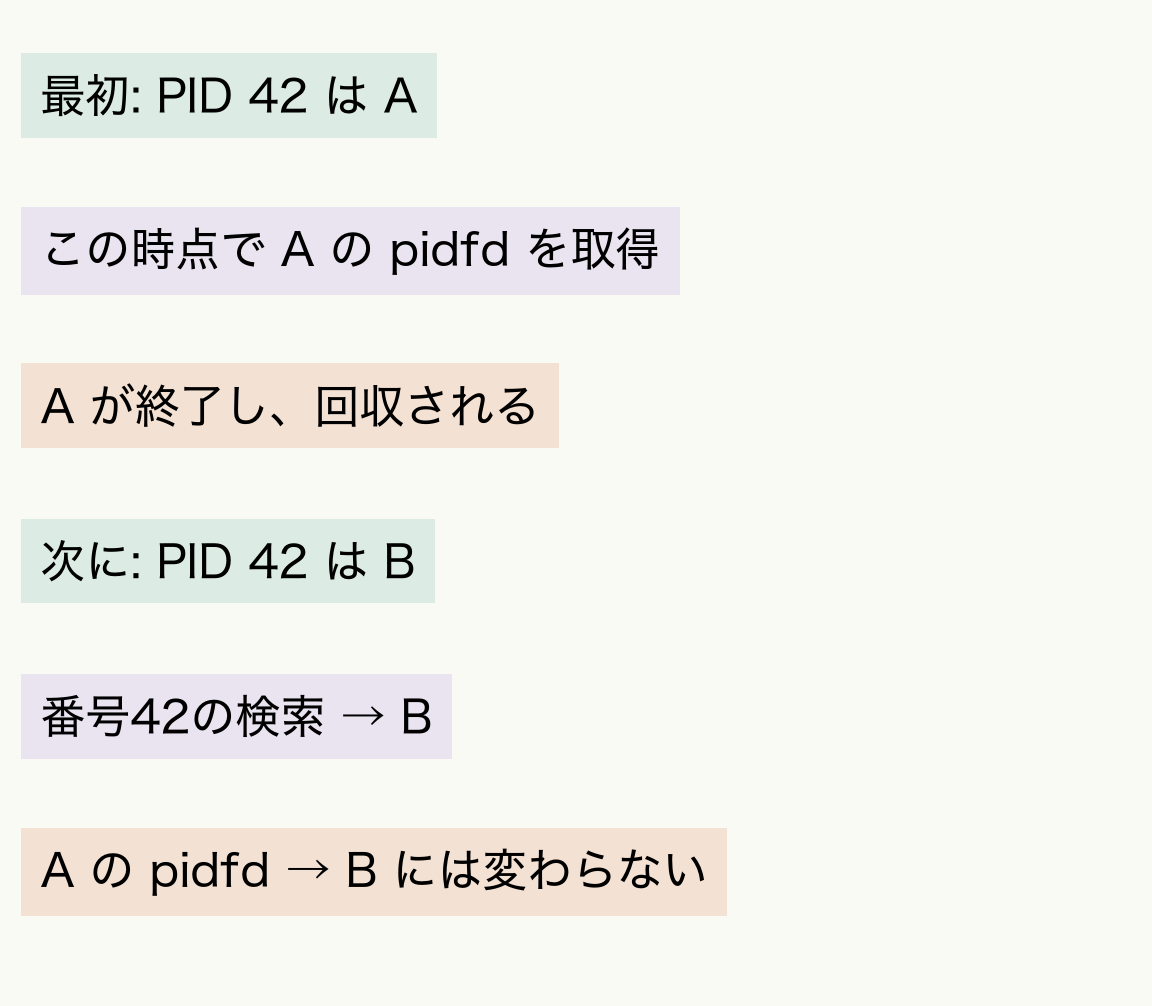
    PIDは、実行中のプロセスを識別する番号です。しかし、その番号が永久に一つのプロセスへ固定されるわけではありません。例えば、監視プログラムがPID 42のプロセスAを確認した後、Aが終了して回収され、プロセスBへ42が再利用されたとします。ここでkill(42, ...)を呼ぶと、操作の宛先はBになります。実際にシグナルが送れるかは権限などにも依存しますが、Aを指すはずだった番号の意味は変わっています。

    pidfd_open(pid, 0)は、呼び出した時点でそのPIDが指すプロセスへのファイルディスクリプタを返します。Aが存在する間にAのpidfdを確保しておけば、その参照が後からBへすり替わることはありません。

    AのPIDが42の間にpidfdを取得。Aが終了して回収された後、BへPID42が再利用されても、元のpidfdはBを指さない。
    PID 42は説明用の番号です。Aを正しく参照できた時点から後の違いを示す状態モデルで、実際のPID割当てを測定したものではありません。

    このpidfdをpidfd_send_signalへ渡すと、参照先のプロセスにシグナルを送れます。参照先が終了して回収済みなら、存在しないことを示すESRCHになります。同じ番号のBを探して送り直す動作にはなりません。

    pidfdを開く前の競合は残る

    ここで大事なのは、「Aのpidfdを取得できている」という前提です。外部から読んだ古いPIDを長時間保持し、その後でpidfd_openを呼んだなら、その時点ですでに番号がBへ再利用されている可能性があります。この場合に取得されるのはBの参照です。

    pidfdは、取得後の参照を安定させる仕組みです。古いPID一覧から本来の相手を推測してくれる仕組みではありません。相手を発見した時点と、安定した参照を得る時点の間に何が起きうるかを確認する必要があります。

    自分がforkした子なら、終了後にも回収待ちのゾンビ状態が残り、その間はPIDが再利用されない性質を使える場合があります。ただし、マニュアルは保証の条件を明示しています。SIGCHLDを明示的にSIG_IGNへ設定していないこと、SA_NOCLDWAITを指定していないこと、別スレッドやハンドラなどが先に子を回収していないことです。

    この保証が成り立たない設計では、生成時にCLONE_PIDFDを使って子と参照を一緒に得る方法が案内されています。単にforkの直後ならいつでも安全、と一般化せず、終了と回収を誰が担当するかまで含めて選びます。

    終了の監視はできても、普通のファイルのようには読めない

    pidfdはpoll、select、epollの監視対象にできます。今回扱うpidfd_open(pid, 0)で取得したプロセス単位の参照では、スレッドグループの最後のスレッドが終了したときに、終了を読み取り可能という形で通知します。マニュアル6.19では、ゾンビ化でEPOLLIN、回収でEPOLLHUPになると説明されています。

    ただし、この「読み取り可能」は、ファイルから終了理由のデータをreadできるという意味ではありません。同マニュアルの実装説明では、pidfdへのreadはEINVALで失敗します。終了状態を得る経路と、イベントループへ通知する経路を分けて理解する必要があります。

    pidfdが呼出し側の子プロセスを指していれば、waitidで待つことができます。任意の他人のプロセスについて、pidfdを持つだけで親のように終了状態を回収できるわけではありません。

    安全な宛先と、操作の成功は別の条件

    pidfdを持っていても、相手にシグナルを送る権限が追加されるわけではありません。権限がなければEPERMとなり、PID名前空間に関する条件もあります。また、シグナル送信の成功を、相手の後処理や終了まで完了した証拠とみなさないことも大切です。終了が必要な操作なら、その後の終了通知を別に確認します。

    監視プログラムを見直すなら、まず「相手を何で識別しているか」、次に「安定した参照をいつ取得するか」、最後に「送信・終了検知・子の回収をそれぞれどう確認するか」を分けて追うと、競合が隠れる場所を見つけやすくなります。

    pidfd_openはLinux 5.3、pidfd_send_signalはLinux 5.1で導入されています。新しいフラグにはそれぞれ追加時期があり、この記事はflagsを0としたプロセス単位の扱いを中心にしています。スレッド単位のPIDFD_THREADや、プロセスグループへ送る新しいフラグまで同じ条件だとみなさず、利用するカーネルの対応を確認してください。

    出典

  • Linuxのsignalfd、送ったシグナルの数がそのまま届くとは限らない

    Linuxのsignalfd、送ったシグナルの数がそのまま届くとは限らない

    終了や設定の再読込みを知らせるシグナルを、ソケットと同じイベントループで扱いたい。Linuxのsignalfdは、そのためにシグナルをファイルディスクリプタから読み取れるようにする仕組みです。ただし、読み取り口ができても、シグナルが一件ずつ保存されるメッセージ列に変わるわけではありません。

    特に同じ標準シグナルを何度も送る設計では、「三回送ったから三回処理できる」という期待が崩れます。何が読み取れ、何が失われるのかを、保留状態から見ていきます。

    簡単にまとめると?

    • signalfdは、保留中の対象シグナルを構造体として読み取る入口です。通常は対象をブロックし、既定の動作へ渡らないようにします。
    • 同じ標準シグナルが保留中に繰り返し発生しても、保留は一つです。後からsignalfdで読んでも、発生回数は復元できません。
    • 「状態を確認してほしい」という合図と、「三件の仕事を保存する」という用途を分けます。件数や内容が必要なら、それを保持する別の仕組みが必要です。

    保留とは、まだ受け取っていない合図

    シグナルは、プロセスやスレッドに出来事を知らせる仕組みです。シグナルマスクは、そのスレッドがいま受け取らずにブロックする種類を指定します。発生してから受け取られるまでの状態が「保留(pending)」です。

    signalfdには、読み取りたいシグナルの集合を指定します。しかし、集合を渡すだけでは、それらのシグナルをブロックしたことにはなりません。通常は単一スレッドならsigprocmask、複数スレッドならpthread_sigmaskなどでマスクを整え、シグナルハンドラや既定の動作に先に渡らないようにします。

    プロセス全体へ送られたシグナルは、ブロックしていない別のスレッドに渡る場合があります。イベントループのスレッドだけを設定して「すべてsignalfdに来る」と考えるのは危険です。また、SIGKILLとSIGSTOPはsignalfdで受け取れません。

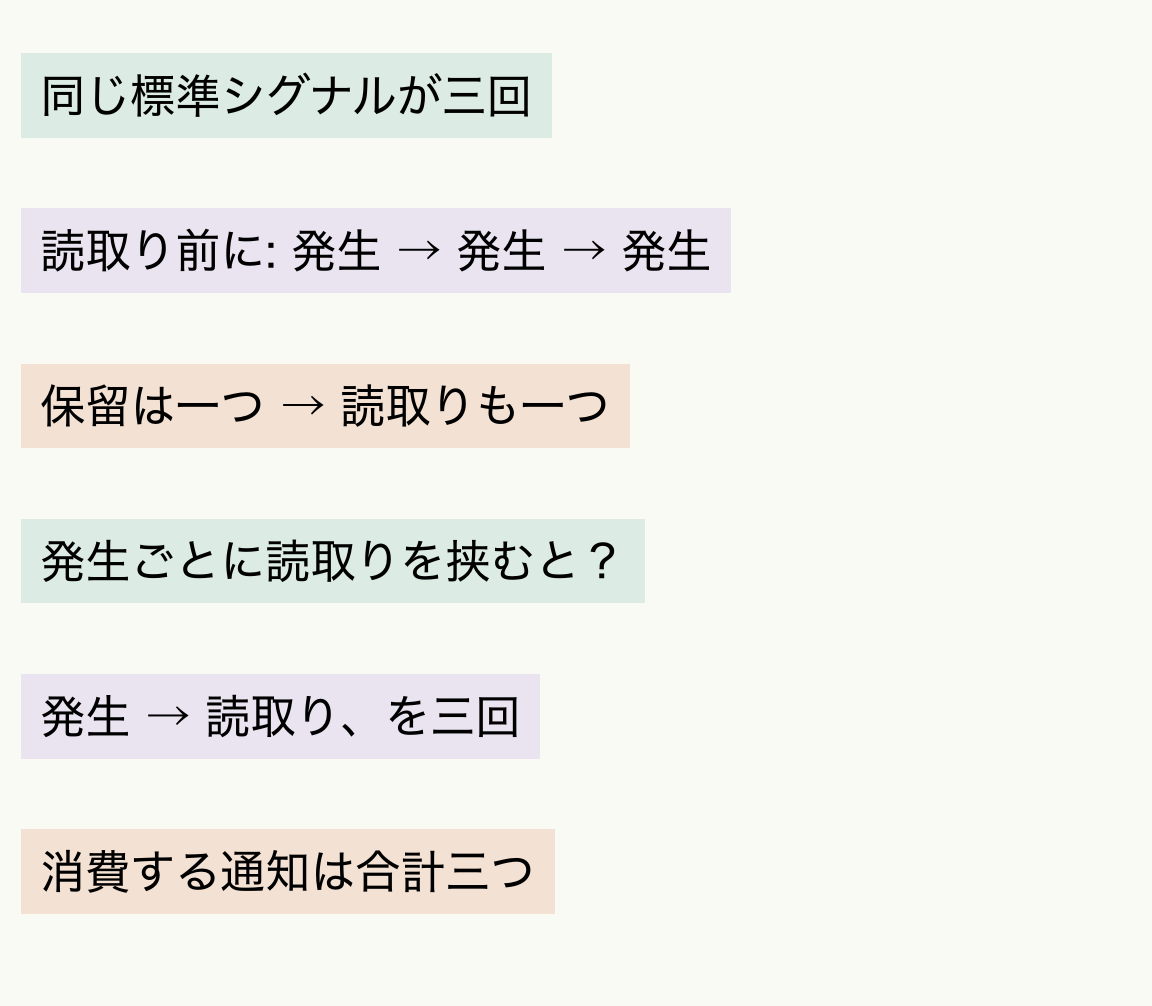
    三回送っても、一つしか保留されない場合

    標準シグナルのSIGUSR1を使う例を考えます。受信側はこれをブロックしており、途中でsignalfdから読み取ったり、他の経路で消費したりしないとします。

    1. 一回目のSIGUSR1が発生すると、「SIGUSR1が保留中」という状態になります。
    2. そのまま二回目、三回目が発生しても、標準シグナルは同じ種類の通知を列に積みません。保留中という状態が続きます。
    3. その後signalfdで読むと、この種類について取り出せる通知は一つです。
    読み取らずに同じ標準シグナルが三回発生すると保留は一つ。毎回読み取りを挟む三回なら、三つの通知をそれぞれ消費できる。
    同じSIGUSR1だけを扱い、他の受信経路がない場合の状態モデル。時刻やLinuxでの実測結果を表す図ではありません。

    一方、一回発生するたびに読み取って保留を解消し、その後に次が発生するなら、合計三回取り出せます。違いは送信回数だけでなく、発生と消費がどう重なったかにあります。負荷が軽い試験では三回届いていても、受信側が忙しくなると一回にまとまることがあります。

    すでに同じ標準シグナルが保留されている場合、付随するsiginfo_tの情報も後の発生で上書きされません。最初の情報が残ります。「最後の送信者の情報が届く」「回数だけ後で数え直せる」とは考えられません。

    readの戻り値と、シグナルの件数も分ける

    signalfdのreadは、signalfd_siginfoという構造体を一つ以上返します。読み取りバッファには少なくとも一つの構造体が入る大きさが必要で、保留中の通知のうちバッファに入る分を取り出します。戻り値はバイト数です。構造体の個数は、このバイト数を構造体のサイズで割って求めます。

    ただし、それで分かるのは今回読み取れた通知の個数であって、過去の全発生回数ではありません。読み取りによって通知は消費されるため、同じ通知が後でハンドラやsigwaitinfoへもう一度渡ることもありません。

    対象の通知が保留されていなければ、通常の読み取りは待ちます。SFD_NONBLOCKを指定した場合は、待つ代わりにEAGAINになります。pollやepollが示す読み取り可能という状態も、「何件の仕事が完了したか」ではなく、取り出せる通知があることを知らせます。

    合図として使うか、仕事の記録に使うか

    設定ファイルの再読込みを促す用途なら、複数の合図が一つにまとまっても、受信時点の設定を改めて読む設計が考えられます。ここで必要なのは、「何か変わったかもしれないので、実際の状態を確認する」というきっかけです。

    対して、一回の通知を一件の注文や一回の課金処理と対応させる設計では、合流がそのまま取りこぼしになります。個々の仕事はキューなどに保存し、シグナルはそのキューを見に行く合図として使う、という役割分担が必要です。キューの排出と新しい合図の発生が競合する場面も含めて設計します。

    リアルタイムシグナルは複数の発生をキューに保持できますが、無制限ではありません。標準シグナルの性質を変える設定としてsignalfdを使うことはできず、リアルタイムシグナルを選ぶ場合にも保留数の制約や送信失敗への対応が残ります。

    また、signalfdの読み取りで受け取れるのは、呼出しスレッド自身へ向けられた通知と、プロセスへ向けられた通知です。別スレッドだけに向けたシグナルを、監視用スレッドから横取りする機能ではありません。種類、宛先、マスク、保持したい情報を分けると、signalfdに任せる範囲が明確になります。

    出典

  • Linuxのtimerfd、期限が来た回数と処理した回数は違う

    Linuxのtimerfd、期限が来た回数と処理した回数は違う

    1秒ごとに実行したい処理があるのに、別の仕事で3秒以上手が離せなかった。次にタイマーを確認したとき、何回分の期限が過ぎていたかを知りたい場合があります。Linuxのtimerfdは、タイマーをファイルディスクリプターとして待ち合わせ、読み取りで期限到来の回数を受け取る仕組みです。ただし、その回数は仕事が実行された回数ではありません。

    簡単にまとめると?

    • 周期タイマーのtimerfdを読むと、前回の成功した読み取り、または設定変更以降に期限が来た回数を受け取ります。
    • 1秒周期を3.4秒で初めて読んで値3を得ても、仕事を3回実行した証明にはなりません。
    • 遅れた分を全部処理するか、まとめて最新状態へ追いつくかは、用途に応じてアプリケーション側で決めます。

    タイマーを、ほかの入出力と一緒に待つ

    timerfd_createでタイマーを作ると、ファイルディスクリプターが返ります。これはソケットなどと同じく、pollやepollの待機対象にできます。通信の到着とタイマーの期限を一つのイベントループで扱えるため、時間待ちのためだけに別の処理経路を用意せずに済みます。

    期限を決めるのはtimerfd_settimeです。最初にいつ期限が来るかをit_valueに、繰り返しの間隔をit_intervalに指定します。最初を1秒後、間隔を1秒にすれば、その後も1秒ごとの期限を設定できます。it_intervalが0なら一度だけのタイマーです。一方、it_valueを0にするとタイマーを停止します。「0秒後にすぐ発火させる」という指定ではありません。

    期限が来れば読み取り可能になりますが、読み取り可能であることと、その場でアプリケーションがCPUを使えることは別です。ほかの処理が長引く場合や、スケジューラーが別の仕事を動かしている場合には、タイマーを読む時刻が遅れます。timerfdは、その遅れをなくす仕組みではありません。

    3.4秒で読んだ値3は、過ぎた期限を数えている

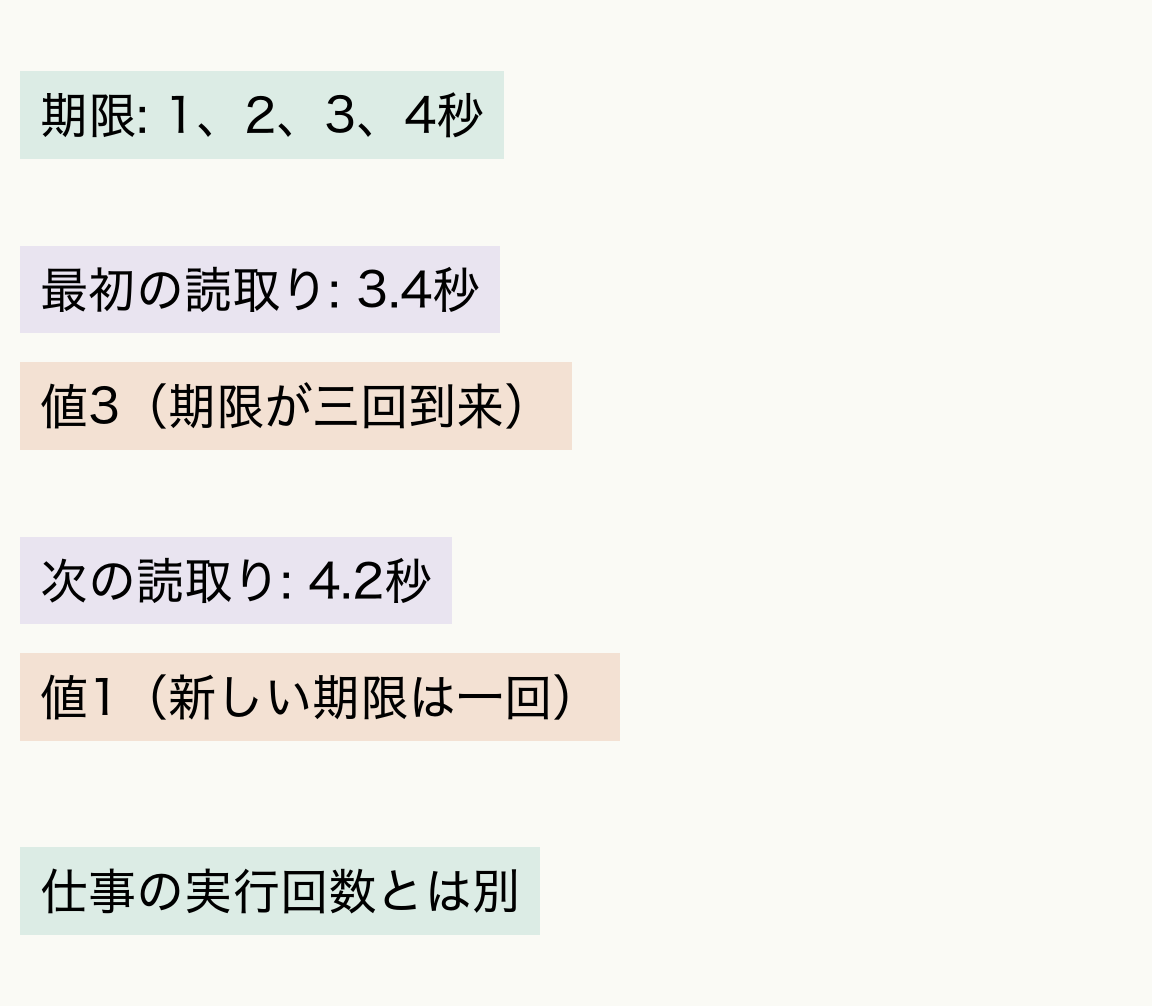
    説明のため、時刻0に設定し、最初の期限が1秒、以後も1秒間隔になる理想的なタイマーを考えます。途中で読み取りも再設定もしなければ、3.4秒の時点では1秒、2秒、3秒の三つの期限が過ぎています。このとき読む値は3です。

    この読み取りが成功した後、4.2秒にもう一度読めば、その間に新たに過ぎた4秒の期限を数え、値1を受け取ります。最初からの合計4ではありません。読み取りは、前回の成功した読み取り、またはtimerfd_settimeによる設定変更からの期限到来回数を受け取ります。

    期限は1、2、3、4秒。最初の読み取りが3.4秒なら値3、次が4.2秒なら値1。読み取った値は期限到来回数で、仕事の実行回数ではない。
    1秒周期で途中の再設定がない説明用の時刻列。Linux上の実測や、読み取り時刻の精度保証ではない。

    readの戻り値と、読み取った整数にも違いがあります。成功したreadは8バイトを読み取ったことを戻り値8で表し、その8バイトの符号なし64ビット整数に期限到来回数が入ります。上の最初の例では、戻り値は8、受け取った整数は3です。

    期限がまだ来ていなければ、通常の読み取りは待機します。TFD_NONBLOCKで作った非ブロッキングのtimerfdなら、待たずにEAGAINになります。これは「仕事が終わった」という知らせでも、読み出せる値0を受け取ったという意味でもありません。通常の読み取りに必要な8バイトより小さいバッファを渡すと、EINVALになります。

    遅れた三回分を、どう扱うか

    値3を読んだ後の方針には、少なくとも二つの選択肢があります。一つは、期限一回ごとに対応する処理を三回進める方法です。一定刻みのシミュレーションなど、各ステップに意味がある場合には候補になります。ただし、一回の処理に長い時間がかかる状況では、追いつくための処理中にも次の期限が来ます。回数だけを見て無制限に追いかけると、遅れが広がる可能性があります。

    もう一つは、複数の期限をまとめ、最新の状態を一度だけ更新する方法です。画面に現在時刻を表示するなら、見逃した三つの古い表示を順に描くより、現在の表示を作るほうが目的に合うことがあります。この場合、受け取った期限到来回数3と、実際の更新回数1は意図して異なります。

    センサー記録では、過去の期限が三つ来たことが分かっても、その三時点の測定値を後から取り出せるとは限りません。測定自体をしていなければ、timerfdの回数は失われたデータを復元しません。期限の遅れを記録する指標と、収集できたデータ件数を分けて管理する必要があります。

    周期の基準と、仕事を動かす時刻を分ける

    処理が終わってから毎回「1秒待つ」方法では、処理にかかった時間も次の開始までの間隔へ足されます。最初の期限と周期を設定したtimerfdでは、周期の期限を継続させたまま、読み取りが遅れた回数を受け取れます。ただし、その結果として仕事が正確に1秒間隔で実行されるわけではありません。期限の列と実行の列は別です。

    初回の期限は、通常は設定時の時計の値からの相対時間です。TFD_TIMER_ABSTIMEを指定すると、選んだ時計上の絶対値として扱います。CLOCK_MONOTONICを選んだ場合、その絶対値はカレンダーの日付や時刻ではありません。起点を固定して次の期限を設計したい場合にも、どの時計の値を使っているかをそろえる必要があります。

    CLOCK_MONOTONICはシステムのサスペンド中の時間を数えません。サスペンドを含む経過時間で期限を考えるならCLOCK_BOOTTIMEが候補になります。ただし、サスペンド中の時間を数えることと、眠っているシステムを起こすことも別です。後者にはALARM系の時計と、その利用に必要な権限という別の条件があります。

    timerfdを選ぶときは、ほかの入出力と一緒に待ちたいか、遅れた期限を数える必要があるか、その回数をどう処理へ結びつけるかを確認すると判断しやすくなります。期限到来、読み取り、仕事の開始、仕事の完了を分けて記録すれば、どこで遅れが生じたかも追いやすくなります。

    出典

    図と時刻列は仕様を説明するための独自作成です。実際のLinux呼出し、負荷時の遅延、リアルタイム性能を測定した結果ではありません。

  • Linuxのeventfd、通知を足し合わせるカウンターと読み取り方

    Linuxのeventfd、通知を足し合わせるカウンターと読み取り方

    別のスレッドで仕事が増えたことを、待機中の処理へ伝えたい場合があります。Linuxのeventfdは、そうした通知をファイルディスクリプターとして扱う仕組みです。ただし、書き込んだ内容を順番に保存するメッセージキューではありません。中にあるのは一つのカウンターで、複数の通知を足し合わせて受け取ることができます。

    簡単にまとめると?

    • 通常のeventfdでは、書き込んだ整数が加算され、読み取り時に合計が返ってカウンターが0になります。
    • EFD_SEMAPHOREを指定すると、読み取りごとに値1を返し、カウンターを1減らします。書込みの区切りが復元されるわけではありません。
    • カウンター値は書込み回数とは限りません。仕事の内容や順序、失敗・完了の状態は別のデータ構造で管理します。

    足されるのは、呼び出し回数ではなく整数の値

    eventfdを作ると、カーネル内に符号なし64ビット整数のカウンターができます。作成時のinitvalが初期値です。返されたファイルディスクリプターを通じて、readとwriteでそのカウンターを扱います。

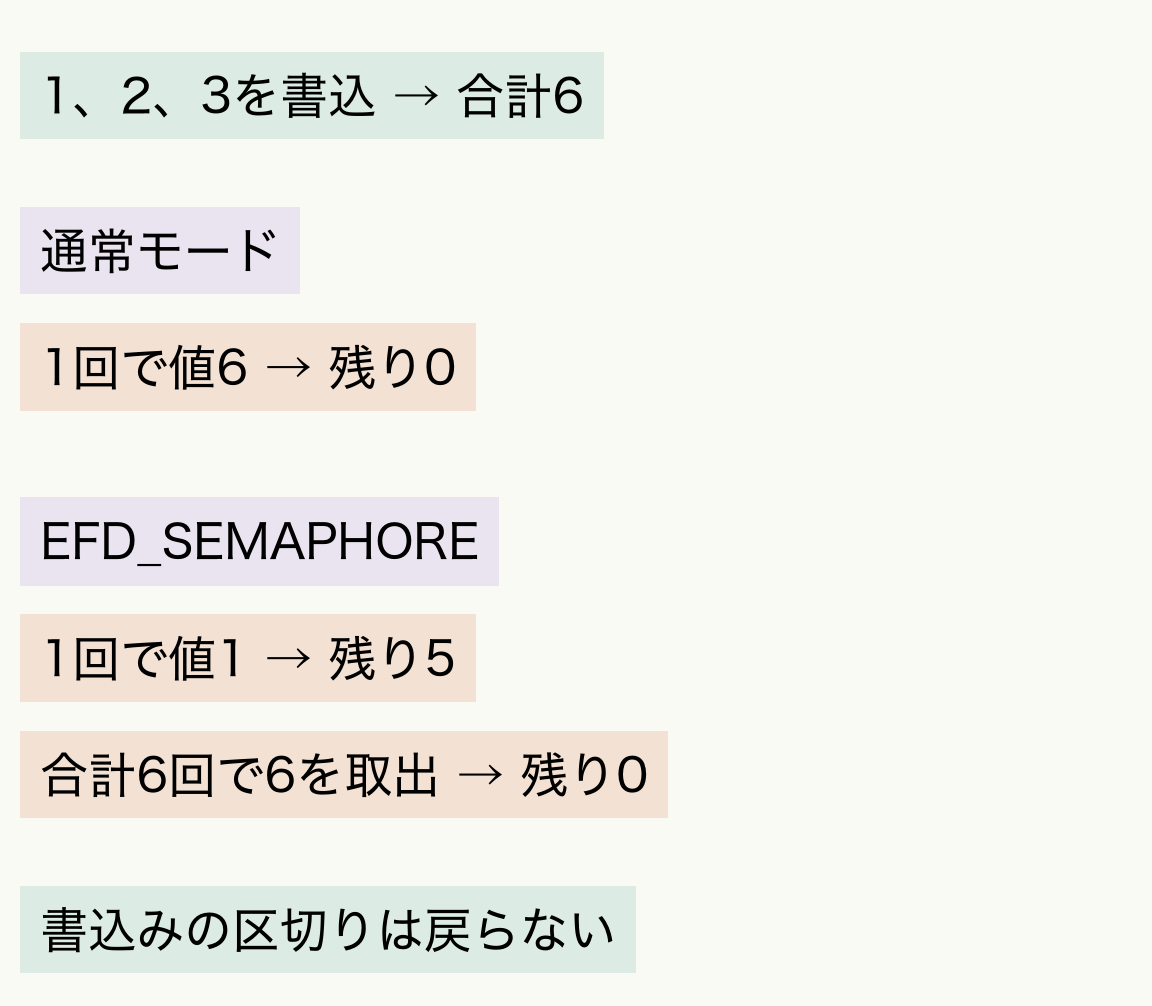
    初期値0に対し、値1、2、3を順に書き込んだとします。途中に読み取りがなければ、カウンターは1、3、6と増えます。書込みは3回ですが、値は6です。「1回の通知で必ず1を書く」というアプリケーション側の約束があって初めて、値と通知件数が一致します。

    その値が何を数えているかも、eventfd自身は知りません。未処理の仕事数、まとめて追加された項目数、単に目を覚ます必要があるという合図など、意味は利用側が決めます。ファイルディスクリプターが読めるようになったことを、仕事が正常に終わった証明として使うこともできません。

    通常モードとセマフォモードで、減り方が違う

    EFD_SEMAPHOREを指定しない通常モードでは、カウンターが0でないときに読み取ると、その値を受け取り、カウンターは0へ戻ります。上の例なら、読み取りで6を受け取ります。値1、2、3という三つの記録が順に出てくるのではありません。

    EFD_SEMAPHOREを指定した場合は、カウンターが0でない限り、一回の読み取りで値1を受け取り、内部の値が1だけ減ります。6がたまっていれば、ほかの書込みや読取りがない条件で、1を6回取り出せます。このモードも、元の三つの書込みを再現する仕組みではありません。

    初期値0へ1、2、3を書き込むと合計6。通常モードは1回で6を受け取り残り0。EFD_SEMAPHOREは1回で1を受け取り残り5、同条件で合計6回読むと0。どちらも元の書込み1、2、3を復元しない。
    途中に別の読み書きが入らない説明用モデル。同じ合計6を受け取っても、元の仕事の内訳や順序までは分からない。

    読み取りで受け取る整数の値と、readの戻り値にも注意が必要です。成功したreadは8バイトを返し、その8バイトの中にカウンター値または1が入っています。たとえば「readが8を返した」ことを、通知が8件あったことと混同してはいけません。マニュアルでは、8バイトより小さい読取り領域はEINVALとなり、整数はホストのバイト順で渡されるとされています。

    0は終わりではなく、今は蓄積がない状態

    カウンターが0のとき、通常のブロッキング読み取りは、値が増えるまで待ちます。EFD_NONBLOCKなどで非ブロッキングにしてあれば、EAGAINを返します。パイプのEOFのように「送り手がすべて閉じた」と知らせる意味ではありません。

    終了を通知したいなら、終了状態を別に保存してから待機中の処理を起こす、といったアプリケーションの規約が必要です。同じeventfdを共有する読み手が複数いる場合は、読み取りによる減算も同じカウンターへ作用します。ある読み手が6を受け取った後に、別の読み手も6を受け取れるとは限りません。

    pollやepollでは、カウンターが0より大きいと読み取り可能として扱われます。ソケットからの入力と、別スレッドからの通知を、同じ待機の仕組みにまとめられるのが利点です。ただし、epollが何回イベントを返すかと、eventfdに加えた値の合計は別に扱います。

    カウンターには上限があり、書込みも失敗し得る

    ユーザー空間からの通常のwriteで保持できる最大値は、符号なし64ビット整数の最大値から1を引いた値、つまり264−2です。加算するとその値を超える場合、ブロッキングなら読み取りを待ち、非ブロッキングならEAGAINとなります。上限を超えて自動的に0へ戻るカウンターとして使うことはできません。

    また、264−1という値そのものを書き込むことはEINVALになります。実装では、writeが成功したかを確かめずに「通知済み」と記録しないことが重要です。この説明はユーザー空間からの通常の読み書きを対象とし、マニュアルにあるカーネル非同期I/Oによる特殊なオーバーフロー状態は含めていません。

    通知と仕事本体を、別々に管理する

    たとえば、共有キューに画像処理の仕事を追加し、eventfdで担当スレッドを起こす構成を考えます。画像の場所や処理パラメーターはキュー側にあり、eventfdはキューを調べるきっかけを渡します。どの仕事を誰が取り出したか、いつ終わったか、失敗した仕事を戻すかは、キューと状態管理の役割です。

    キューへの追加と通知の順序、複数スレッドが触るデータの同期、通知を受け取ってから再び待つまでの競合も設計対象になります。eventfdを使ったというだけで、共有メモリーの更新がすべて正しく同期されるとはみなしません。ロックや適切な原子操作など、キューに合った同期方式を合わせます。

    数を集約した合図だけで足りるならeventfdは候補になります。送り手ごとの情報やメッセージの境界が必要なら、別のキューや通信方式が必要です。選ぶ前に「合計だけが分かればよいか」「一件ずつの内容や順番を残す必要があるか」を決めると、通常モードとセマフォモードの違いも使い分けやすくなります。

    この記事はLinux man-pages 6.19のeventfdの説明と、独自の整数カウンターモデルに基づきます。図はカウンターの加減算を検査したもので、Linuxカーネル上の負荷試験や、特定の並行キューの正しさを実証したものではありません。

    出典

  • 量子ゼノ効果、測定を増やすと変化が抑えられる条件

    量子ゼノ効果、測定を増やすと変化が抑えられる条件

    量子ビットをある状態から別の状態へ動かしている途中で、短い間隔で状態を測ると、その変化が抑えられる場合があります。これが量子ゼノ効果です。ただし、画面を何度も見るだけで物理系が止まるという意味ではありません。どの状態を区別する測定を、どの間隔で行うかが結果を決めます。

    簡単にまとめると?

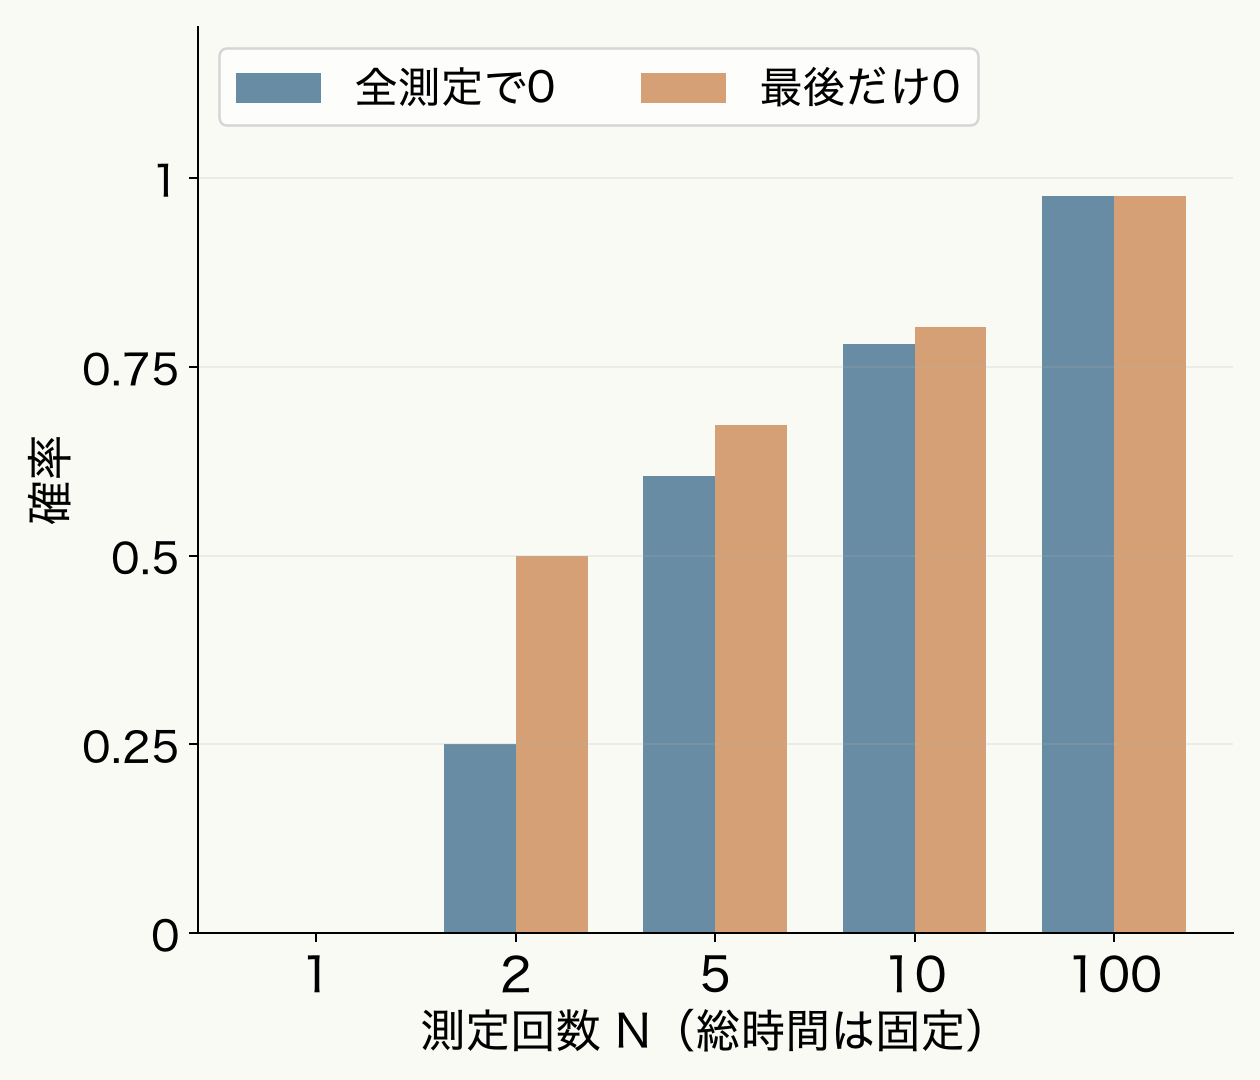
    • 理想的な二準位モデルでは、総時間を固定したまま初期状態を確かめる測定を増やすと、すべての測定で初期状態が得られる確率が高くなります。
    • 「途中もずっと0だった確率」と「最後だけ0を得る確率」は別です。途中で1になってから戻る記録を、前者へ混ぜません。
    • 測定は物理的な操作です。所要時間、誤差、環境との相互作用を無視した極限を、そのまま実機の保証にはできません。

    変化する時間を、測定で区切る

    二つの基底状態を0と1と呼び、最初は0に準備します。測定しなければ、決めた総時間Tの後に1へ移るような一定の回転をかけます。途中の状態には0と1の振幅が含まれ、測定で0か1を得る確率は、その振幅の大きさの二乗から決まります。

    ここでは、時間Δtの発展で0に残る振幅をcos(ΩΔt)と書くモデルを使います。Ωはこの式で定義した回転の強さで、総時間にはΩT=π/2を選びます。0から出発してTだけ発展すると、0を得る確率はcos²(π/2)=0です。Tは同じまま、その間をN等分して各区切りで0と1を区別する理想的な射影測定を入れます。

    射影測定とは、この例では、結果が0なら測定後の状態を0、1なら1として扱う測定モデルです。測定結果を人が読むことではなく、系と測定装置との物理的な関わりを理想化しています。単に同じ計算結果を画面へ何度も表示することとは異なります。

    一回の小さな変化を、N回つなぐ

    最初の区間T/Nを過ごした後に0を得る確率はcos²(π/2N)です。0という結果を得れば、次の区間も0から始まります。そのため、N回の結果がすべて0になる確率は、同じ条件付き確率をN回掛けたP全0=[cos²(π/2N)]Nになります。

    これは「0を得た記録だけを選んだから100%だった」という数値ではありません。最初に準備したすべての試行を分母とし、その中で全測定結果が0だった記録の割合です。一度でも1を得た試行は、全0の成功には含めません。

    短い時間では、0から離れる確率は時間の二乗に比例する形になります。区間を短くすると、一回あたりの変化はおよそ1/N²まで小さくなり、それをN回積み重ねても全体の失敗確率は小さくなります。測定なしの連続した振幅の発展を、測定で状態を区切った確率の積へ変えることが、このモデルで変化が抑えられる理由です。

    「全部0」と「最後が0」を並べる

    N=2なら、各区間で0に残る確率は1/2です。全0の記録は00だけなので確率は1/4になります。一方、最後が0の記録には00に加えて10もあります。途中で1を得てから0へ戻る場合を含むため、最後が0の確率は1/2です。同じ実験の数字でも、集計する条件が違います。

    総回転量ΩTをπ/2に固定した理想モデル。測定回数Nが2では全結果0の確率25.0%、最後だけ0は50.0%。Nを10、100へ増やすと二つの確率はともに1へ近づくが、有限回では区別が残る。
    同じ総時間Tに対する独自計算。青は全測定結果が0、橙は途中の結果を問わず最後だけ0の確率。実機の測定値ではない。

    計算では、各区間の二次元の状態変化と測定を順に適用する方法を使い、全0については上の式と照合しました。最後だけ0の確率については、0から1へ移る記録も含め、測定で0と1の間のコヒーレンスを取り除いた密度行列を次の区間へ渡しています。密度行列は、結果ごとの確率をまとめて扱う表現です。

    N=10で全0の確率は約78.1%、N=100では約97.6%になります。測定回数だけでなく、総時間と回転の強さを固定している点が比較の条件です。測定を増やすたびに総時間まで長くすれば、ここで比べたものとは別の実験になります。

    測る内容が変われば、残る動きも変わる

    今回の測定は、初期状態0という一つの状態にいるかを確かめます。これに対して、複数の状態をまとめた領域の内側にいるかだけを測ると、その領域から外への移り方は抑えられても、領域の中では変化が続く場合があります。量子ゼノダイナミクスと呼ばれる、より広い扱いです。

    したがって「測定を増やすと、すべてが動かなくなる」という説明では、何を区別する測定かが抜け落ちます。量子回路の測定基底や、制御したい状態の集合を変えた場合は、同じ計算式がそのまま使えるとは限りません。

    実機で確かめるときの比較条件

    この例では、測定は瞬時で完全、測定の間の発展は一定、環境による緩和や測定の読み違いはないと仮定しました。実際には測定時間が必要で、測定装置との結合や環境の性質も結果へ影響します。繰り返すほど必ず遅くなるとは限らず、条件によっては変化が速まる反ゼノ効果もあります。

    測定頻度の比較を見るときは、総時間が同じか、測定時間を含めたか、どの結果を残したか、測定誤差を補正したかを確認します。成功した記録だけの状態と、その記録を得る確率も分けて読みます。この区別があれば、理想モデルの高い確率と、実機で繰り返し利用できる制御の性能を混同せずに比べられます。

    今回は、下記レビューの二準位モデルと測定の条件を基に、総回転量と測定回数を明示して計算しました。理想的な射影測定による変化の抑制を理解する例であり、測定装置の実装、性能向上の実証、誤り訂正の代替を示すものではありません。

    出典

  • HTTPの303と307、POSTの後で結果を読むか、同じ要求を送るか

    HTTPの303と307、POSTの後で結果を読むか、同じ要求を送るか

    フォームを送った後、画面が別のURLへ移ることがあります。同じ「移動」に見えても、送信した内容を移動先へもう一度送るのか、処理結果のページを読み取るのかで、サーバーが受け取る要求は変わります。HTTPの303と307は、この違いを考える手がかりです。

    簡単にまとめると?

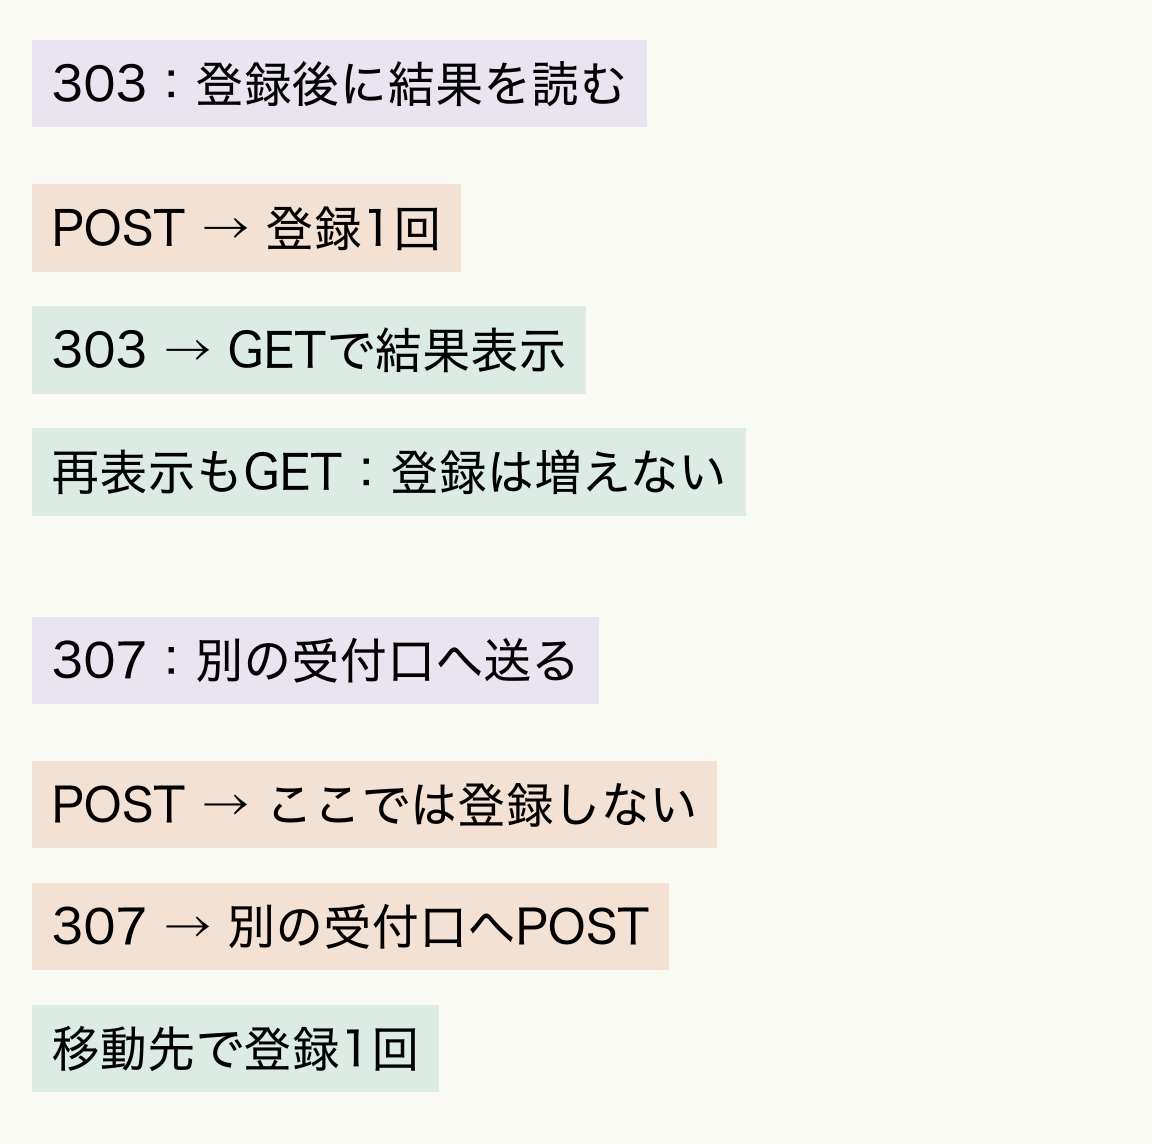
    • 303は、元の要求への間接的な回答を別の資源から取得する案内です。POST後に結果ページをGETする設計で使えます。
    • 307を自動追跡するとき、クライアントは元のメソッドを変更しません。POSTをGETへ置き換えるための応答ではありません。
    • 303に変えただけで二重登録が防げるわけではありません。表示の再取得と、処理そのものの重複対策を分けます。

    Locationは行き先、ステータスコードは移り方

    メソッドは、要求が何をしたいかを示します。GETは資源の表現を取得するために使い、POSTは送った内容を対象に処理してもらうために使います。リダイレクト応答に含まれるLocationは次の行き先を示しますが、URLだけでは、次の要求で何を送るかまでは説明できません。

    たとえば教材サイトで、受講希望をPOST /applicationsへ送ったとします。次のURLが /applications/42 であっても、そこへ同じ申込内容を送るのか、受け付けた結果を読み出すのかは別の設計です。この二つを同じものとして扱うと、画面では正常に移動しているのに、サーバー側では予期しない処理が起きることがあります。

    303で、処理の要求と結果の表示を分ける

    RFC 9110の303 See Otherは、別の資源を通じて元の要求への間接的な回答を提供する意味を持ちます。HTTPでは、その資源をGETまたはHEADで取得できます。この記事では、POSTの後にGETで結果の本文を読む、一般的な使い方を例にします。303はPOSTだけに使えるコードではありません。

    教材サイトが申込を受け付け、識別番号42を割り当てた後で、303とLocation: /applications/42を返すとします。クライアントはそのページをGETし、受付番号や入力内容を表示します。POSTで処理を依頼する段階と、GETで結果を見る段階が分かれます。取得先は、元のURLと同じ資源だと見なしてよい、という意味ではありません。

    この流れでは、結果ページをもう一度読み出す操作はGETの繰り返しになります。ただし、その性質を生かすには、結果表示用のGETを、申込の追加登録を行う処理にしてはいけません。実装上の副作用を伴うGETを作っておいて、303だから安全だと説明することはできません。

    307では、同じ種類の要求を別の場所へ送る

    307 Temporary Redirectは一時的な移動を示し、自動で移動を追跡するときにメソッドを変えないことを求めます。元がPOSTなら、移動後もPOSTです。たとえば、まだ受け付けていない申込を別の受付口へ案内する設計なら、こちらの意味が合う場合があります。

    このとき重要なのは、最初の受付口が実際に何をしたかです。すでに登録を確定した後で、同じ申込を登録する別の受付口へ307で案内すれば、移動先でも処理される可能性があります。307は「前のサーバーでは処理されていない」という証明ではありません。図では、307側の最初の受付口は保存せず、移動先だけが保存する条件を明示しています。

    POST後の二つの設計例。303では最初に登録して結果ページをGETする。307では最初の受付口では登録せず、別の受付口へPOSTする。どちらも登録回数1となる例だが、登録を行う場所は異なる。
    同じPOSTから始まる二つの説明用モデル。登録回数は図の実装条件から数えたもので、ステータスコード自体の重複防止能力を示す値ではない。

    実際のクライアントでは、自動追跡を無効にしている場合や、送信元のストリームを再び読めず要求本文を再送できない場合もあります。307を返せば、すべてのクライアントが必ず同じ内容を送り直して成功する、とは扱えません。実装対象のクライアントと、再送可能な本文の条件を確認します。

    302の歴史的な挙動と混同しない

    302 Foundも一時的な移動を表しますが、歴史的な理由からPOSTをGETへ変えることが認められています。したがって、「一時移動だから302でPOSTも必ず維持できる」と考えると、クライアント間の違いが問題になります。メソッドを維持する意図を伝えるなら307、処理の結果を別の資源から取得してもらうなら303、というように、移動後の意味から選びます。

    恒久的な移動でも同様の区別があり、308は自動追跡時にメソッドを変えないコードです。一時か恒久かという軸と、POSTをどう扱うかという軸を分けて読むと、コードの数字だけを暗記する必要が減ります。

    二重登録の対策は、画面遷移より手前にも必要

    303を使う設計でも、最初のPOSTが二度届く場合は残ります。送信ボタンを二回押した、通信が途切れて受付結果を受け取れなかった、といった場面です。最初のPOSTをサーバーが処理した後で応答が失われると、クライアント側の「失敗したように見える」と、サーバー側の「登録済み」が食い違います。

    この問題には、同じ申込を識別する値と処理済みの記録を結び付け、重複を検出するなど、用途に応じた仕組みが必要です。図の303側で、GETを二回に増やしても登録回数が1なのは、GETが読み取りだけという条件があるからです。最初のPOSTを二回に増やし、重複検出を置かなければ、登録回数は2になります。303の有無だけでは変わりません。

    移動先の安全性も別に確認します。外部から渡された任意のURLをそのままLocationへ入れる設計や、別のホストへ認証情報を引き継ぐ前提は、今回の単純なモデルには含めていません。移動を許す宛先、メソッド、送信本文、認証情報の扱いを、クライアントとサーバーの双方で確認します。

    今回の比較はRFC 9110の意味と独自の要求列を整理したものです。ブラウザー各製品の実測、ネットワーク障害下の完全な再送制御、実際の登録サービスの保証を示すものではありません。「移動先で結果を読むのか、同じ処理を依頼するのか」を先に決めると、303と307を選ぶ理由が明確になります。

    出典

  • epollのエッジトリガー、読み残したデータがあっても待ち続ける理由

    epollのエッジトリガー、読み残したデータがあっても待ち続ける理由

    接続をたくさん扱うサーバーでは、どの接続からデータを読めるかを調べる処理が必要です。Linuxのepollは、その入口になる通知機構です。ただし「読めるという通知を受け取った」と「届いたデータを読み終えた」は別の出来事です。特にエッジトリガー方式では、少しだけ読んですぐ通知待ちに戻ると、読み残しがあるのに処理が止まる場合があります。

    簡単にまとめると?

    • レベルトリガーは読み出せる状態が続いていることを扱い、エッジトリガーは状態の変化に着目します。通知の回数を、受信したメッセージ数と同じには扱えません。
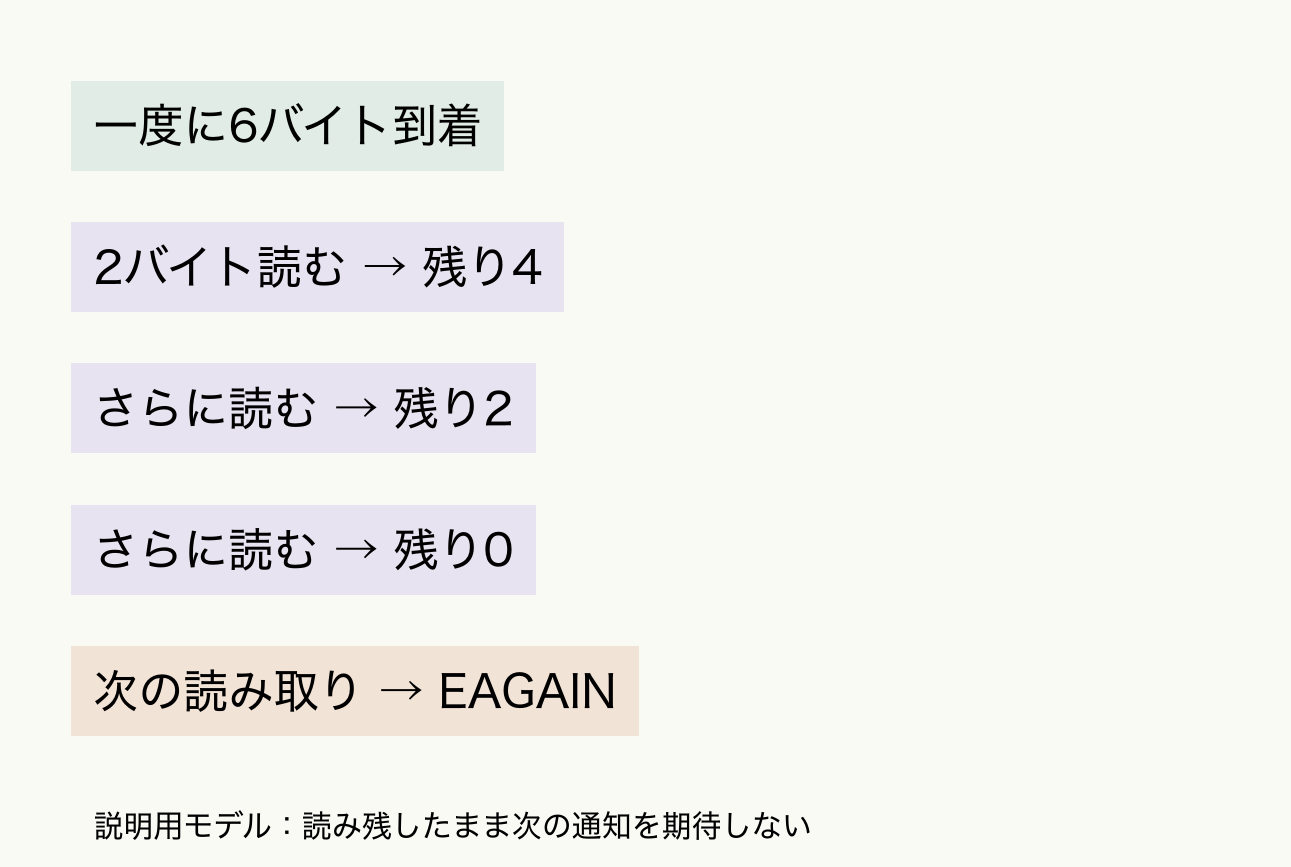
    • EPOLLETでは、非ブロッキングの読み取りを行い、EAGAINになるまで処理するのが基本です。読み残しを自分の処理待ち一覧で管理する設計も必要になります。
    • EAGAINは「今は進められない」という区切りです。通信の完了、相手の切断、データの意味上の完成とは区別します。

    epollが返すのは、データそのものではない

    ファイルディスクリプターは、プロセスがソケットやパイプなどを参照するための番号です。epollには、監視対象を登録する一覧と、入出力を進められる対象の一覧があると考えられます。epoll_waitは後者からイベントを受け取るための呼び出しです。届いた本文やパケットの内容は、その後にreadやrecvなどで読みます。

    ここでいう「読める」は、アプリケーションが欲しい情報がすべてそろった、という意味ではありません。TCP上で長さ付きの要求を受け取るなら、先頭の長さを読めても、残りの本文はまだ届いていないかもしれません。epollで通知を受け取る段階と、受信したバイト列を解釈する段階を分ける必要があります。

    二つの通知方式で、読み残しの扱いが変わる

    EPOLLETを指定しない通常の方式が、レベルトリガーです。これは、対象が読み出せる状態にあるかどうかを扱います。データを一部だけ読んで残りがある場合、引き続き読み出せる対象として扱われます。

    EPOLLETを指定したエッジトリガーでは、通知を消費した後の読み残しに対して、もう一度同じ通知が来ると期待してはいけません。たとえば、パイプに一度だけ6バイトが入り、最初の通知で2バイトだけ読む場合を考えます。残りは4バイトですが、新しい書き込みもほかの変化もなければ、次の通知を待ったままになる可能性があります。データが消えたのではなく、処理を再開する契機を取り違えた状態です。

    公式マニュアルには、パイプへ2 kBを書き込み、通知後に1 kBだけ読む例があります。下の図はその図版を転載したものではなく、同じ注意点を6バイトの独自モデルで表したものです。実際のLinuxカーネルで通知回数を測った結果ではありません。

    一度に6バイトが届いた説明用モデル。2バイト読むと4バイト残る。そこで次のエッジ通知を待つと再開の保証がない。非ブロッキングでさらに2バイトずつ読み、最後にEAGAINで通知待ちへ戻る。
    一度の到着に対し、複数回の読み取りが必要な例。数値は独自の説明用モデルで、実測値ではない。

    非ブロッキングとEAGAINを組にする

    ブロッキングのreadは、入力がなければそこで待つことがあります。一つのスレッドが複数の接続を順番に処理するとき、その待ちがほかの接続の処理まで止めてしまいます。非ブロッキングなら、今すぐ読めない状況をEAGAINとして受け取り、次の仕事へ移れます。ソケットではEWOULDBLOCKも同じ状況を表す場合があるため、戻り値の確認では両方を考慮します。

    上のモデルで2バイトずつ読めば、ABCDEFはAB、CD、EFの3回に分かれます。それでも成功した3回だけでは、「今ある入力を取り切った」という判定を省けません。書き手が開いたままで新しい入力がない条件では、次の非ブロッキング読み取りがEAGAINとなり、そこで通知待ちへ戻る区切りが得られます。readが要求した数より少ないバイト数を返すこと自体は、エラーではありません。

    この例のEAGAINを、EOFと置き換えることはできません。ストリームやパイプでreadが0を返す終端の扱い、EINTRなどのエラーへの対処、アプリケーションの要求が完成したかの判定は、別々に実装します。UDPでは長さ0のデータグラムもあるため、ストリーム向けの終端判定をそのまま持ち込まないことも大切です。

    読み切る方針にも、公平さの設計が要る

    一つの接続に大量のデータが届き続けると、その接続だけを処理してほかの接続が待たされることがあります。マニュアルも、この飢餓状態への対処として、アプリケーション側に処理可能な対象の一覧を持ち、順番に進める方法を挙げています。

    一度の処理量を制限する場合は、「まだ読み残しがある」という状態をその一覧に残します。EAGAINまで進んでいない対象を忘れ、カーネルから次のエッジ通知が来ることだけに再開を任せる設計は避けます。読み取り途中の受信データや解析位置も、次回へ引き継ぎます。

    EPOLLONESHOTは、イベントを一度受け取ると対象を無効にし、再度有効にする操作を必要とする別の指定です。エッジトリガーなら自動で一回限りになる、と理解しないようにします。複数スレッドでの所有権、再登録、切断処理まで含む場合は、今回の単純なモデルより多くの状態管理が必要です。

    方式を選ぶ前に、待ちへ戻る条件を決める

    実装を比較するときは、通知方式の名前だけで高速さを決めず、処理をどこまで進め、何を記録してから待つかを確認します。レベルトリガーは読み残しの状態を扱いやすい一方、エッジトリガーは非ブロッキング処理と処理待ち状態の管理を組にして考えます。どちらでも、イベント通知は要求の意味上の完了を証明しません。

    この記事はLinux man-pages 6.19のepollとreadの仕様説明を扱っています。独自モデルは読み残しの算術と制御の区切りを確認するもので、負荷、カーネル版、接続数ごとの性能比較や、本番サーバーの完全な実装を示すものではありません。

    出典