投稿者: SB-admin

  • FFTのゼロ埋め、周波数の刻みと分解能の違い

    FFTのゼロ埋め、周波数の刻みと分解能の違い

    音や振動の記録をFFTにかけると、どの周波数が強いかを山の形で見ることができます。計算する点を増やしたら、その山が滑らかになり、頂点の位置も細かく読めるようになった。けれど、それだけで近接した二つの振動を見分ける力まで増えたのでしょうか。

    この違いを整理する鍵が、ゼロ埋め(zero-padding)です。記録済みのデータの後ろに0を足し、FFTの出力を細かな周波数間隔で得る方法です。SciPy 1.14.1の公式解説と関数仕様をもとに、計算の刻み、観測時間、窓関数がそれぞれ何を変えるかを見ていきます。

    簡単にまとめると?

    • ゼロ埋めは、同じ記録からスペクトルを読む周波数の刻みを細かくします。新しい観測値は増えません。
    • 近い周波数の成分を見分けるには、観測時間と窓関数が決める山の幅、雑音、成分の強さの差を確かめます。
    • ピーク位置を読むためのFFT点数と、振幅・パワーをそろえるための正規化は、別々に設定します。

    FFTの点数と、実際に記録した点数を分ける

    FFTは高速フーリエ変換の略で、離散フーリエ変換(DFT)を効率よく計算する方法です。時間順に並んだ信号を、異なる周波数の波がどれだけ含まれるかという表現へ変換します。ここでは等間隔で取得したデータを扱います。[1][2]

    1秒あたりに記録する点数をサンプリング周波数 fs、実データの点数を N、FFTの計算点数を M と置きます。ゼロ埋めをしなければ M=N です。M>N にすると、足りない部分に0を並べてから変換します。SciPyの fft(x, n=M) はこの動作をします。逆に入力より小さい n を指定すると、データが切り詰められる点には注意が必要です。[2]

    出力の周波数の刻みは Δf=fs/M です。一方、実データに対応する観測区間の長さは τ=N/fs。この二つは、ゼロ埋めを始めると同じ点数では決まりません。ここでの区間長は公式解説と同じく「点数×サンプル間隔」で表し、最初と最後のサンプル時刻の差 (N−1)/fs とは区別します。[1]

    fs=1,000 Hzとした計算例。Cだけは、同じ現象を実際に4秒間記録し直す。
    条件 実データ N 観測区間 τ FFT点数 M 刻み Δf
    A:そのまま変換 1,000点 1秒 1,000点 1 Hz
    B:0を3,000点追加 1,000点 1秒 4,000点 0.25 Hz
    C:観測を4秒へ延長 4,000点 4秒 4,000点 0.25 Hz

    BとCは、どちらも0.25 Hz刻みの結果を返します。しかしBの後半は作った0であり、Cの後半は新たな観測値です。FFT点数が同じというだけでは、同じ情報を持つ測定にはなりません。この表は関係式を用いた説明例で、センサーによる実測結果ではありません。

    山の間を細かく読んでも、山そのものは狭くならない

    記録を1秒で切り出すことは、その外側を見ない「窓」を信号に掛けることに相当します。区間内をそのまま使う矩形窓では、単一の周波数成分も、周波数軸上で中央の山と周辺の小さな山を持つ形になります。中央を主ローブ、周辺をサイドローブと呼びます。有限時間で切り出したために他の周波数へ広がって見える現象が、スペクトル漏れです。[1]

    ゼロ埋めは、その広がりを持つスペクトルを、より多くの周波数位置で計算し直します。追加した0の項は和の値に寄与しないので、元の記録が作る周波数ごとの形自体を変えるわけではありません。粗い刻みでは飛び越えていた頂点付近を読めることが、見た目が滑らかになる理由です。

    幅を考えるための単純な例として、雑音のない一つの複素正弦波、つまり振動の位相を複素数で表した理想的な単一周波数の信号を、矩形窓で等間隔に切り出します。この場合、中央の頂点から最初の零点までの距離は fs/N=1/τ、左右の零点間の幅は 2/τ です。先ほどのAとBでは幅がともに2 Hz、Cでは0.5 Hzになります。Bの刻みは細かくても、窓が決める幅はAと同じです。これは窓の周波数応答から得られる例であり、実信号のあらゆるピーク形状をこの幅に固定する説明ではありません。

    「分解能」という言葉を、ソフトウェアによっては周波数の刻みの意味で使うこともあります。ここでは、Δfは結果を並べる刻み、二つの近い成分を見分ける能力は別の判断として扱います。主ローブ幅はその判断材料ですが、一定の間隔を超えれば必ず二つに分かれるという万能の境界ではありません。窓の種類、二成分の強さと位相、雑音、採用する推定方法によって見え方は変わります。

    公式図が示すのは、二つの別々の信号の比較

    次の原図は、SciPyの公式解説にある、20 Hzと20.5 Hzの正弦波をそれぞれ別に調べた例です。両方とも100 Hzで100点、1秒間の記録を使い、Hann窓を掛けています。菱形の点はゼロ埋めなし、細かな点をつないだ線はFFT点数を3倍にした結果です。[1][4]
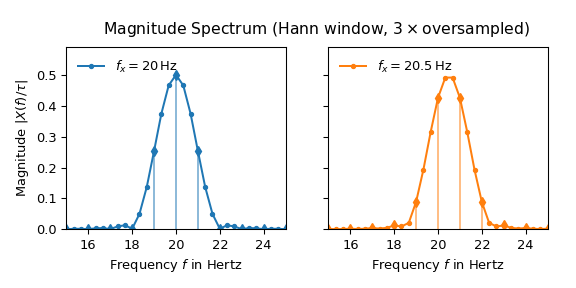
    SciPy公式図。左は20 Hz、右は20.5 Hzの別々の正弦波。Hann窓を掛けた同じ100点の記録を、100点FFTの菱形と300点FFTの細かな点で比較している。
    図1 Hann窓を使った振幅スペクトルと3倍のゼロ埋め。左右は合成した二成分ではなく、別々の入力。原図の縦軸は片側を2倍しない表現で、単位振幅の正弦波の頂点は約0.5となる。SciPy 1.14.1 User Guide「Spectral Analysis」より、原図を無改変で掲載。Copyright (c) 2001–2002 Enthought, Inc.; 2003–2024 SciPy Developers. BSD 3-Clause、末尾のライセンス表示を参照。

    右側では、1 Hz刻みの菱形だけを見ると、20.5 Hzの頂点を直接読めません。1/3 Hz刻みにすると頂点の近くを捉えやすくなります。ただし20.5 Hzはその刻みにも厳密には乗らないため、細かくしたから頂点そのものを必ず計算したことになるわけでもありません。

    この図は「20 Hzと20.5 Hzが同時に含まれる信号を分離できた」という実験ではありません。また、Hann窓はサイドローブを抑える一方で主ローブを広げるので、矩形窓と比べた山の幅の変化を、ゼロ埋めの効果だけに帰すこともできません。図の入力、窓、FFT点数を分けて読むと、滑らかな山を過大評価しにくくなります。

    振幅を比べるときは、0の数で割らない

    FFTの点数を増やした後、振幅まで小さくなったように見えることがあります。そこで確認したいのが正規化、つまり計算結果を何で割って表示するかです。SciPyの fft の既定値 norm="backward" は、順方向の変換では点数による割り算を行いません。[2]

    矩形窓で得た同じ記録の振幅を比べるなら、ゼロ埋め後の M を無条件に分母にしないことが大切です。N 点の元の記録を4倍のFFTにしたとき、同じ周波数の変換値を M=4N で割れば、N で割った表示の4分の1になります。これは信号の振幅が減った証拠にはなりません。

    窓を掛けた振幅表示では、公式解説は窓の重みの和の絶対値 |Σw| での正規化を説明しています。図1の描画コードも、ゼロ埋め前後で同じ値を分母にしています。ただし、有限の刻みが真の頂点を外すことによる誤差まで、正規化だけで消えるわけではありません。実信号の片側スペクトルを2倍するかどうかも、別の表示上の約束です。[1][4]

    さらに、振幅の表示とパワースペクトル密度(PSD)は異なります。SciPyの periodogram では、入力がV、サンプリング周波数がHzなら、scaling="density" はV²/Hz、scaling="spectrum" はV²となります。窓や表示方式を変えたグラフの縦軸を、そのまま同じ「強さ」として比較しないようにします。[3]

    何を改善したいかで、変える設定を選ぶ

    一つの山の頂点付近を細かく読みたいなら、ゼロ埋めは役に立ちます。一方、隣り合う成分が重なって見えるなら、まず観測区間を長くできるか、窓の主ローブ幅とサイドローブが目的に合うかを確認します。長く記録する場合も、その間に回転数や振動状態が変われば、一つの定常的なスペクトルとしてまとめる判断そのものを見直す必要があります。

    サンプリング周波数を上げるときも、何を固定するかで結果が変わります。ゼロ埋めなしで、1秒間の記録を1,000 Hzから4,000 Hzへ変えるなら、実データは1,000点から4,000点へ増えますが、周波数の刻みはどちらも1 Hzです。反対に1,000点という点数だけを固定して4,000 Hzで記録すると、区間は0.25秒、刻みは4 Hzになります。時間軸を細かく刻むことと、周波数軸を細かく読むことは、同じ操作ではありません。

    たとえば測定ソフトの画面に「4,000点」とだけ表示されていても、それが実データ数なのか、0を追加した後の計算点数なのかは区別できません。取得条件と解析条件を別々に確認してから比較すると、設定値だけが増えた変更を、測定能力の向上と取り違えずに済みます。

    高い周波数まで観測したい場合には、FFT点数よりもサンプリング周波数と取得前の帯域制限が関係します。実信号の折り返しを避ける条件として、公式解説はナイキスト周波数 fs/2 を示しています。ゼロ埋めをしても、取得時に失った周波数情報や折り返しを元に戻すことはできません。[1]

    測定結果を比較するときは、実データ点数、サンプリング周波数、観測区間、窓、FFT点数、縦軸の単位と正規化を一緒に残す。この組み合わせが分かれば、「細かく見えるようになった」のか、「新しい観測によって見分けられるようになった」のかを、同じ条件で考えられます。

    参考資料

    参照版はSciPy 1.14.1。原図は公式資料の計算例であり、本文の比較表・零点幅・正規化の説明は関係式を用いた例です。実機測定やSciPyの性能ベンチマークは行っていません。

    1. SciPy 1.14.1 User Guide「Signal Processing — Spectral Analysis」。Continuous-time Sine Signal、Sampled Sine Signal、窓と正規化の節。
    2. SciPy 1.14.1「scipy.fft.fft」。n、norm、DFTの定義。
    3. SciPy 1.14.1「scipy.signal.periodogram」。nfft、scaling、単位。
    4. SciPy v1.14.1、図1の描画ソース。同一Hann窓・同一の振幅正規化と、100点/300点の計算条件。
    図1の著作権・ライセンス表示(BSD 3-Clause)

    SciPy v1.14.1 LICENSE.txt

    Copyright (c) 2001-2002 Enthought, Inc. 2003-2024, SciPy Developers.
    All rights reserved.
    
    Redistribution and use in source and binary forms, with or without
    modification, are permitted provided that the following conditions
    are met:
    
    1. Redistributions of source code must retain the above copyright
       notice, this list of conditions and the following disclaimer.
    
    2. Redistributions in binary form must reproduce the above
       copyright notice, this list of conditions and the following
       disclaimer in the documentation and/or other materials provided
       with the distribution.
    
    3. Neither the name of the copyright holder nor the names of its
       contributors may be used to endorse or promote products derived
       from this software without specific prior written permission.
    
    THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS
    "AS IS" AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT
    LIMITED TO, THE IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR
    A PARTICULAR PURPOSE ARE DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT
    OWNER OR CONTRIBUTORS BE LIABLE FOR ANY DIRECT, INDIRECT, INCIDENTAL,
    SPECIAL, EXEMPLARY, OR CONSEQUENTIAL DAMAGES (INCLUDING, BUT NOT
    LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR SERVICES; LOSS OF USE,
    DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER CAUSED AND ON ANY
    THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY, OR TORT
    (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
    OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.
    
  • Max-Cutの量子最適化、最良の1件と平均の成績をどう比べるか

    Max-Cutの量子最適化、最良の1件と平均の成績をどう比べるか

    量子最適化の結果に「最適解が得られた」とあっても、それが1回だけなのか、何度も得られたのかで受け取り方は変わります。たくさん試した末の1件と、少ない試行で繰り返し得られる良い答えは、同じ成績ではありません。

    二つのグループに分ける組合せ問題「Max-Cut」を使うと、この違いを小さな例で確かめられます。QED-Cの共同研究による評価方法と公開実装を手掛かりに、最良値、平均、そこへ至る試行の量を分けて見ていきます。[1]

    簡単にまとめると?

    • Max-Cutは、点を二組に分け、組をまたぐ辺の数を大きくする問題です。最良の1件と標本全体の平均は、違う問いに答えます。
    • 試行回数を増やすと、同じ分布でも良い答えを一度は引き当てやすくなります。最良値の比較には、試行数と時間の条件が必要です。
    • 結果を読むときは、問題、成績の指標、試行予算をそろえます。量子回路だけでなく、パラメーターを更新する古典計算の時間も区別します。

    Max-Cutの「良い答え」を、四つの点で考える

    正方形の四つの頂点に点を置き、隣同士を4本の辺で結んだグラフを考えます。それぞれの点を赤か青に分け、両端の色が違う辺を数えます。この数がcut値です。色を交互に置けば4本すべてが組をまたぎ、この例の最大値は4になります。全点を同じ色にすれば0本です。

    4点への二色の割当ては16通りあります。色を逆にしたものも別の割当てとして数えると、cut値が0の割当ては2通り、2は12通り、4は2通りです。どの割当ても同じ確率で選ぶなら、平均は2ですが、最良の答えとして4を得る可能性もあります。

    これは説明のために全16通りを数えた独立の小例です。原著が評価に使う、各点につながる辺が3本のグラフとは異なり、量子回路の実行結果でもありません。原著のMax-Cutでも、組をまたぐ辺を多くするという目的は同じです。[1]

    「最良」と「平均」で順位が入れ替わる

    同じ正方形の問題から、次のような4回分の答えが得られたとします。AとBは指標の違いを見るために作った標本で、装置やアルゴリズムの測定値ではありません。

    最大cut値が4の同一問題で、4回分の標本を比べる仮例
    標本 4回のcut値 最良値 平均 平均÷最適値4
    A 4、0、0、0 4 1 0.25
    B 2、2、2、2 2 2 0.50

    最良の答えだけならAが上です。一方、標本全体の平均ではBが上になります。一度でも良い候補を得て採用したいのか、繰り返し良い候補が出るかを見たいのかによって、必要な指標が変わるわけです。ただし、4回の標本だけで、次回以降もBの方が安定すると確定できるわけではありません。

    原著は、標本の平均を最適値で割る近似比に加えて、最良の測定結果や、良い側の一部を重視する指標も比較しています。平均の近似比が1なら、その標本はすべて最適値ですが、最良値の比が1でも他の答えの質は分かりません。[1]

    符号にも注意が要ります。確認した公開実装は、最小化する計算へ渡すため平均cut値にマイナスを付け、成績を記録するときに符号を戻して最適値で割っています。ここでは一貫して正のcut値で比べています。値が大きいほど良いのか、小さいほど良いのかを確かめるだけでも、異なる出力の取り違えを防げます。[2]

    最良値は、試す回数にも左右される

    先ほどの16通りを毎回独立に同じ確率で選ぶ方法では、1回で最適値4を得る確率は2÷16、つまり12.5%です。同じ選び方でも8回試せば、一度以上4を得る確率は約65.6%になります。最適値を一度も引かない確率を使い、1−(7/8)8で求められます。

    選ぶ仕組みは改善していません。それでも、試す回数を増やすだけで「最適解を得られた」と報告しやすくなります。一方、この選び方の1回あたりの期待cut値は2のままです。この計算は一様で独立な試行の仮例であり、学習中の量子回路の出力確率を表すものではありません。

    量子近似最適化アルゴリズム(QAOA)は、量子回路から得た標本を評価し、古典計算で回路のパラメーターを更新していきます。回路を何回測ったかを示すshotsだけでなく、更新を何回行い、初期値を変えて何回やり直したかも、結果を得るための予算に含まれます。最終回のshots数だけでは、探索全体でどれほど試したかは分かりません。[1]

    同じ時間での質か、同じ質に届く時間か

    原著が整理する比較の一つは、時間を決めたときに、どの程度の答えが得られるかです。もう一つは、目標とする答えの質へ届くまでに、どれだけの時間がかかるかです。前者は締切がある仕事に、後者は必要な品質を先に決められる仕事に対応します。[1]

    その時間が量子処理だけなのか、古典計算も含むのか、準備などを含む全体の経過時間なのかで、比較の意味は変わります。回路の中だけが速くても、パラメーター更新に時間を使えば、候補を得るまでの総時間が同じように短くなるとは限りません。

    結果の表を見るときは、まず同じ問題を比べているかを確かめます。次に、平均なのか最良値なのか、既知の最適値を分母にしているのかを読みます。最後に、shots、更新回数、やり直し回数と、時間に含めた範囲を見ます。大きな問題で最適値そのものが分からない場合、既知の最良値との比を「最適値との比」と呼ばない区別も必要です。

    原著の結果は、こうした評価方法を具体化するための例であり、すべての装置や設定を尽くした性能順位ではありません。良い答えを1件得たという数字に、答えの分布と試行予算を添えることで、その結果が自分の用途に合うかを判断しやすくなります。[1]

    参考資料

    1. Thomas Lubinskiほか「Optimization Applications as Quantum Performance Benchmarks」arXiv:2302.02278v2、2024年2月1日改訂。Max-Cutの定義、品質指標、時間との関係、結果の適用範囲。本文ではこの保存版を参照。
    2. SRI International / QED-C「QC-App-Oriented Benchmarks:Max-Cut公開実装」commit 21dfc331ce61a2170b06f88259aa19f901c021bc。compute_sample_meanと品質比の記録処理を参照。
  • TLS 1.3の0-RTTとHTTP 425、速さと再実行の危険をどう分けるか

    TLS 1.3の0-RTTとHTTP 425、速さと再実行の危険をどう分けるか

    同じサービスへもう一度接続するとき、暗号通信の準備が終わるのを待たずに、最初の要求を送る。TLS 1.3の0-RTTは、こうして通信の往復待ちを減らす仕組みです。ところが、早く送った要求が暗号化されていることと、その要求が一度しか実行されないことは、同じ保証ではありません。[1]

    HTTPでこの違いを扱うために用意された応答が、425 Too Earlyです。何を早く処理してよく、何を待たせるべきなのか。0-RTTの時間短縮と、同じ要求が繰り返されるリプレイの危険をつなげて考えます。

    簡単にまとめると?

    • 0-RTTは、共有済みの鍵を使って、TLSの最初の送信にアプリケーションのデータを載せます。通信時間がゼロになる意味ではありません。
    • early dataは暗号化されますが、別の接続で再利用されない保証は通常のTLSデータと異なります。読み取り用に見える要求でも、再実行の副作用を確認します。
    • HTTP 425は、リプレイされ得る要求をそのまま処理しないための応答です。再試行ではearly dataを使わず、プロキシを通る場合も前段の情報を引き継いで判断します。

    0-RTTが省くのは、要求を送る前の往復待ち

    TLSは、通信相手や暗号の条件を確かめ、データを守るための鍵を整えるハンドシェイクを行います。RTTはRound-Trip Timeの略で、通信が相手へ届いて戻るまでの往復時間です。TLS 1.3の通常の1-RTTハンドシェイクでは、クライアントはサーバーからの応答を受け取ってから、通常のアプリケーションデータを送れます。[1]

    0-RTTでは、クライアントとサーバーがPSK(事前共有鍵)を共有していることを利用します。代表的なのは、前回の接続で得た情報を使って接続を再開する場合です。仕様上は外部で共有されたPSKも対象ですが、どちらも、初対面の相手へ何の準備もなく早期送信できる仕組みではありません。クライアントは最初のClientHelloに続けて、PSKから導いた鍵で守ったearly data(早期データ)を送ります。サーバーが受け入れるとは限らず、その後のハンドシェイクも必要です。[1]

    RFC 8446のFigure 4。クライアントからの最初の送信にearly dataのApplication Dataがあり、その後もServerHelloやFinishedなどのハンドシェイクが続く。
    IETF, E. Rescorla, RFC 8446 Figure 4(2018年8月)。左がクライアント、右がサーバー。最初の矢印にある丸括弧のApplication Dataがearly dataで、その後の角括弧のデータとは保護に使う鍵が異なります。原図の文字・配置・凡例を保ってPNG化。狭い画面では左右にスクロールでき、画像を開くと拡大できます。Copyright (c) 2018 IETF Trust and the persons identified as the document authors. All rights reserved. 原典/利用条件。

    図で確認したいのは、0-RTTでもハンドシェイクが消えていないことです。省けるのは、最初の要求を送るまでに待つ一往復です。サーバーが要求を受け取った直後に処理できるかは、さらに別の判断になります。

    たとえばRTTを80ミリ秒、片道を40ミリ秒と仮定します。TLSの送信開始を0ミリ秒とし、ハンドシェイクの追加往復、通信損失、処理時間を考えない場合、要求がサーバーへ届く時点は次のようになります。TCP接続やDNSの時間は、この比較に含めません。

    最初の要求が届く時点の計算例。測定結果ではない
    送り方 クライアントが要求を送る時点 サーバーへの到着
    通常の1-RTT サーバーの応答を受け取る80ミリ秒後 120ミリ秒後
    受け入れられる0-RTT 最初の送信と同時の0ミリ秒 40ミリ秒後

    この条件では、到着を一往復分の80ミリ秒早められます。ただし、画面全体の表示が必ず80ミリ秒速くなるとは言えません。early dataの拒否、要求処理の保留、サーバーの計算時間などが結果に関わります。0-RTTは、特定の待ちを減らす手段として見る必要があります。

    暗号化された要求も、別の接続で繰り返され得る

    リプレイは、攻撃者が通信を記録して再び送り、同じ要求を処理させようとすることです。利用者がボタンを押し直すことや、クライアント自身の再試行とは区別します。また、パケットを失った際のTCPの再送を、そのままアプリケーションの二重実行と同一視するものでもありません。[2]

    通常のTLS 1.3のデータは、その接続でサーバーから受け取った乱数などに結び付いた鍵で保護されます。一方、early dataはServerHelloを受け取る前に送るので、まだその値に依存できません。攻撃者が内容を解読しなくても、暗号化された最初の送信を別の接続へ持ち込む危険が残ります。RFC 8446は、0-RTTについて接続間の非リプレイ性を保証しないと明示しています。同じ接続内で同じデータを二重に処理するという説明ではありません。[1]

    サーバーには、セッションチケットを一度だけ使えるようにしたり、最近のClientHelloを記録して重複を退けたりする対策があります。ただし、複数のサーバーで状態をどこまで共有するかが効いてきます。TLSでの重複排除と、拒否を受けたクライアントが別の接続で再試行して生じる重複は、同じ問題ではありません。後者には、アプリケーション側の扱いも必要です。[1]

    もう一つの違いは前方秘匿性です。これは、後から鍵が漏れても、過去の通信内容が守られる性質を指します。early dataはPSKだけから導いた鍵で暗号化されるため、通常の後続データと同じ前方秘匿性を持つとは扱えません。「TLS 1.3で暗号化した」という一言で、早期データの性質まで一括りにしないことが大切です。[1]

    GETかどうかだけでなく、繰り返されたときの作用を見る

    たとえば、同じ操作が二度届くと数量を二度加算する処理なら、早期送信を受け入れる前に二重実行の扱いを決める必要があります。一方、状態を変えない情報の取得は候補になり得ますが、それだけで無条件に問題がないわけではありません。取得のたびに別の処理を起動する、利用枠を消費する、といった副作用も確認対象です。これは個別サービスの実装を調査した例ではなく、判断のための仮定です。

    RFC 8470は、ほかに情報がないクライアントに対し、安全なHTTPメソッドの要求はearly dataで送ってよい一方、安全でない、または安全性の分からないメソッドは送ってはならないとしています。ただし、GETなど安全なメソッドを名乗るリソースでも副作用を生むことがあるため、メソッド名だけには依存できないとも述べています。何が実行されるかを知るオリジンサーバー、つまり最終的に要求を扱うサーバーの判断が必要です。[2]

    サーバー側で考えられる選択は、TLSの段階でearly data全体を拒否する、ハンドシェイクが終わるまでHTTPの処理を待つ、個別の要求へ425を返す、の三つです。TLSの受入れはearly data全体に対する判断であり、その層で要求ごとに一部だけ拒否するものではありません。HTTPの段階では、リソースごとの扱いを決められます。[2]

    HTTP 425は、early dataを使わない再試行へ戻す

    425 Too Earlyは、リプレイされ得る要求を処理する危険を、サーバーが受け入れないという応答です。early dataで要求を送ったクライアントは425を受けたら再試行し、その再試行をearly dataで送ってはいけません。仕様は自動再試行を推奨していますが、重要なのは、同じ早期送信を繰り返すのではなく、通常の保護が使える段階へ戻すことです。[2]

    したがって、425は要求の内容が永久に禁止されたという意味でも、二重実行済みの処理を取り消す命令でもありません。早く処理してよいか判断できない段階で処理を進めず、クライアントとサーバーが次の送り方を合わせるための仕組みです。early dataでもなく、後述のEarly-Dataヘッダーもない要求へ、一般的な待ち時間の応答として425を流用することは、RFCが想定する使い方ではありません。[2]

    プロキシを挟むと、後段の接続が終わっていても判断は残る

    要求が、クライアントからゲートウェイやリバースプロキシを経て、オリジンサーバーへ届く場合を考えます。前段でearly dataを受け取り、クライアントとのハンドシェイク完了前に後段へ転送するなら、中継するサーバーはEarly-Data: 1を付けます。このヘッダーは、前の区間でearly dataとして運ばれたことと、425を扱えることを伝えます。既に付いているものを中継で取り除いてはいけません。[2]

    ここで、オリジンサーバーとプロキシの間のTLS接続が終わっていても、前段のearly dataの履歴は消えません。オリジンサーバーが自分側のハンドシェイク完了だけを待っても、その要求を安全に処理できるものへ変えたことにはならないのです。Early-Dataが付いた要求を安全に処理できなければ、425で拒否します。[2]

    また、早期に処理してはいけない要求を、一台だけ実行してしまう不整合も避ける必要があります。同じ要求を受け得るサーバー群で、処理を始めてよい条件をそろえます。TLSでの拒否、HTTPでの保留、425の使い分けまで同じにする必要はなく、危険な要求を早期に実行しない点で一貫していることが重要です。0-RTTを採用する判断では、短くできる往復待ちに加えて、リソースの副作用、再試行、中継経路、複数サーバーの一貫性までを一緒に確認します。それが難しい要求を待たせることは、速さを優先しない場面を具体的に決めることです。[2]

    参考資料

    1. E. Rescorla, IETF/RFC Editor, RFC 8446: The Transport Layer Security (TLS) Protocol Version 1.3、2018年8月。§2.3とFigure 4、§8、Appendix E.5。PSKとearly data、接続間リプレイ、対策と限界を参照。
    2. M. Thomson, M. Nottingham, W. Tarreau, IETF/RFC Editor, RFC 8470: Using Early Data in HTTP、2018年9月。§§1〜6。HTTPの処理保留、メソッド、Early-Dataヘッダー、425と再試行条件を参照。
  • 平均光子数だけでは分からない光の揺らぎ QuTiPの二次相関で比較する

    平均光子数だけでは分からない光の揺らぎ QuTiPの二次相関で比較する

    ある光のモードに含まれる光子数の平均が2だったとします。毎回必ず2個なのか、1個や3個などがばらついて出るのか、ときには多く、ときにはほとんど出ないのか。平均だけでは、この違いは見えません。

    光子の数の揺らぎを比較する手掛かりが、二次相関g(2)です。ここではQuTiPの公式資料と5.1.1の固定実装を読み、時間差がゼロのg(2)(0)を中心に、同じ平均を持つ光がどう違うのかを整理します。装置の実測ではなく、単一モードを仮定した量子状態と独立計算の比較です。[1][2]

    簡単にまとめると?

    • g(2)(0)は平均光子数だけでなく、異なる2個の光子からなる組の平均を見ます。同じ平均でも、光子数の揺らぎ方によって値が変わります。
    • 平均2の理想例では、2光子のFock状態が0.5、コヒーレント状態が1、単一モードの熱状態が2です。ただし、この一つの値だけで状態全体は決まりません。
    • ゼロでない平均、対象モード、時刻、規格化の分母をそろえます。時間差をつけた相関では、定常な場合と平均が変化する場合を区別します。

    平均の次に、光子の「組」を数える

    光のモードとは、空間的な形や周波数などで区別する場の一つの自由度です。ここでは一つのモードだけを扱い、同じ量子状態を用意して光子数を測るときの分布を考えます。光子数演算子をn=a†aと書き、aは光子を一つ減らす消滅演算子、a†は増やす生成演算子です。山括弧〈 〉は、その状態での平均を表します。

    時間差ゼロの二次相関は、平均光子数〈n〉がゼロでないとき、次の形になります。[1][2]

    g(2)(0)=〈a†a†aa〉 / 〈a†a〉2=〈n(n−1)〉 / 〈n〉2

    分子が〈n2〉ではない点が大切です。n個の中から最初の光子を一つ選ぶ方法はn通り、同じ光子を除いて次を選ぶ方法はn−1通りなので、順序を区別した組はn(n−1)通りです。これは2個の組に関わる量であり、光子を自分自身と組にする分は数えていません。量子演算子でも、aaが|n⟩へ作用する係数の二乗がn(n−1)になります。

    たとえば毎回2個なら、組の数は常に2です。一方、平均が2になるように光子数がばらつくと、多く出る回の組の数は二乗に近い速さで増えます。平均光子数をそろえても、分子にはその違いが残ります。g(2)(0)は光子数そのものではなく、この平均で規格化した無次元の指標です。

    平均2の三つの状態を比べる

    違いを具体的にするため、理想的な三つの状態を比べます。Fock状態|2⟩は、光子数が必ず2となる状態です。コヒーレント状態では光子数がポアソン分布に従い、平均2の場合の分散も2になります。単一モードの熱状態では幾何分布となり、同じ平均2でも分散は6です。分散は、平均からのずれを二乗して平均した、ばらつきの大きさです。[3]

    光子数がnとなる確率をP(n)とすると、今回のコヒーレント状態はP(n)=e−22n/n!、熱状態はP(n)=(1/3)(2/3)nです。これらの分布から平均と組の数を計算すると、次のようになります。

    単一モード・平均光子数2の独自計算。無限の光子数空間における理論値で、実験値ではありません。
    状態 〈n〉 分散 〈n(n−1)〉 g(2)(0)
    Fock状態 |2⟩ 2 0 2 0.5
    コヒーレント状態
    |α|2=2
    2 2 4 1
    単一モードの熱状態 2 6 8 2

    表は確率分布の式から導き、光子数基底の消滅演算子を別に組み立てた行列計算でも照合しました。残す基底を10、20、40、80状態へ増やして確認し、80状態でのg(2)(0)の理論値との差は、三例とも1.3×10⁻¹¹以下でした。QuTiP本体や光源を動かした結果ではありません。

    熱状態は光子数の大きい側にも確率が残るため、平均だけでなく二次の量も収束しているかを見ます。今回の数値照合では、解析式の係数を有限範囲へ切り出して正規化しました。QuTiPのcoherentには有限空間の変位演算子を使う方法もあるため、同じNという表示だけで構成法まで同一とはしません。[3]

    g(2)(0)が1より小さい、または大きいと何が分かるか

    分散Var(n)=〈n2〉−〈n〉2を使うと、同じ式を次のように書き直せます。

    g(2)(0)=1+[Var(n)−〈n〉] / 〈n〉2

    したがって、この単一モードの条件でg(2)(0)が1より小さければ、分散はポアソン分布の基準である平均光子数より小さくなります。1より大きければ、その基準より大きい揺らぎです。光子がまとまって現れる傾向を論じる際の手掛かりになりますが、時間をずらしたときの相関の形は、これだけでは分かりません。

    1未満というだけで「必ず1個ずつ出る」とは言えません。表のFock状態|2⟩はg(2)(0)=0.5ですが、測れば必ず2個です。一般に、光子数mが正の整数で固定されたFock状態ではg(2)(0)=1−1/mとなります。単一光子の理想状態|1⟩なら0ですが、0.5を見てそれと同じだと扱うことはできません。

    逆に、g(2)(0)=1だから状態が純粋なコヒーレント状態だとも断定できません。光子数分布が同じポアソン分布でも、異なる光子数成分の位相の関係を平均して失わせた混合状態を作れます。光子数の平均と二次相関は同じでも、密度行列の非対角成分は違います。今回の独立計算でも、平均と二次相関が同じでも密度行列は異なることを確認しました。g(2)(0)は有用な比較軸ですが、状態全体を復元する情報ではありません。

    時間差をつけるなら、分母も時刻に合わせる

    ゼロ遅延の比較は、ある時点の状態の光子数分布から行えます。ここまでの表に、時間に依存しない定常状態という仮定は必要ありません。一方、時間差τをつけてg(2)(τ)を求めるときは、その間に状態がどう変わるかというモデルが必要です。

    QuTiP 5.1.1の固定実装coherence_function_g2は、初期時刻を0として、非規格化のG(2)(τ)と、規格化したg(2)(τ)の両方を返します。初期状態を指定する経路では、平均光子数を時間に沿って求め、分母にn̄(0)n̄(τ)を使います。ここでn̄は平均光子数です。[2]

    g(2)(τ)=〈a†(0)a†(τ)a(τ)a(0)〉 / [n̄(0)n̄(τ)]

    定常な状態で平均が一定なら、この分母はn̄2になります。減衰中などで平均が変わる場合に、初期平均の二乗で割り続けると、別の量を比較することになります。公式ガイドの説明式と、初期状態を時間発展させる例の分母を読むときも、この条件を分ける必要があります。[1][2]

    同関数でstate0=Noneを指定すると定常状態を求めて使いますが、文書に記載された条件は、時間に依存しないハミルトニアンと崩壊演算子があることです。遅延相関の計算には量子回帰定理を用いるため、時間発展のモデルとその適用条件を引き継ぎます。任意の記憶効果を持つ環境で、同じ手続きを使えばよいという意味ではありません。

    公式例の三つの曲線は、指定した熱浴との相互作用の下での時間変化です。g(2)(0)が0.5、1、2であることから、どの光源でも同じ時間尺度で同じ曲線へ進むとは言えません。本稿の表はゼロ遅延の数値であり、遅延曲線を独立に再計算したものではありません。

    比較の前に、平均・モード・計算条件をそろえる

    まず、比較する対象が同じモードなのか、複数の周波数や空間モードをまとめたものなのかを確認します。表の熱状態の値2は単一モードの理想例であり、複数モードをまとめた測定へそのまま当てはめる数ではありません。

    次に、平均光子数がゼロでないかを確認します。真空では分子も分母もゼロで、規格化したg(2)(0)は定義できません。平均が非常に小さい計算でも、比だけを見る前に、分子G(2)と平均の値、数値精度を確認したいところです。QuTiPが両方の相関値を返すことは、この切り分けに役立ちます。

    実験と比較するなら、検出する時間幅や周波数帯、背景光、検出器の応答などを含む測定条件と、モデルが表す量を対応させます。理想状態の分散が大きいことと、有限回の測定からg(2)を推定した値の誤差が大きいことも別です。後者には標本数と推定手順の情報が必要です。

    平均光子数に加えて「組の平均」を選ぶと、見えていなかった揺らぎが比較できるようになります。そのうえで、数が固定されているのか、位相の関係まで知りたいのか、時間をまたぐ変化を知りたいのかを分ける。g(2)が答える問いと、追加の観測量が必要な問いを切り分けることが、計算や測定の使い道につながります。

    参考資料

    1. QuTiP 5.1 Documentation, Two-time correlation functions。二時刻相関、定常性、二次相関の定義と熱浴下の計算例。
    2. QuTiP 5.1.1, correlation.pyの固定実装。coherence_function_g2の入力条件、平均の計算、G2とg2の規格化。最新版を示すものではありません。
    3. QuTiP 5.1.1, states.pyの固定実装。coherent・fock_dm・thermal_dmの定義と有限空間での構成法。本文の数表と同じ光子数分布を持つ状態の比較は、Quantum Seaによる独立の解析・行列計算です。
  • DNSのネガティブキャッシュ、「名前がない」と「レコードがない」の違い

    DNSのネガティブキャッシュ、「名前がない」と「レコードがない」の違い

    新しいホスト名とIPアドレスをDNSに登録したのに、手元ではまだ「見つからない」と返ってくる。登録に失敗したとは限りません。DNSは見つかったデータだけでなく、存在しないという応答も期限付きで保存するからです。この仕組みをネガティブキャッシュ、または否定応答のキャッシュと呼びます。[1]

    ただし、「見つからない」には種類があります。名前そのものがないのか、その名前に欲しい種類のレコードがないのかで、保存した情報を使える範囲が変わります。応答の意味と残り時間を分けて見ると、DNS変更後の待ち時間を読み解きやすくなります。

    簡単にまとめると?

    • NXDOMAINは名前の不存在、NODATAは指定した種類のデータの不存在を表します。IPv6用のAAAAがないことだけで、IPv4用のAまでないとは判断できません。
    • 基本の否定応答の保存時間は、SOAレコード自身のTTLとSOAのMINIMUMフィールドの小さい方から決まります。保存済みの不在情報は、新しいAレコードを追加しても直ちには消えません。
    • 確認するのは応答の種類、問い合わせ先、残りTTLです。解決に失敗したSERVFAILや、障害時に期限切れ情報を返す仕組みは、通常の不存在応答と区別します。

    「名前がない」と「その種類のデータがない」を分ける

    DNSの問い合わせでは、名前だけでなく、欲しいレコードの種類も指定します。AはIPv4アドレス、AAAAはIPv6アドレスを求めるときの種類です。ここでは一般的なインターネット用のクラスINを前提に、CNAMEなどの別名の連鎖がない場合を考えます。[1]

    NXDOMAINは、その名前が存在しないという応答です。一方、NODATAは名前はあるものの、指定した種類のレコードがないという意味です。NODATA専用の応答コードがあるわけではなく、コードはNOERRORで、回答欄に該当データがないことなどから判断します。[1][2]

    同じ名前を問い合わせても、不在情報の範囲は異なる(仕様に基づく整理)
    応答 分かったこと 別の種類を問い合わせるとき
    NXDOMAIN その名前がない 同じ名前・クラスの別の種類にも、その不在情報を使える
    NODATA その名前に、指定した種類のデータがない AAAAがないという情報だけでは、Aがあるかは分からない
    SERVFAIL サーバー側の問題などで解決を完了できない 名前やレコードが存在しないと結論づける応答ではない

    たとえば、ある名前にAだけが登録されているなら、AAAAへのNODATAを保存していても、それだけを理由にAの問い合わせを否定してはいけません。また、NOERRORで回答欄が空という見た目だけでも即断できません。別のネームサーバーを案内する応答もあるため、管理情報を載せるAuthority欄のSOAレコードなど、応答全体を見て区別します。[2]

    不存在の期限は、SOAが伝える

    利用者に代わってDNSを調べるリゾルバーは、受け取った応答をキャッシュし、同じ問い合わせに再利用できます。これによって、存在しない名前への問い合わせを繰り返すたびに、そのゾーンを管理する権威サーバーまで調べ直す負担を減らせます。[1][2]

    通常のAレコードなら、データと一緒にTTL、つまり保存に使える時間が付いています。ところが不存在の応答には、保存対象となるAレコード自体がありません。そこで権威サーバーは、ゾーンの管理情報を表すSOAレコードを応答に添え、そのTTLで否定応答の期限を伝えます。[2]

    権威サーバーが否定応答に添えるSOAのTTLは、SOAレコード自身のTTLと、SOA内のMINIMUMフィールドの小さい方に設定されます。たとえば前者が900秒、後者が300秒なら、基本の否定応答TTLは300秒です。MINIMUMという名前から「すべてのレコードに適用する最低TTL」と受け取りやすいのですが、RFC 2308はその意味を廃し、否定応答のTTLに用いると定義しています。[2]

    キャッシュから返す際には、保存していた時間を引いたTTLを添えます。問い合わせが来るたびに、最初の300秒へ戻す仕組みではありません。別のリゾルバーへ引き継がれる場合も、この残り時間が期限を伝えます。[2]

    新しいAのTTLを短くしても、古い不在情報は残る

    次は仕組みを確かめるための仮定例です。あるリゾルバーが09:00に、まだ存在しない名前についてTTL300秒のNXDOMAINを受け取ったとします。途中のキャッシュ削除や置換、実装によるTTLの短縮はなく、権威サーバーの内容は更新後に一致していて、正常に問い合わせられる条件です。障害時の期限切れ情報の利用も含めません。

    300秒の否定応答を保存した後に、Aを追加した場合の計算例
    時刻 権威サーバー側 このリゾルバー側
    09:00 名前はまだない NXDOMAINを保存。残り300秒
    09:01 名前とAを追加。新しいAのTTLは60秒 保存済みの不在情報は残り240秒
    09:03 Aが存在する 同じキャッシュを使う問い合わせには、残り120秒のNXDOMAINを返し得る
    09:05 Aが存在する 通常の否定応答キャッシュは期限切れ。次の問い合わせでは改めて解決する

    09:01にAへ設定した60秒は、そのAを取得した後のキャッシュに関わる値です。それまでに保存されたNXDOMAINの残り240秒を、60秒へ書き換えるものではありません。この例では、通常の否定応答を使える期限が09:05に来るのであって、09:05に世界中の端末へ新しい情報が一斉配信されるわけでもありません。表は仕様から計算した説明で、実際のDNS環境を測定したものではありません。[1][2]

    同じ名前だけに閉じないNXDOMAINの範囲

    NXDOMAINには、さらに名前の階層との関係があります。RFC 8020は、ある名前が存在しなければ、その下の名前も存在しないとして扱う「NXDOMAIN cut」を定めています。たとえばfoo.exampleの不存在を保存したリゾルバーは、その有効期間中、配下のbar.foo.exampleにも、その情報に基づいてNXDOMAINを返せます。逆に、一つの配下名がないだけで、隣の名前や親までないとは判断できません。[3]

    ただし同RFCには、すでに保存している配下のデータをそのTTLが切れるまで返してよいことや、DNSSECで検証されたNXDOMAINだけにこの動作を適用してよいことも書かれています。別名の連鎖がある場合は、どの名前の存在が否定されたのかも確認が必要です。最初に問い合わせた名前とは限りません。[3]

    待ち時間を判断する前に、応答の種類と相手を確かめる

    変更後に見つからないときは、まず名前とレコードの種類をそろえて、権威サーバーの応答と、実際に利用しているリゾルバーの応答を分けて確認します。後者がNXDOMAINまたはNODATAなら、Authority欄のSOAとそのTTLは、否定応答があとどれだけ残り得るかを判断する手掛かりです。問い合わせ先ごとに保存した時点や内容が違えば、見える結果も違い得ます。これはキャッシュの仕組みから得られる点検の順序です。

    SERVFAILやタイムアウトなら、「存在しない」という応答が返った場合と同じ扱いにはできません。RFC 9520は、こうした名前解決の失敗にも、繰り返しの問い合わせを抑えるためのキャッシュを要求しています。NXDOMAINとNODATAは、有用な不存在の情報が得られた応答として、これらの解決失敗とは区別されています。単に「DNSで失敗した」とまとめず、何が返ったのかを残すことが切り分けにつながります。[4]

    また、権威サーバーへ接続できないなど、期限切れの情報を更新できない場面では、古い情報を返して可用性を保つserve-staleという仕組みもあります。RFC 8767は期限切れの否定情報にも言及しています。そのため、先ほどのTTL計算を、障害時も含めた復旧時刻の保証にはできません。正常時のキャッシュ期限、障害による解決失敗、期限切れ情報の利用を分けることで、「何を待っているのか」が具体的になります。[5]

    参考資料

    1. RFC Editor, RFC 9499: DNS Terminology、2024年3月。リゾルバー、権威サーバー、TTL、NXDOMAIN、NODATA、negative cachingの用語を参照。
    2. RFC Editor, RFC 2308: Negative Caching of DNS Queries (DNS NCACHE)、1998年3月。§§1〜6。不存在応答の識別、SOAから決まるTTL、保存時と返答時の扱いを参照。解決失敗に関する旧§7は下記RFC 9520の更新と区別。
    3. RFC Editor, RFC 8020: NXDOMAIN: There Really Is Nothing Underneath、2016年11月。§§1.1〜3.2。NXDOMAIN cut、既存キャッシュ・DNSSECの条件、別名連鎖の扱いを参照。
    4. RFC Editor, RFC 9520: Negative Caching of DNS Resolution Failures、2023年12月。§§2〜3。NXDOMAIN/NODATAと解決失敗の区別、失敗を保存する要件を参照。
    5. RFC Editor, RFC 8767: Serving Stale Data to Improve DNS Resiliency、2020年3月。§§4〜7・10。更新できない期限切れ情報の利用条件と否定情報への影響を参照。
  • QuTiPの定常状態は一つとは限らない 初期状態と収束の確かめ方

    QuTiPの定常状態は一つとは限らない 初期状態と収束の確かめ方

    量子系の計算で「十分に時間がたった後」を知りたいとき、QuTiPのsteadystateは便利な入口です。時間発展を長く追わずに、変化しない密度行列を求められます。ただし、返ってきた一つの行列だけでは、どの初期状態からもそこへ落ち着くことや、手元の計算時間で十分に近づいたことまでは分かりません。

    見分けたいのは、定常解があること、定常解が一つであること、その解へ十分に近づいたことです。QuTiP 5.1の公式資料と、版を固定した5.1.1の実装を手掛かりに、二準位の小さな例で確認の順序を整理します。[1][2]

    簡単にまとめると?

    • 定常状態は、その状態から出発すると変化しない状態です。初期状態の情報が残り、複数の定常解が存在する場合もあります。
    • 位相だけを失う二準位では占有確率が残ります。上下の遷移を入れた今回の例では占有確率が一つに定まりますが、近づく速さは成分によって違います。
    • 密度行列の正規化と正値性、定常方程式の残差、零空間、異なる初期状態からの時間発展を、役割を分けて確かめます。

    「動かない状態を求める」と「そこへ到達する」は別の計算

    密度行列ρは、各状態にいる確率と、状態間の位相の関係をまとめたものです。時間に依存しないLindblad方程式を、dρ/dt=L(ρ)と書きます。Lはリウヴィリアンと呼ばれ、ハミルトニアンによる変化と、環境に由来する変化をまとめた作用です。定常状態ρssでは、その変化がゼロになります。[1][3]

    L(ρss)=0、tr(ρss)=1

    前の式は「今から変わらない」、後の式は「確率の合計が1」という条件です。物理的な密度行列であるためには、エルミート性に加え、固有値が負にならない正値性も必要です。

    QuTiPの通常のdirect法は、定常方程式へトレースを1にする条件を加えて線形方程式を解きます。この計算には、時間発展の出発点となる初期状態を指定しません。一方、時間発展を計算するmesolveなどでは初期状態が入力です。前者は「変化しない解」を探し、後者は「この出発点からどこへ進むか」を追っています。[1][2]

    位相だけを失うと、最初の占有確率が残る

    基底状態を|0⟩、励起状態を|1⟩とする二準位を考えます。占有確率とは、その状態にいる確率のことです。ここでは励起状態の占有確率p1=ρ11を使います。ハミルトニアンをH=0とし、位相の関係だけを弱める純粋位相緩和を入れます。

    Cφ=√(γφ/2) Z、Z=|0⟩⟨0|−|1⟩⟨1|、γφ>0

    Cは環境の作用を表す崩壊演算子です。この設定をLindblad項へ代入すると、対角成分である占有確率は変わらず、非対角成分はρ01(t)=ρ01(0)e−γφtで減少します。つまり、位相の関係は薄れても、|0⟩と|1⟩の間で占有確率を移す仕組みがありません。[3]

    そのため、0≦p≦1を満たすどのρ=diag(1−p, p)も定常解です。|0⟩から始めればp=0、|1⟩から始めればp=1のままです。両者とも残差L(ρ)はゼロですが、同じ状態にはなりません。|+⟩=(|0⟩+|1⟩)/√2から始めた場合は、占有確率1/2を保ったまま位相の成分が消え、diag(1/2, 1/2)へ近づきます。

    この例では、トレース1の条件を加えても占有確率を一つに決められません。定常方程式の解空間に自由度が残るためです。ソルバーが特異性を知らせたり、手法によって解の一つが得られたりしても、それを特定の初期状態からの長時間後の答えと同一視しないことが大切です。

    上下の遷移がある例では、収束先と速さを分けて見る

    次に、H=0のまま、|1⟩から|0⟩へ下がる過程と、逆向きに上がる過程を入れます。ここからは純粋位相緩和だけのモデルを置き換えた、別の設定です。

    C↓=√γ↓ |0⟩⟨1|、C↑=√γ↑ |1⟩⟨0|、γ↓, γ↑>0

    占有確率の変化は、入ってくる分と出ていく分の差になります。

    dp1/dt=γ↑(1−p1)−γ↓p1

    変化がゼロになる占有確率は、p1,ss=γ↑/(γ↑+γ↓)です。このモデルでは非対角成分も減衰するので、密度行列全体の定常解が一つに定まります。状態間を遷移する経路ができたことで、最初の占有確率を保持する自由度がなくなりました。

    具体例としてγ↓=3 s−1、γ↑=1 s−1を仮定すると、定常占有確率は1/4です。τ=(γ↓+γ↑)t=(4 s−1)tを無次元の経過時間とすると、

    p1(t)=1/4+[p1(0)−1/4]e−τ、ρ01(t)=ρ01(0)e−τ/2

    となります。下の表はこの仮定モデルから計算した値です。演算子の式から別に組み立てた4×4のリウヴィリアンと行列指数でも照合しました。実験値やQuTiP本体の実行結果ではありません。

    上下遷移モデルの計算例。占有確率の2列は異なる初期状態、位相の列は初期|+⟩に対応します。
    無次元時間τ
    実時間t
    初期|0⟩のp1 初期|1⟩のp1 初期|+⟩の
    |ρ01|
    0
    0 s
    0 1 0.5
    1
    0.25 s
    0.1580 0.5259 0.3033
    5
    1.25 s
    0.2483 0.2551 0.0410
    十分長い時間の極限 0.25 0.25 0

    τ=5では、二つの初期状態の占有確率はすでに1/4へかなり近づいています。それでも、初期|+⟩に残る位相の成分は約0.0410です。この成分は占有確率のずれより遅い指数で減衰します。励起確率だけを見て止めてよいか、密度行列全体の誤差を小さくしたいのかで、必要な計算時間は変わります。

    計算結果は、四つの問いで点検する

    最初は、物理的な状態になっているか。トレース、エルミート性、固有値を確認します。丸め誤差に由来する微小な負値と、大きな負値を同じ扱いにせず、許容誤差を記録します。正規化し直しただけで、不適切な解や一意性の問題が解消するわけではありません。

    次は、その状態が定常方程式を満たしているか。L(ρ)のノルムで残差を見ます。残差はモデル内の変化率なので、時間の単位やLのスケールをそろえて比較します。すべての速度を小さくしただけでも生の残差は小さくなります。小さな残差は有用な確認ですが、先ほどの純粋位相緩和の例のように、一意性は別に調べる必要があります。

    三つ目は、解を一つに決めるだけの条件があるか。小さなモデルなら、Lの零空間、つまりLがゼロへ写す行列の集合を調べられます。今回の独立計算では、その次元は純粋位相緩和で2、上下遷移で1でした。トレース1という条件を加えた後に自由度が残るかが違います。数値上ゼロとみなすしきい値を変えても結果が安定しているかを確認し、大規模・悪条件の行列へ小例の精度をそのまま持ち込みません。

    最後は、必要な精度まで近づいたか。異なる占有確率から出発させ、位相も重要なら重ね合わせ状態も加えて、時間を延ばした結果を比較します。この例ではLの零でない固有値は−4 s−1と−2 s−1で、位相の成分のほうが遅く減衰します。一般のモデルでも遅い成分の時間尺度は手掛かりになりますが、いくつかの初期状態で一致したというだけで、すべての初期状態についての証明にはしません。

    QuTiPの停止条件を、物理的な一意性と混同しない

    固定した5.1.1の実装には、method='propagator'もあります。初期密度行列rhoへ時間発展を繰り返し作用させ、反復前後の状態の距離がpropagator_tol以下になると返す方法です。rhoを省略した場合はランダムな密度行列から始め、収束しない場合は反復上限で例外を返します。[2]

    ここで判定しているのは、選んだ出発点からの反復がどれだけ変化したかです。純粋位相緩和のように定常解が複数ある系では、到達する占有確率は初期状態に依存します。また、モデルの変化がとても遅ければ、短い間隔での変化が小さいことと、最終状態に近いことは別になります。初期状態、時間間隔、許容誤差を変えて確かめる理由はここにあります。

    一意な定常状態が欲しいのか、保存される初期情報を調べたいのかで、計算結果の読み方は変わります。まず環境との相互作用が何を変え、何を残すモデルなのかを確認し、その上でソルバーの出力と時間発展を照合すると、定常状態の計算を目的に結び付けやすくなります。

    参考資料

    1. QuTiP 5.1 Documentation, Solving for Steady-State Solutions。定常方程式、計算法、時間発展との比較例。
    2. QuTiP, steadystate API、5.1.1の固定実装。トレース条件、各手法、propagatorの初期状態と停止条件。参照版を固定しており、現在の最新版という意味ではありません。
    3. QuTiP, 5.1.1のliouvillian / lindblad_dissipator実装。本文の二準位モデル、解の導出と表の数値は、このLindblad形式を用いた独自の説明・計算例です。
  • WCAG 2.2のターゲットサイズ、ボタンの大きさと間隔をどう測るか

    WCAG 2.2のターゲットサイズ、ボタンの大きさと間隔をどう測るか

    画面の小さなボタンを押そうとして、隣の操作を選んでしまう。こうした誤操作を減らすには、アイコンを見やすくするだけでなく、実際に反応する範囲と、その周りの余白を考える必要があります。指先でのタッチに限らず、マウスやペンで細かい位置を狙うときにも関わる設計です。

    ウェブのアクセシビリティ指針であるWCAG 2.2には、この範囲を評価する「ターゲットサイズ」の達成基準があります。よく見かける24ピクセルと44ピクセルは、同じ基準の言い換えではありません。何を測り、どこまで判断できる数字なのかを、ボタンの配置例から整理します。[1]

    簡単にまとめると?

    • 測るのはアイコンの絵ではなく、クリックやタップを受け付ける領域です。CSSピクセルは、画面を構成する物理的な画素とは別の単位です。
    • レベルAAの達成基準2.5.8では、原則24×24 CSSピクセル以上。小さいターゲットでも、所定の間隔などの例外条件を満たせば、この基準を満たせます。
    • 44×44 CSSピクセルは、より高いレベルAAAの別の達成基準です。最低条件への適合と、使う人にとっての操作しやすさは分けて確かめます。

    アイコンの外側も反応するなら、そこまでがターゲット

    WCAGでいうターゲットは、画面上でポインター操作を受け付ける領域です。たとえば、中央に16×16の絵があり、その周囲を含む32×32 CSSピクセルの正方形全体が同じボタンとして反応するなら、評価する大きさは32×32です。絵の外側が単なる背景で、押しても何も起きないなら、その余白はターゲットに含められません。これは定義に基づく説明例で、特定の製品を測定した結果ではありません。[1]

    ここでのCSSピクセルは、ウェブのレイアウトで使う単位です。高密度のディスプレーの物理的な画素数を、そのまま24や44と比較するものではありません。また、利用者がページを拡大すれば見た目は大きくなりますが、それを前提に元のターゲットサイズの不足を解消したことにはできません。[1][2]

    24×24の大きさか、隣と取り違えにくい間隔か

    レベルAAの達成基準2.5.8「Target Size (Minimum)」は、原則としてターゲットに24×24 CSSピクセル以上の大きさを求めています。W3Cの解説では、画面の横軸・縦軸に沿った24×24の正方形が、操作できる領域の中に収まるかで考えます。丸や角の丸い形では、外接する四角の幅と高さだけを見て済ませない点にも注意が必要です。[1][2]

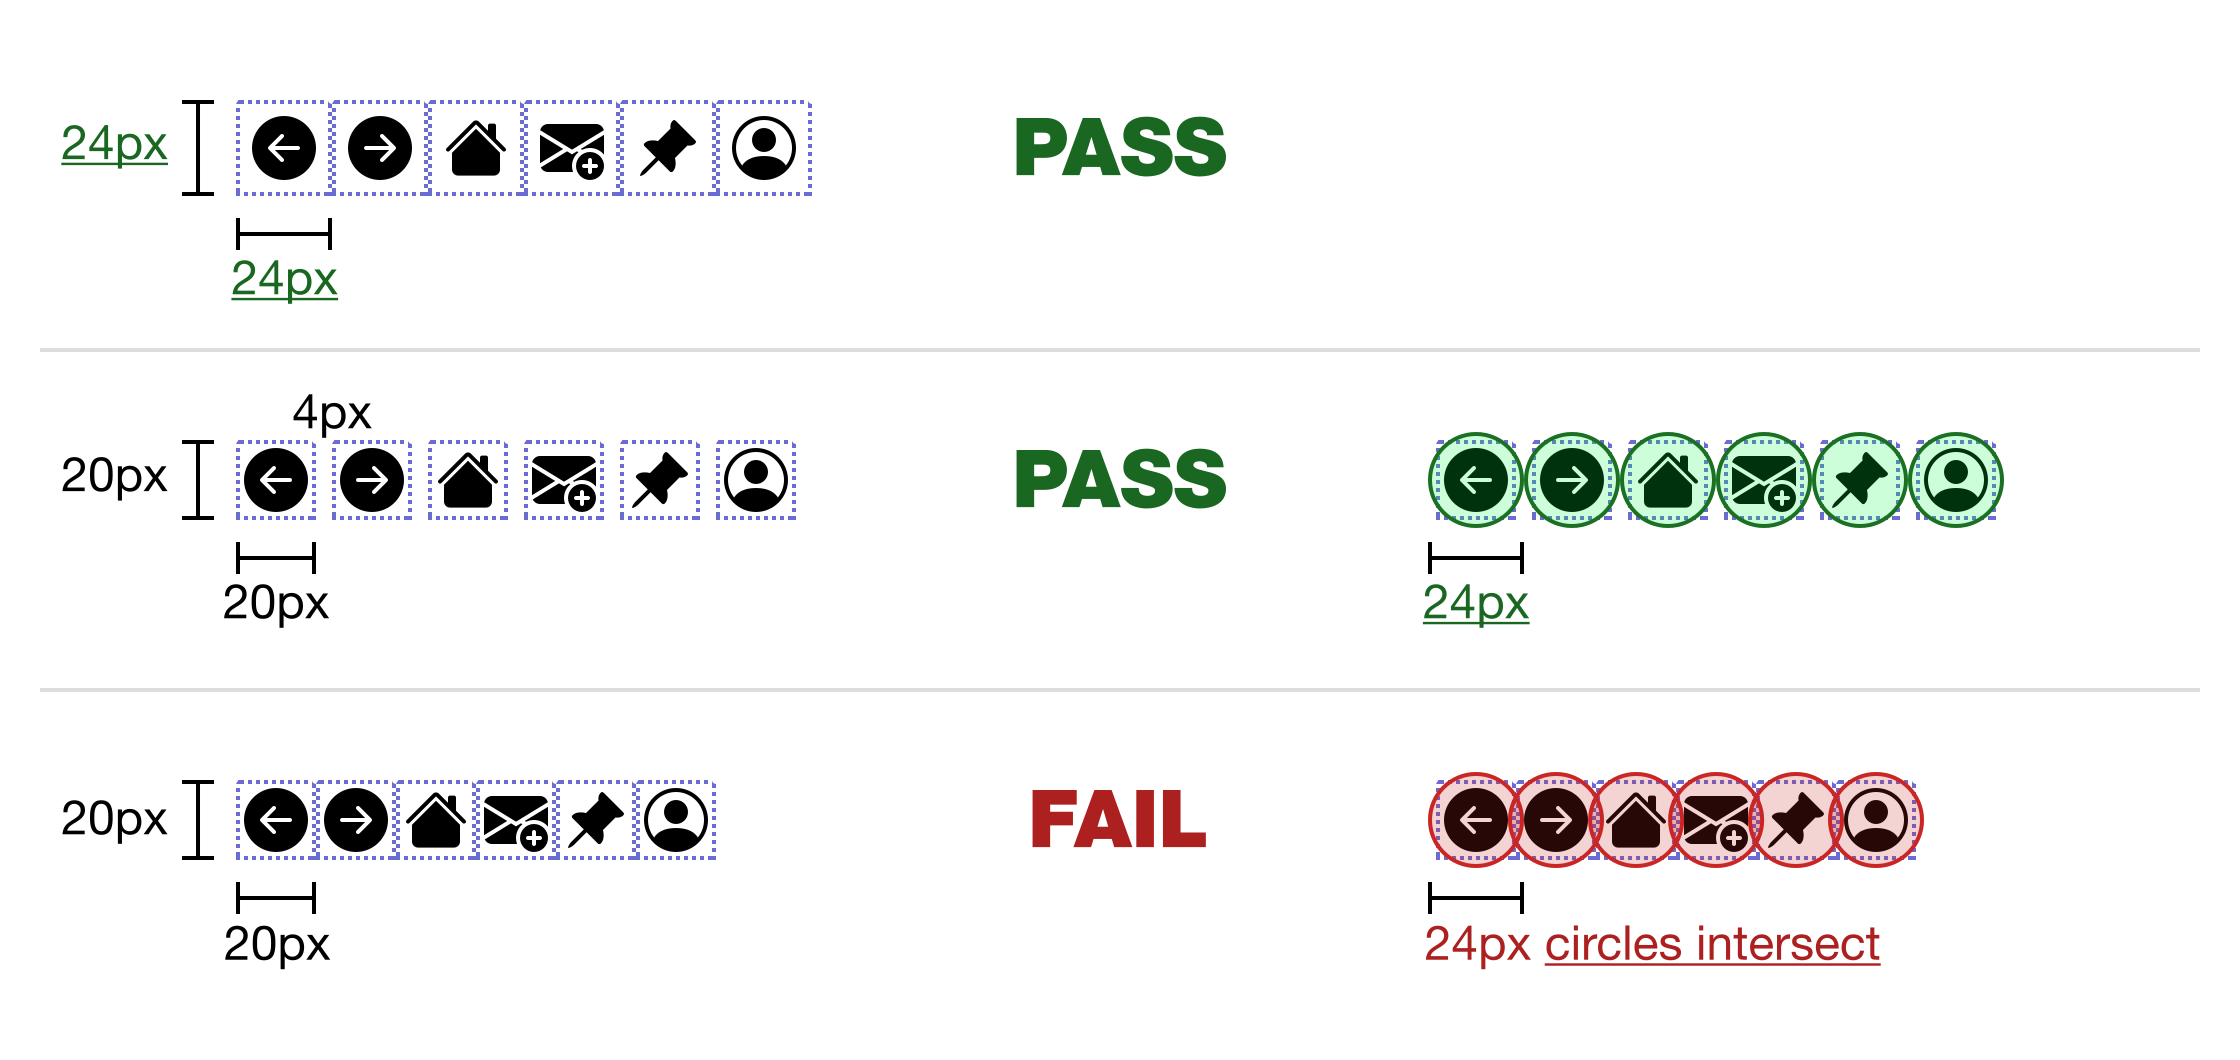
    それより小さいターゲットには、間隔による例外があります。まず、横軸・縦軸に沿ってターゲットを囲む最小の長方形、つまりバウンディングボックスの中心に、直径24 CSSピクセルの仮想の円を置きます。近くの小さなターゲットにも同じ円を置き、他のターゲットや他の円と重ならないかを調べます。円は評価のための目印であって、実際の反応領域を円形に広げる指示ではありません。[1][2]

    下のW3Cの図は、同じ種類のボタンを三通りに配置した例です。上段は各ターゲットが24×24で、大きさの条件を満たします。中段は20×20ですが、間に4 CSSピクセルの余白があります。隣どうしの中心間は20+4=24となり、間隔の例外を満たします。下段は20×20を隙間なく並べたため、直径24の円が重なり、この例外を満たしません。[2]

    三段のボタン配置。上段は24×24 CSSピクセルで合格、中段は20×20と4ピクセルの間隔で合格、下段は20×20で間隔がなく仮想円が重なり不合格。
    W3C「Understanding SC 2.5.8」Figure 5。大きさで満たす例、間隔で満たす例、間隔が不足する例の比較。図は説明用に拡大表示しており、表示上の寸法ではなく図中のCSSピクセル値を読みます。狭い画面では図を左右にスクロールできます。
    Copyright © 2026 World Wide Web Consortium. 原図と解説。W3C Software and Document License(2023)、利用条件全文。SVGをPNGへ変換し、内容の変更・切抜きはしていません。

    ただし、「ボタンの間には常に4ピクセルあればよい」という規則ではありません。4は、この20×20の正方形を一列に並べた例から出てくる値です。上下にも別のボタンがあれば、そちらとの重なりも確認します。相手が大きなターゲットなら、小さなターゲットに置いた円と、その大きな領域自体の重なりを調べます。[2]

    44ピクセルは、間隔の代わりではなく別の基準

    44×44 CSSピクセルは、レベルAAAの達成基準2.5.5「Target Size (Enhanced)」に登場します。こちらにも文章中のリンクなどの例外はありますが、2.5.8と同じ「間隔」の例外はありません。20×20のボタンを離して配置し、2.5.8を満たせたからといって、2.5.5も満たしたとはいえません。[1][3]

    二つのターゲットサイズ基準の違い(原文から編集部整理)
    達成基準 基本の大きさ 間隔による例外 評価の範囲
    2.5.8 Minimum・AA 24×24 CSSピクセル 所定の円で確認する条件がある 小さいターゲットと隣の領域を含めて確認
    2.5.5 Enhanced・AAA 44×44 CSSピクセル 同じ例外はない 大きさと、この基準に定められた別の例外を確認

    また、この二つはWCAG全体の一部です。2.5.8を満たすだけで、そのページ全体がレベルAAに適合したことにはなりません。レベルAAには、レベルAとAAのすべての達成基準など、適合のための要件を満たす必要があります。[1]

    文章中のリンクを、すべてボタンに広げる必要はない

    2.5.8には、間隔以外にも四つの例外があります。同じページに条件を満たす別の操作手段がある場合、文章内や非ターゲット文字の行高に制約される場合、ブラウザー等が決めた大きさを作者が変えていない場合、特定の表示が情報を伝えるうえで不可欠、または法令で必要とされる場合です。例外ごとに条件が異なるので、見た目が小さいことだけで一律に不合格にはできません。[1][2]

    たとえば文の途中のリンクは、画面幅に応じた折り返しと文章の読みやすさを保つ必要があります。一方、独立した操作ボタンまで、文字が載っているというだけで文章内リンクの例外にできるわけではありません。先に「これはどんな操作領域か」を確かめることが、寸法の測定と同じくらい大切になります。[2][3]

    最低条件を確認した後に、使う場面を確かめる

    設計や点検では、まず実際に反応する領域を確かめ、次に大きさ、必要なら隣との間隔や例外を確認すると、判断の根拠を残しやすくなります。小さなアイコンの印象だけで決めず、領域を広げる、配置を離す、重要な操作を大きくする、といった変更を区別して検討できます。

    それでも、周囲に何もない極小のターゲットは、間隔の例外を満たしながら狙いにくいことがあります。W3Cの解説もこの限界を示し、間隔によらず最低限の大きさを確保することや、重要な操作でより厳しい基準を目指すことを勧めています。頻繁に使う操作、取り消しにくい操作、届きにくい位置などは、利用する人と状況を踏まえて大きさを決める材料になります。[2][3]

    この記事は仕様と公式解説の読み方を扱っており、利用者テストや誤操作率の測定は行っていません。数値は点検の出発点です。基準への適合確認と、実際の利用場面で無理なく操作できるかの確認を、両方持つことが役立ちます。

    参考資料

    1. W3C, Web Content Accessibility Guidelines (WCAG) 2.2、W3C Recommendation、2024年12月12日版。達成基準2.5.8・2.5.5、用語「target」「CSS pixel」、適合要件5.2.1を参照。
    2. W3C WAI, Understanding SC 2.5.8: Target Size (Minimum)。2026年5月11日更新表示、2026年10月14日確認。規範そのものではない解説資料。大きさ・間隔の説明、Figure 3〜5と周辺の配置例を参照。
    3. W3C WAI, Understanding SC 2.5.5: Target Size (Enhanced)。2026年10月14日確認。44 CSSピクセルの条件、例外、使う場面に応じた配慮を参照。
    4. 原図の利用条件:W3C Software and Document License — 2023 version。
      原図の著作権表示と利用条件全文

      This article includes Figure 5 copied from Understanding SC 2.5.8: Target Size (Minimum). Copyright © 2026 World Wide Web Consortium. All Rights Reserved. SVG converted to PNG and displayed at a different scale; no diagram content changed or cropped. This work is distributed under the W3C Software and Document License in the hope that it will be useful, but WITHOUT ANY WARRANTY; without even the implied warranty of MERCHANTABILITY or FITNESS FOR A PARTICULAR PURPOSE.

      W3C liability and trademark notices apply.

      This work is being provided by the copyright holders under the following license.

      License

      By obtaining and/or copying this work, you (the licensee) agree that you have read, understood, and will comply with the following terms and conditions.

      Permission to copy, modify, and distribute this work, with or without modification, for any purpose and without fee or royalty is hereby granted, provided that you include the following on ALL copies of the work or portions thereof, including modifications:

      • The full text of this NOTICE in a location viewable to users of the redistributed or derivative work.
      • Any pre-existing intellectual property disclaimers, notices, or terms and conditions. If none exist, the W3C software and document short notice should be included.
      • Notice of any changes or modifications, through a copyright statement on the new code or document such as “This software or document includes material copied from or derived from [title and URI of the W3C document]. Copyright © [$year-of-document] World Wide Web Consortium. https://www.w3.org/copyright/software-license-2023/“

      Disclaimers

      THIS WORK IS PROVIDED “AS IS,” AND COPYRIGHT HOLDERS MAKE NO REPRESENTATIONS OR WARRANTIES, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO, WARRANTIES OF MERCHANTABILITY OR FITNESS FOR ANY PARTICULAR PURPOSE OR THAT THE USE OF THE SOFTWARE OR DOCUMENT WILL NOT INFRINGE ANY THIRD PARTY PATENTS, COPYRIGHTS, TRADEMARKS OR OTHER RIGHTS.

      COPYRIGHT HOLDERS WILL NOT BE LIABLE FOR ANY DIRECT, INDIRECT, SPECIAL OR CONSEQUENTIAL DAMAGES ARISING OUT OF ANY USE OF THE SOFTWARE OR DOCUMENT.

      The name and trademarks of copyright holders may NOT be used in advertising or publicity pertaining to the work without specific, written prior permission. Title to copyright in this work will at all times remain with copyright holders.

  • Floquet法で周期駆動を読む、一周期後と途中の状態の違い

    Floquet法で周期駆動を読む、一周期後と途中の状態の違い

    同じ周期で駆動する二つの量子系を、一周期ごとの同じタイミングで比べると、結果が一致する。では、その途中も同じように動いているのでしょうか。周期に同期した記録は便利ですが、周期内だけに現れる違いを見落とすことがあります。

    Floquet(フロケ)法は、繰り返す駆動の下での量子状態を、「一周期ごとに積み重なる変化」と「周期内で繰り返す変化」に分けて扱います。QuTiP 5.1.1の公開実装と小さな可解モデルから、準エネルギーの値だけでは何が分からず、どの時刻の状態を比較すればよいのかを見ていきます。[1][2]

    簡単にまとめると?

    • 準エネルギーは、一周期の時間発展に含まれる位相の進みを表します。その瞬間のハミルトニアンのエネルギーとは別です。
    • 一周期後の時間発展が同じ二つのモデルでも、周期内の観測値は違い得ます。周期ごとの記録だけで、途中の状態まで一致したとは言えません。
    • 駆動の周期、時間の原点、初期状態、観測量と観測時刻を揃えます。QuTiPでは周期的なモードと、位相を含む実際の状態を区別して読みます。

    準エネルギーは、一周期で進む位相から求める

    外からの駆動が周期Tで繰り返すなら、量子状態の変化を定めるハミルトニアンもH(t+T)=H(t)となります。本稿では、環境への散逸を含めない閉じた系を扱います。Floquet法では、その状態の基本的な解を、一定の速さで進む位相と、周期Tで繰り返す部分に分けられます。後者をFloquetモード、位相の進みを定める量を準エネルギーと呼びます。[1]

    一周期の時間発展をまとめた演算子をU(T,0)と書きます。これは、時刻0の状態を時刻Tの状態へ移す働きです。その固有値は、閉じた系では大きさ1の複素数になり、角度が一周期の位相の進みを表します。QuTiPのFloquetBasisも、一周期の伝播を計算して対角化し、固有値の角度からe_quasiを求めます。ここでいう伝播は、位置の移動に限らず、量子状態の時間発展です。[2]

    一周して2πだけ余分に回った位相は、一周期後の複素数としては区別できません。そのため、準エネルギーにはℏΩの整数倍を加えても同じ表現になる自由度があります。Ωは駆動の角周波数でΩ=2π/T、ℏはエネルギーと位相の進みを結ぶ定数です。準エネルギーをずらしたときは、周期モード側の位相も合わせて変えます。物理的な状態そのものが変わるわけではありません。[1][2]

    したがって、準エネルギーを、その瞬間にH(t)を対角化して得るエネルギーと同じものとして読むことはできません。駆動条件を変えたグラフで値が折り返して見える場合も、選んだ表示範囲を確認する必要があります。固定版の実装は複素数の角度の主値を使い、一つの範囲へ折り返した値を返します。

    一周期後が同じになる、二つの駆動を比べる

    違いを具体的に見るため、状態0と1を持つ二準位系を用意します。最初は両者を同じ重みで重ねた|+⟩=(|0⟩+|1⟩)/√2とします。観測するのは、同じ|+⟩として得られる確率です。0・1それぞれの確率だけではなく、二つの成分の位相の関係に応じて変わる量を選びます。

    説明用のハミルトニアンはH(t)/ℏ=[ω₀+A cos(Ωt)]Z/2です。Zは0の成分に+1、1の成分に−1を掛ける演算子、ω₀は一定の成分、Aは周期的に加える成分の振幅です。ω₀、A、Ωは同じ角周波数の単位で揃え、Ωは正とします。ここではω₀=Ω/4とし、周期成分を加えないA=0と、加えるA=Ωを比較します。実機のパルスや測定値を指定したものではありません。

    このモデルでは、二成分の間に積み重なる位相差はΔ(t)=ω₀t+(A/Ω)sin(Ωt)です。従って、調べたい確率はP₊(t)=[1+cosΔ(t)]/2となります。一周期の整数倍ではsinの項が0になるので、両モデルの時間発展は一致します。一方、その間ではsinの項が残り、確率が変わります。

    同じ初期状態から出発したときのP₊。Quantum Seaによる独立計算、数値は小数第4位まで。
    観測する時刻 周期成分なし A=0 周期成分あり A=Ω
    0 1.0000 1.0000
    T/4 0.9619 0.5886
    T/2 0.8536 0.8536
    3T/4 0.6913 0.9921
    T 0.5000 0.5000
    2T 0.0000 0.0000

    狭い画面では表を横にスクロールできます。閉じた形の式とは別に、Schrödinger方程式を数値積分して照合しました。QuTiP本体や量子装置を実行した結果ではなく、指定した二準位モデルの独立検算です。

    この二つのモデルでは、一周期の演算子自体が同じで、準エネルギーの代表値も±ℏΩ/8で一致します。それでも、T/4の確率は約0.96と約0.59、3T/4では約0.69と約0.99に分かれます。なお、一般には準エネルギーの値だけが一致しても、対応する固有状態が違えば、一周期の演算子まで同じとは限りません。ここでは演算子の一致も別に確かめています。

    また、駆動が周期Tで繰り返すからといって、状態も毎回同じ状態へ戻るわけではありません。表でも確率は0、T、2Tで1、0.5、0と変わっています。周期モードが繰り返すことと、その上に積み重なる位相を含む状態が繰り返すことは別です。

    周期モードから、観測する状態へ戻す

    QuTiP 5.1.1では、FloquetBasis.mode(t)は時刻を周期Tで折り返して、周期的なモードを返します。一方、state(t)はそこへ準エネルギーに対応する位相の進みを掛けます。関数名が似ていても、返すものの役割は異なります。[2][3]

    任意の初期状態を扱うときは、初期状態をFloquetの基底へ分解し、必要な時刻の状態を元の基底へ戻してから観測量を計算します。同版にはto_floquet_basisとfrom_floquet_basisがあり、fsesolveもこの流れを使っています。係数や準エネルギーだけを取り出して、周期内で変わるモードを落とすと、先ほどのT/4のような違いを再現できません。[2]

    渡すTは、見たい計算時間の長さではなく、ハミルトニアンが繰り返す周期です。確認したfsesolveはTを省略した場合、最後の出力時刻を周期として使うため、長い時間区間を計算するなら実際の周期を明示することが大切です。出力時刻も、一周期ごとだけが必要なのか、周期内の特定のタイミングが必要なのかを、読みたい現象に合わせて選びます。[2]

    「平均すればよい」と広げないための条件

    今回の例は、異なる時刻のハミルトニアンがすべて同じZに比例する、特別に解きやすいモデルです。時間発展の順序を入れ替えても結果が変わらないので、周期成分の一周期の積分が0になることを、そのまま使えました。異なる方向の作用を組み合わせ、順序で結果が変わる一般の駆動では、ハミルトニアンを単純に時間平均して同じ結果になるとは限りません。

    比較するときは、周期と駆動の開始位相、初期状態、観測量、観測時刻を揃えます。毎周期の状態を知りたいなら一周期の演算子が出発点になりますが、途中で操作や測定を行うなら、その時刻のモードと状態も必要です。準エネルギーの図だけで結論を出さず、実際に使うタイミングで何が観測されるかまで戻して比べます。

    さらに、本稿は閉じた系の話です。環境による緩和まで含めるには、駆動下での環境との結合や近似を別に確認する必要があります。QuTiPにはFloquet-Markovの機能もありますが、この二準位の比較だけで、その近似や実機の損失まで検証したことにはなりません。[1][2]

    参考資料

    QuTiP 5.1.1の固定コミット7accc77a70a08f965a29fdd13515f79cdcab9703と5.1系公式文書を2026年10月14日に確認しました。最新版一般の評価ではありません。本文の式と表はQuantum Seaによる独立計算で、速度向上や実機性能の実証ではありません。QuTiPへハミルトニアンを渡す際のℏ=1の表記では、準エネルギーに対応する値は角周波数の単位になります。

    1. QuTiP 5.1 Documentation, Floquet Formalism。周期モード、準エネルギー、一周期の伝播演算子と、閉じた系・散逸系の区別。
    2. QuTiP 5.1.1, floquet.py。FloquetBasisの初期化、mode/state、基底変換、fsesolveの周期指定を参照。コードの利用条件はBSD 3-Clause。
    3. QuTiP 5.1 API, FloquetBasis。一周期の伝播、準エネルギー、時刻を指定する基底変換の入出力。
  • Linux cgroup v2のCPU制御、上限時間と配分の重みの違い

    Linux cgroup v2のCPU制御、上限時間と配分の重みの違い

    同じLinuxサーバーで二つの処理を動かすとき、「片方へ多くのCPU時間を配ること」と「片方が使えるCPU時間に上限を置くこと」は別の操作です。この違いを見落とすと、配分の重みを上げたのに処理が進まない、あるいは軽い処理まで上限に抑えられる、といった状況を読み違えます。

    cgroup v2は、プロセスをグループにまとめ、階層に沿って資源の使い方を管理するLinuxの仕組みです。CPU制御にあるcpu.weightとcpu.maxは何を決めるのか。Linux 6.12の公式文書をもとに、時間の単位と小さな配分例から整理します。ここでは通常のスケジューリング方針で動く処理を対象にし、リアルタイム処理は扱いません。[1][2]

    簡単にまとめると?

    • cpu.weightは、同じ親の下でCPUを使おうとしているグループ同士の配分比です。固定のCPU使用率や、処理速度の保証ではありません。
    • cpu.maxは、一定期間に使えるCPU時間の上限を指定します。複数のCPUで同時に動くと、その時間を合計して消費します。
    • 重みを増やしても、自分や親の時間上限は超えられません。比較するときは設定値だけでなく、使えるCPU、上位の制限、抑制の記録を一緒に見ます。

    cpu.weightは、競合している相手との比率

    CPUで実行する準備ができている処理が複数あれば、どれに実行時間を配るかを決める必要があります。cpu.weightは、その配分に使う相対的な重みです。同じ親を持ち、その時点で資源を使える子グループの重みを合計し、それぞれの割合に応じて配分します。通常の、cpu.idle=0のグループでは範囲が1〜10,000、既定値は100です。[1]

    例えば、同じ一つの論理CPUを使う兄弟グループAとBを考えます。Aの重みを100、Bを200にし、両方が常に実行可能で、ほかに競合する処理や帯域上限がないとします。配分モデル上の比率は、Aが100÷300で約3分の1、Bが200÷300で約3分の2です。これは十分な時間で見た配分を考えるための計算例で、100ミリ秒ごとに必ずその通りになる実測結果ではありません。

    ここでBが入出力待ちなどでCPUを使わなくなれば、Aは空いた時間も使えます。重み100が「CPUを100%使う」、あるいは「上限は3分の1」という意味ではないためです。また、Bの重みを2倍にしたことから、同じ仕事が必ず半分の時間で終わるとも言えません。CPUで処理する時間以外に待ちがあれば、その部分は配分比だけでは縮まりません。

    cpu.maxは、期間ごとに使うCPU時間の予算

    cpu.maxは「使えるCPU時間の上限」と「その期間」を、二つの値で表します。順番はMAX PERIODで、どちらもマイクロ秒です。1,000マイクロ秒が1ミリ秒なので、200000 100000なら、100ミリ秒の期間に合計200ミリ秒分のCPU時間を使える設定です。[1]

    経過する時間よりCPU時間が多くなるのは、複数のCPUで同時に実行できるからです。二つの論理CPUで100ミリ秒ずつ実行すれば、合計は200ミリ秒になります。上限÷期間の200,000÷100,000=2は、平均で論理CPU二つ分に相当する実行時間を示します。「特定のCPUを二つ専有する」という指定ではありません。[2]

    逆に、実行可能なスレッドが一つしかなければ、そのスレッドが二つのCPUで同時に走るわけではありません。使ってよい時間に余裕があっても、処理を並行して進められなければ使い切れません。また、割り当てられるCPUの範囲はcpusetなど別の設定にも左右されます。cpuset.cpus.effectiveは、そのグループに実際に認められたCPUの一覧です。[1]

    既定値のmax 100000は、そのグループ自身の帯域上限を設けない設定です。maxにしても親の上限は残り、空いているCPU時間や実行できるスレッド数が増えるわけではありません。

    並列に使うほど、同じ時間予算を早く消費する

    同じ200000 100000でも、四つのスレッドが四つの論理CPUで一斉に動けば、理想化した計算では50ミリ秒で合計200ミリ秒分を消費します。その後も実行したい処理が残っていれば、予算の補充まで抑制される場面があります。この上限による実行の抑制をスロットリングと呼びます。

    帯域制御は、グループの時間予算をCPUごとの実行待ち行列へ小分けに渡します。追加の時間を渡せなくなると、そのグループの処理は実行を抑えられ、次の期間で予算が補充されます。したがって、平均でCPU二つ分という上限でも、四つで短く動いて待つ形と、二つで長く動く形では、処理が進むタイミングが変わり得ます。[2]

    50ミリ秒という値は、常時実行可能な四つのスレッドが待たずに走る、という説明用の計算です。実際にはほかの処理との競合や時間予算の小分け配分があります。さらに、CPUごとに残った小さな未使用枠が次の期間へ持ち越される例外や、cpu.max.burstで蓄積した未使用枠を一時的に使う機能もあります。本文の単純な計算では追加のバースト枠を使わず、残枠の持ち越しも省いています。単一期間の厳密な実行波形を再現したものではありません。[1][2]

    重みを上げても、上限を超える許可にはならない

    AとBが同じ一つの論理CPUを使う例に戻ります。次の表は、ほかの競合や親の制限がなく、Aは常に実行可能という条件で、設定の意味を比較したものです。性能測定ではありません。

    同じ親を持つA・Bの配分例。重みはA=100、B=200。Bの動作状態とAの上限だけを変える。
    条件 Aが使える時間の考え方 判断のポイント
    A・Bとも実行可能、帯域上限なし 配分モデルでは約3分の1 重みは競合する相手との比率
    BはCPUを使わず、Aの帯域上限なし 空いたCPU時間も使える 3分の1に固定されない
    BはCPUを使わず、Aに20000 100000の上限 設定上は100ミリ秒につき20ミリ秒分 相手が休んでも、自分の上限は残る

    最後の条件でAの重みを増やしても、20ミリ秒分という自分の時間予算は変わりません。CPUが空いて見えるのに処理が止まる場合、競合に負けているのか、上限へ達したのかを分ける必要があります。

    親の制限も同様です。子グループに時間予算が残っていても、親が全体の予算を使い切れば、その子は親の予算が補充されるまで実行を抑えられます。また、異なる親の下にあるグループ同士では、末端の重みだけを比べても全体の配分比は分かりません。資源は階層に沿って配られるためです。[1][2]

    設定の目的と、実際の待ちを分けて確認する

    混雑時にどちらへ多くの時間を配るかを決めたいなら、cpu.weightが扱う問いです。一方、空いているときも含めてグループのCPU時間を制限したいなら、cpu.maxが扱う問いになります。ただし、上限を低くすることと、個々の要求が早く終わることは同じではありません。平均の使用量が抑えられても、上限に達した後の待ちが応答時間へ影響する場合があります。

    確認には、対象グループとその親の設定に加え、cpu.statの使用時間やスロットリングの記録を使えます。cgroup v2では、usage_usecがCPU使用時間、nr_periodsが帯域制御の期間数、nr_throttledが抑制の発生した期間数、throttled_usecが抑制時間に関わる統計です。時間の単位はマイクロ秒です。稼働開始からの合計だけで比較せず、同じ観測区間の前後の差を取り、要求の応答時間も別に測ると、設定と症状の関係を追いやすくなります。[1][2][3]

    ここで、抑制が発生した期間数を「遅くなった要求の件数」と読み替えたり、抑制時間をそのまま一つの要求の遅延とみなしたりしないことが大切です。CPU時間が同じでも、CPUの動作周波数や処理内容によって進む仕事量は変わります。重みは相手との配分、上限は時間の予算、応答時間は利用者が待った結果です。この三つを分けると、増やすべきものが配分なのか予算なのか、それ以外の待ちを調べるべきかを判断しやすくなります。

    参考資料

    Linux 6.12の公式文書と同版の原文を参照しています。表と時間計算は仕様を説明するための例であり、実機の設定変更や性能測定は行っていません。

    1. The Linux Kernel documentation, Control Group v2。What is cgroup、Resource Distribution Models — Weights、CPU、CPU Interface Files、Cpuset Interface Files。補助照合:v6.12の文書原文。
    2. The Linux Kernel documentation, CFS Bandwidth Control。帯域制御の仕組み、Statistics、Hierarchical considerations、CFS Bandwidth Quota Caveats、Examples。管理ファイル名と統計の単位は文書内のcgroup v1表記を流用せず、上記cgroup v2文書と対応させています。補助照合:v6.12の文書原文。
    3. Linux v6.12, kernel/sched/fair.c。do_sched_cfs_period_timerでのnr_periodsとnr_throttledの更新。抑制が発生した期間を数えることの補助確認。
  • 量子軌道法の計算はいつ止めるか、QuTiPの軌道数と誤差目標

    量子軌道法の計算はいつ止めるか、QuTiPの軌道数と誤差目標

    量子ビットが周囲へエネルギーを失う様子を計算すると、平均は滑らかに減っていきます。一方、環境で光子を検出する記録に応じて状態を追えば、変化が突然起きる経路も現れます。同じモデルを扱っていても、一本の経路と、多数の経路を集めた平均は別の結果です。

    QuTiPのmcsolveは、このような「量子軌道」を計算するソルバーです。軌道数を増やせば何が改善し、計算が終了したときには何を確認すればよいのでしょうか。QuTiP 5.1.1の固定実装を読み、小さな独立計算で判断の手掛かりを整理します。最新版や実機の性能評価ではありません。[1][2]

    簡単にまとめると?

    • 量子軌道は、環境の観測記録を条件にした状態の時間経路です。最後の状態から測定結果を何回取り出すか、というショット数とは分けて考えます。
    • 軌道ごとのばらつきと、平均を推定する誤差は別です。まれな変化が標本に出ないだけで、変化が起きないとは判断できません。
    • 軌道数、時間制限、誤差目標のどれで止まったかを確認します。統計的な誤差目標は、物理モデルや数値積分の正しさまで保証しません。

    滑らかな平均を、条件付きの経路から作る

    環境とやり取りする量子系では、密度行列を使って多数の実現の平均的な変化を求める方法があります。量子軌道法は、同じ開放系モデルに対して、環境の観測記録に対応する経路を生成し、その結果を平均する方法です。ここでは、光子を数える観測のように、検出のたびに状態が変わる量子ジャンプの表現を扱います。物体が空間を走る軌跡ではなく、量子状態の時間経路です。[1]

    計算では、ジャンプがまだ起きていない状態を進め、その生存確率と乱数を比べて、ジャンプの時刻を選びます。ジャンプ時には、c_opsで指定した作用を状態へ適用し、正規化して先へ進みます。環境をどのように観測するかという表現に依存するため、一本の軌道を、測定方法によらない実物の唯一の履歴とみなすことはできません。[1][2]

    この方法では、一本ずつの状態ベクトルを扱うことで、大きな密度行列を直接進める負担を減らせる場合があります。ただし、必要な平均精度を得るために多数の経路が要ることもあります。状態空間の大きさだけでなく、観測したい量、必要な精度、保存する経路数を揃えて選ぶ必要があり、「軌道法なら必ず速い」という関係ではありません。

    一本は途中で変わり、平均は少しずつ変わる

    二つの状態0と1を持つ、説明用のモデルを考えます。最初は励起状態1にあり、速度γで基底状態0へ緩和します。再励起する駆動はなく、ハミルトニアンは0、環境の作用はC=√γ|0⟩⟨1|です。γは時間の逆数の単位で、時間を秒で表すなら毎秒です。以下では無次元の時間τ=γtを使います。

    このモデルでは、一回のジャンプの後は0に留まります。それぞれの正規化された軌道では、ジャンプまでは1の確率が1、ジャンプ後は0です。多くの軌道を平均すると、時刻τにまだ1にいる割合はexp(−τ)となります。個々の経路の突然の変化と、平均の滑らかな減少は矛盾しません。

    ここでは一様乱数UからγJ=−log(U)でジャンプ時刻Jを生成する独立コードを用意しました。乱数シードを20261014に固定し、同じ10,000本の先頭100本、1,000本、全体を集計した結果です。QuTiP本体の実行結果ではなく、同じ単純モデルの待ち時間を直接生成した数学的検算です。

    τ=1で1に留まる割合。理論値は約0.367879。Quantum Seaによる独立計算。
    軌道数M 標本の平均 理論値との差の絶対値 平均の理論標準誤差
    100 0.3500 約0.01788 約0.04822
    1,000 0.3440 約0.02388 約0.01525
    10,000 0.3676 約0.000279 約0.004822

    狭い画面では表を横にスクロールできます。平均の理論標準誤差は、独立なM本をあらかじめ決めて集める場合の√(p(1−p)/M)で、ここではp=exp(−1)です。回数を増やすほど推定のばらつきは小さくなりますが、個別の標本の誤差が毎回小さくなる保証はありません。この実行でも、100本から1,000本へ増やした段階では理論値との差が一度広がっています。

    「ばらつきゼロ」が、十分な計算を意味しない場合

    同じモデルでも、短い時間τ=0.01では、一軌道にジャンプが起きる確率は約0.995%です。このとき、独立な100本がすべてジャンプしない確率は(exp(−0.01))100=exp(−1)、約36.8%もあります。0回という結果は、十分に起こり得る標本です。

    その標本だけを見れば、励起状態の値は全軌道で1となり、経験的な分散は0です。しかし、モデル上のジャンプ確率まで0になったわけではありません。まれな過程を調べるなら、無変化の標本が得られる確率や、軌道数を増やした比較も確かめます。結果が静かだから十分、と判断しないための具体例です。

    QuTiPのstd_expectにも注意が必要です。確認した実装は、各軌道の期待値の二乗平均と平均の二乗からばらつきを計算します。これは軌道間の標準偏差であり、そのまま平均の推定誤差を表す欄ではありません。上の単純な独立・等重みの例では、軌道間の理論標準偏差は√(p(1−p))、平均の標準誤差はさらに√Mで割った値です。重み付きの計算や、結果を見て途中で止める計算へ、この式を無条件に当てはめないようにします。[3]

    終了した理由を、要求した精度と照合する

    固定版のmcsolveでは、ntrajは軌道数の上限です。timeoutによる時間制限やtarget_tolによる誤差目標も指定すると、いずれかに先に達したところで止まります。したがって、ntraj=1000と書いたことだけでは、1,000本が計算されたとも、誤差目標を満たしたとも言えません。結果のnum_trajectoriesとstats["end_condition"]を読み、実際の本数と終了理由を確かめます。[2][3]

    target_tolは、指定した観測量e_opsと出力時刻に対する平均の統計的誤差を見ます。確認した版ではジャックナイフ法に基づく推定を使い、絶対誤差、または絶対・相対誤差の組を指定できます。これは数値積分の誤差許容値atol・rtolとは別です。観測していない量、出力点の間の挙動、モデルの近似、状態空間の打ち切りまで保証するものではありません。[2][3]

    まれなジャンプが重要な場合には、同版のimproved_samplingも検討対象です。無ジャンプの経路を先に計算してその確率を保持し、残りはジャンプを含む条件付きの経路を生成して、対応する重みで平均します。ジャンプを多く見せるために物理的な発生率を増やす設定ではありません。本稿の表は、この重み付き方式を使った性能比較ではありません。[2]

    版による制約もあります。5.1.1は混合初期状態を受け取れますが、その場合はtarget_tolをサポートせず、APIの注意書きは軌道数以外の理由で終了した結果を無効と扱うよう求めています。純粋な初期状態で確認した設定を、そのまま混合状態へ広げる前に、採用版の制約を読み直します。[2]

    残すべきなのは、平均曲線だけではない

    比較のためには、ハミルトニアン、環境の作用、初期状態、観測量、出力時刻、採用版を揃え、乱数シード、実際の軌道数、終了理由も残します。ジャンプ時刻や各軌道を保存すれば、平均がどのような経路からできたかを追えます。ただし、全経路を保存する量は本数とともに増えるので、必要な観測結果に合わせて保存範囲を選びます。

    量子軌道の本数は、状態を計算し終えてから最終測定を何回行うかというショット数や、計算空間に何状態を残すかというFock打ち切りとは異なります。まず同じ物理モデルの経路を十分に標本化できているかを点検し、そのうえで数値計算や物理的な仮定を確かめる。これらを分けると、曲線のばらつきに対して何を増やし、何を見直すべきかが判断しやすくなります。

    参考資料

    QuTiPは5.1.1の固定コミット7accc77a70a08f965a29fdd13515f79cdcab9703と5.1系の公式文書を参照。資料は2026年10月14日に確認しました。表、待ち時間の生成、まれな事象の確率はQuantum Seaによる独立検算であり、実機測定やQuTiP実行時間の比較ではありません。

    1. QuTiP 5.1 Documentation, Monte Carlo Solver。量子ジャンプの生成、個別経路と平均、結果の保存を参照。
    2. QuTiP 5.1.1, mcsolve.py。入力、停止条件、混合初期状態の制約、improved samplingの固定実装。対応API解説。
    3. QuTiP 5.1.1, multitrajresult.py。平均・軌道間標準偏差、目標誤差と終了理由の記録を参照。コードの利用条件はBSD 3-Clause。