投稿者: SB-admin

  • PDMSナノ膜のCO₂分離、膜の透過性能だけでは回収率が決まらない

    PDMSナノ膜のCO₂分離、膜の透過性能だけでは回収率が決まらない

    CO₂を分ける膜を薄くすると、気体が通り抜ける距離を短くできます。ただし、膜がどれだけ通しやすいかという数字と、流れてくるCO₂を装置がどれだけ取り除けるかという数字は、同じではありません。

    その違いが見えるのが、藤川茂紀氏らが2019年に報告した、PDMS(ポリジメチルシロキサン)のナノ膜です。膜の薄さを変えた測定と、窒素に少量のCO₂を混ぜた分離実験を分けて読むと、材料を選ぶ際に何を比較すべきかが見えてきます。[1]

    簡単にまとめると?

    • 膜の透過量を面積・時間・対象気体の分圧差でそろえたpermeanceと、膜厚も考慮するpermeabilityは、比較する対象が異なります。
    • 約40,000 GPUという値は34 nm膜の測定であり、希薄なCO₂を分けた150 nm膜の実験とは条件を分ける必要があります。
    • 希薄気体の実験では、膜の厚さだけでなく、供給する気体や透過側の流し方も除去性能に関わります。

    「よく通す」と「よく選び分ける」は別の性質

    この研究で使うpermeanceは、膜を通る気体の量を、膜面積・時間・膜の両側での対象気体の分圧差で割って比べる量です。論文ではGPUという単位で示しています。温度や気体の種類などの条件をそろえれば、大きい値ほど、その膜が気体を通しやすいことを表します。

    一方、permeabilityは膜厚を織り込んだ透過係数で、論文ではbarrerという単位を使います。単に薄いから通しやすいのか、材料やその状態によって通り方が違うのかを考えるための量です。研究では、膜を薄くするとpermeanceは増える一方、薄い領域では膜厚を考慮したpermeabilityが低下しました。薄さを半分にすれば透過量が必ず2倍になる、という関係をどこまでも当てはめられるわけではありません。[1、Fig.3]

    著者らは、薄い膜では内部の拡散だけでなく、表面で気体が取り込まれる過程も関わると考察しています。ここは、この測定結果に対する機構の解釈です。

    CO₂と窒素をどれだけ選び分けるかも別に見ます。研究では両者を別々に通し、その透過性の比を評価しました。CO₂/N₂の選択性が約10だからといって、混合気体から得られる製品のCO₂純度が90%や99%になる、という意味ではありません。

    34 nmの膜も、測定時には支持体の上にある

    薄さを追求すると、膜が破れたり、小さな穴から気体が漏れたりする問題が出てきます。漏れる経路ができれば、材料が本来持つ選び分ける働きを生かせません。

    研究チームは、基板上の犠牲層の上にPDMS膜を作り、その犠牲層を溶かして膜を剥がしました。気体の透過を測る際は、エタノール中で多孔質のPAN(ポリアクリロニトリル)支持体へ移しています。「自立した膜を作れる」という製法の特徴と、測定中に支持体を使わないことを混同しないのが大切です。100 nm未満の膜は、空気中へ持ち上げる際の形状維持が難しかったとも記されています。[1、pp.1351–1352]

    単一の気体を使う測定は25±1℃で行われ、厚さ34 nmの膜でCO₂のpermeanceが約40,000 GPUに達しました。著者らは、選択性が保たれたことや電子顕微鏡の観察を、欠陥の少ない膜ができた根拠にしています。この値を、実際の空気からCO₂を回収した装置の性能として読むことはできません。

    permeanceが約13倍でも、CO₂濃度の減少割合は約3.6倍

    希薄なCO₂を分ける実験では、窒素中のCO₂濃度を約1000 ppmにし、常圧で供給しています。使った膜は150 nmと4.4 μmで、34 nmの膜とは別です。膜面積は0.785 cm²、CO₂の分圧差は約100 Pa。供給側とスイープ側の気体の流量は、それぞれ100 sccmとされています。スイープは、透過側に気体を流して、膜を通ってきたCO₂を運び去る方法です。[1、p.1353]

    同じ希薄気体の実験で使った2種類の膜。数値は原論文Table 1から項目を選んで整理。
    比較する量 4.4 μm膜 0.15 μm(150 nm)膜
    論文記載のpermeance 810 GPU 10,750 GPU
    供給気体のCO₂濃度 996 ppm 996 ppm
    膜を通らず残った側のCO₂濃度 950 ppm 832 ppm
    供給濃度からの減少割合 約4.6% 約16.5%

    最後の行は、供給濃度から残った側の濃度を引き、供給濃度で割った値です。たとえば薄い膜では、(996−832)÷996×100で約16.5%となります。原表にも同じ正の値が載っていますが、脚注の式は引き算の順序が逆で、表の値と符号が一致していません。ここでは濃度の減少割合として示しています。

    この2つを比べると、permeanceは約13倍、濃度から計算した減少割合は約3.6倍です。薄い膜による改善は確認できますが、膜の指標と実験装置での除去性能は、同じ倍率では増えていません。また、この濃度差からの評価を、流量条件の異なる装置の物質収支に基づく回収率へ、そのまま置き換えることもできません。

    論文は、スイープ流量を大きくすると透過が改善することも述べています。透過側の膜表面近くからCO₂を運び去る働きがあるためです。したがって、膜だけを交換した場合の比較と、流量や装置構成まで変えた場合の比較は分けて考える必要があります。

    選ぶ前に、膜の数字と運転条件をそろえる

    材料候補を比較するなら、まず同じ気体、温度、圧力条件でのpermeanceと選択性を見ます。そのうえで、膜厚、支持体、気体組成、膜面積、供給側と透過側の流量を確認します。単一のCO₂を使った高い透過量と、窒素に薄く混ぜたCO₂の除去結果を一つの性能値にまとめないことが、比較の出発点になります。

    回収設備として選ぶ段階では、求めるCO₂純度や回収量に加え、スイープや圧力差を作るためのエネルギー、湿気・不純物を含む気体への対応、長く運転した場合の変化が判断材料になります。JSTの俯瞰報告も、分離材料の性能だけでなく、原料の組成や不純物、耐久性、費用などを含めてプロセス全体を考える必要性を整理しています。[2、N1.04]

    今回の原著が示したのは、膜の薄さと透過特性の関係、そして条件をそろえた希薄CO₂/N₂混合気体での分離結果です。実際の大気には湿気や他の成分もあります。ナノ膜の透過量を出発点にしながら、回収したい気体と運転条件に合わせて次の試験を選ぶ、という使い方ができます。

    参考資料

    1. Shigenori Fujikawa, Miho Ariyoshi, Roman Selyanchyn, Toyoki Kunitake. Ultra-fast, Selective CO₂ Permeation by Free-standing Siloxane Nanomembranes. Chemistry Letters 48(11), 1351–1354(2019)。九州大学I²CNER公開PDF。
    2. 科学技術振興機構 研究開発戦略センター(JST CRDS)。研究開発の俯瞰報告書 ナノテクノロジー・材料分野(2026年)、N1.04「分離技術」、印刷98–104頁。
  • OpenStack Ironicのディスク消去、速さと消える範囲をどう見分けるか

    OpenStack Ironicのディスク消去、速さと消える範囲をどう見分けるか

    物理サーバーを別の利用者へ渡すとき、前のOSが起動しなくなったことと、前の利用者のデータが消えたことは同じではありません。パーティションなどを識別する情報だけを消しても、データそのものが残る場合があります。

    ベアメタルの配備を管理するOpenStack Ironicには、次の利用に備えてノードを整える「クリーニング」があります。ディスク消去もその一部ですが、選ぶ処理によって消す範囲、使う装置機能、失敗したときの進み方が変わります。ここでは2025.1系列の公式文書とIronic Python Agentの実装をもとに、その違いを見ていきます。実際の導入版や独自ドライバーで、同じ動作になるとは限りません。[1][3]

    簡単にまとめると?

    • メタデータ消去は再配備の準備を短時間で進められますが、ユーザーデータ全体の消去とは区別が必要です。
    • erase_devicesは装置の消去機能や上書きを使います。erase_devices_expressでは、同じサーバー内でもドライブによって消去方法が異なり得ます。
    • 再利用前には、終了状態に加えて対象ドライブ、実行された処理、失敗後の代替処理を確認します。手動クリーニングの完了だけでは、配備可能な状態へ進みません。

    クリーニングは、次のOSを書き込む前の準備

    Ironicの自動クリーニングは、有効にしている場合、初めてノードを配備可能にするときや、使い終わったハードウェアを次のワークロードへ回すときに行われます。ディスク消去だけでなく、ハードウェアやドライバーに応じた複数のステップを順に実行する仕組みです。OSイメージを書き込む配備処理そのものとは分かれています。[1][2]

    この違いは、標準の消去順序を見ると分かりやすくなります。文書では、クリーニングの早い段階でerase_devices_metadataを実行し、以前のワークロードへ戻って起動しないようにします。その後にerase_devicesでデータを消去する構成が説明されています。先に起動の手掛かりを取り除く処理と、残るデータを消す処理には、それぞれ役割があります。erase_devices_expressは既定では無効です。[1]

    三つの処理は、消す範囲と代替方法が違う

    2025.1資料に基づく標準的なストレージクリーニングの比較。装置への実行結果や処理時間を保証する表ではありません。
    処理 主な動作 再利用時に見落とせない点
    erase_devices_metadata ストレージのメタデータを消去する。 データの全ビットを消す処理ではなく、復元できる可能性が残る。
    erase_devices 対応するハードウェア消去を優先し、条件に応じてshredによる上書きを行う。 機能の非対応と実行エラーを区別する。エラー後の上書き継続には設定条件がある。
    erase_devices_express 対応するNVMeではハードウェア消去を試み、それ以外ではメタデータ消去へ進む。 終了が速くても、全ドライブが同じ消去水準になったとは限らない。

    メタデータ消去が短く済みやすいのは、全データ領域を書き直す処理ではないためです。Ironicの文書は、その目安を秒から分、erase_devicesは装置の高速な消去機能を使えなければ時間から日単位になり得る、と説明しています。これは文書上の幅であり、特定のドライブで計測した結果ではありません。容量だけでなく、実際に選ばれた消去方式が待ち時間を左右します。[1]

    たとえば、以前のOSを使わずに次のOSを配備する準備と、別の利用者が以前のデータへアクセスできないようにする要求では、確かめたいことが異なります。前者の準備が終わったことを、後者の要求を満たした証拠に読み替えないことが、方式を選ぶ出発点になります。

    暗号消去は、全領域への上書きと同じ動作ではない

    erase_devicesという名前から、必ず全領域を何度も上書きすると考えると、実際の処理を見誤ります。NVMeの例では、Agentが装置の機能情報を読み、Format NVMに対応しているか、暗号消去に対応しているかを確認します。2025.1の標準実装は、暗号消去に対応していればses=2、対応していなければユーザーデータ消去のses=1を選びます。[3][4]

    sesはSecure Erase Settings、つまり要求する消去の種類です。nvme-cliの公式説明では、暗号消去は暗号鍵を削除することでユーザーデータを暗号的に消去する方式です。ユーザーデータ消去は、消去後の値が必ずゼロになるという指定ではありません。また、すべてのユーザーデータが暗号化されていれば、装置はユーザーデータ消去の要求に対して暗号消去を行うこともできます。[5]

    そのため、「終了が速かったからメタデータだけを消した」「全体をゼロで埋めなければ消去ではない」と、時間や見た目だけで判断することもできません。一方、Ironicが対応機能を選択した事実だけで、あらゆる装置の実装や消去結果を実証したことにはなりません。必要なのは、対象の装置と機能、選ばれた処理、その成功・失敗を結びつけることです。

    「使えない」と「実行して失敗した」を分ける

    通常のerase_devicesでは、ハードウェア消去が失敗したあとに上書きへ切り替えるかを、deploy.continue_if_disk_secure_erase_failsで制御します。2025.1の設定文書では既定値はFalseで、NVMeまたはATAのsecure eraseが失敗すればクリーニングも失敗します。Trueならshredを呼び出して継続を試みます。これは、消去に失敗してもそのまま次へ進めてよい、という設定ではありません。[4]

    さらに、Agentの標準実装では、ATA消去機能が非対応として返る経路と、対応機能の実行中にエラーになる経路が分かれています。非対応で別の方式を試せる場合には上書きへ進みますが、実行エラーを捕捉した場合には上記の継続設定を確認します。上書き自体も成功しなければ失敗です。「ハードウェア消去をしなかった」という結果だけでは、どちらの経路だったかは分かりません。[3]

    erase_devices_expressの代替処理は、これとは異なります。この版の標準実装では、NVMeのハードウェア消去で特定の消去エラーが発生した場合も捕捉し、メタデータ消去を試みます。メタデータ消去にも失敗すれば、エラーを集めて処理を失敗させます。通常の消去が失敗後に上書きを試す条件と、expressがメタデータ消去へ切り替わる条件を、一つの設定として扱うことはできません。[3]

    NVMeとHDDが混在すると、同じ終了にも違いが残る

    例として、対応NVMeと一般的なHDDを搭載したサーバーで、express方式を使う場合を考えます。NVMeではハードウェア消去が成功し、HDDではメタデータだけを消去して、ステップ全体が成功する構成はあり得ます。公式文書もこの混在構成をexpressの用途として挙げています。ここで共通なのは短時間のクリーニングを目指す方針であり、全ドライブでユーザーデータを同じ方法で消したことではありません。[1]

    もし運用上の要求が「どのドライブも、前の利用者のデータを復元できない状態にして渡す」であれば、HDDに対するメタデータ消去だけでは、その要求を満たしたとは判断できません。逆に、必要な消去水準を別の工程で満たす環境などでは、再配備の準備を短くする価値を検討できます。ただし、それは要求と実施工程を対応させた判断であり、expressという名前だけで決まるものではありません。

    完了状態と実行内容を一緒に確かめる

    Ironicの状態にも区別があります。cleaningはステップの実行やその準備中です。clean waitでは、処理用のramdiskの起動や、ノード内で実行するステップの終了を待っています。どちらも、次の利用に配備できるavailableとは異なります。[2]

    自動クリーニングを経て配備可能にする場合は、正常完了後にavailableへ進みます。一方、運用者が指定した手動クリーニングは、manageableから開始し、終了後もmanageableへ戻ります。手動処理が完了しただけで、すぐに次のワークロードを配置できる状態になったわけではありません。[1][2]

    失敗してclean failedになった場合、clean stepの実行中の失敗ではmaintenance modeにも入り、Ironicによる操作を抑えます。文書は、保守モードを解除する前に、装置の損傷や動作中の処理がないことを確認するよう説明しています。ノードをmanageableへ戻して原因を調べ、修復後に再び配備可能にする流れでは、自動クリーニングを最初から実行して、正常完了後にavailableへ進みます。[1]

    実行中または失敗したステップは、ノードのdriver_internal_infoにあるclean_stepsと、conductorやAgentのログが手掛かりになります。運用で残す記録としては、ノードの最終状態だけでなく、対象ドライブ、選ばれた方式、代替処理の有無と結果を組にするのが有用です。これは消去方式を比較するための確認観点であり、特定機器の消去試験を行った結果ではありません。[1][3]

    クリーニングの待ち時間を短くする判断では、何を省いたのか、装置の機能で何を置き換えたのかを区別すると、速度とデータの扱いを同じ基準で比較できます。再利用の準備ができた状態と、必要な範囲のデータ消去ができた根拠を、両方そろえて次の利用へ渡すことが大切です。

    参考資料

    1. OpenStack Ironic — Node cleaning(2025.1系列)。Storage cleaning options、Manual cleaning、FAQ、Troubleshooting。
    2. OpenStack Ironic — Bare Metal State Machine(2025.1系列)。Enrollment and Preparation、Deploy and Undeploy。
    3. Ironic Python Agent — ironic_python_agent.hardware(2025.1系列の実装表示)。GenericHardwareManagerのerase_block_device、erase_devices_express、_ata_erase、_nvme_erase、_shred_block_device。
    4. OpenStack Ironic — Configuration Options(2025.1系列)。deployの消去設定。
    5. linux-nvme / nvme-cli — nvme-format(1)。Secure Erase Settingsの意味を補足。Ironicの動作条件は上記2025.1資料に限定。資料確認日:2026年10月12日。
  • DLSで測る粒子径、顕微鏡と値が違う理由

    DLSで測る粒子径、顕微鏡と値が違う理由

    同じナノ粒子について、電子顕微鏡では50 nm、DLSでは80 nmという結果が出たとします。これは説明のための仮の数値ですが、どちらかを誤差として片付ける前に、二つの方法が何を「大きさ」と呼んでいるかを確かめる必要があります。

    DLS(動的光散乱)は、液中で動く粒子が散らす光を調べ、その動きやすさから粒径を求める方法です。輪郭を撮影する電子顕微鏡とは、測る物理量も、平均への寄与の仕方も違います。NISTとNCLの2015年改訂プロトコルをもとに、希薄な水系分散液の結果を比較するときの読み方を整理します。[1、pp.1、7–9]

    簡単にまとめると?

    • DLSが求めるのは、液中で同じ速さで拡散する球に置き換えた「流体力学径」です。顕微鏡で見える輪郭の寸法とは区別します。
    • 散乱光には大きな粒子が強く寄与するため、少数の凝集体や異物でも結果が変わります。個数で平均した顕微鏡の値と、数字だけを比べることはできません。
    • 温度・粘度・分散媒の組成、試料濃度、解析方法をそろえて確認します。希釈やろ過が試料自体を変えていないかも、比較の条件に含まれます。

    光の揺らぎから、液中での動きやすさを求める

    液中の小さな粒子は、ブラウン運動によって不規則に動いています。DLSでは、粒子の動きに伴う散乱光の強度の揺らぎを記録し、ある時点の信号と、少し時間を置いた信号との似かより方を調べます。この時間的な相関の減り方から、粒子がどの程度広がっていくかを表す拡散係数を求めます。粒子を一つずつ撮影して、その移動距離を追う測定ではありません。[1、pp.12–13]

    次に、拡散係数をStokes–Einstein式へ入れます。流体力学径を dH、拡散係数を D とすると、関係は dH = kT / (3πηD) です。k はボルツマン定数、T は絶対温度、η は分散媒の粘度です。同じ温度と粘度なら、拡散が遅いほど大きな径として換算されます。[1、p.8]

    ここでいう流体力学径は、測定した粒子と同じ速さで拡散する、等価な硬い球の直径です。実際の粒子が球であることや、その最も長い部分を測っていることを意味しません。液中での動きやすさを、一つの長さで表した値です。

    電子顕微鏡の画像から求める寸法は、投影された形などに基づきます。したがって、冒頭の50 nmと80 nmの差だけでは、粒子が膨らんだとも、装置が30 nmずれたとも決められません。まず、顕微鏡側ではどの寸法を集計し、DLS側ではどの解析値を報告したかを確認します。[1、pp.1、7]

    少数の大きな粒子が、平均を動かす

    もう一つの違いは、平均を作るときの重みです。顕微鏡画像から粒子を数えて個数平均を求める場合、一つの粒子は一票として扱われます。一方、DLSでは散乱光の強さが効くため、大きな粒子の寄与が強くなります。NISTのプロトコルも、少数の大きな粒子や、小さな粒子が集まったクラスターにDLSが敏感であると説明しています。[1、pp.4、7]

    十分に小さな粒子について、材質や周囲の媒質などの条件が同じで、散乱強度が直径の6乗に比例する近似を使える場合を考えます。直径が2倍なら、一粒当たりの散乱強度は2の6乗、つまり64倍になります。これは重みの違いを示す計算例です。粒径や光学条件を問わず64倍になるわけでも、DLSの平均径を単純に64倍の重みで足し合わせればよいわけでもありません。[1、pp.4、8–9]

    このため、多くの小粒子に少数の凝集体が混ざっていると、DLSの値と、顕微鏡で多数見つかる小粒子の寸法が離れることがあります。顕微鏡にも、観察した視野や選んだ粒子が試料全体を代表しているかという問題があります。DLSで大きい値が出たから凝集と断定するのではなく、少数の大粒子を含むか、画像で十分な数と範囲を調べたかを対応させて読みます。[1、p.7]

    粒径を比べる前に分けたい情報。参考資料[1]の説明からQuantum Seaが整理。
    比べる項目 DLS 電子顕微鏡の画像からの計測
    大きさの出発点 液中での拡散から求めた等価な球の径 画像に投影された粒子の形や寸法
    平均の意味 散乱強度の寄与と解析方法に依存 個数平均など、粒子の選び方と集計方法に依存
    大きな粒子が少数ある場合 散乱光への寄与が強く、結果に影響しやすい 観察範囲や粒子数が不足すると捉えきれないことがある

    温度と粘度は、測定後の計算にも入っている

    粒子の動きやすさは、粒子だけで決まりません。周囲の液体の粘り気が強いか、どの温度で測ったかにも左右されます。拡散係数を径へ換算する式に粘度と温度が入るため、試料に合わない値を入力すれば、換算された粒径も変わります。

    プロトコルの物性表では、純水の粘度は20 ℃で1.002 mPa·s、25 ℃で0.890 mPa·sです。「水に分散させた」という情報だけでは、計算に使う粘度は決まりません。また、リン酸緩衝生理食塩水(PBS)に分散した試料へ純水の粘度を使うと、室温では粘度の入力に約2%の差が生じると説明されています。これは粒子が変わったこととは別の、換算条件の違いです。[1、pp.8–9]

    分散媒の組成は、入力値を通じてだけでなく、粒子の動きそのものにも影響します。帯電した粒子では、周囲の電気二重層が拡散に関わり、塩濃度によって見かけの流体力学径が変わる場合があります。逆に、塩を増やしすぎると分散が不安定になり、凝集を起こすこともあります。試料ごとに、分散媒の条件と安定性を確かめる必要があります。[1、pp.3–4]

    濃すぎる試料では、光が複数回散乱したり、粒子同士が相互作用したりします。しかし、薄めれば必ず本来の径が得られるわけではありません。純水を加えるだけの希釈では、粒子濃度と同時に塩濃度なども変わるためです。資料は、複数の濃度で結果を比べることに加え、組成を合わせた分散媒などで希釈する考え方を示しています。濃度の影響を調べたいなら、媒質まで変えてしまっていないかを分けて確認します。[1、pp.3–4]

    z-averageと分布のピークは、同じ値ではない

    DLSの結果にある「z-average」は、相関データをキュムラント法で解析して求める平均径です。光を強く散らす成分の寄与を含む値で、画像から数えた粒子径の単純な算術平均とは異なります。同時に得られる多分散指数(PI、PDI)は、広がりを表す量です。キュムラント法だけで、粒径分布の形や複数の山が直接得られるわけではありません。[1、pp.9、14]

    装置ソフトウェアが分布のグラフも表示している場合は、使った解析法と、強度・体積・個数のどれで重みを付けた分布かを見ます。強度分布から個数分布へ変換した結果は、顕微鏡で粒子を直接数えた結果そのものではありません。変換に用いた光学モデルや入力値が加わっています。

    ここでは、二種類の屈折率も区別が必要です。分散媒の屈折率は、拡散係数を求める計算に使います。一方、粒子の屈折率は、強度で重み付けした分布を体積・個数の分布へ変換するときに必要となります。入力する粒子の屈折率は、拡散係数やz-averageを求める計算自体には使いません。入力欄を一括して「屈折率」と見ると、どの結果に影響する値なのかが分かりにくくなります。[1、pp.8–9]

    値の違いを、材料の違いへ結び付けるには

    ロット間の粒径を比べるなら、まず同じ測定量を比べます。DLSのz-average同士なのか、同じ方法で数えた顕微鏡画像の粒子径同士なのか。次に、分散媒の組成、温度と粘度、試料濃度、解析法、測定の繰り返しとばらつきをそろえて読みます。これらを伴わない「平均80 nm」だけでは、材料の差と測定条件の差が重なったままです。[1、pp.9–10]

    大きな成分が現れたときには、異物の混入と、試料自身の凝集も区別します。ろ過で大きな成分を取り除けば結果は変わりますが、それが除きたかったほこりなのか、測定対象の一部なのかを確かめなければなりません。プロトコルは、フィルターが対象粒子を取り除いたり変えたりしないことを、試料ごとに検証するよう求めています。[1、pp.2、4–5]

    また、測定中に粒子が沈んでいく試料を、ブラウン運動で分散し続ける粒子と同じ前提で扱うことはできません。資料は、測定後に底へ沈殿が見える場合には結果を採用せず、対象に適した別の方法を検討するよう説明しています。[1、p.6]

    DLSと顕微鏡を組み合わせる意味は、同じ数値になるまで条件を調整することにはありません。液中での動きやすさと、画像から分かる形・寸法を対応させ、差を生む要因を絞ることにあります。測った量、平均の重み、媒質と試料の状態を分けて見れば、「値が違う」という結果から、次に確かめるべき条件が見えてきます。

    参考資料

    1. V. A. Hackley、J. D. Clogston『Measuring the Size of Nanoparticles in Aqueous Media Using Batch-Mode Dynamic Light Scattering』、NIST Special Publication 1200-6/NIST–NCL Joint Assay Protocol PCC-1、Version 1.2、2015年5月改訂。DOI: 10.6028/NIST.SP.1200-6。本文の頁表記を使用。定義はp.1、分散・濃度・清浄度はpp.3–6、他手法との比較はp.7、解析・入力値と報告条件はpp.8–10、用語はpp.12–14を参照。
  • etcdの復元、データを戻してもKubernetesの監視がずれる理由

    etcdの復元、データを戻してもKubernetesの監視がずれる理由

    バックアップから保存データを戻せても、そのデータを見て動く仕組みまで、同じ時点へ戻るとは限りません。Kubernetesの復旧では、etcdに残る状態と、変更通知を受けてきたコントローラーの見ている状態が食い違うことがあります。

    etcdは、キーと値の形で状態を保存する分散ストアです。変更の順序にはrevisionという番号を使います。ここではetcd v3.6の公式文書をもとに、スナップショットからの復元でこの番号が巻き戻る問題と、復元時に使う二つのオプションの役割を読み解きます。[1][2]

    簡単にまとめると?

    • 古いスナップショットへ復元すると、保存データだけでなくrevisionも以前の値へ戻り、変更を監視する側のキャッシュが正しく更新されない場合があります。
    • --bump-revisionは番号を先へ進め、--mark-compactedは古い履歴からの監視を続けさせないための処置です。番号を増やしても、失われたデータは戻りません。
    • 復元後は、etcdが起動したことに加えて、監視の張り直しと利用側の状態の取り直しまで確かめる必要があります。

    revisionは、時刻でも保存件数でもない

    etcdのrevisionは、ストア全体に一つある、変更の順序を表す番号です。キーの集合が変更されると増え、どの更新が先だったかを並べる論理的な時計として使われます。複数の操作をまとめるトランザクションでは、その中で複数のキーを変更しても、revisionが増えるのは一度です。保存されているキーの数や、時計の秒数を表すものではありません。[2]

    変更を受け取るwatchは、この番号を起点にできます。利用側が「ここまでは見た」と記憶しておけば、切断後にその続きの変更を受け取る仕組みを作れます。ただし、いつまでもすべての履歴が残るわけではありません。etcdは古いrevisionの履歴を保持しつつ、運用上の方針に従って整理するため、再開できる範囲には限りがあります。[2]

    保存側だけを過去へ戻すと、観測の順序が崩れる

    説明のため、revisionが1,000の時点でスナップショットを保存し、その後、利用側が1,400までの更新を観測したとします。障害後にそのスナップショットへ復元すると、etcd側の保存内容と番号は1,000の時点へ戻ります。一方、利用側には、1,400まで進んだという記憶や、その間に更新したキャッシュが残るかもしれません。これは仕組みを示す仮の数値です。

    Kubernetesのコントローラーやオペレーターは、informerと呼ばれる仕組みで状態を手元に保持し、watchによる変更通知を利用することがあります。etcdの復旧文書は、古いrevisionへの復元によって、こうしたキャッシュが正しく更新されず、コントローラーの動作に不整合が生じ得ると指摘しています。保存側が応答できるようになったことだけでは、この不整合が解消したとは言えません。[1]

    番号を進めることと、古い履歴を無効にすることを分ける

    この問題に対し、公式文書が示すのがrevision bumpです。--bump-revisionには、復元するスナップショットのrevisionへ加える増分を指定します。到達させたい番号をそのまま指定するものではありません。先ほどの例なら、1,000に増分1,000を加えると、復元後の番号は2,000になります。ここでも数値は説明用であり、実環境に勧める設定値ではありません。[1]

    ただし、番号が2,000になっても、保存内容が1,400の時点まで追いつくわけではありません。スナップショットに含まれない更新を作り直す処理ではなく、復元後の番号が利用側の観測済み番号より後になるようにする処置です。データの新しさと、通知の順序を示す番号を分けて見る必要があります。

    もう一つの--mark-compactedは、増分を含むrevisionまでを、履歴の整理が済んだ範囲として扱います。etcdのWatch APIでは、整理済みのrevisionを起点とするwatchはキャンセルされます。同じ開始revisionのまま作り直しても失敗します。古い履歴を連続して読めるという前提を利用側へ残さず、キャッシュの無効化につなげるための処置です。[1][2]

    二つの復元オプションの役割。etcd v3.6公式文書をもとにQuantum Seaが整理。
    処置 変えるもの それだけでは行わないこと
    --bump-revision スナップショットのrevisionに指定増分を加える。 スナップショット以後に失われた更新の復元。
    --mark-compacted 増分を含むrevisionまでを整理済みとし、その古い履歴に基づくwatchを続けさせない。 独自クライアントのキャッシュ処理が正しく実装されていることの保証。

    公式文書は、Kubernetesやwatchを利用するシステム、etcdデータのローカルコピーを持つシステムの復元では、revision bumpの利用を強く勧めています。Kubernetesのコントローラーについては、--mark-compactedも併用することが重要だと説明しています。番号を進めるだけの処置と、古い観測履歴を使えなくする処置は、同じ役割ではありません。[1]

    増分は、スナップショットの古さと更新量に依存する

    どれだけ番号を進めるかは、スナップショットの取得後に、どこまでrevisionが進んだ可能性があるかによります。公式文書には、毎秒1,500回未満の書き込みを仮定し、1週間前のスナップショットに10億を加える例があります。10億という値だけを抜き出すと、元の条件が抜けてしまいます。スナップショットがさらに古い環境や、更新量が多い環境でも十分だと保証する数字ではありません。[1]

    検討時には、使うスナップショットのrevisionと取得時点、障害までの経過時間、更新の進み方を対応させます。また、revisionはキーの総数ではないので、保存件数が少ないことだけを根拠に、小さな増分でよいとは判断できません。同じキーを繰り返し変更する環境でも、番号は進むからです。[2]

    戻すファイルの由来と、復元先の識別も別の確認点

    監視の整合を考える前提として、どの状態を保存したファイルなのかも確かめます。公式文書は、稼働中のetcdからスナップショットを取得する方法と、データディレクトリ内のmember/snap/dbをコピーする方法を区別しています。後者では、先行して記録するWAL(write-ahead log)に含まれていても、まだdbへ書き込まれていないデータを失う可能性があります。[1]

    整合性検査にも違いがあります。etcdctl snapshot saveで取得したスナップショットには、復元時に確認する整合性ハッシュが付きます。dbファイルを直接コピーした場合にはそのハッシュがなく、同じ検査はできません。検査を省けば同じ根拠が得られる、と読み替えないことが大切です。なお、ファイルの整合性が確認できても、必要な時点までの更新を含むことや、利用側のキャッシュまで一致することを一度に証明するものではありません。[1]

    スナップショットからの復元では、member IDとcluster IDなどの識別情報も書き換えられ、新しい論理クラスタを作ります。元のクラスタへ誤って参加しないための扱いであり、単に保存ファイルを置き換えて同じクラスタの続きを動かす、という捉え方では不十分です。複数メンバーを復元するときは、同じスナップショットを使うことも公式文書の条件です。[1]

    復旧確認を、保存側から利用側までつなぐ

    復旧の検証では、戻ったキーと値、復元後のrevision、監視が古い履歴をそのまま使っていないかを、順につなげて確かめます。Kubernetesのコントローラーなら、手元の状態を取り直したあと、期待する対象を見て制御が再開したかまでを見る、という評価になります。これは公式文書の不整合の指摘から導く確認の考え方であり、すべての独自コントローラーの動作を保証するものではありません。

    スナップショットは保存内容を以前の状態へ戻します。一方、その内容を見ていた利用側には、過去へ戻ったことを正しく受け止める経路が必要です。データを戻す処理、revisionを進める処理、古い監視履歴を無効にする処理を分けて理解すると、「etcdが起動した」から「制御が整合した状態で再開した」までの、確かめる範囲が見えてきます。

    参考資料

    2026年10月12日確認。etcd v3.6系列の公式文書に基づきます。

    1. etcd Authors — Disaster recovery。Revision Difference、Restoring with revision bump、Snapshotting the keyspace、Integrity Checks、Restoring from snapshot。
    2. etcd Authors — etcd API。Revisions、Transaction、Watch API/Watch streams。
  • Cephのイレイジャーコーディング、4+2で保存容量を減らす仕組みと復旧の負担

    Cephのイレイジャーコーディング、4+2で保存容量を減らす仕組みと復旧の負担

    同じデータを三つずつ保存する代わりに、細かく分けて復元用の情報を添えれば、必要な容量を減らせます。ただ、空き容量が増えることと、故障中も同じ速さで使い続けられることは別です。

    分散ストレージのCephには、イレイジャーコーディング(Erasure Coding、EC)という保存方式があります。ここではデータ4断片と復元用2断片を組み合わせる「4+2」を例に、三重複製との容量差、断片の置き場所、故障後に戻すまでの負担を、公式のTentacle系列の文書から読み解きます。4+2は本記事の比較例であり、すべてのCeph環境の初期設定ではありません。[1]

    簡単にまとめると?

    • 4+2のECは、符号化に必要な容量が理論上元データの1.5倍になり、三重複製の3倍より小さくなりますが、実際の必要容量には別の上乗せがあります。
    • 復元できる断片数と、読み書きを許す断片数は別で、ホストやラックの故障に耐えるには、断片の配置も対応させる必要があります。
    • 故障後は残った断片を読み、再構成して書き戻すため、平常時の容量だけでなく、更新の大きさや復旧中の負荷まで比べて選びます。

    4+2は、コピーを六つ作る方式ではない

    三重複製では、同じデータのコピーを三つ持ちます。ECでは、元のデータをK個のデータ断片に分け、そこからM個の復元用断片を計算します。復元用断片は、元データをもう一度丸ごと保存したコピーではありません。失った部分を、残った断片と組み合わせて求めるための情報です。[1] [2]

    4+2ならK=4、M=2です。符号化した断片の大きさをそろえると、保存する量は(4+2)÷4=1.5倍になります。たとえば論理データ1 TiBを保存する場合、符号化した断片の合計は理論上1.5 TiB、三重複製なら3 TiBです。これは圧縮や重複排除で中身を小さくした結果ではなく、故障に備える情報の持ち方による違いです。[1]

    論理データ1 TiBに対する容量の計算例。Ceph公式文書の式を用いてQuantum Seaが整理。実機で測定した使用量ではありません。
    保存方式 持つ情報 理論上の保存量
    三重複製 同じデータを3組 1 TiB × 3=3 TiB
    4+2のEC データ4断片+復元用2断片 1 TiB × 6÷4=1.5 TiB

    この1.5 TiBを、そのまま購入すべきディスク容量にはできません。メタデータ、データ配置や復旧に残す空き容量、小さなオブジェクトの格納効率などは、別に見積もる必要があります。公式文書も、小さなファイルやオブジェクトが多い用途では、ECの実際の容量増加が大きくなり得ると注意しています。「利用できる容量が必ず2倍になる」と約束する数字ではありません。[1]

    二つ失っても戻せる、の「二つ」は何か

    Cephでは、ディスク上のデータを扱うOSDという保存サービスへ断片を配置します。4+2の構成で二つの断片を失っても復元できることと、どの二台のサーバーが止まってもよいことは、同じではありません。何台分が一緒に失われるかは、置き方で変わるからです。[1]

    たとえば六つの断片を六つのOSDへ置いていても、そのうち三つのOSDが同じホスト上にあれば、ホスト一台の故障で三断片を同時に失います。ディスクの本数だけを数えても、ホスト故障への備えは分かりません。これは配置条件を説明する仮の例です。

    そこで使うのが、Cephの配置規則であるCRUSHの「障害ドメイン」です。障害ドメインをホストにすれば、同じデータを構成する断片を別々のホストへ分ける規則を作れます。ラック全体の停止を考えるなら、ラック単位に分ける規則と、それを満たす台数・構成が必要です。公式文書のラック配置例も、同じラックに二つの断片を置かない規則を示しています。[1]

    通常の4+2配置では、少なくとも六つの障害ドメインが必要になります。公式文書は、K+M個ちょうどより、さらに一つ多い障害ドメインを用意する運用上の利点にも触れています。容量表を作る段階で、復旧先となる場所と空き容量を合わせて考える理由です。ホスト間に分けた配置を、ラック間にも分かれていると読み替えてはいけません。[1]

    復元できても、読み書きを進めるとは限らない

    ここで二つの条件を分けます。一つは、元のデータを再構成するために必要な断片数。もう一つは、利用者の読み書きを進めるために、Cephが最低限そろえる断片数です。

    公式文書では、Octopus以降のECプールは、少なくともK個の断片が利用できれば復旧を進められると説明しています。一方、min_sizeは、データ配置の管理単位であるPGが動作し、I/Oを進めるために必要な最小の稼働断片数です。CephはECでKより大きい値を勧めています。K個しか残っていない状態でさらに断片を永久に失うと、復元に必要な情報が足りなくなるためです。[1] [3]

    4+2でmin_size=5と設定した例なら、断片が四つ残っていても、読み書きを進めるための本数には届きません。再構成が可能なことだけを理由に、通常どおりサービスが続くとは言えないのです。

    4+2、min_size=5の仮の構成。通常のReed–Solomon方式を前提にした条件の整理であり、実環境の可用性を保証する表ではありません。
    利用できる断片 データの再構成 min_sizeの本数条件
    6個 必要数を満たす 満たす
    5個 必要数を満たす 満たす。ただしI/O継続には他の稼働条件も必要
    4個 必要数を満たし、復旧は可能 満たさず、この状態のままI/Oは進められない
    3個以下 その断片だけでは不足。残りを永久に失ったならデータ喪失 満たさない

    この区別は、保守時の判断にも関わります。「あと二つ失ってもデータは戻せる」という説明だけで、二つの障害ドメインを同時に止めてよいとは判断できません。現在の断片の状態とmin_sizeを確かめ、データを守れる範囲とサービスを続けられる範囲を別々に見ます。

    節約した容量の代わりに、復旧では何をするのか

    三重複製でコピーを失った場合は、残ったコピーから不足分を作れます。ECで断片を失った場合は、残った断片を読み、計算で再構成し、新しい断片を書き込みます。公式文書は、この読み取り・再構成・書き込みを復旧の処理として説明し、とくにHDDを使う場合や復旧・再配置の最中に性能との引き換えがあるとしています。[1]

    たとえば、長く保管する大きなデータが中心なら、平常時の容量差は魅力になります。それでもホスト一台を失った後には、残る機器が通常の要求に加えて復旧の読み取りや通信を受け持ちます。ここで確かめたいのは、空き容量が足りるかだけでなく、復旧中のアプリケーションの待ち時間と、冗長性が戻るまでの時間です。この評価の進め方は処理の仕組みから導くもので、本記事で測った結果ではありません。

    Kを増やすと、同じMに対する容量の割合は小さくなります。しかし、配置に必要な障害ドメインも増え、性能への影響も変わります。容量効率の数字だけを最小にするのではなく、実際の読み書きと故障復旧を同じ条件で比べる必要があります。[1]

    小さな更新とメタデータには、別の条件がある

    Cephの保存領域はプールという単位で方式を選びます。ECプールは、初期状態ではオブジェクト全体の書き込みや追記を扱います。一部だけを書き換えるには、BlueStoreという保存方式のOSDを使い、allow_ec_overwritesを有効にする条件があります。これによって、仮想ディスクを扱うRBDや、ファイルを扱うCephFSのデータにもECを使えるようになります。[1]

    ただし、ECプールはキーと値の情報を持つomapに対応していません。RBDやCephFSでは、データをECプールに置いても、メタデータは複製プールに残します。「保存領域を全部4+2へ変える」という一括の計算では、この役割分担を見落とします。[1]

    Tentacle系列には、これとは別にallow_ec_optimizationsがあります。小さなI/Oの性能を改善し、容量を埋め合わせるパディングをなくす最適化ですが、一部上書きの許可と同じ設定ではありません。すべてのMON(クラスタ状態を管理するサービス)とOSDがTentacle以降であることに加え、対象のプラグインと符号化方式にも条件があり、有効にした後は無効へ戻せません。公式文書が挙げる対象はJerasure/ISA-Lのreed_sol_van方式です。[1]

    1ストライプあたり各データ断片へ割り当てる量を決めるstripe_unitも、読み書きの性質に関わります。最適化を使う場合、値を大きくすると小さな読み取りに利点がある一方、小さな連続書き込みには不利になると説明されています。この値はプール作成後には変更できません。既存プールへ最適化を有効にすれば、どの仕事も同じように速くなる、とは読まないようにします。[1] [2]

    容量、故障の範囲、戻るまでの負荷を一組で比べる

    方式を選ぶなら、まず保存するデータの大きさと、一回の読み書きの大きさを分けて捉えます。大きなファイルでも、その一部を細かく更新する仕事はあります。次に、守りたい故障の単位に合わせて断片の配置を考え、min_sizeを含む停止条件を確認します。最後に、代表的な負荷をかけた平常時と復旧中で、必要容量・応答時間・復旧時間を比べます。

    4+2の1.5倍という計算は、この比較の出発点です。容量の利点を生かせるのは、減らした複製の代わりに必要になる配置と再構成の仕事まで、運用の中へ織り込めたときです。

    参考資料

    2026年10月12日確認。Ceph公式のTentacle系列の文書に基づく方式の解説です。容量と断片数の表は条件を示す計算例で、実機の性能試験ではありません。

    1. Ceph authors and contributors, Erasure code。Erasure-code profiles、Erasure Coding with Overwrites、Erasure Coding Optimizations、Erasure-coded pool overhead、Erasure-coded pool recovery。
    2. Ceph authors and contributors, Erasure code profiles。K・Mの定義とstripe_unit。
    3. Ceph authors and contributors, Pools。Setting Pool Valuesのmin_size、allow_ec_overwrites、allow_ec_optimizations。
  • 二周波TDTR、薄膜の熱伝導率と測定用Al膜の影響を分ける

    二周波TDTR、薄膜の熱伝導率と測定用Al膜の影響を分ける

    熱をよく通す薄膜を作ったら、その熱伝導率を確かめたいところです。しかし、測定のために表面へ載せた金属膜の厚さが少し違うだけで、求めたい薄膜の値まで変わってしまうことがあります。薄膜そのものの性質と、測定を助ける層の影響を、どう分ければよいのでしょうか。

    その問題に取り組んだのが、シンガポール国立大学のPuqing Jiang、Bin Huang、Yee Kan Kohによる二周波TDTRの研究です。時間領域サーモリフレクタンス(TDTR)という光を使う測定を、二つの加熱周波数で行います。ここでは2016年の論文をもとに、高熱伝導の薄膜を低熱伝導の基板上で測るとき、なぜ二つの信号を組み合わせると役立つのかを見ていきます。[1]

    簡単にまとめると?

    • TDTRは表面の温度応答を熱拡散モデルと照合するため、測定用Al膜の厚さの不確かさが、試料の熱伝導率へ入り込みます。
    • 二周波TDTRは、Al膜厚への感度が似て、目的の薄膜への感度が異なる二つの信号の比を使い、Al膜厚の影響を減らします。
    • 周波数は試料に合わせて選びます。薄膜への感度が足りない場合や、界面で熱が強く妨げられる場合まで解決する方法ではありません。

    表面の温度応答には、複数の層の性質が重なる

    論文の測定では、試料の上に厚さ約100 nmのアルミニウム(Al)膜を載せます。加熱用の光でこの膜を温め、少し遅れて届く観測用の光で、温度に伴う反射率の変化を調べます。Al膜は、光を熱へ変え、温度の変化を光で読み取るための層です。[1、pp.5–6]

    観測するのは、薄膜の熱伝導率そのものではありません。熱がAl膜から試料へ、さらに基板へ移る間の表面の応答です。この応答を、各層の厚さ、熱容量、熱伝導率、層どうしの界面の熱の通しやすさを含むモデルに合わせ、目的の値を求めます。

    ここでAl膜の厚さを変えると、その層に蓄えられる熱の量も変わり、モデルが予測する応答が動きます。厚さの入力に誤差があれば、計算上は薄膜の熱伝導率を変えることでも、観測結果へ近づいてしまうことがあります。論文が対象にした高熱伝導の薄膜では、信号が目的の熱伝導率よりもAl膜厚へ強く反応することが、測定の不確かさを大きくしていました。[1、pp.6–8]

    二つの信号を平均せず、影響の差を利用する

    二周波TDTRで変えるのは、加熱用の光の強さを周期的に変化させる変調周波数です。レーザーの光パルス自体の繰り返し周波数とは区別します。論文の装置では後者は80 MHzですが、二周波測定に使う加熱の変調周波数は、それとは別に設定しています。[1、pp.5–6]

    同じ材料なら、変調周波数を上げると、周期的な温度変化が届く深さは浅くなります。低くすると、より深くまで熱が伝わり、下の基板の影響が強くなります。この深さの目安が、熱浸透深さです。薄膜を詳しく見たい高周波側と、薄膜の熱伝導率への反応が弱くなる低周波側を組み合わせる、というのが出発点です。[1、pp.2–4、7–9]

    ただし、低い周波数を一つ足せばよいわけではありません。二つの周波数で、Al膜厚を少し変えたときの信号の変化は似ている一方、目的の薄膜の熱伝導率を変えたときの変化は異なる。その組み合わせを、あらかじめモデルで探します。

    各周波数のTDTR信号を R とすると、解析に使うのは R高周波 ÷ R低周波です。ここでの R は、検出した信号の同相成分と直交成分から作る比で、温度そのものではありません。さらに二周波数の比を取ることで、両方に似た割合で現れるAl膜厚の影響を弱め、異なって現れる薄膜の熱伝導率の手掛かりを残します。[1、pp.5–9]

    原図で見る、残す感度と減らす感度

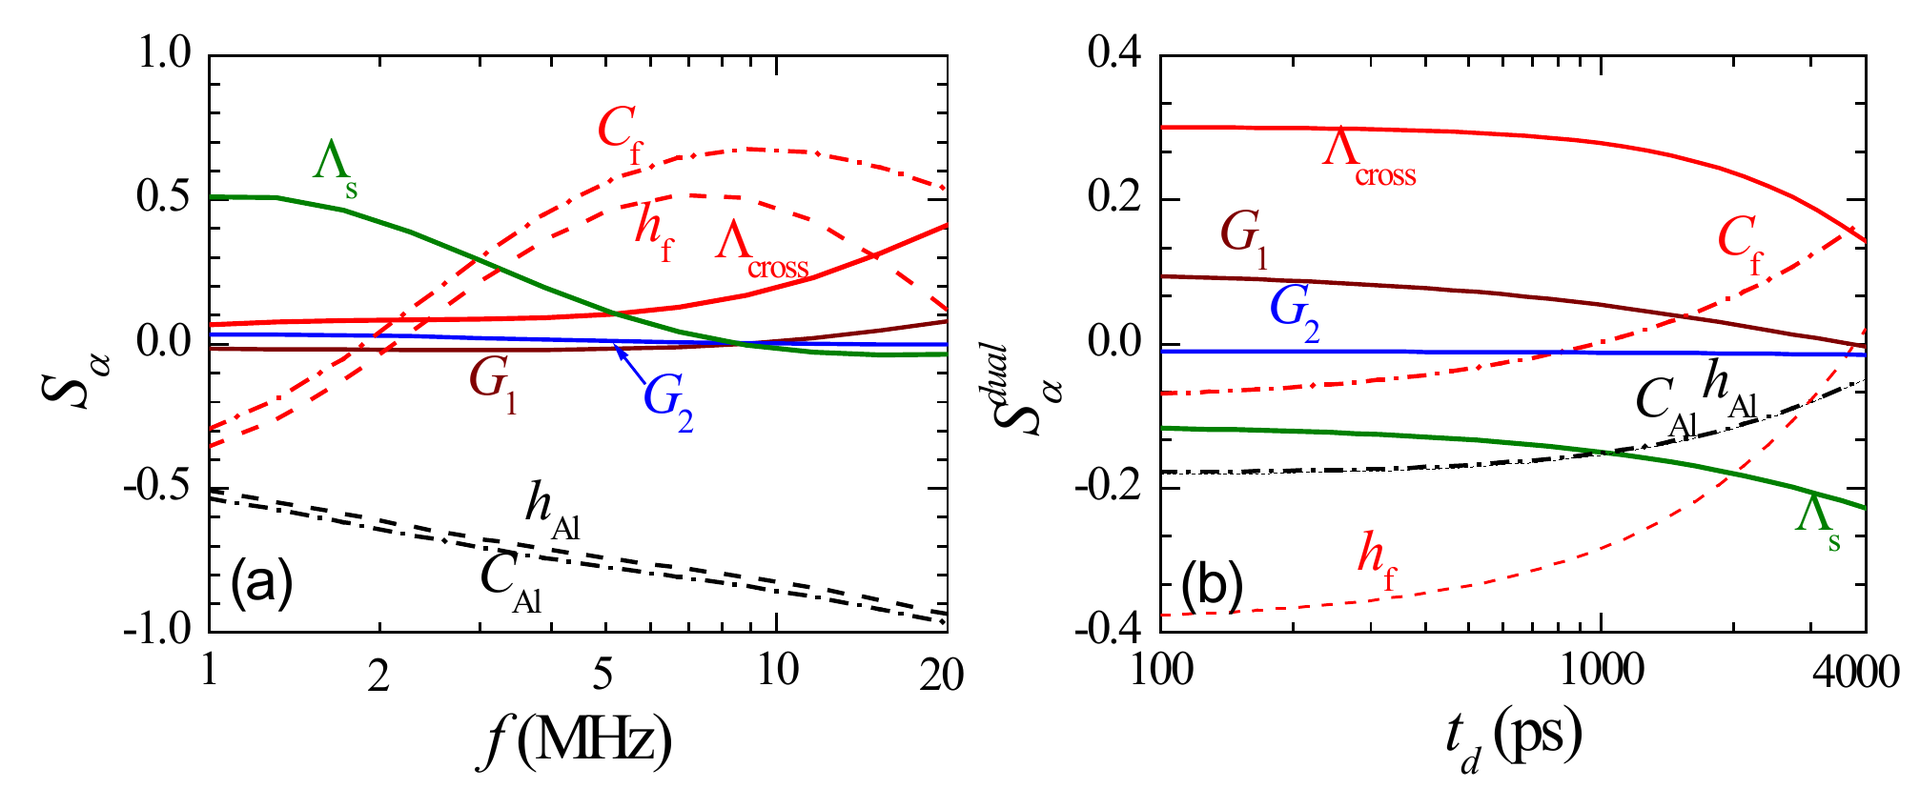
    下図は、論文が仮想的な多層試料について計算した感度です。感度は、ある材料の値や厚さを少し変えたときに、信号がどれだけ変わるかを表します。絶対値が小さいほど、その入力の変化が信号に表れにくくなります。

    二周波TDTRの感度計算。左は変調周波数ごとの感度、右は20 MHzと6 MHzの信号比の感度を遅延時間に対して示す。Al膜厚の感度は比で小さくなるがゼロではなく、薄膜の熱伝導率への感度は残る。
    図1 Jiang・Huang・KohのFig.2(a,b)から、グラフのパネルを抜粋。左(a)の横軸は変調周波数、右(b)は20 MHzと6 MHzの信号比を調べる際の遅延時間です。赤実線のΛcrossが薄膜の厚さ方向の熱伝導率、黒破線のhAlがAl膜厚に対応します。仮想試料はAl 100 nm/薄膜500 nm/SiO2 100 nm/Si。薄膜の熱拡散率10−5 m2/s、体積熱容量2 J/(cm3·K)、上下の界面熱コンダクタンス各200 MW/(m2·K)、レーザーの1/e2半径28 μmという計算条件です。左図の遅延時間は100 ps。出典:参考資料[1]、PDF p.18。図中の軸・曲線・記号は変更していません。小さい画面では横にスクロールできます。図を拡大する。

    左図の6〜20 MHz付近では、薄膜の熱伝導率を表す赤実線が周波数によって大きく変わります。一方、Al膜厚を表す黒破線の変化は比較的緩やかです。右図では、二つの信号の比にも赤実線の感度が残り、Al膜厚への感度の絶対値は左図より小さくなっています。[1、pp.7–9、Fig.2]

    Al膜厚の影響が完全に消えているわけではありません。また、右図には試料の膜厚hfや体積熱容量Cfへの感度も残っています。二周波数にすれば他の入力を調べなくてよい、という読み方はできません。なお、左右は横軸が異なるので、同じ横位置の点どうしを比較する図でもありません。

    NiFe薄膜では、どこまで確かめられたか

    研究チームは、厚さ403 ± 20 nmのNi80Fe20合金膜で方法を検証しました。この試料で使った周波数は17.4 MHzと4 MHzです。原図の仮想試料で使った20 MHzと6 MHzとは異なり、試料の条件と装置の信号対雑音比を踏まえて選ばれています。[1、pp.12–13]

    同じNiFe薄膜について論文が報告した熱伝導率
    求め方 熱伝導率 W/(m·K)
    従来のTDTR、17.4 MHz 28 ± 6
    二周波TDTR、17.4 MHzと4 MHz 22 ± 2
    四端子法による電気抵抗からの推定 21.7 ± 3.6

    出典:参考資料[1]、pp.12–14、Table 1。±は論文が見積もった不確かさです。表はNiFeの報告値だけを整理しています。

    二周波法では、報告された不確かさが小さくなり、電気抵抗を使った別の推定値とも近づきました。ただし、三つ目は熱伝導率を直接測った「正解の値」ではありません。電気の流れやすさと熱の運ばれ方を結ぶWiedemann–Franz則と、NiFe合金に対して見積もった係数を使う推定です。著者は、金属膜の熱伝導の等方性や、熱を運ぶ電子の短い平均自由行程を根拠として、この比較を行っています。[1、pp.11、13–14]

    界面の値もすべて正確に分かったわけではありません。解析ではAlとNiFeの界面の熱コンダクタンスも調整していますが、著者は、その推定値の不確かさが大きいと明記しています。薄膜の熱伝導率が安定して求まることと、界面の性質まで同じ精度で決まることは、分けて評価する必要があります。[1、p.13]

    採用を判断するには、膜厚と界面から考える

    たとえば、基板上の金属膜で熱伝導率の推定値がばらつき、Al膜厚の入力を少し変えるだけでも結果が大きく動くとします。このような場合は、二周波法を検討する理由があります。まず試料と装置のモデルで感度を調べ、目的の薄膜の感度を残したまま、Al膜厚への感度差を小さくできる周波数の組があるかを確かめます。これは論文の手法から導ける検討順序であり、あらゆる試料に通用する設定値ではありません。

    薄すぎる試料では、比を取っても十分な感度を得られません。論文のモデル計算では、高周波側の熱浸透深さに対して膜厚が約0.85倍より小さいと、目的の熱伝導率への感度が足りず、二周波法でも正確な測定が難しくなりました。大きな改善が得られたのは、おおむね0.85〜1.5倍の範囲です。これは、その研究のモデル条件から得た目安で、材料を問わない固定の膜厚基準ではありません。[1、pp.9–10、Fig.3]

    Al膜から試料へ熱が渡りにくい場合も、別の問題になります。界面の熱抵抗が薄膜内部の熱抵抗より大きいと、表面の応答は主に界面で制限され、薄膜の熱伝導率を変えても信号が変わりにくくなります。論文の検討では、Alと試料の界面熱コンダクタンスが「薄膜の熱伝導率÷膜厚」より大きいことが、改善の条件でした。[1、pp.10–11、Fig.4]

    さらに、この研究は低熱伝導の基板上にある高熱伝導の薄膜を狙ったものです。検討した多層モデルでは、薄膜と下層のSiO2の熱伝導率の比が10を超える範囲で有用性が示されています。低周波側を下げすぎると、今度は基板の値への感度が大きくなり、その不確かさが入り込みます。周波数を下げるほど測りやすくなるわけでもありません。[1、pp.9–11]

    測定を依頼したり結果を比較したりする際には、二つの周波数の数値だけでなく、膜厚や熱容量をどう決めたか、どの入力が結果を大きく動かすか、界面を含むモデルで感度が確保されているかを見ます。二周波TDTRの価値は、測定回数を増やすことよりも、求めたい性質と測定用の層の影響が違って表れる条件を、実験の前に選べることにあります。

    参考資料

    1. Puqing Jiang, Bin Huang, Yee Kan Koh, Accurate Measurements of Cross-plane Thermal Conductivity of Thin Films by Dual-Frequency Time-Domain Thermoreflectance (TDTR)。arXiv:1511.04852v2、2016年5月27日版、公開PDF(全23ページ)。測定系と解析はpp.5–6、二周波法と適用条件はpp.7–11、試料と検証はpp.11–14、原図はp.18のFig.2を参照。掲載誌:Review of Scientific Instruments 87, 075101 (2016)、DOI: 10.1063/1.4954969。本稿はこの研究手法と検証条件を解説したもので、現在の装置の性能比較や、あらゆる薄膜に対する精度保証を示すものではありません。
  • AFMのナノ粒子計測、横幅と高さをどう読み分けるか

    AFMのナノ粒子計測、横幅と高さをどう読み分けるか

    同じナノ粒子をAFMで測ったのに、画像の横幅と断面の高さが一致しない。そんな結果を見たとき、すぐに装置の誤差や粒子の変形と決めてよいのでしょうか。まず分けたいのは、横方向の輪郭を測った値と、基板からの高さを測った値です。

    原子間力顕微鏡(AFM)は、細い探針で表面をたどり、その凹凸を調べる装置です。ただし、探針にも大きさと形があります。NISTとNCLの金ナノ粒子測定プロトコルを読むと、横幅に探針の形が入り込むことと、高さを粒径として扱える条件が、別の問題だと分かります。[1]

    簡単にまとめると?

    • AFMの横方向の輪郭には探針の形が影響します。画像で広く見えることだけでは、粒子そのものが大きいとは判断できません。
    • 粒子の高さは頂点と周囲の基板の差から求めます。高さを直径と読むには、球形や変形の有無も確かめる必要があります。
    • 測定を比べるときは、探針、走査条件、基板、画像処理、校正をそろえて読みます。柔らかい粒子では、測る力自体が形を変える場合があります。

    横幅には、粒子だけでなく探針の形も入る

    AFMの探針は、小さな片持ちばりであるカンチレバーの先に付いています。探針と試料の間に働く力でカンチレバーの状態が変わり、その変化を検出します。間欠接触モードでは、カンチレバーを振動させ、設定した振幅を保つように上下位置を調整しながら表面を走査します。その位置の変化を並べることで、表面の高さの分布が得られます。[1]

    ここで、探針の先が無限に細い点なら、粒子の輪郭に沿ってどこまでも近づけるはずです。実際の探針は丸みや斜面を持つため、粒子の側面では、先端の中心が側面の真上へ来る前に探針の一部が触れます。記録される横方向の輪郭には、粒子と探針の両方の形が含まれるのです。横に広がった像を、そのまま粒子の直径と読むことはできません。これはプロトコルが述べる、探針と試料の形状による像の広がりを、接触の位置から説明したものです。[1]

    一方、孤立した粒子の頂点と十分に平らな基板へ探針が届き、測定で粒子の形を変えない場合、高さはこの横方向の広がりとは分けて測れます。「横幅と高さが違う」という結果だけでは、どちらか一方が間違っているとは限りません。

    高さを「粒径」と呼べるのは、どんなときか

    プロトコルの高さ測定は、粒子の頂点の値から、粒子の両側にある基板の平均高さを引く方法です。基板の段差に乗った粒子や、隣の粒子と重なった部分まで同じ方法で読めるわけではありません。断面を複数の位置で確認し、孤立した粒子が平らな場所にあるかを確かめます。[1]

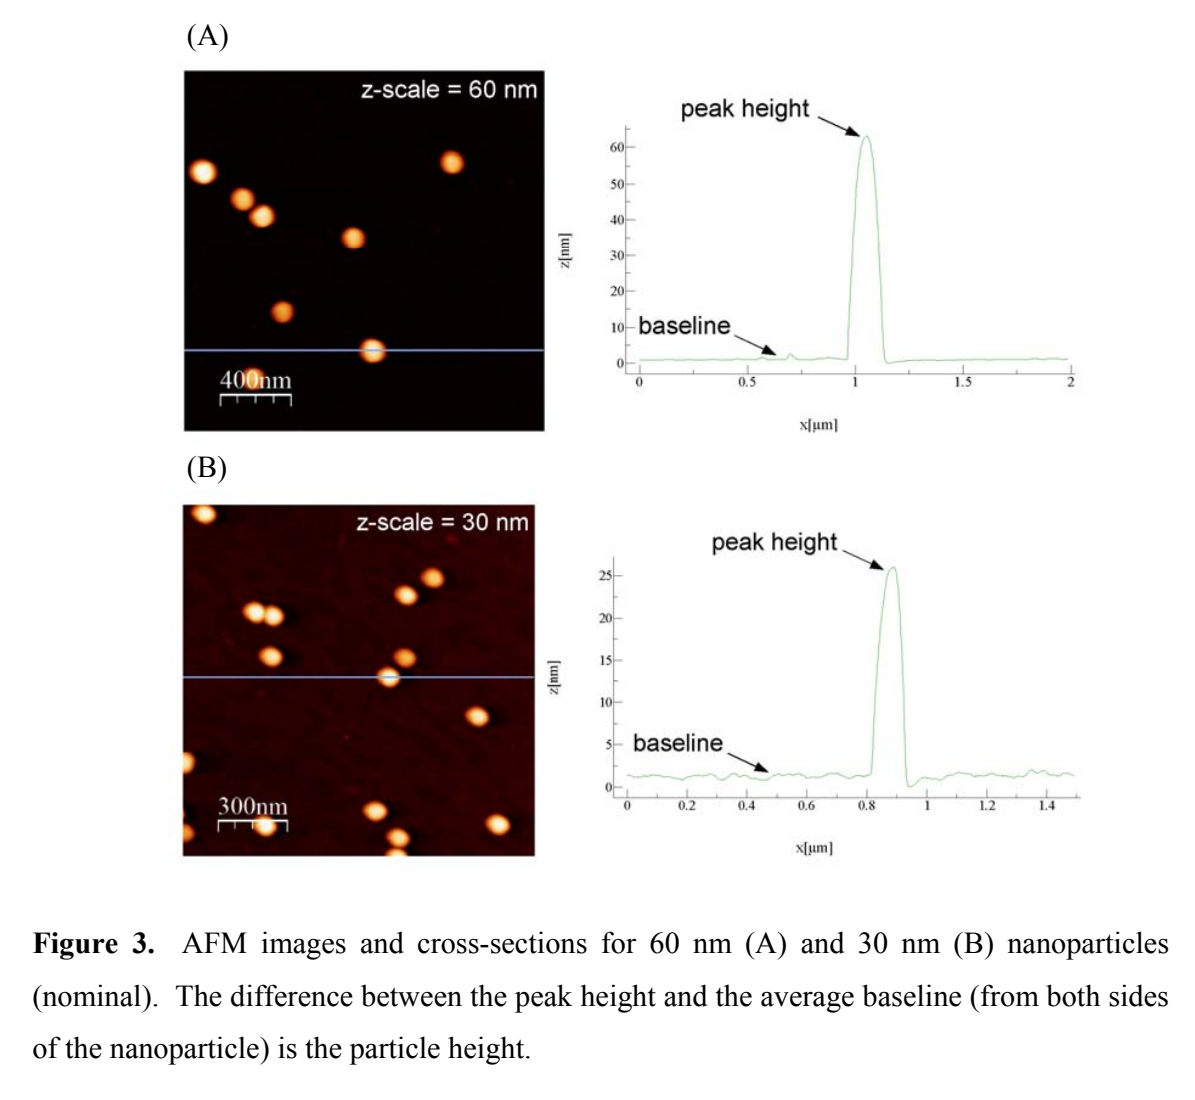
    公称60 nmの金ナノ粒子を示すAと公称30 nmを示すB。それぞれ左にAFM像、右に線に沿った断面があり、基板のbaselineと粒子頂点のpeak heightを示す。
    図1:金ナノ粒子のAFM像と断面。Aは公称60 nm、Bは公称30 nmの試料で、粒子の高さは頂点と両側の基板の平均値との差から求めます。Grobelnyほか、NIST–NCL Joint Assay Protocol PCC-6、Version 1.1(2009年)、p.14、Figure 3。原資料。Republished courtesy of the National Institute of Standards and Technology. 図を拡大する

    図1では、左の画像の線に沿った断面が右に示されています。山の頂点(peak height)と、粒子の両側の基板(baseline)の差を読みます。Aの60 nm、Bの30 nmは公称値であり、断面の頂点がその数字と一致することを示すものではありません。[1]

    たとえば仮に、基板からの高さが20 nm、画像上の横幅が45 nmだったとします。この二つを平均して「粒径32.5 nm」とする根拠はありません。横幅には探針の形が関わり、高さには基板の決め方や粒子の置かれ方が関わるためです。この数値は考え方を示す例で、原資料の測定結果ではありません。

    粒子を球とみなせ、基板上でつぶれたり積み重なったりしていなければ、高さを直径として扱えます。反対に、薄い板状の粒子や平らにつぶれた粒子では、高さはその姿勢での厚さです。高さから得た粒径は、形状についての前提を含む値として読む必要があります。プロトコル自体も、球形を仮定した場合に高さが直径に対応すると説明しています。[1]

    鮮明な画像でも、測定の基準は別に確かめる

    高さの基準になるのは、粒子の周囲の表面です。基板の粗さが粒子の大きさに近いと、どこをゼロにするかが曖昧になります。乾燥後に残った有機物の層も、基板や粒子の表面を変える要因です。NIST–NCLの手順は、金ナノ粒子を平らな基板へ分散させ、凝集や残留物を抑える準備を測定の一部に含めています。[1]

    画像の傾きを取り除く平坦化処理にも注意が要ります。粒子を含んだまま基準面を計算すると、粒子の山まで背景の傾きとして扱ってしまうことがあります。プロトコルは、粒子の部分を除外して基板側を平坦化し、その後に高さを測る手順を示しています。見た目を整える処理が、測りたい量を変えないかを確認するためです。[1]

    さらに、画像の画素数と観察範囲も分けて読みます。資料の例では、一辺10 µmを512画素で記録すると、1画素は約19.5 nmです。画像を拡大表示しても、もとの測定点の間隔は細かくなりません。ただし、この横方向の間隔を、そのまま高さ方向の分解能と呼ぶこともできません。横と縦では、確認する性能が違います。[1]

    高さ軸には、測りたい粒子に近い高さの段差標準を使った校正が必要です。また、多数の粒子の高さが散らばる幅と、平均値に付ける不確かさは同じではありません。粒子を多く数えることに加え、校正の不確かさも含めて結果を読む必要があります。[1]

    柔らかい粒子では、探針が高さまで変える

    探針の形による横方向の広がりと、探針が試料そのものを変形させる現象は別です。NISTのFarkasとKramarによる2020年の研究は、ポリスチレンラテックス粒子を強いタッピング条件で走査すると、探針の形やカンチレバーの傾きによって非対称な変形が生じることを示しました。繰り返しの走査で、最も高い点の位置も移動しました。[2]

    同研究では、小さい粒子の一部で、変形によって見かけの最大高さがいったん増える場合も報告されています。「押せば低くなるだけ」と考えると読み違えます。ただし、これは特定の柔らかい粒子と強いタッピング条件での結果です。金粒子の標準手順や、すべてのAFM測定へ同じ変形量を当てはめることはできません。[2]

    違う測定結果を比べるとき、何をそろえるか

    粒子のロット間で大きさを比べたいなら、まず「横幅を比べるのか、基板からの高さを比べるのか」を決めます。続いて、粒子の形状、分散と基板、探針、走査条件、平坦化と粒子の選び方、校正を確認します。こうした条件が違うと、材料の差と測定方法の差が一つの数字に混ざってしまうからです。

    AFMの結果に違いが出たときの切り分け。資料[1・2]からQuantum Seaが整理したもので、原因を断定する表ではありません。
    見えた違い 先に確かめること その値だけでは決められないこと
    横幅が大きく、高さとの差がある 探針の形、粒子の孤立、横方向の測定点の間隔 粒子そのものが大きくなったか
    高さが試料や場所によって違う 基板の段差・残留物、基準面、平坦化、粒子の姿勢 粒子の製造ばらつきだけが原因か
    繰り返すと高さや形が変わる 探針との相互作用、設定値、走査履歴 もともとの形状がどうだったか

    AFMの長所は、表面の凹凸を位置と結び付けて調べられることです。その情報を生かすには、画像の輪郭と高さを別々に読み、粒子の形状と測定条件を添えて比べます。そうすれば、単に大きい・小さいと結論づける前に、材料の違いを判断するために何が足りないのかを具体的に確かめられます。

    参考資料

    1. Grobelnyほか、NIST–NCL Joint Assay Protocol PCC-6「Size Measurement of Nanoparticles Using Atomic Force Microscopy」、Version 1.1、2009年10月改訂。測定原理と球形の前提はpp.3–5、校正と走査条件はpp.9–12、画像解析と不確かさはpp.12–17。金ナノ粒子の測定手順をもとに、測定値の読み方を整理しました。
    2. Natalia Farkas、John A. Kramar、「Tip-induced deformation of polystyrene latex reference nanoparticles in atomic force microscopy」、Journal of Vacuum Science & Technology A 38、023211、2020年。保存した著者原稿のpp.3–14を参照。DOI: 10.1116/1.5141749。
  • StarlingXの分散クラウド、中央との回線断でも現場に残る制御

    StarlingXの分散クラウド、中央との回線断でも現場に残る制御

    複数の工場や店舗を中央から管理するとき、拠点との回線が切れたら、現場のクラウド基盤まで使えなくなるのでしょうか。答えは、中央へ何を任せ、拠点に何を残しているかで変わります。画面に拠点を一覧できることと、その拠点が自力で制御を続けられることは、別の設計だからです。

    StarlingXのDistributed Cloud(分散クラウド)は、中央管理と拠点側の自律した制御を組み合わせます。OCP Korea Tech DayのOpenInfra講演で紹介されたこの基盤について、StarlingX 12.0の公式文書から、回線断、保守のための同期停止、拠点内の機器故障を分けて見ていきます。[1][2]

    簡単にまとめると?

    • StarlingXのサブクラウドは、拠点内に制御と認証の仕組みを持ち、中央との接続が失われてもローカルサービスを動かす設計です。
    • 中央の同期対象か、オンラインか、設定が同期済みかは別の状態です。保守用のUnmanagedも、回線断そのものを意味しません。
    • 中央回線への依存を減らしても、1台構成の機器故障や、アプリが利用する外部サービスの停止までは防げません。

    中央が束ねるもの、拠点に残すもの

    Distributed Cloudは、中央のCentral Cloudと、一つ以上のサブクラウドをL3ネットワークで結びます。サブクラウドは、単なる遠隔端末ではなく、コンテナ化したアプリケーションを動かすStarlingXのシステムです。中央には、自身の設備を管理するRegionOneと、サブクラウド群を管理するSystem Controllerという役割があります。[3]

    System Controllerは、サブクラウドの追加、対象となる設定の同期、稼働状態やアラームの監視、システムソフトウェアの更新管理を担います。一方、サブクラウドには自律した制御プレーンがあり、公式の概要は、中央へ向かう接続が失われても拠点内のローカルサービスが動作する構成だと説明しています。すべての制御を中央へ毎回問い合わせる構成ではありません。[2][3]

    この違いを具体的に示すのが認証です。公式構成文書では、サブクラウドのサービスは、その拠点内のIdentity Providerだけで認証するとしています。StarlingXのサービスではKeystone、KubernetesではService Accountを使うため、中央との通信が途切れたことだけで、認証先まで失う作りにはしていません。ここで説明しているのは基盤サービスの認証であり、上に載せるアプリ独自のログイン先まで自動的に拠点内へ移るわけではありません。[3]

    回線断でも残る処理を、アプリの依存先までたどる

    説明用の例として、工場Aと工場Bにそれぞれサブクラウドを置き、中央から管理する構成を考えます。工場Aと中央を結ぶ回線だけが切れ、工場Aの電源、機器、拠点内ネットワークは正常に動いているとします。工場Aに制御と認証を残す意味は、この場面で現れます。中央へ到達できないことと、拠点内の基盤サービスがすべて止まることを切り離せるからです。これは構成の理解を助ける仮例で、実機試験の結果ではありません。

    ただし、工場Aの検査アプリが、判定のたびに中央にあるデータベースを読むなら、その処理には回線への依存が残ります。アプリのログインに外部の認証サービスを使う場合も同様です。ローカルのクラウド制御が動くことだけから、アプリの入力、処理、結果の保存まで成立すると判断することはできません。

    そこで構成を選ぶときは、制御プレーンの配置に加え、アプリが使う認証先、データ、保存先を一つずつたどります。中央へ送る結果を一時的に現場へ残す設計なら、その保存容量と後から送る手順も確認対象です。これらは本稿で提案するアプリ側の確認事項であり、StarlingXが任意のデータを自動的に保管・再送するという説明ではありません。

    Managed、Online、In-syncは同じ「正常」ではない

    中央から見える状態も、一つの表示だけでは読み切れません。公式のdcmanager subcloud listの出力例は、management、availability、syncを別々の列にしています。その例には、managedかつonlineでも、out-of-syncのサブクラウドが載っています。接続状態と設定の同期状態は一致するとは限らないのです。[4]

    中央の状態表示を、三つの問いに分ける
    表示 読み分ける内容 その表示だけでは分からないこと
    management 中央からの設定同期を行うManagedか、保守用のUnmanagedか。 物理的に回線が切れているか、アプリが正常か。
    availability 中央の一覧に、Online/Offlineのどちらで報告されているか。 設定の同期完了や、業務処理の完了。
    sync 同期対象の状態がIn-syncか、Out-of-syncか、Unknownか。 アプリ独自のデータや外部サービスまで正常か。

    この表は公式構成説明とCLIの出力例を整理したものです。表示の更新間隔や障害の検知時間を示す表ではありません。詳細を見るdcmanager subcloud showの例では、identity、patching、platformの同期状態も別々に表示されます。再接続後の確認でも、Onlineへ戻ったことだけでなく、どの同期項目がどう表示されているかを調べる手掛かりになります。[3][4]

    特にUnmanagedは、通信障害の名前ではありません。公式文書では、拠点を保守するため、中央からの同期操作を切り離す状態としています。その間に中央側で行った設定変更は中央で待たせ、Managedへ戻したときにサブクラウドへ送ります。通信できる状態なら、Unmanagedでもアラームは中央へ送られます。「同期を止める」と「監視の通信まで止める」を同じ操作として扱わないことが大切です。[3]

    反対に、回線そのものが切れている間は、その回線を使う中央への報告も届きません。拠点の処理が続いていても、中央から現在の様子を確認できない場面があります。Unmanagedの設定保留についての説明を、そのまま「あらゆる通信障害中の変更が必ず再送され、順序どおりに適用される」という保証へ広げることもできません。

    中央との回線断と、拠点内の1台故障を分ける

    もう一つ分けたいのが、拠点を外部から切り離せることと、拠点内の機器を冗長にすることです。StarlingXはサブクラウドにSimplex、Duplex、Standardなどの構成を使えます。12.0の構成比較表では、1ノードのAIO-SX(All-In-One Simplex)は冗長性とコントローラーサービスの高可用性が「なし」、AIO-DX(All-In-One Duplex)とStandardは「あり」とされています。[3][5]

    工場AがAIO-SXなら、中央回線の故障には拠点側の自律性が役立っても、その1台が故障したときに代わりのローカルコントローラーが生まれるわけではありません。複数拠点を中央で束ねるだけでは、各拠点の電源、サーバー、保存装置といった、同じ原因で一緒に止まり得る範囲をなくせないためです。

    AIO-DXなどを検討する場合も、「冗長性あり」は全アプリの無停止を意味しません。アプリを何台へ配置するか、保存先をどう構成するか、障害時にどれだけの処理能力が残るかは別の条件です。小さな拠点を1台で構成する判断と、拠点内の機器故障も受け止める判断を、中央管理の有無と分けて行う必要があります。

    試すなら、切る場所と観測する場所を対応させる

    導入を判断するための確認では、まず「中央との回線だけが失われる場合」と「拠点内の機器が故障する場合」を別の試験にします。前者では、現場からの基盤へのアクセス、アプリが必要な入力と保存先、中央側の状態表示を分けて観測します。接続を戻した後は、設定の同期状態とアプリの実際の動作も照合します。後者では、選んだ拠点構成で代替できる制御と、代替できない処理・保存先を確かめます。

    ここで挙げたのは、公式の構成から導く確認の考え方です。本稿は障害試験を実施したものではなく、復旧時間、データ損失の有無、可用性の数値を示すものでもありません。StarlingXを選ぶ際に見るべきなのは、「分散しているから止まらない」という一語ではなく、中央から切り離しても成立させたい現場の処理と、その処理が依存するものが、同じ拠点のどこまで揃っているかです。

    参考資料

    1. Seongsoo Cho/OpenInfra Korea User Group「Open Infrastructure: Global Trends」、2026 OCP Korea Tech Day、全36頁。StarlingXの紹介はpp.19–22。OCP公式資料一覧。
    2. StarlingX 12.0「Overview of Distributed Cloud」。中央管理、サブクラウドの自律した制御プレーン。
    3. StarlingX 12.0「Distributed Cloud Architecture」。System Controller、拠点内の認証、Managed/Unmanagedとネットワークの役割。
    4. StarlingX 12.0「Manage Subclouds Using the CLI」。一覧と詳細表示、管理状態の切り替え。
    5. StarlingX 12.0「Deployment Model Comparison Matrix」。AIO-SX/AIO-DX/Standardの冗長性とコントローラーサービス。

    資料確認日:2026年10月12日。構成と操作表示はStarlingX 12.0の公式文書に揃えています。講演にある個別企業の導入規模や効果を、この構成の性能保証として用いていません。

  • Kata Containersの隔離、PodごとにVMを使うと何が変わるか

    Kata Containersの隔離、PodごとにVMを使うと何が変わるか

    コンテナに入れた処理と、その処理を動かすサーバーの間には、どのような境界があるのでしょうか。利用者が持ち込むプログラムを実行する場合などは、コンテナを起動できることに加えて、何を共有し、どこから分離するかが重要になります。

    Kata Containersは、コンテナを仮想マシン(VM)の中で動かし、隔離の層を増やす仕組みです。OCP Korea Tech Dayで紹介されたこの技術を、公式設計文書と制約の説明から見ていきます。特にKubernetesで使うときは、VMで分ける単位がPodであることと、従来のコンテナと同じ設定をそのまま使えるとは限らないことが、選定の出発点になります。[1、2]

    簡単にまとめると?

    • Kata Containersは、KubernetesのPodをVMに対応させ、その中でコンテナを動かします。同じPod内の各コンテナが、別々のVMになるわけではありません。
    • VMの境界があるため、ホストのネットワークを直接使う設定や、特権コンテナに与えられる権限の範囲は、通常のLinuxコンテナと異なります。
    • 導入時は必要なホスト連携を照合し、同じ仕事で起動時間やメモリー使用量も確認します。隔離を増やすことと、互換性や性能を保つことは別の確認です。

    コンテナの外側に、もう一つカーネルを置く

    Linuxのカーネルは、プログラムからの要求を受け、CPUやメモリー、入出力などを扱うOSの中核です。従来のLinuxコンテナは、名前空間やcgroupという仕組みで処理の見える範囲や資源の使い方を分けますが、ホスト側のカーネルを共有します。ホストとは、コンテナやVMを載せる側のシステムです。

    Kata Containersでは、ホスト側のランタイムがVMを起動し、VMの内側にあるゲストLinuxカーネルでコンテナを作ります。コンテナの名前空間やcgroupによる区分は、ゲストの中にも残ります。その外側に、ハードウェア仮想化を使うVMの境界が加わる構成です。コンテナをVMへ置き換えてなくすのではなく、VMの中で引き続きコンテナとして管理します。[2、3]

    公式文書の起動手順では、ホスト側のランタイムがハイパーバイザーを起動し、そのハイパーバイザーがゲストのカーネルとシステムイメージを使ってVMを立ち上げます。VM内のkata-agentがコンテナを作り、利用者の処理を実行します。このように、ホストで管理する部分と、ゲストで処理を動かす部分を分けています。[2]

    同じPodの中まで、VMで分かれるわけではない

    KubernetesのPodは、一つ以上のコンテナをまとめて扱う単位です。Kataの公式設計では、このPodの実行環境をVMに対応させます。一つのPodにアプリ本体と補助コンテナを置く場合、両方が同じVMに入り、ゲストカーネルを共有します。「コンテナを二つ作ったから、VMも二つ」という理解では、実際の境界とずれてしまいます。[2、3]

    例えば、文書変換サービスで、サービス提供者が管理する処理と、利用者が持ち込む変換プログラムを動かす場面を考えます。二つを同じPodに置けば、コンテナが別でもVMの境界は共有します。利用者の処理を別のVMへ分けたいなら、Podの分け方から検討する必要があります。これは境界を説明する仮例で、特定サービスの導入結果ではありません。

    ただし、Podを分けた後も、共有するファイルや認証情報、アクセスできる通信先は別に設計します。VMを分けることだけで、データの受け渡し方まで決まるわけではありません。どこまで同じ実行環境を共有してよいかを先に定めると、Kataを使う対象と、その対象をまとめる単位が見えてきます。

    ホストに直接触れる設定は、そのまま移せない

    隔離の境界を増やすと、ホストの機能を直接利用していた処理には違いが出ます。2026年10月12日に確認した公式のLimitationsは、ホストのネットワーク名前空間を使うhostNetworkを未対応としており、VMの中からホストのネットワーク設定へ直接アクセスできないことを理由に挙げています。従来のコンテナで使っていた設定を、Kataへ機械的に移す前に照合すべき点です。[4]

    privileged、つまり特権付きコンテナの意味にも注意が要ります。Kataでは、コンテナが持つ高い権限はゲストの内側でのものです。通常のruncベースのコンテナにある、ホストの機器を特権コンテナへ渡す既定の挙動と同じではありません。ゲスト内で権限が高いことと、ホストの機器を操作できることを分けて考えます。[4]

    Kataへ移す前に、設定名と実際の境界を照合する
    確認する対象 Kataでの意味 選定につながる確認
    同じPodの複数コンテナ 一つのVMの中で動き、ゲストカーネルを共有する VMで分離したい処理を、同じPodへまとめていないか
    hostNetwork 参照した公式制約文書では未対応 ホストのネットワークへ直接入る要件があるか
    privileged 権限が高くなるのはゲスト内。ホスト機器の自動的な受け渡しとは異なる 必要な機器や操作を、ゲスト側で実現できるか

    この表は公式文書の説明を本稿の判断項目に整理したものです。小さい画面では横へスクロールできます。[2、3、4]

    例えば、ホスト全体のネットワーク状態を直接調べるために作られた処理は、普通の業務アプリと同じ前提では移せません。どの情報や機器へ触れる必要があるかを確認し、その要件に合う実行方法を選びます。KubernetesではRuntimeClassを使ってPodのランタイムを指定できるため、すべてのPodを一度にKataへ切り替えることを前提にする必要もありません。[2]

    ゲストの中と、ホスト側の資源を分けて見る

    Kataの仕事は、VM内のコンテナだけで完結しません。ホスト側には、VMを動かすVMM(仮想マシンモニター)などもあります。公式文書は、資源制約を掛ける場所として、ゲストカーネル、ゲスト内のコンテナ、ホスト側のVMMを分け、目的によって複数の層へ制約を設定する場合があると説明しています。[4]

    そのため、アプリの処理時間だけで導入可否を決めると、VMの起動や維持に必要な条件を見落とします。同じ入力と同じ同時実行数で、処理を始められるまでの時間、ゲスト側とホスト側のメモリー使用量、必要な入出力が動くかを比べると、どこに違いが出たか判断しやすくなります。これは本稿からの評価方法の提案であり、Kataと通常のコンテナを実測した結果ではありません。

    また、公式文書は複数のハイパーバイザーを扱っていますが、対応する機器やファイル共有の仕組みは一律ではありません。「Kataに対応」という名称だけで、必要な周辺機能がそろうとは判断できません。採用するランタイム、ハイパーバイザー、版と設定をそろえ、その組合せで確認する必要があります。[3]

    Kata Containersで増えるのは、コンテナとホストの間にある防御の層です。完全な安全や、従来と同じ性能を保証するものとして選ぶのではなく、分離したい処理の単位と、ホストへ触れる必要性を照らし合わせる。そのうえで資源と互換性を確かめると、VMの隔離をどの仕事へ使うべきか、具体的に判断できます。

    参考資料

    1. Seongsoo Cho/OpenInfra Korea User Group「Open Infrastructure: Global Trends」、2026 OCP Korea Tech Day、全36頁。Kata Containersの紹介はpp.26–27。OCP公式資料一覧。
    2. Kata Containers contributors「Kata Containers Architecture」。Shim v2 architecture、Container creation、Mixing VM based and namespace based runtimes。
    3. Kata Containers contributors「Virtualization in Kata Containers」。PodとVMの対応、ゲスト内のコンテナ、ハイパーバイザーごとの機能。
    4. Kata Containers contributors「Limitations」。Host network、Privileged containers、The constraints challenge。

    資料確認日:2026年10月12日。公式文書の公開版とリポジトリのmainを参照しています。特定の配布版を導入した検証や、速度・メモリー使用量の比較試験は行っていません。採用時は対象版の文書と実際の設定を確認する必要があります。

  • Zuulのゲーティング、取り込む順番に沿って変更をテストする

    Zuulのゲーティング、取り込む順番に沿って変更をテストする

    それぞれの変更はテストに通ったのに、二つを取り込むと動かなくなる。ソフトウェアの開発では、変更そのものだけでなく、組み合わせた状態も確かめる必要があります。後から取り込む変更を、古い状態のまま試した結果では、その違いが抜け落ちるためです。

    この問題を扱うのが、Zuulのゲーティングです。コードを本流へ取り込む「マージ」の前に、必要な試験を通す仕組みを指します。OCP Korea Tech DayでOpenInfra Korea User GroupのSeongsoo Cho氏が紹介したZuulについて、公式文書を重ね、変更の順番と再試験の関係を見ていきます。[1][2]

    簡単にまとめると?

    • Zuulは、前の変更も取り込まれると仮定し、後ろの変更をその組み合わせで先にテストします。
    • 前の変更が失敗すれば、それを除いた状態で後続を試し直します。ただし、失敗した変更を本当に必要とする変更は、そのまま先へ進めません。
    • 関連するリポジトリの範囲、試験内容、先に試す変更の数を合わせて設計します。並列化すれば必ず速くなるわけではありません。

    「単独で通る」と「一緒に通る」の間

    仕組みを理解するための例として、送信側が一度に8件を送り、受信側は16件まで受け取れる処理を考えます。変更Aで送信を12件に増やしても、現在の受信上限16件なら収まります。別の変更Bで受信上限を10件に下げても、現在の送信件数8件なら収まります。

    ところがAとBを合わせると、12件を送る先の上限は10件です。各変更を元の構成に対して試すだけでは、この組み合わせを確かめたことになりません。これは説明用の仮例で、特定製品の試験結果ではありません。

    一つ取り込むたびに次の変更を試せば、順番に沿った確認はできます。ただ、試験が長いほど待ち行列が伸びます。Zuulのdependent pipeline managerは、この順序を保ちながら試験を並行させる役割を持ちます。[3]

    前の変更が通ると仮定して、先に試す

    変更A、B、Cがこの順でキューへ入ったとします。キューは、取り込みを待つ変更の列です。ZuulはAだけ、AとB、AとBとCという組み合わせを作り、利用できる実行資源の範囲で並行して試験します。これがspeculative execution(先行する変更の成功を仮定した実行)です。まだ確かめていない変更を本流へ先に入れる、という意味ではありません。[2][3]

    同じ開始時点から、どの変更を重ねて試すか
    対象の変更 試験する状態
    A 現在の本流 + A
    B 現在の本流 + A + B
    C 現在の本流 + A + B + C

    この表は公式文書の説明を三つの変更に整理したものです。Bを試す環境にAが入っているため、Bだけを古い本流に載せた試験とは、結果の意味が違います。後続の試験が早く終わっても、先行する変更の合否を無視してよいわけではありません。[2]

    失敗したら、何を除いて試し直すか

    先頭のAが失敗すると、Aを含めて試したBとCの結果は、そのまま使えません。単に順番待ちしていた独立した変更なら、Aを列から外し、Bは「現在の本流+B」、Cは「現在の本流+B+C」で試し直します。前提となる組み合わせが変わったからです。[3]

    ここで区別したいのが、順番の都合で先行変更を含めることと、機能としてその変更を必要とすることです。例えば、共通ライブラリーへ新しい関数を加える変更Aと、その関数を呼ぶサービス側の変更Bは、Aを除いてBだけ進められません。Zuulでは、変更URLを指定するDepends-Onで、こうしたリポジトリをまたぐ依存を明示できます。依存先が失敗すれば、その依存先とそれに依存する変更はキューから外され、依存先が取り込まれるまでは依存する側も取り込めません。[2]

    「失敗したものを飛ばす」と一律に考えると、この違いを見失います。再試験で進められる変更と、前提の修正を待つ変更を分けるためにも、コード上の依存を記録しておく必要があります。

    一緒に試す範囲を、リポジトリの境界と照合する

    リポジトリは、ソフトウェアや設定の変更履歴を保存する単位です。サービスと共通ライブラリーを別のリポジトリで管理しているなら、それぞれの単体試験だけでは、組み合わせの不整合を見逃すことがあります。

    Zuulのproject.queueでは、試験で相互に関わるプロジェクトへ同じ共有キューを指定します。dependent pipelineでは、その列の先行変更を含めて後続を試します。共有キューの設定自体は、試しの変更として置くだけでは有効にならず、設定をマージしておく必要があります。[4]

    queue.typeをper-branchとしてブランチ名ごとにキューを分ける場合には、関連プロジェクトのブランチ名をそろえる条件もあります。名前が違えば、一緒に試したい変更が別のキューへ入るためです。また、複数のリポジトリを同じキューへ置いても、複数のマージが一つの不可分な操作になるわけではありません。公式文書は、循環する依存を許可した場合でも、一部だけ取り込まれる失敗があり、人の介入が必要になり得ると説明しています。[5]

    共有する範囲は、部署や組織の大きさより、実際に一緒に試す必要のある関係から考えます。無関係な変更まで同じ列へ集めると、ある変更の失敗によって、試し直す範囲も広がり得ます。

    待ち時間だけでなく、試し直す量も見る

    並行して試す変更を増やせば、すべて通るときは待ち時間を減らせます。一方、先行変更が頻繁に失敗する環境では、後続の試験をやり直す負担が増えます。Zuulのwindowは、キューの先頭から何件の変更について試験を開始できるかを制御します。これは、個々のテストジョブの本数と同じ数ではありません。[3]

    導入を考えるなら、まず関連する二つのリポジトリと、それらを組み合わせる試験を一組選びます。通常の変更が通る場合に加え、先行変更が失敗する場合、明示した依存先が失敗する場合に、どの結果が破棄され、どの変更が止まるかを見る。待ち時間の短縮と、再試験に使う時間・実行資源を合わせて比べるための確認です。

    ゲーティングが整えるのは、変更を試す状態と取り込みの条件です。用意していない試験の不具合まで自動で見つけたり、本番への配備が安全であると保証したりするものではありません。早い段階で結果を返す試験、取り込みを決める試験、取り込み後の配備を区別したうえで、どの組み合わせを合格とするかを設計することが、Zuulを使う出発点になります。[3]

    参考資料

    1. Seongsoo Cho/OpenInfra Korea User Group「Open Infrastructure: Global Trends」、2026 OCP Korea Tech Day、全36頁。Zuulの紹介はpp.23–25。OCP公式資料一覧。
    2. Zuul contributors「Project Gating」。並行試験、再試験、共有キュー、明示的な変更依存。
    3. Zuul contributors「Pipeline」。independent/dependent/serialの役割、pipeline.window。
    4. Zuul contributors「Project」。project.queueと設定の有効化。
    5. Zuul contributors「Queue」。ブランチ単位の区分と、循環依存を扱う際の制約。

    資料確認日:2026年10月12日。公式文書のlatest版を参照しています。試験環境を動かした検証や、講演に登場する個別企業の改善効果の検証は行っていません。