
連立方程式を量子コンピューターで解くと、答えはどのように返ってくるのでしょうか。HHLアルゴリズムが作るのは、解の成分を並べた表ではなく、解の方向を表す量子状態です。この違いを見落とすと、「解けた」と「必要な数値を取り出せた」を同じ意味で扱ってしまいます。
二つの未知数だけを持つ例で、普通の解、量子状態の振幅、測定で見える確率を順に比べます。ここで行う計算は出力の意味を確かめるための理想的な数値例で、HHL回路の実機実行や速度の実証ではありません。
簡単にまとめると?
- HHLの出力状態は解ベクトルを正規化したものです。元の解の大きさまで、状態だけから読み取れるわけではありません。
- 成分が2対1なら、その基底で測った確率は4対1です。測定を繰り返して得る頻度は、解の成分そのものとは違います。
- 全成分が必要か、一つの特徴を推定できればよいかで、必要な読み出し作業が変わります。入力準備、行列の扱いやすさ、精度も含めて比較します。
解は「1と0.5」、測定確率は「80%と20%」
未知数をx₀、x₁とし、x₀=1、2x₁=1という二つの式を考えます。行列ではA=diag(1,2)、b=(1,1)、Ax=bです。解はx=(1,0.5)。Aは対角行列なので、それぞれの式を割り算すれば確かめられます。
この解を量子状態の振幅として使うには、成分の絶対値の二乗の合計を1にそろえます。元の解の長さは√(1²+0.5²)=√5/2。両成分をこの長さで割ると、状態は|x⟩=(2/√5)|0⟩+(1/√5)|1⟩になります。|0⟩と|1⟩は、ここでは二つの成分を区別するラベルです。
振幅は約0.894と約0.447ですが、同じ基底で測定して得られるのは0か1のどちらかです。それぞれの確率は振幅の絶対値の二乗なので、4/5と1/5、つまり80%と20%になります。一度の測定で「0.894」と表示されるのではありません。
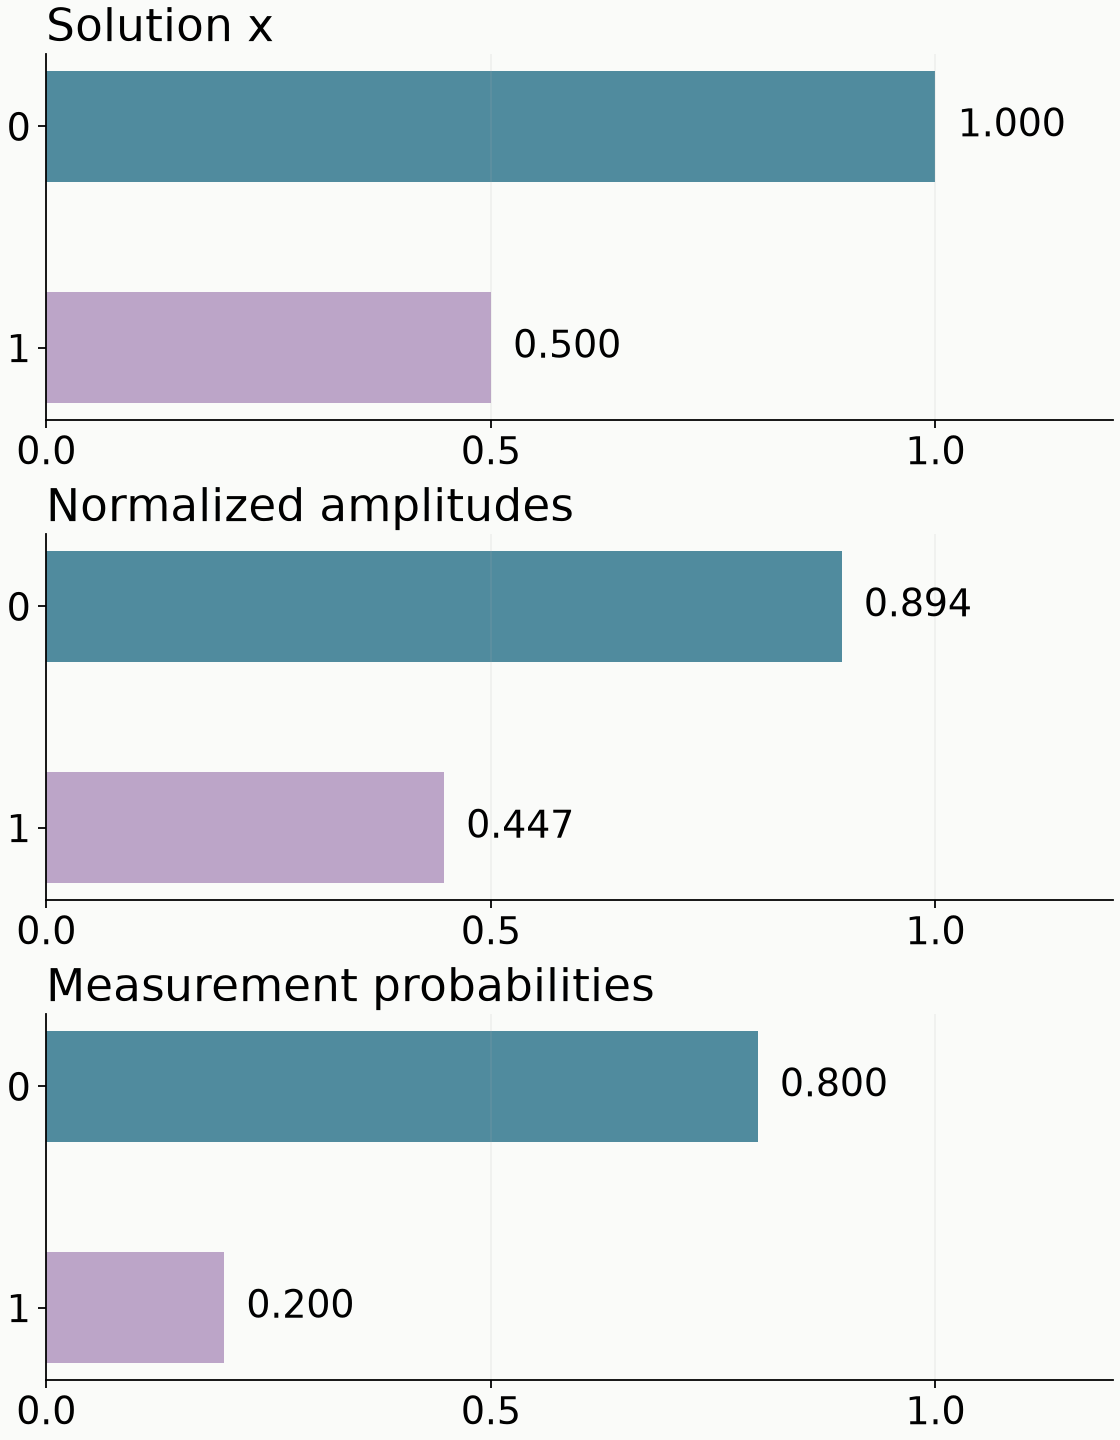
たとえば、この状態を100回準備して測れば、0の回数の平均は80回です。ただし、毎回80回になるわけではありません。独立な測定なら回数の標準偏差は√(100×0.8×0.2)=4回。測定を増やすと確率の見積もりは安定しますが、確率と振幅を区別する必要は残ります。
同じ確率でも、同じ解とは限らない
解が(2,1)でも、長さで割れば同じ|x⟩になります。正規化後の状態は成分どうしの割合を保ちますが、元のベクトル全体の大きさは保ちません。元のbの大きさや、計算途中の成功確率など、別の情報を使って規模を求める必要があります。
もう一つ、(1,−0.5)を正規化した状態を考えると、0と1の測定確率はやはり80%と20%です。符号が二乗で消えるためです。ただし二つの状態は同一ではなく、測り方を変えると区別できます。
具体的には、|+⟩=(|0⟩+|1⟩)/√2と|−⟩=(|0⟩−|1⟩)/√2を基底にして測ります。元の正の例で+が出る確率は|(2+1)/√10|²=90%。負の例では|(2−1)/√10|²=10%です。これは成分間の相対的な符号を、干渉によって確率へ変えて調べる例です。実数二成分だけの説明であり、一般の複素ベクトル全体を一種類の測定で復元できるという意味ではありません。
HHLは、どこで割り算を行うのか
HHLはHarrow、Hassidim、Lloydによる量子線形方程式アルゴリズムです。原論文では、まずエルミート行列、つまり複素共役を取って転置しても同じになる行列Aを扱います。今回の実数対角行列も該当します。入力bを状態として準備し、行列Aの固有値を位相推定で推定します。その値に応じて補助量子ビットを回転させ、成功した枝に固有値の逆数で重みを付けます。推定に使った情報を戻す操作と成功条件の選別を経て、A⁻¹|b⟩に比例する状態を得ます。[1]
この例では固有値は1と2です。入力状態は(|0⟩+|1⟩)/√2。理想的に固有値が分かっているとして、成功側の振幅に1と1/2を掛ければ、成功側は(1/√2,1/(2√2))になります。その二乗の合計は5/8で、成功確率は62.5%。成功した枝を正規化すると、先ほどの(2/√5,1/√5)に一致します。
ここで使った共通係数は1で、二つの成功側係数がどちらも1以下になるよう選んでいます。原論文で用いる行列の規格化へ合わせてAをA/2にし、共通係数も1/2にすれば、比は同じです。この計算は逆数による重み付けと選別だけを取り出した説明であり、有限精度の位相推定や回路雑音は含めていません。
また、この理想例では成功確率pと係数Cから、正規化入力に対する解の長さを√p/Cで求められます。元の入力の長さ√2も掛けると、√2×√(5/8)=√5/2。元の解の長さと一致します。大きさの情報が完全に消滅するのではなく、出力状態とは別の測定と既知の入力情報が必要だと分かります。
何を受け取りたいかを先に決める
原論文が扱う利点には、入力状態を効率よく準備できること、行列の非ゼロ要素へ効率よくアクセスできること、条件数や要求精度が適切であること、といった条件があります。条件数は、ここでの正の対角行列なら最大固有値と最小固有値の比です。小さな固有値の逆数を使うほど、固有値の推定誤差が解へ効きやすくなります。[1]
今回のAの条件数は2です。一方、対角成分を1と0.01にしたA、同じbなら、解は(1,100)、条件数は100になります。二番目の対角成分が0.0101へわずかに変わると、解の二番目は約99.01へ変わります。絶対値では小さな行列の変化でも、逆数を取る側の尺度で確かめる必要があります。この例だけで一般の誤差や実行時間を見積もることはできません。
「全地点の値を一覧にして保存したい」なら、必要な成分数と精度に応じた読み出しを計算に含めます。「ある領域に状態の重みがどれくらいあるかを知りたい」なら、その領域を区別する測定で目的を満たせるか検討できます。今回の例で二番目の状態の重みだけが目的なら、1の頻度を推定することが直接その答えになります。
入力を状態へ載せる手間、解を得る操作、必要な量を測る手間。この三つを同じ条件で比べてはじめて、利用目的に合うかを判断できます。HHLの原論文は2009年のアルゴリズム研究であり、この小さな例も、現在の量子機が通常の連立方程式計算より速いことを示すものではありません。
参考資料
- [1] Harrow, Hassidim, Lloyd, Quantum algorithm for linear systems of equations(arXiv:0811.3171v3、2009年9月30日)。状態の準備・逆数による重み付け・成功条件・読み出しの前提はIntroductionおよびAlgorithmを参照。本文の二成分の数値例と図は、ここで示した式に基づく独自計算。