応答を作り始めた時点では、最終的な本文の長さがまだ分からない。それでも、受信側には「ここまでが今回の本文」と伝える必要があります。同じ接続で次のやり取りを続けるなら、接続が切れるまで待つ方法だけでは足りません。
HTTP/1.1のchunked転送符号化は、本文を長さ付きの小さな塊へ分け、最後の塊と終端を伝える仕組みです。全体長を最初に知らせる代わりに、各部分の長さを順に知らせます。RFC 9112の定義と、短い文字列を使う独自例から、データそのものと境界を表す情報を分けて読みます。
簡単にまとめると?
- 各チャンクには16進数で表すデータ長が付きます。数えるのは文字数ではなくオクテット、つまり8ビット単位の長さです。
- サイズ0の最後のチャンクに続き、必要ならトレーラーの欄を送り、空行で終わります。データ中の数字0を探す処理ではありません。
- chunkedはHTTP/1.1のメッセージ境界を伝える方式です。圧縮や文字コードの変換とは役割が異なり、Content-Lengthとの併記にも制約があります。
総量を先に決めず、部分ごとの長さを知らせる
通常の本文付き応答でContent-Lengthを使う場合、受信側は示された長さを手掛かりに本文の範囲を判断できます。しかし、処理しながら生成する本文では、送信開始時に総量が確定していないことがあります。全体の完成を待って数える設計も可能ですが、生成と送信を並行させたい場合には別の境界の伝え方が必要です。
そこで、Transfer-Encodingにchunkedを指定し、生成できた部分を長さ付きで送り出します。受信側は長さ行を読み、その数のデータを受け取り、区切りを確認して次へ進みます。全体長が未知であることと、何も区切りを持たないことは違います。小さな長さの情報を重ねることで、全体の終わりまで追えるようにしています。
7バイトの内容を、二つに分けて送る
独自例として、ASCII文字列seawaveをseaとwaveへ分けます。前者は3バイト、後者は4バイトです。拡張情報やトレーラーを付けない場合、チャンク化した本文は次のバイト列になります。表示のため、改行を構成する二つの制御文字をCRLFと書きます。実際にCRLFという4文字を送るわけではありません。
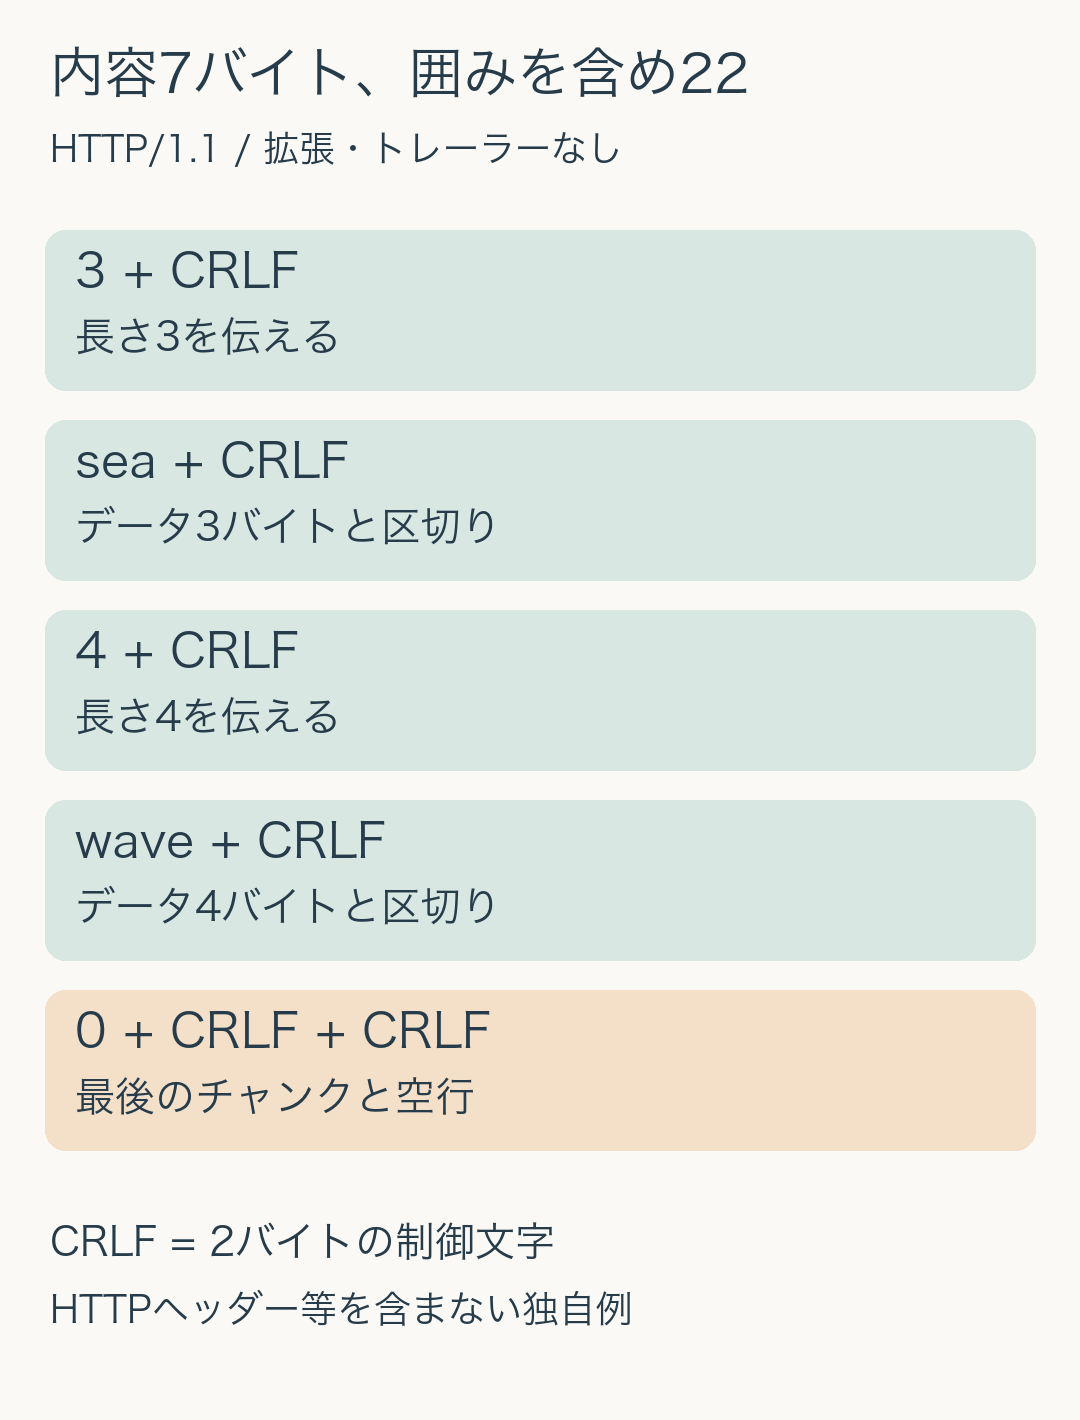
最初の3とCRLFで3バイト読むと分かり、続くseaがデータになります。その後のCRLFを挟んで次の長さ4を読み、waveを受け取ります。最後は0、CRLF、空のトレーラーを終えるCRLFです。0の行だけを見て、後ろにある欄や終端を無視してよいわけではありません。
この例のデータは合計7バイトです。長さ行と区切りを含めた本文は22バイトで、同じ内容を一つのチャンクにすると17バイトになります。塊を増やせば、その分だけ長さ行と区切りが増えます。ここで比べたのは構文上のバイト数であり、応答時間や通信性能を測った結果ではありません。
長さを読む段階と、文字を読む段階を分ける
チャンクサイズは16進数です。十進で10バイトなら長さ欄はAと表せます。一方、今回の3と4は十進数と同じ見かけなので、例だけでは16進表記である点を見落としがちです。受信処理は、数字の見た目ではなく仕様に従って解釈します。
さらに、サイズが数えるのはオクテット数です。日本語の文章をUTF-8にしたとき、文字数とバイト数が同じになるとは限りません。まず指定された数のバイトを取り出し、チャンクの構造を解いた後で、本文に合う文字コードとして解釈します。「何文字表示されたか」を、チャンクの終了位置の判定に使うことはできません。
同様に、データ内に数字0が現れても、それだけでは終端になりません。今が長さ欄を読む段階なのか、指定されたデータを読む段階なのかを区別します。短い例であっても、読む順番と残りバイト数を書き出すと、境界の取り違えを確認しやすくなります。
圧縮された表現と、転送中の囲み方は別
Content-Encodingは、gzipなど、表現へ施された符号化を伝えます。Transfer-Encodingは、内容をメッセージ本文として転送する際の処理を表します。chunked自体は、繰り返す文字を短く圧縮する方式ではありません。今回の7バイトが22バイトになったのも、境界を知らせる情報を加えたためです。
RFC 9112では、Transfer-Encodingを持つメッセージへ送信側がContent-Lengthを付けることを禁止しています。異なる受信処理が別々の境界を採用すると、その後のデータの解釈までずれる可能性があるためです。ログに両方があるとき、都合のよい方を選んでよい通常例として扱わず、仕様のエラー処理を確認します。
また、中継する受信者が転送符号化を解いたり、別の形へ組み直したりする場合があります。アプリが受け取った本文に長さ行が見えなくても、元の通信がchunkedではなかったとは限りません。観測しているものが線上の本文か、HTTPライブラリー処理後の内容かを記録することが比較の前提です。
小さな例から一般の受信処理へ進むとき
一般のchunked構文には、各チャンクの拡張情報と、最後に置くトレーラーの欄があります。サイズの整数変換があふれないか、指定したデータが最後まで届いたか、区切りが正しいかも確認が必要です。本稿の二つのチャンクだけを処理できる模型を、一般のHTTPパーサとしてそのまま使えるとは扱いません。
ここではHTTP/1.1の本文の囲み方に範囲を限定しました。HTTP/2やHTTP/3のフレームへ、同じ長さ行と終端の並びをそのまま当てはめる説明ではありません。HTTP/1.1でも、本文を持たない応答やCONNECTによる切替などは別の条件があるため、全応答がこの例になるわけではありません。
設計や不具合調査では、総量を事前に知れるか、どの段階で境界を解くか、受信完了を何で判断するかを分けます。chunkedの役割は、生成途中の内容を順次送れるようにしながら、その一つのメッセージの終わりを受信側へ伝えることです。小さな長さ行を追う作業が、接続の継続と本文の終了を混同しない手掛かりになります。
出典
- RFC 9112, HTTP/1.1(2022年6月、STD 99)、6.1〜6.3節、7.1節。具体的な文字列・バイト数・図は独自の構文模型。