同じ密度行列を持つ量子ビットを受け取っても、送り手が選んだメッセージについて得られる情報が同じとは限りません。違いは、平均した状態の奥に、どのメッセージとどの状態を結び付けたかという準備の規則があることです。Holevo量(ホレボ量)は、その規則と測定から得られる情報の関係を整理します。
簡単にまとめると?
- Holevo量χは、平均状態のエントロピーから、メッセージごとの状態エントロピーの平均を引いた値です。平均の密度行列だけでは決まりません。
- 0と1を直交する純粋状態へ対応させる例と、どちらにも同じ最大混合状態を割り当てる例では、平均状態はどちらもI/2ですがχは1 bitと0 bitに分かれます。
- χは測定で得られる古典的な相互情報量の上限です。いつも一度の測定でその値まで読み取れるという保証ではなく、共有済みのもつれなどの条件も分けて扱います。
状態を平均する前に、メッセージとの対応を残す
送り手が古典的なラベルXを確率p(x)で選び、そのラベルに対応する量子状態ρxを準備するとします。受け手は準備規則を知っていますが、今回どのxが選ばれたかは知りません。確率と状態を組にした集合を、ここではアンサンブルと呼びます。
ラベルを知らずに状態だけを見ると、平均の密度行列はρ̄=Σxp(x)ρxです。受け手が行う測定の結果をYとすると、測定の要素Eyを使って、ラベルxのときに結果yが出る確率はp(y|x)=tr(Eyρx)と書けます。Eyは正で、すべての結果について足すと単位行列になる、一般化された測定の表し方です。[1、§10.6.1]
測定結果のばらつきH(Y)そのものが、メッセージを知った量になるわけではありません。ラベルと無関係な乱数がたくさん出ても、Xを推測する助けにはならないからです。両者の結び付きを表す相互情報量I(X;Y)を使います。古典的な離散変数ではH(X)−H(X|Y)と書け、結果Yを知ることでXの不確かさがどれだけ減るかを表します。
平均の不確かさから、各信号の内側の不確かさを引く
有限次元の状態ρに対し、フォン・ノイマンエントロピーはS(ρ)=−Σλ log₂λです。λは密度行列の固有値で、0 log₂0は0とします。底を2にそろえるので単位はbitです。本稿のSは原資料がHと書いている量子エントロピーに対応します。
Holevo量はχ=S(ρ̄)−Σxp(x)S(ρx)と定義されます。[1、式10.214] 二つ目の項は「ラベルを一つに決めた後でも、その信号の状態に残るエントロピー」を平均したものです。信号を混ぜて全体として見たときのエントロピーから、この項を差し引くことで、ラベルと量子系の間にある相関を表します。
任意の測定に対してI(X;Y)≤χが成り立ちます。さらに、許されるすべての測定から最善のものを選んで得られる情報をaccessible information、取り出せる情報と呼ぶと、その値もχ以下です。[1、式10.205、10.211] 上限の計算と、その上限を達成する測定の発見は別の課題になります。
同じI/2を作る二つの準備を比べる
ラベルは0と1を半々に選びます。最初の準備Aでは、0なら|0⟩、1なら|1⟩を送ります。二つは直交する純粋状態です。それぞれのエントロピーは0ですが、平均するとρ̄=I/2となり、エントロピーは1です。したがってχ=1−0=1 bitになります。
この場合、0と1を区別するZ基底の測定を選べば、ラベルと結果は必ず一致します。H(X)=1、結果を知った後のH(X|Y)=0なので、I(X;Y)=1 bitです。この具体例では上限を達成できます。ただし、測定する前にX基底へ読み方を変えると、どちらのラベルでも+と−が半々に出ます。その測定のI(X;Y)は0です。χが1でも、任意の測り方が1 bitを取り出せるわけではありません。
次の準備Bでは、ラベルが0でも1でも、まったく同じI/2を送ります。たとえばラベルとは独立な別の乱数で|0⟩か|1⟩を半々に用意し、その乱数の記録も受け手へ渡さない準備です。平均状態はやはりI/2ですが、各ラベルの状態エントロピーも1なので、χ=1−1=0 bitです。
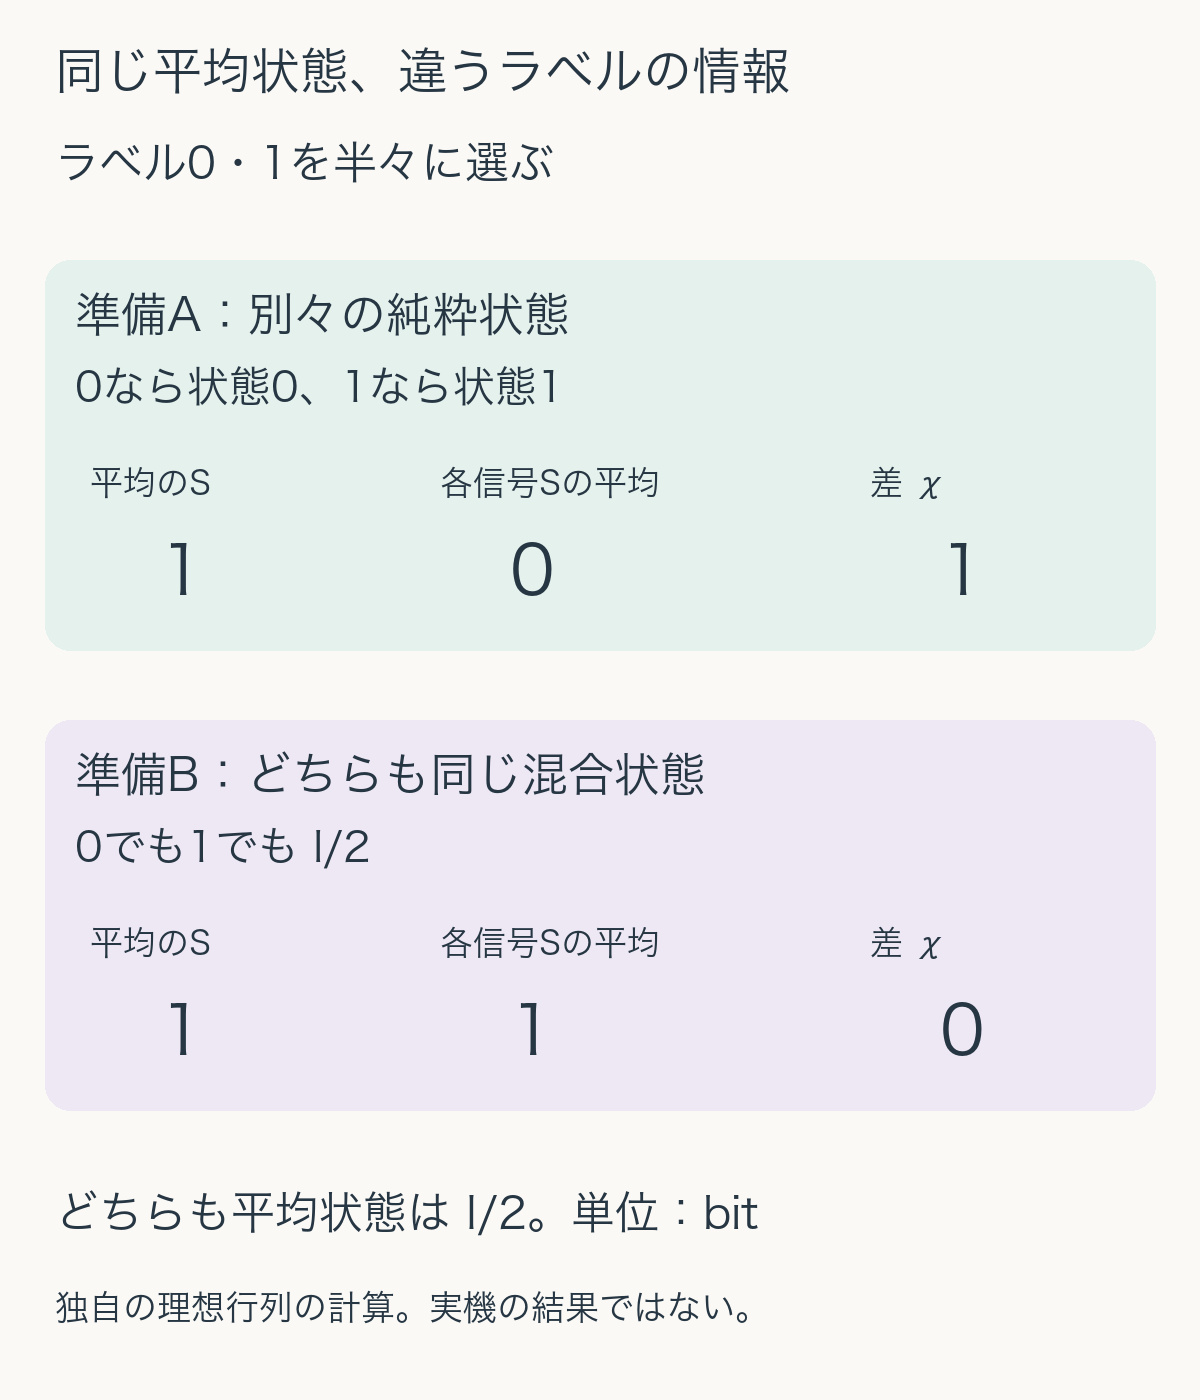
準備BではZ測定の結果が0・1の半々でも、その出方はラベルに依存しません。任意のEyについてp(y|0)=tr(EyI/2)=p(y|1)なので、どの測定でもラベルと結果は独立です。出てきた乱数を何個記録しても、それだけで今回のラベルが分かるようにはなりません。
「区別できない平均状態」と、ラベルの相関は両立する
二つの準備の平均密度行列が等しいなら、受け取った量子系だけに行う測定の結果分布p(y)は同じです。これと、準備Aでラベルが読めるという説明は矛盾しません。違うのは、結果とラベルを組にした分布p(x,y)です。
Z測定なら、準備Aでは(ラベル0,結果0)と(ラベル1,結果1)が各1/2です。準備Bでは(0,0)、(0,1)、(1,0)、(1,1)が各1/4です。結果だけを合計すると両方とも半々ですが、対応表の中身は一致しません。平均密度行列からラベルとの対応関係まで逆算しようとすると、この違いを失います。
独自計算では、平均行列の一致、各状態の固有値、二つのχ、Z測定の同時確率と相互情報量を照合しました。準備AでX測定を選ぶ場合のI(X;Y)=0も計算しています。これは例の整合性確認であり、一般のアンサンブルで最適な測定を探索した結果ではありません。
情報量を比較するときにそろえる条件
通信やセンシングの説明で情報量を読むときは、まず何をラベルXにしたか、各ラベルの事前確率は何か、対応する状態は何かを確かめます。次に、受け手へ渡した量子系の範囲と、使った測定を確認します。状態の平均エントロピー、χ、特定の測定の相互情報量を一つの数値として扱わないことが大切です。
特に「一つの量子ビットで何bit伝わるか」は資源の条件に依存します。本稿では受け手が信号以外に、メッセージと結び付いた補助系を持たない単純な準備を比べました。あらかじめ共有したもつれを使う超密度符号化では、受け手が持っていた相手側の量子系も合わせて測ります。その資源まで含む別の課題なので、本稿の単独信号の比較と混同しません。
また、長い符号列をまとめて送って測る通信の到達率や、雑音を含む実装の速度は、ここでの二つの理想行列からは決まりません。Holevo量は測定の可能性を考える大切な上限ですが、装置の測定精度、符号化、必要な試料数や時間を省いて性能保証へ置き換えることはできません。
出典
- John Preskill, Quantum Information, Chapter 10: Quantum Shannon Theory(2025年6月改訂の講義草稿)。§10.6.1–10.6.2、本文40–42頁、式10.204–10.205、10.211–10.214。2026年10月23日に公式掲載版を確認。二つのアンサンブル、測定の比較、数値照合と図表は独自作成。