パケットの一部を書き換えるたびに、検査用の値を最初から計算し直す必要があるでしょうか。Internetチェックサムでは、変更前の値と変更後の値が分かれば、すでにあるチェックサムから新しい値を求められます。ただし、その計算を普通の整数の引き算と同じように整理すると、ゼロになる境目で結果がずれることがあります。鍵になるのは、1の補数という計算でゼロを二通りのビット列で表せることです。
簡単にまとめると?
- Internetチェックサムは、16ビットごとの1の補数和を求め、最後に各ビットを反転して作ります。はみ出した桁は下位へ戻して足します。
- 差分更新では、古いチェックサムを和に戻し、変更前の語を取り除いて変更後の語を加え、最後に反転します。
- 0000とFFFFという二つのゼロがあるため、式を変形した結果が全体の再計算と一致するか、ゼロ付近まで確かめる必要があります。
IPv4では、本文ではなくヘッダーを検査する
チェックサムは、データから短い検査値を計算し、受信時の照合に使う仕組みです。IPv4のヘッダーチェックサムが対象にするのは、宛先などを持つヘッダー部分です。後ろに続くデータ全体を、この欄だけで検査しているわけではありません。RFC 791では、ヘッダーの各16ビット語を使って計算する方法が定められています。
転送の途中でヘッダーの値が変わると、対応するチェックサムも変わります。たとえばTTLは、パケットがネットワーク内に残り続けることを防ぐための値で、処理の途中で減らされます。変更した部分が分かっているなら、変わらない部分まで足し直さずに済む。そのための方法が差分更新(incremental update)です。対象は、正しい元のチェックサムと、対応が分かる16ビット語の変更です。
桁あふれを捨てず、下位へ戻して足す
まず計算の約束をそろえます。この記事では、0001やFFFFは16進数で書いた16ビットの値です。FFFFは全16ビットが1、0000は全ビットが0を表します。1の補数を取る操作は、各ビットの0と1を入れ替えることです。たとえば0001を反転するとFFFEになります。
1の補数和では、16ビットからはみ出した桁を下位側へ戻して加えます。これをエンドアラウンドキャリーと呼びます。たとえばFFFFと0001を普通に足すと10000ですが、下位16ビットの0000に、はみ出した1を加えて0001にします。単に上位の桁を捨てる16ビット加算とは、ここが違います。
チェックサムを作るときは、チェックサム欄を0にしたうえで対象の語をこの方法で足し、最後に16ビットを反転します。和そのものと、ヘッダーに保存するチェックサムは別の値です。この区別が、差分更新の式を読むときに効いてきます。
古い語を外し、新しい語を入れる
元のチェックサムをHC、変更前の16ビット語をm、変更後をm′とします。RFC 1624の式3は、新しいチェックサムHC′をHC′ = ~(~HC + ~m + m′)と表します。ここで~は16ビットの反転、+はエンドアラウンドキャリーを含む1の補数加算です。
順に読むと、~HCで元の和へ戻し、~mを足して古い語の寄与を取り除き、m′を加えて新しい内容の和にし、全体を最後に反転します。変更しなかった語は、元の和の中に残っています。全部のデータをもう一度読む代わりに、変更箇所を勘定し直せる理由はここにあります。
この式を通常の整数代数の感覚で整理し、保存済みのHCにmと~m′を直接足す形にすると、ゼロの表現に関する条件が抜け落ちます。RFC 1624はこの形を式2として取り上げ、全体を再計算した結果と異なる例を示しています。文書の区分はInformationalで、差分計算の注意点を説明する資料です。
3語だけの例で、二つの結果を比べる
説明用に、対象の語を1234、0001、EDC9とします。これは計算だけを切り出した小さな例で、実際のIPv4ヘッダーを表してはいません。この3語の和はFFFEなので、反転した元のチェックサムは0001です。中央の語だけを0001から0002へ変えると、全体の和はFFFF、新しいチェックサムは0000になります。
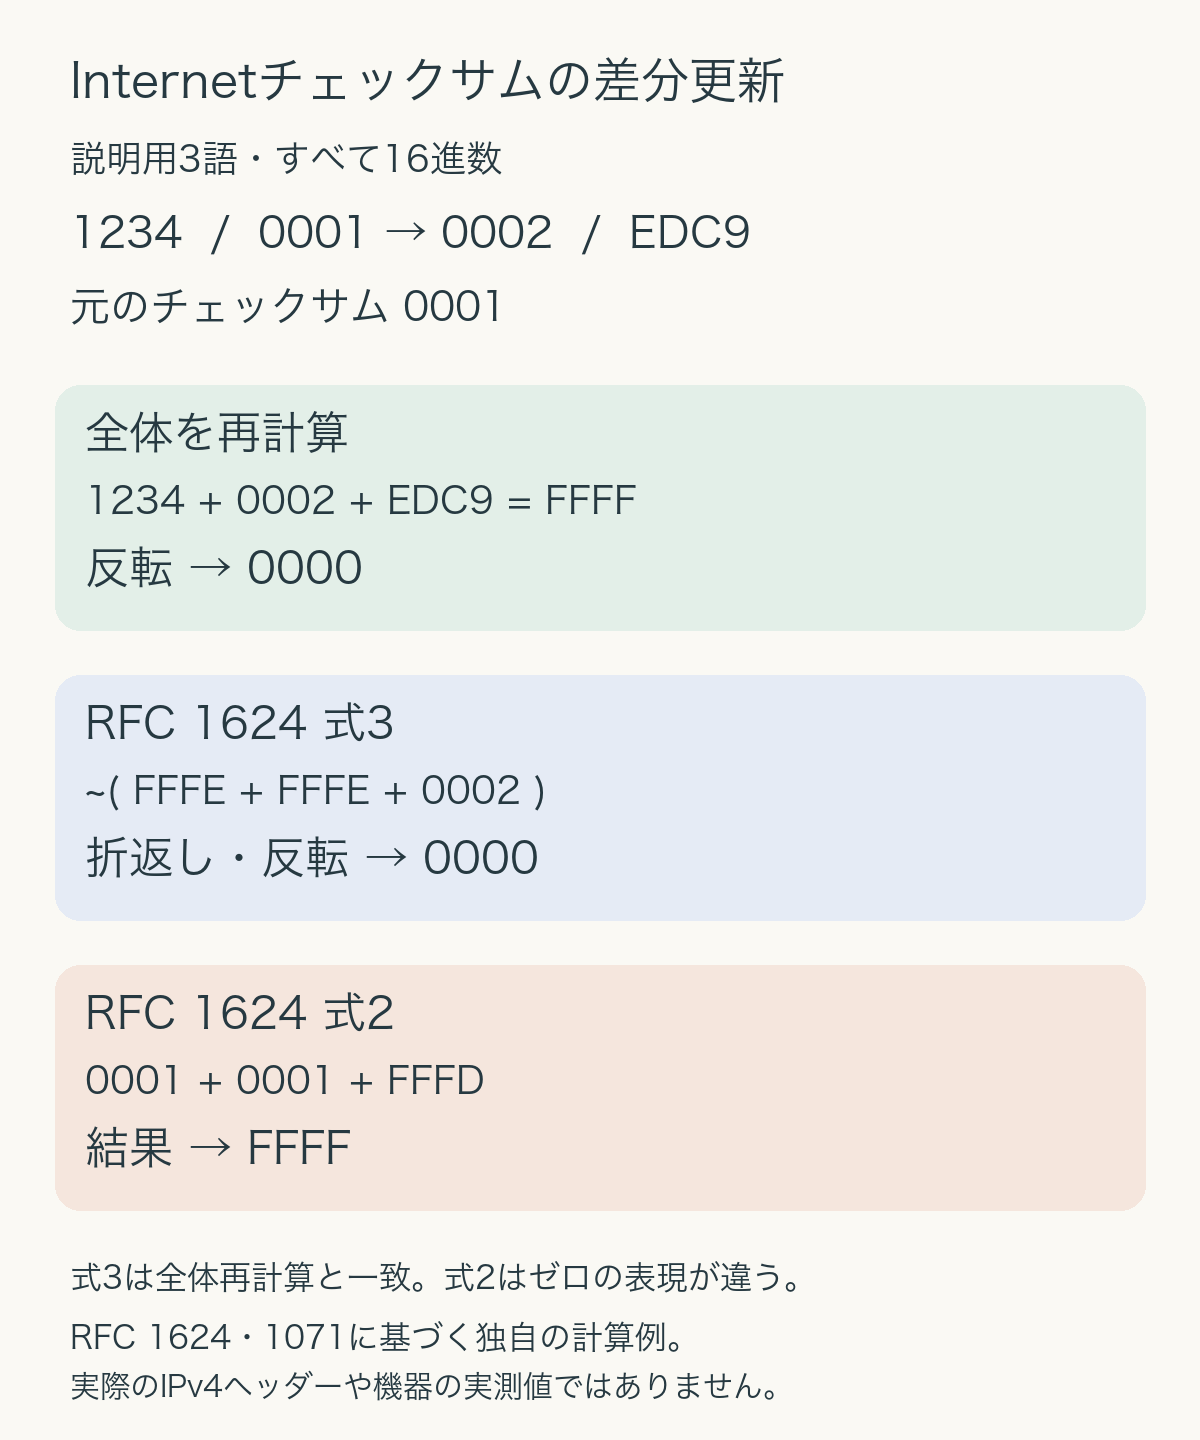
式3では、~HCがFFFE、~mがFFFE、新しいm′が0002です。足した1FFFEを折り返すとFFFF、最後に反転して0000になり、全体の再計算と一致します。一方、式2のHC + m + ~m′では、0001 + 0001 + FFFD = FFFFとなります。計算途中の丸め誤差ではなく、保存されるビット列が異なっています。
1の補数では、0000を正のゼロ、FFFFを負のゼロと呼びます。数学上のゼロとして似た役割を持っていても、通信で保存・比較する16ビット列は同じではありません。ゼロを一種類だと思って式を変形すると、この違いを落とすことがあります。
「検査に通る」と「再計算に一致する」を分ける
ここにはもう一つ、見逃しやすい点があります。RFC 1071の照合方法では、受信したチェックサム欄も含めて1の補数和を取り、FFFFになるかを見ます。今回の変更後の3語に0000を加えても、FFFFを加えても、その和はFFFFになります。したがって、差分更新の値が再計算と違うからといって、この照合方法で必ず不合格になるとは限りません。
別の実装がチェックサムを作り直し、受信した欄とビット単位で比較すれば、0000とFFFFの違いが現れます。RFC 1624は、この検査方法の違いも説明しています。「受信側の検査が通った」という観測だけで、更新結果が全体再計算と一致すると判断しないことが大切です。
更新の速さを調べる前に、比較する条件をそろえる
実装を確かめるなら、同じ変更後データから全体再計算した値を基準にし、差分更新の16ビット値と比べられます。今回のように和がFFFFになる境目、桁あふれが起きる入力、変更なしの入力を含めると、普通の値だけでは見えない違いを探せます。複数箇所を書き換える場合は、変更した語の取りこぼしがないかも確認します。
また、16ビット語へのバイトの組み方と、~を16ビット内の反転として扱うことをそろえる必要があります。大きな整数を扱える言語では、~だけを書いても16ビットの値になるとは限りません。元のチェックサムが正しいことを前提にする差分更新は、元データ全体の検証を自動的に代行するものでもありません。
差分更新は、読まずに済む部分を増やす方法です。ただし、実際にどれほど速くなるかは、データの長さや処理の構成に依存します。小さな計算例から機器の速度を推定するのではなく、まず同じ結果になる範囲を確かめ、その後で対象の実装を測る。この順序にすると、計算量を減らす工夫と、検査値の正しさを一緒に扱えます。
参考資料
- RFC 1624 — Computation of the Internet Checksum via Incremental Update(1994年5月、特に2〜5節)
- RFC 1071 — Computing the Internet Checksum(1988年9月、1〜3節。差分更新はRFC 1624と併読)
- RFC 791 — Internet Protocol(1981年9月、3.1節のヘッダーとチェックサム)