処理の平均が10ミリ秒なら、平均して1秒に100件を扱える。ところが、そこへ同じ頻度で仕事を送っても、毎回ほぼ同じ時間で終わる場合と、ときどき長い処理が混ざる場合では、順番を待つ時間が変わります。平均の速さだけでは、待ち行列の様子を決めきれないためです。
この違いを扱えるのがM/G/1待ち行列です。ここでは到着頻度と平均処理時間を固定し、処理時間のばらつきだけを変えます。実機の性能を予測する前に、何を測って比較すべきかを整理するための数理モデルです。
簡単にまとめると?
- M/G/1はランダムな到着と、さまざまな処理時間の分布を扱う1台の待ち行列です。先着順などの条件を置くと、平均待ちには処理時間の「二乗の平均」が効きます。
- 到着80件/秒、平均処理10ミリ秒なら、平均待ちは処理時間が一定のとき20ミリ秒、指数分布なら40ミリ秒。短い処理と長い処理を混ぜた今回の例では65ミリ秒になります。
- 長い処理は件数の割合以上にサーバーの時間を占めます。平均処理時間に加え、ばらつきや長い処理の割合を確認することが、待ちの原因を切り分ける手掛かりになります。
M/G/1のGは、処理時間の分布を限定しないという意味
M/G/1の最初のMは、到着をポアソン過程で表すことを示します。単位時間当たりの到着率をλとし、到着間隔は独立な指数分布に従います。Gはgeneralの頭文字で、処理時間を指数分布に限定しないという意味です。最後の1は処理担当が1台であることを表します。
ここでは到着順に、一つずつ、途中で割り込まずに処理する方式を考えます。個々の処理時間Sは同じ分布から独立に決まり、到着とも独立。待つ場所は十分にあり、途中離脱や受付拒否は起きないとします。M/G/1という略号だけで処理順まで決まるわけではないため、この前提が必要です。
平均処理時間をm=E[S]とすると、利用率はρ=λmです。以下ではρ<1の定常状態、つまり長く観察したときの統計的な状態を扱います。処理時間の二乗の平均も有限であることを前提にします。
平均待ちを決める「二乗の平均」
Pollaczek–Khinchine(ポラチェク–ヒンチン)の公式は、処理を始めるまでの平均待ち時間Wqを次のように表します。ここでE[ ]は平均を取る記号です。
Wq=λ E[S²] ÷ {2(1−ρ)}
E[S²]は、一件ずつの処理時間を二乗してから平均した値です。平均処理時間を二乗したm²とは異なります。関係はE[S²]=Var(S)+m²で、Var(S)は平均からの散らばりを表す分散です。
λとmを固定すると、利用率ρと分母は変わりません。その条件で分散が大きくなるほど、平均待ちは増えます。処理そのものも含む到着から完了までの平均時間はWq+mであり、二つを混ぜないことが大切です。
平均10ミリ秒、利用率80%で三つを比べる
到着率を80件/秒、平均処理時間を10ミリ秒にそろえます。利用率はすべて80%です。一つ目は毎回10ミリ秒で終わる一定時間の処理。二つ目は平均10ミリ秒の指数分布。三つ目は各仕事が独立に90%の確率で5ミリ秒、10%の確率で55ミリ秒になる処理です。
三つ目の平均は0.9×5+0.1×55=10ミリ秒ですが、二乗の平均は0.9×5²+0.1×55²=325ミリ秒²です。「10件に必ず1件長い」という規則的な並びではなく、それぞれの処理時間が独立に決まる例です。
| 処理時間の分布 | E[S²] | 平均待ち Wq | 処理を含む平均 |
|---|---|---|---|
| 毎回10 ms | 100 ms² | 20 ms | 30 ms |
| 平均10 msの指数分布 | 200 ms² | 40 ms | 50 ms |
| 90%が5 ms、10%が55 ms | 325 ms² | 65 ms | 75 ms |
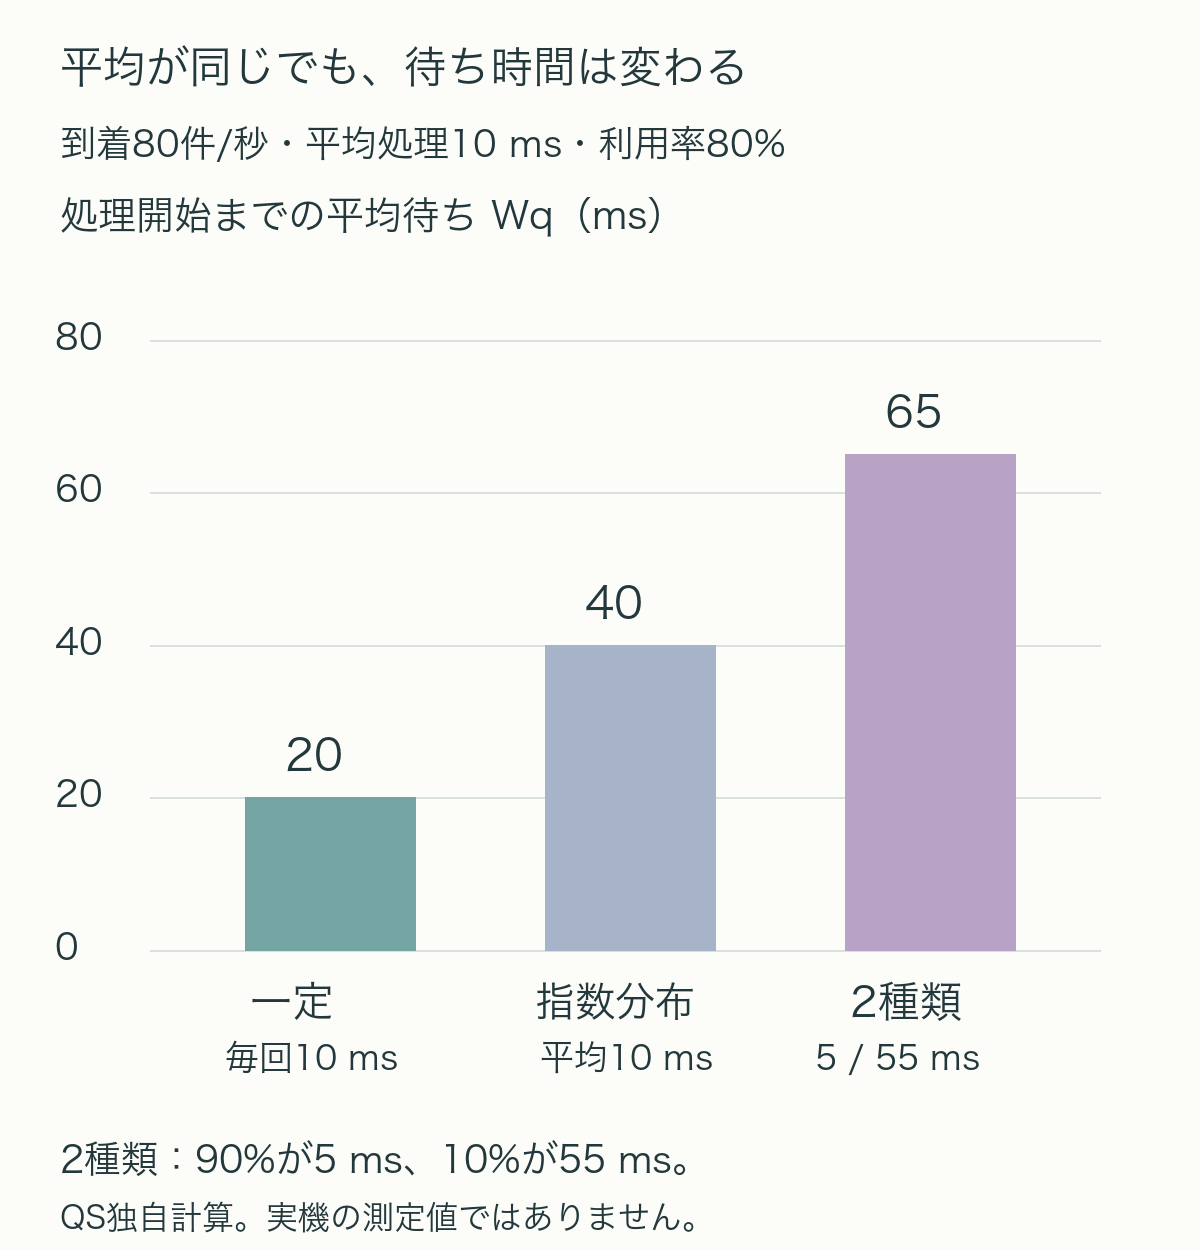
混合した例の待ちは一定時間の例の3.25倍です。処理担当を遅くしたわけでも、仕事の到着を増やしたわけでもありません。また、毎回10ミリ秒にそろえても平均待ちはゼロになりません。到着がランダムなので、短い間隔で仕事が続けて届くことがあるためです。
少ない長時間処理が、なぜ後ろの仕事に効くのか
処理中のサーバーをランダムな時刻に観察すると、長い処理の途中に当たりやすくなります。今回の混合例では55ミリ秒の仕事は件数の10%ですが、処理に使う時間の割合は0.1×55÷10=55%です。件数で少数でも、サーバーの忙しい時間の半分以上を占めます。
処理中であることを条件に、その仕事が終わるまでの残り時間を平均すると、E[S²]÷(2m)になります。混合例では16.25ミリ秒、一定10ミリ秒なら5ミリ秒です。単純に「平均処理時間の半分」とすると、長い仕事に出会いやすい効果を落としてしまいます。
新しい仕事の待ちには、この残り時間に加え、すでに前で順番を待つ仕事の処理も加わります。到着がポアソン過程で、現在の状態を先読みしないという条件の下では、到着時の観察と時間平均を結び付けられます。この仕組みが、公式に二乗の平均と混雑の係数1/(1−ρ)が現れる背景です。
性能を比較するときは、どの時間を測るかをそろえる
例えば同じ平均10ミリ秒の処理系を二つ比べるなら、受付から完了までの時間だけでなく、実際に処理担当を占有した時間を分けて集計します。その平均、二乗の平均、長い処理の頻度を見れば、「平均は同じだが長時間の処理が混ざる」という違いを捉えられます。
ただし、受付から完了までの応答時間をそのままSとして式へ入れると、すでに発生している待ちを処理時間として数えてしまいます。割り込み、並列処理、優先順位、複数段の待ちがある環境では、どこを1台の処理担当とみなすのかを先に定める必要があります。
また、長い処理を別系統へ移す判断には、その系統の容量や到着の変化も関わります。今回の式だけから最適な分割方法は決まりません。二乗の平均は少数の大きな値に影響されやすいため、短い測定で長い処理を取り逃がすと、待ちを小さく見積もることもあります。
分散の効果と、モデルの限界を分ける
この比較が示すのは、同じポアソン到着、同じ平均処理時間、同じ先着順の1台という条件で、処理時間の分散が平均待ちを変えることです。到着が集中する、処理時間同士が相関する、有限の待機場所で仕事を捨てる、といった条件では、そのままの計算にはなりません。
平均待ち20ミリ秒という結果も、どの仕事も20ミリ秒以内に処理を始められるという保証ではありません。最大値や99パーセンタイルには、別の分布の評価が必要です。平均の速さを比較した後に、処理時間の散らばりと測定条件を確かめる。その一段が、同じ利用率なのに待ちが違う理由を見つける助けになります。
出典
- Eytan Modiano/MIT 6.263J(2002年秋)Lectures 8 & 9: M/G/1 Queues:前提、P-K公式、M/M/1・M/D/1の比較、残余処理時間からの導出。
- Stanford EE384X Handout 10: Packet Switch Architectures I:19〜21ページのM/GI/1、仕事量の図、処理時間一定の場合の帰結。版の日付は未確認。