量子コンピューターの誤りを直すには、量子ビットだけでなく、測定結果から誤りを推定する古典回路も必要です。その回路が「次にどの部分を計算するか」を細かく選ぶほど、誤りを見つけやすくなる一方、順番を管理する回路が大きくなることがあります。
2026年11月3日に公開されたプレプリントは、量子LDPC符号の復号器で、この順番の管理を簡略化しました。学習済みの優先度を少数の段階に分け、段階ごとの待ち行列へ入れる方法です。回路設計を合成した比較では、細かな優先度を扱う方式より使用資源が減りました。ただし、完成したFPGAや製造済みチップの動作実証ではありません。[1]
簡単にまとめると?
- BRL-Sは、更新順を決める学習済みスコアを2・4・8段階へ丸め、優先度ごとの待ち行列で扱う復号方式です。
- 一つの量子LDPC符号を対象とした合成結果では、従来の学習型逐次方式に対しFPGAのLUT数を約68〜72%減らしました。
- 段階数を減らすほど小型化できるとは限りません。誤り訂正の性能、回路資源、推定電力、復号全体の時間を分けて比較する必要があります。
誤りの候補を、どの順番で更新するか
LDPCは「低密度パリティ検査」の略です。多数の量子ビットに情報を分散し、それぞれ限られた量子ビットに関わる検査結果から、どこで誤りが起きたかを推定します。今回の対象はBB(bivariate bicycle)と呼ばれる量子LDPC符号の一つで、288個の物理量子ビットに12個の論理量子ビットを符号化する、符号距離18の構成です。[1]
復号器へ入るシンドロームは、誤りそのものの一覧ではなく、検査で得られた手掛かりです。BP(信念伝播)では、誤りの候補を表す変数ノードと、検査を表すノードの間で情報をやり取りし、推定を更新します。標準的な一斉更新方式は規則的な回路を作りやすい一方、量子LDPC符号の短いループなどによって推定がうまく収束しない場合があります。[1]
そこで研究チームが比較対象にしたRL-Sは、学習済みのQテーブルを使い、変数ノードを一つずつ選んで更新します。現在残っているシンドロームの局所的な状態に応じてスコアを参照し、まだ更新していないノードのうち高いものを選びます。「学習型」といっても、今回の復号回路が動作中に大きな学習モデルを訓練する仕組みではありません。[1]
細かな順位を、少数の待ち行列に置き換える
RL-Sは、最大の優先度を取り出しやすい最大ヒープというデータ構造を使います。推定が変われば近隣のノードの優先度も更新されるため、比較と並べ直しの処理が必要です。今回の回路では16ビットのQランクテーブルと、最大288ノードを管理するヒープが使われています。[1]
これに対しBRL-S(バケット方式の強化学習型信念伝播)は、スコアをあらかじめ少数の優先度へ量子化します。ここでいう量子化は、連続的・細かな値を段階に丸める情報処理上の意味で、量子ビットへ変換する操作ではありません。2段階なら1ビット、4段階なら2ビット、8段階なら3ビットで優先度を表せます。[1]
各段階にはFIFO、つまり先に入れたものを先に取り出す待ち行列を設けます。空でない最上位の列から先頭のノードを選び、その優先度が変わった場合は該当する列へ移します。同じ列の中では細かなスコアの順を区別しないため、その精密さと引き換えにヒープの並べ直しを省けます。[1]
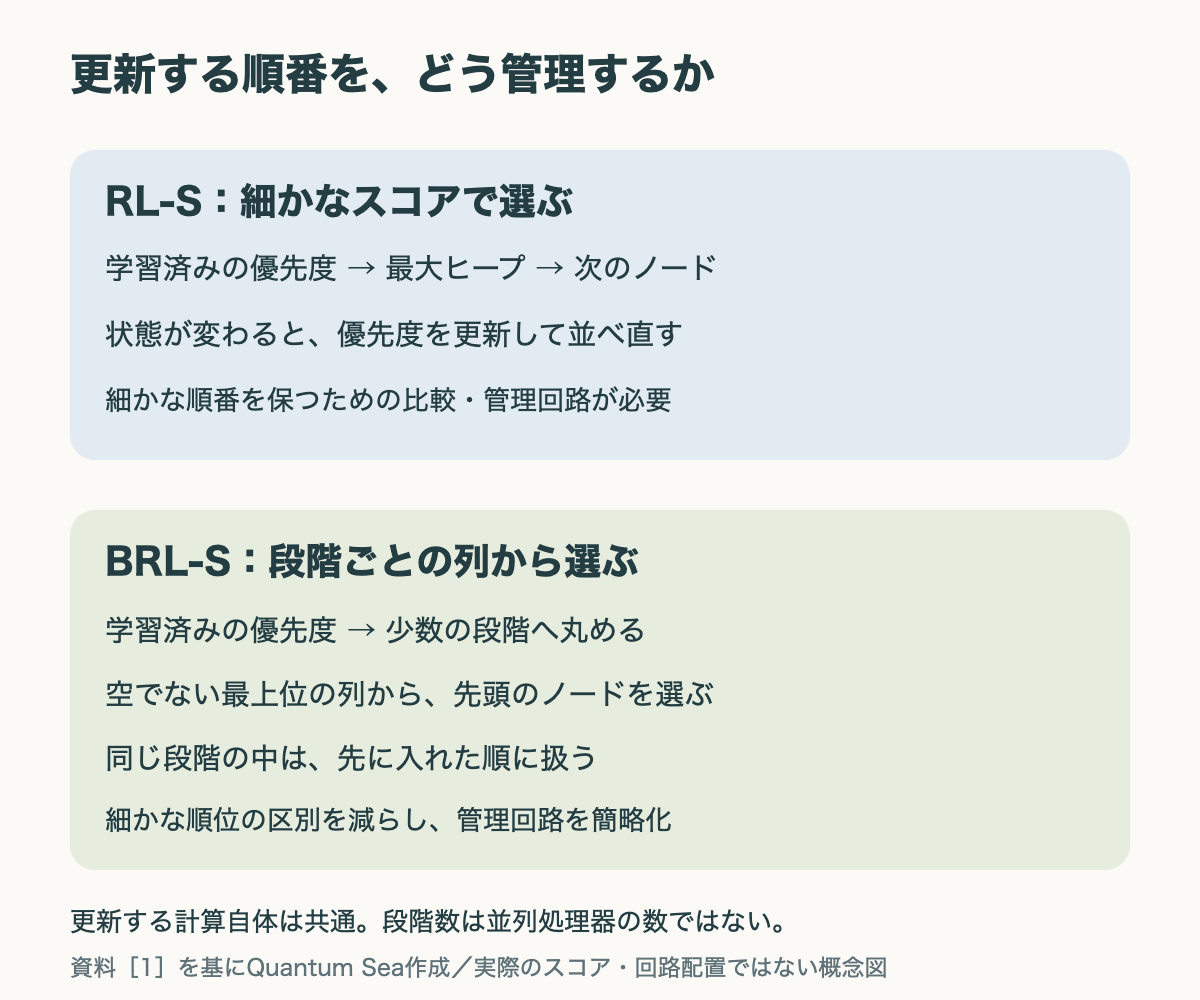
例えば説明用に、近い二つのスコアが同じ段階へ入る場面を考えると、BRL-Sではスコアのわずかな差より列に入った順番が優先されます。段階数を増やせば区別は細かくなりますが、列や優先度を管理する資源も必要になります。論文の2・4・8段階は、並列に計算する処理器の数ではなく、この優先度の分解能です。逐次的なメッセージ更新の計算自体はRL-Sと共通です。[1]
合成結果で減った資源と、残った性能差
研究では、五つの回路をVerilog RTLという回路記述で設計し、FPGA用の合成と45 nmの標準セルを使うASIC合成で評価しました。LUTはFPGA上で論理処理を実現する要素の数で、ASICのセル面積は別の製造技術を前提とした指標です。表の電力も同じ動作条件での推定値であり、実機の消費電力測定ではありません。[1]
| 方式 | FPGAのLUT数 | ASICセル面積 | ASIC推定電力 |
|---|---|---|---|
| 一斉更新BP | 100,267 | 1.0710 mm² | 15.243 mW |
| RL-S | 69,737 | 0.4564 mm² | 3.766 mW |
| BRL-S・2段階 | 19,873 | 0.1485 mm² | 1.175 mW |
| BRL-S・4段階 | 22,078 | 0.1591 mm² | 1.266 mW |
| BRL-S・8段階 | 20,505 | 0.1712 mm² | 1.366 mW |
RL-Sを基準にすると、三つのBRL-SはLUT数を68.3〜71.5%、ASICセル面積を62.5〜67.5%、推定電力を63.7〜68.8%削減しました。比較の要点は、更新計算の枠組みを共有するRL-SとBRL-Sの差です。一斉更新BPとの違いには、並列性や回路構成の差も含まれます。[1]
今回もっともLUT数が少ないのは2段階ですが、4段階より8段階のほうが少なくなっています。段階数だけから最終的な回路資源が単調に増えると決めることはできません。ASIC面積も含め、合成後の実際の数値を確認する必要があります。
誤り訂正の比較は、X・Y・Zのパウリ誤りを等しい確率で発生させる脱分極チャネルを用いたものです。最大100反復で、逐次方式の1反復は最大288ノードを一巡する更新に相当します。調べた誤り確率の範囲では、4・8段階のブロック誤り率はRL-Sに近い一方、2段階は、とくに低い誤り確率側で性能が悪化しました。回路が小さい方式と、訂正性能をよく保つ方式は同じではありません。[1]
量子計算機につなぐ前に必要な検証
今回示されたのは、特定の符号と誤りモデルに対する復号性能、および合成段階の回路比較です。論文はFPGAの数値を「完成した実装」ではなく合成後の資源見積もりと明記しています。ASICのクロック周期も50 nsの制約に対する余裕時間から推定したもので、復号一回がその周期だけで終わることを意味しません。[1]
実用上は、測定結果の入力から訂正判断まで何サイクルかかるか、繰返し入力に追いつけるか、測定誤りや回路内の相関した誤りでも性能を保てるかを確認する必要があります。今回の結果から、別の符号や実機のすべての雑音へ同じ削減率を広げることもできません。
この研究が示す設計の選択肢は、学習した順番をできるだけ細かく再現することだけではなく、訂正性能を保てる範囲で順位を粗くして回路を軽くすることです。2段階の小ささと4・8段階の訂正性能を並べることで、復号器に割ける面積・電力と、必要な信頼性を結びつけて判断できます。
出典
- Moradi et al., Hardware-Efficient Reinforcement-Learned Scheduling for Quantum LDPC Decoders, arXiv:2611.04179v1(2026年11月3日)。本文II・III節、図1・2、表II・III。