タグ: Microsoft

  • MicrosoftとNexthop AIが示すSONiC BMC、液冷漏れの監視と停止

    MicrosoftとNexthop AIが示すSONiC BMC、液冷漏れの監視と停止

    液冷のネットワークスイッチでは、冷却液を流す仕組みに加えて、漏れたときに誰が気づき、どこを止めるかも設計する必要があります。通信を制御する主CPUを停止したあとも、監視や遠隔操作の経路を残せるかが大切になります。

    2026年8月のOCP APAC SummitでGuohan Lu氏(Microsoft)とRyan Torres氏(Nexthop AI)が紹介したのは、機器の状態監視と遠隔管理を担うBMC(Baseboard Management Controller)でSONiCを動かす構成です。液漏れの程度や検知した場所に応じて、通知、主系の電源停止、ラック側との連携を分けています。[1]

    簡単にまとめると?

    • SONiC BMCは主CPUと監視・管理を分け、主系を止めた後も液漏れへの対応経路を残す設計です。
    • 漏れの重大度や場所に応じて、通知、主系の停止、ラック側や担当者との連携を使い分けます。
    • 発表は対応構成と展開計画を示すもので、停止のしきい値や全機種への対応、無停止運用を保証していません。

    主CPUを止めても、監視する側を残す

    BMCは、主CPUとは別の管理用プロセッサーです。資料では、主CPUの動作状態によらずBMCを動かし、液漏れセンサーを監視する設計が示されています。ここでいう常時監視は、主系と監視系の動作を分ける考え方であり、機器への給電が失われても動き続けるという意味ではありません。[1]

    スイッチ側の要件には、BMCから主系の電源を入れ直せること、BMC自身の再起動が主CPU側へ影響しないこと、管理ポートをBMCへ接続することが挙げられています。BMCと主CPUの間には、USBを使ったEthernetの管理通信経路を設けます。通信を転送する回路と、それを外側から管理する回路を分ける構成です。[1]

    軽微な漏れと重大な漏れで、対応を分ける

    漏れを検知したら、すべて同じ動作にするわけではありません。資料は、異なる重大度のセンサーを複数備えることに加え、センサー自身が正常かを確認すること、検知後の対応方針を決めることを要件にしています。[1]

    スイッチ内の軽微な漏れの例では、BMCがSyslogというログ通知を送り、担当者が機器を点検します。この図には、主系の自動停止は示されていません。一方、重大な漏れの例では、通知とともにスイッチの主系を電源停止し、担当者が隔離と点検に向かう流れです。[1]

    重大な漏れの図には、リンク切断を検知したあとに通信を別経路へ移す動作も描かれています。ただし、これは発表が示す対応の構成例です。通信の切り替え時間や、切り替え先の容量、無停止で運用できることを実証した数値は示されていません。[1]

    ラック側の異常も、同じ管理経路へつなぐ

    漏れがスイッチ内ではなく、ラック側で見つかる場合もあります。資料の構成では、ラック全体を管理するラックマネージャーとBMCが、機器管理用の標準インターフェースRedfishで連携します。ラック側の異常を、スイッチを止める判断へつなげるためです。[1]

    ラック側の液漏れの例では、ラックマネージャーからBMCへ通知と停止要求が送られます。BMCは、運用操作を伝えるgNOIを使って主系へ正常な終了処理を求め、代替手段として主系の電源停止も備えます。同時に担当者へ知らせ、ラックの隔離と点検につなげます。[1]

    図1では、左側のラックマネージャーから中央のBMCへ、漏れの通知と停止要求が送られています。BMCから右側の主CPUへ向かう赤い経路は、gNOIによる正常な終了処理と、代替手段としての電源停止です。下部には担当者によるラックの隔離・点検と、リンク切断後の通信切り替えも並んでいます。機器の停止だけで完結せず、人とネットワーク側の対応までつなぐ構成です。
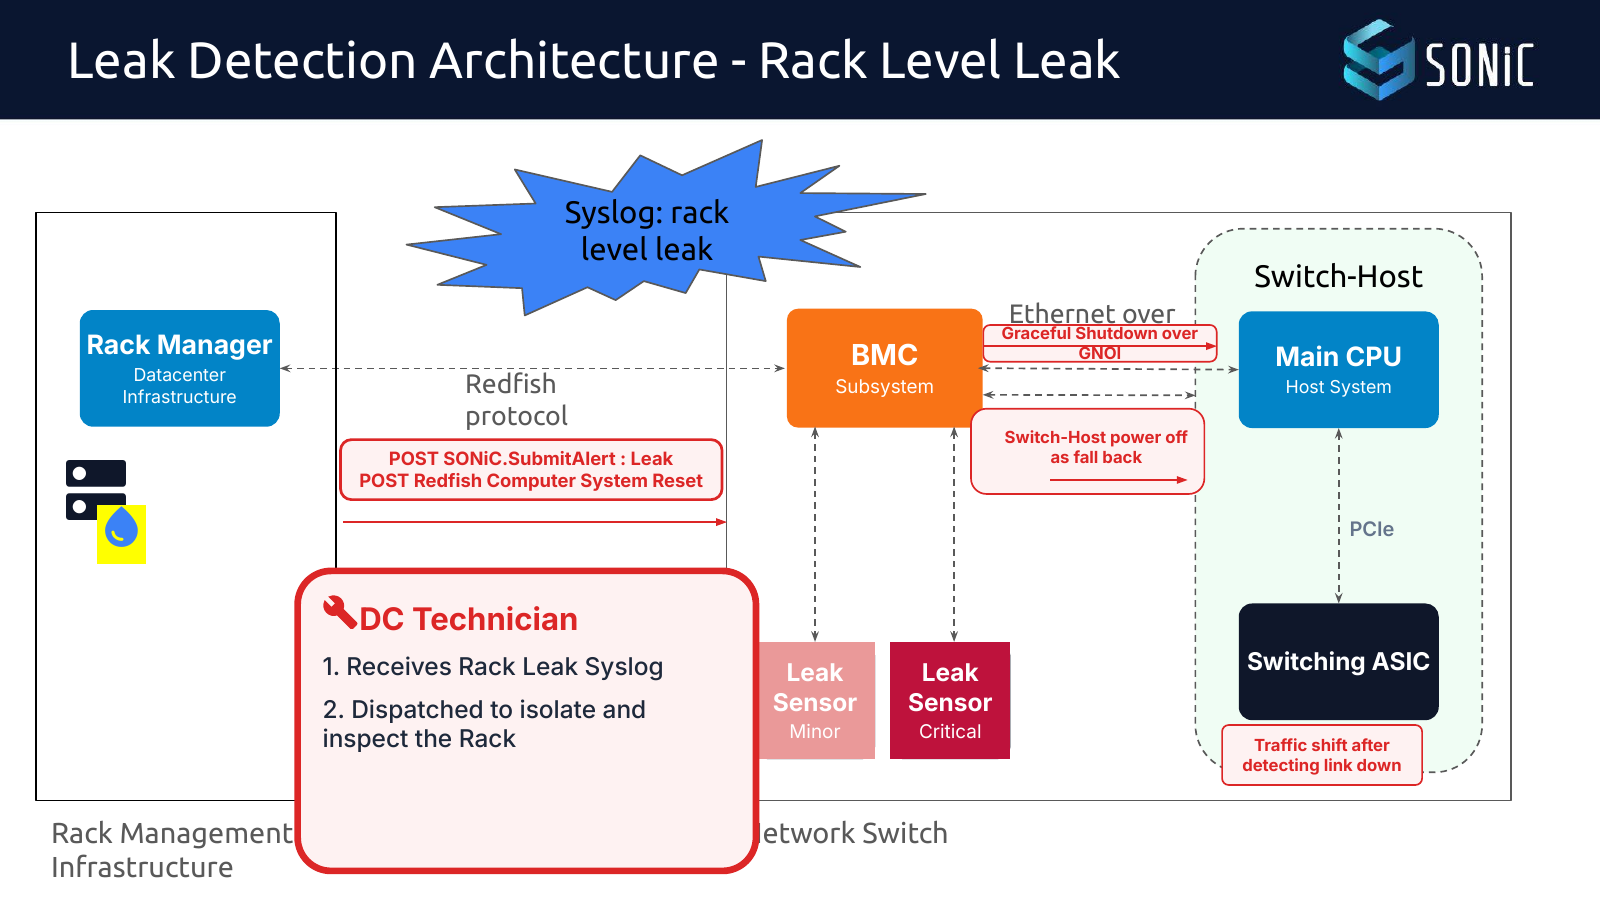
    ラックマネージャーがRedfishでBMCへ漏れを通知し停止を要求する構成図。BMCは主CPUへgNOIによる終了処理を求め、代替として主系の電源を切る。Syslog通知を受けた担当者のラック隔離・点検と、リンク切断後の通信切り替えも示す。具体的なしきい値・待ち時間は記載されていない。
    図1 ラック側の漏れを検知したあとの通知と停止経路(原図引用)
    Guohan Lu(Microsoft)、Ryan Torres(Nexthop AI)「SONiC BMC for Liquid-Cooled Switches」、2026年8月、p.20。講演資料[1]。
    図は横にスクロールできます。図の画像を開く

    この設計でそろえようとしているのは、センサーの検知から、人への通知、機器の停止までの受け渡しです。軽微と重大を分ける具体的なしきい値や、終了処理をどれだけ待つかは、今回のスライドには示されていません。図の流れと、個々の設備で決める運用条件を分けて読む必要があります。

    BMCでもSONiCを使う理由

    SONiCはネットワークスイッチ向けのOSです。BMC側でも同じソフトウェア基盤を使う狙いは、コンテナの管理、ソフトウェア更新、脆弱性への対応といった運用方法をそろえることにあります。ただし、主系とまったく同じ機能をBMCへ載せるわけではありません。[1]

    BMC側では、データベースや監視情報を扱う機能の一部を動かし、パケット転送用ASICを制御するsyncdやswssは動かしません。機器を監視するpmonコンテナには、液漏れやラックマネージャーの指示に応じて電源を制御するbmcctldを追加し、Redfish用のコンテナも設けます。BMCが引き受けるのは、通信を転送する主系を管理する役割です。[1]

    初期対応と、これからの機種展開を分ける

    資料が示すBMCのハードウェア要件は、ARM64、4GBのDDR5メモリー、8GB以上のeMMCストレージ、セキュアブートなどです。ソフトウェアの使用量としては、イメージ750MB、ディスク1.5GB、メモリー1GB未満が記載されています。後者は紹介された構成の使用量であり、搭載メモリーの要件を1GB未満へ置き換えるものではありません。[1]

    初期実装の範囲も具体的です。ロードマップの「202605」には、BMC向けチップであるAST2720のA1/A2対応と、sonic-aspeed-arm64.binという専用イメージ、Redfishが挙げられています。一方、空冷・液冷の最初のプラットフォーム対応は「202611」の項目です。これは2026年8月の発表時点の計画で、あらゆるBMCや液冷スイッチがすでに対応しているという説明ではありません。[1]

    液冷を運用へ入れるには、冷やす能力とともに、異常を見つけたあとに動く仕組みが必要です。SONiC BMCの取り組みは、主系から分けた監視と管理を土台に、漏れの重大度や場所に応じた対応を組み立てるものです。対応機種と運用条件を確かめながら、設備側とネットワーク側の管理をつなぐ設計として見ることができます。

    共同発表者が所属するMicrosoftの事業全体は、cyclewaveの企業解説にまとめています。

    BMC向け半導体を手がけるASPEEDの事業は、cyclewaveの企業解説で紹介しています。

    参考資料

    [1]Guohan Lu(Microsoft)、Ryan Torres(Nexthop AI)「SONiC BMC for Liquid-Cooled Switches」。2026年8月の公開スライド、全25ページ。7–14ページ:BMCの要件とSONiCの構成、15–20ページ:軽微・重大・ラック側の液漏れへの対応例、21–22ページ:使用量とロードマップ。本文は公開スライドに基づき、録画は未視聴です。

    [2]Open Compute Project「2026 OCP APAC Summit」。開催日、登壇者、公式公開資料の一覧。
  • MicrosoftのMaia・Cobalt・Boost DPU、AI処理を支える三つの役割

    MicrosoftのMaia・Cobalt・Boost DPU、AI処理を支える三つの役割

    たとえば、AIが必要なデータを探し、外部の処理を呼び出し、その結果を使って答えを作るとします。モデルの推論を速くするだけでなく、データを取り出す処理や、次の仕事へ進める処理にも時間がかかります。AI基盤を考えるときは、どの計算器が速いかと一緒に、どの仕事をどこへ任せるかを見る必要があります。

    2026 OCP APAC Summitの公式一覧に掲載されたMicrosoftの資料は、半導体からサーバー、ネットワーク、データセンターまでを一緒に設計する考え方を示しています。その中から、推論向けのMaia 200、CPUのCobalt 200、データ処理向けのBoost DPUという、役割の異なる三つに注目します。[1・2]

    簡単にまとめると?

    • Microsoftは、推論・CPU処理・データ入出力を、役割の異なる半導体へ分担する設計を示しています。
    • Boost DPUは、ストレージやネットワークの基盤処理をホストCPUから引き受けます。
    • 三つの性能指標は対象が異なり、改善率を組み合わせてサービス全体の高速化とは評価できません。

    AIの処理が変わると、待ち時間の場所も変わる

    資料は「ボトルネックは移り続ける」という見出しで、モデルの規模、計算能力、メモリー、ストレージを並べています。モデルを動かすには演算だけでなく、必要なデータを保持し、読み書きする能力も要るからです。グラフは異なる指標の伸びを2019年基準で示したもので、線同士の差を、そのまま実際の処理時間の差として読むことはできません。[1]

    さらに資料は、AIエージェントの処理を背景に、CPUとGPUの役割へ目を向けています。たとえば、複数の処理を進める順番や結果の受け渡しを整える時間が長ければ、推論部分だけを速くしても、全体の待ち時間は同じ割合では短くなりません。どこが処理の進行を妨げているかによって、強化したい部分も変わります。

    Maia、Cobalt、Boost DPUで見る三つの役割

    Microsoftは、対象となる処理に応じて自社の半導体を紹介しています。資料と同社の補足記事に沿うと、役割は次のように整理できます。これは製品群の役割分担であり、三つを同じサーバーへ搭載する配線図ではありません。[1・3]

    半導体資料で示す主な対象注目する点
    Maia 200AIモデルの推論処理するモデルとチップを合わせて設計し、費用や電力あたりの推論処理を考える
    Cobalt 200クラウド向けのCPU処理、AIエージェントに関わる処理複数の仕事の並行処理と進行管理、呼び出しの待ち時間を考える
    Boost DPUストレージやネットワークの基盤処理ホストCPUから専用の半導体へ処理を移す

    Maia 200は、推論を担うアクセラレーターとして位置づけられています。資料が挙げるのは、チップとモデルの協調設計です。チップ単体の演算能力だけで評価を終えず、動かすモデルと組み合わせて、電力や費用に対してどれだけ推論を進められるかを見ます。[1]

    Cobalt 200はCPUです。補足記事では、並行処理や、複数の処理の進行をまとめるオーケストレーションに向けた設計と説明されています。モデルの推論を担う部分と、仕事を進めるCPU側の処理を分けて考えると、AI基盤に求める性能を捉えやすくなります。[1・3]

    Boost DPUは、CPUが担っていた基盤処理を引き受ける

    DPU(Data Processing Unit)は、ここではデータの入出力に関わる処理を受け持つ専用プロセッサーです。MicrosoftはBoost DPUについて、ストレージやネットワークの基盤処理をホストCPUから移す、オフロードの役割を説明しています。OCP資料でも、クラウドのストレージ処理が主な対象として挙がっています。[1・3]

    この役割は、アプリケーションの計算を速くすることとは分けて考えられます。たとえば、CPUがアプリケーションとデータ入出力の両方を担っているなら、入出力側の仕事を別の処理器へ移すことで、CPUに任せる仕事の範囲が変わります。ここでいうI/Oは、データの入力と出力のことです。効果を見る際には、移した処理の速さだけでなく、CPU側と合わせた待ち時間や消費電力を確認します。

    違う性能指標を、一つの倍率にまとめない

    資料に出てくる性能指標も、三つで異なります。Maia 200では費用・電力あたりの推論性能、Cobalt 200ではエージェント呼び出しの遅延や一定時間に処理できる量、Boost DPUではストレージ処理の性能と電力です。対象の仕事が違うため、それぞれの改善率を足したり掛けたりして、AIサービス全体の高速化を求めることはできません。[1]

    掲載スライドだけでは、比較した構成や測定条件の詳細までは分かりません。この記事では改善率を一般的な性能値として使わず、何を測る指標なのかに注目しています。推論の処理量、呼び出しの待ち時間、入出力の負荷を分けて見ることで、必要な改善を選びやすくなります。

    処理の分担を、サーバーと施設の設計へつなぐ

    資料の全体図では、半導体、プラットフォーム、ネットワーク、データセンターの協調設計を重ね、その周囲にセキュリティと持続可能性を置いています。処理を専用化する方針を、部品一つの効率で終わらせず、組み合わせたシステムとして考える構成です。電力や冷却も同じ資料で扱われています。[1]

    AI基盤を選ぶときは、「最も速いチップはどれか」に加え、「推論、CPU処理、データ入出力のどこに時間を使っているか」を確かめる。Maia、Cobalt、Boost DPUの役割を並べると、専用の半導体を作る意味が、仕事の分担として見えてきます。その分担をソフトウェアやサーバー構成までつなげることが、今回の資料を読む一つの軸になります。

    Microsoftの事業を知る

    Azureを含むMicrosoft全体の事業は、cyclewaveの企業解説にまとめています。

    参考資料

    公式一覧から公開された18ページのPDFと、Microsoftの補足記事をもとに構成しました。PDFの作成日は2026年9月8日です。開催当日の版との同一性は未確認のため、公開資料に示された設計として紹介しています。

    [1]Gohar Waqar、Sushant Gupta(Microsoft)「From Silicon to Systems: Driving Innovation for Azure Compute & AI」。8ページ:処理の制約、10–14ページ:全体設計と各半導体の役割・評価指標、15–18ページ:セキュリティ、電力・冷却、ネットワーク、協調設計。

    [2]Open Compute Project「2026 OCP APAC Summit」。講演と公開資料の公式案内。

    [3]Microsoft「From Silicon to Systems: Bending the Cost and Complexity Curves of AI」(2026年8月)。Cobaltの並行処理・オーケストレーションと、Boost DPUへの基盤処理のオフロードを補足。

  • MicrosoftとBroadcomが示すSONiCの混雑対策、経路制御と早い通知を組み合わせる

    MicrosoftとBroadcomが示すSONiCの混雑対策、経路制御と早い通知を組み合わせる

    GPUの計算が速くても、通信の一部が遅れると、AIの処理全体を終えるまでの時間が延びます。大きなデータが短時間に集中する場面では、回線の速さに加えて、どの経路を通り、混雑をどれほど早く知れるかが大切になります。

    2026年8月のOCP APAC SummitでMicrosoftとBroadcomが紹介したのは、ネットワークスイッチを動かすソフトウェアSONiCを、AI向けの大規模な通信基盤へ対応させる取り組みです。経路情報を扱うBGPの拡張から、送信元が経路を指定するSRv6、混雑を早く伝えるパケットトリミング、細かな統計収集までをつなげて見ていきます。[1・2]

    簡単にまとめると?

    • SONiCでは、AI通信に合わせて経路制御、混雑の通知、細かな観測を組み合わせます。
    • パケットトリミングは混雑時のパケットを短くし、再送と送信速度の調整へつなげます。
    • 発表された機能が使えるかは、ASICやNIC、ソフトウェアの実装によって異なります。

    少数の大きな通信が、同じ経路へ重なる

    発表が対象とするAIの学習通信には、少数の大きなフロー、短時間に通信が集中するバースト、遅い側の通信時間であるテールレイテンシーへの敏感さという特徴があります。経路の振り分けに使える通信の違いも少なく、大きなフローが同じリンクへ重なると、混雑しやすくなります。[2]

    等しいコストの経路へ通信を振り分けるECMPでも、このような条件では負荷がうまく分散しないと説明されています。経路が複数あることと、実際の通信が均等に流れることは別の問題です。資料の課題設定は、こうしたAI通信の性質を前提にしています。[2]

    接続が増えれば、BGPにも処理能力が要る

    資料では、1ポートあたり100Gbps、スイッチ全体で51.2Tbpsの構成を、複数のネットワーク面へ分けて導入したとしています。接続先が増えると、経路情報を交換するBGPの接続数も増えます。多数のポートを備えるハードウェアを用意すると同時に、それを制御するソフトウェアも拡張する必要があります。[2]

    そこで示されたのが、経路制御ソフトウェアFRRを10.0.1へ更新し、約20件のパッチを加えるSONiCの改善です。512のBGPセッション、約1,000の経路、次の転送先である512のネクストホップを扱う構成が紹介されています。単一ポートの切断・復帰に関する発表結果は、データ転送の停止が0.1秒未満、経路情報の収束が約5秒です。異なる二つの時間を、同じ「復旧時間」としてまとめないことが大切です。[2]

    SRv6で、送信元から通る経路を指定する

    通信の経路選択には、IPv6を使うセグメントルーティングのSRv6が挙げられています。資料の構成では、送信元のネットワークインターフェースカード(NIC)が、経路を表す短い識別子uSIDの列をパケットへ入れます。途中のスイッチが順に処理し、宛先のNICが受け取る仕組みです。[2]

    これにより、送信元が指定した経路をたどらせます。資料では、識別子の列が合わない場合はパケットを破棄する、厳密なソースルーティングを説明しています。経路を指定する仕組みそのものが混雑を自動で解決するわけではなく、どの経路を選ぶかと、途中で起きた混雑へどう応えるかを組み合わせる設計です。[2]

    パケットを短くして、混雑の知らせを先へ送る

    パケットトリミングは、混雑時に対象のパケットを短くし、宛先へ送る仕組みです。受信側のNICは、正常に受け取れなかったことを伝えるNACKを送信元へ返します。送信元は、その知らせを受けてパケットを再送し、送る速度を落とします。大きなデータを運び続ける代わりに、小さくしたパケットを早い通知につなげます。[2]

    資料の図では、通信の種類やヘッダー、サイズでトリミングの対象を選び、通常のデータ用とは別に、優先度の高い待ち行列と専用バッファーへ入れています。多数の送信元から一か所へ通信が集中するインキャストに対応するため、短くしたパケットをためる領域の容量も検討項目です。[2]

    発表では、優先度ごとに通信を一時停止するPFCや、パケットに混雑を知らせる印を付けるECNだけでは、このバースト性の高い通信に十分すばやく対応しにくいと説明しています。特にPFCの停止が周囲へ広がると、処理完了までの時間が延びる点を挙げています。PFCやECNがあらゆるネットワークで使えないという意味ではなく、ここで想定する通信に、より早いフィードバックを求める議論です。[2]

    ミリ秒単位の観測を、運用のデータへつなぐ

    短い混雑を調べるには、観測の間隔も細かくする必要があります。そこで紹介された高頻度ストリーミングテレメトリー(HFST)は、スイッチの統計をミリ秒単位で収集するための仕組みです。ASICがIPFIX形式で計測情報を送り、SONiC側のCounter Syncdが受け取って読み解きます。[2]

    受信した情報は、登録済みのIPFIXテンプレートに従って解析します。対応するテンプレートがなければ、そのメッセージは破棄されます。得られたカウンターは手元のデータベースへ保存でき、OpenTelemetry形式へ変換して収集・処理の仕組みへ渡すこともできます。細かく測るだけでなく、正しく解釈して保存するところまでを一つの経路として考えています。[2]

    実装の報告と、次に取り組む範囲を分けて読む

    発表は、BGPの拡張結果と、SRv6・トリミング・テレメトリーの設計を並べて紹介しています。設計資料へのリンクもありますが、これだけで、すべてのSONiC製品や導入先に同じ機能がそろっているとは判断できません。利用するASICやNIC、ソフトウェアの実装を合わせて見る必要があります。[2]

    今後の取り組みとしては、アクセラレーター同士を密に結ぶスケールアップ向けEthernetも挙げられています。今回の大規模なスケールアウト網を支える改善と、その先の検討範囲は分けて捉えたいところです。経路を制御し、混雑を早く伝え、その状態を細かく観測する。SONiCの役割は、この三つをハードウェアと運用の間でつなぐことにあります。[2]

    MicrosoftとBroadcomについて

    発表に登壇したMicrosoftとBroadcomの事業全体は、cyclewaveの企業解説で紹介しています。

    参考資料

    2026年8月の発表資料をもとに構成。性能値と課題は、資料で示された構成・通信条件に関する説明です。

    1. Open Compute Project「2026 OCP APAC Summit」 — 公式イベント・発表資料一覧。
    2. Microsoft・Broadcom「How SONiC Powers the World’s Largest AI Infrastructure」 — Guohan Lu、Mehak Mahajan。pp.4〜11:AI通信、BGP、SRv6、パケットトリミング、HFST。pp.12〜14:設計資料と今後の取り組み。
  • MicrosoftのDiablo 400検証案、800V高電圧直流の負荷変動と給電切り替えを確かめる

    MicrosoftのDiablo 400検証案、800V高電圧直流の負荷変動と給電切り替えを確かめる

    AIラックの電源は、負荷が短時間で変わるときにも、交流入力が失われるときにも、必要な電力を届け続けることが求められます。複数の電源装置や蓄電装置を組み合わせるほど、装置同士が切り替わる瞬間や、故障から復帰する順序までが大切になります。

    2026年8月のOCP APAC SummitでMicrosoftが示したのは、高電圧直流(HVDC)を使うDiablo 400のシステム検証です。個々の部品から一つのラック、さらに複数ラックへと範囲を広げ、負荷変動・電源喪失・保護動作を確かめる考え方が紹介されています。[1・2]

    簡単にまとめると?

    • Microsoftは800V級の給電を、部品、単一ラック、複数ラックの順に検証する考え方を示しました。
    • 負荷変動だけでなく、給電の切り替え、故障時の停止と復帰までが検証対象です。
    • 検証の「100%」は試験範囲の目標であり、故障しない確率や達成済みの結果ではありません。

    ±400V/800Vの電源構成を、ITラックと分けて考える

    発表の前提は、電源をITラックから切り離して配置する、±400V/800VのHVDC電源ラックです。目標として挙げられる電力密度は、ITラックあたり約1MW。これは資料が示す設計上の目標値であり、この発表で達成済みの運転性能を示す数値ではありません。[2]

    電源を分けると、電力の変換を担うPSU、蓄電と給電の切り替えに関わるCBU、電力を分配するPDU、電流を流す母線(バスバー)を、ラックをまたぐ一つのシステムとして扱う必要があります。資料は、電気的な乱れがこれらの装置やIT側の負荷へ伝わり得る点を、検証の出発点に置いています。[2]

    L10・L11・L12で、確かめる範囲を広げる

    Microsoftの検証フレームワークは、三つの段階に分かれています。資料中のL10・L11・L12は、今回の検証範囲を区別する呼び方です。[2]

    段階検証する範囲主な対象
    L10構成部品PSU、CBU、PDU、バスバーなどの個別の適合性
    L11単一ラック給電、電源異常時の運転継続、故障の切り離し
    L12複数ラックを含むシステム製品構成や実際のワークロードを踏まえた相互動作

    たとえば、PSU単体が試験に合格していても、それを複数台並べ、別のラックへ給電したときの応答まで同じとは限りません。部品の結果を土台にしながら、配線や蓄電装置、負荷を組み合わせた状態へ確認を進める。その順序が、この三段階の役割です。

    負荷の大きさに加え、変化の速さと繰り返しを試す

    電気的な検証では、入力電源の振る舞い、直流出力の安定性、効率などに加えて、急な負荷変動への応答を調べます。資料に挙がるのは、高い頻度で繰り返す負荷ステップ、大きな過渡変動、電圧のオーバーシュート・アンダーシュートです。目標値から一時的に上へ外れるか、下へ外れるかを含め、変化の最中を見ます。[2]

    ここで気を付けたいのが、複数の電源モジュールの電流分担(Ishare)です。発表は、急激な負荷変化の初期には制御の応答が追い付かず、分担が崩れるリスクを挙げています。試験設備を含む配線の電気的特性も応答へ影響し、負荷を変化させる周波数によっては共振が生じ得る、としています。[2]

    そのため、一定の負荷を一度かけるだけでは見えない振る舞いがあります。負荷の変え方や繰り返しの周波数をそろえ、電気計測とテレメトリーを突き合わせる。テレメトリーは装置から取得する状態情報ですが、資料はその測定誤差を抑えるため、事前の校正も重視しています。[2]

    交流入力の喪失から復帰まで、PSUとCBUの連携を見る

    電源が一時的に乱れたとき、給電を維持して運転を続ける能力はライドスルー(ride-through)と呼ばれます。今回のCBUの検証は、交流入力の喪失、復帰、給電の切り替えを、一連のシナリオとして扱います。[2]

    対象には、蓄電と電力の受け渡し、蓄電状態のバランス、負荷変動の平滑化、PSUとCBUの相互動作が含まれます。蓄電装置があることに加え、電源が失われたときにどう引き継ぎ、戻ったときにどう通常の状態へ移るかを確かめるわけです。資料はこうした検証項目を示していますが、運転を維持できる時間の保証値は示していません。[2]

    保護動作は、止める範囲と復帰の振る舞いまで確認する

    安全性の検証でも、構成部品、ラック、複数ラックという段階を使います。接地、絶縁、保護機能を調べ、故障を模擬的に与える故障注入試験によって、停止と復帰の振る舞いを確認する方針です。装置が残す状態情報やイベントの記録も、想定した応答との照合に使います。[2]

    資料は、高いインピーダンスを使う接地方式や、保護接地(PE)の接続を、複数ラック構成で注意する点に挙げています。ここから読み取れるのは、ラックの内側だけで安全を完結させず、接続先も含めて故障の影響を追う必要があるということです。特定の接地方式を、すべての設備へそのまま適用するための説明ではありません。[2]

    「100%」は、試験で扱う範囲を広げる目標

    発表はシステム統合検証の100%カバレッジを目標に掲げ、標準化された試験、設計固有の条件、実際の使い方を組み合わせています。この100%は、故障が起きない確率や、すでに達成した検証結果を表すものではありません。対象に選んだ構成とシナリオを、どこまで試験で扱うかという計画の話です。[2]

    800Vの電源構成を読み解くときは、容量や変換効率と一緒に、負荷変動、給電の切り替え、故障時の停止と復帰にも目を向ける。Microsoftの発表は、それらを部品からシステムへ順に積み上げて確かめる道筋を示しています。

    Microsoftの事業をもう少し知る

    Azureを含むクラウド、業務ソフト、Windowsなど、Microsoft全体の事業についてはcyclewaveの企業解説にまとめています。

    参考資料

    2026年8月11〜12日開催のOCP APAC Summitの公式掲載資料を使用し、2026年9月28日に保存済みスライドの全16頁を確認しました。検証の対象・方針と、性能の実測結果を分けて記述しています。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧

    [2]Microsoft「Validating HVDC AI Rack Platforms with Complex Architecture: Diablo 400 System」公式掲載スライド。電源構成と目標はp.4、検証の段階と計画はpp.5–6、電気・ライドスルー・保護の検証はpp.9–11、リスクと校正はp.12、検証範囲を広げる提案はpp.13–15。公式一覧では「Validating High-Power AI Rack Platforms with complex architecture: Lessons from Mt. Diablo 400 System Qualification」として掲載されています。

  • MicrosoftのAIエージェントによるサーバー検証、試験生成から不具合分類へ

    MicrosoftのAIエージェントによるサーバー検証、試験生成から不具合分類へ

    サーバーの不具合は、ハードウェア、ファームウェア、ソフトウェアのどれか一つに、きれいに分かれて現れるとは限りません。温度の変化、装置側のログ、ソフトウェアのエラーを別々に見ていると、同じ問題を何度も調べたり、必要な試験へたどり着くまでに時間がかかったりします。

    MicrosoftがOCP APAC Summitで示したのは、テスト生成と不具合分類を、層をまたぐ計測情報でつなぐ検証AIです。試験項目を一度作って終えるのではなく、結果や過去の不具合を次の検証へ戻す仕組みとして、自律検証エージェントを位置付けています。[1・2]

    簡単にまとめると?

    • Microsoftの検証AIは、装置の計測情報やログを、試験の生成・実行・不具合分類へつなぐ仕組みです。
    • 過去の不具合と人の確認を次の試験へ戻しますが、似たログだけで原因を確定するわけではありません。
    • 重複試験の削減はサンプルデータでの結果で、検証全体の短縮は予測値として区別されています。

    ログを並べるだけでなく、次の試験へつなぐ

    資料の検証ループは、ソフトウェアの不具合情報、ファームウェアのログ、ハードウェアのテレメトリーを入力にします。異常を見つけたら、その装置の条件に合う試験を起動し、過去の似た故障と関連付けて、原因を絞っていく流れです。[2]

    例として、ハードウェアとファームウェアの情報にメモリーエラーが現れた場合、ストレステストを実行し、過去の類似障害と照合する構成が描かれています。「エラーが出た」と記録するだけでなく、次に何を確かめるかまでつなぐ点が特徴です。[2]

    もちろん、同じようなログが出ていても、原因が同じとは限りません。似た事例は調査の手がかりであって、それだけで原因が確定するわけではないため、試験結果と人の判断を戻す経路も必要になります。

    TestGen.AIとBugEval.AIの役割

    資料では、検証シナリオを作るTestGen.AIと、不具合を評価・分類するBugEval.AIが示されています。意味の近い情報を探す検索や、過去の不具合のまとまりを使い、その時点で優先すべき試験や問題を選ぶ考え方です。[2]

    ここで大事なのは、過去に用意した試験だけを引き継ぐのではなく、前の世代で見逃した不具合も、次の世代の試験へ反映することです。資料は、過去世代の故障パターンを調べ、試験と変更提案を作る流れを示しています。[2]

    Microsoftの関連ブログも、こうしたエージェントを社内の検証・プラットフォーム開発で使う仕組みとして説明しています。公開資料に名前が出ていることと、そのまま利用できる一般向け製品であることは別です。[3]

    CPUの温度保護を、生成から再試験までたどる

    具体例は、CPUのサーマルトリップ点、つまり温度保護が作動する条件の検証です。まずTestGen.AIが試験を生成し、実行を統括するオーケストレーターが対象のハードウェアへ割り当てます。装置で負荷を動かし、温度の計測情報を集めます。[2]

    次にBugEval.AIが、集まった情報を判定条件と照合し、合否と診断に役立つ情報を返します。不合格なら、その結果を使って試験を調整し、再試験へ進みます。試験生成、実行、計測、評価を、ひと続きに扱う構成です。[2]

    この資料には、具体的な温度閾値や負荷条件までは示されていません。ここで示されているのは検証の組み立て方であり、個々のCPUで保護機能を試すための操作手順ではありません。

    試験を減らすときは、見逃しを増やしていないかを見る

    資料は、サンプルデータセットで重複する試験の実行を30%減らしたとしています。一方、検証サイクル全体を40%短くするという数字には、予測値と明記されています。評価対象の規模や詳細な比較条件も、このスライドだけでは分かりません。[2]

    試験の数や時間が減るだけでは、品質が良くなったとは判断できません。必要な不具合を引き続き見つけられるか、過去に見逃した条件を追加できたか、誤った分類が増えていないかも合わせて見る必要があります。これは、資料の効率改善を実際の検証へ持ち込むときの確認点です。

    変わりやすいハードウェア構成やファームウェアの条件を、試験結果と一緒に残すことも欠かせません。前の環境で役立った試験が、次の環境でも同じ意味を持つとは限らないからです。

    人の判断を残しながら、検証のつながりを短くする

    資料のループには、人が結果を確認し、学習へ戻す段階が含まれています。AIが情報を集め、似た不具合を整理し、試験の候補を用意する。その先の設計判断まで、根拠が追える状態にしておく構成です。[2]

    検証AIの価値は、試験を自動で増やすことだけではありません。過去に分かったことを、いま必要な試験へ結び直すことにあります。ハードウェアとソフトウェアを一緒に設計するなら、検証もまた、それぞれの情報をつないで進める必要があります。

    Microsoftの事業をもう少し知る

    Azureを含むクラウド、業務ソフト、Windowsなど、Microsoft全体の事業についてはcyclewaveの企業解説にまとめています。

    参考資料

    2026年9月27日確認。講演の公開スライドをもとに構成しています。

    [1]Open Compute Project:2026 OCP APAC Summit 公式セッション一覧

    [2]Microsoft:Embedding Intelligence into Hardware-Software Co Design Through Autonomous Validation Agents(講演スライド)

    [3]Microsoft:Driving Efficiency in Modern System Engineering with AI Agents

  • MicrosoftのAFPD、ディスク故障の予測を検証と保守につなぐ

    MicrosoftのAFPD、ディスク故障の予測を検証と保守につなぐ

    データセンターで使うディスクは、同じように見えても、機種やファームウェア、使われ方が違います。故障の前に現れる兆候も一つではありません。すべてに同じ閾値を当てはめると、見逃す異常と、故障ではないのに拾ってしまう変化の両方が生まれます。

    Microsoftが紹介したAFPD(Azure Failure Prediction and Detection)のディスク向けの仕組みは、こうした違いを前提にしています。機種と故障種別に合わせた予測モデルを用意し、その予測を確かめてから、保守へつなぐ構成です。[1・2・3]

    簡単にまとめると?

    • AFPDは、ディスクの機種と故障種別ごとに予測モデルを用意します。
    • 予測を先に評価し、誤検知や見逃しを確かめながら段階的に保守へつなぎます。
    • LLMの出力だけで設備を動かさず、不可逆な操作には方針に基づく承認や人の確認を置きます。

    ディスクの内側と、周囲の動きを合わせて読む

    手がかりは、ディスクが持つ健康状態の情報だけではありません。資料ではSMARTなどの内部テレメトリーに加え、システム側のI/Oやイベント、エラーログ、温度や湿度などの環境情報を合わせています。テレメトリーは、運用中の状態を継続して集めた計測情報です。[2]

    単発の値を見るだけでなく、前回からの差分や変化の傾向、一定期間をまとめた統計量を特徴量にします。たとえばエラーの増え方を扱うには、その時点の件数だけでは足りません。いつ、どのように変わってきたかを、モデルが比較できる形に整える必要があります。[2]

    さらに、ディスクが完全に利用不能になった後の記録だけで学習するのではなく、本番の故障検知やシステムログから、より早い段階の不具合をラベルに使います。故障を知らせる時点を、利用者への影響が出る前へ近づける考え方です。[2]

    機種と故障種別の組合せに、モデルを用意する

    この仕組みの軸は、ドライブの機種 × 故障種別ごとにモデルを持つことです。機種が変われば使える信号も変わり、故障の種類が変われば、重視する特徴や判定の閾値も変わります。[2]

    そのため、一つの大きなモデルの成績だけで運用を判断するのではなく、それぞれのモデルを学習し、検証し、更新できる構成にしています。ある故障を拾うルールが有効でも、それだけで別の故障まで見つかるとは限らないからです。

    正解率だけで、使える予測とは決めない

    故障がまれなデータでは、多くを「正常」と答えるだけでも、全体の正解率は高く見えます。運用で知りたいのは、故障と判断したものがどれだけ本当だったか、そして実際の故障をどれだけ拾えたかです。

    前者が適合率に当たる指標、後者が再現率(Recall)です。資料はHITを「検知したうち実際に正しかった割合」と定義し、HITと再現率が閾値を満たすかを、本番導入の判断に使っています。見逃しを減らすことと、不要な対応を増やさないことを、両方確かめるためです。[2]

    学習段階の受入基準として、正解率90%超、適合率75%超、再現率70%超、F1スコア70%超も示されています。これらはモデルを受け入れる基準であり、すべての機種で達成した実績値ではありません。[2]

    予測だけを動かしてから、保守へつなぐ

    本番へ広く展開する前には、予測を日次で評価しながら、実際の運用操作は起こさない検証段階を置きます。過去の故障結果と照らし合わせ、HITと再現率が基準を下回れば、学習や特徴量の見直しへ戻ります。[2]

    導入後も、少数の対象で先に動かすカナリア展開などを使い、段階的に適用します。誤検知や見逃しを追い、ハードウェアやファームウェアの変化によって予測が合わなくなれば再学習する。モデルは作って終わりではなく、運用に合わせて保つ対象です。[2]

    生成AIの説明と、設備を動かす判断を分ける

    発表の後半では、既知の故障を捉えるルール、機械学習モデル、原因分析を助けるAIエージェントを重ねる構成へ話が広がります。大規模言語モデル(LLM)は、証拠をまとめたり、原因の候補や対応案を整理したりする役割です。[2]

    ここで明示されているのは、LLMの出力だけを根拠に、設備群への操作を実行しないという境界です。不可逆な操作には、定めた方針による承認や人の確認を必要とし、実行の根拠、確信度、結果を残します。[2]

    新しい自動対応も、過去データによる評価、操作をしない観察運転、限定した本番適用という順に進めます。予測を当てる技術と、予測に基づいて安全に動く技術は、つながっていても同じではありません。[2]

    故障を早く知る価値を、運用で確かめる

    AFPDのディスク向け発表から見えてくるのは、予測モデルだけを高度化する設計ではありません。機種ごとの信号を整え、見逃しと誤検知を確かめ、影響の小さい範囲から保守へつなぐ。その連続した手順が、予測を使えるものにします。

    故障の兆候を早く知れれば、対応を選ぶ時間ができます。その時間を役立てるには、どの予測を、どの条件で、どの操作へつなぐかまで決めておくことが大切です。

    Microsoftの事業をもう少し知る

    Azureを含むクラウド、業務ソフト、Windowsなど、Microsoft全体の事業についてはcyclewaveの企業解説にまとめています。

    参考資料

    2026年9月27日確認。講演の公開スライドをもとに構成しています。

    [1]Open Compute Project:2026 OCP APAC Summit 公式セッション一覧

    [2]Microsoft:AFPD Disk Failure Prediction and Detection and AI Transformation(講演スライド)

    [3]Microsoft:Azure Failure Prediction & Detection の概要(2025年11月4日)

  • Microsoftの液冷バスバー案、大電流を運ぶ導体の小型化と漏れ対策

    Microsoftの液冷バスバー案、大電流を運ぶ導体の小型化と漏れ対策

    AIサーバーへ大きな電力を届けるとき、熱くなるのはチップだけではありません。電流を運ぶ経路にも抵抗があり、そこで生じた熱を逃がす必要があります。給電する量が増えるほど、その経路の大きさや重さも、ラック設計の課題になってきます。

    MicrosoftがOCP APAC Summitで取り上げたのは、バスバーを液体で冷やす設計です。バスバーは、大きな電流をまとめて運ぶ棒状・板状の導体。空気で冷やすだけでは寸法や気流の制約が厳しくなるため、冷却液を使って電力経路そのものを小さくする考え方です。[1・2]

    簡単にまとめると?

    • 液冷バスバーは、大電流を運ぶ導体を液体で冷やし、給電経路の小型化を目指す設計です。
    • 重量や占有面積の比較は特定条件のシミュレーションで、量産運用の実績や全ラック共通の効果ではありません。
    • 小型化と引き換えに、回路全体の流量配分や充填、清浄度、漏れへの対応が必要になります。

    電源ラックからITラックまで、冷やす場所を分けて考える

    資料の構成例では、電源ラックから±400V DC/800V DCの高電圧直流で電力を送り、ITラック側で低電圧直流へ変換します。高電圧側と低電圧側の両方にバスバーがあり、それぞれの場所で冷却方法を選びます。[2]

    選択肢は、空冷バスバー(ACBB)と液冷バスバー(LCBB)です。電源ラックとITラックがどちらも空冷なら両側で空冷を使う構成が考えられます。一方だけが液冷なら、その側のバスバーを液冷にする組み合わせも示されています。[2]

    つまり、ラックのどこかに液冷を入れたら、給電経路も一律に液冷へ変わるわけではありません。そこで利用できる気流と液冷回路を見ながら、区間ごとに決める設計です。

    5,000Aの比較では、重さと占有面積に差が出る

    空冷バスバーは、冷却液の配管を持たない単純さが強みです。ただ、大電流に対応するためにヒートシンクや気流を整える板を加えると、重さや占有面積が増え、電源ユニットの保守もしにくくなります。液冷は、こうした空気側の制約を減らす方向に働きます。[2]

    資料には、目標電流を両方式とも5,000Aにそろえたシミュレーション比較があります。空冷を1としたとき、液冷は重量が0.68、占有面積が0.67。電流密度は空冷の2倍超とされ、コネクター周囲の温度余裕も、5℃未満から約10℃へ広がる例が示されています。[2]

    この数字は、資料中の設計条件を比較したものです。すべてのラックで同じ比率まで小型化できるという意味ではなく、実機の量産運用で得た結果でもありません。それでも、冷却方法を変えることで、導体を太くする以外の設計余地が生まれることは読み取れます。

    流れやすくするだけでは、必要な場所へ届かない

    液冷バスバーは、ラック内の既存の液冷回路へ組み込む案です。ここで重要になるのが流量配分です。バスバー側の流路抵抗が低すぎると、冷却液がそちらへ多く流れ、同じ回路につながるほかの部品とのバランスが変わります。[2]

    流路抵抗は、ある流量を通すためにどれだけの圧力差が必要か、という関係で捉えられます。冷却したい部品ごとに必要な流量が違うため、バスバー単体の流れやすさだけでなく、回路全体の圧力損失と合わせて設計する必要があります。

    長い配管には、導入や保守の難しさもあります。資料では、マニホールドからの充填が難しく、専用の治具が必要になる可能性や、途中で分割しにくい配管の洗浄が課題に挙がっています。[2]

    冷却の故障を、給電の故障へ広げない

    バスバーは、止まればその先へ電力を届けられなくなる部分です。発表では、漏れがラック運転へ直接影響すること、冗長性を持たない構成では単一障害点(SPOF)になり得ることを、主要なリスクとして挙げています。[2]

    そのため、冷却性能と並んで、漏れをどこで検知し、検知後に何を保護するかを決めておく必要があります。資料は、接合部を減らすこと、漏れ検知線の配置、既存ラックの漏れ対応への統合や、ファームウェア側の変更も検討項目にしています。[2]

    確認する側にも設備が要ります。大電流を流して冷却能力を確かめるには、十分な電源と電子負荷が必要です。形が収まること、計算上は冷えること、実際の負荷で安全に使えることは、別々に確かめなければなりません。[2]

    液冷は、チップの外側へ広がっていく

    液冷バスバーの狙いは、電流を運ぶ経路を小さくし、ラック内の空間と温度の余裕を取り戻すことです。その代わり、流量配分、充填、清浄度、漏れへの対応までが、配電の設計に加わります。

    AIサーバーの高密度化を支えるのは、冷却能力だけではありません。電力を届ける部分と、そこで生まれた熱を運び出す部分を、一緒に成立させること。液冷バスバーは、そのつながりがよく見える設計例です。

    Microsoftの事業をもう少し知る

    Azureを含むクラウド、業務ソフト、Windowsなど、Microsoft全体の事業についてはcyclewaveの企業解説にまとめています。

    参考資料

    2026年9月27日確認。講演の公開スライドをもとに構成しています。

    [1]Open Compute Project:2026 OCP APAC Summit 公式セッション一覧

    [2]Microsoft:Busbar Cooling Challenges and Emerging Opportunities for Next-Generation AI Platforms(講演スライド)

  • MicrosoftとBroadcomが示すMRC、通信を複数経路へ分け不足分だけ再送する

    MicrosoftとBroadcomが示すMRC、通信を複数経路へ分け不足分だけ再送する

    AIの処理を分担する計算機が増えると、通信の一部に混雑が集まるだけで、ほかの計算機も待たされます。回線の速度を上げるだけでなく、空いている経路を使い、届かなかったデータを効率よく送り直すことが重要になります。

    2026年8月のOCP APAC SummitでMicrosoftとBroadcomが説明したMRC(Multipath Reliable Connection)は、パケット単位で通信を複数の経路へ分け、順番が前後した到着と選択的な再送を扱う仕組みです。一本の経路に通信を固定する考え方から、ネットワーク全体の使い方を見直しています。[1・2]

    簡単にまとめると?

    • MRCはパケットを複数の経路へ分け、届く順序の違いを受信側で扱う仕組みです。
    • 不足分だけを再送し、経路選択や混雑の検知と組み合わせてネットワークの余力を使います。
    • 障害試験は特定構成での結果であり、損失の影響がなくなることや、すべてのAI処理の性能を保証しません。

    複数の経路を使うなら、到着順の違いも受け止める

    RDMAは、離れた計算機のメモリーへ効率よくデータを転送するための仕組みです。今回の資料では、従来のRDMA運用での課題として、多経路化、順序が入れ替わったパケットの処理、再送の効率、輻輳制御の調整を挙げています。ここでの比較を、あらゆるRDMA実装が同じ制約を持つという意味には広げられません。[2]

    MRCで使うパケットスプレーは、一つの通信のパケットを複数の経路へ振り分ける方法です。同じ宛先でも通る道が違えば、後から送ったパケットが先に着くことがあります。

    そこで必要になるのが、Out-of-Order Packet Delivery(OOPD)、つまり送信順と異なる順番での到着を扱う機能です。資料の図では、異なる経路を通ったパケットを受信側がメモリー内の対応する位置へ受け入れています。経路を増やすことと、順序の違いを扱うことを組み合わせて初めて、複数の道を使いやすくなります。[2]

    届いたものを全部送り直さず、不足分を再送する

    パケットが欠けたときの処理も重要です。資料は、途中から後ろをまとめて送り直すGo-Back-N型の課題に対し、選択的再送を示しています。[2]

    受信側が、どの範囲を受け取り、どこが欠けたかをSACK(Selective Acknowledgment)とビットマップで知らせ、送信側は必要なパケットを送り直します。資料の例では、先に届いたデータを残し、欠けた番号を埋める流れが描かれています。[2]

    これは、届かなかったデータを無視して処理を進めるという話ではありません。正しくそろえるための信頼性を保ちながら、すでに届いたデータの再送を減らす考え方です。多経路による順序の変化と、実際の欠落を区別して扱うことが、その前提になります。

    経路の選択を、通信の端から考える

    MRCの説明には、SRv6を用いたソースルーティングも登場します。SRv6は、IPv6ネットワーク上でセグメントの指定を使って通信の経路や処理を表す仕組みです。[3]資料では、各スイッチだけで判断する従来の構成と、コントローラーを用いてワークロードに応じた端から端までの経路を扱う構成を対比しています。[2]

    ここで重要なのは、単に経路の本数が多いことではありません。計算の通信パターンに合わせて、どの経路へ負荷を分けるかを考えられることです。複数の独立したネットワーク面を使うマルチプレーン構成も、この説明の一部になっています。

    混雑の手がかりを、データが消える前に返す

    資料のパケットトリミングの例では、混雑した箇所でパケットのペイロードを取り除き、ヘッダーを受信側へ渡します。到着したヘッダーを、混雑に関する手がかりとして使う構成です。[2]

    すべてが消えて何も届かない場合と比べると、どのパケットが混雑の影響を受けたかを知る材料が残ります。MRCの発表では、この仕組みを誤った混雑判断を減らすための要素として位置づけています。具体的な制御条件は実装に依存し、図に描かれたバッファー使用率を、あらゆる機器の共通設定値と読むものではありません。

    障害試験から、何が分かるか

    発表では、Thor Ultraを搭載したPCIe Gen 5サーバーで、リンクを取り外す試験や、ランダムな損失を加える試験が示されました。後者は、16台のサーバー、リーフ・スパイン構成、ib_write_bwによる全対全の通信で、特定のリンク群の損失率を変えています。[2]

    結果の図は、損失が増えるにつれて再送が増え、スループットも低下する様子を示しています。MRCが損失や故障の影響をなくすのではなく、残る経路と再送処理を使って通信を続ける、という読み方が適切です。この試験だけから、あらゆるAIモデルの学習時間や、すべての障害時の性能を決めることはできません。

    MRCの要点は、経路を分ける、順序の違いを扱う、不足分を送り直す、混雑を知るという機能を一緒に考えることです。AIネットワークの余力を使うには、速いリンクを並べるだけでなく、データが届くまでの振る舞いをつないで設計する必要があります。

    発表企業の事業を知る

    MicrosoftとBroadcomの会社全体の事業については、cyclewaveの企業解説から読めます。

    参考資料

    2026年9月27日確認。試験結果は講演資料に記された構成と条件に限ります。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧

    [2]Microsoft・Broadcom「Enabling AI Networking @ Scale with Multi-path Reliable Connections(MRC)」公式掲載スライド。機能と経路はpp.3–8・16、順不同受信と選択的再送はpp.9–15、パケットトリミングはpp.17–20、障害・損失試験はpp.21–22。

    [3]IETF RFC 8986「Segment Routing over IPv6(SRv6)Network Programming」。SRv6の概要とセグメントの定義。

  • Microsoftの液空HRU、冷却液の熱を空気へ渡す装置の流量診断

    Microsoftの液空HRU、冷却液の熱を空気へ渡す装置の流量診断

    液冷の装置を設置しても、冷却液が予定どおり流れなければ、期待した熱を運べません。ポンプの能力だけでなく、ホースの曲がり方、弁の状態、フィルターや気泡までが、実際の流れを変えます。

    2026年8月のOCP APAC SummitでMicrosoftが紹介したのは、液体から空気へ熱を渡すHRU(Heat Reduction Unit)を、大規模に導入・保守するための考え方です。焦点は、運転が始まってから故障を探すだけでなく、初期設定の段階で流れの異常を見つけ、装置自身が状態を知らせる設計にあります。[1・2]

    簡単にまとめると?

    • 液空HRUは、サーバーから冷却液が運んだ熱を空気へ渡す装置です。
    • 流量はポンプと流路の釣り合いで決まり、弁やホースの状態も影響します。
    • 導入時の診断と原因別の通知を重視しますが、資料の改善数値は実測の保証値ではありません。

    冷却液で集めた熱を、空気へ渡す

    資料の液空HRUは、サーバーのコールドプレートから戻った冷却液を、液空熱交換器のコイルへ通します。ファンウォールで空気を流し、液体が運んだ熱をホットアイル側へ渡す構成です。ポンプ、リザーバーや膨張タンク、マニホールド、温度・圧力・流量の計測点も含まれます。[2]

    ここでHRUは、熱を消しているわけではありません。チップから冷却液へ移った熱を、今度は空気へ受け渡しています。したがって、液体側の流れと、空気側の熱の受け入れが、どちらも成立する必要があります。

    流量は、ポンプと流路の両方で決まる

    流れにくさを表すのが、流量に対する圧力損失です。資料では液体系のインピーダンスとして説明されています。マニホールド、弁、ホース、QD、コールドプレート、フィルターなど、流路に入る部品がそれぞれ抵抗を加えます。[2]

    実際の動作点は、ポンプが生み出せる圧力と、流路が必要とする圧力の釣り合いで決まります。同じポンプでも、弁が十分に開いていなかったり、ホースが折れ曲がっていたりすれば、設計時とは違う流量になります。「ポンプが動いている」と「必要な量が流れている」を分けて確かめる理由です。

    そのため発表では、最初の充填時から流れにくさと圧力を確認することを重視しています。初期の組立てや設定の問題を見逃すと、運用後の温度異常や、原因を絞れない警報として現れかねません。[2]

    一つの警報に、違う原因を押し込めない

    たとえば流量が少ないとき、ポンプの異常、弁の閉止、フィルターの詰まり、充填不足や気泡では、調べる場所も対処も違います。すべてが一つの「冷却異常」という警報になれば、正しい部品を選んで交換することも難しくなります。

    Microsoftの資料は、ポンプ保護、流量と流体系、漏れと液位、温度、設定と操作を分けた検知階層を示しています。過熱や過圧、空運転、極端な低流量、フィルター詰まり、リザーバー液位などを、条件に対応したコードで知らせる考え方です。[2]

    何かが悪いと知らせるだけでなく、何を先に確かめればよいかまで絞れることが、保守を支えます。同時に、閾値は機器の世代や構成に合わせて調整する必要があります。

    工場から本稼働まで、確認を段階に分ける

    発表では、故障モード影響解析(FMEA)を、設計側と作業工程側の両方へ適用する方針が示されています。部品が壊れる場面だけでなく、作業で弁を閉じたままにするような誤操作も想定して、検知と自己保護を確かめます。[2]

    資料の導入フローは、工場での状態確認から、現地での流体系の診断、設定値の自動適用、IT機器への給電、最終確認を経て本稼働へ進む構成です。センサー、弁、フィルター、液位、流量を初期段階で調べ、冷却液の状態に合わせて制御を整えます。[2]

    自動化の価値は、単に作業を速くすることだけではありません。同じ確認を毎回行い、手順の抜けを本稼働へ持ち込まないことにもあります。写真を用いた作業手順や、条件ごとの案内は、その確認を現場で再現しやすくする手段です。

    改善率より、改善につながる仕組みを読む

    資料には、導入時間や誤った部品交換、耐久性などの改善を示す数字もあります。ただし、該当ページには、説明のための概数であり、正確な運用データではないと明記されています。この発表から実測の改善率や、導入後の効果を保証することはできません。[2]

    それでも、設計の方向は明確です。流量不足を早く見つけること、原因ごとに知らせること、点検までの間に自己保護できること。液冷を使い続けるためには、熱交換器の性能と同じくらい、導入時に正しく整え、その状態を読み取れる仕組みが重要になります。

    Microsoftの事業をもう少し知る

    Azureを含むクラウド、業務ソフト、Windowsなど、Microsoft全体の事業についてはcyclewaveの企業解説にまとめています。

    参考資料

    2026年9月27日確認。HRUの名称と構成は今回の講演資料に沿っています。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧

    [2]Microsoft「Liquid-to-Air HRU Cooling at Scale: Serviceability and Fleet-Safe Maintenance Practices」公式掲載スライド。構成と圧力損失はpp.4–5、導入・保守の課題はpp.6–7、FMEAと検知・導入工程はpp.8–10、数値の留意事項はpp.6・11。

  • Microsoftの電力テレメトリー活用、CPU利用率の分布からラックのサーバー搭載数を見積もる

    Microsoftの電力テレメトリー活用、CPU利用率の分布からラックのサーバー搭載数を見積もる

    たとえば、ラックにまだ空きがあるのに、電力の上限が気になってサーバーを追加できない場面を考えてみます。一台ずつの最大消費電力を足せば慎重に見積もれますが、実際には全台が同じ強さで動き続けるとは限りません。反対に、平均値だけで台数を決めると、負荷が重なったときの余裕を見落とします。

    2026年8月のOCP APAC SummitでMicrosoftが示したのは、実際に動くサーバー群の利用率と消費電力の分布から、ラックへの搭載台数を見積もる考え方です。最大性能を測る試験から少し視点を変え、「普段はどんな負荷で動き、ときどきどこまで電力が増えるのか」を計画に持ち込みます。[1・2]

    簡単にまとめると?

    • ラックの台数を見積もるには、CPUの平均利用率だけでなく、負荷の偏りや実運用の電力分布も読みます。
    • 搭載台数の増加例は、負荷の分布と許容する電力超過確率を使った計算で、ラックの供給電力を増やした結果ではありません。
    • 電力予測や負荷の再現は対象フリートでの検証であり、すべてのサーバーに通用する完成済みベンチマークではありません。

    一台分の電力を、どの負荷で決めるか

    講演では、ラックや電力区画に収めるノード数を elevation と呼んでいます。ここでいうノードは、電力を見積もる単位となるサーバーです。台数を少なく抑えすぎれば、同じサーバー数により多くのラックや床面積が必要になります。多く詰め込みすぎれば、電力を抑えるための性能制限が働き、利用者の仮想マシンに影響するおそれがあります。[2]

    その間を探る手がかりが、利用率に対して電力がどう変わるかを表すロードラインです。ただし、試験用の負荷で描いた曲線が、実際のクラウドと同じ形になるとは限りません。資料の比較例では、従来のベンチマークは低い利用率では実フリートより電力が小さく、高い利用率では逆に大きくなっていました。曲線上の一点だけを選ぶと、選んだ負荷によって余裕を大きく見積もったり、小さく見積もったりします。[2]

    CPUの平均利用率が同じでも、中の動きは違う

    フリートとは、運用中のサーバー群のことです。資料にある複数のフリートでは、CPU利用率の分布も、利用率に対する電力の曲線も異なります。立ち上がり途中のフリートと、運用が進んだフリートでは、よく現れる利用率の範囲さえ変わります。CPUだけでなく、メモリーやその他の部品が使う電力も、ノード全体の見積もりに含める必要があります。[2]

    もう一つの違いは、CPU内部の負荷の偏りです。論理プロセッサー(LP)は、この資料ではハードウェアスレッドを指します。たとえば、少数のLPが忙しく残りが休んでいる状態と、全LPがほどほどに動く状態では、平均利用率が同じでも内訳は違います。資料の実測例も、LPごとの利用率が均一ではないことを示しています。平均を一つ読むだけでは、この違いが消えてしまいます。[2]

    平均と偏りを、電力予測の入力にする

    Microsoftは対象の「Fleet A」で、LP全体の平均利用率、利用率の偏りを示すジニ係数、平均動作周波数、周波数のばらつきを示す変動係数の四つを使い、ブレードの電力を予測しました。報告された決定係数R²は約0.97、平均絶対誤差(MAE)は約18Wです。[2]

    R²は、観測された電力のばらつきをモデルがどれだけ説明できたかを見る指標です。MAEは、予測と実測の差の絶対値を平均したもの。したがって、この結果を「すべての予測が18W以内に収まる」「どのサーバーでも97%の精度が出る」と読むことはできません。対象フリートで、平均に加えて負荷の偏りを持ち込む意味があった、と受け止めるのが自然です。

    実際のフリートに近い負荷を、試験でも作る

    モデルで傾向をつかんだら、試験用の負荷も現実に近づけます。発表の最初の試作は、整数演算とメモリー負荷を組み合わせ、LPごとに動く時間と休む時間を変えるものでした。ディスクとネットワークにも軽い負荷を加え、CPUだけを一様に動かす試験から一歩進めています。[2]

    二つ目の試作では、圧縮、暗号処理、キーバリュー処理、グラフ処理、メモリーアクセスを混ぜました。資料の比較図では、三つのフリートに対する電力曲線が初回の試作からさらに近づいています。ただし、二つ目にはその時点でI/O負荷がなく、発表者も完全な一致とはしていません。これは公開クラウドの負荷を再現するための概念実証であり、完成した汎用ベンチマークの紹介ではありません。[2]

    台数の増加例には、電力超過の条件が付く

    搭載台数の図では、Fleet Aの利用率分布とノード間の違いを使い、利用率50%のベンチマーク値を基準にする従来の方法と比べています。たとえばラックの電力枠が20kWの場合、電力が枠を超える確率の目標を1%とした例では、22台から28台へ増える計算です。同じ20kWでも、超過確率の目標を0.01%にすると26台になります。[2]

    ここで変わったのは、ラックが供給できる電力ではなく、負荷の分布と許容する超過確率を踏まえた台数の見積もりです。図は単純化した例で、28台ならどの環境でも安全という設置指針ではありません。また、この確率を、そのまま年間の停止時間やサービスの障害率へ換算することもできません。

    ラックの外側と、これからの負荷も含めて考える

    実際の計画には、曜日や季節、地域、特定顧客の使い方が関わります。ラック単体に余裕があっても、列やデータセンター全体の電力枠が先に制約になることもあります。AI処理が増えれば、これまで観測した分布がそのまま続くとも限りません。資料は、こうした複雑さと、性能制限をどこまで許容できるかを未解決の条件として挙げています。[2]

    発表の呼びかけは、事業者の運用データをそのまま公開せずに、共通の用語、検証手順、匿名化した根拠の示し方をOCPコミュニティで作ろう、というものでした。電力計画を平均一つで済ませず、普段の負荷とまれな大きな負荷を一緒に読む。そのために、テレメトリーと試験をつなごうとする提案です。[2]

    Microsoftの事業をもう少し知る

    今回の発表を行ったMicrosoftは、Azureだけでなく、業務ソフトやWindowsなども展開しています。会社全体の事業と設備投資については、cyclewaveの企業解説にまとめています。

    参考資料

    2026年9月26日確認。公式スライド全24ページと、グラフ・試作条件を照合しました。講演動画の音声・質疑は確認対象に含めていません。

    [1]Open Compute Project「2026 OCP APAC Summit」発表一覧。演題・登壇者・公式資料への導線。

    [2]Microsoft「Telemetry-Driven Power Estimation for Rack-Level Provisioning in Public Cloud Data Centers」公式掲載スライド。課題とロードラインはpp.2–6、実フリートはpp.7–11、モデルはpp.12–13、試作はpp.14–19、搭載台数例と条件はpp.20–22。