タグ: テレメトリー

  • gNMIで異常を捉え、IOAMで経路を調べる――WooriNetの連携案

    gNMIで異常を捉え、IOAMで経路を調べる――WooriNetの連携案

    AIの学習を複数の拠点で動かすとき、一部の通信が遅れて処理の完了を待たされることがあります。回線の平均使用率を見るだけでは、遅い通信がどの経路を通り、どこで待っていたのかまで分からない場合があります。

    2026年のOCP Korea Tech Dayで、WooriNetのSunghyuk Park氏は、データセンター間を結ぶScale-Acrossの技術を紹介しました。その中にあるのが、機器の状態を集めるgNMIと、パケットの通過情報を記録するIOAMを組み合わせる案です。広く異常を見つける観測と、対象を絞って詳しく調べる観測を、どう使い分けるのでしょうか。[1][4]

    簡単にまとめると?

    • gNMIによる機器・ポートの統計と、IOAMによる対象パケットの通過記録では、分かることが異なります。
    • 異常を見つけてから対象フローを詳しく調べる案ですが、過去に通過したパケットの記録を後から取り戻すことはできません。
    • 使える機器、取得間隔、時刻と単位、追加する情報の負荷を確かめて、観測する範囲を決めます。

    gNMIで、いつ・どの機器に変化があったかを見る

    gNMI(gRPC Network Management Interface)は、機器の設定や状態をやり取りするための仕組みです。WooriNetの案では、ポートの状態やキューの量などを継続して集め、ECNの増加やキューの閾値超過を異常の手がかりにします。キューは、転送を待つパケットの待ち行列。ECNは、ネットワークの混雑をパケットに付けた印で知らせる仕組みです。[1]

    ただし、gNMIを使えば何でも細かく測れるわけではありません。値が変わったときに送る方法や、指定した周期で送る方法などがあり、機器が対応する項目と間隔を選びます。周期を細かく設定しても、機器が対応できなければ、その要求は受け付けられません。[3]

    この段階で得たいのは、調査の範囲を絞る手がかりです。あるポートで混雑の印が増えたとしても、その集計値だけで「遅い通信がここを通った」とは確定できません。通信ごとの経路を知るには、別の情報が要ります。

    IOAMで、対象のパケットが通った場所を調べる

    IOAM(In Situ Operations, Administration, and Maintenance)は、実データのパケットに観測用の情報を加える技術です。対応する途中の機器が、ノードや入出力ポートの識別情報、時刻、キューの状態などを記録します。別に送ったPingなどの調査用パケットが、実際の通信と違う扱いを受ける場合を補う方法です。[2]

    見る対象が、機器全体の統計から、そのパケットが通過したときの状態へ変わります。全体の混雑と、調べたい通信が経験した混雑を結びつけるための情報です。もっとも、途中にIOAMへ対応しない機器があれば、そこから記録は得られません。記録のない部分を「問題なし」と読まないことが大切です。[2]

    常時監視から、必要な通信だけの詳細観測へ

    図1の上段は、gNMIによる常時監視から始まり、異常の兆候を受けて、問題のあるフローにIOAMを選択的に有効にする流れです。フローは、一連の通信を識別してまとめた単位です。WooriNetは、AI向け通信に使うRoCEv2のフローなどを例に挙げています。[1]
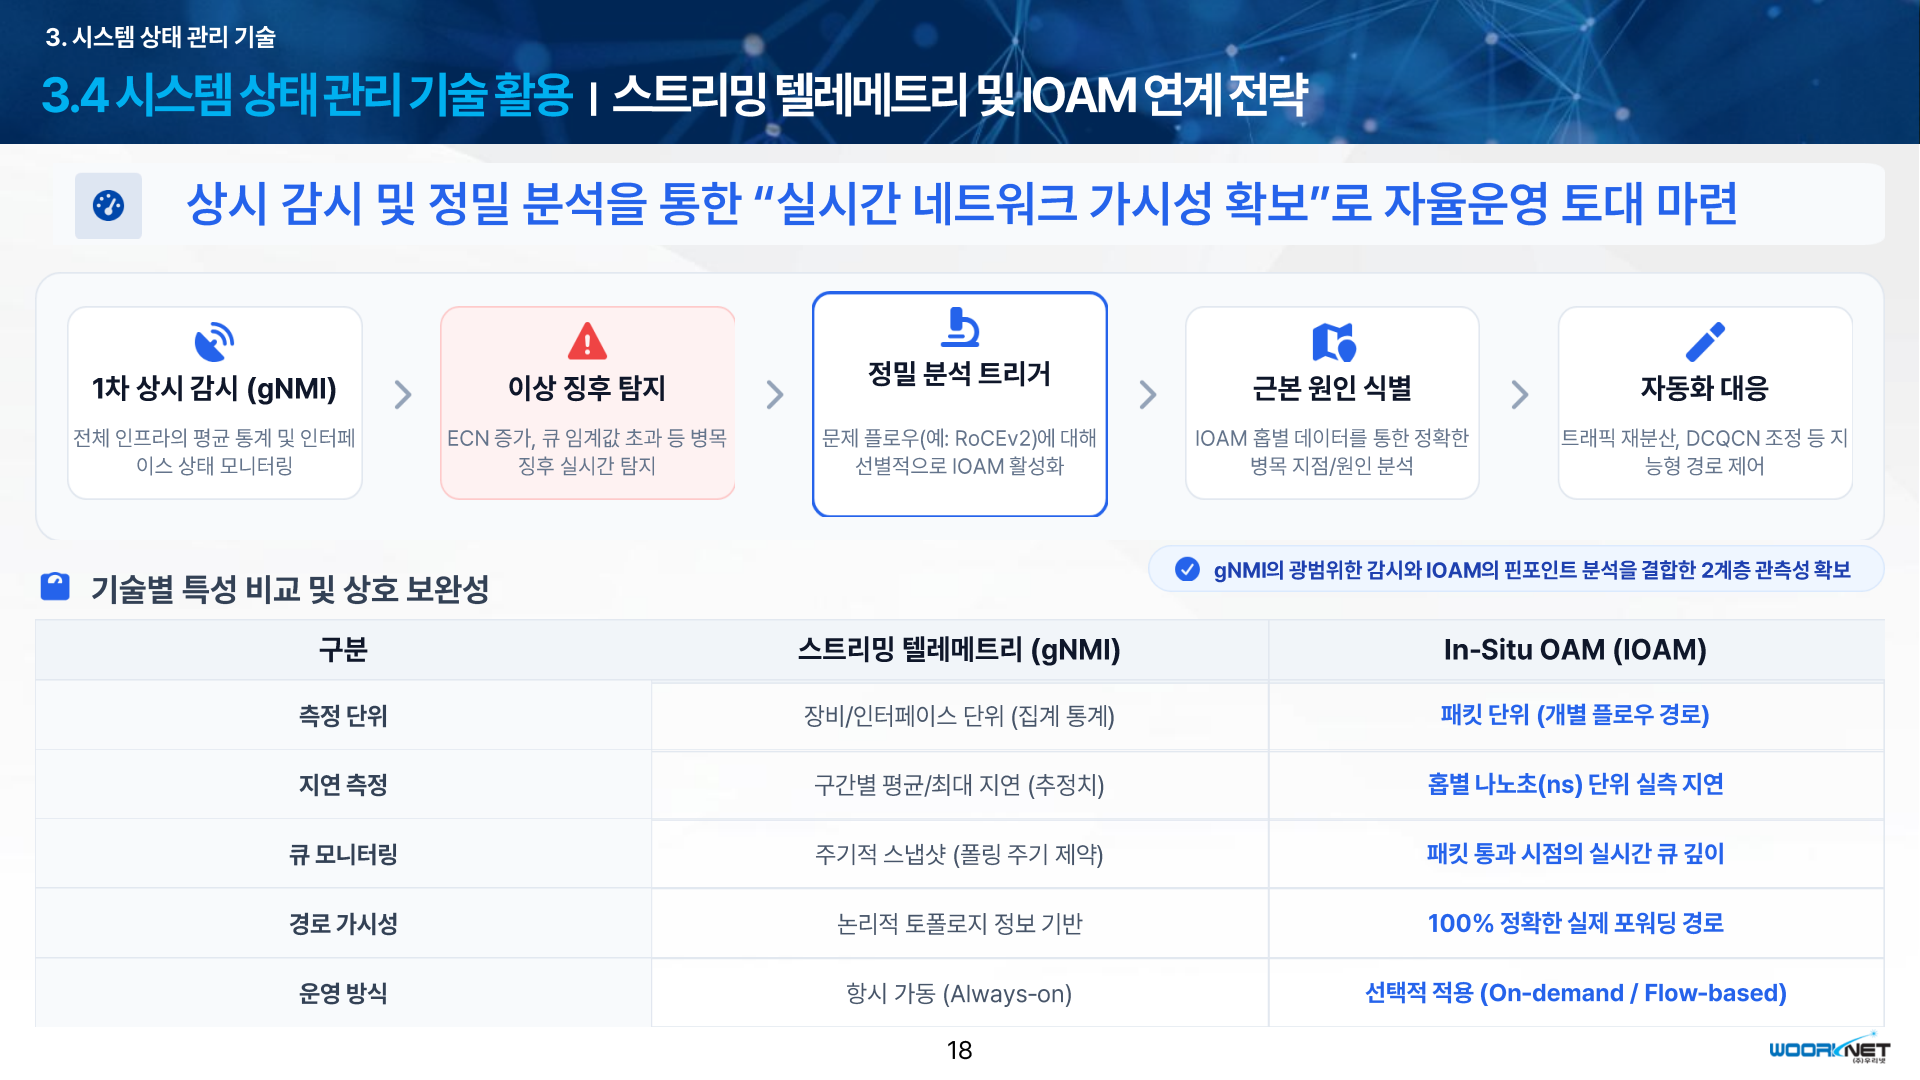
    gNMIで常時監視し、異常の兆候から対象フローのIOAMを有効にして各ホップを調べる、WooriNetの連携案。下段は二つの観測方法の比較。
    図1:WooriNetが示す常時監視と詳細観測の連携案。上段は左から、監視、異常の検知、IOAMの選択的な有効化、原因の調査、対応へ進みます。下段の「100%」「ns」などは発表資料の表現で、対応機器や測定条件を合わせて読む必要があります。出典:Sunghyuk Park/WooriNet「AI 데이터센터간 Scale-Across 전송 기술 동향」、p.18。原資料 / 図を拡大する

    この分担の利点は、詳細な記録を取る範囲を絞れることです。IOAMは追加の情報を運ぶので、パケットが長くなり、機器での処理も増えます。常時すべてを詳しく測るか、対象を限定するかは、観測したい現象と許容できる負荷で決めます。別の調査用パケットを送らないことと、観測の負荷がゼロであることは同じではありません。[2]

    図の下段にある「100%」や「ns」という表現にも条件があります。全経路が見えるかは途中の機器の対応範囲に左右され、時刻の細かさがそのまま測定の正確さになるわけではありません。異なる機器の時刻を引き算するなら、時計のずれも考慮する必要があります。[2]

    二つの経路の一方だけが遅いとしたら

    ここからは、仕組みを理解するための例です。拠点AとBの間に複数の経路があり、ある学習ジョブの通信だけが遅くなったとします。まずgNMIで集めた記録から、その時間帯にどのポートでECNやキューの量が増えたかを探します。これで、詳しく調べたい機器と時間帯を絞ります。

    次に、同じ通信で現象が続く、または繰り返すときに、対象フローへIOAMを適用します。パケットが実際に通ったノードと、その通過時のキューや時刻を突き合わせれば、疑っていた経路を通っていたか、途中のどこに待ちがあったかを調べやすくなります。集計値からの推測を、対象パケットの記録で確かめる順序です。

    この方法で、すでに終わった現象を必ず再現できるわけではありません。IOAMを有効にする前のパケットには、その記録がありません。短時間で消える異常を対象にするなら、普段から残す統計の細かさと、詳細観測を始める条件を先に設計しておく必要があります。これは、異常を見つけた後に観測を始める方式の限界です。

    導入前に合わせる四つの条件

    どちらの方式を使うかに加えて、取得した値を比較できるかを確認します。たとえば同じ「キューの量」でも、装置が使う単位や測る位置が違えば、大小をそのまま比べられません。IOAMの仕様も、キューや共通バッファーの情報を扱う際に、実装ごとの意味を考える前提です。[2]

    確認すること 判断のために見る点
    機器と観測範囲 どの機器・ポートが値を返し、IOAMの途中記録を残せるか。記録のない区間を明らかにする。
    時間と取得周期 現象の長さに対して取得周期は足りるか。機器間の時刻を比べるなら、同期状態と測定位置をそろえる。
    値の意味と単位 キューの量が何を数えた値か、共通バッファーの占有量と区別されているかを確認する。
    パケット長と処理負荷 情報を追加しても経路のMTUに収まるか。MTUは一度に運べるパケットの大きさの上限。対象フローと記録項目を絞れるかも見る。

    表は、WooriNetの連携案とIOAM・gNMIの仕様を基に、導入時の確認事項として整理したものです。通信相手までの全区間を自分たちで管理できない場合は、とくに観測の境界を明らかにしておく必要があります。IOAMは、管理する範囲を定めて運用する技術として設計されています。[2][3]

    原因を絞ることと、自動で直すことを分ける

    WooriNetの図は、観測の先に、通信の再分散や送信速度を調整するDCQCNの設定変更も置いています。ただし、この資料は、変更を選ぶ具体的な条件、変更後の確認方法、失敗時に戻す手順までを示した運用実証ではありません。末尾には、2026年から2030年にかけての伝送システムと運用体制の研究開発計画が示されています。[1]

    この発表から持ち帰れるのは、監視を細かくすれば自動的に通信が速くなるという話ではなく、調査の順序です。まず広い範囲で変化を捉え、次に対象の通信が通った場所を確かめる。自分たちが必要とする判断に対して、どこまでの記録があれば足りるかを決めることが、gNMIとIOAMを組み合わせる出発点になります。

    参考資料

    2026年10月10日確認。発表資料にある技術の説明と研究開発計画を扱い、商用導入の効果や性能値を検証した記事ではありません。

    1. Sunghyuk Park/WooriNet「Trends in Scale-Across Transfer Technology Between AI Data Centers」 — 全22頁。pp.16–18:gNMI・IOAMと連携案、pp.20–21:研究開発計画。
    2. IETF「RFC 9197: Data Fields for In Situ Operations, Administration, and Maintenance (IOAM)」 — 1・3・4.4・5節:観測範囲、データ項目、負荷、時刻の形式。
    3. OpenConfig「gRPC Network Management Interface (gNMI)」 — 3.5節、とくに3.5.1.5.2:購読方式と取得周期。
    4. Open Compute Project「2026 OCP Korea Tech Day」 — 公式の講演・発表資料一覧。
  • ORv3の導入試験はどこまで必要か、TERATECが示す三段階の検証

    ORv3の導入試験はどこまで必要か、TERATECが示す三段階の検証

    高密度のAIラックを選ぶとき、電源容量や冷却能力が足りることは出発点です。実際の導入では、部品を組み合わせて動くか、故障時に影響を切り分けられるか、保守後に計算処理を戻せるかまで確かめる必要があります。

    2026年のOCP Korea Tech Dayで、TERATECのSungYun Kim氏は、Open Rack v3(ORv3)の導入を「部品の適合」「ラックとしての安定性」「施設・運用との適合」に分けて検証する考え方を示しました。ORv3はラックの機構・給電・冷却接続などの共通仕様です。この記事では、対応部品の選定から、現場で使える受入試験へ進むための見方を整理します。[1][2]

    簡単にまとめると?

    • ORv3の接続仕様に合うことと、施設や運用を含めて使えることは、別の検証です。
    • 電源切替や冷却異常では、部品の応答に加えて、共通の給電・配管を使う機器への影響を確認します。
    • 導入試験の成果を、測定結果、故障時の対応、担当者の承認、復旧手順までそろえると、運用へ引き継ぎやすくなります。

    ORv3がそろえる接点と、現場で決めること

    ORv3では、IT機器を載せるフレームだけでなく、Power Shelf(複数の電源ユニットを収める棚)、48V系のバスバー、液冷マニホールドと機器側の接続などを共通化します。バスバーは電力を分配する導体、マニホールドは冷却液を各機器へ分配・回収する管です。[1]

    接続点がそろうと、別々に設計された機器を組み合わせる基盤ができます。ただし、CDU(冷却液分配装置)をどこに置くか、施設からどの温度・流量で液を供給するか、保守時にどの計算処理を退避するかまでは、それだけでは決まりません。Kim氏の資料も、冷却設備の構成や上位の運用ソフトウェアを、ORv3の接続仕様とは分けて扱っています。[1]

    ここを分けずに「ORv3対応」とだけ発注すると、部品の接続は確認できても、冷却異常時に誰がどこを止めるのかが残ります。受入試験では、仕様への適合と、導入先で必要な運転条件を別々に書くことが大切です。

    部品、ラック、施設・運用の順に試す

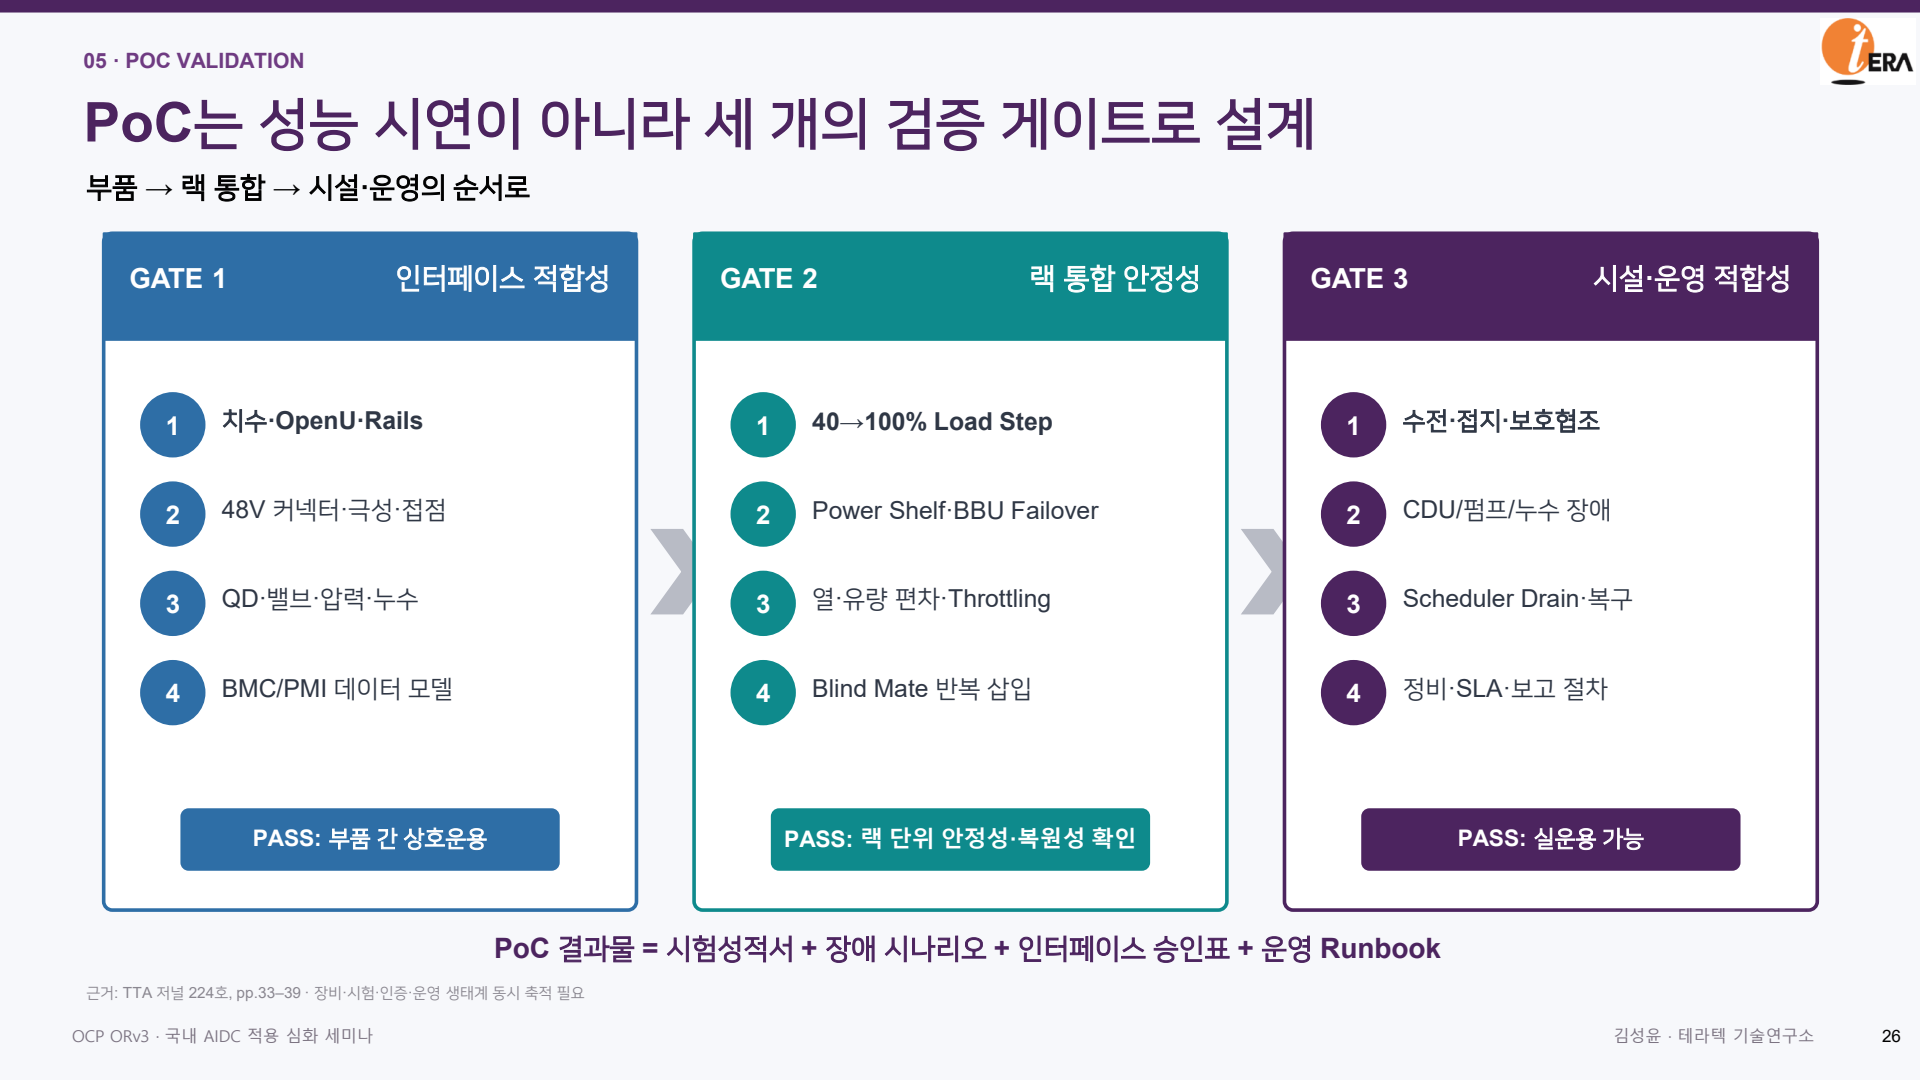
    発表のPoC(概念実証)は、性能を一度見せるためのデモではなく、次の段階へ進める条件を確かめる試験として構成されています。図1はその三段階です。[1]

    ORv3の導入試験を、部品の接続適合、ラック統合の安定性、施設と運用への適合という三段階に分けた原資料の図。
    図1:TERATECの発表にあるPoCの三段階。左から、部品間の相互運用、ラックの安定性と復元性、実運用への適合を確認します。図中の40→100%負荷変化は発表の試験例です。出典:SungYun Kim(김성윤、TERATEC)「OCP ORv3 기반 고밀도 랙 표준의 현황과 국내 AIDC 적용 방안」、p.26。原資料 / 図を拡大する

    第一段階は、部品同士の適合です。機器の寸法とレール、電源コネクターの極性と接点、冷却液の接続部・圧力・漏れ、管理データの形式などを確認します。「取り付けられる」と「必要な情報を受け取れる」の両方を扱う段階です。

    第二段階は、組み上げたラックの試験です。負荷を変えたときの給電、Power ShelfとBBU(バッテリーバックアップユニット)の切替、温度や流量の偏り、機器の繰り返し挿抜を確認します。資料にある40%から100%への負荷変化は具体例であり、すべての設備にその条件だけを適用すれば十分という意味ではありません。実際の負荷の変わり方や、機器が許容する条件に合わせて試験を決めます。

    第三段階は、施設・運用とつないだ試験です。施設の給電や接地、CDUやポンプの異常、計算処理の退避と復旧、保守・報告の手順を扱います。前の段階で部品が正常でも、現場側の条件が合わなければ、この段階は合格にできません。三段階はKim氏が示した導入検証の枠組みであり、ORv3の一律の認証手続を示すものではありません。[1]

    BBUがあると、どの故障まで支えられるのか

    三段階に分ける理由は、同じ「冗長化」でも守る範囲が違うからです。資料の電源構成では、通常のPower Shelfと停電時のBBUが、同じ48V系バスバーへ給電します。BBUは交流入力が失われたときの供給を補いますが、IT機器まで完全に独立した二つの電源経路を作る構成としては示されていません。[1]

    この接続関係から考えると、「BBUへ切り替わった」という試験結果だけでは、共通のバスバーや接続点で起きる問題への備えまでは判断できません。設備ごとに、どの部分を共有し、どの故障で何台が影響を受けるかを確認する必要があります。

    たとえば、交流入力の喪失を想定した試験なら、切替時の電圧と給電継続を見ます。一方、共有する給電部分の異常を想定するなら、故障箇所を切り離す保護動作と、影響が及ぶ機器の範囲が論点になります。これは資料の構成から整理した検討例です。具体的な異常の与え方は、機器・施設の試験計画と安全手順で定めます。

    抜き差しのしやすさを、仕事の復旧までつなぐ

    液冷のBlind Mate(ブラインドメイト)は、機器の挿入・引出しに合わせて、背面の冷却液接続を着脱する仕組みです。BMQC(Blind Mate Quick Connector)によって、背面でホースを一本ずつ手でつなぐ作業を減らせます。しかし、処理中の仕事を退避することや、電源を安全な状態にすることまで、コネクターが代わりに行うわけではありません。[1]

    資料の交換手順例は、計算処理の退避、電源状態の確認、機器の引出しと交換、再挿入後の検証を一続きに並べています。再挿入後には、電源だけでなく流量・温度・漏れも、それぞれの管理経路から確かめます。漏れを抑える接続構造でも、すべての条件で漏れがなくなるとは扱っていません。[1]

    保守計画では、「交換作業が終わった時点」と「計算処理を戻してよい時点」を分けると、担当の境界が明確になります。機器の交換時間だけが短くても、冷却状態の確認や復旧判断に長くかかれば、サービスの停止時間は縮まりません。ここは交換機構の性能から、運用全体へ評価を広げる部分です。

    試験結果を、誰が使える記録にするか

    Kim氏は、電力・冷却・機器管理・施設・計算処理の情報を、共通の時刻やラック/ノードIDで結び付ける構成も示しています。[1] これを試験の記録へ当てはめると、単に警報件数を数えるより、原因と影響を追いやすくなります。

    たとえば、冷却流量が下がる異常を想定するとします。流量低下の記録、機器温度の変化、性能を抑えるスロットリング、処理の退避開始を、同じラック・機器・時刻に対応付けます。すると「警報は出たが退避開始が遅れた」のか、「退避は始まったが対象機器を取り違えた」のかを切り分けられます。これは編集上の例であり、同社が実測して報告した障害事例ではありません。

    受入試験を依頼する際は、試験条件と測定結果に加えて、故障時の対応シナリオ、接続条件を承認する担当者、復旧手順を成果物に含めるとよいでしょう。資料p.26も、試験成績書だけでなく、障害シナリオ、インターフェース承認表、運用Runbookを並べています。

    既存設備の変更を小さくしたい場合には従来ラックの補強、段階的に検証したい場合にはORv3専用の列や区画、新設・大規模増設なら施設と一体の設計という選択肢が、資料では示されています。どれを選んでも、判断の軸はラックの最大電力だけではありません。許容できる停止、既存設備を残す範囲、保守を担う人と手順までそろえて、試験で確かめる対象を決めることが導入への一歩になります。[1]

    参考資料

    1. SungYun Kim(김성윤、TERATEC)「OCP ORv3 기반 고밀도 랙 표준의 현황과 국내 AIDC 적용 방안」。OCP公式一覧の英題は「Current Status of OCP ORv3-Based High-Density Rack Standards and Implementation Strategies for AIDC in Korea」。発表スライド(全29ページ)。本文では主にpp.11–18・26–27を参照。
    2. Open Compute Project「2026 OCP Korea Tech Day」公式発表一覧。2026年8月21日開催、登壇者と資料の掲載先を確認。

    資料確認日:2026年10月10日。韓国での導入を扱う公開講演資料に基づく技術解説です。個別製品の認証・性能保証や、日本の施設への適合判定を示すものではありません。

  • SK Broadbandのデータセンター運用案、テレメトリーで電力と冷却をつなぐ

    SK Broadbandのデータセンター運用案、テレメトリーで電力と冷却をつなぐ

    たとえば、稼働中のデータセンターで、ラックの消費電力と冷却液の温度が近い時間帯に上がったとします。記録の時計がずれていると、どちらが先に変わったかも分かりません。AIデータセンターの運用では、設備を増やす前に、判断に使えるデータをそろえることが欠かせなくなっています。[1]

    2026年8月のOCP Korea Tech Dayで、SK BroadbandのPark Jaewook氏は、運用を四つの仕事に分けました。①データの品質、②手順と知識、③電力と冷却の連携、④運用者の役割です。発表は構想と例を交えた提案で、示された時間や精度の目標が、すべての施設で達成済みという意味ではありません。[1・2]

    簡単にまとめると?

    • 電力と冷却を一緒に見るには、測定値の単位・周期・欠損の扱いと時刻をそろえる必要があります。
    • 電力の変化を冷却の先行信号に使う案ですが、制御条件は自施設の遅れや安全装置と合わせて確かめます。
    • AIは検証しやすい作業から段階的に使い、専門家の判断を残す提案で、自律制御の完成報告ではありません。

    まず、同じ出来事を同じ時刻で見る

    センサーの値は、届くだけでは十分ではありません。記録が抜けていないか、測定器のずれはないか、同じ「流量」が機器ごとに別の単位や周期で届いていないか。さらに、設備の時計がずれていれば、障害の前後関係まで曖昧になります。発表資料は、この四つをデータ品質の問題として並べています。[1]

    そこで必要なのが、集める項目と単位、収集周期、欠損の扱いを先に決め、計測網と時刻同期を設計することです。時刻をそろえれば「電力の変化が冷却の異常より先だったか」は確かめやすくなります。ただし、順番が分かっても、それだけで因果関係は決まりません。現場の構成や他の記録と突き合わせる工程は残ります。[1]

    次に、経験を点検できる手順へ移す

    運用者の頭の中にだけある判断を、設備図、過去の事例、手順書、警報の条件と結びつける。資料は、その最初の題材にイベントログを選びます。たとえば冷却液の流量が下がり、フィルターの前後で圧力差が増えたとき、システムが「詰まりの可能性」を示し、運用者が値と条件を確かめる形です。発表スライドの数値入り事例は説明用の例であり、導入施設の実績とは読みません。[1]

    AIエージェントを使うとしても、まずはログの要約や候補の提示から始め、誤りを測れるようにする。資料も、専門家が最終判断する形と、簡単で検証しやすい作業から段階的に広げる考え方を示しています。液冷装置や電源の自動制御まで完成した、という発表ではありません。[1]

    電力を、冷却の少し先にある手がかりにする

    GPUの仕事量が変わると電力が先に動き、その熱が冷却液の計測点に届くまでには時間差が生じます。温度が上がってからポンプを動かすだけでは、対応が遅れる場合があります。発表は、まずラックの電力変化を先行する信号として使い、将来は仕事量の情報まで組み合わせる案を示しました。[1]

    ここで大事なのは、資料にある秒数をそのまま制御設定へ写さないことです。熱が伝わる時間は、チップ、配管、流量、センサーの位置で変わります。自施設で遅れを測り、冷却の能力や安全装置との関係を確かめてから、予測や制御の条件にします。電力と冷却をつなぐ発想は有用ですが、早く反応させれば必ず安全、とは言えません。[1]

    運用する人を、設計の初めから入れる

    計測点や配線が固まった後で運用者が参加しても、必要なデータを後から取りにくくなります。資料は、名称や単位、判断条件を設計段階から合わせ、試運転で実際に読めるか確かめる役割を運用者に求めています。複数の施設を一画面にまとめるときも、画面を作る前に共通の項目と時刻の基準が必要です。[1]

    OCPにも、施設の電力・温度などのテレメトリーを扱う取り組みと、IT機器と施設側の管理を近づける「Open Data Centers for AI」があります。ただし、発表スライドに並ぶすべての文書や数値が、そのまま確定した統一規格ではありません。今回の資料は、既存の公開資料を確かめつつ、現場で足りない定義を探す入口として読むのがよさそうです。[1・3・4]

    AIデータセンターを安定して動かす道筋は、派手な自律制御から始まるわけではありません。欠損のない計測、同じ時刻、説明できる判断条件、そして運用者が止められる手順。その土台があって初めて、電力と冷却を一緒に見守れるようになります。

    SK Broadbandの通信・メディア事業とデータセンター事業は、cyclewaveの企業記事で整理しています。

    参考資料

    2026年9月23日確認。発表資料に含まれる対応時間・損害額・精度目標は、一般施設の実測値やOCPの一律要件として用いていません。講演動画・質疑応答は根拠に含めていません。

    [1]SK Broadband / Park Jaewook「F1-Style AI DC Operations: 4 Core Pillars」OCP掲載スライド(27頁。四つの仕事はp.7、データ品質はpp.8–9、運用知識はpp.11–12、電力と冷却はpp.14–15、運用者はpp.17–18)。

    [2]Open Compute Project「2026 OCP Korea Tech Day」発表一覧(開催日・登壇者・資料の掲載)。

    [3]Open Compute Project「Data Center Telemetry」(施設の電力・熱・機械系データを扱う取り組み)。

    [4]Open Compute Project「Open Data Centers for AI」(施設側とIT側のテレメトリーおよび管理の方向)。