AIの学習を複数の拠点で動かすとき、一部の通信が遅れて処理の完了を待たされることがあります。回線の平均使用率を見るだけでは、遅い通信がどの経路を通り、どこで待っていたのかまで分からない場合があります。
2026年のOCP Korea Tech Dayで、WooriNetのSunghyuk Park氏は、データセンター間を結ぶScale-Acrossの技術を紹介しました。その中にあるのが、機器の状態を集めるgNMIと、パケットの通過情報を記録するIOAMを組み合わせる案です。広く異常を見つける観測と、対象を絞って詳しく調べる観測を、どう使い分けるのでしょうか。[1][4]
簡単にまとめると?
- gNMIによる機器・ポートの統計と、IOAMによる対象パケットの通過記録では、分かることが異なります。
- 異常を見つけてから対象フローを詳しく調べる案ですが、過去に通過したパケットの記録を後から取り戻すことはできません。
- 使える機器、取得間隔、時刻と単位、追加する情報の負荷を確かめて、観測する範囲を決めます。
gNMIで、いつ・どの機器に変化があったかを見る
gNMI(gRPC Network Management Interface)は、機器の設定や状態をやり取りするための仕組みです。WooriNetの案では、ポートの状態やキューの量などを継続して集め、ECNの増加やキューの閾値超過を異常の手がかりにします。キューは、転送を待つパケットの待ち行列。ECNは、ネットワークの混雑をパケットに付けた印で知らせる仕組みです。[1]
ただし、gNMIを使えば何でも細かく測れるわけではありません。値が変わったときに送る方法や、指定した周期で送る方法などがあり、機器が対応する項目と間隔を選びます。周期を細かく設定しても、機器が対応できなければ、その要求は受け付けられません。[3]
この段階で得たいのは、調査の範囲を絞る手がかりです。あるポートで混雑の印が増えたとしても、その集計値だけで「遅い通信がここを通った」とは確定できません。通信ごとの経路を知るには、別の情報が要ります。
IOAMで、対象のパケットが通った場所を調べる
IOAM(In Situ Operations, Administration, and Maintenance)は、実データのパケットに観測用の情報を加える技術です。対応する途中の機器が、ノードや入出力ポートの識別情報、時刻、キューの状態などを記録します。別に送ったPingなどの調査用パケットが、実際の通信と違う扱いを受ける場合を補う方法です。[2]
見る対象が、機器全体の統計から、そのパケットが通過したときの状態へ変わります。全体の混雑と、調べたい通信が経験した混雑を結びつけるための情報です。もっとも、途中にIOAMへ対応しない機器があれば、そこから記録は得られません。記録のない部分を「問題なし」と読まないことが大切です。[2]
常時監視から、必要な通信だけの詳細観測へ
図1の上段は、gNMIによる常時監視から始まり、異常の兆候を受けて、問題のあるフローにIOAMを選択的に有効にする流れです。フローは、一連の通信を識別してまとめた単位です。WooriNetは、AI向け通信に使うRoCEv2のフローなどを例に挙げています。[1]
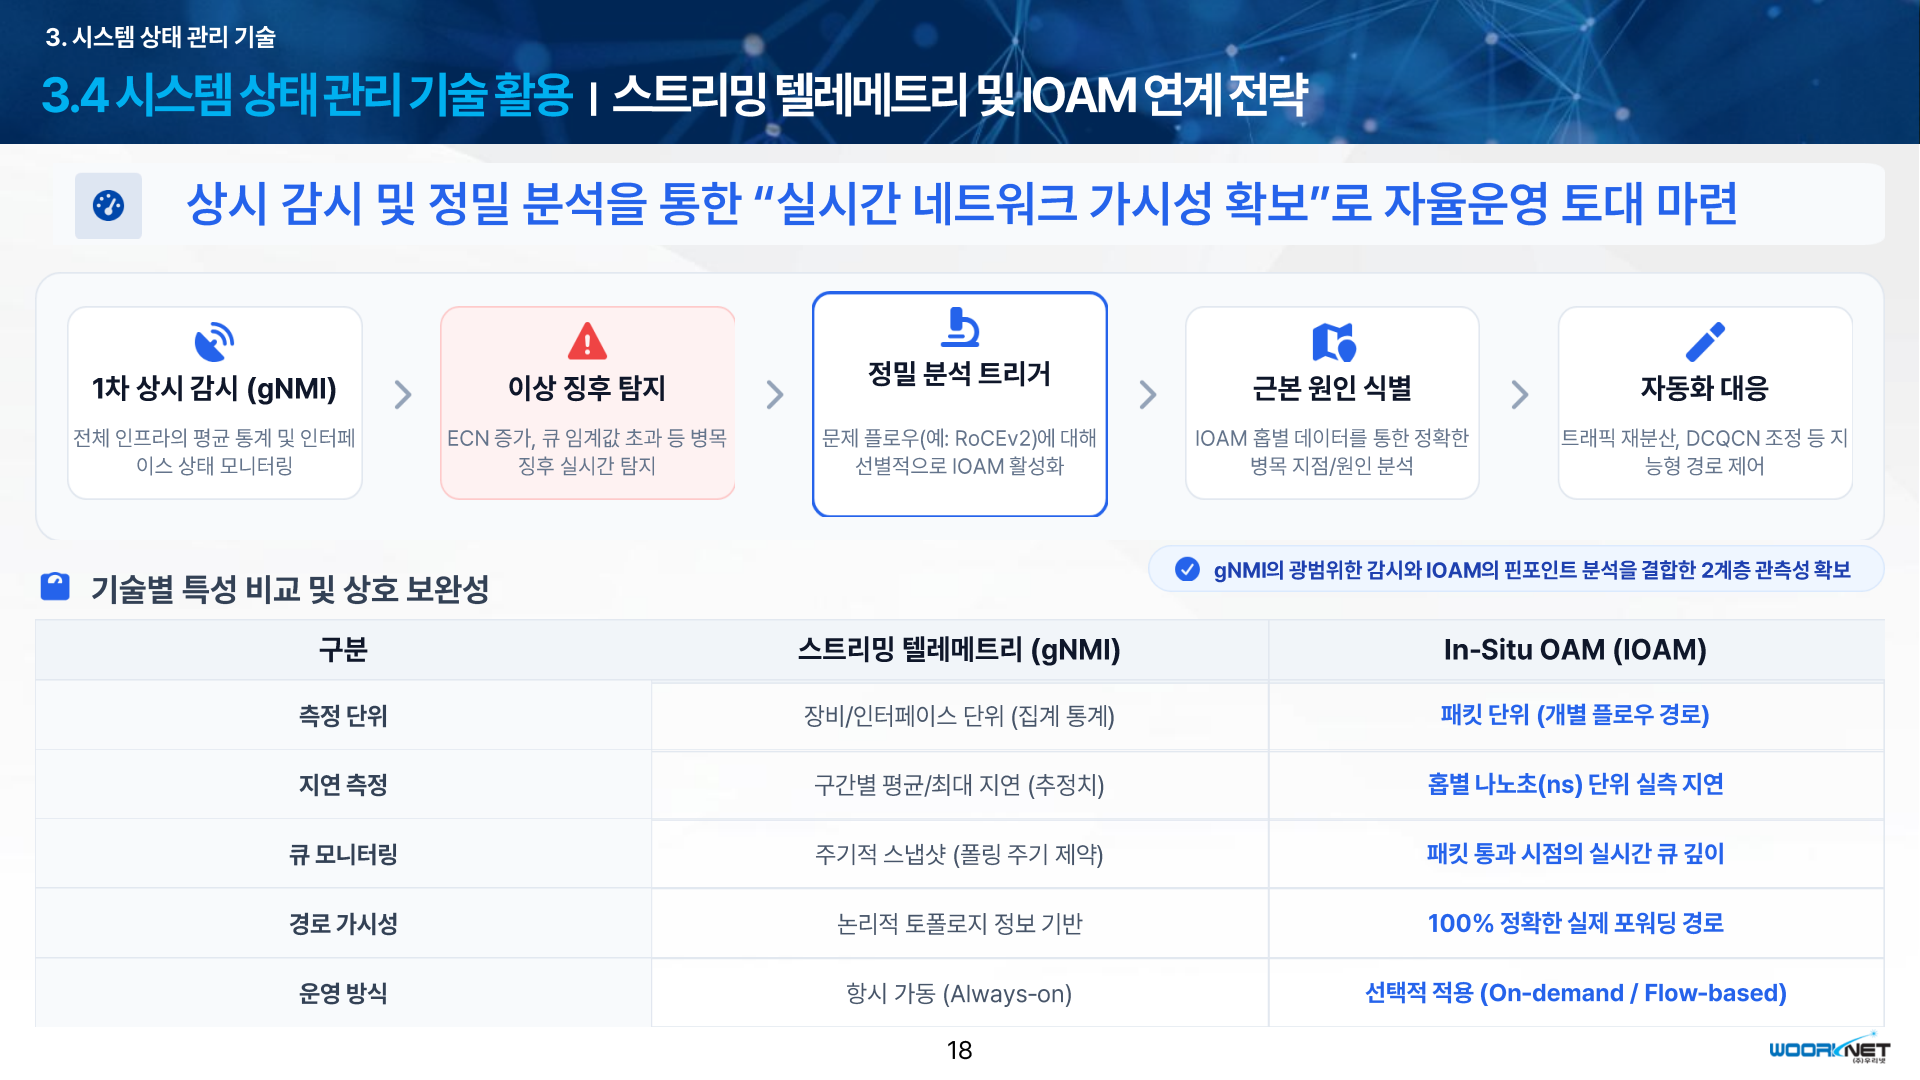
この分担の利点は、詳細な記録を取る範囲を絞れることです。IOAMは追加の情報を運ぶので、パケットが長くなり、機器での処理も増えます。常時すべてを詳しく測るか、対象を限定するかは、観測したい現象と許容できる負荷で決めます。別の調査用パケットを送らないことと、観測の負荷がゼロであることは同じではありません。[2]
図の下段にある「100%」や「ns」という表現にも条件があります。全経路が見えるかは途中の機器の対応範囲に左右され、時刻の細かさがそのまま測定の正確さになるわけではありません。異なる機器の時刻を引き算するなら、時計のずれも考慮する必要があります。[2]
二つの経路の一方だけが遅いとしたら
ここからは、仕組みを理解するための例です。拠点AとBの間に複数の経路があり、ある学習ジョブの通信だけが遅くなったとします。まずgNMIで集めた記録から、その時間帯にどのポートでECNやキューの量が増えたかを探します。これで、詳しく調べたい機器と時間帯を絞ります。
次に、同じ通信で現象が続く、または繰り返すときに、対象フローへIOAMを適用します。パケットが実際に通ったノードと、その通過時のキューや時刻を突き合わせれば、疑っていた経路を通っていたか、途中のどこに待ちがあったかを調べやすくなります。集計値からの推測を、対象パケットの記録で確かめる順序です。
この方法で、すでに終わった現象を必ず再現できるわけではありません。IOAMを有効にする前のパケットには、その記録がありません。短時間で消える異常を対象にするなら、普段から残す統計の細かさと、詳細観測を始める条件を先に設計しておく必要があります。これは、異常を見つけた後に観測を始める方式の限界です。
導入前に合わせる四つの条件
どちらの方式を使うかに加えて、取得した値を比較できるかを確認します。たとえば同じ「キューの量」でも、装置が使う単位や測る位置が違えば、大小をそのまま比べられません。IOAMの仕様も、キューや共通バッファーの情報を扱う際に、実装ごとの意味を考える前提です。[2]
| 確認すること | 判断のために見る点 |
|---|---|
| 機器と観測範囲 | どの機器・ポートが値を返し、IOAMの途中記録を残せるか。記録のない区間を明らかにする。 |
| 時間と取得周期 | 現象の長さに対して取得周期は足りるか。機器間の時刻を比べるなら、同期状態と測定位置をそろえる。 |
| 値の意味と単位 | キューの量が何を数えた値か、共通バッファーの占有量と区別されているかを確認する。 |
| パケット長と処理負荷 | 情報を追加しても経路のMTUに収まるか。MTUは一度に運べるパケットの大きさの上限。対象フローと記録項目を絞れるかも見る。 |
表は、WooriNetの連携案とIOAM・gNMIの仕様を基に、導入時の確認事項として整理したものです。通信相手までの全区間を自分たちで管理できない場合は、とくに観測の境界を明らかにしておく必要があります。IOAMは、管理する範囲を定めて運用する技術として設計されています。[2][3]
原因を絞ることと、自動で直すことを分ける
WooriNetの図は、観測の先に、通信の再分散や送信速度を調整するDCQCNの設定変更も置いています。ただし、この資料は、変更を選ぶ具体的な条件、変更後の確認方法、失敗時に戻す手順までを示した運用実証ではありません。末尾には、2026年から2030年にかけての伝送システムと運用体制の研究開発計画が示されています。[1]
この発表から持ち帰れるのは、監視を細かくすれば自動的に通信が速くなるという話ではなく、調査の順序です。まず広い範囲で変化を捉え、次に対象の通信が通った場所を確かめる。自分たちが必要とする判断に対して、どこまでの記録があれば足りるかを決めることが、gNMIとIOAMを組み合わせる出発点になります。
参考資料
2026年10月10日確認。発表資料にある技術の説明と研究開発計画を扱い、商用導入の効果や性能値を検証した記事ではありません。
- Sunghyuk Park/WooriNet「Trends in Scale-Across Transfer Technology Between AI Data Centers」 — 全22頁。pp.16–18:gNMI・IOAMと連携案、pp.20–21:研究開発計画。
- IETF「RFC 9197: Data Fields for In Situ Operations, Administration, and Maintenance (IOAM)」 — 1・3・4.4・5節:観測範囲、データ項目、負荷、時刻の形式。
- OpenConfig「gRPC Network Management Interface (gNMI)」 — 3.5節、とくに3.5.1.5.2:購読方式と取得周期。
- Open Compute Project「2026 OCP Korea Tech Day」 — 公式の講演・発表資料一覧。