投稿者: SB-admin

  • 光の2量子ビットでLiHを計算、Q-DFTで残る密度更新の課題

    光の2量子ビットでLiHを計算、Q-DFTで残る密度更新の課題

    分子の電子の状態を、少ない量子ビットで調べたい。そのためには、同じ問題を小さく詰め込むだけでなく、何を計算するかを組み替える方法があります。電子一つひとつの複雑な組み合わせではなく、電子の分布を手がかりにする量子密度汎関数理論(Q-DFT)も、その一つです。

    2026年11月3日公開のプレプリントは、水素化リチウム(LiH)を対象に、Q-DFTで用いる計算を二つの光量子ビットで実行しました。ただし、実機で確かめたのは、あらかじめ用意した問題の最適化です。電子密度から問題を作り直す循環全体と、分子の結合を正確に描くことには課題が残りました。[1]

    簡単にまとめると?

    • 四つの軌道を基底として使うコーン・シャム問題を、2量子ビットへ符号化しました。電子間相互作用をすべて同じ精度で扱う多体計算とは条件が違います。
    • 光回路上で最適化は進みましたが、密度を更新する自己無撞着計算は実機では閉じていません。各段階の問題は、雑音のない古典シミュレーションから供給しました。
    • 測定数の不足と、光子を完全には区別不能にできないことが誤差に効きます。量子ビット数だけでなく、測定費用・結合の再現・循環の収束を分けて見る研究です。

    四つの軌道を、二つの量子ビットに載せる

    密度汎関数理論(DFT)は、電子の密度を使って物質の性質を求める方法です。よく使われるコーン・シャム法では、相互作用する多数の電子の問題を、密度に依存する有効な場の中で動く電子の問題に置き換えます。電子間の効果は有効な場に含めますが、実際には交換・相関を表す汎関数の近似が必要です。Q-DFTは、この枠組みの一部を量子計算で解きます。[1]

    今回使う基底は、リチウムの1s・2s・2pzと、水素の1sに対応する四つの直交化された軌道です。これらを2量子ビットの四つの状態に対応させます。四つの軌道を一度に四つの別々の量子ビットへ割り当てるのではなく、各軌道の重ね合わせを2量子ビットの状態として表すため、少ない量子ビットで扱えます。

    この縮約には前提があります。対称性から寄与しないリチウムの2px・2pyを除き、さらにコーン・シャムの一体問題へ移しています。論文が比較する多体波動関数の表現は、最小基底全体なら12量子ビット、同じ軌道の除外後でもJordan–Wigner変換では8量子ビットです。12から2という数字だけで、同じ多体計算をそのまま6分の1にしたとは読めません。[1]

    二つの占有軌道を、一緒に最適化する

    LiHには四つの電子があり、この計算では二つのコーン・シャム軌道を二個ずつ占有します。そのため、一番低い状態だけを探せば十分ではありません。研究では、二つの直交する初期状態へ同じ可変回路をかけ、二つのエネルギーの重み付き和を小さくするアンサンブルVQEを使いました。

    同じ重みで最適化する場合、重要なのは二つの状態が張る空間です。その中で状態の組み合わせが変わっても、和と電子密度を正しく求められます。各状態がそれぞれ厳密な固有状態に一致することを、最適化の必須条件にはしていません。ここでいう第一励起状態も、有効な一体問題の状態であり、LiH分子全体の励起をそのまま測ったものではありません。[1]

    光回路では、一つの光子が二つの経路のどちらを通るかで1量子ビットを表します。装置は8モードの集積回路で、実際の計算には4計算モードと2補助モードを使いました。二つの光子を入力し、回転とC-NOTに対応する操作を行い、出力を測って古典側で四つのパラメーターを更新します。

    ただし、このC-NOTは所定の検出結果を選び出す事後選択を必要とします。二つの量子ビットを表す各経路の組で、光子が一個ずつ検出された事象を採用します。入力した光子がすべて有効な計算結果になるわけではなく、将来の規模拡大では成功率と損失も数える必要があります。[1]

    実機で閉じていない、密度の更新ループ

    コーン・シャム法では、仮の密度から有効な問題を作り、それを解いて新しい密度を得ます。この更新を、密度とエネルギーが十分変わらなくなるまで繰り返します。これが自己無撞着計算、またはSCFループです。
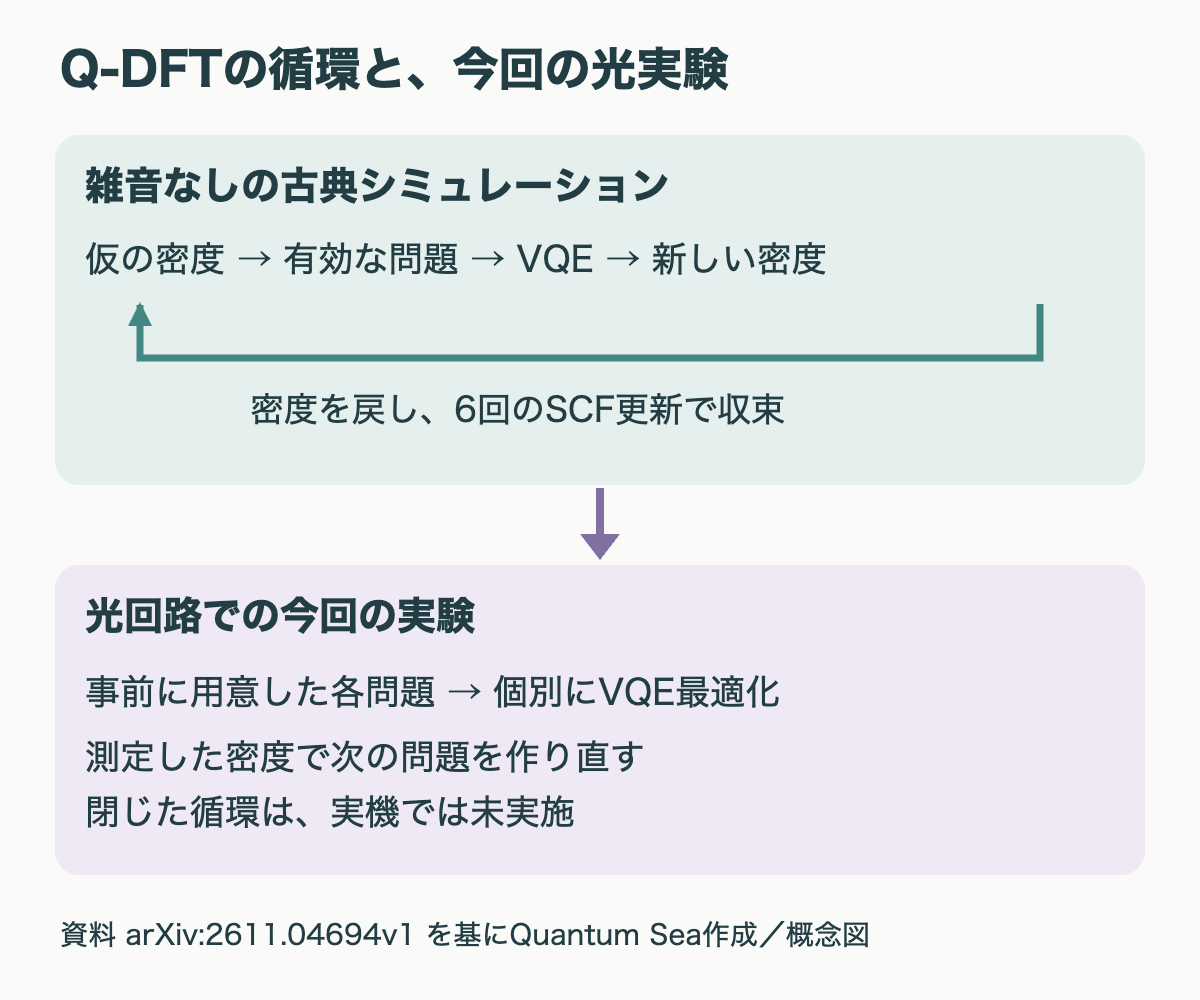
    雑音なしの古典シミュレーションでは密度から問題を作り直す循環を実行し、今回の光実験にはそこで用意した各問題を個別に渡したことを示す図。
    自己無撞着計算と、今回の光実験の範囲を分けた概念図。資料[1]を基にQuantum Sea作成。

    雑音のない状態ベクトルシミュレーションでは、この循環が6回の更新で収束しました。ところが、測定回数を有限にしたシミュレーションでは、10億ショットでも、同じ6回の範囲で完全には収束しません。後半の問題同士のエネルギー差が小さく、測定の揺らぎの中で見分けにくくなるためです。[1]

    そこで実験では、雑音のない古典シミュレーションから得た六つのハミルトニアン、つまり解くべき有効な問題を、個別に光回路へ渡しました。実機の測定で得た密度を次の問題へ戻して、循環全体を収束させたわけではありません。

    論文で分けて確かめたこと
    検証の場 確かめた範囲 残った条件
    雑音なしの古典シミュレーション 6回のSCF更新で収束し、参照計算へ近づく 交換・相関汎関数などの近似は残る
    有限測定のシミュレーション 測定の揺らぎで密度更新が停滞する影響 10億ショットでも6回以内の完全収束なし
    光量子回路の実験 事前に用意した各問題のVQE最適化と電子密度の推定 閉じたSCF循環と定量的に正確な結合描写は未達

    光子を増やすだけでは、消えない誤差

    測定回数が少ないと、光子を数える統計の揺らぎが目立ちます。一方、十分な数を集めても、二つの光子の区別不能性が完全でなければ誤差が残ります。干渉させたい光子に、見分けられる違いが残ると、意図した光回路の働きからずれるためです。

    実験のHong–Ou–Mandel干渉の可視度は約89%でした。これは光子の区別不能性を評価する指標で、計算全体の正答率ではありません。雑音モデルでは、測定数を増やすと誤差の支配要因が統計から区別不能性へ移ります。さらに、実際の装置にはモデルに含めていない位相制御などの誤差もあります。[1]

    電子密度を見ると、リチウム側から水素側への電荷の移動は実験でも表れました。しかし、原子間の結合に関わる密度の形は参照結果とずれ、イオン結合を定量的に正確に描くには足りませんでした。「最適化の値が下がった」と「化学的に必要な答えが得られた」を分ける意味が、ここにあります。

    この研究から読み取れるのは、少ない量子ビットへ問題を写す工夫と、それを測って更新する費用は別だということです。次の比較では、符号化する量子ビット数に加え、採用できる検出事象の割合、密度の精度、閉じた循環の収束、全体の計算時間をそろえる必要があります。大きな分子での量子優位を示した段階ではありません。シミュレーションには公開ソフトウェアが使われていますが、この研究の結果を支えるコードとデータは請求に応じて提供すると記されています。公開実装があることと、結果一式が公開され再現確認済みであることも分けて捉えたいところです。

    出典

    1. Giovanni Adrianoほか「Quantum Simulation of Electronic Structure using Quantum Density Functional Theory on a Programmable Integrated Photonic Circuit」、arXiv:2611.04694v1、2026年11月3日投稿。論文・書誌情報。
  • VQEの初期角度、早い誤差低下が雑音込みの収束につながらない理由

    VQEの初期角度、早い誤差低下が雑音込みの収束につながらない理由

    量子回路を少しずつ調整して答えを探す計算では、最初に誤差が速く減る設定が、最後まで有利とは限りません。雑音のない計算なら順調に見えても、雑音を含む答えは途中で改善しにくくなることがあります。

    2026年11月3日公開のプレプリントは、この違いを変分量子固有値ソルバー(VQE)の数値シミュレーションで調べました。着目したのは、量子回路の角度をどの範囲から選んで計算を始めるか。答えの良さと雑音への敏感さを分けて追うことで、初期値によって遠回りが生じる仕組みを探っています。[1]

    簡単にまとめると?

    • 8スピンのモデルでは、広い範囲の初期角度が雑音なしの誤差を速く減らす一方、雑音を含む目標への到達は遅れました。
    • 停滞時には、理想的なエネルギーを下げる方向と、雑音によるずれを増やす方向が競合します。二つを足した改善の手がかりが小さくなります。
    • 小さな初期角度の効果は、特定のモデル・雑音・最適化法で調べた結果です。更新回数の短縮を、実機の実行時間や測定回数の短縮と同一視はできません。

    同じ回路を、雑音あり・なしで読み直す

    VQEは、パラメーターを持つ量子回路で状態を作り、そのエネルギーを評価して、より低くなるよう古典側でパラメーターを更新する方法です。エネルギーが最も低い基底状態を、回路が表せる範囲で探します。

    今回の主な対象は、8個のスピンが輪につながったハイゼンベルク模型です。16層の回路には640個の角度があり、各ゲートの後に局所的な脱分極雑音を加えました。これは、確率的に量子状態の向きを乱す理想化された雑音モデルです。主な雑音条件はp=0.001で、実際の装置を動かした実験ではありません。[1]

    研究では、雑音を含めて学習した各時点の角度を、同じまま雑音なしでも計算し直します。これにより、基底状態からの全体の誤差を、雑音がなければ残る誤差と、雑音を加えることで生じたエネルギーのずれに分けられます。両者を混ぜると、「理想的な状態をうまく作れてきた」と「雑音込みの答えが良くなった」を取り違えてしまいます。

    初期角度の幅で、途中の進み方が変わる

    比べたのは五つの初期化です。横方向の回転を小さな範囲から始めるか、広い範囲から始めるかに加え、各層を同じ初期値にするか、別々にするかも変えました。層の繰り返しを課すのは初期値だけで、その後はすべての角度を独立に更新します。[1]

    下の表は、各層を別々に初期化する二つの設定に絞った比較です。小さく始める設定Bでは、横方向の角度を−0.2〜0.2ラジアンに収め、縦方向は広い範囲にします。設定Dでは、どちらも−π〜πの範囲から選びます。

    8スピン・16層・p=0.001での比較
    比べる項目 横方向を小さく始めるB 両方向を広く始めるD
    雑音なしで読み直した誤差が5%以下になる更新 104回 32回
    雑音込みの誤差30%以下に、試行の半数が到達する更新 31回 343回
    600更新後の雑音込み誤差の中央値 23.99% 24.64%

    資料[1]の表II・IIIから整理。各設定20個の乱数シードを用います。最初の行は成功した試行の初回到達更新の中央値で、この比較では両設定とも20試行が到達しました。二行目は未到達も含めた累積到達率が50%になる時点です。「更新」は厳密に求めた勾配によるAdamの1ステップであり、量子測定1回を意味しません。

    広い初期値Dは、雑音なしで読み直した答えを早く改善しています。しかし、雑音込みの目標へはBより遅く到達しました。600更新後には両者の誤差は近づきます。途中の差を、そのまま永続的な精度の差と見ることもできません。

    改善する二つの方向が打ち消し合う

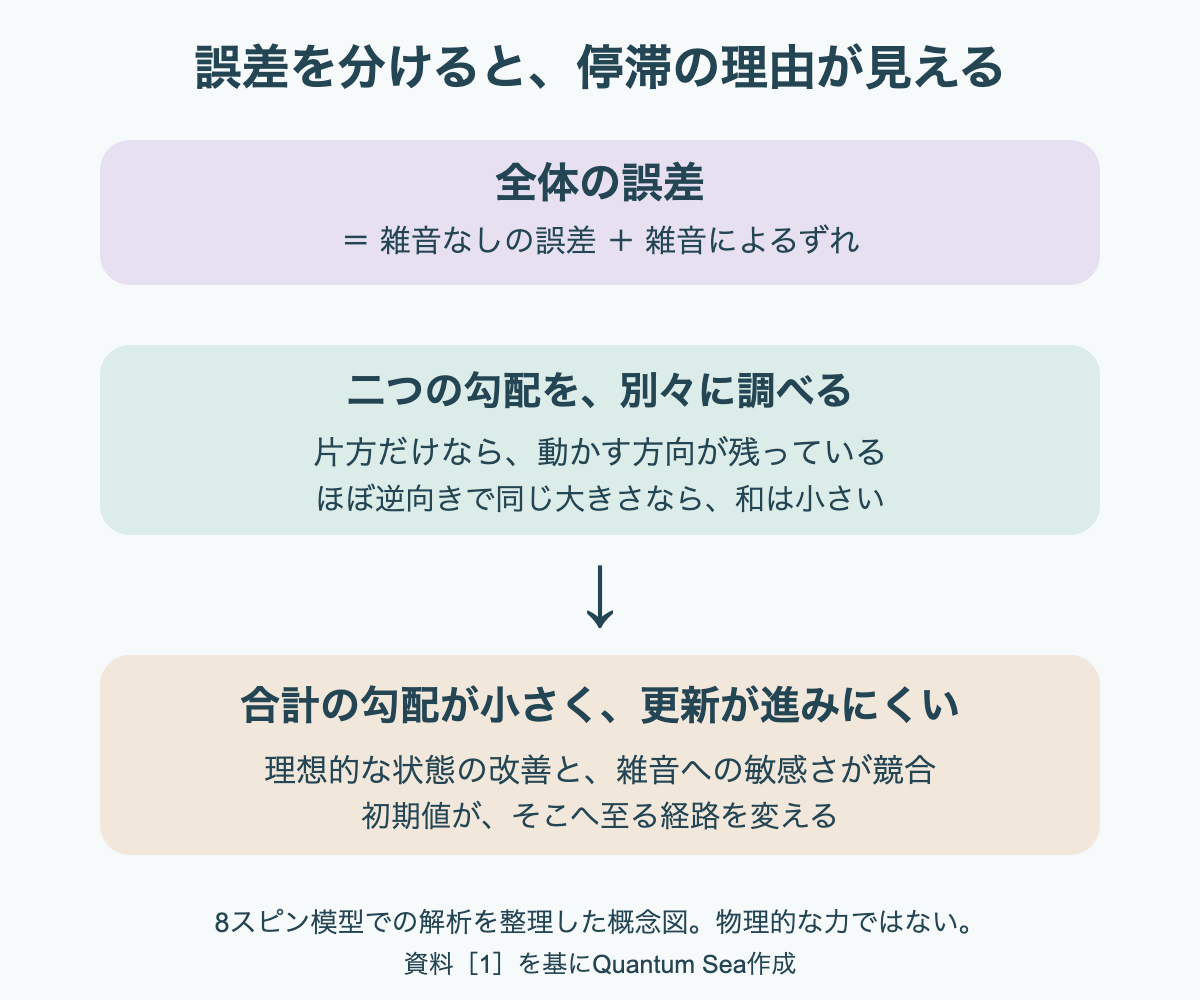
    パラメーターをどちらへ動かすと評価値が変わるかを示す量が、勾配です。今回の解析では、理想的なエネルギーの勾配と、雑音によるずれの勾配を分けます。停滞した領域では、片方だけなら動かす手がかりが残っているのに、二つがほぼ逆向きで釣り合っていました。[1]

    全体の誤差を、雑音なしの誤差と雑音によるずれに分ける概念図。二つの勾配が逆向きに釣り合うと、足し合わせた勾配が小さくなり更新が進みにくくなる。
    誤差と勾配の分解を整理した概念図。力を実際に加える実験ではなく、パラメーター空間での方向を示しています。資料[1]を基にQuantum Sea作成。

    たとえば、角度を動かすと雑音のないエネルギーは下がっても、その状態が故障に敏感になり、雑音による上昇が増えるなら、合計の改善は小さくなります。研究はこの停滞を、勾配そのものが消える通常の「不毛の台地」と区別しています。ただし、実機で直接測れるのは基本的に合計の勾配なので、その小さな残りを読み取る費用も問題になります。

    小さな横方向の初期角度は、初期段階で局所的な故障の作用が回路内へ広がるのを抑えます。ただし、作用がどこまで広がるかと、現在の状態のエネルギーをどれだけ変えるかは別の指標です。計算が進むと、広がりが縮むより先にエネルギーへの敏感さが下がる例もありました。初期化だけで雑音がなくなるという話ではありません。[1]

    実機へ移す前に、残る条件を見る

    この結果で使った勾配は、シミュレーションから厳密に求めたものです。有限回の測定から勾配を推定する実機では、推定の揺らぎが加わります。また、エネルギー緩和など、今回と異なる種類の雑音で同じ釣り合いになるかも未検証です。

    8スピンで見えた広い初期値の早い進み方は、10スピンの比較計算では維持されませんでした。回路の表現力と、対象の大きさの関係が変わるためです。さらに、今回のAdamとは異なる単純な勾配降下法なら、雑音による勾配の縮小が進む速さに別の形で効きます。[1]

    したがって、初期化を選ぶ際の比較材料は、最初の誤差の下がり方だけでは足りません。同じ雑音条件で目標へ到達する割合、必要な更新数、最後に残る誤差、測定から勾配を得る費用をそろえる必要があります。今回のプレプリントは、その比較を分解して考える材料です。実機での高速化や、大規模な問題への一般的な優位を示したものではありません。研究データとソフトウェアは公開されていないと記載されており、外部からの再現確認も残ります。

    出典

    1. Longhui Shen、Fangzhou Jin、Bin Guo「Initialization-controlled fault sensitivity and force-balance plateaus in noisy variational quantum optimization」、arXiv:2611.04198v1、2026年11月3日投稿。論文と書誌情報。
  • IBM・理研らのSQD、電子状態の出発点を工夫して精度を改善

    IBM・理研らのSQD、電子状態の出発点を工夫して精度を改善

    量子コンピューターで分子を計算するとき、測定を増やすだけで精度が上がるとは限りません。どの電子状態を出発点にして、測定結果からどの配置を残すか。その選び方も、最後の答えに影響します。

    IBM、理化学研究所、NVIDIAの研究者らが2026年11月3日に公開したプレプリントは、サンプルベース量子対角化(SQD)の出発点を見直した研究です。鉄と硫黄を含む分子モデルで、電子のスピンの偏りを許す参照状態を使い、量子測定と古典計算を組み合わせて基底状態のエネルギーを求めました。注目したいのは、計算した値と、そこから外挿した値の違いです。[1]

    簡単にまとめると?

    • SQDは量子回路で電子配置の候補を測定し、候補を絞った空間で古典計算を行う方法です。
    • スピン対称性を破ったBS-UHF参照状態を使い、鉄硫黄クラスターの計算を改善しました。ただし、出発点だけでなく、残す配置数や回復計算の回数も結果に関わります。
    • 直接計算したSQDと有限精度のDMRGとの差は約4.3 mHa。別々に外挿した推定値の差0.33 mHaとは、比較の段階が異なります。

    量子測定は、計算する電子配置の候補を集める

    分子中の電子には、多くの軌道への入り方があります。軌道とは、電子が取りうる空間的な状態を表すものです。その組合せをすべて扱うと、必要な計算量が急速に大きくなります。

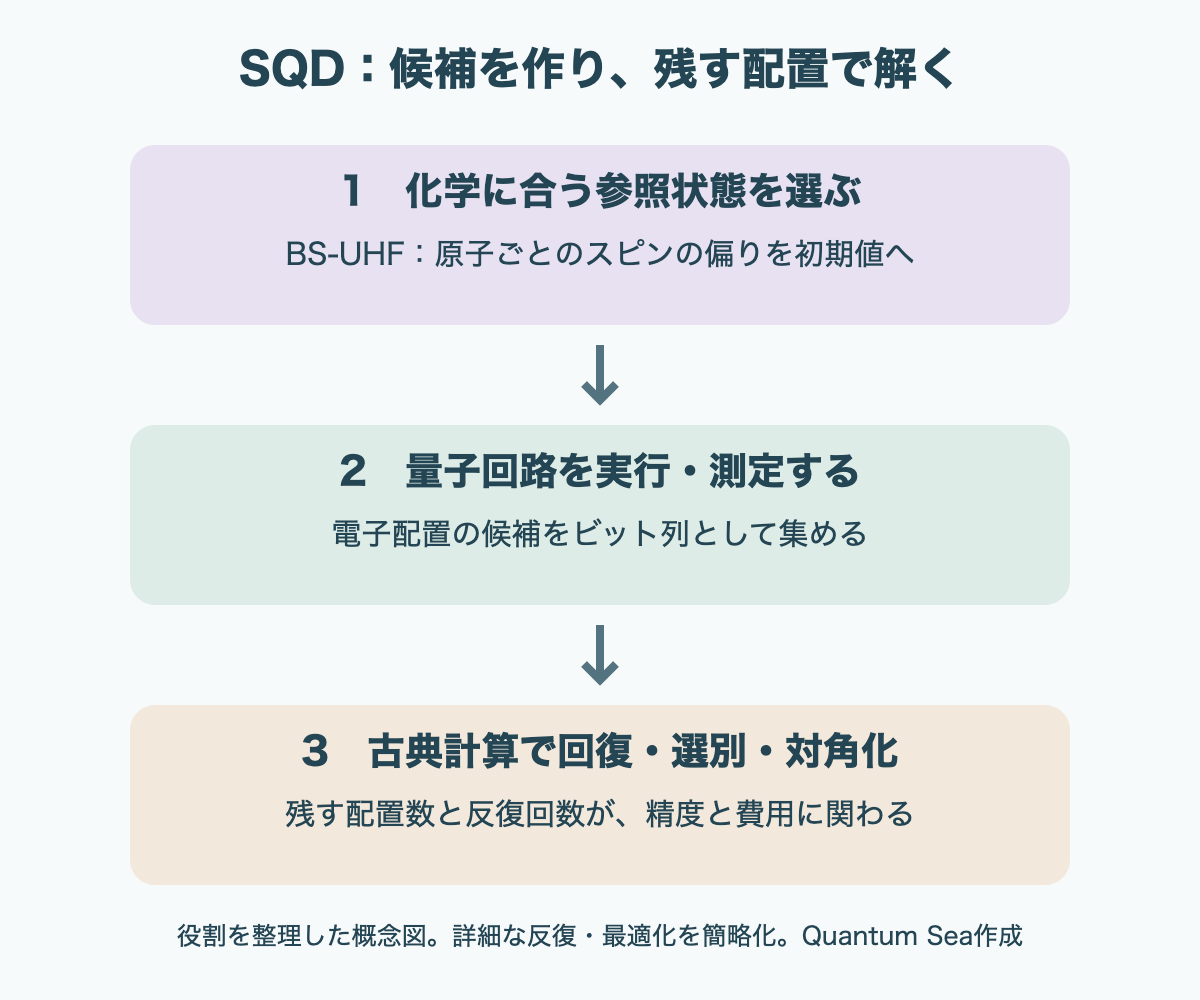
    SQDでは、まず量子回路を実行し、測定されたビット列から電子配置の候補を得ます。雑音の影響で電子数などの条件を満たさない結果は、配置回復(configuration recovery)という処理で修正します。そのうえで候補の一部を選び、そこに限定したハミルトニアンを古典コンピューターで対角化します。これは、選んだ配置を組み合わせて、どこまで低いエネルギーの状態を表せるかを解く工程です。[1]

    たとえば、よく現れる配置を残そうとしても、最初の回路が重要な配置をほとんど生まなければ、後段で選べる候補は偏ります。逆に、候補があっても計算に残せる数が少なければ捨てられます。量子側の状態の作り方と、古典側の選別・計算の規模は、つながった問題です。

    参照状態を選び、量子回路で電子配置を測定し、古典計算で配置回復と対角化を繰り返すSQDの流れ。出発点、候補の質、残す配置数、反復回数を別々の判断項目として示す。
    SQDの役割分担を整理した概念図。配置回復と対角化には反復があり、量子測定の時間だけでは全体の計算時間を表せません。資料[1]の説明を基にQuantum Sea作成。

    同じスピンの扱いに縛られない出発点

    今回の対象は、鉄と硫黄を含むクラスターです。主な計算では、54電子・36空間軌道を選んだモデルを扱います。このような系では電子どうしの相関が強く、一つの単純な電子配置だけで状態を十分に表せません。[1]

    従来の出発点で使われる制限Hartree–Fock法(RHF)は、上向きと下向きのスピンの電子に共通の空間軌道を使います。今回用いたBS-UHF(スピン対称性を破った非制限Hartree–Fock法)では、その制限を緩めます。鉄の中心ごとに逆向きのスピンの偏りを与えた初期値から計算を始め、より低いエネルギーの参照状態を探しました。[1]

    単に設定名をUHFへ変えればよいわけではありません。初期値に偏りがなければ、計算がRHFと同じ対称な解へ戻る場合があります。研究では、原子の位置と磁気的な結び付きを踏まえた初期値や、得られた解の安定性の確認を組み込みました。参照状態は、量子回路の初期状態やパラメーター、測定結果を回復する際の初期の占有情報に影響します。[1]

    一方で、この参照状態は全スピンの値が一つに定まる状態ではありません。異なる全スピンの成分が混ざる「スピン汚染」があり、エネルギーが下がっただけでそれが解消したとは言えません。今回の結果を、スピンの違いが重要なスペクトルや状態間のエネルギー差へ、そのまま適用することはできません。[1]

    4.3 mHaと0.33 mHaは、別の比較

    主な実験ではIBMの量子プロセッサーibm_kingstonを用い、72個のデータ用量子ビットに、接続を補う補助・経路用の量子ビットを加え、計88個を回路に使いました。72個は電子の軌道占有を表すデータの数で、誤り訂正された72論理量子ビットを実証したという意味ではありません。測定したサンプルを再利用し、古典側で配置回復を繰り返しています。[1]

    比較相手の密度行列繰り込み群(DMRG)も、計算資源に応じて近似の精度が変わる古典計算法です。SQDが残す部分空間の次元dと、DMRGの表現力を調整するボンド次元Dは異なる量です。次の数値は、同じ桁の資源を使った比較という意味ではありません。

    鉄硫黄クラスターのエネルギー比較
    比較する段階 SQDとDMRGの差 読み方
    直接計算したSQDと有限DのDMRG 約4.3 mHa SQDはd=3×10¹⁰、DMRGはD=4000。実際に計算した二つの値の差
    直接計算したSQDと外挿したDMRG 約9.7 mHa DMRG側の有限資源による誤差を外挿で見積もると、比較基準も下がる
    両手法をそれぞれ外挿した推定値 約0.33 mHa SQDの誤差幅±1.05 mHa、DMRGの±0.46 mHaの範囲内で整合

    資料[1]の表IV・図7・結論から整理。mHaはエネルギー単位Hartreeの1000分の1です。直接計算したSQDの値は−327.235076 Ha、D=4000のDMRGは−327.2393952 Ha。これらの差は4.3192 mHaとなります。

    外挿は、限られた計算結果に式を当てはめ、さらに大きな資源を使った先の値を推定する手続きです。今回のSQDの最大計算空間は、対象モデルの全配置空間の約0.00034%にとどまります。報告された誤差幅は当てはめに伴う統計的な見積もりで、外挿式の選び方などの系統的な誤差をすべて保証するものではありません。0.33 mHaを、その精度で直接計算できたという数字に置き換えないことが大切です。

    出発点と、計算全体の条件を一緒に見る

    研究では、富岳、Miyabi-G、ROQUOで古典側の処理を動かし、チェックポイントから計算を再開できることも調べています。三つのシステムを同時に束ねて一つの答えを計算したのではなく、それぞれの実行環境で動かした結果です。[1]

    量子プロセッサーの利用時間として示される約25分は、古典側の長い回復・対角化を含む総所要時間ではありません。また、論文に示されたROQUOの時間測定は2026年7〜8月の構成に基づきます。異なるソフトウェアや資源配置で得た時間を、現在のハードウェア単体の性能順位に読み替えることも避ける必要があります。[1]

    従来のRHFを出発点にした研究との大きなエネルギー差についても、部分空間の大きさ、反復の深さ、サンプル、量子ハードウェアが異なります。論文の結論が留保する通り、差のすべてを参照状態だけの効果とするには、条件をそろえた比較が必要です。

    今回の研究が示すのは、量子ビット数や測定回数に加え、化学的に適切な出発点と、そこから候補を残す仕組みを見直す余地です。次の成果を読むときも、直接計算か外挿か、比較基準は有限精度か、古典計算を含む費用はどうかを分けると、改善の意味を捉えやすくなります。プレプリント段階の結果であり、量子計算の速度優位や実用的な反応エネルギーの精度まで実証したものではありません。

    研究を支える企業の位置付けは、CyclewaveのIBMの事業と量子計算への取り組み、NVIDIAのGPU・ソフトウェア基盤で解説しています。

    出典

    1. Kunal Kumarほか「Broken-Symmetry Reference States for Sample-Based Quantum Diagonalization with Near-DMRG Accuracy」、arXiv:2611.04496v1、2026年11月3日投稿。論文と書誌情報。
  • 準確率で見る量子の不確かさ、混合状態に残る下限

    準確率で見る量子の不確かさ、混合状態に残る下限

    量子状態を完全に知っていても、測定結果をすべて言い当てられるとは限りません。たとえば一つの量子ビットで、Z方向の測定結果が0と決まる状態を用意しても、X方向の測定では二つの結果が半々になります。状態についての知識と、測定結果の不確かさは、同じものではありません。

    2026年11月2日に公開されたJonathan J. Thio氏らのプレプリントは、この不確かさを準確率という量子状態の表現で調べています。二つの測定を一つの表に結び付けると、表の広がりにはどんな下限があるのか。特定の表現と非負の条件の下で、混合状態の不確かさが、最小値を達成する純粋状態より小さくならないことを示した理論研究です。

    簡単にまとめると?

    • 準確率は量子状態を数の表へ写す方法です。一般には負の値や複素数も現れるため、普通の確率と同じ扱いはできません。
    • 対象とする非負の表では、状態がどれほど混ざっているかを表す「純度」から、エントロピーの下限を求められます。
    • 結論には表現と測定基底の条件があります。すべての純粋状態が最小になるわけでも、任意の準確率で同じ下限が成り立つわけでもありません。

    二つの測定を、一つの表に結び付ける

    ここでは、Kirkwood–Dirac(KD)準確率を考えます。行には測定Aの結果、列には測定Bの結果を並べ、それぞれの組に量子状態から計算した数を割り当てます。行ごと、列ごとに足すと、Aだけ、Bだけを測ったときの通常の確率が得られるのが特徴です。

    ただし、表の中身は一般には実数に限らず、負の値や虚数部分を持つことがあります。そのため、二つの測定結果が同時に確定していて、その組が表の確率で出現する、と解釈することはできません。とくに、測定を順番に実施したときの結果の表と、そのまま同じだと思わないことが大切です。

    今回の主結果で重要なのが、互いに偏りのない基底(MUB)です。一方の測定結果が確定する状態を用意したとき、もう一方では全結果が等しい確率で出る関係を指します。1量子ビットのZ基底とX基底は、その具体例です。

    著者らは、KD表の実部を取ったMargenau–Hill(MH)分布も使います。主なエントロピーの不等式は、この実部の表がすべて非負になる状態に適用されます。KD表自体が非負の実数ならもちろん含まれますが、KD表に虚数部分があっても、実部が非負なら含まれます。この二つの条件は区別する必要があります。

    四つのマスで比べる、1量子ビットの例

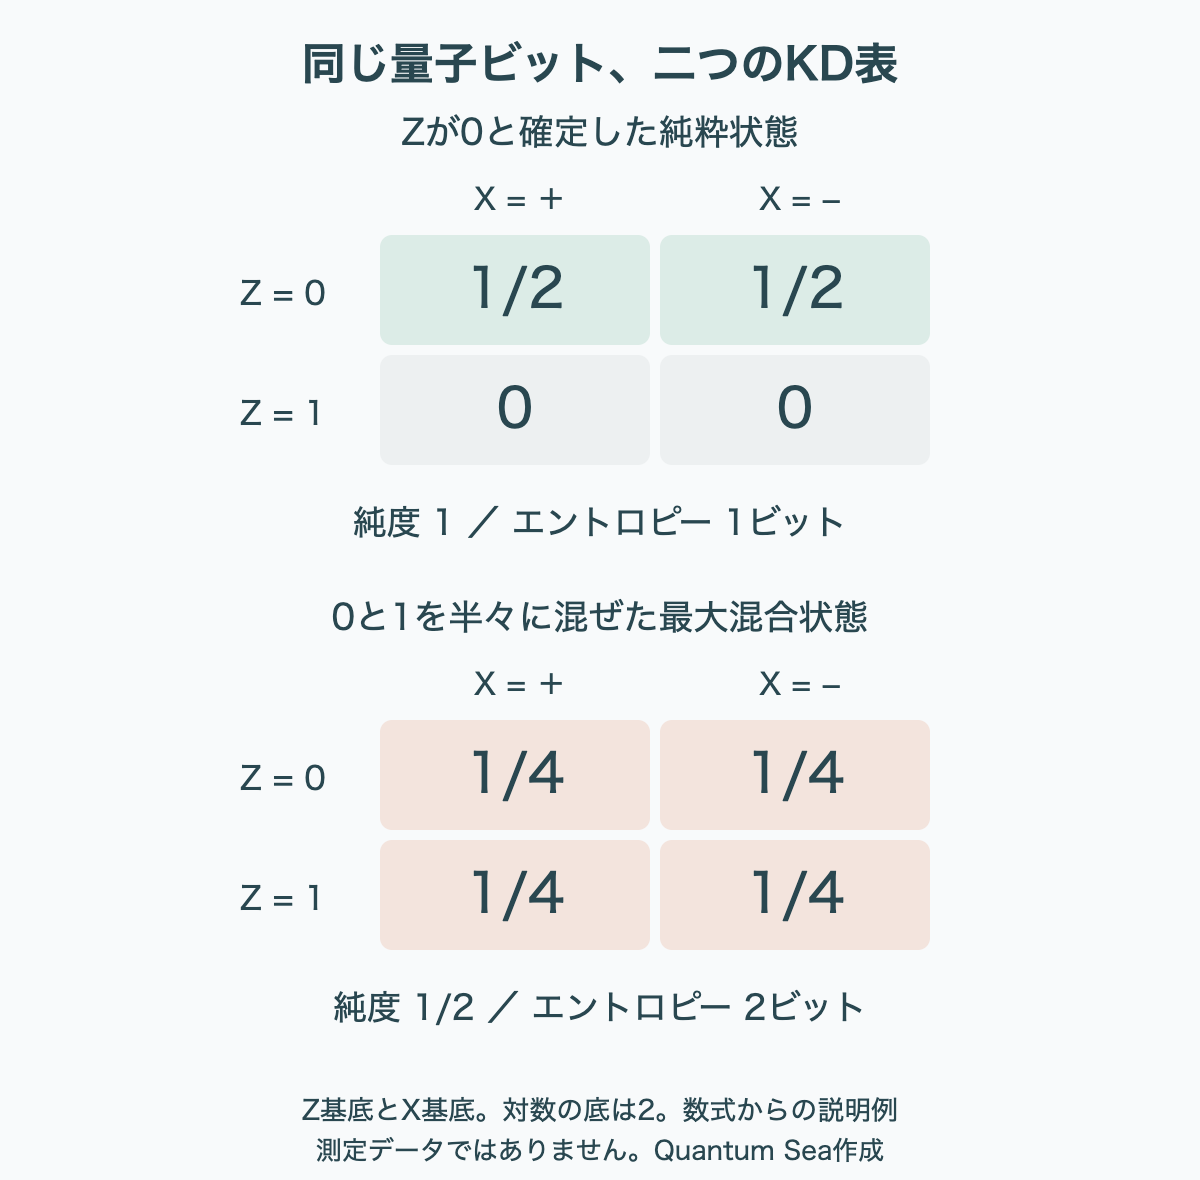
    Zを測ると0になる純粋状態を、ZとXのKD表で表してみます。Z=0の行には1/2と1/2が並び、Z=1の行は0と0です。行の和は1と0、列の和は1/2と1/2なので、Zは確定し、Xは半々になることが確かめられます。

    一方、0の状態と1の状態を半々に混ぜた最大混合状態では、四つのマスがすべて1/4になります。ZでもXでも結果は半々ですが、表全体で見ると、非ゼロの値は二つのマスから四つのマスへ広がります。

    Zが0と確定した量子ビットのKD表は上段に2分の1が二つ、下段は0。最大混合状態の表は四マスすべて4分の1。エントロピーはそれぞれ1ビットと2ビット。
    Z基底とX基底による1量子ビットのKD表。論文の定義から計算した説明例で、測定データではありません。Quantum Sea作成。

    非負の表の広がりを測るのが、Shannonエントロピーです。それぞれの確率pについて−p log₂pを足すと、最初の表は1ビット、最大混合状態の表は2ビットになります。ここで「ビット」は不確かさの単位であり、装置に必要な量子ビット数を数えているわけではありません。論文は自然対数を使いますが、ここでは身近な情報量の単位へ換算しています。

    純度が低いほど、下限が上がる

    状態の混ざり具合を表す量に、純度P=Tr(ρ²)があります。純粋状態ならP=1、D次元の最大混合状態ならP=1/Dです。ここでρは状態を表す密度行列、Dは系全体の状態空間の次元です。N個の量子ビットならD=2のN乗になります。

    論文の主定理をビット単位に書き換えると、対象とする非負のMH表のエントロピーHには、H ≥ log₂D − log₂Pという下限があります。1量子ビットではD=2なので、純粋状態の下限は1ビット、最大混合状態では2ビットです。先ほどの二例は、それぞれこの下限に一致します。

    この関係の背景には、「表をどこまで集中させられるか」という制約があります。表の各値を二乗して足した量は、純度をDで割った値以下になります。一方、Shannonエントロピーは、その二乗和のマイナス対数以上です。この二段階をつなぐと、純度からエントロピーの下限が得られます。

    混合状態ではPが1より小さくなるため、−log₂Pは正になります。その分、絶対的な最小値log₂Dよりも高い不確かさが残ります。すべての混合状態を個別に列挙して、表の形を調べなくても、この制約を導ける点が研究の要所です。

    ただし、純度を途中の値に固定すれば、その下限へ必ず届くわけではありません。付録では、等号に必要な条件として、非ゼロのマスの値が一様であることなどが示されています。「下回れない値」と「その純度で実際に達成できる最小値」は、別に確かめる必要があります。

    純粋なら、いつでも不確かさが最小なのか

    主定理では、表のエントロピーが絶対的な最小値log₂Dへ達するのは、その準確率表が非負である純粋状態に限られます。純粋であることだけでは十分ではありません。

    同じ1量子ビットでも、Y方向のプラスの状態を用意し、ZとXのKD表を作ると、各マスには(1+i)/4または(1−i)/4が現れます。実部はどのマスも1/4なので、MH表のエントロピーは2ビットです。純度は1でも、ZとXに対する不確かさは最小になりません。これは論文の定義から計算できる例で、純粋状態と、特定の測定にとって確定的な状態とを分けて考える助けになります。

    確かめる項目 今回の条件・意味 広げすぎないための注意
    表現と基底 MUBに基づくKD表など 任意の基底や準確率へそのまま拡張しない
    非負性 Shannonエントロピーを扱う表の実部が非負 複素数のKD表へ普通の確率の式を直接適用しない
    純度 状態の混ざり具合 純粋でも、選んだ測定の結果が確定するとは限らない
    下限の達成 絶対最小値と、固定純度での最小値を区別 不等式の右辺へすべての純度で届くとは限らない

    量子らしさの資源と、不確かさは同じ指標ではない

    論文はさらに、KD表が非負の確率表からどれほど外れるかと、二つの測定のRényiエントロピーの関係も調べています。対象とするMUBの設定では、この非正性を測る資源量が大きければ、測定結果の不確かさにも大きな値が必要になります。ここで使うRényiエントロピーは次数1/2のもので、前のShannonエントロピーとは別の指標です。

    逆に、測定結果が大きくばらつくからといって、その資源量も必ず大きいとは言えません。最大混合状態の例では、ZとXの結果はどちらも半々ですが、KD表はすべて非負です。混合によるばらつきと、準確率の非正性が示す性質を、同じ「量子らしさ」として一括りにはできません。

    主定理のもう一つの対象は、奇数次元の量子系を組み合わせたGross–Wigner表現です。通常の量子ビットへ、この表現の結論をそのまま移すわけではありません。また、連続変数のWigner関数や、MUBでないKD表では、同じ最小化の関係を一般に主張できないことも論文で論じられています。

    今回の成果は、測定器の雑音を減らした実験や、計算の高速化を示す結果ではありません。量子状態の表し方を定めたとき、混合度と測定の不確かさの間に残る数学的な制約を明確にするものです。量子の不確かさを比べる際には、何の表を使い、どの範囲の状態で、どのエントロピーを測ったのかまでそろえることが、結果を理解する入口になります。

    出典

  • 量子回路はどこまで短くできるか、近似最適化の計算量

    量子回路はどこまで短くできるか、近似最適化の計算量

    量子回路の同じ計算を、もっと少ない操作で実行したい。少しの誤差を許せば、候補は増え、短い回路を見つけやすくなるように思えます。それでも、どんな入力回路に対しても、許容範囲内の最良の短縮を判定することには、強い計算上の難しさが残ります。

    2026年11月3日に公開された、オーフス大学のAdam Husted Kjelstrøm氏、Jaco van de Pol氏、Andreas Pavlogiannis氏の論文は、この量子回路の近似最適化を計算量の観点から調べています。距離の測り方や削減する資源を分けたうえで、広い誤差許容範囲でPP困難という結果を示すプレプリントです。コンパイラの処理時間を測った実験ではなく、一般的な判定問題の難しさを示す理論研究です。

    簡単にまとめると?

    • 「少し短くできた」と「これ以上短くできないと保証する」は、別の課題です。論文は後者にもつながる一般的な判定の難しさを扱います。
    • 回路全体を何もしない操作へ置き換えられるか、という特別な場合だけでも、近似を許した判定はPP困難になります。
    • 難しさは、距離の定義と入力への条件を含む結果です。実用的な局所最適化が役に立たないことや、すべての回路が同じだけ難しいことを意味しません。

    誤差の予算と、操作数の予算を分ける

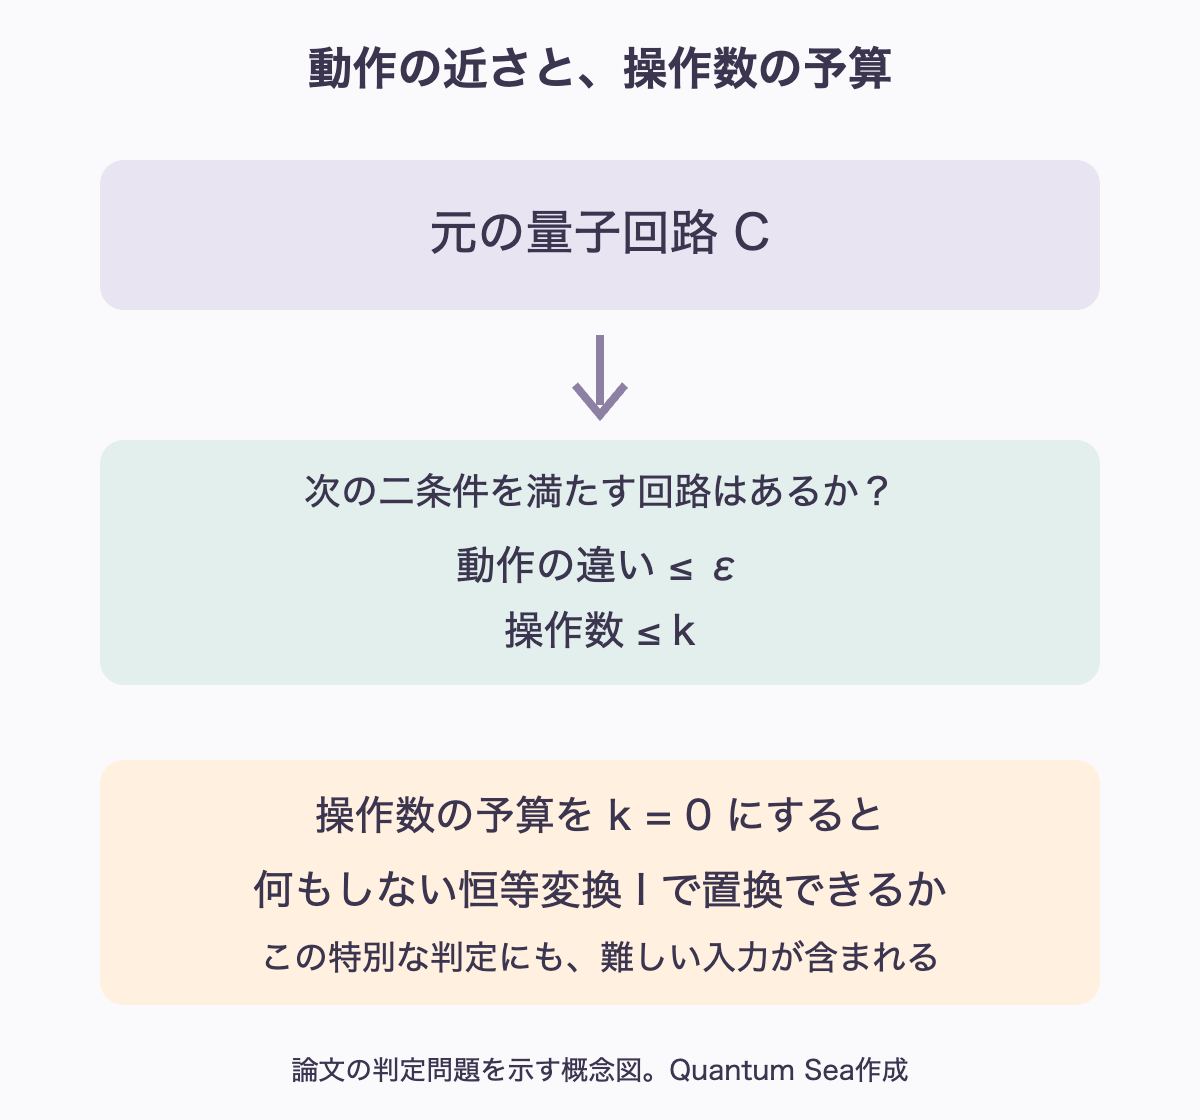
    論文が考える問題には、二つの上限があります。一つは元の回路と新しい回路の動作の違いを測る距離の上限ε、もう一つは新しい回路に使えるコストの上限kです。コストには、総ゲート数や、並列に実行できる段階を数えた回路の深さなどを選べます。

    問うのは、「元の回路との距離がε以下で、コストがk以下の回路が存在するか」です。ここでの近似は、回路の動作を少し変えることを許すという意味です。最適化プログラムが、判定をときどき間違えてよいという条件とは異なります。

    たとえば、同じ量子ビットへXゲートを続けて二回かける部分は、二回の反転で元に戻るので削除できます。このように局所的な規則だけで分かる簡単な例はあります。難しさの主張は、あらゆる回路に対して同じように判定できる一般的な手順へ向けられています。

    元の回路から、許容する動作の違い以内で、操作数の予算以下の回路が存在するかを問う図。操作数ゼロなら何もしない恒等変換への近さを調べる。
    近似最適化の判定問題と、操作数の予算をゼロにした特別な場合。Quantum Sea作成。

    何もしない回路に近いか、だけでも難しい

    総ゲート数の予算をk=0にすると、候補はゲートを一つも使わない回路になります。その動作は、入力をそのまま返す恒等変換Iです。つまり、一般的な最適化を解けるなら、「この回路は、何もしない動作に十分近いか」という問いも解けなければなりません。

    著者らは、この近似恒等性の判定へ、別の難しい問題を変換して埋め込みます。その一つが、論理式を満たす0と1の入力の割合が、指定した閾値以下かどうかを判定する問題です。入力がnビットなら組み合わせは2のn乗通りありますが、論点は単に全列挙が多いことではありません。この割合の判定を解けることが、PPという計算量クラスに属する問題を解けることにつながります。

    PPは、確率的な多項式時間の計算で、受理する確率が半分を超えるかどうかによって答えを定める問題のクラスです。半分からどれだけ離れているかという余裕は要求されません。したがって、少しだけ半分を超える場合まで含めて判定する必要があり、通常の少数回の無作為な試行で安定して答えが得られるという意味ではありません。

    PP困難とは、このクラスのどの問題も、効率よく対象の問題へ変換できるという性質です。対象を一般に効率よく解けるなら、元の広い問題群も効率よく解けてしまいます。ただし、それだけで、すべての個別回路に指数時間が必要だと証明したことにはなりません。

    入力の割合が、回路の距離へ現れる

    論文のトレースに基づく距離の場合は、変換の仕組みを比較的簡単に追えます。論理式が真になる入力xのときだけ、もう一つの出力ビットbを反転する可逆回路を作ります。動作は「xはそのまま、bは条件に応じて反転」です。

    論理式を満たす入力の割合をγとすると、反転しない基底状態の割合は1−γになります。この回路と恒等変換とのSine距離は、√(1−(1−γ)²)と表せます。γが大きいほど距離も大きくなるため、回路が閾値以内の距離にあるかという判定に、入力割合の判定を移せます。

    この構成は、X、CNOT、Toffoliという古典可逆ゲートでも実現できます。少なくとも、この距離に関する近似恒等性の難しさは、重ね合わせを新たに作るゲートだけが原因ではないことが分かります。ほかの距離や資源については、論文中で別の構成と条件が使われています。

    同じεでも、距離の意味が違う

    回路の「似ている」をどう測るかは、結果の適用範囲に直結します。論文は三つの距離を区別しています。

    論文の距離 捉える違い 全体の位相
    Sine距離 二つの変換のトレースの重なりに基づく、全体を平均する性格の指標 全体の位相だけの違いは数えない
    Spectral距離 入力状態について最も大きくなる、状態ベクトルの違い 全体の位相の違いも数える
    Operator距離 全体の位相をそろえたうえで、最も大きくなる違い 全体の位相だけの違いは数えない

    たとえばIと−Iは、状態全体に同じ位相が付く点だけが違います。論文のSpectral距離では2ですが、全体の位相を調整するOperator距離では0です。Sine距離でも0になります。同じ数値のεを置いても、同じ誤差条件を課したことにはなりません。

    主定理は、Clifford+Tを厳密に実装できるゲート集合と、必要な精度まで効率よく計算できるεを対象にします。恒等変換への近似や総ゲート数・総深さの最適化では、それぞれの距離の自明でない許容範囲全体でPP困難性が示されます。一方、非Cliffordゲートなど特定の資源だけを削る場合には、証明が届くεの範囲が異なります。すべての資源、すべての許容誤差で同じ結論が出た、と広げることはできません。

    境界に近い入力を除くかどうかも条件になる

    従来の近似恒等性の研究には、入力回路が「十分近い」か「十分遠い」かのどちらかで、中間の曖昧な領域には入らないという約束を置く設定があります。近い側と遠い側の間に、入力サイズに対して一定以上の隙間を持たせることで、判定する課題を定めます。

    今回の主結果は、そのような隙間を保証しない入力を扱います。εのすぐ近くにある回路も除外せず、どちら側かを判定する課題です。近似を認めることと、判定の境界に余裕を設けることは別であり、この条件の違いを落とすと、過去の結果との比較を誤ります。

    実用的なコンパイラを評価する際には、まずどの距離で誤差を確かめ、どの資源を減らすのかを明示します。そのうえで、改善した回路が得られたことと、最良だと保証できたことを分けます。特定の構造に絞る、局所的な置換を使う、時間を決めて良い候補を探す、といった方法の価値は、この最悪時の難しさによって失われません。

    この論文が示すのは、近似を許せば最適化の根本的な難しさも消える、とは限らないという境界です。回路を短くする成果を読むときも、短縮率とあわせて、許した誤差、対象とした入力、保証した範囲を見ることが大切になります。

    出典

    • Adam Husted Kjelstrøm, Jaco van de Pol, Andreas Pavlogiannis, On the Hardness of Approximate Quantum Circuit Membership and Optimization, arXiv:2611.04381v1(2026年11月3日公開)。問題設定・主定理・許容範囲は第1節とTable 1、距離とPPの定義は第2節、可逆回路によるSine距離の構成は第3.2.1節、最適化への帰結はCorollary 1、未解決範囲は第5節。
  • 適応的な量子ビット符号化で、連続値の探索範囲を動かす

    適応的な量子ビット符号化で、連続値の探索範囲を動かす

    量子ビットで最適化を行うとき、温度や位置、照射の強さのような連続した値を、そのまま無限の精度で扱えるわけではありません。たとえば一つの変数に2ビットを割り当てると、表せる候補は四つです。最初に四つの値を固定してしまうと、調べたい範囲を外したり、よい解の近くを粗くしか探せなかったりします。

    2026年11月2日に公開されたSamuele Cavinato氏らの「Adaptive Qubit Encoding for Continuous-Variable Quantum Optimization」は、ビット列に対応する実数を、探索の途中で変える方法を提案しています。適応的な量子ビット符号化と、元の関数を局所的に近似するモデルを組み合わせた研究です。評価に使ったのは、量子状態の表現を応用する古典計算であり、量子プロセッサによる高速化の実証ではありません。

    簡単にまとめると?

    • 一度に表せる候補の数を保ったまま、基準値と刻み幅を変え、別の範囲や細かさで探索します。
    • 元の目的関数を近傍で評価して二次の代理モデルを作り、そのモデルが提案した候補を、元の関数でもう一度確かめます。
    • 数値実験では有望な比較結果がありますが、計算時間の優位や実機での量子優位、臨床規模の治療計画を示した結果ではありません。

    四つの候補は、ずっと同じ四つでなくてよい

    この方法では、各変数に基準値aと正の刻み幅δを持たせます。2ビットの場合、00、01、10、11は、それぞれa−2δ、a−δ、a、a+δに対応します。基準の左右に完全に対称な四点を置く符号化ではありません。

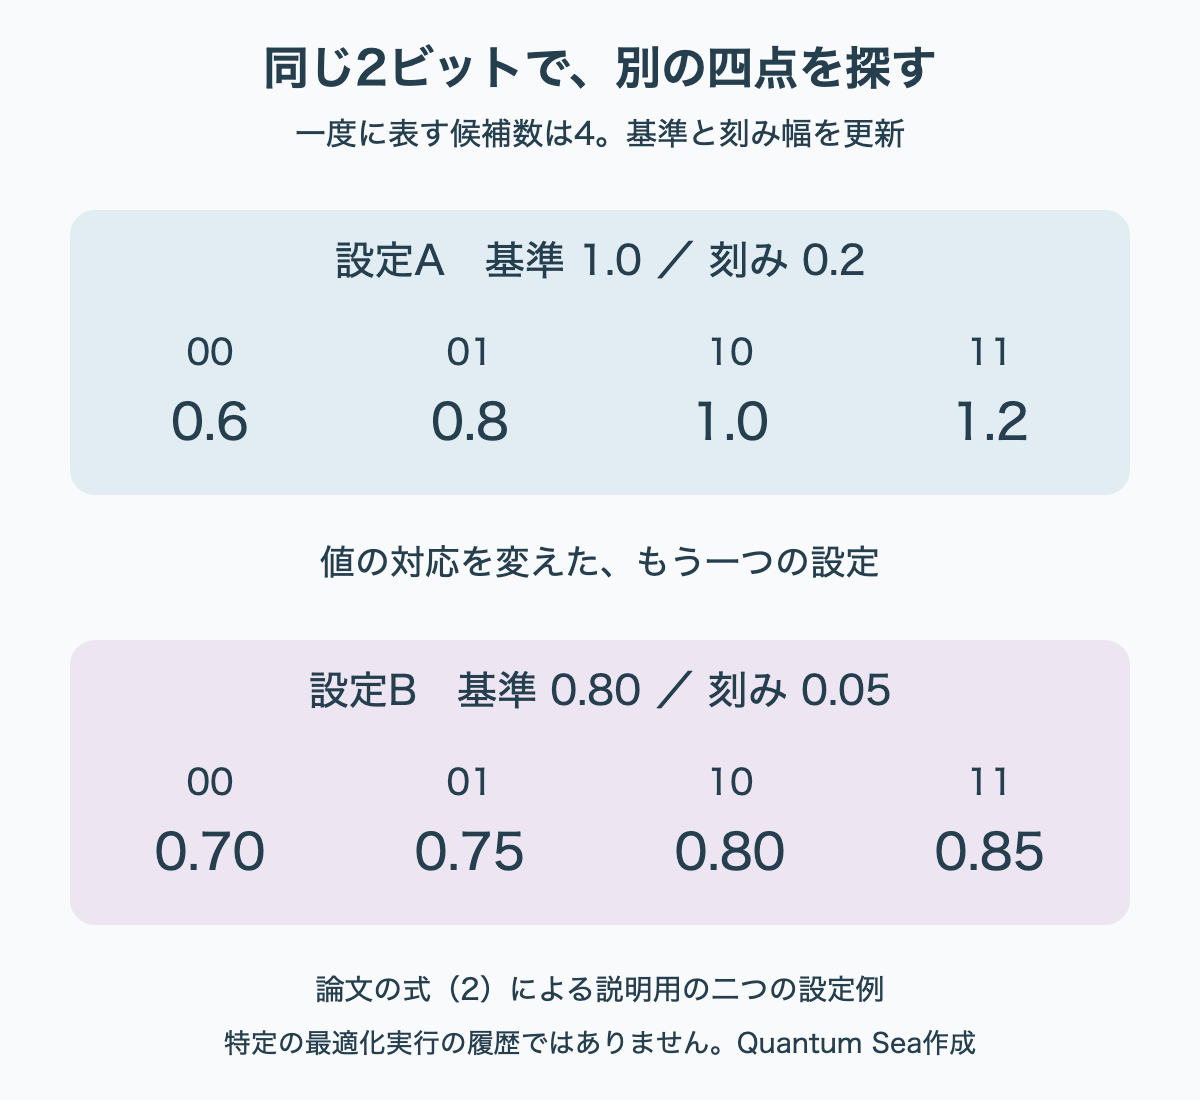
    たとえばa=1、δ=0.2なら、候補は0.6、0.8、1.0、1.2です。別の反復でa=0.8、δ=0.05という設定を使えば、同じ四つのビット列が0.70、0.75、0.80、0.85を表します。ビット数は増えていませんが、注目する場所と細かさが変わります。

    2ビットで表す四つの値を、基準1と刻み0.2では0.6、0.8、1、1.2へ、基準0.8と刻み0.05では0.7、0.75、0.8、0.85へ対応させる例
    論文の式(2)を使った二つの設定例。特定の最適化実行の履歴を表すものではありません。Quantum Sea作成。

    各反復で選べる値は、あくまで有限個です。無限個の実数を2量子ビットに同時に保存するわけではありません。基準値と刻み幅を古典側で管理し、次の有限問題を作り直すことで、探索全体では最初の四点に縛られなくなります。

    刻み幅は、変数ごとの履歴で更新します。その変数も目的関数の値も動かなければ、刻みを小さくして近くを詳しく調べます。その変数は動かず、ほかの変数の変更などで目的関数が改善したなら、刻みを広げて周囲を探索します。変数自体が変わった場合には、その刻み幅を維持します。細かくなりすぎた刻みを戻す操作も用意されています。

    この仕組みには、狭い範囲を詳しく見ることと、別のよい領域へ移ることの折り合いが残ります。初期の刻み幅や戻す条件に万能な選び方があるわけではなく、最良の解を必ず見つける保証として読むことはできません。

    元の関数を、近くで解ける形に写す

    連続値の表し方を決めても、量子最適化向けの形式で目的関数を扱うという問題が残ります。実際の設計では、関数が単純な多項式とは限らず、数値計算をして初めて値が分かることもあります。

    著者らは、全領域を一つの式へ正確に変換する代わりに、現在の候補の周囲で元の関数を評価します。その結果に合うよう、各ビットに対応するスピンの項と、スピン対の結合項からなる二次の代理モデルを作ります。これは、良い候補を低いエネルギーとして探せる、スピングラス型のハミルトニアンです。

    ただし、近傍の評価点に合うことは、まだ調べていない点でも元の関数と一致することを意味しません。そのため、代理モデルから得た低エネルギーのビット列を実数へ戻し、元の目的関数を改めて評価します。モデルの中だけで良い値が出たことを、元の問題の改善と取り違えないための段階です。

    今回の数値実装では、代理モデルを木構造テンソルネットワーク(TTN)で解いています。大きな状態を小さなテンソルのつながりで表す方法で、ここでは古典計算機上の数値手法として使われています。符号化に128量子ビット分を用いることと、実際の128量子ビットプロセッサで計算したことは別です。

    ビットを増やすと、モデルを作る費用も増える

    細かい値を一度に多く表すには、変数あたりのビット数を増やせます。しかし、この研究の全結合の代理モデルでは、その分だけ決める係数も増えます。総ビット数をQとすると、一次の項と二次の結合の係数はQ(Q+1)÷2個です。提案手順は、この数に合わせて近傍の関数を評価してモデルを作ります。

    8変数を2ビットずつ表すならQ=16で136個、4ビットずつならQ=32で528個になります。候補の表現力を増やす一方、外側の探索を一回進める前に必要な関数評価が、約3.9倍になる計算です。これは式から数えたモデル構築の負担であり、実行時間が同じ倍率になるという測定結果ではありません。

    論文でも、8変数と32変数の試験で、変数あたり2ビットから4ビットへ増やしても、同じ関数評価回数の下では改善しませんでした。評価の予算が決まっているなら、精密な一回の探索に費やす分と、探索を更新できる回数との両方を見る必要があります。

    比較する手法 何を解くか 比較から分かる範囲
    TTN 各反復で作る二次の代理モデル 今回提案した符号化とモデル構築を含む数値探索
    Simulated Annealing TTNと同じ代理モデル 同じ写し方の下での、解法による違い
    Best Neighbor モデル構築時に評価した近傍から最良の点を選ぶ 代理モデルを追加で解くことの効果
    Particle Swarm 元の連続変数の目的関数 別の古典最適化手法との、問題全体としての比較

    数値実験が示した改善と、まだ残る差

    試験では、局所的な谷が複数あるGramacy–Lee関数を、8、16、32、64変数で調べました。主な設定は変数あたり2ビット、初期値を変えた10回の実行です。同じ問題サイズでは初期条件をそろえ、関数を評価する回数を共通の予算として比較しています。

    この試験でTTNは、近傍から選ぶだけの方法や、同じ代理モデルを使うSimulated Annealingより良い結果を示しました。元の関数を直接探索するParticle Swarmに対しても、初期段階で目的値が下がりやすい傾向が見られ、次元が大きい設定で差が広がりました。一方、制約を加えた試験では、最終的な解の質はParticle Swarmと同程度でした。特定の関数と設定で得た比較であり、すべての最適化問題に共通する順位ではありません。

    もう一つの例は、放射線治療の照射強度を決める逆計画の概念実証です。標準的な試験用ファントムの前立腺ケースを使い、向かい合う二方向の照射を合計64本の小さなビームに分け、その強度を2ビットずつ、合計128ビット分で表しました。患者への治療試験ではなく、目的関数の条件も臨床プロトコルから採ったものではありません。

    この例では、TTNとParticle Swarmが得た線量と体積の関係は近いものでしたが、低いほどよい最終目的値は、最良の設定でTTNが1033、Particle Swarmが755でした。ここではTTNが勝ったとは言えません。少数ビットの適応的な符号化でも、非多項式の条件を含む問題へ対応できることを示す結果として位置付けられています。

    次に確かめたいのは、写し替えを含む総費用

    今回の提案の価値は、連続した値を有限のビットへ写すときに、最初の格子だけに探索を閉じ込めない点にあります。さらに、関数全体を扱いやすい式へ変形しきれなくても、局所的な代理モデルを繰り返し作るという入口を用意しています。

    実用性を比べる次の段階では、解の良さと関数評価回数に加え、係数を決める計算、代理モデルを解く時間、候補を再評価する費用も必要です。量子ハードウェアへ移すなら、全結合に近い相互作用を、その装置でどう実現するかも課題になります。ビット数の小ささだけでなく、問題の写し替えと実行まで含めた負担を追うことが、提案を評価する手掛かりになります。

    出典

  • 非エルミート量子力学、測定結果の選別で変わる状態の見方

    非エルミート量子力学、測定結果の選別で変わる状態の見方

    量子系の実験を何度も繰り返し、ある測定結果が出た回だけを残すと、全実験を平均したときとは違う状態が見えてきます。この事後選択、つまり結果を見てから対象を絞る操作が、非エルミート量子力学を理解する手掛かりになります。

    2026年11月2日に公開された、RWTHアーヘン工科大学のApostolos Siskou氏とVolker Meden氏の論文「Non-Hermitian effective dynamics from post-selection protocols」は、異なる方法で導かれてきた非エルミートな時間発展を、測定結果の選別という共通の枠組みで整理しています。新しい量子装置の性能実証ではなく、どの状態や測定値を計算しているのかを明確にする理論研究です。

    簡単にまとめると?

    • 非エルミートな時間発展は、特定の測定結果を選んだ量子状態を表すために使えます。実験全体の平均とは区別が必要です。
    • 選別後の状態を合計1にそろえると、採用した実験の中での割合が分かります。一方、採用できた確率は別に残さなければなりません。
    • 環境の最終状態を選ぶ方法、途中で量子跳躍が起きなかった履歴を選ぶ方法、補助スピンを使う方法では、必要な仮定が異なります。

    減ったのは状態の重さか、実験の採用数か

    閉じた量子系の時間発展には、通常、エルミートなハミルトニアンを使います。これはエネルギーを表す演算子で、状態の確率の合計を保つ時間発展を生みます。エルミート性は、行列を複素共役にして転置したものが元と同じ、という性質です。

    対して非エルミートな有効ハミルトニアンでは、状態ベクトルの長さが変わることがあります。だからといって、直ちに量子力学の確率の規則が破れたと考える必要はありません。選んだ測定結果に対応する部分だけを追っているなら、その長さの二乗は、選別に通る確率を表せるからです。

    たとえば、光が外へ漏れる共振器を考えます。理想的に漏れた光を検出できるモデルで、「測定の間、一度も光の検出がなかった」という実験の回だけを残すとします。全実験には光が漏れた回も含まれますが、残した集団の状態は、その情報を条件として更新されます。実際の装置で検出器が光を見逃す場合には、見逃しも含めた別の測定モデルが必要です。

    このとき、選別前からの重さを保った状態と、選別を通った集団の中で合計を1にそろえた状態は、違う情報を持っています。後者を求める正規化だけを見ていると、どれほど多くの実験を捨てたかが分からなくなります。

    割合が増えても、採用した数が増えたわけではない

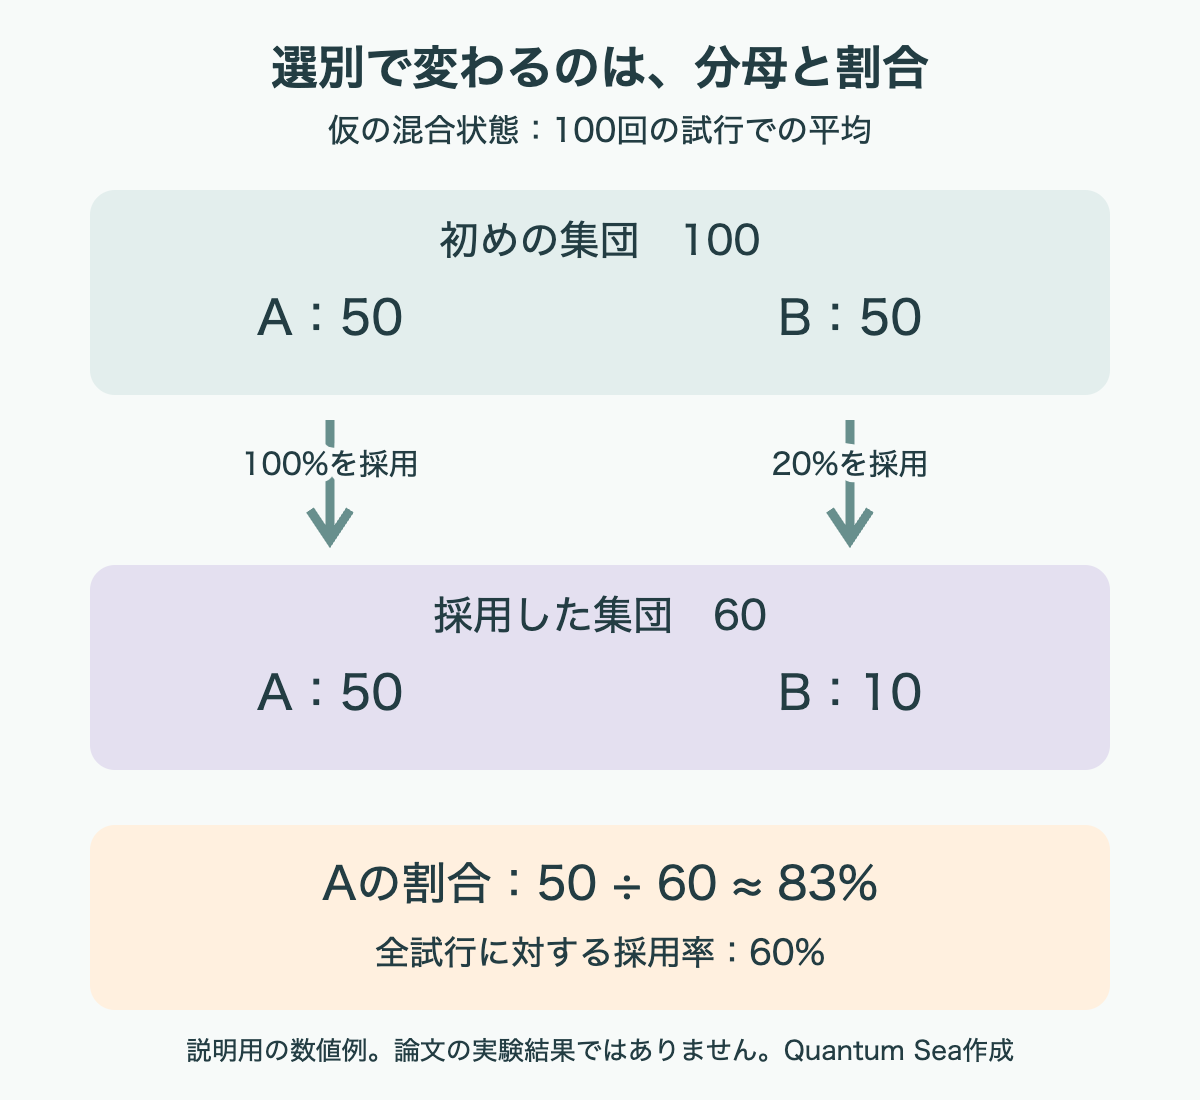
    違いを、二つの状態AとBの古典的な混合で見てみます。初めの割合は半分ずつで、選んだ測定結果が出る確率を、Aでは100%、Bでは20%と仮定します。これは仕組みを説明するための数値例で、論文が報告した測定値ではありません。また、AとBのコヒーレントな重ね合わせを扱う例でもありません。

    100回の試行なら、平均するとA由来の50回とB由来の10回、合計60回が採用されます。採用した集団の中でのAの割合は50÷60、約83%です。初めの50%から増えていますが、A由来の採用数が50から増えたわけではありません。B由来の回が多く除かれ、分母が変わった結果です。

    初めにAとBが50ずつある混合状態から、Aは50、Bは10を採用すると、採用60の中でAの割合が約83パーセントになる例
    選別と正規化を示す仮の数値例。論文の実験結果ではありません。Quantum Sea作成。

    密度行列を使うと、この違いをそのまま書けます。選別した結果に対応する演算子をM、初めの状態をρとすると、正規化前の状態はMρM†です。その跡、つまり対角成分の合計が、その結果の起こる確率pになります。条件付きの状態はMρM†をpで割ったものです。結果を一つに絞らず、すべての測定結果に対応する状態を足せば、選別しない場合の状態になります。

    論文は、この選別した枝の時間変化から、非エルミートな有効ハミルトニアンを導きます。ただし、局所的な時間発展の生成子を逆演算子で書くには、対応する演算子が可逆であるなどの条件があります。「どんな選別も、いつでも同じ有限のハミルトニアンで表せる」という主張ではありません。

    三つの方法は、何を選んでいるのか

    研究が結び付けたのは、Feshbach射影、Lindblad方程式からの量子軌道、補助スピンを使う構成です。いずれも系の一部に注目しますが、選ぶ測定結果と近似の置き方が違います。

    方法 選ぶもの 読解で大切な条件
    Feshbach射影 終点で指定した環境状態 一般には環境へ出て戻る過程も含む。広い帯域を持つ環境などの近似で、時間に依存しない有効記述へ進む。
    Lindblad方程式の量子軌道 途中も含め、量子跳躍が一度も起きなかった履歴 環境の記憶を無視する近似や、選別する測定記録を明示する。
    補助スピンによる構成 補助系を含めて動かした後の、選んだ測定結果 初期状態と結合を設計する。環境の記憶を無視する近似は必須ではないが、成功確率や実現時間の制約がある。

    Feshbach射影は、大きな系から注目する部分を取り出す方法です。環境を指定した状態で観測する終点の条件だけでは、途中で何も起きなかったとは限りません。振幅が環境側へ移り、後で戻る過程も含みえます。環境の帯域を十分広く取るなど、記憶を失わせる近似をしたときに、無跳躍の記述との対応が明確になります。

    Lindblad方程式は、環境と相互作用する開放量子系の、選別しない平均的な変化を表します。それを、跳躍が起こる履歴と起こらない履歴に分け、全時間を通じて跳躍のなかった履歴だけを残すと、非エルミートな時間発展が現れます。終点の環境だけを選ぶ操作と同じだと扱うには、近似の条件まで確認しなければなりません。

    補助スピンを使う方法では、元の系と二準位の補助系を一緒に、通常のエルミートなハミルトニアンで動かします。その後で選んだ測定結果に条件を付けることで、元の系に非エルミートな有効記述を実現します。論文は増幅を含む形の生成子も扱いますが、正の虚部を持つ固有値がある場合には、実現できる時間に制約が生じます。初期の成功確率を小さくして時間範囲を延ばす構成も、採用できる実験を減らす代償と一緒に読む必要があります。

    測定値と熱平衡を、そのまま読み替えない

    有効ハミルトニアンが非エルミートだからといって、測定値の計算まで別の確率規則へ置き換える必要はありません。この論文の測定と事後選択の枠組みでは、物理的な観測量は通常どおりエルミートで、選別後に正規化した状態を使って期待値を求めます。

    非エルミート行列の解析では、左固有ベクトルと右固有ベクトルを組にした計算が便利です。しかし、その数学的な組を使った式が、そのまま実験で測る平均値になるわけではありません。著者らは、今回の構成では通常の内積で計算した期待値と、選別の成功確率を分けて扱うことを強調しています。有効な時間発展の生成子も、系のエネルギーという観測量そのものとは限りません。

    同じ注意は、熱平衡にも関わります。通常のエネルギーに基づく熱的な混合を用意しても、選別によって成分ごとの重みが異なる速さで減れば、残った集団の割合は変わり続けます。論文が検討する一般的な場合、熱平衡の分布をそのまま入れても定常状態にはなりません。特別な条件で割合が変わらない場合まで否定するものではなく、何が一定になるかを選別込みで計算する必要がある、という指摘です。

    モデルの比較では、採用率まで見る

    この整理が役立つのは、同じ「非エルミート」という言葉で書かれた結果を比べる場面です。まず、何を測定し、どの結果を残したのかを確認します。次に、環境の記憶を無視する近似があるか、終点だけの条件なのか、途中の記録まで選んだのかを確かめます。

    そのうえで、正規化後の状態の性質と、そこへ到達する確率を並べます。仮に採用率が1%なら、独立した同条件の試行で1,000回の採用を得るには、平均して10万回の試行が必要です。これは装置の所要時間や感度を表す実測値ではありませんが、状態の良さだけを比べると見落とす負担を示します。

    選別された状態は、量子系の一部を詳しく見るための有用な記述です。その意味を保つには、何を残し、何を数えなかったかを、状態と一緒に追うことが欠かせません。

    出典

  • QuantinuumのComb、量子回路の故障の組み合わせを検証する

    QuantinuumのComb、量子回路の故障の組み合わせを検証する

    量子回路で一か所の故障に耐えられても、一回の実行中に二つの故障が起きたときにも耐えられるとは限りません。誤り訂正に使う回路を少し簡単にするだけでも、調べ直すべき故障の組み合わせは膨大になります。Quantinuumの研究チームは、この確認を助けるソフトウェア「Comb」を公開しました。

    2026年11月3日公開のプレプリントが扱うのは、量子計算の資源となるマジック状態を、CNOTとTという二種類のゲートを使って準備する回路です。Combは、故障の組み合わせが検出されるか、訂正可能な範囲に収まるかを調べます。回路を短くする設計と、その変更で壊してはいけない性質の確認をつなぐ道具です。

    簡単にまとめると?

    • CNOTとTで構成する回路では、故障が伝わった先の誤りを、DCPと呼ぶまとまった表現で扱えます。
    • Combは、用意された故障と出力誤りの情報から、多数の組み合わせを検証します。故障モデルの選択や、各故障がどう伝わるかの計算は別に必要です。
    • 検証を通った回路でも、実機で常に有利とは限りません。回路を短くした効果、残る誤り、準備した状態を採用できる割合を分けて比べます。

    マジック状態を作る回路にも、故障は入る

    マジック状態は、誤り訂正された量子計算でTゲートなどの操作を実現するために使う、特別に準備した量子状態です。雑音のある状態を複数集めて精度を高める「蒸留」がよく知られていますが、小規模な量子符号では、目的の状態を直接準備する方法も研究されています。

    直接作れば、必要な量子ビットや操作を減らせる可能性があります。ただし、準備の途中で生じた小さな故障が、多くの量子ビットへ広がってしまっては困ります。出力が理想状態に近いかを平均だけで評価するのではなく、決めた個数までの故障が、どこでどのように組み合わさっても条件を満たすかを調べる必要があります。

    論文の距離5の例では、二つまでの故障の組み合わせを確認します。「距離」は量子符号の誤りに対する強さを表す指標ですが、距離5の符号を使えば、どの準備回路も自動的に同じ強さを持つわけではありません。実際の回路について検証することが必要です。

    誤りを全部展開せず、構造を保ったまま扱う

    解析の基本となるパウリ誤りは、量子ビットの0と1を入れ替える誤りや、重ね合わせの位相を変える誤りです。クリフォードと呼ぶ種類の操作だけなら、こうした誤りを回路の先へ移しても、別のパウリ誤りとして追跡できます。ところがTゲートを含むと、出力の誤りは一つのパウリ誤りには収まらず、複数の成分を重ね合わせた表現になります。

    対象の回路では0または+の状態に初期化し、選別に使う測定はXまたはZの基底で行います。研究チームが利用したのは、ゲートをCNOTとTに限定すると、その複雑さにも一定の形が残ることです。誤りを、対角クリフォード演算とパウリ演算の積で表すDCP(Diagonal Clifford and Pauli)として保持します。CNOTやTを通った後もDCPの形が保たれるため、毎回すべてのパウリ成分へ展開せずに計算を進められます。

    量子ビット数をnとすると、この表現の記憶量は、全体の位相を除いてnの二乗に比例する大きさです。ただし、検証全体が常に軽くなるという意味ではありません。故障する場所や調べる故障数が増えれば組み合わせは増え、最後に残った誤りの成分を調べる工程にも指数的な負担が残ります。扱う対象を絞り、その構造を使って計算を実用的な大きさへ近づける方法です。

    Combへ渡すまでの準備と、Combが確かめること

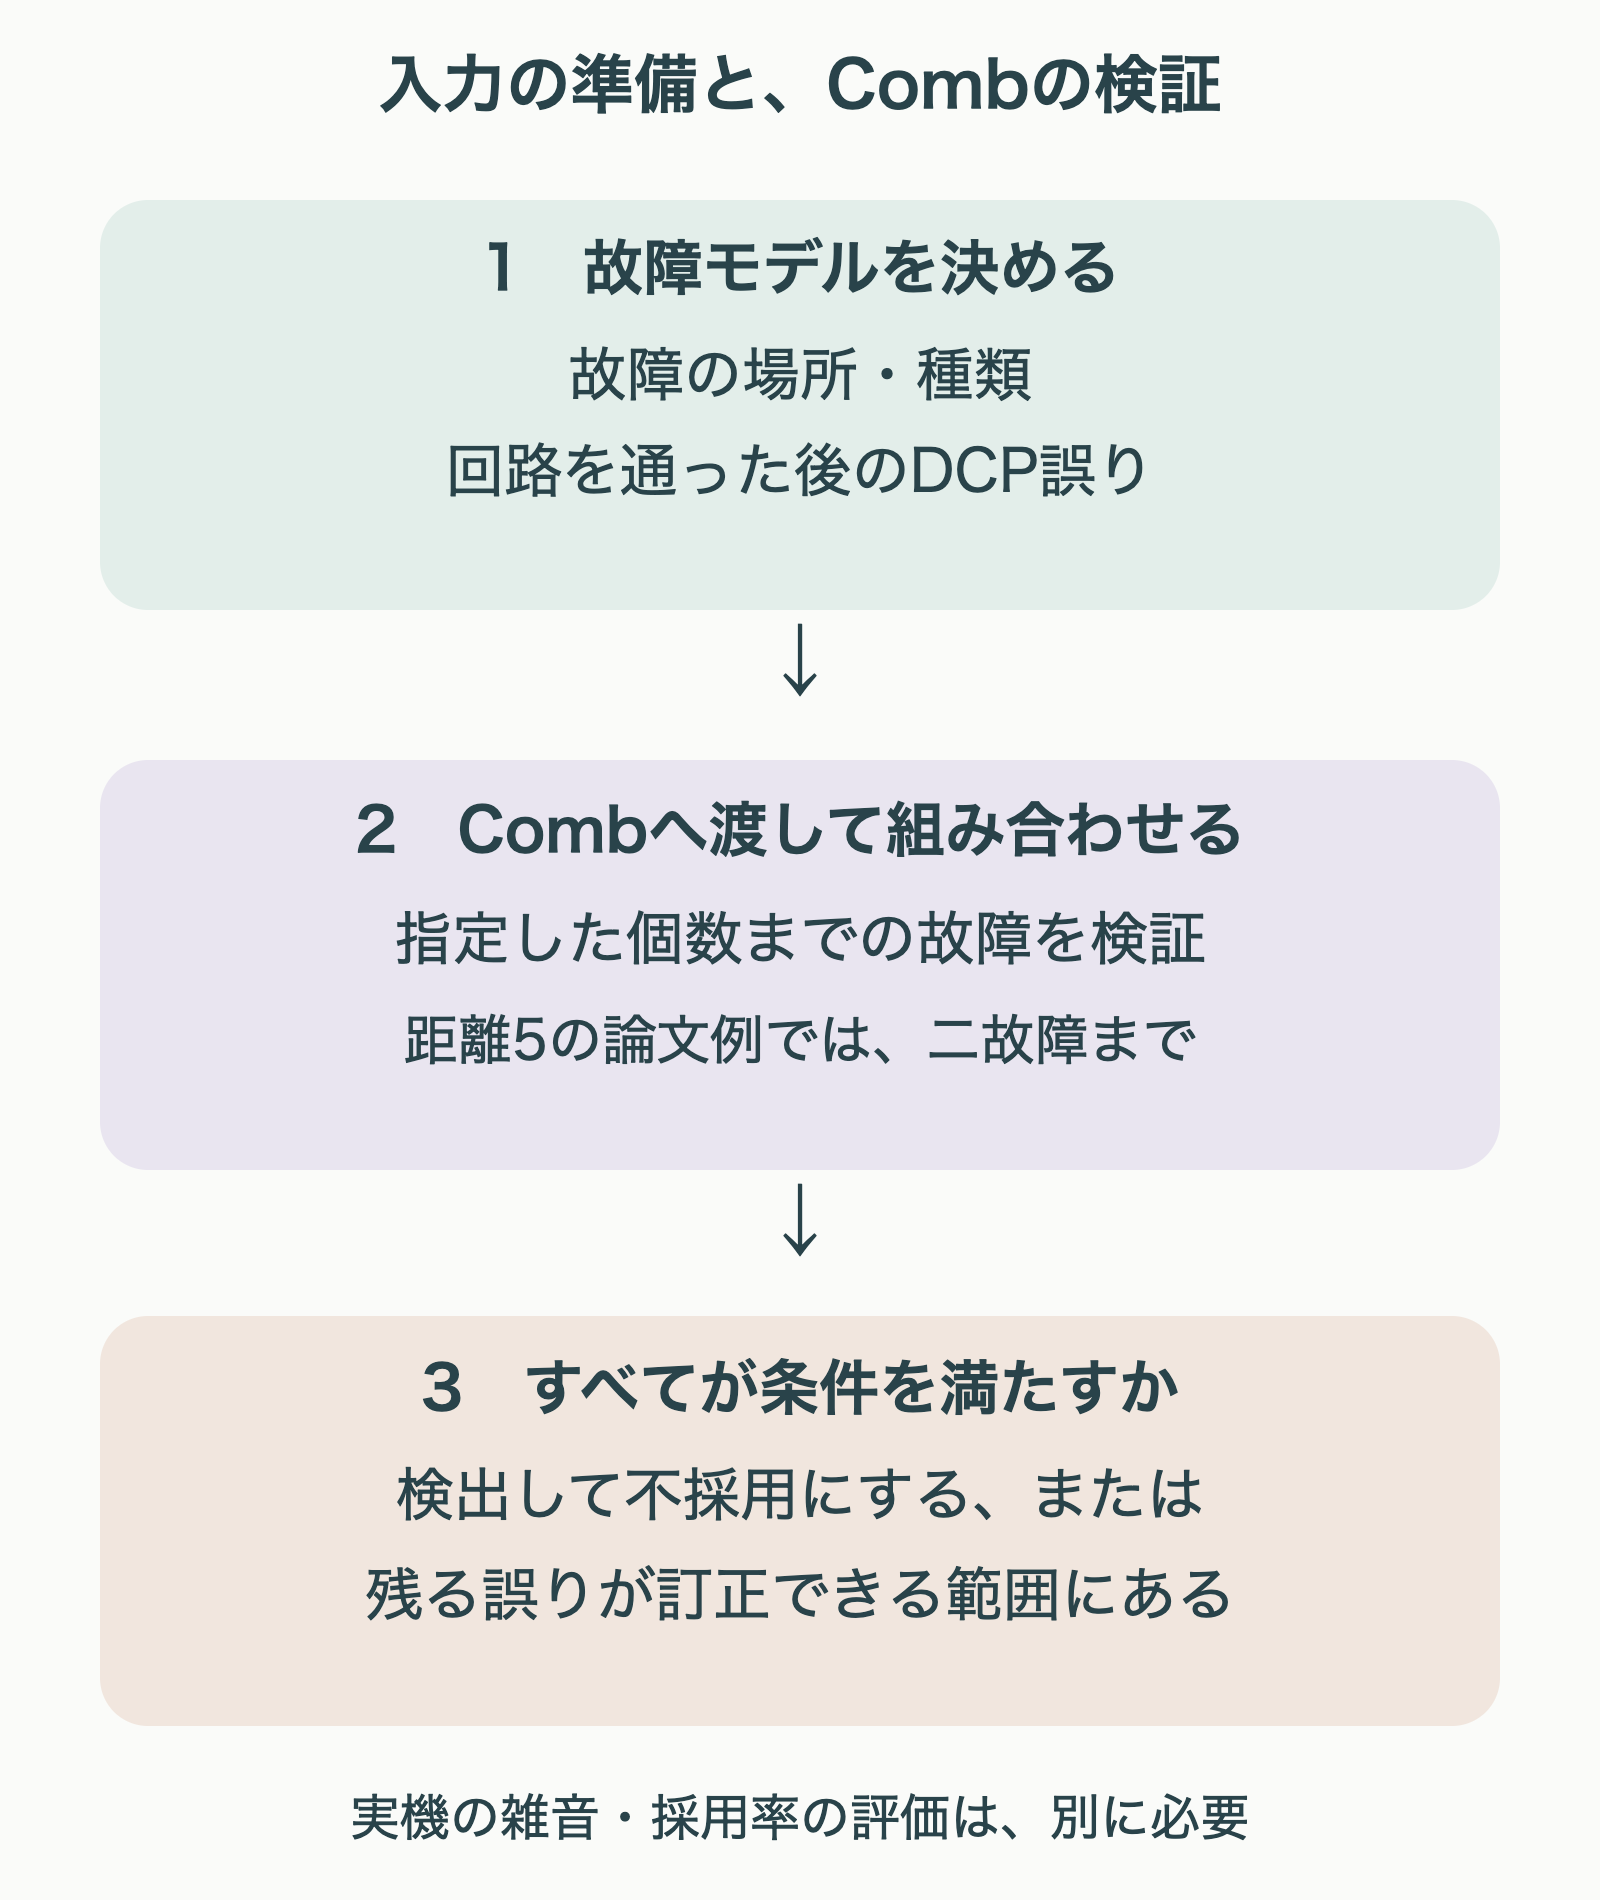
    Combを使うには、まず故障が起こりうる場所と、各場所で想定する故障を決めます。次に、それぞれが回路を通った後のDCP誤りを求め、目的のマジック状態と、誤りの重さを調べるための表を用意します。Combの中心機能は、この入力を受けて故障の組み合わせを順に検証することです。

    故障モデルと出力誤りを準備してCombへ渡し、検出または訂正可能な範囲を確認する三段階の図
    Combの入力準備と検証の役割を分けた模式図。論文第IV・V節をもとにQuantum Sea作成。

    確認する条件は、s個の故障が起きたとき、その誤りが補助量子ビットの測定で検出されるか、検出されずに残る場合でも、各パウリ成分がs個以下の量子ビットへの誤りと等価であることです。見かけ上は多くの量子ビットに作用していても、量子符号の性質を使うと小さな誤りと等価になる場合があります。

    測定で問題を検出した場合は、その試行で作った状態を採用しません。この選別をポストセレクションと呼びます。「耐故障性を確かめた」は、どの試行も成功する、あるいは出力に誤りが一切ない、という意味ではありません。採用できた状態の品質と、採用できる割合は別の指標です。

    見る項目確かめたいこと
    故障モデル実際の装置で問題となる故障や場所を含んでいるか
    回路の耐故障性指定した故障数までの全組み合わせが条件を満たすか
    採用後の論理誤り率測定で選別した後にも、どれだけ誤りが残るか
    採用率と回路の長さ必要な品質の状態を、どれだけの時間・資源で得られるか

    検証が速いと、回路を削って試し直せる

    論文では、17個の物理量子ビットで一つの論理量子ビットを表す距離5のカラー符号などを使って検証しています。Table Iの未最適化の距離5回路では、二故障の組み合わせ約1,266万通りを調べる時間が8分3秒、故障を伝搬させる前処理なども含めた全体が11分17秒でした。16GBのメモリーを備えた論文記載のノートPCでの著者の測定値であり、別環境での再現結果ではありません。

    この確認を繰り返せると、補助量子ビットとそれに関わるゲートを一部取り除き、残る回路が条件を満たすか試せます。条件を満たせば変更を採用し、満たさなければ元に戻します。研究チームはこの手順で、より少ない操作で同じ耐故障性の条件を満たす回路を探索しました。

    一方、同じ論文の雑音シミュレーションでは、最適化前の距離5回路のほうが、短くした回路より低い論理誤り率を示しています。著者らは、用いたモデルが待ち時間中の誤りや量子ビットの漏れを含まない影響と説明しています。著者らは短い回路が実機で有利になる可能性を述べていますが、それはこの研究で実機実証された結果ではありません。短さだけで良し悪しを決めず、想定する雑音と採用率も合わせて比べる必要があります。

    公開コードから確認できる範囲

    2026年11月5日に確認した公式リポジトリには、CombのC実装とPythonから呼び出す例が公開されています。READMEでは中心となる実装を逐次処理とし、並列化などを今後の改善候補に挙げています。コードが公開されていること、論文が性能を報告していること、手元の回路と装置で使えることは、それぞれ確認する段階が違います。

    導入を考える際は、まず回路が扱えるゲート・初期化・測定の範囲に収まるか、故障の入力を漏れなく作れるかを確かめます。そのうえで、検証に要する時間と、回路を変更した後の品質・採用率を測ります。Combが支えるのは、設計変更のたびに「この故障の組み合わせを見落としていないか」を確かめる工程です。

    研究チームの企業としての位置づけは、CyclewaveのQuantinuumの事業と量子計算技術の解説でも紹介しています。

    出典

    1. Selwyn Simsekほか、Fast verification of fault tolerant magic state preparation circuits with the CNOT + T gate set、arXiv:2611.04909v1(2026年11月3日公開)。DCPと検証条件は第III・IV節、役割分担と時間は第V節・Table I、回路削減は付録E、雑音モデルは付録F。
    2. Quantinuum、Comb公式リポジトリ。2026年11月5日確認の版。README.org、Python用README、LICENSEを参照。
  • 量子回路の並行処理、ゲートの分解で増える実行順を検証する

    量子回路の並行処理、ゲートの分解で増える実行順を検証する

    一つの量子ゲートを、同じ働きをする複数の小さなゲートへ置き換える。単独で動かす回路なら正しい変換でも、別の処理が途中に入ると、結果が変わることがあります。共有する量子ビットへ別の処理が触れるためです。

    シドニー工科大学のMingsheng Ying氏が2026年11月3日に公開した「Reasoning about Shared-Qubit Concurrency in Quantum Computing」は、この量子回路の並行処理を検証する理論的な枠組みを提案しています。個々の回路の正しさと、互いの処理がその証明を壊さないことを分けて調べる、Owicki–Gries法の量子回路への拡張です。対象は途中の測定を含まない回路で、実機の速度向上を測った研究ではありません。

    簡単にまとめると?

    • 単独では同じ変換をする回路でも、分解したゲートの間に別の処理が入ると、共有量子ビットの状態は変わりえます。
    • 途中に別の処理を入れない「アトミック領域」を決め、各回路の途中条件が他の回路の操作でも保たれるかを調べます。
    • 保証するのは、許された実行順で目的の性質が成り立つことです。すべての順序で最終状態が同じになるとは限りません。

    同じSWAPでも、途中へ入れる操作が変わる

    論文の入口は、二つの量子ビットの状態を入れ替えるSWAPゲートと、一つ目の量子ビットに作用するHadamard(H)ゲートです。Hゲートは、0や1の状態を、位相の異なる二種類の重ね合わせへ変えます。この二つの処理は、一つ目の量子ビットを共有しています。

    SWAPを途中で分けられない一つの操作とみなすなら、実行順は「SWAPの後にH」か「Hの後にSWAP」の二通りです。入力を一つ目が1、二つ目が0の状態とすると、どちらの順でも最終状態は、二つの量子ビットそれぞれの状態に分けて書けます。

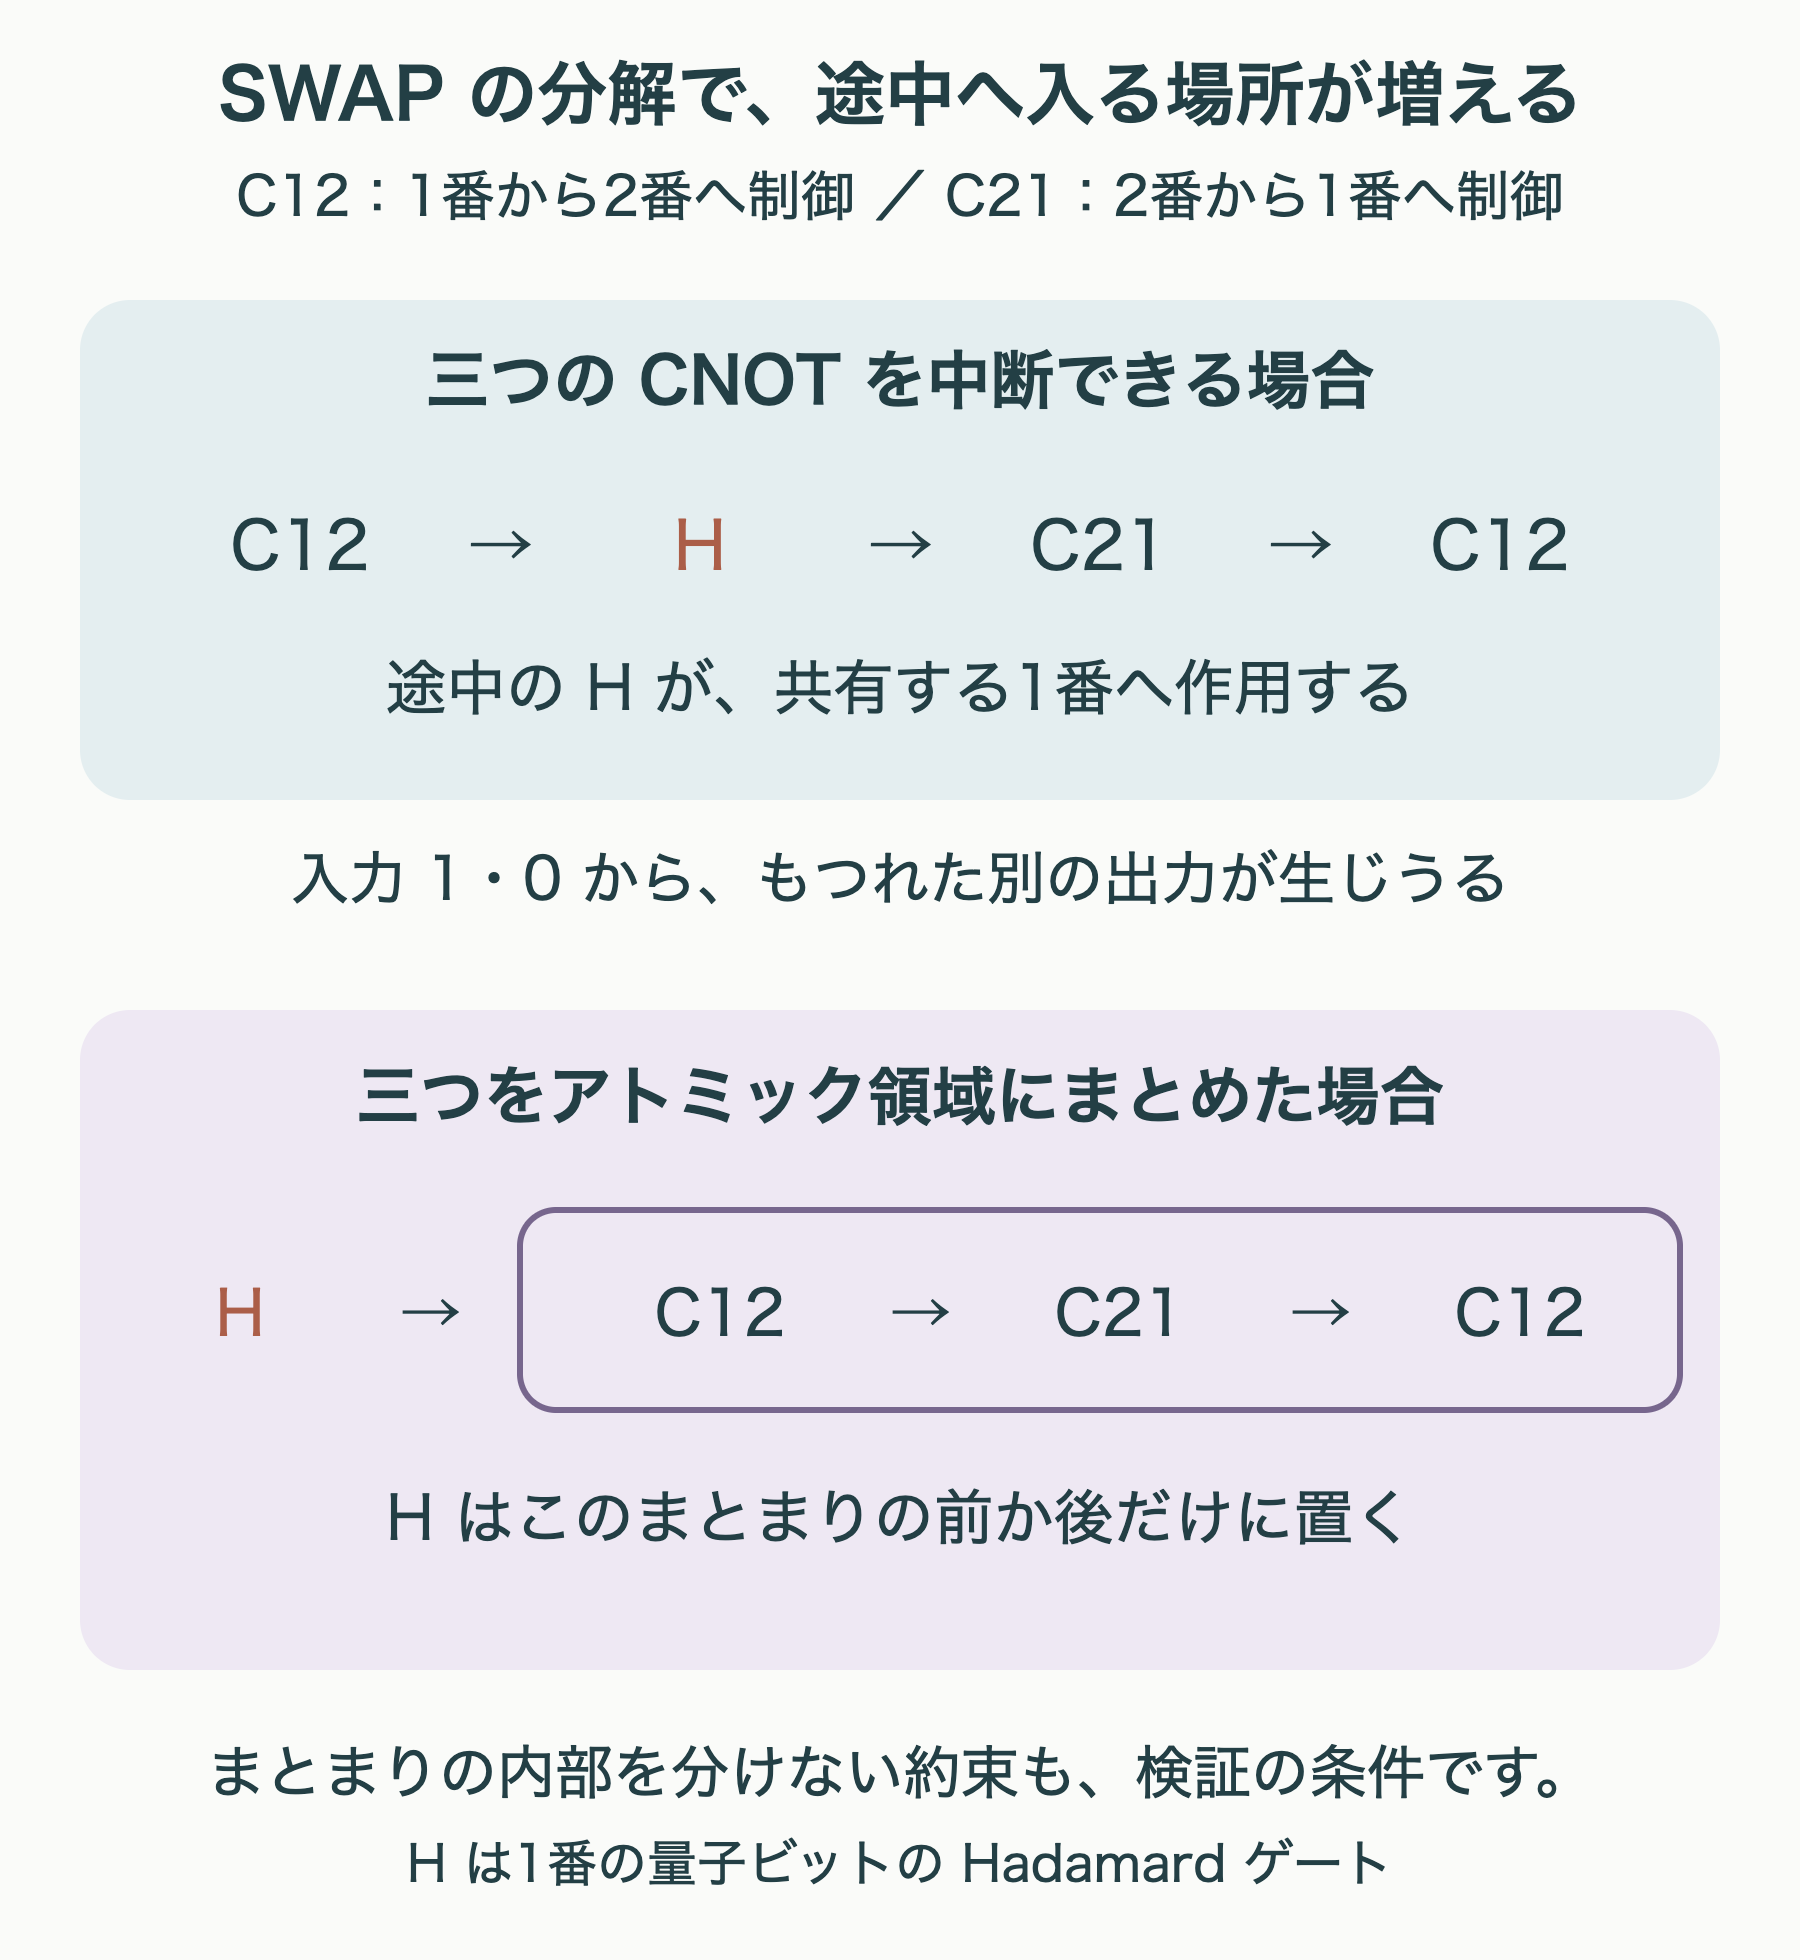
    一方、SWAPは三つのCNOT(制御NOT)ゲートでも実現できます。CNOTは、制御側が1のときに対象側の0と1を入れ替える操作です。「一つ目で二つ目を制御」「二つ目で一つ目を制御」「一つ目で二つ目を制御」と続ければ、全体として入れ替えになります。

    この三操作を途中で中断できるようにすると、Hを入れられる場所が増えます。最初のCNOTの直後へHが入る例では、二つの量子ビットは、1・0と0・1を逆符号で重ね合わせたもつれ状態になります。SWAPの前か後にHを置いた二通りの結果とは異なります。

    SWAPを分解した三つのCNOTの間へHが入る場合と、三操作をアトミック領域でまとめた場合の実行順の違い
    論文の例を二つの動作中の量子ビットで示した実行順の模式図。論文中の三つ目の量子ビットは操作されず、0のままなので省略しています。矢印は手順の順番で、実機の時間間隔ではありません。Quantum Sea作成。

    単独実行でSWAPと三つのCNOTが等価であることは、この例でも変わりません。変わったのは、その途中へ別の操作を入れてよいという約束です。回路の変換だけを確かめ、実行を分ける単位を見落とすと、並行処理を含む全体の振る舞いを取り違えてしまいます。

    途中で割り込まない単位を、回路の意味に含める

    論文は、複数の処理が進む様子を、各処理の内部順序を保ったまま、操作を交互に並べるインターリービングとして表します。一つの入力から、許された順番に応じて複数の出力状態が生じるモデルです。物理的に重なった制御パルスの相互作用を、そのまま計算するモデルではありません。

    ここに導入するのが、アトミック領域です。領域の中にある複数のゲートを、他の処理から見れば途中に入れない一まとまりとして扱います。先ほどの三つのCNOTをこの領域に入れると、Hはその前か後にしか置けず、もとのSWAPを一操作として扱った場合の結果へ戻ります。

    アトミックという名前は、内部が物理的に一個のゲートになるという意味ではありません。実装では複数の操作を行っていても、ほかの処理に対して途中を見せない、という実行上の条件です。その条件を実機の制御やスケジューラーが守れるかは、理論の指定とは別に確認しなければなりません。

    それぞれの証明を、隣の操作が壊さないか

    提案する検証は二段階です。まず、それぞれの回路を単独で動かしたとき、入力に関する条件から、出力に関する条件が導けるかを調べます。途中の各段階にも「この状態の範囲にある」という条件を付けます。

    次に、もう一方の回路の一操作が、その途中条件を壊さないかを調べます。自分の回路だけなら正しかった証明も、共有する量子ビットの状態を他の処理が変えてしまえば、その先で使えなくなるためです。終了した側の条件が、まだ動いている側の操作で崩れないことも必要になります。

    量子系では、一つの量子ビットだけを見た状態では、ほかの量子ビットとの相関が失われることがあります。そこで論文は、条件をヒルベルト空間の部分空間、つまり許される量子状態の範囲として表し、比較する条件を共通の量子ビット集合へ広げてから組み合わせます。共有部分だけを切り出して、もつれを無視する検査にはしません。

    これらの条件が満たされれば、許された操作の入れ替わり方すべてについて、並行回路全体の目的の性質を導けます。論文は、この証明規則が定めた実行モデルに対して健全であることを示しています。規則で証明できた性質はそのモデルの実行で成り立つ、という意味であり、どんな回路でも自動的に証明できるという主張ではありません。

    順序が違っても、守りたい性質は同じことがある

    「互いの証明を壊さない」と「操作の順序を変えても最終状態が同じ」は、同じ条件ではありません。論文のケーススタディは、四つのデータ量子ビットを二つの処理が共有し、誤りの種類を調べるためのシンドローム情報を、それぞれ専用の補助量子ビットへ記録する例です。ここでは途中で測定せず、量子的な相関として情報を保持します。

    各処理が五つのアトミックな段階を持つため、内部順序を保った全十段階の並べ方は252通りあります。提案する規則によって、どの並べ方でも所定のシンドローム相関を保てることを示しています。一方で、合わせて行う論理操作の順序により、最終的な量子状態そのものは違ってよいのです。

    確かめたいこと 必要な見方
    単独で同じ回路か 入力から出力への変換を比べる
    途中に別の処理が入ってもよいか ゲートの分解とアトミック領域を含め、許す実行順を定める
    並行実行でも目的を満たすか 各回路の途中・終了条件を、他の回路の操作が保つか調べる

    量子回路を部品として組み合わせるときは、正しい変換を書くだけでなく、どこまでを一まとまりに実行するか、何を不変に保ちたいかを明示する必要があります。この研究は、その約束を証明へ結び付ける方法を与えています。

    適用範囲には境界もあります。途中の測定結果に応じた条件分岐やループを含む一般の量子プログラムへの拡張は、論文でも未解決の課題とされています。並行処理の理論上の正しさと、雑音のある実機での忠実度や所要時間は、それぞれ別の評価です。

    出典

  • 量子チャネルの排除、正解を決めずに候補を確実に外す

    量子チャネルの排除、正解を決めずに候補を確実に外す

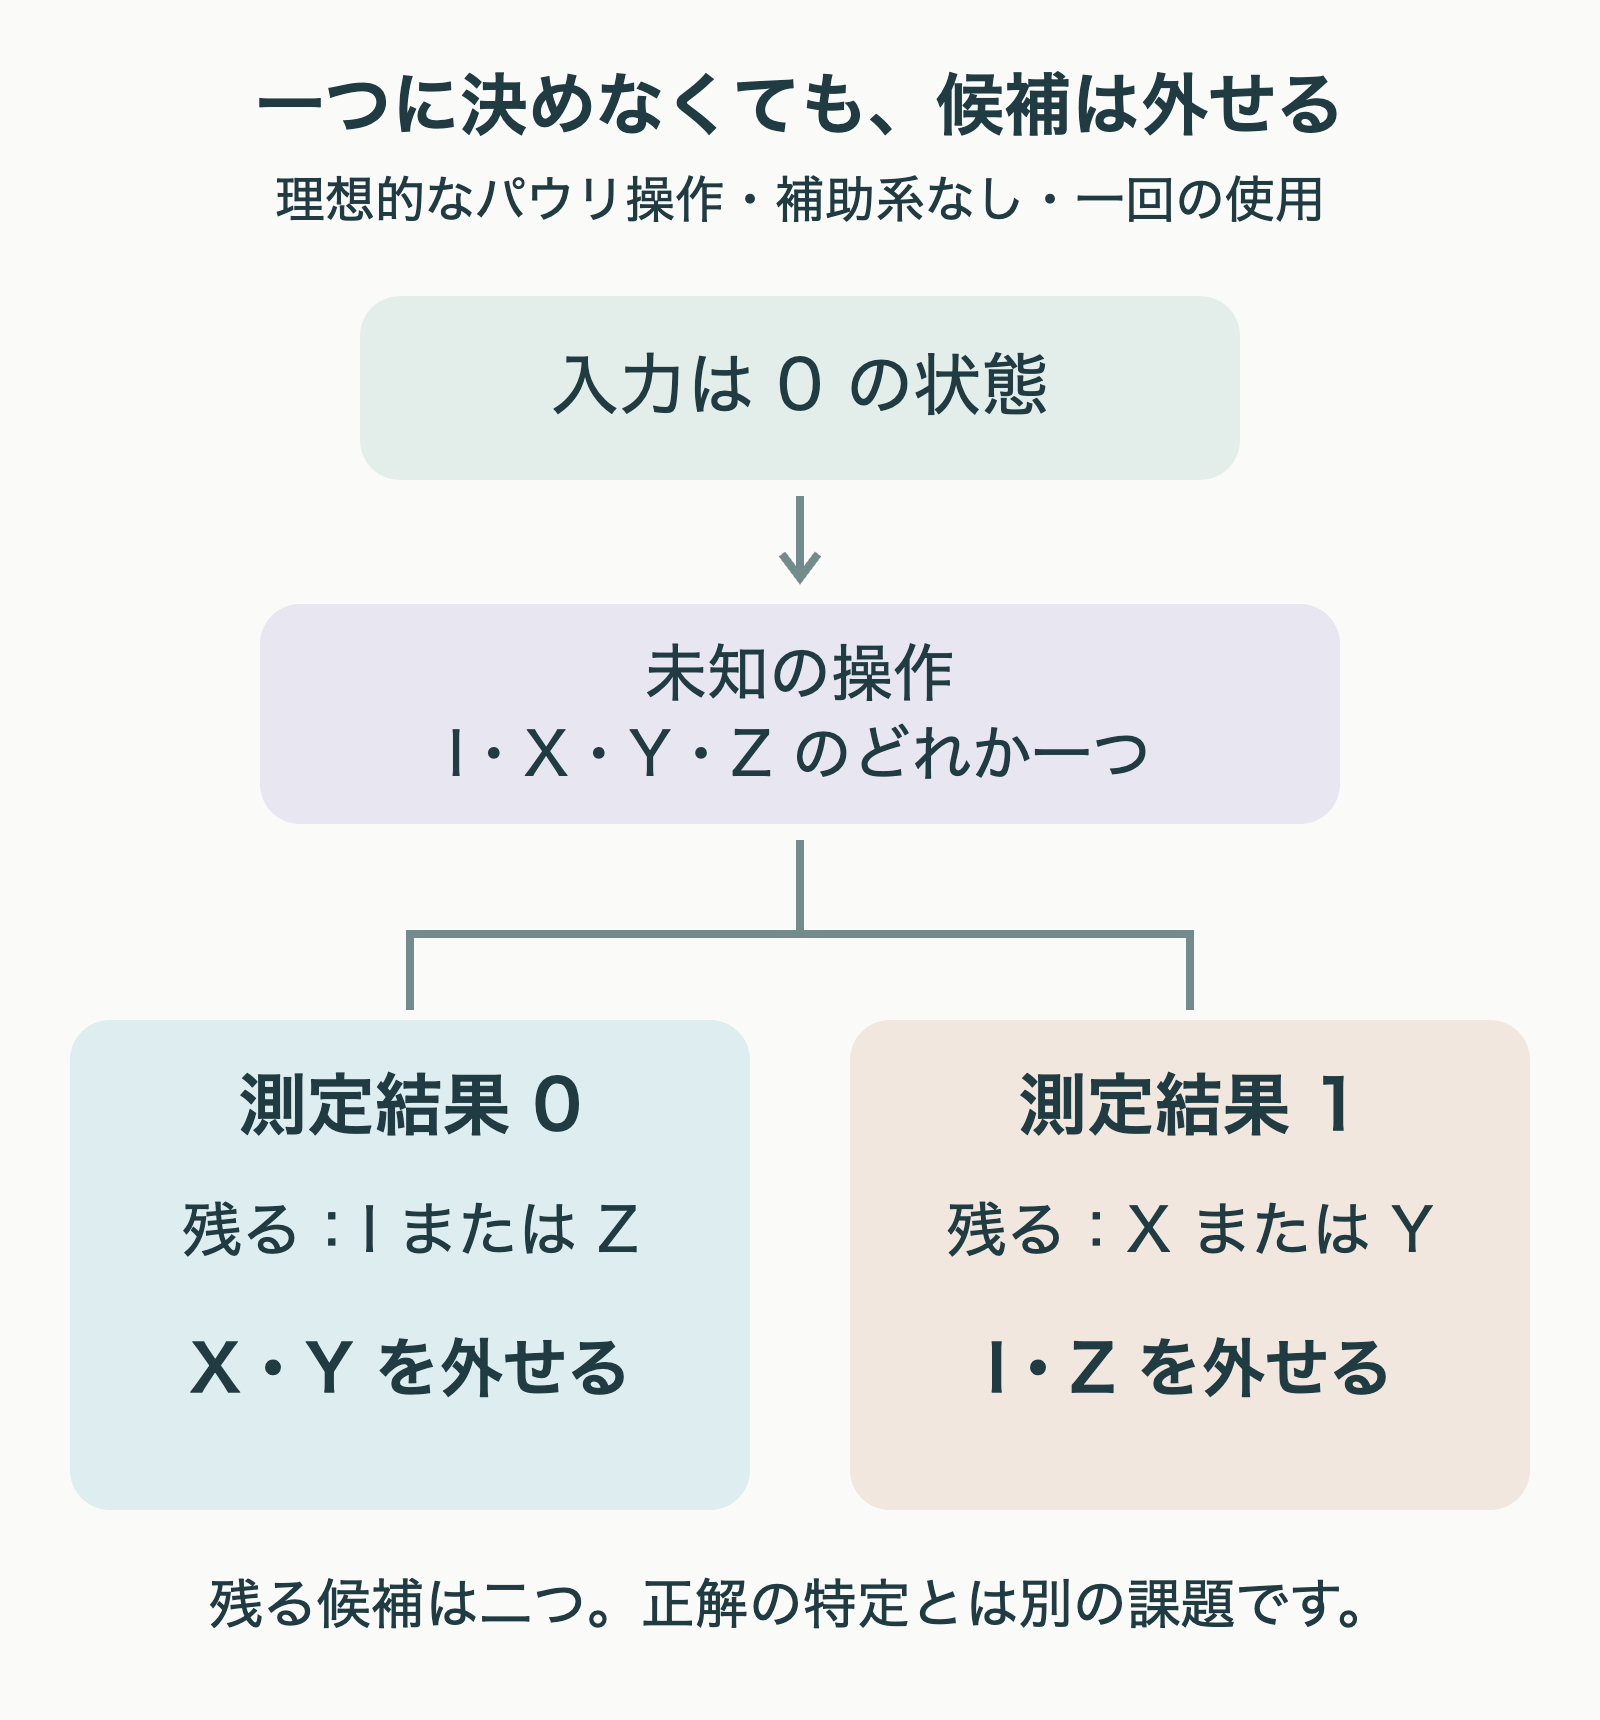
    未知の量子操作を調べても、どの操作だったのか一つには決められない。それでも「少なくとも、この操作ではなかった」と確実に言えることがあります。正解を当てる代わりに、誤った候補を一つ外す。この違いを、量子状態を変える操作の一般的な表現である量子チャネルについて調べた理論論文が、2026年11月3日に公開されました。

    Ardra Ajitha Vijayan氏とNidhin Sudarsanan Ragini氏の「Anti-distinguishability of quantum channels」は、候補が既知で、未知のチャネルを一度だけ使う場合の量子チャネルの排除を扱います。何を「確実に外せる」と呼ぶかを分け、その条件と、共通の雑音がある場合の限界を示したプレプリントです。量子装置を使った実験の報告ではありません。

    簡単にまとめると?

    • 操作を一つに特定できなくても、測定結果と両立しない候補を誤りなく外せる場合があります。
    • 「どの結果でも何かを外せる」ことと、「どの候補にも外せる機会がある」ことは、候補が三つ以上なら別の条件です。
    • すべての候補に同じ雑音チャネルが少しでも混ざるモデルでは、一度の使用による完全な排除はできません。小さな誤りを許す推定の有用性まで否定した結果ではありません。

    四つの操作を、二つの測定結果で調べる

    違いが見えやすいのは、一つの量子ビットに作用する四つのパウリ操作、I・X・Y・Zです。Iは状態をそのままにし、Xは0と1を入れ替えます。Zは重ね合わせの相対的な位相を変え、Yは入れ替えと位相変化を組み合わせた操作です。

    入力を0の状態に固定すると、IとZの後では0、XとYの後では1が測定されます。Yの場合に付く全体の位相は、この測定結果を変えません。したがって、0が出てもIとZのどちらかは決められませんが、Xだった可能性とYだった可能性はともに消えます。1が出た場合は逆です。

    入力0に四つのパウリ操作のどれかを施し、測定0ならXとYを、測定1ならIとZを除外できる分岐図
    補助の量子ビットを使わない理想的な例。測定結果から候補を二つまで絞れますが、一つには決まりません。Quantum Sea作成。
    測定結果 残る候補 確実に外せる候補
    0 I、Z X、Y
    1 X、Y I、Z

    論文では、結果として「Xではない」のように一つの候補名を返す測定を考えます。この例なら、0が出たときはXとYから、1が出たときはIとZから、それぞれ半分の確率で外す候補名を選べます。選んだ候補名は、実際に作用した操作とは必ず違います。

    ここで、候補名を無作為に選ぶことは、答えを当てずっぽうにすることとは異なります。測定によって不可能だと分かった二つの中から選ぶためです。また、どの候補名にも選ばれる機会があります。たとえば「Iではない」という結果は、実際の操作がXやYだったときに起こりえます。

    この比較では、補助の量子ビットを使わない条件が大切です。四つの操作を一度で完全に見分けられないという話を、もつれた補助系まで使う場合へ広げることはできません。何が可能かは、用意する入力状態と、使える測定にも左右されます。

    「何かを外せる」と「どの候補も外しうる」

    論文は、完全な排除を二段階に分けます。弱い意味では、実際に得られるどの測定結果も、少なくとも一つの候補を確実に外せればよく、ある候補を外す結果が一度も出ない測定も含みます。強い意味では、それに加えて、すべての候補について、その候補を外す結果が別の候補のもとで起こりうることを求めます。

    先ほどのパウリ操作の例で、0なら常に「Xではない」、1なら常に「Iではない」と答えるだけでも、答えは毎回正しいままです。ただし、その答え方ではYとZを名指しで外す機会がありません。外せる二候補から選ぶ段階を加えることで、強い意味の条件も満たせます。

    強い排除でも、一回の結果で実際の操作が特定できるとは限りません。候補が二つだけなら、一つを外せば残りが正解ですが、三つ以上では残る可能性が複数あります。排除の「完全」は、正解をすべて知ることではなく、本当だった候補を誤って外さないことを指しています。

    共通の雑音があると、確実さはなぜ崩れるのか

    この確実さには、厳しい条件が伴います。論文が示したのは、各候補のチャネルに同じ雑音チャネルが正の割合で混ざると、弱い意味の完全な排除さえできなくなるという結果です。混ざる割合は候補ごとに違っていてもかまいません。

    直感的には、どの候補を選んでも、ある小さな確率で同じ処理に置き換わってしまう状況です。たとえば共通の雑音が、入力を捨てて同じ状態を出す処理だとします。この処理が起きたとき、出力はどの候補からでも生じます。その結果を見て特定の候補を外すと、その候補が本当だった場合にも外してしまう可能性が残ります。

    完全な排除では、起こりにくい結果も無視できません。雑音の割合を限りなく小さくしても、正である限り、厳密な誤りゼロという条件には届かないのです。論文はこの障害を、特定の入力に限らず、補助系を含む一度の使用の設定で示しています。

    ただし、この結論を「雑音があれば量子操作を調べられない」と読むのは行き過ぎです。対象は、すべての候補に共通の雑音成分があるモデルと、誤りを一切許さない課題です。許容する誤り率を決めて候補を絞る方法や、何度も装置を使う方法の性能は、それぞれ別に評価する必要があります。

    装置の検証に使うなら、何を比べるか

    この研究から得られるのは、測定で知りたいことを分ける視点です。「どの操作かを言い当てたい」のか、「少なくとも特定の操作ではないと示したい」のかによって、必要な入力と測定は変わります。後者で十分な課題なら、完全な識別より弱い要求から検証を設計できる可能性があります。

    一方、実機の検証へ進むには、まず候補となる操作のモデルがどこまで確かかを確かめる必要があります。そのうえで、チャネルを使う回数、補助系の有無、候補ごとの排除の機会、許容する誤りを同じ条件にそろえて比較します。有限回の実験で誤りを観測しなかったことは、モデルの上で確率が厳密にゼロだと示したこととは別です。

    量子チャネルの排除は、見分ける能力を単に点数へ置き換える考え方ではありません。何を確実に否定でき、その確実さがどの仮定に支えられているかを、入力・測定・雑音まで含めて捉えるための枠組みです。

    出典

    • Ardra Ajitha Vijayan, Nidhin Sudarsanan Ragini, Anti-distinguishability of quantum channels, arXiv:2611.04105v1(2026年11月3日公開)。定義とパウリ操作の例は第II節・Example 1、共通雑音の限界はProposition 5、課題の範囲と今後の方向は第VII節。