投稿者: SB-admin

  • ソケットの半閉鎖、送信を終えても返答を受け取れる理由

    ソケットの半閉鎖、送信を終えても返答を受け取れる理由

    依頼のデータを送り終えたので、相手に終わりを伝えたい。しかし、相手が返す結果はこれから受け取りたい。このとき、通信全体を閉じる操作と、自分から送る方向だけを終える操作は区別する必要があります。

    ソケットのshutdownと半閉鎖は、この違いを扱う仕組みです。ここでは同じ計算機内のAF_UNIX・SOCK_STREAMのソケット対を使い、送信の終了、受信で見えるEOF、記述子のcloseを分けて考えます。Linuxの仕様説明と、手元のmacOSで実行した小さな観測例を区別して示します。

    簡単にまとめると?

    • shutdownのSHUT_WRは、そのソケットからの以後の送信を止めます。受信する方向まで止める指定ではありません。
    • 正の長さを要求するストリーム受信では、相手の正常な送信終了後、残るデータを読み終えるとEOFを確認できます。「今データがない」とは違います。
    • closeは記述子を閉じる操作です。依頼の終端を知らせながら返答を待つ設計では、送信終了と記述子の解放を別の段階にします。

    二つの方向を持つ接続として見る

    socketpairは、既につながった名前のないソケットを二つ作り、それぞれを参照するファイル記述子を返します。[1] AF_UNIXは同じ計算機内の通信に使う方式で、ここではバイト列を扱うSOCK_STREAMを選びます。[2] 図では二つの端をAとBと呼び、AからBへ送る方向と、BからAへ返す方向を分けます。

    たとえばAが検査してほしい文章を渡し、Bが最後まで受け取ってから結果を返す処理を考えます。Aが何もせず返答を待ち、Bが入力の終わりを待ち続けると、互いに相手の次の動きを待つ構成になり得ます。本文の長さや終端を別途取り決めるか、送信方向の終了で入力の終わりを示すかを、通信手順として決めておく必要があります。

    SHUT_WRで止めるのは、自分から送る方向

    shutdownの指定には、受信を止めるSHUT_RD、送信を止めるSHUT_WR、両方を止めるSHUT_RDWRがあります。[3] AがSHUT_WRを成功させた場合、この接続についてAがさらに依頼を送り足す段階は終わります。一方で、Bから届く結果をAが受け取る方向は残せます。

    これが、片方向だけを閉じる「半閉鎖」と呼ばれる考え方です。Aが送る方向の終了を、Bが送る方向の終了へ読み替えてはいけません。両端の状態を一つの「接続済み/切断済み」だけで表すと、どちらからのデータがまだ来るのかを見失いやすくなります。
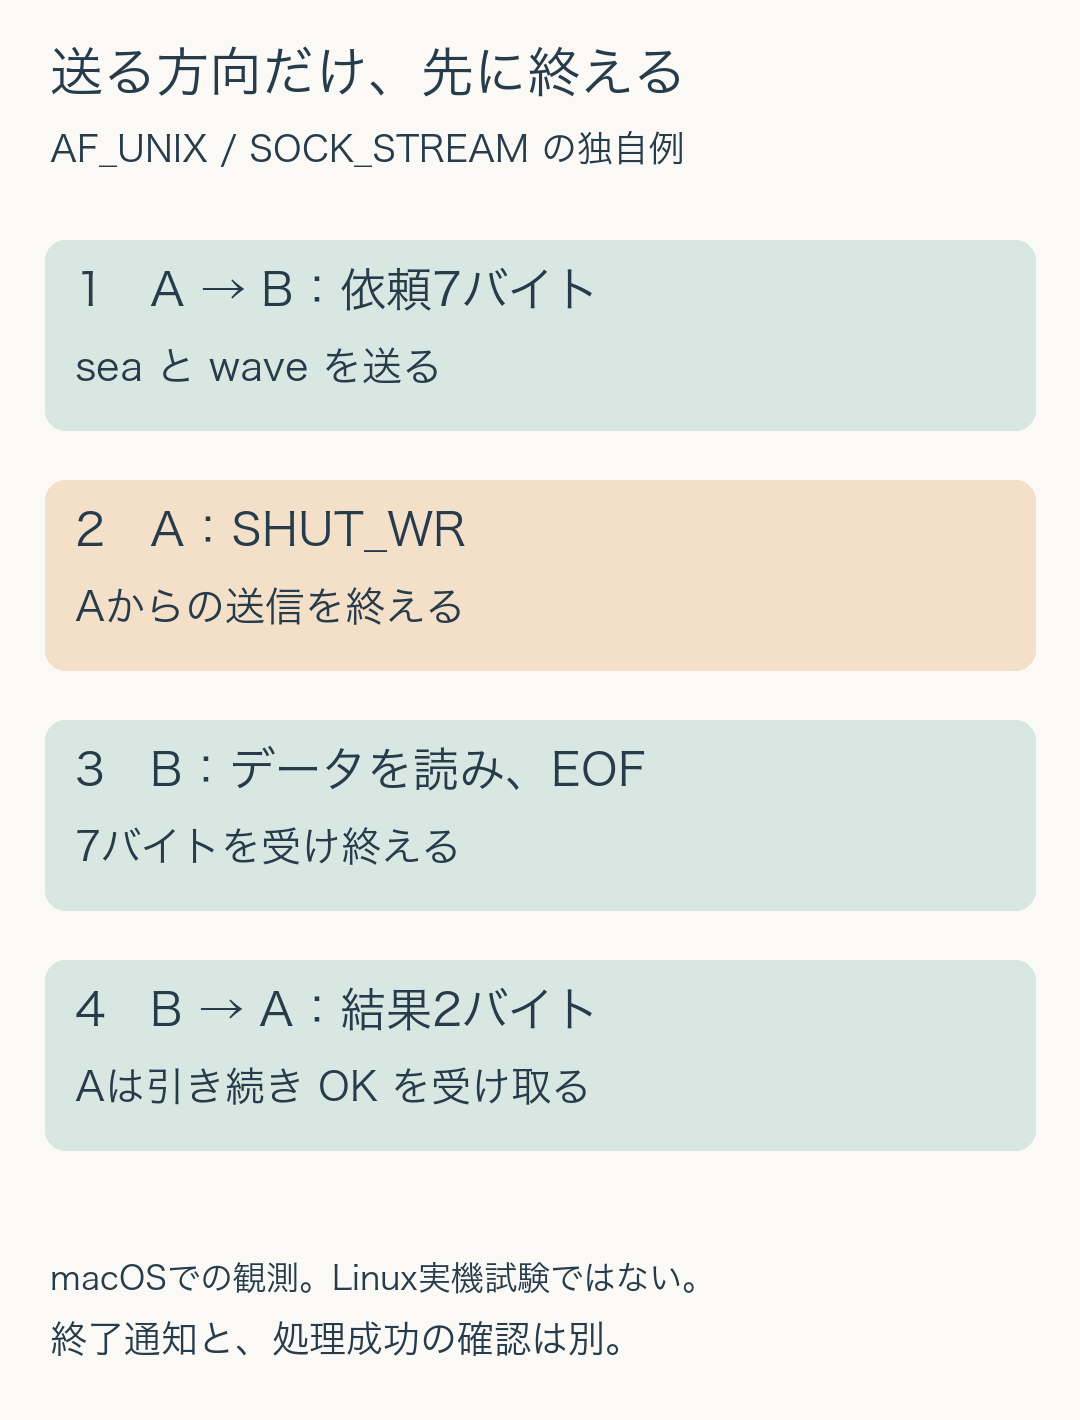
    Aが7バイトの依頼を送り送信を終了し、BがEOFまで読んでから2バイトの結果をAへ返す四段階。
    独自例。Aの送信終了後も、BからAへの返答は別の方向として残る。LinuxのAPI説明と、macOS上のAF_UNIX・SOCK_STREAMの観測を対応させた図。

    7バイトを受け終えてから、2バイトを返す

    手元の例では、Pythonのsocketpairで二つの端を作り、AからASCIIのseaとwaveを順に送信しました。内容は合計7バイトです。続いてAがSHUT_WRを行い、Bは一度に最大2バイトずつ受信して、EOFまで読み続けます。Bは受け取った内容がseawaveであることを確認し、OKという2バイトを返した後、自分の送信方向を終えます。

    この実行では、Bの受信片はse、aw、av、eとなり、その後に空のバイト列を受け取りました。Aは自分の送信を終えた後でもOKを受信できました。ここで確認したのは、この順序で動く小さなローカル例です。macOS上の結果を、Linuxカーネルで試験した証拠や、全ソケット方式で同じ動作になる保証にはしません。

    また、最初にseaとwaveへ分けて送った境目は、2バイトずつの受信片の境目と一致していません。今回の主題は分割数ではなく終了の伝え方ですが、データの一部が届いたことと、依頼全体を受け取ったことも分けて追う必要があります。図の7と2は独自例のバイト数であり、通信性能の比較値ではありません。

    EOFと、今は受け取れない状態を混同しない

    Linuxのrecvの説明では、ストリームの相手が正常に送信を終えた場合、受信は0を返します。一方、データがまだなく非ブロッキング受信が待つ必要のある場合は、EAGAINまたはEWOULDBLOCKで失敗します。[4] EOFはその方向の正常な終了を示す観測であり、待てば次が来るかもしれない一時的な空きとは違います。

    ただし、0という数だけでは判断できません。受信を要求した長さ自体が0の場合や、長さ0のデータグラムを受信した場合にも0が返り得ます。本稿の説明は、正の長さを要求するストリーム受信を前提にしています。ソケットの種類、要求した長さ、戻り値、エラーを一緒に記録して初めて、終端として扱える条件を確認できます。

    同様に、通信がエラーで途切れたことを、正常に全て届いたことへ変換してはいけません。受信の終了を観測しても、送られた内容がアプリの期待する完全な依頼かは別の検査です。件数、形式、必要な項目など、アプリ側の受入条件も用意します。

    closeは、最後の片付けとして別に考える

    closeは指定したファイル記述子を閉じ、その番号を再利用可能にする操作です。同じ実体への別の参照がある場合もあり、一つの記述子を閉じることと、全ての参照をなくすことも同一ではありません。[5] この例では、AとBが必要な受信まで終えた後で、両方の記述子を閉じました。

    依頼を送った直後にAの記述子をcloseすると、その記述子を使って返答を読むことはできません。返答が必要な設計なら、送信の終了を通知する段階と、受信を終えて資源を解放する段階を分けます。逆に、通信方式や上位の手順が半閉鎖を想定していないなら、SHUT_WRを付ければ解決すると決めつけず、その方式の終了規則を確認します。

    shutdownはアプリの処理成功を確認する命令でもありません。依頼を出し終えたこと、相手が終端まで読んだこと、処理結果が届いたこと、記述子を閉じたことを別々に確認します。この四つを分けると、単に「送信完了」と書かれたログから、どこまで進んだのかを読み取りやすくなります。

    出典

    1. Linux man-pages 6.19、socketpair(2)、DESCRIPTION。
    2. 同、unix(7)、DESCRIPTION。
    3. 同、shutdown(2)、DESCRIPTIONとRETURN VALUE。
    4. 同、recv(2)、DESCRIPTIONとRETURN VALUE。
    5. 同、close(2)、DESCRIPTION。具体的な文字列、手順、図は独自例。
  • memfdのシール、内容の固定とサイズの固定を分けて考える

    memfdのシール、内容の固定とサイズの固定を分けて考える

    共有するデータを「確定したので、もう変えられない状態」にしたい。ただし、内容の書き換えを止めることと、入れ物の大きさを変えられなくすることは同じではありません。Linuxのmemfdで利用できるファイルシールは、変更の種類ごとに制約を加える仕組みです。

    ここではmemfd_createとfcntlのシール操作を対象に、内容、縮小、拡大、シールの追加という四つの違いを整理します。名前から「全て固定された」と判断せず、何が禁止され、何が残るかを読み取るための説明です。

    簡単にまとめると?

    • F_SEAL_WRITEは内容の変更を制限しますが、ファイルサイズの縮小・拡大は別のシールで制限します。
    • 追加したシールは外せません。F_SEAL_SEALはシール集合を固定するためのもので、単独で内容やサイズを固定する意味ではありません。
    • F_SEAL_FUTURE_WRITEでは、設定前から存在する共有・書込み可能なマッピングによる変更が残ります。完全に確定した内容を渡す場合とは区別します。

    memfdは、名前で共有する普通のファイルとは違う

    memfd_createは匿名ファイルを作り、それを参照するファイル記述子を返します。作成直後のサイズは0で、ftruncateで大きさを設定したり、writeで内容を入れたりできます。揮発的な記憶を使い、参照が全て失われると解放されます。名前の引数はデバッグ用の表示に使われ、同じ名前を渡せば同じファイルへつながるという意味ではありません。[1]

    シールを使う予定なら、作成時にMFD_ALLOW_SEALINGを指定します。この場合、最初のシール集合は空です。指定しない場合は最初からF_SEAL_SEALがあり、後から別のシールを追加できません。「封印を許可しない」が、内容の書込みまで禁止しているわけではない点に注意が必要です。

    固定したい性質を、別々の軸で見る

    独自例として、16バイトのファイルに確定した設定値が入っているとします。既存の範囲内へ別の値を書く操作、サイズを8バイトへ縮める操作、32バイトへ広げる操作は、全てデータの見え方を変えますが、同じ制約で止まるとは限りません。

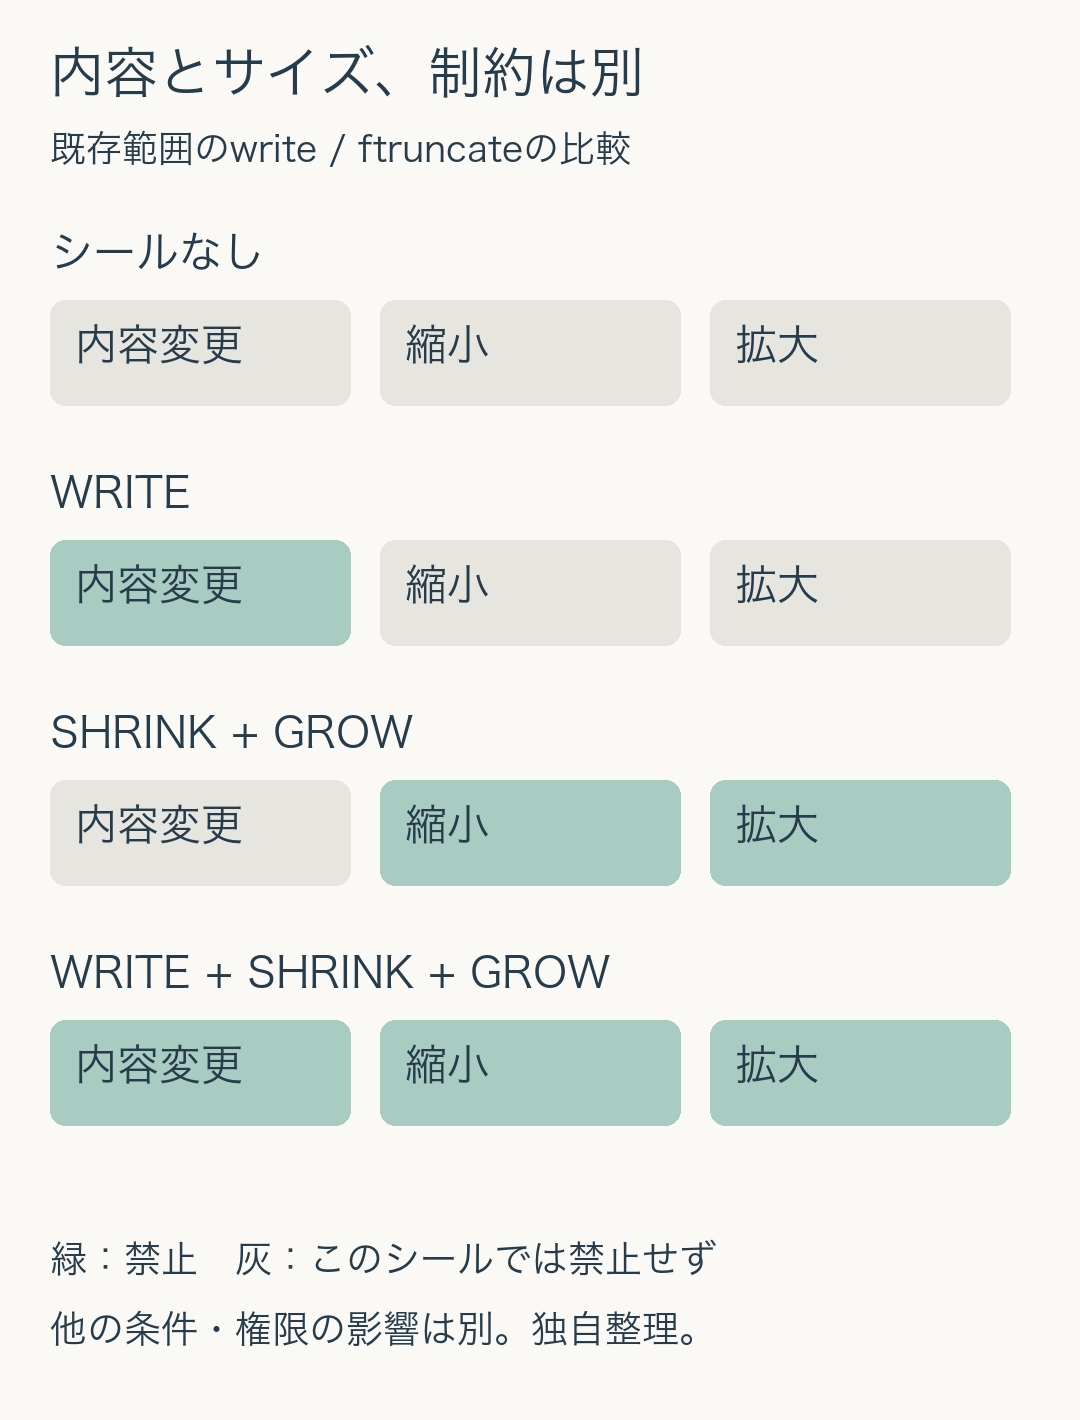
    F_SEAL_WRITEを付けると、writeによる内容の変更や、新しい共有・書込み可能なマッピングの作成などが制限されます。一方で、サイズを縮めることや広げることは、このシール単独では禁止されません。縮小を止めるのがF_SEAL_SHRINK、拡大を止めるのがF_SEAL_GROWです。[2]

    WRITEのみでは内容変更を禁止しサイズ変更は制限しない。SHRINKとGROWではサイズ変更を禁止し、三つを組み合わせると内容とサイズの両方を制限する。
    独自の制約整理。対象操作は既存範囲へのwrite、ftruncateによる縮小・拡大。緑はそのシールが禁止する操作、灰色はそのシールでは禁止しない操作。他の権限や条件による失敗は別に考える。

    図で「そのシールでは禁止しない」とした欄は、実機で必ず成功する保証ではありません。呼び出しの引数や権限、他のシール、メモリーやファイルの状態などは別に確認します。目的は、どの性質をどの制約で守るのかを対応させることです。

    たとえば、読み手が「16バイトある」と確認した後で、別の参照を持つ処理が8バイトへ縮められるなら、サイズ確認時の前提が利用時まで保たれるとは限りません。内容が書き換わらないことだけを確認しても、範囲が維持されることの確認にはなりません。確定した内容と大きさを渡したい場合には、三つの制約を一緒に検討します。

    シールはファイルに付き、追加後には外せない

    シールは一つのファイル記述子だけの設定ではなく、inode、すなわちファイルの実体に属する性質です。同じinodeを参照する複数のファイル記述子は、同じシール集合を共有します。自分の記述子を開き直すだけで制約を回避するための仕組みではありません。[2]

    F_ADD_SEALSはビットマスクで指定したシールを追加し、成功するとカーネルが直ちに制約を適用します。追加済みのシールを取り除く操作はありません。そのため、作成、サイズの設定、内容の記入、検査、制約の追加という順序を、処理の設計として先に考える必要があります。

    F_SEAL_SEALは、この集合への追加そのものを止めます。WRITE、SHRINK、GROWとは役割が異なります。たとえばSHRINKだけを付けた後でSEALを付けると、縮小を禁じた集合が固定されますが、それだけで拡大や内容変更まで禁じた集合に変わるわけではありません。名前のSEALが重なるため、集合の固定とデータの固定を混同しないことが大切です。

    既にある書込み経路を残すかどうか

    F_SEAL_WRITEを追加しようとしても、そのファイルに共有・書込み可能なマッピングが存在するとEBUSYで失敗します。そのようなマッピングを解除してから追加する必要があります。シールを要求したというログだけでは、内容の固定を確認したことになりません。戻り値と実際のシール集合を確認します。[2]

    Linux 5.1で導入されたF_SEAL_FUTURE_WRITEは、既に存在する共有・書込み可能なマッピングを通した内容変更を残せる点が違います。新しい共有・書込み可能なマッピングやwriteによる書込みは制限しますが、設定前から持っていた経路は残ります。

    これは、作成側が更新を続け、他の処理には読取り用として共有したい設計で役立ちます。しかし、受け手が内容を確認した直後から永遠に同じ値である、と推論する根拠にはなりません。更新する主体を残すのか、全ての内容変更を止めるのかを、シールの選択と対応させます。本稿の図はF_SEAL_WRITEの比較であり、FUTURE_WRITEへそのまま置き換えた表ではありません。

    受け取った側も、実際の制約を読む

    F_GET_SEALSは現在のシール集合をビットマスクで返します。受け手は、必要な制約が含まれているかを確認できます。作成側が「確定済み」と説明したことと、必要なシールが付いたことは別の観測です。シールを扱えない対象や操作失敗の場合もあるため、戻り値とerrnoを分けて記録します。

    たとえば、内容とサイズの両方が固定されていることを前提にする読み手なら、WRITE、SHRINK、GROWをそれぞれ点検します。さらに制約集合を変えられないことまで必要かは、別の設計判断になります。単一の真偽値として「sealed」と記録するだけでは、この違いが消えてしまいます。

    本稿はLinux man-pages 6.19の記述から制約の組合せを整理したもので、Linuxカーネル上で各システムコールを実行した試験ではありません。永続化、暗号化、アクセス権の付与、処理同士の同期までシールだけで保証する説明でもありません。内容、サイズ、変更できる経路、実際の設定結果を分けて追うことが、共有データの前提を正確に保つ出発点です。

    出典

    1. Linux man-pages 6.19、memfd_create(2)、DESCRIPTIONとNOTESのFile sealing。
    2. 同、F_GET_SEALS / F_ADD_SEALS、各シールの説明とERRORS。図は指定した操作に対する独自の制約整理。
  • HTTP/1.1のchunked転送、長さが未確定でも本文の終わりを伝える仕組み

    HTTP/1.1のchunked転送、長さが未確定でも本文の終わりを伝える仕組み

    応答を作り始めた時点では、最終的な本文の長さがまだ分からない。それでも、受信側には「ここまでが今回の本文」と伝える必要があります。同じ接続で次のやり取りを続けるなら、接続が切れるまで待つ方法だけでは足りません。

    HTTP/1.1のchunked転送符号化は、本文を長さ付きの小さな塊へ分け、最後の塊と終端を伝える仕組みです。全体長を最初に知らせる代わりに、各部分の長さを順に知らせます。RFC 9112の定義と、短い文字列を使う独自例から、データそのものと境界を表す情報を分けて読みます。

    簡単にまとめると?

    • 各チャンクには16進数で表すデータ長が付きます。数えるのは文字数ではなくオクテット、つまり8ビット単位の長さです。
    • サイズ0の最後のチャンクに続き、必要ならトレーラーの欄を送り、空行で終わります。データ中の数字0を探す処理ではありません。
    • chunkedはHTTP/1.1のメッセージ境界を伝える方式です。圧縮や文字コードの変換とは役割が異なり、Content-Lengthとの併記にも制約があります。

    総量を先に決めず、部分ごとの長さを知らせる

    通常の本文付き応答でContent-Lengthを使う場合、受信側は示された長さを手掛かりに本文の範囲を判断できます。しかし、処理しながら生成する本文では、送信開始時に総量が確定していないことがあります。全体の完成を待って数える設計も可能ですが、生成と送信を並行させたい場合には別の境界の伝え方が必要です。

    そこで、Transfer-Encodingにchunkedを指定し、生成できた部分を長さ付きで送り出します。受信側は長さ行を読み、その数のデータを受け取り、区切りを確認して次へ進みます。全体長が未知であることと、何も区切りを持たないことは違います。小さな長さの情報を重ねることで、全体の終わりまで追えるようにしています。

    7バイトの内容を、二つに分けて送る

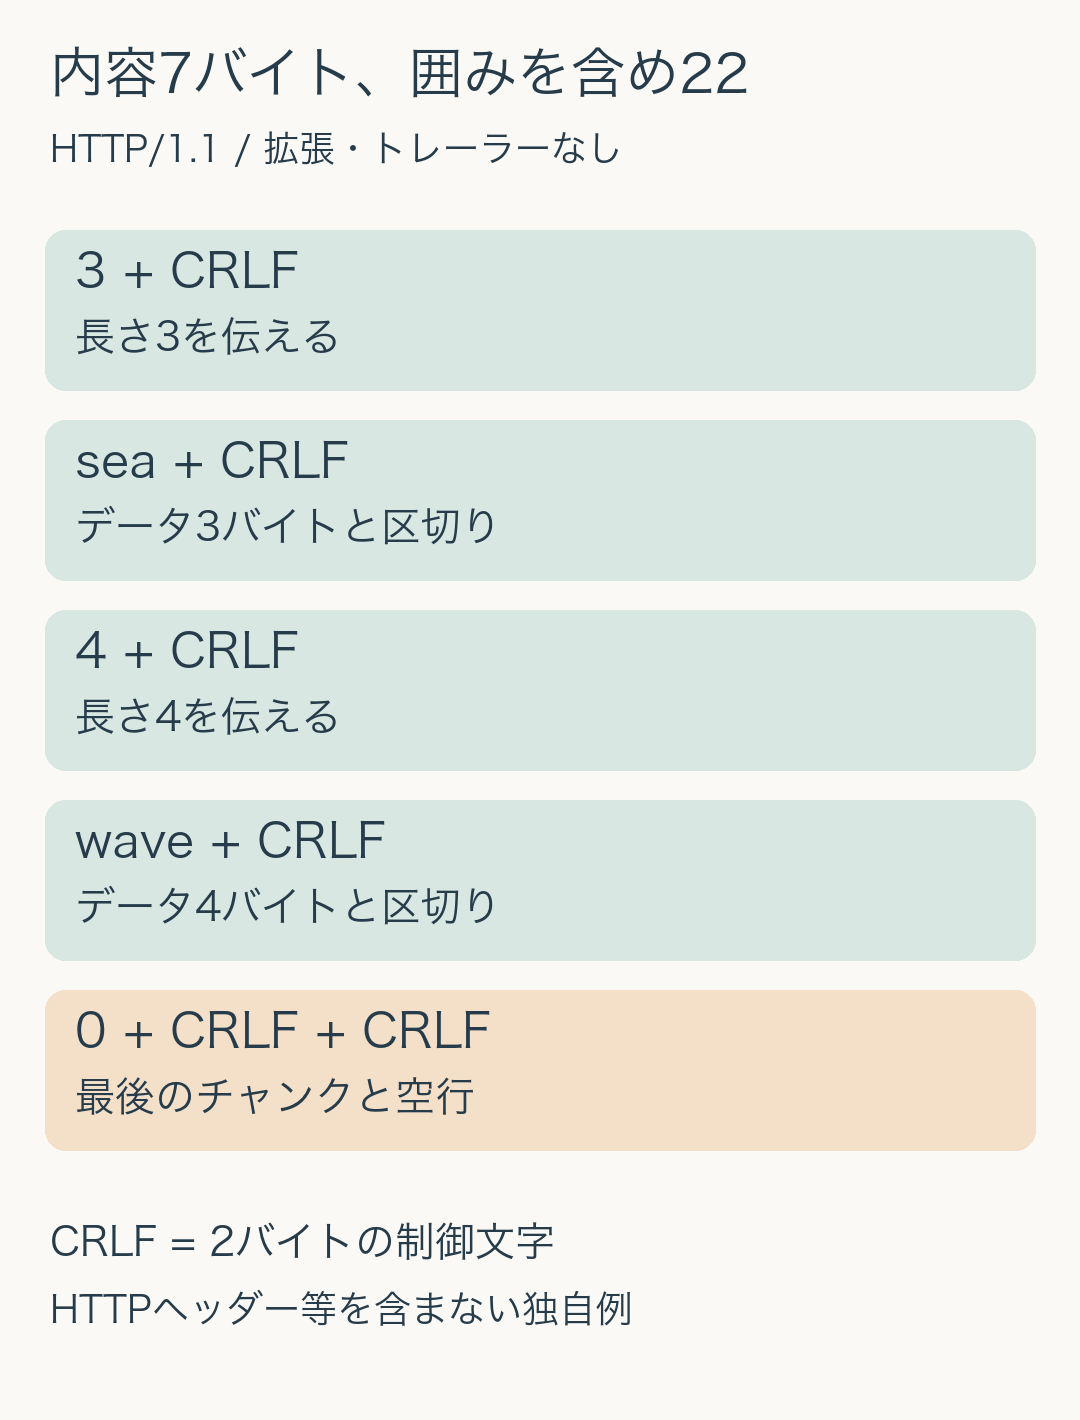
    独自例として、ASCII文字列seawaveをseaとwaveへ分けます。前者は3バイト、後者は4バイトです。拡張情報やトレーラーを付けない場合、チャンク化した本文は次のバイト列になります。表示のため、改行を構成する二つの制御文字をCRLFと書きます。実際にCRLFという4文字を送るわけではありません。

    seaの前に長さ3、waveの前に長さ4を置き、各区切りのCRLFと最後の0・空行を含めると22バイトになる独自例。
    独自に構成したASCIIの例。内容7バイトに対し、チャンク化した本文は22バイト。HTTPの開始行・ヘッダーやTCP等は含まない。CRLFは2バイトの制御文字を示す。

    最初の3とCRLFで3バイト読むと分かり、続くseaがデータになります。その後のCRLFを挟んで次の長さ4を読み、waveを受け取ります。最後は0、CRLF、空のトレーラーを終えるCRLFです。0の行だけを見て、後ろにある欄や終端を無視してよいわけではありません。

    この例のデータは合計7バイトです。長さ行と区切りを含めた本文は22バイトで、同じ内容を一つのチャンクにすると17バイトになります。塊を増やせば、その分だけ長さ行と区切りが増えます。ここで比べたのは構文上のバイト数であり、応答時間や通信性能を測った結果ではありません。

    長さを読む段階と、文字を読む段階を分ける

    チャンクサイズは16進数です。十進で10バイトなら長さ欄はAと表せます。一方、今回の3と4は十進数と同じ見かけなので、例だけでは16進表記である点を見落としがちです。受信処理は、数字の見た目ではなく仕様に従って解釈します。

    さらに、サイズが数えるのはオクテット数です。日本語の文章をUTF-8にしたとき、文字数とバイト数が同じになるとは限りません。まず指定された数のバイトを取り出し、チャンクの構造を解いた後で、本文に合う文字コードとして解釈します。「何文字表示されたか」を、チャンクの終了位置の判定に使うことはできません。

    同様に、データ内に数字0が現れても、それだけでは終端になりません。今が長さ欄を読む段階なのか、指定されたデータを読む段階なのかを区別します。短い例であっても、読む順番と残りバイト数を書き出すと、境界の取り違えを確認しやすくなります。

    圧縮された表現と、転送中の囲み方は別

    Content-Encodingは、gzipなど、表現へ施された符号化を伝えます。Transfer-Encodingは、内容をメッセージ本文として転送する際の処理を表します。chunked自体は、繰り返す文字を短く圧縮する方式ではありません。今回の7バイトが22バイトになったのも、境界を知らせる情報を加えたためです。

    RFC 9112では、Transfer-Encodingを持つメッセージへ送信側がContent-Lengthを付けることを禁止しています。異なる受信処理が別々の境界を採用すると、その後のデータの解釈までずれる可能性があるためです。ログに両方があるとき、都合のよい方を選んでよい通常例として扱わず、仕様のエラー処理を確認します。

    また、中継する受信者が転送符号化を解いたり、別の形へ組み直したりする場合があります。アプリが受け取った本文に長さ行が見えなくても、元の通信がchunkedではなかったとは限りません。観測しているものが線上の本文か、HTTPライブラリー処理後の内容かを記録することが比較の前提です。

    小さな例から一般の受信処理へ進むとき

    一般のchunked構文には、各チャンクの拡張情報と、最後に置くトレーラーの欄があります。サイズの整数変換があふれないか、指定したデータが最後まで届いたか、区切りが正しいかも確認が必要です。本稿の二つのチャンクだけを処理できる模型を、一般のHTTPパーサとしてそのまま使えるとは扱いません。

    ここではHTTP/1.1の本文の囲み方に範囲を限定しました。HTTP/2やHTTP/3のフレームへ、同じ長さ行と終端の並びをそのまま当てはめる説明ではありません。HTTP/1.1でも、本文を持たない応答やCONNECTによる切替などは別の条件があるため、全応答がこの例になるわけではありません。

    設計や不具合調査では、総量を事前に知れるか、どの段階で境界を解くか、受信完了を何で判断するかを分けます。chunkedの役割は、生成途中の内容を順次送れるようにしながら、その一つのメッセージの終わりを受信側へ伝えることです。小さな長さ行を追う作業が、接続の継続と本文の終了を混同しない手掛かりになります。

    出典

    1. RFC 9112, HTTP/1.1(2022年6月、STD 99)、6.1〜6.3節、7.1節。具体的な文字列・バイト数・図は独自の構文模型。
  • mprotect、1バイトの指定でも保護がページ全体へ及ぶ理由

    mprotect、1バイトの指定でも保護がページ全体へ及ぶ理由

    ある領域を読み取り専用にしたいとき、プログラム上の「この変数だけ」という境界が、そのままOSの保護の境界になるとは限りません。Linuxのmprotectは、呼び出したプロセスのメモリ領域について、読み取り・書き込み・実行などのアクセス保護を変更するシステムコールです。

    鍵になるのは、保護を変える単位がメモリページであることです。バイト数で範囲を渡しても、その範囲と重なるページが対象になります。ここではページサイズを4096バイトと仮定した独自例で、指定した範囲と実際に保護される範囲を分け、隣のデータへ影響を及ぼさない設計を考えます。4096は説明用の仮定で、全環境の固定値ではありません。

    簡単にまとめると?

    • mprotectの開始アドレスはページ境界にそろえます。指定範囲に少しでも重なるページ全体が保護変更の対象です。
    • ページを読み取り専用にすることと、そのページ内のデータを消すことは別です。同じページにある別のデータも、同じ保護の影響を受けます。
    • 戻り値で設定の成否を確認し、アドレス・範囲・現在の対応付けを照合します。読み取り、書き込み、実行の関係には環境差があり、フラグの名前だけで実環境の全てを決めつけません。

    バイトで指定し、ページへ広がる

    mprotectへ渡す主な情報は、開始アドレスaddr、長さsize、保護を表すprotです。開始アドレスはページ境界にそろえる必要があります。長さを指定すると、addrからaddr+size−1までの範囲を含むページが対象になります。

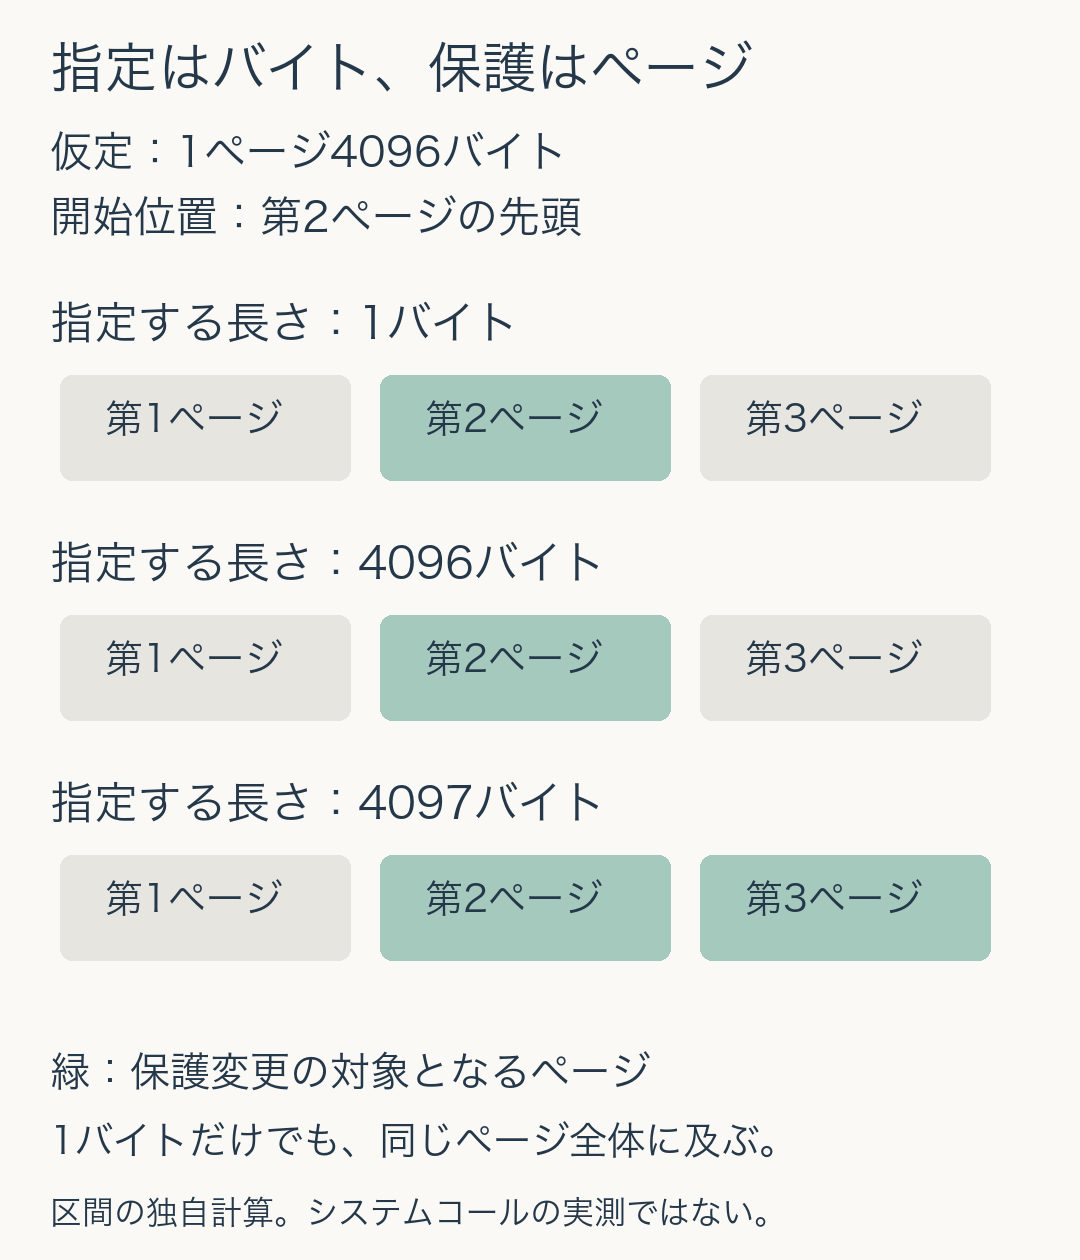
    独自の計算例として、ページサイズを4096バイト、ページ境界にある基準アドレスをBとします。Bから始まる第1ページの相対範囲は0〜4095、第2ページは4096〜8191、第3ページは8192〜12287です。B+4096から1バイトだけを指定したとき、対象はその1バイトだけではなく第2ページ全体になります。

    同じ開始位置から4096バイトを指定しても、対象は第2ページだけです。しかし4097バイトなら、最後の1バイトが第3ページへ入ります。そのため第2・第3ページの二つが対象になります。「長さが1増えただけ」という差が、保護対象では1ページ分の差になるわけです。

    4096バイトのページを仮定し、第2ページ先頭から長さ1または4096なら第2ページ全体、4097なら第2と第3ページ全体が対象になる独自計算例。
    指定範囲とページ単位の保護範囲を分けた独自例。Bはページ境界、ページサイズ4096は仮定。Linux上で保護違反を発生させた実験ではなく、区間の重なりを計算した図。

    境界を丸める前に、巻き込むものを調べる

    では、B+5000にある100バイトのデータを読み取り専用にしたい場合はどうでしょうか。そのアドレスをそのまま開始位置にすると、ページ境界にそろっていません。ページサイズ4096の仮定では、B+5000は第2ページの途中です。

    対象を含むページへ広げるなら、開始はB+4096、終わりはB+8192の直前になります。元の100バイト以外に、同じページにある残りの領域も保護されます。境界を丸めて呼び出しを成立させることと、目的のデータだけに影響を限定できることは違います。

    たとえば、一つのページの前半に公開用の設定、後半に更新中の作業データを置いたとします。設定だけを読み取り専用にするつもりでも、後半への書き込みも影響を受けます。個々のオブジェクトの意味は、ページ単位の保護には反映されません。保護を切り替える予定のあるデータは、配置の段階でページの共有を考える必要があります。

    この例の開始位置や長さは、全て相対位置です。実装では実際のページサイズを取得し、対象アドレスと長さの計算があふれないか、広げた範囲が対応付け済みの領域に収まるかも確認します。図の4096をそのままコードの固定値にすることが、ここでの結論ではありません。

    保護の変更と、内容の変更を分ける

    代表的な指定は、読み取りのPROT_READ、書き込みのPROT_WRITE、実行のPROT_EXECと、アクセスを許さないPROT_NONEです。複数の許可を組み合わせるときはビット単位のORを使います。変更後の保護に反するアクセスを試みると、LinuxはプロセスへSIGSEGVを発生させます。

    これはデータを別の内容へ書き換える操作を指定しているわけではありません。たとえば読み取り専用へ切り替えたページの文字列が、それだけでゼロになるという意味ではありません。データの内容、ページへのアクセス許可、アドレス空間への対応付けは、別々に追います。

    独自例で第2ページを読み取り専用へ変更できたとすると、読み取りを行う処理と、同じ場所を更新しようとする処理は違う結果になります。設定後も更新する設計なら、どの段階でどの処理がそのページを使うかを先に決める必要があります。保護を変更する呼び出しを一つ足しても、処理同士の順序やデータの共有設計まで自動的に整うわけではありません。

    呼び出しが成功したことを確認する

    mprotectは成功時に0、失敗時に−1を返し、失敗理由をerrnoで示します。開始アドレスの整列が不適切、範囲に対応付けられていないページがある、要求する保護を許せない、といった問題を区別して調べます。呼び出したという事実だけで、保護が希望どおりに変わったと扱ってはいけません。

    切り分けには、先ほどの図のような範囲表が役立ちます。渡したaddrとsizeから末尾を求め、どのページにかかるかを確認します。次に、その範囲が対象のマッピング内か、要求した許可とマッピングの条件が合っているかを見ます。アドレスを印字しただけでは、これらの条件を全て確認したことにはなりません。

    また、アクセスフラグ間の関係にはCPUやプロセスの状態による違いがあります。資料では、書き込み許可が読み取り許可を伴うハードウェアや、読み取り指定が実行許可を伴う条件も説明されています。「PROT_WRITEだけなら読み取りは禁止」といった解釈を、全環境へ一般化しないことが大切です。本稿はLinux man-pages 6.19のmprotectを対象とし、保護キーを扱うpkey_mprotectの設計には踏み込みません。

    変数の境界とOSの境界をそろえる

    mprotectを検討するときには、保護したいデータを囲むだけでなく、そのデータがどのページを共有しているかまで見ます。1バイトの指定でも一つのページへ及び、境界を一つまたげば対象ページも増える。この対応を設計と検証の両方へ持ち込むことが、思わぬ保護違反を理解する助けになります。

    図で確認したのは、明示したページサイズと区間に対する計算です。実際の環境では、戻り値、マッピング、保護変更後の処理を別々に確認します。計算上の対象範囲が正しいことと、実機で設定・動作が確認できたことを分けて記録します。

    出典

    1. Linux man-pages 6.19、mprotect(2)(ページ日付2026年2月11日)。DESCRIPTION、RETURN VALUE、ERRORS、VERSIONS。範囲の数値・配置例・図は本稿の独自計算。
  • Schmidt分解、式の項数に惑わされず量子状態の重みを読む

    Schmidt分解、式の項数に惑わされず量子状態の重みを読む

    二つの量子系を合わせた状態を書き下すと、いくつもの項が現れます。しかし、式に項が多いことと、二つの系の間にもつれがあることは同じではありません。各系の基底、つまり状態を表すものさしを選び直すだけで、見かけの項数は変わります。

    Schmidt分解(シュミット分解)は、二体系の純粋状態を、対応する基底の組と非負の係数で整理する方法です。係数を二乗した重みを見ると、基底の見かけに左右されずに比較できる情報が残ります。ここでは二つの量子ビットA、Bを例に、係数行列を作るところから、係数・重み・ランクの違いまでを追います。

    簡単にまとめると?

    • Schmidt分解では、二体系の純粋状態を、A側とB側の直交する基底の組へ整理します。元の式にある項の数を数える方法ではありません。
    • 非負のSchmidt係数を二乗した値が、片方だけの状態の固有値になります。係数そのものを確率として足すのは誤りです。
    • 非ゼロ係数の数がSchmidtランクです。純粋状態ならランク1は積状態、2以上はもつれた状態ですが、同じランクでも重みの偏りは異なります。

    四つの振幅を、2行2列へ並べる

    二つの量子ビットの純粋状態を、A、Bの順で |ψ〉=c00|00〉+c01|01〉+c10|10〉+c11|11〉 と表します。各cは振幅で、一般には複素数です。状態を規格化しているなら、四つの振幅の絶対値の二乗を足すと1になります。

    この四つを、Aの値を行、Bの値を列として並べたものが係数行列Cです。最初の行にc00とc01、次の行にc10とc11を置きます。これは全体の密度行列ではありません。二量子ビット全体の密度行列は4行4列ですが、ここで使う表は状態ベクトルの四つの成分を並べ直した2行2列です。

    Cに特異値分解、略してSVDを行うと、非負の特異値sと、左右の基底を取り出せます。このsがSchmidt係数です。対応するAの基底をa、Bの基底をbとすると、状態は |ψ〉=Σ s_k |a_k〉⊗|b_k〉 という形になります。A側もB側も、同じ側の基底同士は直交し、長さは1です。

    複素数を扱う実装では、右側のベクトルの共役にも注意します。通常のSVDをC=UΣV†と書く約束なら、この係数の並べ方でB側に使うのはVの列を複素共役したベクトルです。ソフトウェアが返すものがVなのかV†なのかも確認します。実数だけの例で問題が見えなくても、複素数の状態へそのまま持ち込めるとは限りません。

    式の項数と、Schmidtランクは違う

    まず |+〉⊗|+〉 を考えます。|+〉は(|0〉+|1〉)/√2ですから、展開すると00、01、10、11の四項が全て現れ、振幅は全て1/2になります。それでも、最初からAの状態とBの状態の積になっており、もつれはありません。

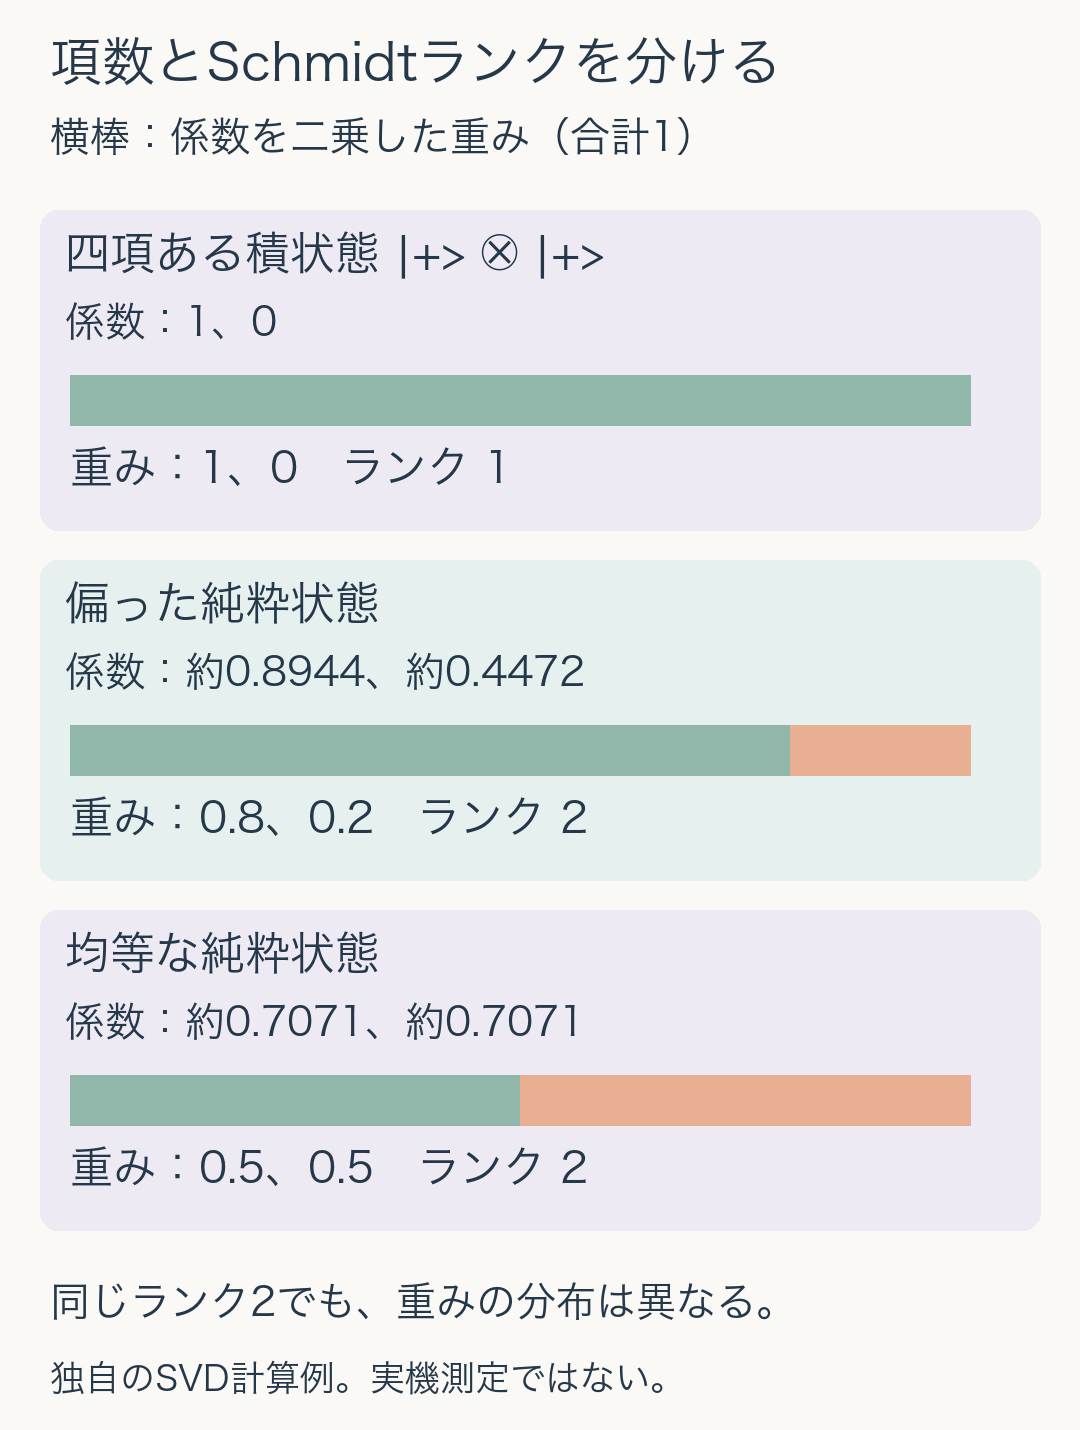
    係数行列は、全成分が1/2の表です。SVDで得られる非ゼロの特異値は1だけで、もう一つは0です。非ゼロのSchmidt係数の数をSchmidtランクと呼ぶので、この状態のランクは1です。「四項あるからもつれている」という判断ができないことが分かります。

    次に √0.8|00〉+√0.2|11〉 を考えます。係数行列は対角成分が√0.8、√0.2で、非対角成分は0です。二つのSchmidt係数がどちらも非ゼロなので、ランクは2です。この純粋状態は、一つのAの状態と一つのBの状態の積にはまとめられません。

    係数を二乗して、比較する重みへ

    規格化された状態では、Schmidt係数の二乗を全て足すと1です。先ほどの例なら係数は約0.8944と0.4472ですが、重みは0.8と0.2になります。係数の和は1ではありません。計算結果を確率として読むときは、どちらを表示しているのかを区別します。

    Aだけの状態を作るためにBを部分トレースすると、B側の基底が直交しているため、異なる番号を結ぶ項が消えます。残るのは、A側の各基底の状態へs_k²の重みを付けた和です。したがって、Aだけの密度行列の非ゼロ固有値はs_k²になります。Bだけを残した場合にも同じ非ゼロ固有値が得られます。二つの系の次元が異なる場合、余分なゼロ固有値の数まで同じとは限りません。

    四項の積状態はSchmidtランク1、偏った重み0.8と0.2の純粋状態と均等な0.5と0.5の純粋状態はともにランク2となる比較。係数と二乗した重みを区別する。
    独自の二量子ビット例。横棒はSchmidt係数の二乗で、合計1の重みを表す。SVDと縮約状態の固有値を計算で照合したもので、量子装置の測定結果ではない。

    均等な例 (|00〉+|11〉)/√2 の重みは0.5、0.5です。こちらもランクは2ですが、0.8、0.2の例と同じ分布ではありません。ランクは、非ゼロの組がいくつ必要かを示します。重みがどれほど均等かまで、一つの整数で表しているわけではありません。

    基底を変えても、係数は変わらない

    Aだけ、またはBだけにユニタリ変換を施すと、局所の基底が回転します。係数行列の各成分は変わっても、特異値は変わりません。これは、同じ二体系の分け方を保ったまま行う局所の変換についての性質です。AとBを結びつける一般の二体系の操作にまで広げることはできません。

    独自計算では、重み0.8、0.2の例のA側へHadamard変換を施し、さらにB側へ位相を加えました。元の係数行列は対角の二成分だけでしたが、変換後は四成分が非ゼロになります。それでも二つのSchmidt係数と、その二乗の0.8、0.2は一致します。振幅の見た目を比べるより、基底に依存しない情報を取り出して比べる利点がここにあります。

    一方、Schmidt係数が同じ値に重なっている場合などには、対応する基底の選び方が一意とは限りません。二つの計算が異なる基底ベクトルを返したというだけで、片方が誤りとは言えません。元の状態を再構成できるか、係数が一致するか、直交性が保たれるかを確認します。

    適用する状態と、数値の小ささを確認する

    ここまでの議論は、全体が一つの状態ベクトルで表せる純粋状態であることを前提にしています。混合状態の4行4列の密度行列を、説明なく2行2列へ読み替えて同じ判定へ入れてはいけません。混合状態のもつれの判定は別の問題です。

    たとえば00を80%、11を20%の確率で準備した混合状態は、積状態を確率的に選んだだけです。Aだけの固有値は0.8、0.2となり、先のもつれた純粋状態と一致します。それでも全体は同じ状態ではありません。「片方の重みが同じ」だけから、全体のもつれを断定しないことが大切です。

    数値計算では、本来ゼロの特異値が丸め誤差でごく小さく残る場合があります。ランクを表示するときは、何以下をゼロとみなすかという許容値も記録します。これは計算上の判断基準であり、小さな値を消しただけで実際の状態の性質が確定するわけではありません。

    Schmidt分解を使うときは、まず二体系への分け方と基底の並びを定め、純粋状態であることと規格化を確認します。そのうえで、係数、二乗した重み、非ゼロの個数を分けて読む。式の項数や見た目に引っぱられず、比較したい情報を選ぶための道具として使えます。

    出典

    1. John Watrous, The Theory of Quantum Information, Chapter 1(2018)。印刷ページ31、Schmidt decompositions、式1.162〜1.164。二体系ベクトルと特異値分解の関係。
    2. 同書、Chapter 2(2018)。Sections 2.1.2の量子状態・混合と純粋状態(印刷ページ62〜64)。数値と図は本稿の独自計算。
  • Content-Disposition、保存する扱いとファイル名の提案を分ける

    Content-Disposition、保存する扱いとファイル名の提案を分ける

    同じPDFでも、リンクを開くと画面に表示される場合と、保存を促される場合があります。HTTP応答のContent-Dispositionは、その内容をどう扱ってほしいか、保存時にどんな名前を候補にするかを伝えるヘッダーです。

    たとえば、日本語の「資料.pdf」という名前を提案しても、実際の保存先や使用する名前は受信側で決まります。応答の扱い方から名前の読み取り、保存までを順に追うと、ヘッダーが担う役割が見えてきます。本稿ではHTTP応答ヘッダーを扱います。フォーム送信のmultipart内にある同名フィールドは対象に含めません。

    簡単にまとめると?

    • attachmentは保存を促す扱い、inlineは通常の処理を示します。Content-Typeが表す内容の種類とは別の情報です。
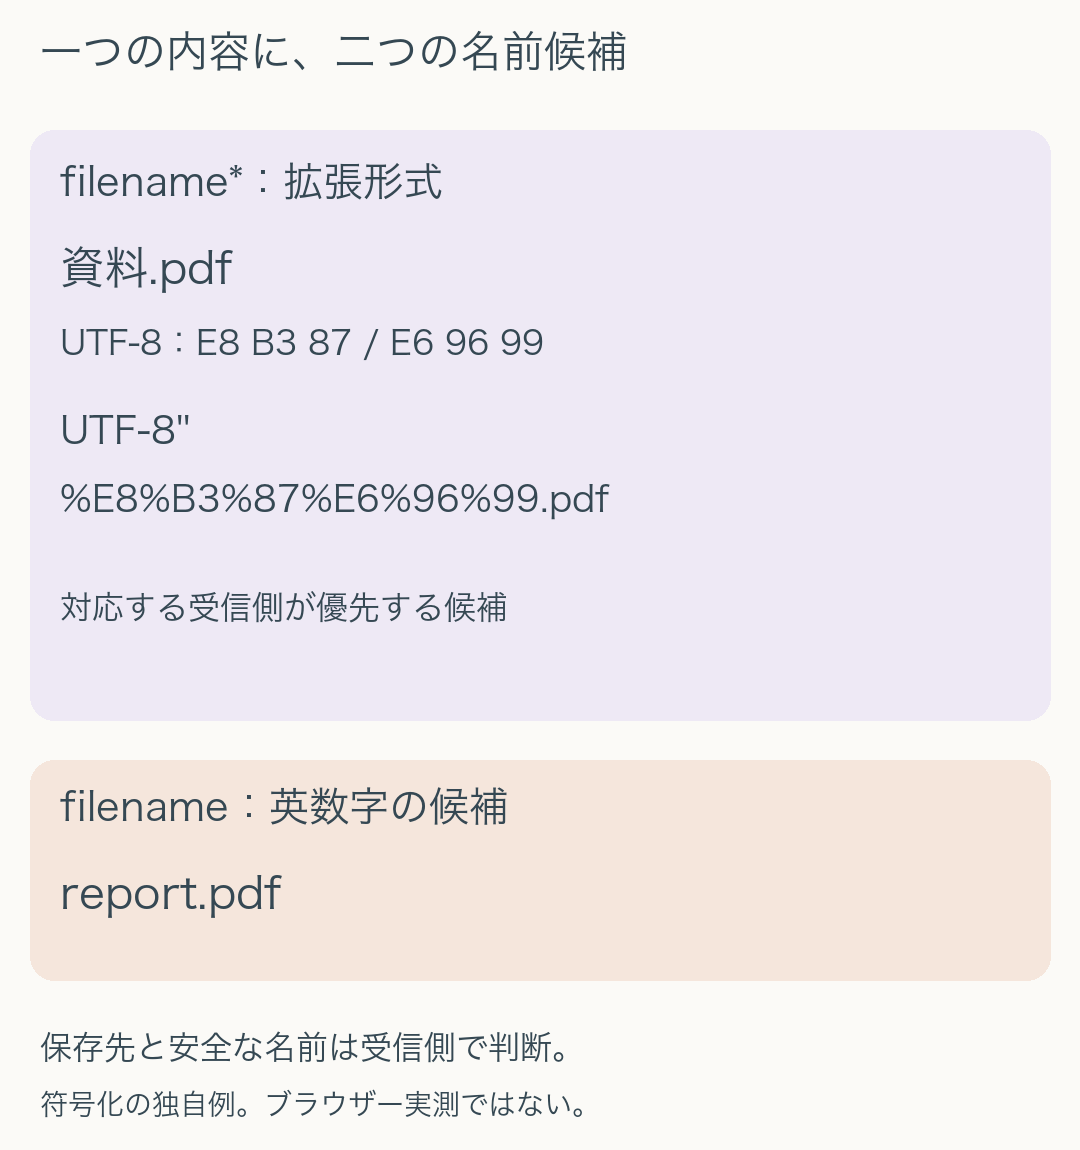
    • filenameは名前の候補、filename*は文字コードを伴う拡張形式です。日本語名と、非対応の受信側向けの英数字名を組み合わせられます。
    • 名前は提案として扱います。受信側はパス・拡張子・制御文字などを確認し、指定された任意の場所への保存を許しません。

    何のデータかと、どう扱うかは別

    Content-Typeは、たとえばapplication/pdfのように内容のメディアタイプを表します。対してContent-Dispositionは、その応答内容の扱いに関する追加情報です。PDFという内容の種類を伝えたうえで、保存を促してほしいと指定できるわけです。

    RFC 6266では、attachmentは通常のメディアタイプに基づく処理よりもローカル保存を利用者へ促すことを示し、inlineは通常の処理を示します。inlineにfilenameを添える場合は、その場では表示し、あとで保存するときの名前の候補として使うことも考えられます。

    実際に出る画面や保存の手順は、ブラウザーなど受信側の機能・設定にも左右されます。attachmentを付ければ、どの環境でも同じダイアログになるわけではありません。

    filename*で日本語の名前を伝える

    filenameは保存名を組み立てるための情報です。たとえばreport.pdfという英数字名なら、そのまま候補を表せます。一方、日本語などを含む名前には、文字コードを明示できるfilename*の形式を使えます。末尾のアスタリスクは飾りではなく、値を読む形式の違いを示します。

    filename*には、文字コード、任意の言語情報、符号化した値を並べます。UTF-8を使い、言語を空にした形なら、先頭はUTF-8''となります。その後ろに、必要なバイトをパーセント表記した名前が続きます。これはHTTP本文全体を変換する処理ではなく、ヘッダー内の名前を表すための仕組みです。

    両方のパラメーターを置く構成では、対応する受信側はfilename*を優先し、filenameを無視することが推奨されています。filenameの側には古い受信側向けの候補を残せます。ただし同じ名前のパラメーターを何度も並べることは別問題で、RFC 6266では同名パラメーターの重複は不正な値です。

    「資料.pdf」をバイトへほどく

    独自の例として、保存名の候補を「資料.pdf」とします。「資」のUTF-8はE8 B3 87、「料」はE6 96 99です。日本語部分の各バイトをパーセント表記すると、%E8%B3%87%E6%96%99.pdfになります。アスタリスク付きの値は、UTF-8''%E8%B3%87%E6%96%99.pdfです。

    非対応の受信側に渡す候補をreport.pdfとすると、二つの名前が同じ応答に共存します。ここで別々のPDFを送っているわけではありません。一つの応答本文に対して、受信側の対応に応じた名前の情報を添えています。

    資料.pdfをUTF-8のバイトへ変換してfilename*へ置く経路と、英数字のreport.pdfをfilenameの候補へ置く経路を示す。どちらも同じ応答本文の保存名を提案する。
    日本語名の符号化と英数字名の候補を分けた独自例。バイト列の計算を確認したもので、各ブラウザーの保存操作を実測した図ではない。

    このパーセント表記は、filename*の拡張形式として読み取るためのものです。通常のfilenameへ入れると、受信側によっては表記がそのまま名前に残るなど、意図と異なる結果になり得ます。空白や特殊文字を扱うときも、URL・フォーム・ヘッダーパラメーターそれぞれの符号化の規則に合わせます。

    読み取った名前を、そのまま保存に使わない理由

    「資料.pdf」を読み取れたら、受信側は保存に使える名前かを判断します。サーバーの指定は名前の提案なので、フォルダー情報が含まれていても、ローカルの保存先を自由に選ばせてはいけません。RFC 6266は、スラッシュやバックスラッシュで区切られたパスの最後の要素だけを取り出す方法を例示しています。

    取り出した名前にも手当てが必要です。制御文字や前後の空白は取り除くか置き換え、OSで特別な意味を持つ名前は避けます。拡張子をもとにファイルの種類を判断する環境では、サーバーの指定を信用すると、あとで開く際に危険な処理へつながるおそれがあります。受け取った内容の種類に合う安全な拡張子を選ぶ必要があり、名前が.pdfであることだけでは内容が正しいPDFかどうかは分かりません。

    こうして名前を整えたあとも、利用者が選ぶ保存先や、同名の既存ファイルがある場合の扱いは受信側で決めます。ヘッダーに名前があることを理由に、任意の場所へ書き込んだり、既存ファイルを無条件に上書きしたりはしません。

    表示や保存が想定と違ったら、どこを見るか

    保存を促したいのに画面で開かれるなら、まず送信した応答のContent-Dispositionがattachmentになっているかを調べます。そのうえで、受信側の設定や実装を確認します。Content-Typeと実際の内容が一致しているかも、応答を調べる段階で押さえます。

    日本語の名前が崩れるなら、filename*の指定とUTF-8のバイト列を確認します。「資料」の符号化と復号が正しく往復できても、受信側がfilename*に対応しているとは限りません。report.pdfが選ばれた場合は、filenameの候補が使われた可能性があります。同名パラメーターを重複させていないかも確認します。

    名前が読めるのに保存時に変わるなら、受信側が名前を安全化したり、同名ファイルとの衝突を処理したりしている可能性があります。対象の環境で、表示・保存・再保存まで確かめると、どの段階で変わったかを追えます。本稿で確認したのは例のUTF-8バイト列の計算であり、ブラウザー間の互換性試験は行っていません。

    Content-Dispositionは、応答をどう扱い、どんな名前で保存してほしいかを伝えます。受信側がその提案を読み取り、利用環境に合う保存方法を決めるところまでが、一連のダウンロード処理です。

    出典

    1. RFC 6266 — Use of the Content-Disposition Header Field in HTTP(2011年6月)。Sections 3、4.1〜4.3、5を参照。
    2. RFC 8187 — Indicating Character Encoding and Language for HTTP Header Field Parameters(2017年9月)。Sections 3.2、3.2.1を参照。RFC 6266が引用するRFC 5987を置き換えた文字コード表現の仕様。
  • MADV_DONTNEEDは何を捨てるのか、次のアクセスで戻る内容を分ける

    MADV_DONTNEEDは何を捨てるのか、次のアクセスで戻る内容を分ける

    大きな計算が終わると、途中で使ったメモリーが不要になることがあります。あとで同じアドレスを使いたいなら、領域の割り当てを残したまま、中身を手放す方法があります。Linuxでは、madviseにMADV_DONTNEEDを指定すると、このような使い方ができます。

    その後に読める値は、メモリーの種類によって変わります。ファイルに結び付いていない、そのプロセス専用の領域ではゼロ埋めされた内容を読みます。一方、共有ファイルの領域では、元のファイルの現在の内容を読みます。以下では呼び出しが成功し、マッピングと読み取り権限が保たれ、その後に別の書き込みがない場合を見ていきます。

    簡単にまとめると?

    • MADV_DONTNEEDは、割り当てたアドレスを残したまま、その範囲を当面必要としないとカーネルへ伝えます。成功後には、そこから読む内容が変わる場合があります。
    • 匿名privateの領域では次のアクセスでゼロ埋めされた内容を読み、共有ファイルの領域ではファイルの現在の内容に基づいて再び使われます。
    • 呼び出し元のRSSが減っても、システム全体で同じ量の物理メモリーがすぐ空くとは限りません。あとで必要になるデータは残しておく必要があります。

    同じアドレスを残し、ページ単位で中身を手放す

    madviseは、指定したアドレス範囲をどう使うか、カーネルへ伝える仕組みです。連続して読むという助言なら、先読みの調整に使われます。MADV_DONTNEEDもその指定の一つですが、処理速度だけでなく、次にアクセスしたときの内容にも関わります。

    操作が及ぶ単位は「ページ」です。ページは仮想メモリーを管理するまとまりで、配列やオブジェクト一つとは限りません。開始アドレスはページ境界に合わせ、指定した長さはページサイズの倍数へ切り上げられます。小さな変数だけを手放したい場合でも、同じページに残すべきデータがあれば、まとめて対象に入ってしまいます。

    アドレスの対応そのものをなくすmunmapとは違い、マッピングは残ります。ただし、同じアドレスを使えることと、以前の値を読み戻せることは別です。次の二つの例では、その違いが中身に表れます。

    匿名privateの作業領域は、次に読むとゼロになる

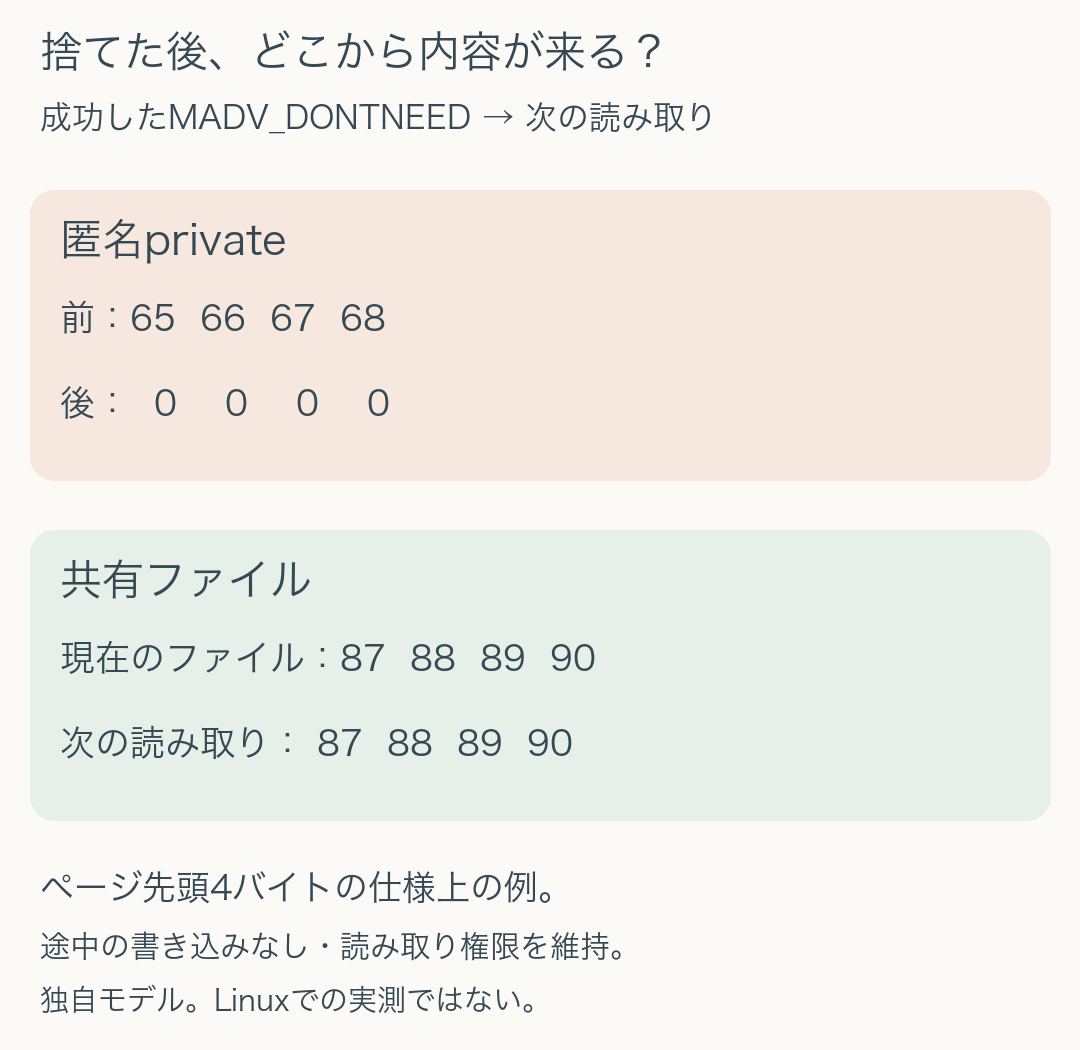
    匿名privateマッピングは、ファイルの内容を元にしない、そのプロセス専用の作業領域です。例えば、一ページに計算途中のデータがあり、先頭4バイトが65、66、67、68だとします。文字ではABCDに対応する値です。

    このページにMADV_DONTNEEDを適用して成功すると、次のアクセスでは、必要に応じてゼロ埋めされたページが用意されます。先ほどと同じ位置から読む値は0、0、0、0になります。文字の「0」が四つ並ぶのではなく、各バイトの数値がゼロです。一ページの変化を、ここでは先頭4バイトに絞って見ています。

    匿名privateの領域には、古い値を再び読み込む元ファイルがありません。計算途中の値をあとで使うつもりなら、この操作で手放さずに保持するか、別の場所へ保存しておく必要があります。再計算できる作業データなら、使うときに作り直す設計も考えられます。

    共有ファイルの領域は、ファイルの現在の内容から戻る

    sharedのファイルマッピングは、ファイルの対応部分を複数の利用者で共有できる形です。MADV_DONTNEEDの成功後にアクセスすると、対応するファイルの現在の内容に基づいてメモリーの中身が用意されます。

    例えば、ファイルの対応する4バイトが87、88、89、90なら、WXYZという内容を元に読みます。捨てる直前の値を凍結して保存し、それを戻す仕組みではありません。ほかの処理がファイルを書き換える場合は、必要な時点の内容を読めるよう、読み書きの順序を同期する必要があります。

    成功したMADV_DONTNEED後の次の読み取りを比較。匿名privateの65、66、67、68はゼロ4個、共有ファイルの例は現在のファイル値87、88、89、90から内容を得る。
    ページ先頭4バイトを使った仕様上の例。マッピングと読み取り権限を維持し、途中の書き込みを置かない。Linuxでの実測ではない。

    ここで比べたのは、匿名privateと共有ファイルの二種類です。privateのファイルマッピングや特殊なデバイス領域は、この二つだけでは説明できません。実装では、領域を作ったときの指定に合う動作を参照します。

    RSSはすぐ減っても、物理ページの解放は遅れることがある

    RSSは、そのプロセスの常駐メモリー量を表す指標です。Linuxのマニュアルでは、共有マッピングにMADV_DONTNEEDを適用すると、呼び出し元のRSSは直ちに減る一方、ページそのものの解放はカーネルが適切な時点まで遅らせられると説明されています。

    共有ページには、ほかの利用者も関わっています。そのため、あるプロセスのRSSが減った分だけ、システム全体の空きメモリーが直ちに増えるとは限りません。再びアクセスすれば、内容を用意する処理も発生し得ます。頻繁に手放してすぐ使う場合は、保持する量を減らせる効果と、再アクセスにかかる負担を実際の環境で比べます。

    また、MADV_DONTNEEDはファイルへの保存完了を保証する操作ではありません。共有ファイルから内容を読めるという説明も、電源断に耐えて保存済みであることを示してはいません。秘密データを確実に消去できたかどうかも、この指定だけでは判断できません。

    ページの種類と、呼び出しの成否を確かめる

    大きなページを明示的に使うHuge TLBページでは、そのページサイズに合わせて開始アドレスを整列し、範囲の長さもその倍数へ切り上げます。通常ページと同じサイズとは限りません。参照したマニュアルでは、MADV_DONTNEEDのHuge TLB対応はLinux 5.18以降です。

    ロックされたページや、カーネル内部でVM_PFNMAPと記された特殊領域には適用できません。後者には、デバイスドライバーがユーザー空間へ割り当てる、通常の仮想メモリー管理の対象ではない領域などがあります。

    madviseの戻り値は成功時に0、失敗時に−1で、失敗の理由はerrnoに設定されます。呼び出しただけで領域がリセットされたとは扱わず、戻り値を確認して失敗を処理します。ここで説明したのはLinuxのmadviseです。似た名前のPOSIXのposix_madviseへ、内容が変わるという動作をそのまま移すことはできません。

    使い終えた作業領域を手放すときは、次に必要なのが同じアドレスなのか、そこに残した値なのかを考えると判断しやすくなります。値を再計算できる領域と、まだ保存していない唯一の結果がある領域とでは、MADV_DONTNEEDを使える場面が変わります。

    出典

    1. Linux man-pages 6.19 — madvise(2)。DESCRIPTIONのConventional advice values、MADV_DONTNEED、RETURN VALUEを参照。例と図は当該仕様を説明するための独自モデル。
  • LinuxのO_PATH、ファイルを参照することと読めることを分ける

    LinuxのO_PATH、ファイルを参照することと読めることを分ける

    openがファイル記述子を返したのに、readすると失敗する。LinuxのO_PATHでは、これは必ずしも異常ではありません。O_PATHは、対象を読み書きするためではなく、ファイルシステム内の対象を参照するための番号を取得する指定です。

    たとえば、ファイルの長さだけを調べたいときと、中の設定値を読みたいときでは、必要な操作が違います。通常のファイルとディレクトリを例に、O_PATHでできることを順に見ていきます。

    簡単にまとめると?

    • O_PATHで得た記述子は対象への参照です。その番号でreadやwriteを行うとEBADFになり、読み書き用の番号とは用途が違います。
    • 属性を調べるfstatや、ディレクトリを基準にするopenatなど、対応した操作には利用できます。使える操作とLinuxの版を確認します。
    • 参照を取得できても、その後の操作に必要な権限がすべて揃うわけではありません。O_PATHはアクセス制御を無効にする指定ではありません。

    「対象を指す」と「中身を読む」は別の役割

    ファイル記述子は、プロセスがカーネルの管理する対象を指定するときに使う小さな整数です。openに渡したフラグによって、その番号を使ってできることが変わります。

    O_RDONLYなら、対象を読み取り用に開くことを求めます。対してO_PATHは、ファイルシステムの木の中で対象を指す参照を取得する指定です。その記述子に対するread、write、mmapなどはEBADFで失敗します。EBADFは無効な記述子などを表すエラーですが、この場合は番号が存在しないのではなく、要求した入出力に使えないことが理由です。[1]

    設定値を解析する関数が内部でreadを呼ぶなら、渡すのは読み取り可能な記述子です。長さなどの属性を調べるだけなら、O_PATHの記述子でも対応する操作を使えます。関数へ番号を渡すときは、その関数が何をするかが選び分けの手掛かりになります。

    同じ四文字のファイルで、三つの操作を比べる

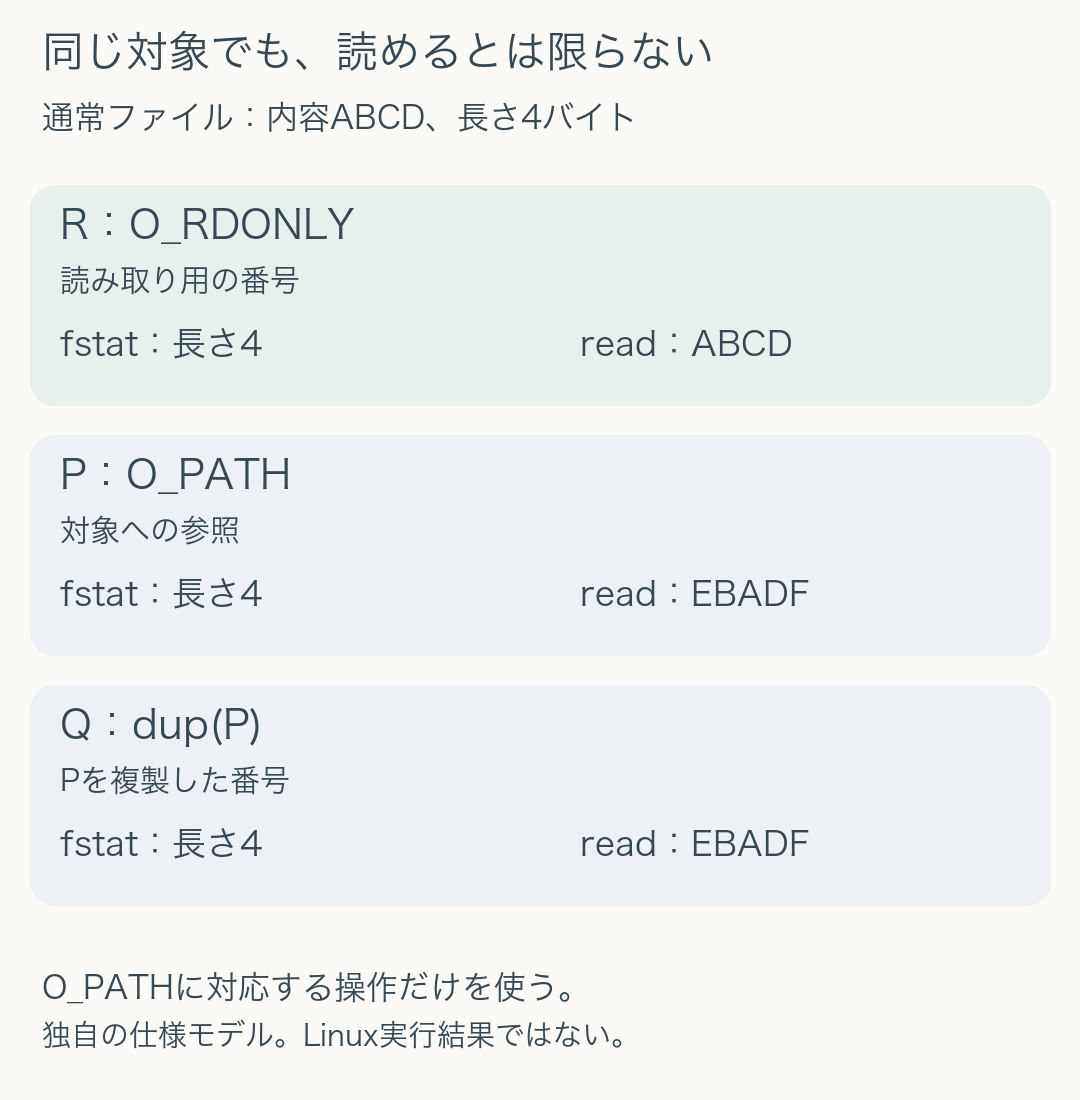
    内容がABCD、長さが4バイトの通常ファイルを考えます。対象は変化せず、必要な権限があり、読み取りが正常に4バイト返る説明用の例です。O_RDONLYで開いた番号Rなら、fstatで長さ4を調べ、readでABCDを読めます。

    同じ対象へのO_PATHの番号Pでも、対応するLinuxの版ではfstatによる属性確認ができます。しかし、Pをreadへ渡してもABCDは得られず、EBADFになります。Pをdupで複製すると別の番号Qが得られますが、二つはカーネル内の同じ管理情報(open file description)を参照します。dupは読み取り用に開き直す操作ではないため、Qでreadしても同じくEBADFになります。

    4バイトのABCDを指す番号を比較。O_RDONLYのRではfstatは長さ4、readはABCD。O_PATHのPとその複製Qではfstatは長さ4、readはEBADF。
    マニュアルの操作条件を整理した独自モデル。Linuxシステムコールの実行結果や性能測定ではない。fstatのO_PATH対応はLinux 3.6以降。

    実際のreadは要求したバイト数より短く終わる場合もあります。上の4バイト例は操作の違いを示すもので、読取り処理をそのまま実装した例ではありません。

    ディレクトリを、後続の処理の基準にする

    O_PATHは、ディレクトリへの参照を保持するときにも使えます。たとえばディレクトリをO_PATHとO_DIRECTORYで取得し、その番号をopenatのdirfdへ渡す構成です。O_DIRECTORYは、対象がディレクトリでなければ失敗させる指定です。[1]

    openatへ相対パスを渡すと、そのパスはdirfdが参照するディレクトリを基準に解釈されます。たとえば「設定ディレクトリの参照D」と相対名configを組にすれば、プロセス全体の現在の作業ディレクトリに頼らず、Dを起点に対象を探せます。絶対パスを渡した場合は、dirfdが無視されます。

    ここでも、Dそのものをreadして設定ファイルの中身を得るわけではありません。Dを基準に、configを別途読み取り用に開き、その新しい番号から読みます。「基準となるディレクトリへの参照」と「選んだ子ファイルの内容へのアクセス」は二段階です。子ファイルを開くopenatが失敗すれば、その内容を読む段階へは進めません。

    また、ディレクトリの参照を持つことは、その中の名前や内容を凍結することではありません。子の名前が付け替えられる場合や、内容が更新される場合には、それぞれの操作時点で何を参照したかを考えます。任意の相対パスを一定の範囲内へ閉じ込める保証や、複数の処理を一つの取引にする保証も、この参照だけでは得られません。

    権限の確認を飛ばす指定ではない

    O_PATHで対象を取得する際、対象そのものの読取り許可は要求されません。ただし、そこへ至る途中のディレクトリをたどるための実行許可は必要です。その後の操作に応じて、別の権限確認も行われます。たとえばfchdirでは、参照先ディレクトリの実行許可が必要です。[1]

    対象への参照を得られることと、その場所へ移動したり内容を読んだりできることは別です。後続の操作にも権限確認が残るため、取得時だけでなく、それぞれの戻り値を見て処理を進めます。

    O_PATHと組み合わせたフラグにも注意が必要です。O_CLOEXEC、O_DIRECTORY、O_NOFOLLOW以外のフラグは無視されます。O_RDWRを一緒に書けば読書きも可能になる、という解釈はできません。内容を読み書きする必要があるなら、そのアクセスモードで別途開きます。

    採用前に確認する条件

    O_PATHはLinux 2.6.39からの機能です。利用可能な後続操作には追加された時期の違いがあり、fchdirは3.5、fstatは3.6からO_PATHの記述子へ対応しています。本稿の比較はLinux man-pages 6.19に掲載された仕様を参照しており、ほかのOSへ同じ名前と挙動を仮定しません。

    O_PATHを使うか迷ったら、取得した番号の行き先を追ってみます。内容を解析するreadへ渡すのか、属性を調べるfstatへ渡すのか、子ファイルを探すopenatの基準にするのか。必要な操作を決めると、読み取り用の記述子を用意すべき場所もはっきりします。

    そのうえで、利用するLinuxの版、相対パスの基準、後続の権限確認、エラー時に記述子を閉じる処理をそろえます。対象への参照を保持する段階と、内容へアクセスする段階を分けておくと、失敗した場所も追いやすくなります。

    出典

    1. Linux man-pages 6.19 — open(2)、DESCRIPTIONのO_PATH・O_DIRECTORY・openat、およびNOTESのOpen file descriptions。取得した掲載版を資料庫へ保全。操作比較の表と4バイト例は独自の説明モデル。
  • 量子チャネル後の忠実度、値が上がっても元の情報が保たれるとは限らない

    量子チャネル後の忠実度、値が上がっても元の情報が保たれるとは限らない

    量子状態の忠実度が上がると、装置の動作が良くなったように見えるかもしれません。しかし、比較している二つの状態が同じ雑音を受ける場合、違いが失われることで忠実度が上がることがあります。近くなったという数値だけでは、元の情報が保たれたとは判断できません。

    この関係を表すのが、量子チャネルに対する忠実度の単調性です。二つの入力へ同じ処理をした後の比較と、処理後の状態を固定した理想状態と比べる評価を、小さな計算で分けてみます。

    簡単にまとめると?

    • 二つの状態へ同じ量子チャネルを作用させると、状態間の忠実度は下がりません。両方に同じ処理をすることが条件です。
    • 忠実度が上がる理由には、二つの状態の違いが雑音で消える場合もあります。値の上昇を、情報の保存や装置性能の改善とは呼べません。
    • 出力を固定した理想状態と比べる忠実度は、別の比較です。同じ例でも、出力同士の忠実度は上がり、理想状態への忠実度は下がります。

    式の両側で、同じものを比べているか

    この記事では、平方根を取る側の定義を忠実度Fと呼びます。密度行列ρとσに対し、F(ρ,σ)=Tr√(√ρ σ √ρ)です。Fの二乗を忠実度と呼ぶ文献もあるため、数値を読むときは定義を揃えます。ここでいう密度行列は、同じ入力空間にある正規化された量子状態です。[1]

    量子チャネルΦは、状態を別の状態へ変える処理を、完全正値かつトレース保存の写像として表したものです。測定結果の一部だけを選別せず、すべての結果を含めた決定的な処理を考えます。有限次元で、次の不等式が成り立ちます。[1、定理3.27]

    F(ρ, σ) ≤ F(Φ(ρ), Φ(σ))

    左は二つの入力の比較、右はその両方へ同じΦを作用させた出力同士の比較です。片方だけを処理する式ではありません。固定した理想状態σと、処理後のΦ(ρ)を比べるF(Φ(ρ),σ)には、この式をそのまま使えません。

    単調性とは、この処理の前後で値が減らないという関係です。必ず大きくなるわけでもありません。同じユニタリ変換を両方へ行う場合は忠実度が保たれます。回転によって二つを同じように動かすことと、違いを消してしまうことを、どちらも「忠実度が下がらない」の一言だけで区別することはできません。

    0と1を、同じ割合で混ぜていく

    最初の状態をρ₀=|0〉〈0|、ρ₁=|1〉〈1|とします。この二つは直交しているため忠実度は0です。ここへ、確率pで完全混合状態I/2へ置き換え、残りの確率ではそのままにする処理を考えます。Iは2×2の単位行列、0≤p≤1です。

    Φp(ρ) = (1−p)ρ + p I/2

    これは、密度行列に対する処理の式です。行列一般へ写像を拡張するときは、置換側をp Tr(X) I/2と書きます。何もしないチャネルと、入力を捨ててI/2を用意するチャネルを確率的に混ぜているため、ここでは正当な量子チャネルになっています。実際の装置の雑音が必ずこの一つのパラメーターで表せるとは仮定しません。

    基底を|0〉、|1〉の順にすると、二つの出力はどちらも対角行列です。ρ₀からの出力はdiag(1−p/2,p/2)、ρ₁からの出力はdiag(p/2,1−p/2)になります。対角行列同士なので、対応する対角成分の積の平方根を足して忠実度を求められます。

    F(Φp(ρ₀), Φp(ρ₁)) = √(2p−p²)

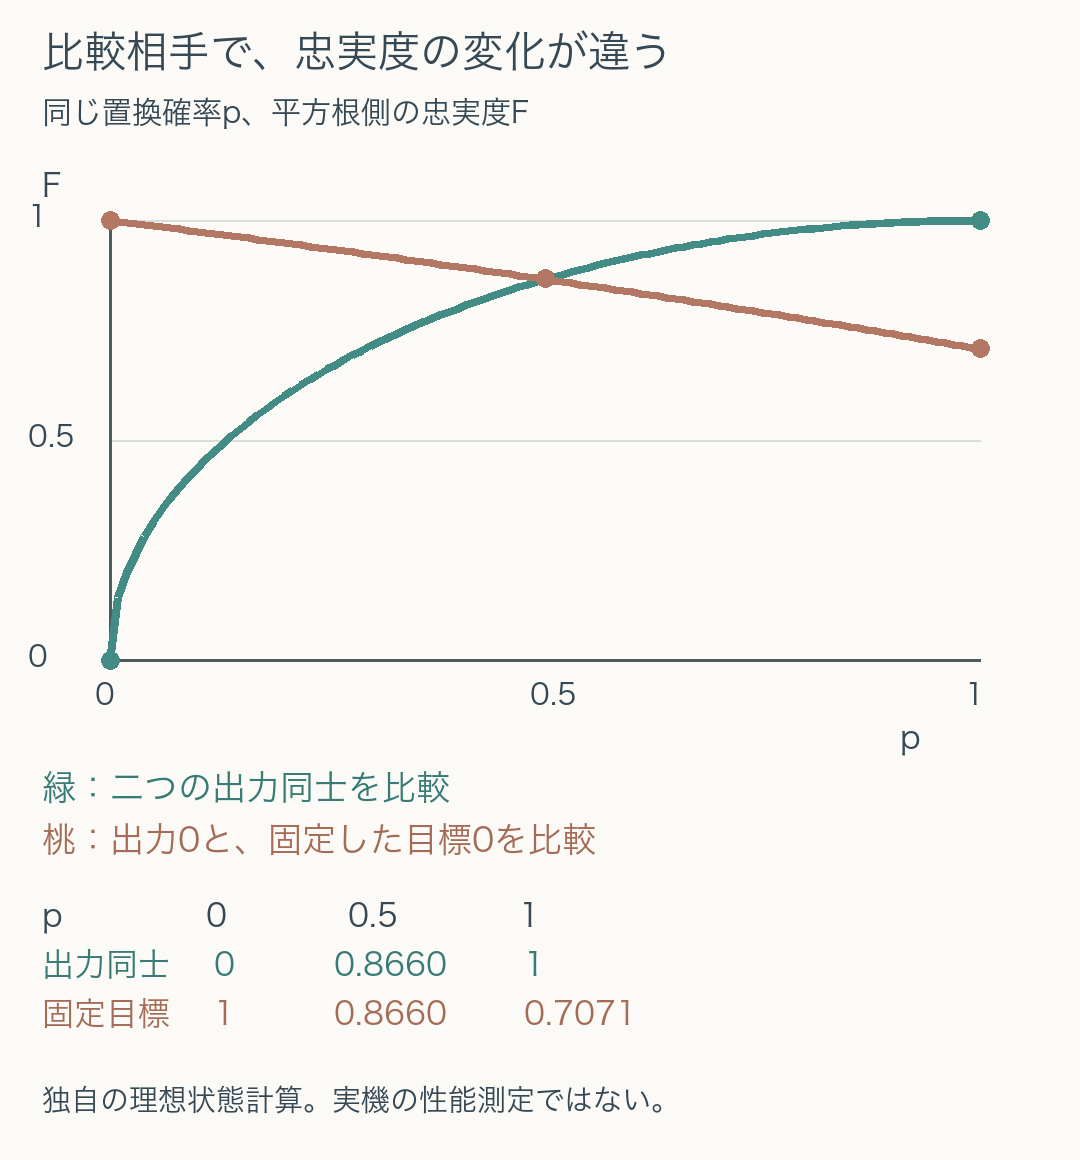
    p=0なら0、p=0.5なら√0.75≒0.8660、p=1なら1です。pを増やすと出力同士は近づき、最後には両方ともI/2になります。忠実度1は、この比較では二つの出力が同じになったことを表します。入力の0と1を良い状態のまま保存できた、という意味ではありません。

    pが0、0.5、1と増えると、出力同士の忠実度は0、0.8660、1。出力0と固定目標0の忠実度は1、0.8660、0.7071。同じ処理でも比較対象で変化が異なる。
    指定した1量子ビットの置換混合モデルによる独自計算。平方根を取る忠実度Fを使用。実機の測定値ではない。

    固定した目標に対しては、値が下がる

    次はρ₀から作った出力だけを取り出し、処理前の理想状態|0〉を固定した目標として比べます。目標が純粋状態なので、忠実度はその状態への射影確率の平方根です。

    F(Φp(ρ₀), ρ₀) = √(1−p/2)

    今度はp=0で1、p=0.5で約0.8660、p=1で約0.7071です。出力同士の忠実度は上昇していたのに、固定した目標への忠実度は低下しました。二つの計算は矛盾していません。一方では目標側も同じチャネルを通し、もう一方では元の理想状態を固定しているからです。

    装置が理想の出力をどれほど再現できるかを評価したいとき、雑音を受けた出力同士を近づける指標だけでは足りません。比較相手を固定した目標にするのか、同じ処理を受けた別入力の出力にするのかを、数値の横へ明記する必要があります。

    同じ出力から、失った違いを取り戻せるか

    p=1では、元が0でも1でも受け取る状態はI/2です。出力しか受け取れず、どちらが準備されたかを示す別の記録もないなら、この出力に同じ後処理を加えて入力の違いを取り戻すことはできません。同じ入力I/2に同じ処理をすれば、どちらの場合も同じ結果になるからです。

    この説明は、情報を持つ補助系や、エラーの記録、事前に施した誤り訂正まで否定するものではありません。それらを利用する処理は、今回の「出力だけ」という条件と異なります。チャネルの入力・出力として、どの系や記録を含めたのかも比較条件の一部です。

    また、特定の測定結果が出た試行だけを採用する選別では、成功確率を伴う条件付き状態を扱います。選別後の状態を正規化して比べる操作へ、上のトレース保存チャネルの不等式を無条件に当てはめることはできません。選別ありの報告では、得られた状態と採用率を分けて読む必要があります。

    「忠実度が改善した」を読むときの条件

    最初にFとF²のどちらかを確認し、次に比較する二つの状態を具体的に書きます。両方へ同じチャネルを作用させた比較なのか、理想状態を固定した比較なのか、試行の選別を含むのかを揃えると、値が上がった理由を絞れます。

    今回の二つの曲線は、同じ置換確率pを使っています。それでも、出力同士の一致は増え、理想状態への一致は減りました。状態が近くなることと、保持したい情報が残ることを分けるために、単調性は有用な確認条件になります。有限の測定データからの状態推定、実機の誤差、チャネルそのものの性能指標は、この理想的な計算とは別に扱います。

    出典

    1. John Watrous, The Theory of Quantum Information — Chapter 3、忠実度の定義と性質、および定理3.27・式(3.173)(書籍156頁)。著者の公開PDF保存版を参照。
  • mmapのPRIVATEとSHARED、メモリーへの変更はどこへ届くのか

    mmapのPRIVATEとSHARED、メモリーへの変更はどこへ届くのか

    ファイルをメモリーへ対応付けるmmapでは、配列へ値を入れるように内容を扱えます。ただし、その代入が元のファイルへ届くかどうかは、書き込みを許しただけでは決まりません。MAP_PRIVATEとMAP_SHAREDの選び方が、変更の行き先を分けます。

    ここでは、同じ初期データへ一文字だけ代入する例から、読み書きの許可、変更の共有、保存の同期を分けて考えます。対象は通常のファイルを使ったマッピングです。匿名メモリー、デバイス固有の領域、性能比較は扱いません。

    簡単にまとめると?

    • MAP_PRIVATEへの書き込みは、そのマッピングの私有の変更になります。元のファイルを編集するための指定ではありません。
    • MAP_SHAREDは変更を同じ領域の共有マッピングやファイルへ伝える方式です。ただし、複数の値を一括で更新する仕組みまでは用意しません。
    • 書けるかを指定するPROT_WRITE、変更の共有先、書き戻しを待つmsyncは別の役割です。用途に合わせて三つを確認します。

    書き込み許可と、変更の行き先を分ける

    mmapが作るのは、プロセスの仮想アドレス空間と、ファイルのある範囲との対応です。プログラムは返されたアドレスを通してその範囲を扱います。Linuxのmmapでは、prot引数が読み書きなどの保護を、flags引数がマッピングの共有方式を指定します。[1]

    PROT_WRITEは、そのマッピングへ書き込めるよう求める指定です。一方、MAP_PRIVATEかMAP_SHAREDかは、その変更を誰と共有するかに関係します。「書き込める」という条件だけから、「元のファイルが変わる」と結論してはいけません。要求する保護と、ファイルを開いたときのモードも整合させる必要があります。

    この二つを分けておくと、ファイルの内容を作業用に加工する処理と、ファイル自体を更新する処理を設計しやすくなります。同じ代入式でも、どのマッピングを通して実行するかで意味が変わるからです。

    ABCDの二文字目を変える、小さなモデル

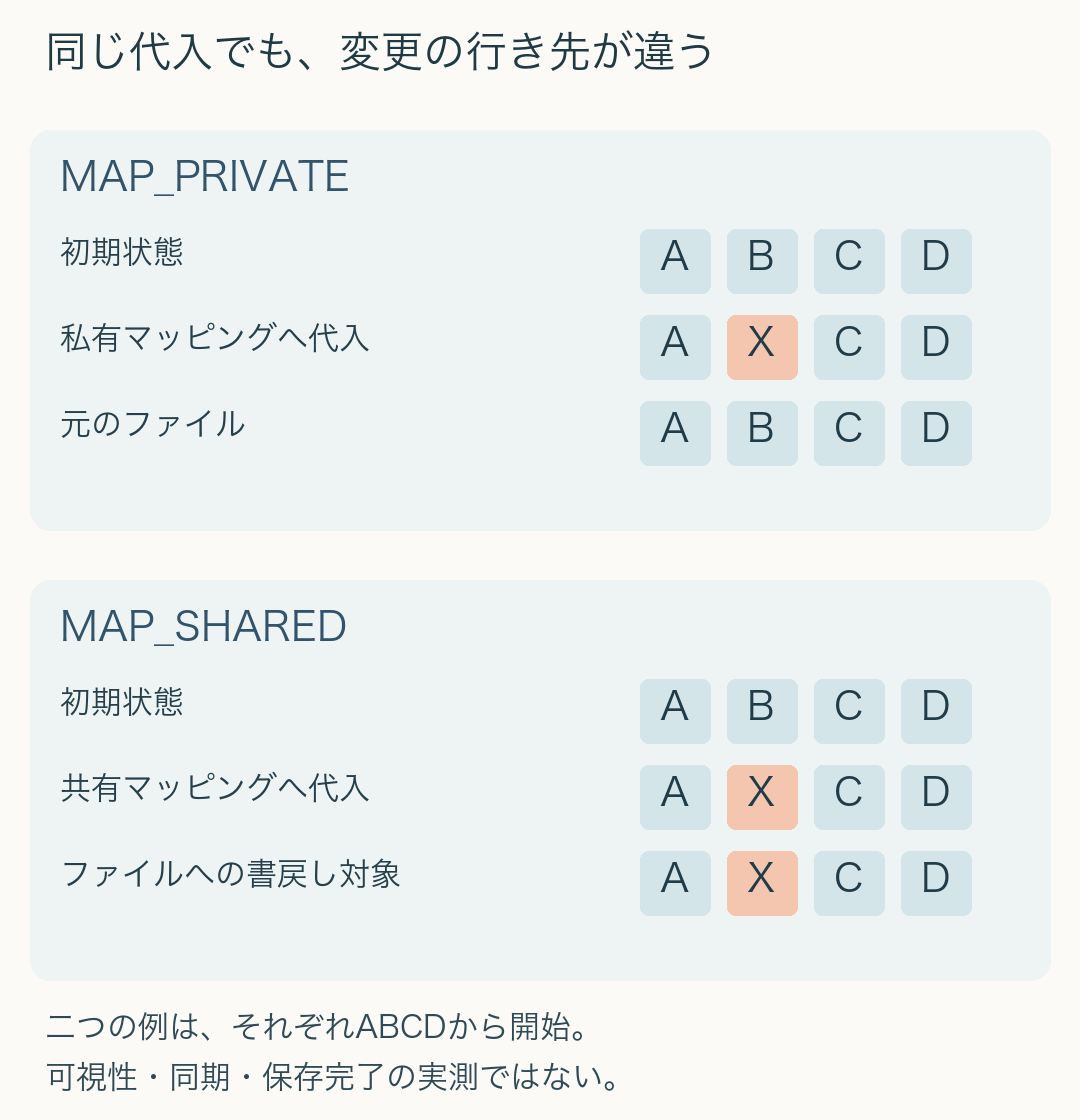
    初期内容をABCDとするファイルを考えます。最初の実行では、そのファイルをMAP_PRIVATEで読み書きできるように対応付け、先頭から二文字目へXを代入します。変更後、そのマッピングを読むとAXCDになりますが、元のファイルへこのXを書き戻す操作にはなりません。

    MAP_PRIVATEはコピーオンライト方式の私有マッピングです。変更を私有のものとして扱う仕組みであり、mmapを呼んだ瞬間にファイル全体を別の巨大な配列へコピーする、と説明する必要はありません。また、別の処理が後から元のファイルを変更した場合、それが私有マッピングに見えるかどうかは未規定です。「作成時点の内容を永久に固定したスナップショット」として使える保証もありません。[1]

    二つ目の実行では、初期内容をABCDへ戻し、MAP_SHAREDのマッピングへ同じ代入をします。今度は変更を共有する方式なので、同じ領域を共有しているマッピングとファイルへ変更を伝える対象になります。図では二つの実行を混ぜず、それぞれの初期状態から比較しています。

    別々に初期化したABCDの二文字目をXへ変更。PRIVATEでは私有表示AXCDとファイルABCD、SHAREDでは共有変更AXCDとファイルへの書戻し対象AXCDを分ける。
    独自のデータ所有モデルによる比較。実際のLinux実行、ページフォルト数、書き戻し時刻の測定ではない。共有側の矢印は変更の対象を表し、電源断後の保存確認を意味しない。

    この比較から選べるのは、まず変更の行き先です。元データを変えずに一時的な加工を行うなら私有方式、ファイルを更新したいなら共有方式が候補になります。読み取り中心か、書き換える範囲が広いかによるメモリー消費や速度の差は、この四文字のモデルからは判断できません。

    共有できても、二つの代入が一組になるわけではない

    共有する領域に、説明用の二つの値「個数」と「合計」を置く設計を考えます。初期値を個数1・合計10とし、別の値20を追加すると、更新後は個数2・合計30です。プログラムが個数を先に変更し、その次に合計を変更するなら、その二つの間を読む処理についても考えなければなりません。

    説明用の逐次モデルで、その間に読取りを差し込むと、個数2・合計10という、更新の途中の組が見えます。MAP_SHAREDは同じ領域へ変更を伝える方式であり、この二項目をアプリの意味で一つの取引として更新する指定ではありません。実際の並行プログラムでは、言語のメモリーモデルや処理間の同期手段も関わるため、この単純なモデルをそのまま無同期の実装へ置き換えてはいけません。

    したがって、共有領域を使う設計では、「どちらの処理がいつ変更し、いつ読んでよいか」を別に決めます。読み取り中の更新を排除するのか、変更完了を示す状態を同期して受け渡すのかなど、目的に合う手順が必要です。共有を選んだことと、途中状態を読まないことは、別々に検証する項目です。

    見えた変更と、書き戻しの完了も別

    MAP_SHAREDで変更を伝える先が決まっても、プログラムが代入を終えた時点を、そのまま保存完了時刻として扱うことはできません。マッピングした範囲の変更をファイルシステムへ書き戻すための呼出しがmsyncです。MS_SYNCでは更新を要求し、その完了を待ちます。戻り値も確認して、失敗を処理する必要があります。[2]

    一方、msyncを呼べばMAP_PRIVATEで作った私有の変更が、共有の変更へ切り替わるわけではありません。保存したい内容をどの経路でファイルへ渡す設計なのかを先に揃えます。また、同期呼出しの成功と、複数項目をまとめたトランザクション、名前の置換、電源断試験は別の確認です。本稿の比較では、障害からの復旧や装置全体の耐久性までは実証していません。

    用途を三つの問いへ分解する

    mmapの指定を選ぶときは、最初に「この領域を読みたいのか、書きたいのか」を決めます。次に「その変更は私有の加工なのか、元のファイルや別の処理へ共有する更新なのか」を決めます。最後に、共有する場合は「いつ読んでよいか」「どの書き戻しの完了を確認するか」を決めます。

    今回のモデルなら、PRIVATEでAXCDと読めたことは、私有の加工を確認した結果です。SHAREDで別の読取り側へ変更を伝えたいなら、共有方式に加えて読取りのタイミングを揃える必要があります。ファイルの保存まで要件に入るなら、その同期とエラー処理も確認に加えます。ひとつの「書けた」という観察を、これらすべての成功へ広げないことが、マッピングを扱うときの判断を明確にします。

    出典

    1. Linux man-pages 6.19 — mmap(2)、DESCRIPTIONのprot、MAP_SHARED、MAP_PRIVATE。取得版は記事資料に保全。
    2. Linux man-pages 6.19 — msync(2)、DESCRIPTION、MS_SYNC、RETURN VALUE。