投稿者: SB-admin

  • PhoenixとPeregrineのイオントラップ、レーザーを通すくびれと溝

    PhoenixとPeregrineのイオントラップ、レーザーを通すくびれと溝

    イオントラップ型の量子コンピューターでは、電極が作る電場でイオンを空間にとどめ、レーザーを用いて量子状態を操作したり、状態を読み出したりします。その光は、目的のイオンへ届かなければ役に立ちません。イオンのすぐ下にある電極、厚みのある基板、周囲のパッケージは、電気的な部品であると同時に光の通り道を囲む壁にもなります。

    この関係が具体的に見えるのが、Sandia National Laboratoriesの研究者Melissa C. Revelleによる設計資料『Phoenix and Peregrine Ion Traps』です。本稿では2020年の固定版を使い、二つの表面電極型イオントラップを比べます。現在販売されている装置の仕様や、最新の量子ゲート性能を示す資料としては扱いません。

    簡単にまとめると?

    • 横からイオンへ光を入れるときは、イオンの高さだけでなく、基板の縁までの距離が通せる角度を決めます。中央が細い「くびれ」は、その距離を短くする形です。
    • Phoenixには中央を貫く溝があり、基板を通る垂直方向の光路を使えます。Peregrineには、この中央溝を通る光路がありません。
    • 開口数NAは向きと条件をそろえて比べます。開口が広いことと、実際の集光性能や量子ゲートの精度が高いことは、別の確認事項です。

    平面の電極の上に、イオンを浮かせる

    表面電極型イオントラップは、基板の表面付近に複数の電極を並べる構造です。PhoenixとPeregrineは、どちらも高周波の電場と制御用の電極を組み合わせる線形トラップで、イオンを保持する位置は電極面より上にあります。資料の光学アクセスの節では、その高さをPhoenixで68 µm、Peregrineで74 µmとしています。

    イオンを電極面の外へ出せば、横方向から光を近づけられます。ただし「表面より上にある」だけでは、どの方向からでも自由に光を集められるわけではありません。集光する光には角度の広がりがあり、その一部が基板やパッケージにぶつかると、光の裾が削られます。この遮られ方をクリッピングと呼びます。

    同資料のHigh Optical Access(HOA)プラットフォームは、表面をかすめる光を使いやすくするため、中央部が細い蝶ネクタイのような形を採っています。設計上の工夫は、光源だけでなく、光を受け入れる側の形にもあるわけです。

    くびれが効くのは、縁までの距離を短くできるから

    イオンへ横から光を集める様子を、断面で考えてみます。光の中心は表面にほぼ平行でも、集光する光の下側は表面へ近づきます。イオンから基板の縁までが長ければ、下向きに傾いた光は途中で表面に遮られます。縁が近ければ、その外側は空間なので、より大きく傾いた光も通せます。

    単純な直線のモデルでは、イオンの高さをh、光の進む方向に沿った縁までの距離をLとすると、表面をぎりぎり避ける角度は arctan(h/L) です。hを上げるだけでなく、Lを小さくしても、通せる角度は広がります。くびれが役立つ理由は、この幾何学的な関係にあります。ただし実際の電極形状やイオンの高さは、イオンを保持する電場の設計とも結び付いているため、光の都合だけで自由に変えられる寸法ではありません。

    資料では、くびれの幅は1.2 mmを超え、くびれを横切る方向に入れる光のNAを0.11、平面内で45度傾けて入れる光のNAを0.08としています。斜めに横切ると、同じ幅でも表面の上を進む距離が長くなるので、許される上下方向の角度は小さくなります。ここでの45度は基板の平面内での光の向きであり、次に説明する集光の半角とは別の角度です。
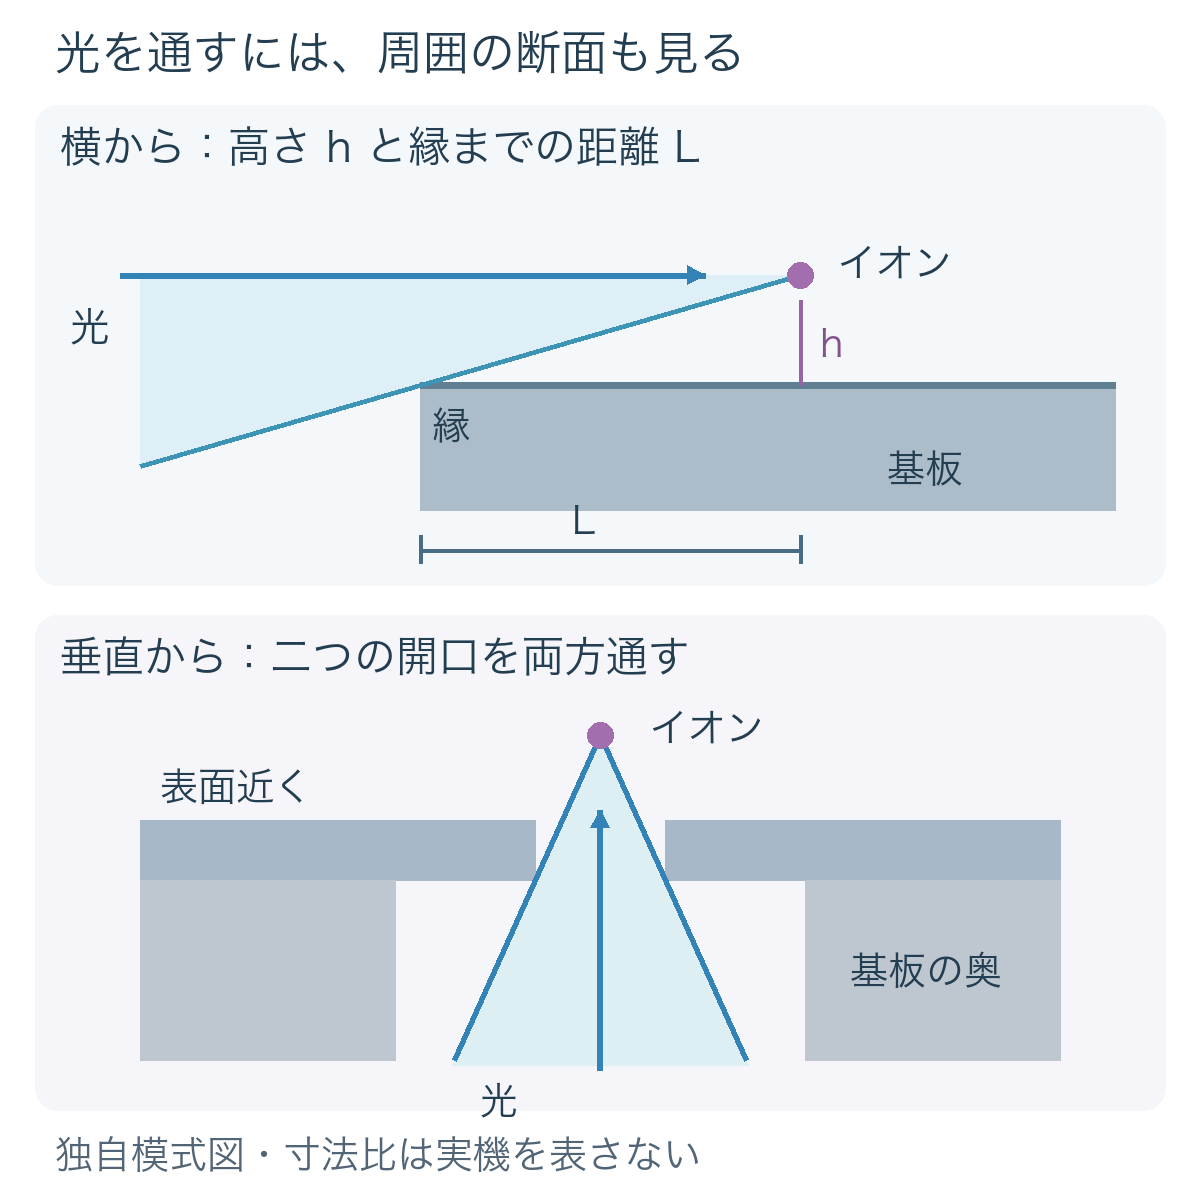
    上段は表面に平行に入れる光の模式断面。イオンの高さhと縁までの距離Lによって、下側の光が表面を避けられる角度が変わる。下段は溝を通る垂直方向の光。表面近くと基板の奥にある二つの開口を、どちらも通過する必要がある。寸法比は実機を表さない。
    光路と周囲の構造の関係を説明する独自模式図。実機の断面図や寸法比の再現ではありません。下段はPhoenixのように中央に貫通溝がある場合の考え方です。

    Phoenixの溝は、別の方向から光を入れる入口

    PhoenixとPeregrineの違いは、イオンの高さだけではありません。Phoenixには中央に基板を貫く溝があり、基板の裏側からイオンへ向かう光路を設けられます。Peregrineは中央の量子操作領域にその溝を持たない表面型です。Phoenixの内部制御電極は上面の電極より低い層に置かれており、見た目の溝の幅だけでなく、電極と基板を含む立体的な断面を考える必要があります。

    2020年の設計資料で比べる二つのトラップ
    比較する点 Phoenix Peregrine
    基本の構成 中央に貫通溝を持つ表面電極型 中央溝のない表面電極型
    資料に記されたイオンの高さ 上面から68 µm 表面から74 µm
    表面をかすめる横方向の光 HOAのくびれを利用 HOAのくびれを利用
    中央溝を通る垂直方向の光 利用できる光路として説明 この光路は該当しない

    中央の溝と、原子をトラップへ導入するためのローディング用の穴は、役割の異なる構造です。「Peregrineには穴が一切ない」という意味ではありません。比較したいのは、量子操作を行う中央領域を通してレーザーを入れられるか、という点です。

    Phoenixの垂直方向について、資料が示すNAは0.25です。ただし制限要因の説明には注意が要ります。11ページは裏面側のエッチングを挙げ、24ページは表面金属の溝幅60 µmを挙げています。断面図にも複数の高さと幅が描かれています。本稿では、どちらか一方だけが支配的だと決めず、同じ光路上の開口をすべて通過する必要があると読みます。0.25は資料の設計説明として示し、溝幅一つから再計算できた値とはしません。

    開口数NAを、向きと一緒に比較する

    開口数(Numerical Aperture、NA)は、光軸を中心に受け入れる光の半角θと、周囲の屈折率nから、NA=n sin θで表します。真空中でnを1とする理想的な円すいの見方なら、NA 0.11は半角約6.3度、0.08は約4.6度、0.25は約14.5度に対応します。これは数字の角度としての読み替えです。

    ただし、このトラップの光路はすべての方向に同じ広さを持つ円形の入口ではありません。横から入れる場合の上下方向の制約と、中央溝を通る場合の制約を、そのまま一つの丸いレンズの性能のようには比べられません。資料も、光学アクセスを「集光したガウシアンビームのどれだけが構造物に遮られるか」で説明しています。ガウシアンビームには裾があるので、光線の境界を一本引くだけでは、失う光量まで決まりません。

    資料にはビームウエスト2.5 µm未満への対応と、くびれを横切る370 nmの光をさらに遮らないようにしたパッケージ設計の説明があります。これらは同資料の光路・ビーム条件を伴う記述です。任意の波長、レンズ、入射方向でも同じ焦点が得られる保証へは広げられません。

    広い穴でも、奥にあると光を制限する

    断面全体を見る意味を、実機とは別の単純な模型で確かめます。光軸上の点から、距離dにある開口まで光を通し、開口の半幅をaとします。直線的な光線だけを考えると、片側の半角は arctan(a/d)、真空中の対応するNAは a/√(a²+d²) です。

    独自計算による開口の例(Phoenix/Peregrineの寸法ではありません)
    開口 半幅a 点からの距離d 半角 対応するNA
    近くの開口 50 µm 100 µm 約26.6度 約0.447
    奥の、幅が2倍の開口 100 µm 400 µm 約14.0度 約0.243

    奥の開口は幅が2倍でも、距離は4倍です。通せる角度は小さくなります。この二つを同じ光軸上に重ねるなら、両方を通れる範囲は小さいほうの約14.0度までです。「入口を広げたから十分」と判断せず、基板の厚さ、裏側の加工、パッケージまで確認する必要があることが分かります。この模型は直線光学の説明で、回折やビームの裾、軸のずれを含む光学設計の代用ではありません。

    光学アクセスが良いと、何が分かり、何は残るか

    トラップを比較するときは、まず光をどこから入れたいかを決めると、形の違いを判断しやすくなります。表面に沿って入れるなら、イオンの高さ、くびれの幅、平面内の入射方向、パッケージの縁が関係します。基板を通して入れるなら、中央溝の有無と、その奥まで続く開口が関係します。さらに使う波長と焦点の大きさ、許容するクリッピングをそろえて初めて、必要な光路が確保できるかを比べられます。

    広い光学アクセスは、強く集光した光や、イオン列の特定のイオンを照らすための設計に役立ちます。しかしそれだけで、量子ゲートの忠実度、状態読出しの精度、イオンの加熱率が分かるわけではありません。それらには別の実験条件と測定が必要です。PhoenixとPeregrineの例が教えるのは、量子計算を支える光学系の一部が、レーザーやレンズだけでなく、電極と基板の形にも組み込まれているということです。

    出典

    1. Melissa C. Revelle, Phoenix and Peregrine Ion Traps, arXiv:2009.02398v1。arXivのv1登録日は2020年9月4日、PDF表紙は「Version 1, September 8, 2020」と表記。固定版PDFの5〜11ページ(設計・断面・中央溝)、15〜20ページ(Peregrine)、24ページ§4.1(Optical Access)を参照。
    2. Open Quantum Design, Hardware。2026年10月18日に確認した機器案内から、Sandia Phoenix Trapの一次資料へ到達。案内ページ自体を、性能の独立した実証とは数えていません。
  • ARTIQのRTIO、量子実験のパルスを予定時刻にそろえる仕組み

    ARTIQのRTIO、量子実験のパルスを予定時刻にそろえる仕組み

    量子実験では、レーザーやマイクロ波を「どの順番で動かすか」だけでなく、「いつ動かすか」も重要になります。ところが、制御プログラムが計算や通信に使う時間は、毎回まったく同じとは限りません。命令を書いた順番だけで、必要なパルスの間隔までそろえられるのでしょうか。

    実験制御システムARTIQは、CPUが命令を準備する時刻と、装置がその命令を実行する予定時刻を分けて扱います。その中心にあるのがRTIO(Real-Time Input/Output)です。Open Quantum Designのハードウェア資料も、リアルタイム制御の構成要素としてARTIQを案内しています。ここでは、予定を先に渡す仕組みと、その予定が間に合わなくなる条件を見ていきます。

    簡単にまとめると?

    • RTIOでは、CPUが時刻付きの出力命令を準備し、ハードウェアが指定された時刻に実行します。プログラムの処理時間とパルスの幅を切り離せます。
    • 予定時刻とハードウェアの現在時刻の差が、slack(余裕時間)です。過去の時刻への出力は間に合わず、RTIOUnderflowになります。
    • 予定を未来へずらす、実時刻の到来を待つ、装置を初期化する、という操作は別物です。実験の時刻関係を保ちたいのか、処理の遅れを吸収したいのかで使い分けます。

    「今」が二つある理由

    ARTIQの実験は、ホスト側のコンピューターと、時間を厳密に扱うコア装置に役割を分けられます。コア装置のCPU上で動くプログラムをkernelと呼びます。CPUが出力イベントを時刻付きでバッファーへ送り、FPGAに実装された回路が、その時刻になったときに出力します。FIFOは、このようなイベントを一時的に蓄える待ち行列です。

    ここで区別したいのは、プログラムが予定を置くタイムラインのカーソルと、装置内で進み続けるハードウェアの時計です。now_mu()が返すのは前者であり、CPUが呼び出した瞬間の実時刻ではありません。一方、get_rtio_counter_mu()はハードウェアのカウンターを読みます。ただし、読み取り結果がプログラムへ戻るまでにも時間が進むため、返された値は、その後の実時刻の下限として扱う必要があります。

    muはmachine unit、つまり装置の時間単位です。何秒に相当するかは構成に依存します。以下では、特定の装置の性能を仮定せず、時刻も間隔もmuで表します。

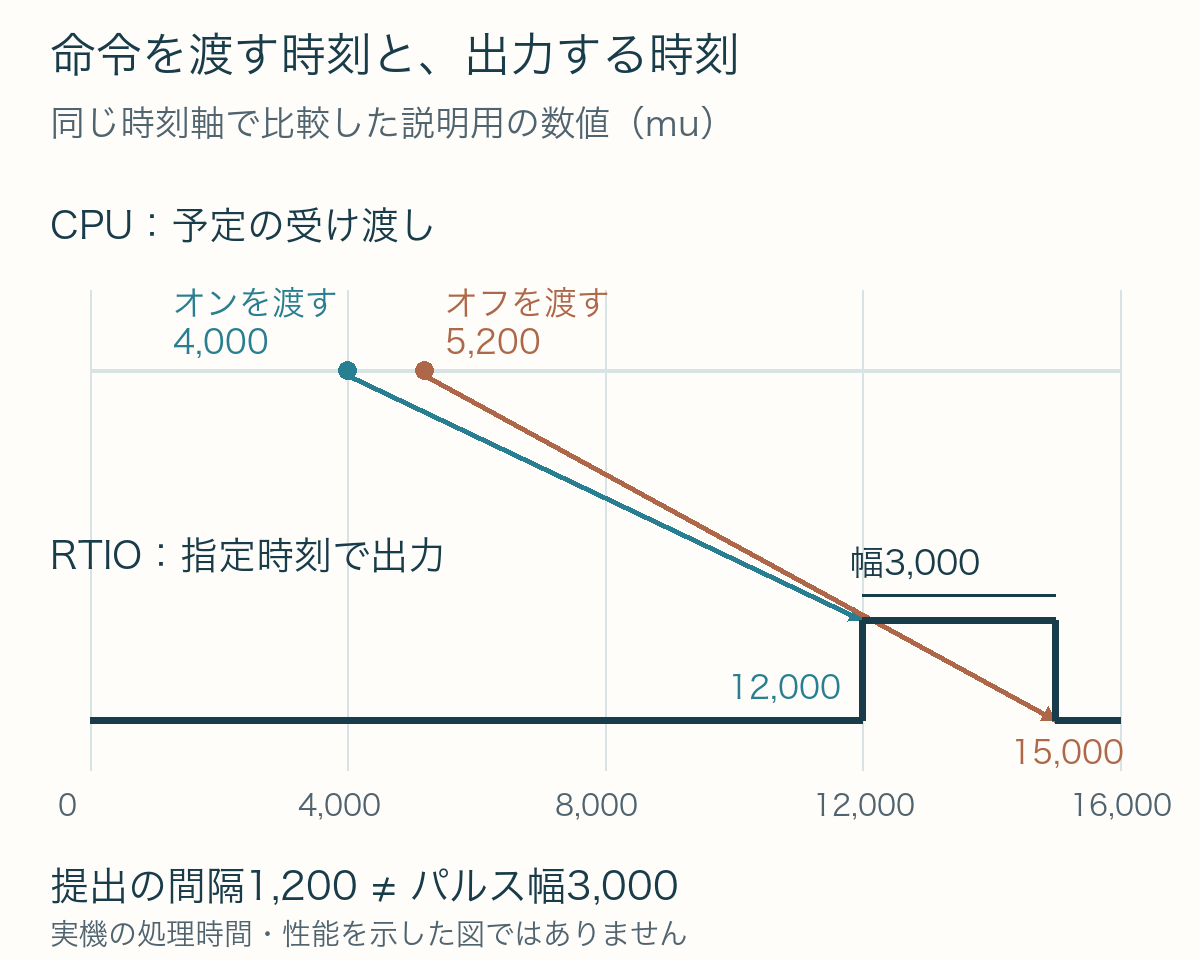
    3,000 muのパルスを、先に予約する

    TTL出力は、デジタル信号をオンまたはオフにする基本的な出力です。説明用に、タイムラインのカーソルを12,000 muに置き、オン、3,000 mu進める、オフ、の順で処理するとします。delay_mu(3000)は予定を3,000 mu先へ動かす操作です。CPUを3,000 muの間その場で待たせる、という意味ではありません。実際のTTLドライバーのpulse_mu()も、このオン・カーソル移動・オフの構成になっています。

    次の数値は仕組みを説明するために置いた架空の値であり、実機で測った処理時間ではありません。イベントの受け渡しが完了した時点など、比較する瞬間をそろえて余裕時間を計算します。

    見る瞬間 ハードウェア時刻 カーソル 差=余裕時間
    オンの予定を受け渡した時点 4,000 mu 12,000 mu 8,000 mu
    カーソルを3,000 mu進めた時点 4,700 mu 15,000 mu 10,300 mu
    オフの予定を受け渡した時点 5,200 mu 15,000 mu 9,800 mu

    受け渡しが間に合い、ほかの出力条件も満たされれば、オンは12,000 mu、オフは15,000 muで実行されます。両者の差は3,000 muです。CPUがオンとオフの予定を送り出した時刻の差、5,200−4,000=1,200 muが、そのままパルス幅になるわけではありません。

    CPUは4,000 muと5,200 muで予定を渡し、RTIOは12,000 muにオン、15,000 muにオフを実行する説明図。パルス幅は3,000 muで、提出時刻の間隔1,200 muとは異なる。
    図1:独自に置いた数値による模式図。CPUの受け渡しと出力の実行を、同じ時刻軸の別の段に描いています。実機測定や原資料の図の転載ではありません。

    この分離が、計算や通信の揺れを出力タイミングへ直接持ち込まないための土台です。ただし、「CPUの速度は関係ない」という意味ではありません。CPUには、必要なイベントを締切までに準備する役目が残ります。

    余裕時間は、命令を準備するための持ち時間

    slackは、カーソルからハードウェアの現在時刻を引いた差です。カーソルを先へ進めれば増え、カーソルを動かさず計算などに時間を使えば減ります。たとえば、オフの予定時刻を15,000 muにしたまま、送ろうとした時点で時計が15,500 muまで進んでいたら、差は−500 muです。すでに過去の予定となり、RTIOUnderflowが起きます。間に合わなかったイベントは破棄されます。

    プログラム上でイベントを順番に書けていても、実時間の締切に遅れることはあります。また、先にオンだけが受理され、オフが間に合わなければ、意図した幅のパルスは完成しません。例外を受け取ったことと、出力が望む状態へ戻ったことは別に確認する必要があります。

    入力を待つ処理も、この持ち時間を使います。たとえば検出窓を設けて入力イベントを数える場合、結果の取得は、窓が終わるまで待つことがあります。その間にもハードウェアの時計は進みます。取得した値で分岐してすぐ次の出力を決める実験では、入力待ち、計算、次のイベントの受け渡しに必要な時間を、ひとまとまりで考える必要があります。

    逆に、予定を大量に先送りすれば無制限に安心、というわけでもありません。出力FIFOの容量は有限で、満杯になるとCPU側の受け渡しが待たされます。この待ち時間も余裕を消費します。これは、入力側のイベントがあふれるRTIOOverflowとは区別されます。

    未来へずらす操作と、実時刻を待つ操作

    ARTIQには、遅れを吸収するためのbreak_realtime()があります。今回固定した版では、読み取った時計の値に125,000 muを足した位置と、現在のカーソルを比べ、カーソルが手前なら前者へ進めます。すでに十分先なら動かしません。

    たとえば、読み取った時計が200,000 mu、カーソルが150,000 muなら、新しいカーソルは325,000 muになります。一方、カーソルが400,000 muならそのままです。125,000 muはこの実装に書かれた余裕であり、すべての装置で125マイクロ秒になるという意味ではありません。その後の処理が長ければ、この余裕も使い切ります。

    使う前に判断したいのは、「後続の出力を遅らせてもよいか」です。計測のまとまりの間で余裕を取り直すなら役立ちますが、外部トリガーから厳密に一定時間後に出力したい場合、途中で予定をずらすと、その約束を変えてしまいます。遅れを解消する操作が、元の時刻関係まで守ってくれるわけではありません。

    操作 何をするか 気を付けたい点
    break_realtime() 必要ならカーソルを未来へ進める 後続の予定がずれる。FIFOを消去する操作ではない
    wait_until_mu(t) ハードウェアの時計がtに達するまで待つ 未来の余裕を作る操作ではない。すでにtを過ぎていればすぐ戻る
    reset() RTIOのFIFOを消去し、リセットを解除してカーソルを未来へ置く まだ実行されていない予約イベントも失われる。単なる待機の代わりには使えない

    kernelが終了した時点でも、FIFOに未来の出力が残っていることがあります。最後に予約した出力の時刻まで待ちたいなら、その時刻をwait_until_mu()へ渡す、という使い方になります。ただし、タイムラインを途中で戻した場合など、現在のカーソルが必ず最後のイベント時刻を表すとは限りません。また、装置内の時計が到達したことは、外につないだレーザーなどの応答や量子操作の精度を測定したことではありません。

    「余裕が正なら成功」とは限らない

    正の余裕時間は、未来へ命令を渡すための基本条件です。しかし、時計を読み取ってから送信するまでの時間もあり、小さな正の値を見ただけで締切を保証することはできません。さらに、RTIOにはイベントの並び順、同じ出力への衝突、装置が次の命令を受け付けられる間隔などの条件があります。

    これらの違反は、CPUに返るunderflow例外と同じ形で現れるとは限りません。sequence errorやcollision、busy errorでは、不適切なイベントが捨てられ、コア装置のログに記録される場合があります。実験を比べるときは、プログラムが最後まで走ったかだけでなく、予定したイベント、装置側のエラー、観測した出力を突き合わせる必要があります。

    RTIOの役割は、準備を間に合わせた時刻付きイベントを、装置の時計に沿って実行することです。本稿で確認したのは公開資料と固定版コード上の仕組みであり、特定の量子装置を動かした測定結果ではありません。装置ごとの時間単位、イベント密度、外部機器の応答を確認して初めて、必要なタイミングを実験全体で満たせるか判断できます。

    出典

    2026年10月18日に参照したARTIQ文書の表示版は9.9698+a7303a7です。下記のコードと文書原本は、コミット日時が2026年10月7日(UTC+8)の固定版で照合しました。公開コードは実行せず、仕組みの読解に使用しています。

    1. Open Quantum Design — Hardware / Devices:ARTIQにつながるリアルタイム制御の構成。2026年10月18日参照。
    2. ARTIQ — Real-Time I/O concepts:カーソル、slack、入出力イベント、エラー。同文書の固定版原本。
    3. ARTIQ coredevice/core.py(固定版):カウンター読取り、待機、reset、break_realtime。
    4. ARTIQ language/core.py(固定版):delay_mu、now_mu、at_mu。
    5. ARTIQ coredevice/ttl.py(固定版):TTLのオン・オフとpulse_mu。
  • トロッター分解、分割数と操作の順序で近似誤差が変わる理由

    トロッター分解、分割数と操作の順序で近似誤差が変わる理由

    量子系が時間とともにどう変わるかを計算するとき、ひとまとまりの複雑な変化を、実行しやすい短い操作へ分けることがあります。その代表がトロッター分解です。時間を細かく刻めば目標に近づきますが、刻みの数だけで近似のよさが決まるわけではありません。

    操作を「A、B」と繰り返すか、「Aを半分、B、Aを半分」と挟むか。この並べ方によって、残る誤差の性質が変わります。一次分解と対称な二次分解を、小さな行列の計算と操作数の比較で見てみます。扱うのは時間によらないハミルトニアンと、雑音のない理想的な操作です。[1]

    簡単にまとめると?

    • トロッター分解の誤差は、同時に働く作用を順番のある操作へ置き換えることで生じます。操作どうしが可換なら、ここで扱う分解の誤差はありません。
    • 左右対称に半分の操作で挟むと、一次分解に残る低い次数の誤差を打ち消せます。分割数を増やすことと、分解の次数を上げることは別の変更です。
    • 理想的な近似誤差が小さくても、実機での結果がよくなるとは限りません。操作数、ゲートの種類、実行時間、比較する誤差の定義をそろえて判断します。

    分割するのは、時間だけでなく作用の組み合わせ

    ハミルトニアンは、量子系のエネルギーや相互作用を表す演算子です。時間に依存しないハミルトニアンを H=A+B と分けられるとき、時間tの変化は U(t)=exp(−i(A+B)t) と書けます。ℏを1とする単位を使います。

    Aだけ、Bだけなら扱いやすくても、その和による変化を直接実行するのは難しいことがあります。そこで全時間をK個に分け、短い時間を δ=t/K とします。まずAによる変化をδだけ、続いてBによる変化をδだけ進める組をK回繰り返すのが、ここでいう一次分解です。

    この操作は、AとBが同時に働く時間δの近似です。「Aにδ、Bにδ使ったから、物理モデルの時間を2δ進めた」という意味ではありません。各項の働きを別々の操作で表しているためです。また、このtは模擬したい系の時間で、装置が回路を実行する秒数とも区別します。

    状態を列ベクトルとし、右側の操作から作用する約束なら、1区間の一次分解は L₁(δ)=exp(−iBδ)exp(−iAδ) です。全体は L₁(δ)ᴷ になります。

    順番の偏りが、小さな誤差として残る

    AとBを交換しても同じになる場合を「可換」と呼びます。可換なら exp(−iBδ)exp(−iAδ)=exp(−i(A+B)δ) が成り立ち、この分解による誤差はありません。一方、交換すると結果が変わる場合には、短い操作を順に実行した結果と、同時に作用させた結果が一般にはずれます。

    その違いは、指数関数を小さなδについて展開すると見えます。同時に作用する式にはABとBAが対になる形で現れますが、順序を固定した積では片方に偏ります。差を表すのが交換子 [A,B]=AB−BA です。一次分解の1区間では、最初の誤差がδの二乗に比例する次数から現れます。[1]

    同じ有限次元のA、Bと全時間tを保ち、十分細かく分割した場合、K区間を合わせた誤差はおおむね O(t²/K) で抑えられます。Oは誤差の上限の増減の次数を表す記号で、実際の値には演算子の大きさや交換子に応じた係数が掛かります。Kを2倍にすれば、どの問題でも誤差がぴったり半分になる、という約束ではありません。

    半歩ずつ挟むと、対称性で誤差の次数が変わる

    対称な二次分解では、1区間を「Aをδ/2、Bをδ、Aをδ/2」とします。式では次の積です。

    S₂(δ)=exp(−iAδ/2)exp(−iBδ)exp(−iAδ/2)

    左右の並びが同じなので、δの符号を反転した組は元の組をちょうど打ち消します。すなわち S₂(δ)S₂(−δ)=I です。この時間反転に対する対称性から、δが十分小さいところで積を一つの指数の形にまとめると、その指数にはδの偶数次の項が現れません。一次分解で残った二次の項が消え、1区間の誤差は三次から始まります。[1]

    全時間tを固定してK区間にすると、二次分解の誤差の上限は O(t³/K²) となります。「二次」という名前は、2回繰り返すという意味ではありません。1区間でδの二次まで正しく表せることを指しています。Kは区間の数、一次・二次は近似の次数です。

    同じKでも二つの近似は異なります。また、対称性だけで装置の雑音が消えるわけでもありません。ここで打ち消しているのは、理想的な積の式に現れる近似誤差の低次の項です。

    小さな例で、誤差の減り方を比べる

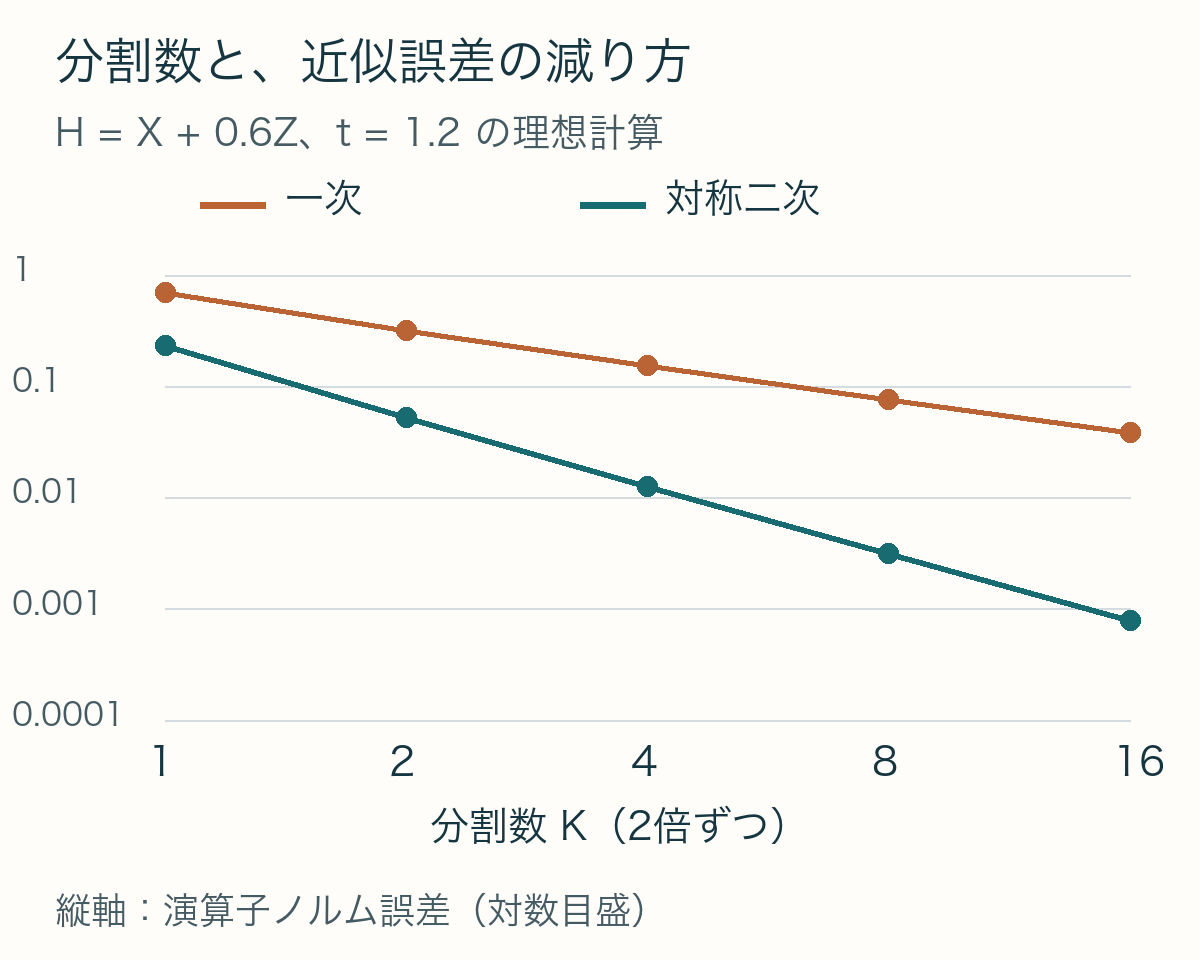
    説明用に、1量子ビットの H=X+0.6Z と t=1.2 を選びます。Xは基底状態0と1を入れ替え、Zは1の成分の符号を反転するパウリ演算子です。XとZは可換ではありません。比較するのは、A=X、B=0.6Zとした一次分解と対称二次分解です。

    厳密な時間発展は H²=1.36I を使い、三角関数で直接求められます。その値を、ハミルトニアンを対角化する別の計算でも照合しました。下表は公開ベンチマークや実機の測定値ではなく、この2×2行列から独自に計算した値です。

    誤差には ε=‖U近似−U厳密‖₂ という演算子ノルムを使います。これは、長さ1の入力状態を変えたときに、二つの出力のベクトルとしての差が最大でどれだけになるかを表します。特定の測定で0や1が出る確率の差でも、忠実度でもありません。ここでは全体位相を合わせ直す最小化もしていません。

    分割数K 一次の誤差 対称二次の誤差
    1 0.69334 0.23327
    2 0.31480 0.05217
    4 0.15341 0.01265
    8 0.07621 0.00314
    16 0.03804 0.00078
    分割数1、2、4、8、16に対する一次分解と対称二次分解の演算子ノルム誤差。対数目盛の縦軸で、二次分解の線がより速く下がる。表と同じ独自の理想行列計算。
    図1 H=X+0.6Z、t=1.2に固定した独自計算。縦軸は対数目盛で、1目盛下がると誤差は10分の1。横軸の点はKが2倍ずつになるように並べています。線は点の対応を示す補助で、実機結果ではありません。

    K=8から16に増やすと、一次の値は約半分、二次の値は約4分の1になっています。十分細かい分割で期待する次数の違いが、この例にも見えます。ただし、特殊な相殺や状態・観測量の選び方で見かけの減り方は変わります。この一例だけから、あらゆる問題で二次分解が同じ倍率だけ優れるとはいえません。

    同じ分割数でも、操作数を確かめる

    対称二次は1区間に3個の指数があるので、K区間なら常に3K操作が必要に見えます。しかし、隣り合う区間の境界には、同じAの半歩が二つ続きます。間に別の操作を挟まなければ、それらをAの1歩へまとめられます。

    分解 K区間の操作数 K=8の場合
    一次 2K 16
    対称二次、各区間をそのまま 3K 24
    対称二次、境界の半歩を結合 2K+1 17

    これは二つの項だけを使い、同じ生成子の連続操作を結合できる条件で数えた、抽象的な回転操作の数です。この1量子ビットの例ならX軸とZ軸の回転に対応しますが、多量子ビットの一項を実現するには、複数のゲートが必要な場合があります。上表をそのまま二量子ビットゲート数や実行時間に読み替えることはできません。

    たとえば「理想的な演算子ノルム誤差を0.01以下にする」という目標なら、示した範囲では対称二次のK=8が条件を満たし、一次のK=16はまだ満たしません。分割数だけを同じにする比較に加え、同じ誤差目標を達成するための操作数を比べると、選び方が変わります。実機での最適点は、各操作の誤差、接続制約、変換後の回路長なども含めて探す必要があります。

    公開実装では、引数から回路まで追う

    QED-Cの公開ベンチマークにも、分割数と時間を指定するハミルトニアン・シミュレーションがあります。本稿で参照した固定版の回路生成部は τ=t/K とし、K回のループで短い操作を並べています。コメント中にKを「order」と呼ぶ箇所があっても、この処理でのKは分割回数です。近似の次数と名前だけで同一視しないことが大切です。[2]

    さらに、同じ固定版のベンチマーク入口にはKとtの引数がありますが、実際の呼出しでは保存済みデータのkとtを読み、そちらを回路へ渡しています。引数を変えたつもりでも、生成される回路の条件が変わったとは限りません。ここではソースを読んだ結果を記しており、そのプログラムを実行して確認した結果ではありません。版を固定し、実際に渡される値と生成回路を確かめる必要があります。[3]

    誤差の比較先にも注意が必要です。同じ近似回路の雑音なし計算と比べると、回路を作る前から含まれる近似誤差は見えにくくなります。近似自体を調べたいなら、今回のように回路へ分ける前の時間発展を比較先にします。QED-Cの説明も、雑音なしの回路を参照する方法と、ハミルトニアンの時間発展を直接参照する方法を区別しています。[4]

    トロッター分解を比較するときは、まずモデルと全時間を固定し、次に分割数と分解の次数を分けて記録します。そのうえで、何を誤差と呼ぶか、同じ操作を結合できるか、実機の雑音を含めた値かを確かめます。細かく刻むことと、上手に並べることの効果を分けると、回路を長くする理由と、その代わりに何が改善するのかが見えてきます。

    参考資料

    1. Naomichi Hatano、Masuo Suzuki「Finding Exponential Product Formulas of Higher Orders」、arXiv:math-ph/0506007v1、2005年6月2日。第2節の式(18)–(23)、第3節の式(37)・(38)を参照。固定版PDF。本稿の数値表・図は原論文の転載ではなく、明示した別の条件による独自計算です。
    2. QED-C「Hamiltonian Simulation / Qiskit回路生成」。commit 21dfc331ce61a2170b06f88259aa19f901c021bc に固定。τ=t/K、Heisenberg/TfimのK回反復を参照。
    3. 同じ固定版の hamiltonian_simulation_benchmark.py。get_circuits内の保存済みパラメータ読込と回路への受渡しを参照。公開コードは読解のみで、実行していません。
    4. 同じ固定版の Hamiltonian Simulation — Benchmark Program。近似分解と比較先の区別、および原論文への参照を確認。実装上の設定は上記ソースと照合しています。
  • 量子振幅増幅、反復しすぎると成功確率が下がる理由

    量子振幅増幅、反復しすぎると成功確率が下がる理由

    量子計算の操作をもう1回繰り返せば、よい答えが出る確率はさらに高くなるのでしょうか。量子振幅増幅では、そうとは限りません。うまく止めれば成功確率を大きくできる一方、同じ操作を続けると、いったん高くなった確率が下がることがあります。

    鍵になるのは、確率を少しずつ足しているのではなく、量子状態を回転させていることです。ここでは4候補から条件を満たす1個を探す説明用の例を使い、25%だった成功確率が1回の反復で100%、もう1回で25%になる過程を追います。実機の測定結果ではなく、誤差のない理想的な演算から計算した値です。[1]

    簡単にまとめると?

    • 量子振幅増幅は、条件を満たす状態の位相を変える操作と、準備した状態を基準にする操作を組み合わせます。位相を変えるだけでは、測定確率は変わりません。
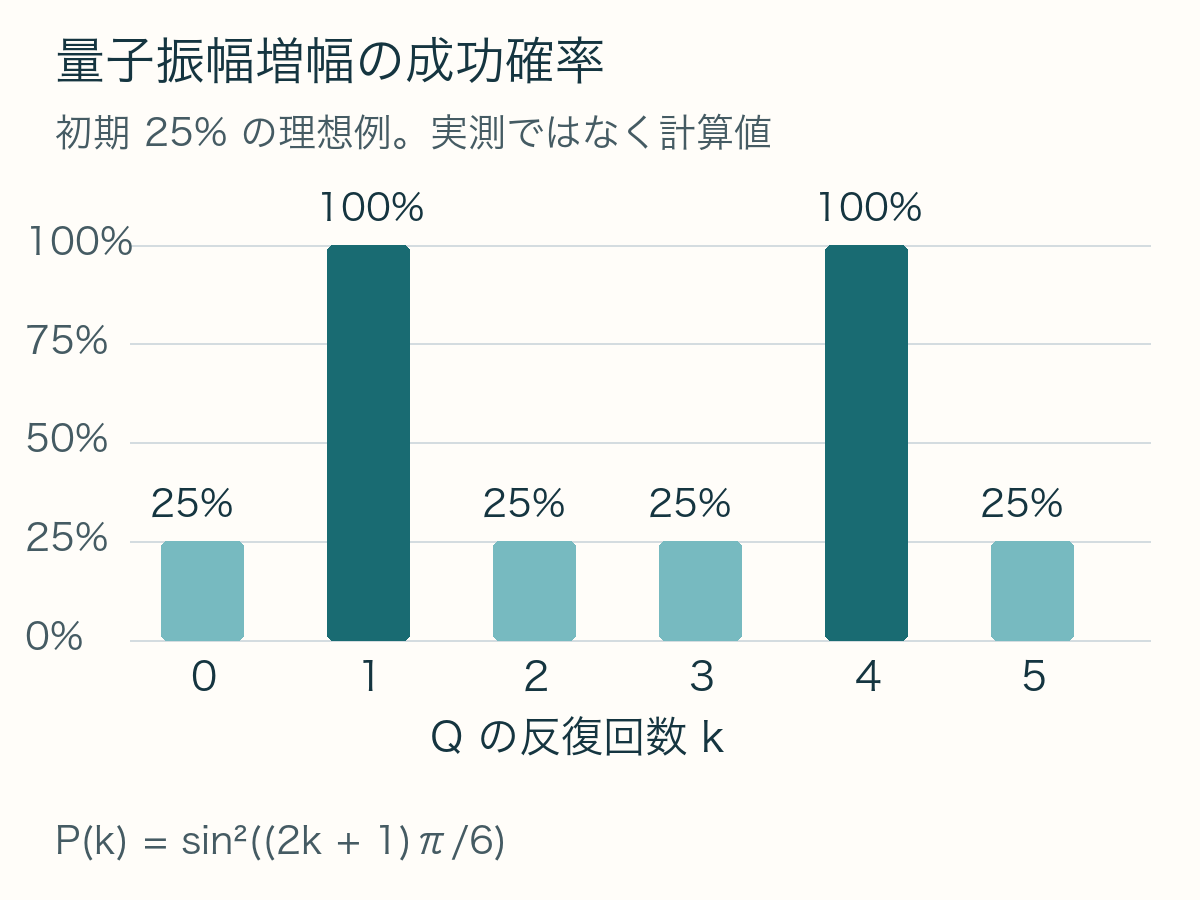
    • 成功確率は反復回数に対して振動します。4候補中1個が正解の理想例では、0回・1回・2回で25%・100%・25%となり、反復のしすぎが逆効果になります。
    • 初期の成功確率が未知なら、反復回数の選び方も必要です。理論上の呼び出し回数の削減と、装置で答えが得られるまでの時間は分けて評価します。

    探したい答えを、判定できる条件として用意する

    候補は作れるものの、そのうち条件を満たすものが少ない場面を考えます。候補を出す手続きをA、出てきた候補が条件を満たすかを調べる判定をχとします。χは、合格なら1、不合格なら0を返す関数です。「合格」を判断する基準は、問題の側で与えておきます。

    たとえば、制約を満たす組合せを探すなら、制約に違反していないかを計算できる必要があります。判定できることと、合格する候補を最初から知っていることは別です。ただし、その判定を量子回路の中で使える形にする費用まで無料になるわけではありません。

    量子振幅増幅で使うAは、途中で測定を行わず、逆向きの操作A−1も実行できる状態準備です。Aを1回実行して測定したとき、合格する候補が出る確率をaと呼びます。初期状態が合格する候補をまったく含まずa=0なら、以下で扱う標準の振幅増幅を繰り返しても、その候補の確率は増えません。[1]

    符号を変えてから、干渉で測定確率を変える

    説明用に、00・01・10・11の4候補が同じ重みで並び、11だけが合格する場合を使います。それぞれの振幅は1/2です。振幅は確率そのものではなく、確率を決める数で、一般には複素数になります。この例では実数だけで計算でき、各候補の測定確率は振幅の二乗、つまり1/4です。

    最初に、合格する11の振幅だけを1/2から−1/2へ変えます。これは位相をπだけ変える操作です。二乗するとどちらも1/4なので、この段階では、11を測定する確率はまだ25%です。符号の違いは、次の操作で振幅を干渉させたときに効いてきます。

    一様な重ね合わせから始めたこの例では、続く操作は「各振幅を平均値の反対側へ移す」と計算できます。符号を変えた後の平均振幅は、(1/2+1/2+1/2−1/2)÷4=1/4です。新しい振幅を「平均の2倍−元の振幅」で求めると、不合格の3候補は0、合格の11は1になります。

    段階 00・01・10の各振幅 11の振幅
    最初の状態準備 1/2 1/2
    11の符号を反転 1/2 −1/2
    平均を基準に反転 0 1
    4候補が一様で、11だけが合格する理想例。表は確率ではなく振幅を示しています。振幅の式から独自に計算。

    この2つの操作を合わせた1回の反復をQと書きます。一般の状態準備Aでは、単純な候補ごとの平均値ではなく、Aが準備した状態を基準にした反射を使います。したがって、この「平均の反対側」という計算を、一様でない状態にそのまま当てはめることはできません。Grover探索は、一様な重ね合わせを使う振幅増幅の代表例です。[1]

    正解に集中した後も、同じ操作は止まってくれない

    ここで測定すれば、理想的には11が必ず出ます。ところが測定せずに、もう1回Qを実行するとどうなるでしょうか。11の振幅1が−1になり、他の3候補は0のままです。平均は−1/4になるので、平均を基準に反転した後は、不合格の3候補がそれぞれ−1/2、合格の11が1/2になります。

    振幅の符号は最初と異なりますが、二乗した確率はすべて1/4です。せっかく11に集中した状態が、測定確率の上ではまた4候補へ広がったことになります。成功確率が下がるのは、実機の雑音が原因でなくても起こります。理想的な量子演算そのものが、同じ向きへ進み続けるためです。

    この動きをまとめるには、合格側と不合格側の2方向で状態を考えると見通しがよくなります。初期の成功確率をa=sin2θと表すと、Qをk回繰り返した後の成功確率は次の式になります。ここで0≦θ≦π/2です。[1]

    P(k)=sin2((2k+1)θ)

    初期の角度θから、1回ごとに2θずつ進みます。合格側に近づく間は確率が上がりますが、通り過ぎれば下がります。今回のa=1/4ではθ=π/6、つまり30度です。0回・1回・2回は30度・90度・150度に対応し、確率は25%・100%・25%となります。

    初期成功確率25%の理想例で、振幅増幅の反復回数0から5回に対し、成功確率が25、100、25、25、100、25%と変化する棒グラフ。1回で最大に達した後、2回に増やすと低下する。
    初期成功確率a=1/4の理想計算。横軸は整数の反復回数、縦軸は1回の測定で合格する確率。式P(k)から独自作図し、実測値は使用していません。

    なお、すべてのaでちょうど100%に届くとは限りません。kは整数なので、合格側を最も向く角度の前後で止めることになります。また、ここで示した振動は、同じ標準のQを反復する方法についての説明です。異なる位相の選び方を使う改良まで、すべて同じ振る舞いと決めつけるものではありません。

    「成功確率が高い」と「安く答えが出る」を分ける

    反復を増やすほど、状態を保ったまま実行する回路も長くなります。標準のQは、条件付きの位相反転に加え、AとA−1をそれぞれ1回使います。初期のAも含めれば、Qをk回行う1試行は、AとA−1を合計2k+1回呼び出します。[1]

    今回の例で、毎回同じkを使い、測定して不合格なら初期状態から独立にやり直すとします。1試行の成功確率をP(k)とすると、最初の合格までの平均試行数は1/P(k)です。そこへ1試行の呼び出し回数を掛けると、次の比較になります。

    Qの反復 成功確率 1試行のA・A−1呼び出し 合格までの平均呼び出し
    0回 25% 1回 4回
    1回 100% 3回 3回
    2回 25% 5回 20回
    同じ4候補の理想例を独自に計算。平均呼び出し回数は(2k+1)/P(k)。位相反転、測定、リセット、制御や実機の誤差に要する費用は、この表の回数には含めていません。

    2回まで反復した場合は、1試行が長くなったうえに成功確率が下がり、やり直しも必要になります。一方で「4回が3回になったから、実際の所要時間も4分の3」とは言えません。Aと逆操作の実装、合格判定の回路、測定・再準備の時間が異なるからです。この小さな例は反復の選び方を示すもので、装置の優位性を実証した比較ではありません。

    原論文の平方根の改善も、基本的にはこうした呼び出し回数の議論です。小さいaに対し、候補をそのまま作って調べる方法は平均1/a回の試行を要しますが、条件を満たす振幅増幅では、AとA−1の利用回数を1/√aに比例する規模へ減らせます。入力の準備や判定が重い場合は、その中身を含む比較が必要です。[1]

    初期の成功確率が分からなければ、止め方も工夫する

    aが分かればθを求め、成功確率が高くなる整数kを選べます。しかし、合格する候補がどのくらいあるか分からない問題では、そのままでは適切な反復回数も分かりません。未知のaを既知として、理想的な止めどころだけを比較すると、実際の探索に必要な手間を落としてしまいます。

    原論文のQSearchは、反復回数を固定せずに選ぶ方法です。まず増幅しない状態でも候補を測り、合格なら終了します。合格しなければ新しく状態を準備し、1からMまでの整数を一様に選んで、その回数だけQを反復します。それでも合格しなければ、Mの範囲を段階的に広げて再試行します。[1]

    同じ回数で毎回行き過ぎることを避け、まだ分からない適切な反復規模を探す考え方です。ここでも、測定で得た候補が合格かどうかを判定できなければ、成功した時点で止められません。原論文はa>0のもとで期待呼び出し回数が1/√aに比例することを示していますが、a=0なら、この手順は停止しません。「見つからない」と「存在しない」の判定まで自動的に解決する手続きではありません。

    そのため、振幅増幅の比較では、初期の成功確率を既知とするのか、未知のまま探すのか、条件を満たす候補の存在を保証するのかを揃えることが大切です。同じ反復回数でも、初期状態と合格条件が違えば、成功確率も止めるべき位置も変わります。

    確率の山だけでなく、1試行の長さまで見る

    振幅増幅を使う説明や実装を見るときは、まず「何を合格とし、それをどう判定するか」を確かめます。次に、状態準備Aを逆向きにも実行できるか、反復回数を何から決めたかを見ます。最後に、成功確率だけでなく、1試行の回路と、失敗後のやり直しを含む費用を比べます。

    今回の4候補では、1回で止めることに意味がありました。量子振幅増幅の強みは、操作を長く続ければ確率が積み上がることではありません。干渉で状態の向きを変え、求める候補が出やすいところで測定することにあります。その止めどころを、与えられた知識と費用の範囲で選ぶのが、アルゴリズムを使う際の大切な部分です。

    参考資料

    1. Gilles Brassard, Peter Høyer, Michele Mosca, Alain Tapp「Quantum Amplitude Amplification and Estimation」(2000年5月15日公開、arXiv:quant-ph/0005055v1)。§2、式(1)・(5)・(8)、定理2・3とQSearch、PDF pp.5–9を参照。本文の4候補・反復回数の表とグラフは、この理論式に基づく独自の説明例です。
  • 量子振幅推定、精度を上げると制御回路が長くなる理由

    量子振幅推定、精度を上げると制御回路が長くなる理由

    ある量子回路を測定したとき、目的の条件を満たす結果はどれくらいの確率で出るのでしょうか。回路を何度も実行して数える方法に対し、量子振幅推定(Quantum Amplitude Estimation、QAE)は、その確率を量子状態の位相から読み取ろうとします。

    位相推定を使う標準的な方式では、読み取り用の量子ビットを増やすと、位相を刻む目盛りが細かくなります。ただし、それに合わせて同じ演算を何度も組み込む必要があります。QED-Cの公開ベンチマーク実装と原論文をもとに、細かい推定のために、回路側で何が増えるのかを見ていきます。[1][2]

    簡単にまとめると?

    • 振幅推定は、目的の結果が出る確率を、量子状態に蓄積される位相から推定します。ここでは位相推定と逆量子フーリエ変換を使う方式を扱います。
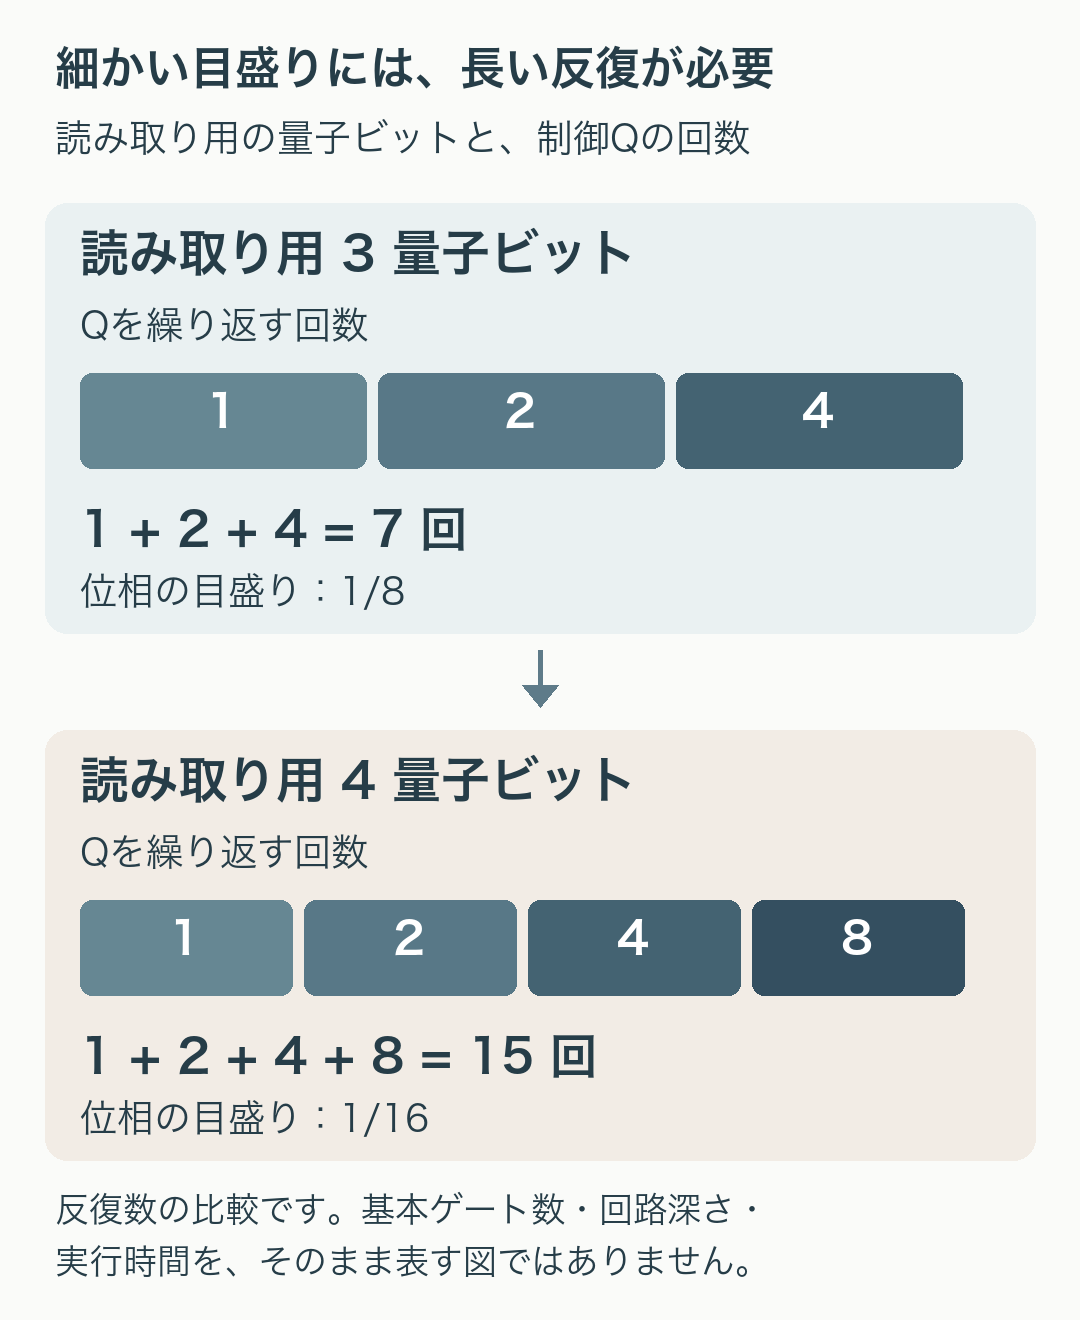
    • 読み取り用がm量子ビットなら、位相の目盛りは1/2m。確認した実装では、制御された演算Qを1、2、4……回と繰り返し、合計2m−1回組み込みます。
    • 反復数は装置上の実行時間や最終的な回路深さとは別です。このベンチマークは既知の確率を埋め込んだ試験なので、未知の実問題を高速に解いた実証とも区別します。

    推定するのは「目的の結果が出る確率」

    まず、入力状態を用意する回路をAと呼びます。Aを実行してから測定すると、目的に合う「よい結果」と、それ以外の結果が出ます。「よい」は計算で決めた条件を満たすという意味で、装置のエラーがないという意味ではありません。

    よい結果が出る確率をaとすると、その部分の振幅は√aです。振幅は量子状態の係数で、確率はその絶対値の二乗から得られます。「振幅推定」という名前ですが、ここで最終的に求める値は確率aです。たとえば、ある条件を満たす候補の割合を、状態の作り方と判定回路に埋め込めれば、その割合の推定に結び付けられます。[2]

    Aの出力をすぐ測るのではなく、A、その逆演算A−1、よい結果と初期状態に応じて符号を変える操作を組み合わせ、演算Qを作ります。原論文の定義では、関係する二つの固有状態にQを作用させると、位相がそれぞれ+2θ、−2θだけ進みます。ここでa=sin²θ、0≤θ≤π/2です。確率を直接数える代わりに、この回転の角度を調べるのが位相推定型QAEの考え方です。[2]

    目盛りを細かくするために、1・2・4回と演算を重ねる

    位相推定では、読み取り用の量子ビットを別に用意します。各ビットに応じてQを作用させる「制御Q」を使い、Q、Q²、Q⁴……という異なる反復回数を組み合わせます。固有状態にQを2回作用させれば位相も2倍、4回なら4倍蓄積します。異なる長さで位相を蓄積した情報を、逆量子フーリエ変換によって、測定できるビット列へ変換します。[1][2]

    QED-Cの固定版実装では、読み取り用の量子ビットごとに、制御Qを追加する回数を1、2、4……と倍増させています。m量子ビットなら、合計は次のようになります。

    1+2+4+…+2m−1=2m−1

    読み取り用3量子ビットでは制御Qを1、2、4回の合計7回、4量子ビットでは1、2、4、8回の合計15回組み込む。位相の目盛りは8分の1から16分の1へ細かくなる。
    図1 読み取り用の量子ビットを一つ増やしたときの違い。QED-C固定版カーネルの反復構造をもとに作成。数えているのは制御Qの組込み回数で、装置上の時間や基本ゲート数ではありません。画像を押すと拡大できます。

    m=3なら7回、m=4なら15回、m=5なら31回です。一本増えた読み取り用の量子ビットが、たとえば8回分のQを担うため、必要な反復は一つだけ増えるのではありません。ここでmは回路全体の量子ビット数ではなく、位相を読み取る部分だけの数です。対象を表す量子ビットや、よい結果を示す量子ビットは別に必要です。[1]

    測定した数から、確率へ戻す

    読み取り用がm量子ビットなら、測定値yは0から2m−1までの整数になります。M=2mと置くと、位相を一周で割った値をy/Mという目盛りで読み取ります。原論文と、このベンチマークの結果変換処理は、確率の推定値を次のように計算します。[2][3]

    推定値 ã=sin²(πy/M)

    ここでπは落とせません。また、Qが進める位相は±2θなので、測定された位相角2πy/Mをそのままsin²へ入れるのではなく、半分の角度に対応させます。角度そのものと、一周を1とした位相の値を混ぜると、答えが変わってしまいます。

    具体例として、m=3、M=8で、a=sin²(π/8)≒0.1464を考えます。理想的な位相推定では、二つの位相に対応する測定値はy=1とy=7です。どちらからもsin²(π/8)=sin²(7π/8)となり、同じ確率へ戻ります。ビット列が二種類出ることだけで、推定が失敗したとはいえません。これは原論文の理想回路についての計算例で、今回この公開実装を実行して得た測定結果ではありません。[2][3]

    mを4にすれば目盛りは1/16になり、この例の二つの位相はy=2とy=14で表せます。もともと目盛りに合う値なので、この一例では、細かくしただけで正しい値がさらに改善するわけではありません。一般の未知の確率では、位相が目盛りと一致するとは限らず、測定値にばらつきが生じます。また、sin²を通して確率に戻すため、位相の等間隔な目盛りは、確率の等間隔な目盛りではありません。たとえばM=8のy=0、1、2は、それぞれ確率0、約0.1464、0.5へ対応します。

    理論上の精度と、装置で支払う負担を分ける

    原論文は、理想的に演算できる条件で、推定誤差が主に1/Mに従って小さくなることを示しています。具体的には、次の誤差範囲に入る確率が少なくとも8/π²、約81.1%とされます。[2]

    |ã−a| ≤ 2π√{a(1−a)}/M + π²/M²

    これは各回で必ずその誤差に収まるという保証でも、装置のノイズを含めた誤差評価でもありません。Mを増やすと理論上の範囲は狭くなりますが、この実装では制御Qの反復がM−1回へ増えます。Qの中にはAとA−1が含まれるため、問題に対応するA自体が複雑なら、一回のQも重くなります。

    さらに、制御Qという大きな操作は、実行先の装置が使える基本ゲートへ分解されます。量子ビット同士の接続や回路の最適化、Aの作り方によって、実際のゲート数と回路深さは変わります。回路深さは順番に実行する操作の層の数であり、2m−1という反復数そのものではありません。ここで確認した反復数だけから、「何秒かかる」「何倍速い」「精度が必ず上がる」とは結論できません。

    既知の確率を使う試験で、何を確かめているのか

    QED-Cのこの実装は、試験用の入力を作りやすくしています。実行側の処理は整数sからa=sin²(πs/2m)を計算し、所定の小数桁へ丸めてから、状態準備回路へ渡します。カーネルのA_genはそのaを使い、回転角を2arcsin√aとして組み立てます。つまり、この試験で使う確率は、入力回路を作る段階ですでに分かっています。[1][3]

    結果を評価する処理は、既知のaに対応するビット列を計算し、通常は二つに各50%、両者が重なる場合などは一つに100%の参照分布を用意します。実測の分布と比較するためのものです。入力の小数丸めもあるため、試験入力が理想の位相目盛りへ厳密に一致すると一律には扱えません。[3]

    既知の答えを持つ試験は、実行先や回路条件を変えたときの出力を比べるために役立ちます。一方、実問題では、未知の確率を含む状態をAでどう準備し、その逆演算をどう実現するかが課題になります。ここでの単純なA_genを使えたことは、現実のデータ読み込みや複雑な計算も同じ負担で実装できる証拠ではありません。公開コードがあること、既知入力で結果を比較できること、未知の問題で実用上の優位を示したことを分けて読む必要があります。

    量子ビット数を見るときは、反復数と問題の準備も確かめる

    位相推定型の振幅推定を比較するときは、まず読み取り用の量子ビット数mと、対象を表す量子ビット数を分けます。次に、制御Qの反復回数だけでなく、Qに含まれるAと逆演算、装置向けの分解後の回路、測定を繰り返す回数を確認します。測定回数を増やすことと、一本の回路内でQを長く繰り返すことも、別の変更です。

    読み取り用のビットを増やせば、位相の目盛りは細かくなります。そのために長い制御演算を保てるか、状態を準備する負担がどれくらいかを合わせて見ることで、振幅推定の理論上の利点と、実装で確かめるべき条件がつながります。

    参考資料

    1. QED-C, Amplitude Estimation Qiskit kernel。固定コミット21dfc331ce61a2170b06f88259aa19f901c021bcのAmplitudeEstimation、A_gen、Ctrl_Qを参照。静的なコード確認であり、今回の実行結果ではありません。
    2. G. Brassard, P. Høyer, M. Mosca, A. Tapp, Quantum Amplitude Amplification and Estimation, arXiv:quant-ph/0005055v1、2000年5月15日。§2、§4、Est_Amp手順、定理12。理想的なアルゴリズムの条件と誤差評価を参照。
    3. QED-C, Amplitude Estimation benchmark driver。同じ固定コミットのa_from_s_int、a_to_bitstring、bitstring_to_a、analyze_and_print_resultを参照。
  • パウリ項をまとめて測る条件、回路数と測定回数のトレードオフ

    パウリ項をまとめて測る条件、回路数と測定回数のトレードオフ

    量子コンピューターで分子や物質を調べるとき、欲しい答えは測定した0と1の並びそのものとは限りません。例えばエネルギーを求めるには、複数の測定結果を平均し、それぞれに係数を掛けて足し合わせます。ここで、同じ測定結果からいくつもの項を計算できれば、測定のために用意する回路の種類を減らせます。

    この工夫がパウリ項のグループ化です。ただし、何でも一つの測定にまとめられるわけではありません。まとめ方によっては、測定直前に量子ビット同士を結ぶ操作が必要になり、回路が長くなります。QED-Cの共同研究は、グループの作り方、各グループに割り当てる測定回数、回路を実行する時間を分けて比較しています。回路の種類が少ないことと、同じ精度の答えを少ない負担で得られることを、区別して読むのがポイントです。[1]

    簡単にまとめると?

    • エネルギーなどを表すパウリ項は、両立する測定のまとまりに分けられます。一度の測定から複数の項の値を読み取れると、用意する測定回路の種類を減らせます。
    • 量子ビットごとに測定方向がそろう場合と、全体としてだけ両立する場合では、必要な回路が違います。後者では、量子ビット間の操作が追加されることがあります。
    • 比較するには、グループ数に加えて、測定回路の深さ、総測定回数と配分、最終的な誤差をそろえて確認します。特定の論文で有利だった配分が、すべての状態や実機で最善とは限りません。

    一つの測定結果から、三つの項を読む

    パウリ演算子の X、Y、Z は、量子ビットの異なる方向の測定に対応する基本的な演算子です。それぞれの測定値は +1 または −1 です。I は恒等演算子で、その量子ビットの結果を使わないことに相当します。複数量子ビットについてこれらを並べたものを、パウリ文字列と呼びます。

    ここでは左を1番目、右を2番目の量子ビットとします。ZI は1番目のZ測定、IZ は2番目のZ測定、ZZ は両方のZ測定値の積です。二つの量子ビットをZ方向に測れば、この三つの値を同じ結果から読み取れます。ZZ のためだけに、もう一度別の回路を実行する必要はありません。

    説明用に、同じ状態を準備して100回測り、次の回数が出たと仮定します。Z測定のビット0を +1、ビット1を −1 に対応させます。この回数は仕組みを示すための例で、論文や実機の測定データではありません。

    表1 同じ二つのビットから、ZI・IZ・ZZの三つの値を計算する例。Quantum Sea作成。
    結果 回数 ZI IZ ZZ
    00 40 +1 +1 +1
    01 10 +1 −1 −1
    10 20 −1 +1 −1
    11 30 −1 −1 +1

    この表から、ZIの平均は (40+10−20−30)/100=0、IZの平均は (40−10+20−30)/100=0.2、ZZの平均は (40−10−20+30)/100=0.4 です。説明用のハミルトニアン、つまりエネルギーを表す演算子を H=0.7 ZI+0.2 IZ−0.4 ZZ と置くと、その期待値の推定は 0.7×0+0.2×0.2−0.4×0.4=−0.12 となります。単位も係数も、この例のために選んだものです。

    三つの項を別々に100回ずつ測れば、合計300回の状態準備と測定になります。この例では一つの測定回路を100回実行するだけで、三つの平均を計算できました。ただし、これだけで「精度を保ったまま、測定回数を必ず3分の1にできる」とは言えません。同じ結果から求めた項の値には相関があり、足し合わせたエネルギーのばらつきにも影響するためです。省けた回路の種類と、必要な精度に達する総測定回数は、別々に評価します。

    全体では両立しても、量子ビットごとには両立しない場合

    ここでいう両立は、演算子の順序を入れ替えても同じになる可換性に対応します。パウリ項同士が可換なら、共通の測定基底、すなわち両方の値を一緒に読み取れる測定の枠組みを選べます。今回のグループ化は、その性質を使う方法です。[1]

    ZIとIZは、各量子ビットでZかIだけを使うので、量子ビットごとの測定方向が衝突しません。一方、XX と ZZ は少し違います。XとZは一つの量子ビット上では反可換で、順序を交換すると符号が反転します。しかし二つの量子ビットでは、その符号反転が二回起きて打ち消されます。したがってXXとZZは、全体としては可換です。

    表2 可換性の違いと、同じ測定にまとめる条件。資料[1]の区分を使った独自の2量子ビット例。Quantum Sea作成。
    項の組 量子ビットごとに可換 全体として可換 測定の組み方
    ZIとIZ はい はい 両方をZ方向に測る
    XXとZZ いいえ はい 両量子ビットにまたがる基底変換でまとめられる
    XIとZI いいえ いいえ この可換グループ測定では別のグループに分ける

    XXとZZを一緒に読む方法の一つは、1番目を制御、2番目を標的とするCNOTゲートをかけ、その後で1番目にアダマールゲートをかけてから、両方をZ測定する手順です。このとき1番目の測定値が変換前のXX、2番目の測定値が変換前のZZに対応します。CNOTは二つの量子ビットを結ぶ操作で、アダマールゲートは測定方向を切り替える基本的な操作です。ここでは理想的な操作を仮定しています。

    この例では、別々だった測定を一つにまとめる代わりに、CNOTが必要になります。実機では量子ビットの接続やゲートの誤りも関係するため、回路の種類を減らす効果と、追加操作による負担を比べる必要があります。

    kは「まとめる項の数」ではなく、可換性を調べる範囲

    原論文のk可換性(k-commutativity)では、量子ビットの並びをk個ずつのブロックに区切り、各ブロックの中でパウリ項同士が可換になることを求めます。最後のブロックだけk個未満になる場合もあります。k=1なら量子ビットごとの可換性、kが全量子ビット数nなら全体の可換性です。kはグループ内の項の個数でも、測定の繰り返し回数でもありません。[1]

    先ほどのXXとZZは、k=1では分かれ、k=2なら一緒にできます。グループの測定基底は、ブロックごとにクリフォード回路で変換します。これはパウリ演算子を別のパウリ演算子へ移す性質を持ち、アダマールやCNOTなどで構成できる回路です。大きなブロックでまとめるとグループを減らせる場合がある一方、測定のための量子ビット間操作が増える可能性があります。[1]

    公開実装では、係数の絶対値が大きい項から順に、条件を満たす既存グループへ入れていき、入る場所がなければ新しいグループを作ります。こうした貪欲法は、その時点で選べるまとまりを順に決める方法で、最少グループ数を保証しません。論文でも、kを変えたときにグループ数が期待どおり減らない例が示されています。「kを大きくしたから、必ず回路が少なくなった」と考えず、実際に生成されたグループと測定回路を確認します。[1][2]

    グループを作ったあとに、測定回数を配る

    同じ回路の状態準備から測定までを一度行うことを、通常1ショットと呼びます。グループが10個あって、各グループに100ショットを割り当てれば、合計は1,000ショットです。グループを5個に減らし、各100ショットにすれば500ショットになりますが、これは総測定回数を変えた比較です。総数を1,000に保ち、各200ショットとする比較とは分けて考えます。

    原論文は、総ショット数を固定したうえで、各グループのパウリ係数の絶対値について、平均や最大値、その二乗などから重みを作る方法を調べています。各グループへ、その重みに比例する回数を配ります。係数の小さなグループが丸めによって0回にならないよう最低1回を割り当て、丸めで総数がずれた分も調整しています。全グループを少なくとも1回測るには、当然ながら、総ショット数がグループ数以上である必要があります。[1]

    係数の大きな項を丁寧に測る考え方には理由があります。同じ平均値のずれでも、最後に大きな係数を掛ければ、エネルギーへの影響が大きくなるからです。ただし、係数だけで測定の難しさがすべて決まるわけではありません。同じ項でも、準備する量子状態によって +1 と −1 の出やすさが変わります。また同時に測る項の間の相関も、グループを合計した値のばらつきを変えます。係数に基づく配分を、状態や装置によらない万能な最適解とみなすことはできません。

    論文の比較では、12量子ビットの8種類のハミルトニアンを使い、100通りのランダムな状態準備について測定による推定を評価しています。この部分では時間発展のトロッター・ステップ数を0とし、時間発展の近似誤差を混ぜずに測定方法を比較しています。グループ化を全体として可換なn-commuteに固定した総4,000ショットの比較では、係数の絶対値の平均を使う配分が、一様に配る方法より小さな誤差を示しました。ここでの誤差は、シミュレーションで得たエネルギーと理論値の差について、複数試行で求めた標準偏差です。特定の比較条件で得た結果であり、量子状態そのものの忠実度や、すべての実機での改善率を表す数値ではありません。[1]

    回路の種類、ショット数、実行時間を分けて比べる

    グループ化を選ぶときは、まず同じハミルトニアンと同じ状態を対象にし、何を固定して比べるかを決めます。総ショット数を固定して誤差を見る方法もあれば、目標誤差に届くまでの総時間を比べる方法もあります。後者には量子回路の実行だけでなく、グループ化や測定回路の生成、実行要求をまとめる処理の時間も入ります。[1]

    表3 同じ精度に届く測定方法を選ぶための確認項目。資料[1]と本文の例を基にQuantum Sea作成。
    確認するもの 比較でそろえる条件 判断への使い方
    グループと測定回路 同じパウリ項・係数、量子ビットの順序と区切り 何種類の回路ができたか、追加の2量子ビット操作が何個必要かを見る
    測定回数と配分 総ショット数、グループごとの回数、状態準備 回路を減らした効果と、測定回数を増減した効果を混ぜない
    誤差と実行時間 参照値、誤差の定義、装置と雑音、集計に含める工程 目標誤差に届いたか、そのためにどれだけの総時間を使ったかを見る

    例えば、kを大きくしても生成されたグループ数が同じなら、測定基底を変える回路が短い方を選べるか確認する価値があります。逆にグループ数が大きく減っても、追加ゲートの雑音で推定値のずれが増えるなら、短時間で多く測るだけでは解決しない場合があります。ショット数を増やして抑えやすい統計的なばらつきと、装置や回路に由来する偏りを分けて調べます。

    論文に結び付いた公開実装からは、グループ化と測定回路の構成を追えます。ただし、コードが公開されていることは、手元の装置で同じ精度や所要時間を再現できたことを意味しません。本稿では版を固定して処理を確認しており、実装を実行した性能試験は行っていません。測定をまとめる目的は、単に回路の種類数を小さくすることではなく、求める物理量を必要な精度で得るための負担を減らすことです。[2]

    出典

    1. Siyuan Niuほか「A Practical Framework for Assessing the Performance of Observable Estimation in Quantum Simulation」、arXiv:2504.09813v1、2025年4月14日提出。第III節のグループ化・測定回路・ショット配分、第IV節A–Cの比較条件と結果を参照。表1・2の数値や回路例は本稿独自の説明例。
    2. QED-C「Application-Oriented Performance Benchmarks for Quantum Computing — HamLib」、コミット 21dfc331ce61a2170b06f88259aa19f901c021bc。パウリ項のグループ化と測定回路の生成の実装を参照。論文と関連実装を、独立した二つの性能実証としては扱っていない。
  • 量子計算のミラー回路、元へ戻る結果で確かめられること

    量子計算のミラー回路、元へ戻る結果で確かめられること

    量子コンピューターの計算結果を確かめるには、比較する答えが必要です。小さな回路なら、通常のコンピューターで同じ計算を再現できます。けれども、量子ビットが増えてその再現が重くなると、試したい回路だけでなく、答え合わせの計算にも大きな負担がかかります。

    ミラー回路は、計算を進めたあとに、その操作を逆順に戻す回路を付ける方法です。理想的には出発点へ戻るので、途中の複雑な状態をすべて計算しなくても、最後に期待する答えを用意できます。QED-Cの共同研究は、この方法をハミルトニアン・シミュレーションの評価へ組み込んでいます。ただし、「戻れた」という結果と、途中で目的どおりの物理計算ができたことは、同じ意味ではありません。[1]

    簡単にまとめると?

    • ミラー回路は、元の回路とそれを打ち消す回路を組み合わせ、答え合わせをしやすくします。途中の状態を古典計算で再現する負担を減らせますが、実行する回路は長くなります。
    • 「雑音なしの同じ回路」「物理モデルの時間発展」「往復後の既知の答え」は、それぞれ異なる比較対象です。ミラー回路だけでは、回路を作るときの近似誤差を測れません。
    • 単純な往復では、行きと帰りのずれが打ち消し合う場合もあります。ランダムな操作を組み込む工夫や、測定方法・初期状態・回路の深さの確認が必要です。

    物理モデルを回路へ移すときにも、誤差が入る

    ハミルトニアンは、量子系のエネルギーや、状態が時間とともにどう変わるかを表す演算子です。ここでは時間によらないハミルトニアン H と、時間 t を指定し、状態の変化を表す U(t)=exp(−iHt) を量子回路で実現することを考えます。式ではプランク定数の一種である ℏ を1とする単位を使っています。[1]

    装置が一度に実行しやすい操作へ分ける方法の一つが、トロッター分解です。例えば H=A+B なら、Aによる短い変化とBによる短い変化を順に行い、それを何回も繰り返します。AとBを入れ替えると結果が変わる場合、この順番のある操作は、両方が同時に働く時間発展と一般には一致しません。これが近似に由来するトロッター誤差です。

    時間を細かく分ければ、この近似誤差を抑えられます。一方、操作数は増えるため、実機では雑音の影響を受ける機会も増えます。回路が指定どおりに動いたかと、その回路が元の時間発展を十分よく表すかを、分けて調べる必要があります。[1]

    三つの答え合わせは、違う問いに答える

    QED-Cの研究では、同じハミルトニアン・シミュレーションに対して、三種類の評価方法を整理しています。数値を見る前に「何を正しい分布として比べたか」を確かめると、結果の意味がはっきりします。ここでいう分布は、決めた測定方法で0と1の並びが出る確率です。量子状態のすべての情報を直接比較しているわけではありません。原論文で使う正規化ヘリンガー忠実度(normalized Hellinger fidelity)は、二つの測定結果の確率分布の近さを表す指標です。量子状態や量子操作そのものを比べる忠実度と、同じ数値になるとは限りません。[1]

    表1 QED-Cの三つの評価方法を、比較相手と用途で整理。資料[1]第III節を基にQuantum Sea作成。
    方法 比較する答え 主に確かめたいこと
    Method 1 同じトロッター回路を雑音なしで計算した分布 指定した回路の実行で、結果がどれだけ変わったか
    Method 2 ハミルトニアンを行列として解いた時間発展の分布 トロッター近似と実行時の雑音を含めて、目標の時間発展にどれだけ近いか
    Method 3 回路の構成からあらかじめ分かる分布(単純な往復では初期状態の分布) 途中の状態を古典計算で再現せずに、回路の実行品質を調べる

    Method 1では、比較する側も同じトロッター近似を使います。実機と雑音なしの回路がよく一致しても、両方が同じ近似誤差を含んでいれば、その誤差は見えてきません。Method 2なら、回路に分割する前の時間発展と比べられます。ただし、ここでいう厳密な時間発展にも、古典計算の数値精度の限界があります。

    Method 2を雑音なしの回路に対して行えば、近似そのものの影響を調べられます。まず小さい問題でこの差を確認し、次に実機での差を見ると、近似の刻み方と装置の雑音を考え分ける手掛かりになります。二つの指標の差をそのまま引いて「雑音だけの誤差」とする、という意味ではありません。

    逆に戻すのは、作った回路そのもの

    ある回路を C とすると、その操作を打ち消す逆回路は C⁻¹ です。先にC、続いてC⁻¹を実行すれば、理想的には C⁻¹C=I、つまり何もしない操作と同じになります。例えば0101から始めるなら、最後に0101が出るはずだと分かります。初期状態が複数の測定結果を取りうる場合は、その既知の分布と照合します。[1]

    大切なのは、逆に戻している相手が作成した近似回路Cである点です。Cが目的の時間発展Uと少し違っていても、Cの逆回路を正しく実行すれば戻れます。元へ戻れたことだけで、CとUの違いを判定することはできません。

    これを一つの量子ビットで確かめてみます。説明用に H=X+Z、t=1、初期状態を0とします。XとZは異なる方向の状態変化を表すパウリ演算子で、順序を入れ替えると結果が変わります。短いXの操作、次に短いZの操作を行う組をK回繰り返す、一次のトロッター回路を考えます。

    表2 説明用の1量子ビット計算。雑音と標本抽出は含めず、2×2行列から求めた確率を小数第3位まで表示。QED-Cの実験データではありません。
    計算 片道後に1を測る確率 その回路の逆操作後に0を測る確率
    K=1 0.708 1.000
    K=4 0.502 1.000
    K=16 0.489 1.000
    Hから直接求めた時間発展 0.488 比較対象外

    片道の結果は、Kを増やすとこの例の厳密な値へ近づいています。それでも、近似の粗いK=1を含め、逆回路の後はどれも元へ戻ります。「往復が合う」と「途中の答えが目標に合う」を分ける理由が、この二列の違いに表れています。実機でKを増やした場合に、雑音も含めた結果が同じように改善するとは限りません。

    行きと帰りのずれが、打ち消し合うこともある

    単純なミラー回路には、別の見落としもあります。例えば、ある軸の周りに90度回す指定が、装置の系統的なずれで100度になったとします。帰りの−90度という指定も−100度になれば、合計は0度です。往復だけを見ると元へ戻っても、片道では指定からずれています。これは、ずれが角度の符号に応じて同じ比率で生じると仮定した説明例です。

    このように、量子操作の振幅や位相に系統的に生じるコヒーレント誤差は、往復の間で打ち消し合ったり、逆に強め合ったりすることがあります。原論文は、回路の中央へランダムなパウリ操作を入れ、後半もそれに合わせて変更する方法を扱っています。この乱択変種では、元のビット列がそのまま戻るとは限りません。初期状態に、追跡したパウリ操作を施した結果が、あらかじめ分かる比較対象になります。最後の答えを古典計算で追えるまま、単純な往復の対称性を崩して、誤差の見落としを減らす狙いです。ランダム操作を挟むだけで、後半をそのままにする方法ではありません。[1]

    固定した公開コードにも、通常の逆回路を使う分岐と、パウリ操作を考慮した回路を使う分岐があります。同じ「Method 3」という名前でも、どの変種を使い、何種類のランダム回路を何回ずつ測ったかを確認する必要があります。ここでは公開コードを読んだ範囲を扱い、QED-Cのプログラムや量子実機を実行した評価はしていません。[2]

    答え合わせが軽くなっても、試験の条件は残る

    ミラー回路では、行きの回路に帰りの回路を加えるため、深さがおよそ2倍になります。原論文は往復で得た指標の平方根を使って片道と比較する整理も行います。その説明では、系全体にかかる脱分極雑音(global depolarizing noise)を仮定し、各ゲートとその逆は同じ程度の誤差を持つとしています。各ゲートの指標をFと置き、n個の操作の指標を Fⁿ と近似する考え方です。この条件で、往復の指標を片道の指標の二乗として扱い、平方根を比較に使います。一般の装置で、単に平方根を取れば片道の品質が正確に分かるわけではありません。状態の準備と測定に由来する誤差も、回路本体の誤差と分けて点検する課題です。[1]

    評価結果を選ぶ場面では、まず、物理モデルの近似精度を知りたいのか、用意した回路の実行品質を知りたいのかを決めます。前者なら、小さい問題で厳密な時間発展と比べる検証が手掛かりになります。後者で、途中の状態を古典計算で再現するのが難しければ、既知の答えを作れるミラー回路が候補になります。

    そのうえで、初期状態、トロッター分解の順序と回数、測定方法、回路の変換条件、測定回数、往復の変種を揃えます。古典計算による答え合わせを軽くできることは、量子回路を任意の規模で正確に動かせることでも、実用計算で優位になったことでもありません。ミラー回路の結果は、何を確かめるために往復したのかと結び付けて読むと役立ちます。

    参考資料

    1. Avimita Chatterjeeほか(QED-C collaboration)「A Comprehensive Cross-Model Framework for Benchmarking the Performance of Quantum Hamiltonian Simulations」。arXiv:2409.06919v1、2024年9月11日投稿、PDF表記は9月12日。第II.B節、第III.A–D節、Fig.3、Table I・II、付録Aを参照。参照版PDF。本稿はこの投稿版に基づき、後の出版版の実験結果を検証した記事ではありません。
    2. QED-C「QC-App-Oriented-Benchmarks」。commit 21dfc331ce61a2170b06f88259aa19f901c021bc、2026年10月18日確認。Hamiltonian Simulationの説明/回路生成と逆回路の分岐。公開実装は性能標準ではなく、参照用アプリケーションの試作群として提供されています。
  • DNSのserve-stale、古い答えで障害をしのぐ条件

    DNSのserve-stale、古い答えで障害をしのぐ条件

    名前に対応するIPアドレスなどを管理する権威DNSサーバーへつながらなくなっても、少し前まで使えていた名前なら、手元のキャッシュにIPアドレスが残っているかもしれません。ただし、そのデータのTTLがすでに切れていたら、もう回答に使えないのでしょうか。

    serve-staleは、更新できないときに期限切れのDNSデータを利用し、名前解決の停止を避けようとする仕組みです。古い情報をどこまでも信じるのではなく、更新を試すことと、利用者を待たせる時間を分けて考えます。ここではRFC 8767の仕組みと例示手順をもとに、何のための時間制限なのかを整理します。[1]

    簡単にまとめると?

    • serve-staleは、更新できない期限切れデータを使ってDNSの可用性を補います。元のTTLを一律に延長する仕組みとは異なります。
    • 利用者を待たせる時間、名前解決を続ける時間、失敗後の再確認間隔、期限切れデータの保持期間は別々です。返答に添えるTTLも区別します。
    • 古い回答を返した後も更新を続けることが大切です。ただし、DNSで名前が引けても接続先が使える保証はなく、DNSSECの署名期限や正当な不存在応答も無視できません。

    TTLが切れることと、データが役立たなくなることは同じではない

    利用者に代わってDNSを調べる再帰リゾルバーは、受け取ったデータをキャッシュします。TTL(Time To Live)は、受け取ったDNSレコードをキャッシュしておける秒数を伝える値です。通常はその期間内に再利用し、期限が切れたら元の情報源へ再び問い合わせます。期限が切れた時点で、実際のIPアドレスも必ず変わるわけではありません。

    たとえば、権威サーバーへのネットワークが一時的に途切れていても、ウェブサーバー自体は以前と同じアドレスで動いていることがあります。このとき古いDNSデータが役立つ可能性があります。反対に、障害中にアドレスが変更されていれば、古い回答は接続できない相手へ利用者を案内するかもしれません。serve-staleは、この名前解決を止めない利点と、更新を確認できない不確かさを引き受ける仕組みです。[1]

    RFC 8767は、TTLが切れたときにデータを権威サーバーから更新できないなら、期限内のデータと同様に利用してもよいとしています。一方、更新を試すことまで省いてよいわけではありません。古い回答を常に先に返すのではなく、最近きちんと更新を試したという条件が必要です。[1]

    四つのタイマーは、違うものを守っている

    RFC 8767の第5節は、責任を持ってserve-staleを実装する一つの方法として、四つのタイマーを示しています。同じ値を別名で呼んでいるわけではありません。利用者の応答待ちを短くしながら、裏側では更新の機会を確保するために分かれています。

    Client response timer:利用者への応答待ち

    問い合わせを受けてから、利用者へ回答するまでの待ち時間です。短すぎると、権威サーバーが遅いだけでも古い回答を使いやすくなります。長すぎると、利用者側が待ちきれずタイムアウトします。

    Query resolution timer:名前解決を続ける時間

    権威サーバーなどへの問い合わせ処理に使える時間の上限です。利用者へ古い回答を返した後も、この上限までは更新を試せます。応答待ちと同時に処理を打ち切ると、遅れて届く正しい回答でキャッシュを更新する機会を失います。

    Failure recheck timer:失敗後の再確認間隔

    失敗した問い合わせを、再び試す頻度を抑えます。短すぎると障害中の相手へ問い合わせが集中し、長すぎると復旧を見つけるのが遅れます。

    Maximum stale timer:期限切れデータの保持期間

    元のTTLが切れてから、古いデータを保持する長さです。短すぎると障害時に使える情報が残らず、長すぎるとメモリーを使って古い内容を保持し続けます。利用者への回答時間を決めるタイマーとは独立しています。

    同節は利用者への応答待ちに1.8秒を推奨し、名前解決を続ける時間は一般的に10〜30秒程度と説明しています。期限切れデータの保持期間には1〜3日を提案しています。これらは、すべてのリゾルバーに共通する実際の設定値ではありません。RFC自身が、正式な一つのアルゴリズムを定めるのではなく、実装上の選択肢と影響を説明するとしています。導入済み製品の挙動は、その版と設定で確認する必要があります。[1]

    古い回答を返しても、更新処理は終わらない

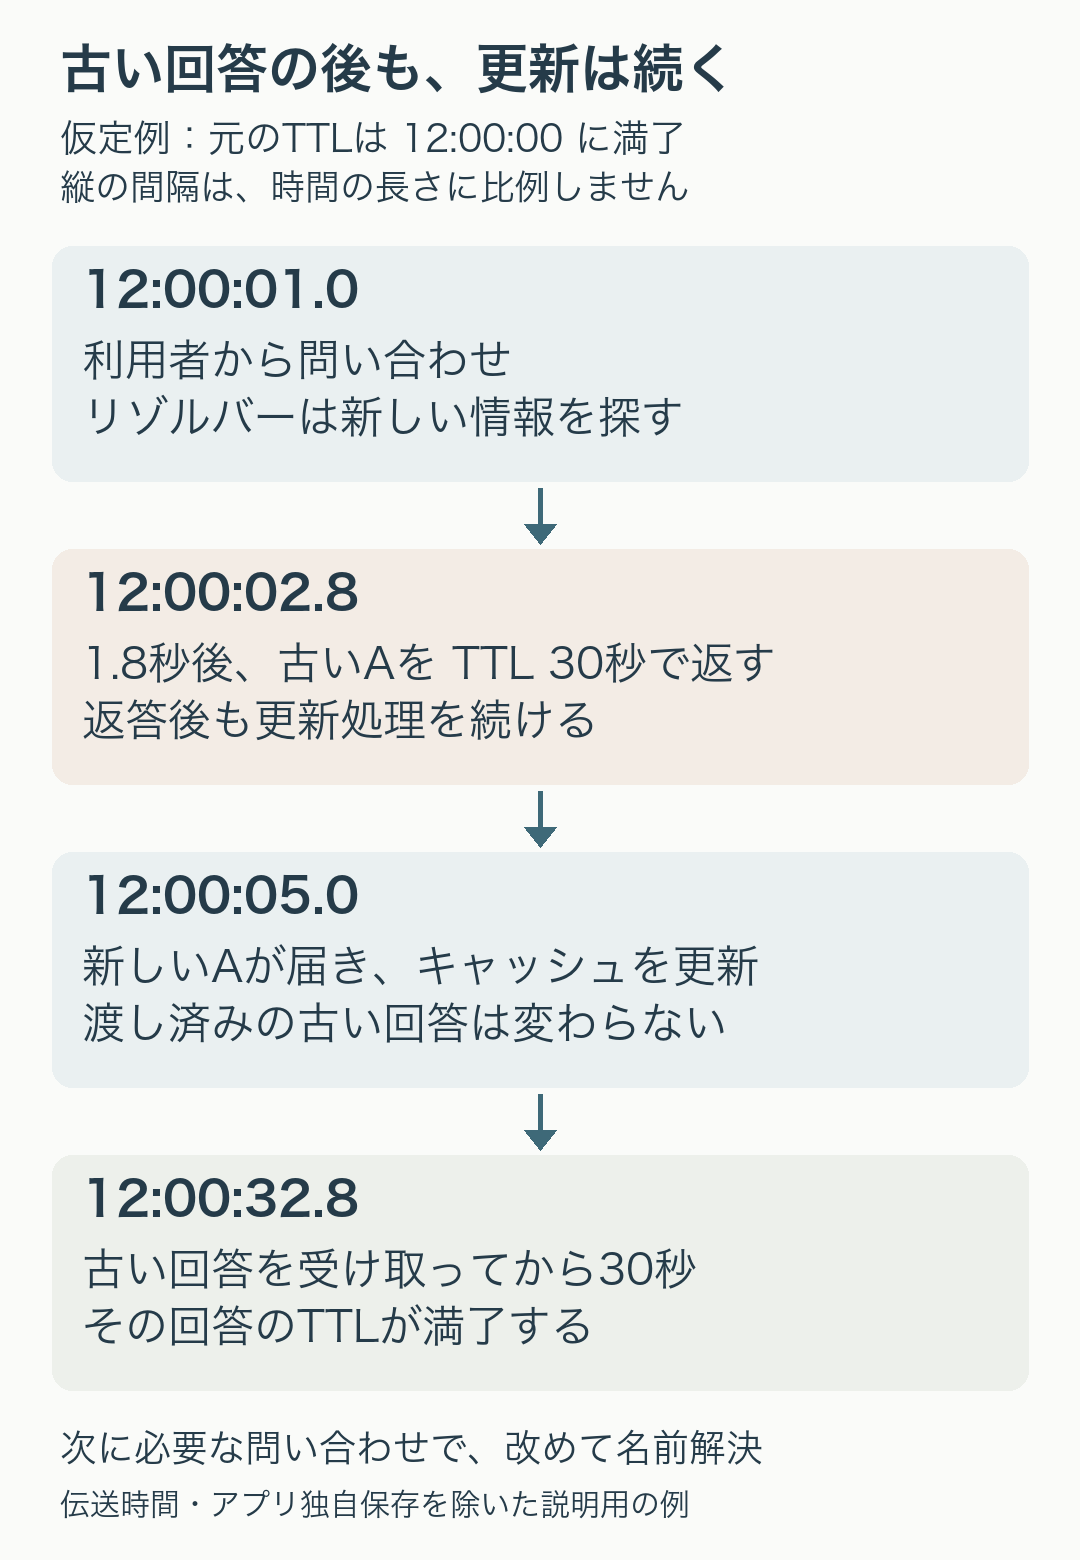
    次は、時刻の関係を確かめるための仮定例です。リゾルバーには、ある名前の古いAレコードが残っています。元のTTLは12:00:00に切れ、12:00:01に利用者から問い合わせが来たとします。直前の失敗による再試行の待機中ではなく、ここから更新を試す条件です。利用者への応答待ちは1.8秒、名前解決の上限は20秒、期限切れデータの保持上限は2日と仮定します。Aレコードは名前に対応するIPv4アドレスを示す情報です。この例では古いAが保持され、DNSSECの検証上の問題など、ほかの制約はないものとします。

    12時00分01秒に更新開始、02.8秒に古い回答をTTL30秒で返した後も更新を続け、05秒に新しい情報を得る。利用者へ渡した古い回答のTTLは32.8秒に満了する時刻例。
    図1 回答を待つ時間と、更新を続ける時間を分けた仮定例。RFC 8767 §§4〜7の動作をもとに作成。間隔は時間の長さに比例していません。画像を押すと拡大できます。

    この例の20秒は、12:00:01から12:00:21まで更新処理に使える上限です。12:00:05に回答が得られれば、その時点で処理できます。20秒間必ず待つという意味ではありません。図の12:00:32.8は、古い回答を受け取った12:00:02.8から30秒後です。伝送時間を無視し、利用者側が返されたTTLを守ってキャッシュし、アプリケーション独自の保存などがない場合を示しています。TTL満了と同時に新しいアドレスが全端末へ配られるわけではありません。図は仕様を説明する計算例で、実際の障害環境を測定した結果ではありません。[1]

    ここで、古い回答を返した12:00:02.8に更新処理まで打ち切ってしまうと、12:00:05に得られたはずの新しいデータを受け取れません。権威サーバーを探す処理がいつも利用者の待ち時間より長くかかる環境なら、問い合わせのたびに古い回答へ戻り、更新できない状態が続くおそれがあります。利用者への返答を済ませることと、更新を諦めることを分けるのが、この例示手順の要点です。[1]

    返答のTTL 30秒と、保持上限2日は別の時計

    期限切れデータを回答に使う場合、RFC 8767は、期限切れの各レコードへ0より大きいTTLを付けることを要求し、30秒を推奨しています。この値は、その回答を受け取る側が再利用する時間に関わります。リゾルバー自身が期限切れデータをどれだけ長く保持するかとは別です。[1]

    たとえば先ほどの2日という保持上限は、元のTTLが切れた後も古いAを残しておく期間の仮定です。回答するたびにこの保持期限を2日先へ戻す、という説明ではありません。RFCにある「7日」という推奨上限も、この保持期間とは別です。7日は権威サーバーから受け取ったTTLに上限を設ける場合の値で、期限が切れた後の保持期間には第5節で1〜3日が提案されています。また、保持上限まで必ず残るとも限りません。メモリー不足なら、期限内のデータを優先して古いデータを削除する設計も考えられます。短い返答TTLと長い保持期間を一つにまとめると、どちら側にどれだけ古い情報が残るのかを見誤ります。[1]

    失敗後の再確認間隔も、別に考えます。問い合わせるたびに障害中の権威サーバーへ同じ処理を繰り返せば、負荷を増やしてしまいます。RFC 8767の例では、失敗した権威サーバーへの更新試行を30秒より頻繁に行わないことを推奨しています。後のRFC 9520は解決失敗のキャッシュを必須にし、保存された失敗に一致する問い合わせは、その期限が切れるまで対応する外向き問い合わせを送らないと定めています。RFC 9520では、失敗の保存時間は少なくとも1秒、最長5分とされ、失敗が続く場合には待機時間を延ばす方法を推奨しています。これは古い正常回答の保持期間とは異なる制御です。[1][2]

    古い情報を使わない境界も必要になる

    新たに権威サーバーへ到達できたら、以前の情報が都合よいからという理由で使い続けることはできません。RFC 8767では、応答コードがNOERRORまたはNXDOMAINで、権威応答を示すAAビットが付いた回答を、更新に成功したものとして扱います。名前が正式になくなった場合のNXDOMAINは、単なる通信障害とは違います。古いIPアドレスを保持しているだけで、正当な不存在の回答を覆すわけにはいきません。[1]

    元のTTLが0のレコードも例外扱いで保存できるわけではありません。TTL 0は、その取引中だけに使い、キャッシュしないデータです。RFC 8767は、serve-staleのための予備としても使えないと明記しています。[1]

    さらに、署名でDNSデータを検証するDNSSECを使う場合、データのTTLと署名の有効期間は別です。古いデータがキャッシュに残っていても、署名まで有効だとは限りません。RFC 8767は、署名期限が切れて検証に失敗する可能性を注意点に挙げています。serve-staleによって署名の期限が延長されるわけではありません。名前に対応する情報が手元にあることと、その情報を検証できることを分ける必要があります。[1]

    設定を読むときは、何を待つ時間なのかを確認する

    serve-staleの設定や障害時の記録を見るときは、「有効か無効か」だけでなく、期限切れデータをどこまで保持するか、利用者へ返す前に更新を試すか、古い回答後も更新が続くかを確かめると判断しやすくなります。復旧後もしばらく古いアドレスが見えるなら、失敗後の再確認待ちと、すでに利用者へ渡した回答のTTLを区別して調べます。

    障害中も名前が引けることは、接続先のサービスが動いていることや、最新の移転先へ到達できることの保証にはなりません。通常のキャッシュ期限、古い回答を許す条件、更新を再開する条件を別々に確認することで、serve-staleが守れる範囲と、その外に残る問題が見えてきます。

    参考資料

    1. RFC Editor, RFC 8767: Serving Stale Data to Improve DNS Resiliency、2020年3月。§§4〜7・10。TTLの扱い、例示手順、実装上の選択肢と制約を参照。
    2. RFC Editor, RFC 9520: Negative Caching of DNS Resolution Failures、2023年12月。§§1.2・3.1〜3.4。serve-staleの背景、再試行と解決失敗キャッシュの要件を参照。
  • OQDのデータフロー解析、変化した先だけを調べ直す仕組み

    OQDのデータフロー解析、変化した先だけを調べ直す仕組み

    処理が一本道なら、手前から順に調べれば済みそうです。けれども、途中で道が分かれ、再び合流したり、前の処理へ戻ったりするとどうでしょう。後から届いた情報によって、一度調べた場所の答えが変わることがあります。

    このとき、何をもう一度調べるかを管理するのが、データフロー解析のワークリスト法です。Open Quantum Design(OQD)の公開コンパイラー基盤には、その仕組みを汎用のグラフへ適用する実装があります。保存されたコードの具体例から、情報が合流する方法、ループで調べ直す理由、計算を終えてよい条件を見ていきます。

    簡単にまとめると?

    • ワークリストは「これから調べる場所」の一覧です。OQDの対象実装は最初に全ての点を入れ、その後は出力が変わった点の影響先を再登録します。
    • 合流では、何を知りたいかに合わせて情報をまとめます。「どれかの経路から届く」なら和集合、「全ての経路に共通する」なら共通部分、という違いがあります。
    • 同じ計算をしても値が変わらない状態が固定点です。単調性や有限の高さなどの条件が収束を支えますが、反復上限へ達してエラーになったことは、答えが確定した意味ではありません。

    データフロー解析で流すのは、処理についての情報

    データフロー解析は、処理のつながりに沿って情報を伝え、各地点で何が分かるかを調べる方法です。例えば、「この場所まで、どの処理からたどり着けるか」「この変数の値は、この先で使われるか」といった問いがあります。ここで流すのは解析用の集合や状態であり、量子ビットを物理的に運ぶ話ではありません。

    OQDの対象実装では、グラフの各点について、入ってきた情報を表す in_states と、その点で計算した後の情報を表す out_states を持ちます。複数の相手から届く情報をまとめる merge と、その点で情報を変換する transfer は、解析を作る側が定義します。グラフの点と前後の隣接関係があれば使えるため、特定の量子回路専用の解析には固定されていません。[1]

    この記事で扱うのは、OQD Compiler Infrastructureのコミット 1e861edacd25773df3b678c6002c5439b0691c37 です。保存版の宣言バージョンは0.1.0、開発状態はAlphaです。公開実装の読み取りと小さなソフトウェア例の検証であり、量子実機の性能向上を示すものではありません。[1、3]

    合流とループがあると、一度の順番では足りない

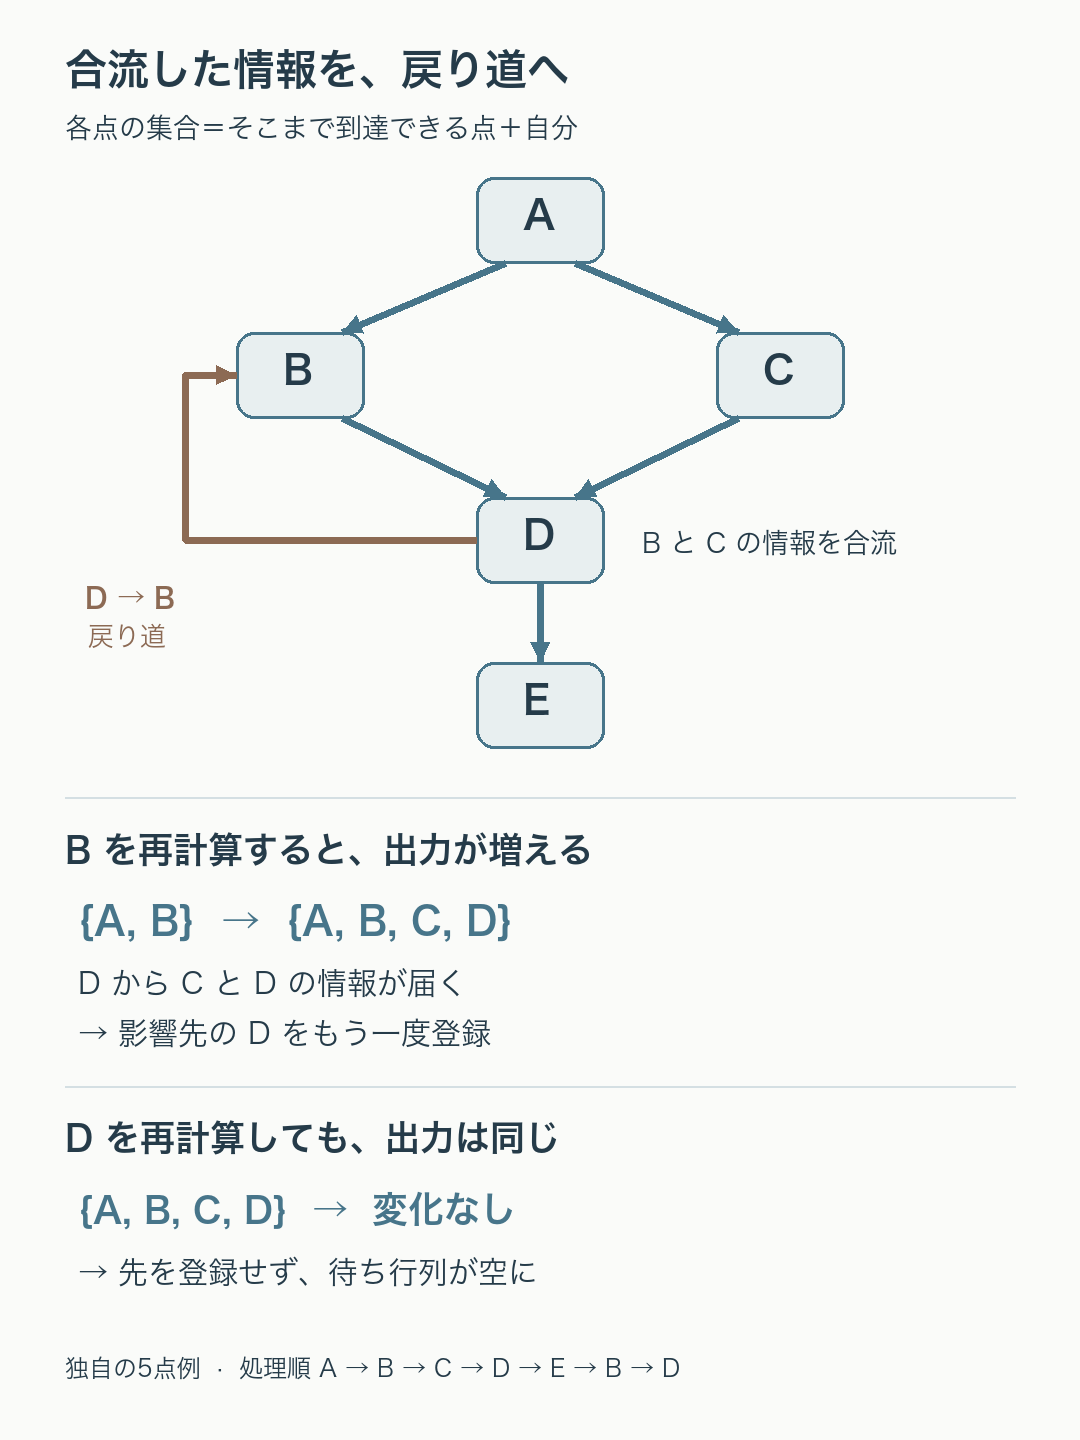
    例として、AからBとCへ分かれ、Dで合流してEへ進むグラフを考えます。さらに、DからBへ戻る道も一本あります。各点に持たせるのは、その点までたどり着ける点の集合です。自分自身も含めます。

    最初は全て空集合にし、前の点から届いた集合を和集合で合わせ、そこへ自分の名前を加えます。これは、OQDの上流テストにある到達関係の解析を、合流とループを含む独自の例へ適用したものです。集合に入った名前は「そこから到達できる」という可能性を表し、実際のプログラムが全ての道を一度に通った、という意味ではありません。[2]

    AからBとCへ分岐しDで合流、Eへ進むグラフ。DからBへの帰還でBの集合が増え、Dを再計算して変化がなければ再登録が止まる。
    図1 合流で得た情報が、戻り道を通ってBへ届きます。下段はBとDを調べ直したときの出力の変化。クリックすると拡大できます。OQDの保存版実装による独自の検証例をもとに作図。

    A、B、C、D、Eの順に最初の計算をすると、Aの出力は{A}、Bは{A, B}、Cは{A, C}です。DではBとCから来た情報を合わせ、自分のDも加えるので、{A, B, C, D}になります。

    ここでDの出力が増えたため、その影響先であるBとEを調べる必要が生まれます。Eはまだワークリストにいるので追加せず、既に一度調べ終えたBだけを末尾へ戻します。残る順番はE、Bです。

    Eを調べた後にBへ戻ると、今度はAだけでなくDからも情報が来ます。Bの出力は{A, B}から{A, B, C, D}へ増えます。そこで、Bの影響先であるDをもう一度登録します。

    Dを調べ直しても、出力は既に{A, B, C, D}です。入力は更新されますが、出力には新しい情報が加わりません。このため、BやEをさらに登録せず、ワークリストが空になります。今回の初期順序と隣接関係の順序では、点を取り出す回数は7回でした。グラフ全体を7周した数でも、他の方法との速度比較でもありません。

    出力が変わらなければ、先へ通知しない

    対象のOQD実装は、待ち行列の先頭から点を取り出し、入力をまとめ、変換後の出力を前回と比べます。出力が同じなら、その点の処理はそこで終わります。変わったときだけ影響先を末尾へ追加し、既に待ち行列にある点を重ねて追加しません。[1]

    大事なのは、途中で入力が変わったかだけでなく、その点から先へ渡す出力が変わったかで判断することです。今回のDのように、入力が増えても、出力に新しい情報がなければ先の計算は増やさずに済みます。ただし、この仕組みだけから、任意のグラフで何倍速くなるとまでは言えません。

    なお、この到達集合の例では初期値を空集合へ明示的に変更しています。基底クラスの既定値はラティスの最上位値 top() です。「OQDの全ての解析が空集合から始まる」と読むと、別の解析を組むときに意味が変わってしまいます。

    前向きと後向きは、知りたいことから選ぶ

    過去の処理から現在へ届く情報を調べるなら、前向き解析が自然です。OQDの ForwardDataflowAnalysis は前の点から情報を受け取り、出力が変わると次の点を登録します。

    一方、「この値がこの先で使われるか」のように、将来の必要性を現在へ伝えたい場合は後向き解析を考えます。BackwardDataflowAnalysis は次の点から情報を受け取り、前の点を登録します。ただし、方向を替えるだけで変数の生存解析が完成するわけではありません。何を使用・定義として扱うか、どの情報を残すかも別に定めます。[1、4]

    この実装の in_states と out_states は、解析の情報が入る側・変換後の側の名前です。後向き解析ではプログラムの実行方向と逆になるので、コード上の名前をそのまま実行前・実行後と読み替えないことも大切です。

    合流の方法も、問いと一緒に選びます。今回のように「どれかの経路で到達できる」を集めるなら和集合です。「どの経路を通っても必ず成り立つ」を調べるなら、各経路の情報の共通部分を残す設計が考えられます。和集合か共通部分かを替えれば済むとは限らず、状態の順序、初期値、入口や出口の条件も、その意味に合わせる必要があります。

    固定点に着くことと、上限で止めることは違う

    同じ関係式をもう一度計算しても値が変わらない状態を、固定点と呼びます。有限のグラフで、状態の変化が定めた順序を保つこと、異なる値がその順序に沿って際限なく続かないこと、適切な初期値と境界条件から始めることが、収束を考えるうえで重要です。順序を保つ性質が「単調性」、順序に沿う変化の段数が有限であることが「有限の高さ」です。[4]

    今回の例は、A〜Eの有限個の名前を、空集合から和集合で増やしていきます。一度得た名前を消さず、追加できる名前も有限なので、ずっと新しい情報が増え続けることはありません。

    けれども、解析を作る側が任意の変換を与えられる以上、フレームワークだけで全ての解析の収束が保証されるわけではありません。例えば、自分へ戻る点で「空なら名前を入れ、入っていれば空にする」と変換すれば、二つの状態を往復します。この非単調な独自例では、反復上限を4にして実行すると、結果を返す代わりに上限超過のエラーになりました。

    OQDの対象版の max_iterations は、既定で1,000,000です。この数はワークリストから点を処理する回数の上限であり、実行時間の保証でも、正しい答えへ近づいた度合いでもありません。上限を超えたときは、単に値を大きくする前に、変換が収束する設計か、初期値や合流の意味が合っているかを確認する必要があります。[1]

    この実装を読むときは、「何を知りたいか」「どちら向きに情報を伝えるか」「合流で何を残すか」「なぜ変化が止まるか」を一組で見ると、ワークリストの役割がはっきりします。待ち行列は調べ直す順番を管理しますが、何を答えとするかは、解析の設計に残されています。

    参考資料

    1. Open Quantum Design — dataflow.py(対象コミットの実装)。グラフの契約は同版のinterface.py、順序・合流・等値比較はlattice.pyを参照。
    2. Open Quantum Design — test_dataflow.py。前向き・後向きの到達集合の上流テスト。本文の合流・ループ・上限例は、この保存版に対する独自のソフトウェア検証です。
    3. Open Quantum Design — pyproject.toml。宣言バージョン0.1.0、Alpha分類、Python要件など。コミット日時は2026年10月8日。最新の全機能や実機性能を確認したという意味ではありません。
    4. Cornell University, CS 4120(2023年春)— Iterative solving。固定点、単調性、有限高さと反復解析。講義の上から下へ進む順序と、本文の空集合から増やす例は順序の取り方が異なります。
  • もつれた相手がいる量子操作には、なぜ完全正値性が要るのか

    もつれた相手がいる量子操作には、なぜ完全正値性が要るのか

    ある量子ビットに加える操作が、単独の状態をどれも正しい状態へ変える。それなら、量子計算の途中でも安心して使えるでしょうか。実は、別の量子ビットともつれている場合まで含めると、それだけでは足りません。操作しない相手を含む全体も、有効な量子状態へ移す、という条件が必要になります。

    この条件が完全正値性です。行と列を入れ替える「転置」を例に、単独での正しさと、組み合わせたときの正しさの違いを見ていきます。

    簡単にまとめると?

    • 正値性は、正半定値の入力を正半定値の出力へ移し、負の測定確率を出さない条件です。完全正値性は、触らない相手を含む全体にもこの条件を求めます。
    • 転置は正値でトレースも保ちますが、ベル状態の片側だけへ適用すると負の固有値が現れ、物理的な状態になりません。
    • 量子チャネルの判定では、完全正値性とトレース保存を分けて確認します。Choi行列を使うときは、正規化と部分系の順序もそろえます。

    「正しい状態」を、測定確率から考える

    量子状態は、密度行列という行列で表せます。これは純粋な状態だけでなく、複数の状態が確率的に混ざる場合も扱える表現です。密度行列には、エルミートであること、トレースが1であること、正半定値であること、という条件があります。正半定値とは、すべての固有値が0以上であることです。

    最後の条件には、測定確率を負にしないという意味があります。ある状態ベクトル |v〉 に対応する結果の確率は、密度行列をρとして 〈v|ρ|v〉 で計算できます。もしρに負の固有値があれば、その固有ベクトルを測定の一つの結果に選ぶと、確率が負になります。確率が「−50%」という状態を、測定装置が出力することはできません。

    そこで、正半定値の行列を正半定値の行列へ移す変換を「正値写像」と呼びます。ここでは有限次元で、行列に線形に作用する変換を考えます。また、必ず何らかの出力を返す量子チャネルを扱うため、確率の合計を保つトレース保存も必要です。特定の測定結果だけを選び出す操作は、この後で区別します。

    転置は、単独の入力なら条件を満たす

    転置Tは、行列の行と列を入れ替える操作です。たとえば2行2列なら、右上と左下の成分が入れ替わります。元の行列と転置後の行列は同じ固有値を持ち、対角成分の合計であるトレースも変わりません。そのため密度行列を転置しても、単独で見れば密度行列のままです。

    これは、計算基底の0と1を入れ替える量子ゲートとは別の操作です。「行と列を入れ替える」と「量子ビットの値を反転する」を同じ意味で扱わないことが大切です。

    単独の入力をいくら調べても、この転置は正値性とトレース保存を満たします。問題は、その入力が外部の相手ともつれているときに現れます。

    ベル状態の片側だけを転置すると、何が起きるか

    量子ビットAとBを、ベル状態 |Φ+〉=(|00〉+|11〉)/√2 に準備したと考えます。Aはそのままにして、Bにだけ転置を適用する計算が「部分転置」です。Aを変えない操作をidと書くと、全体の変換は idA⊗TB です。

    基底を |00〉、|01〉、|10〉、|11〉 の順に並べると、計算結果は次の行列になります。全体を転置するのではなく、Bの行と列に相当する添字だけを入れ替えています。

            ⎡ 1  0  0  0 ⎤
    M = 1/2 ⎢ 0  0  1  0 ⎥
            ⎢ 0  1  0  0 ⎥
            ⎣ 0  0  0  1 ⎦

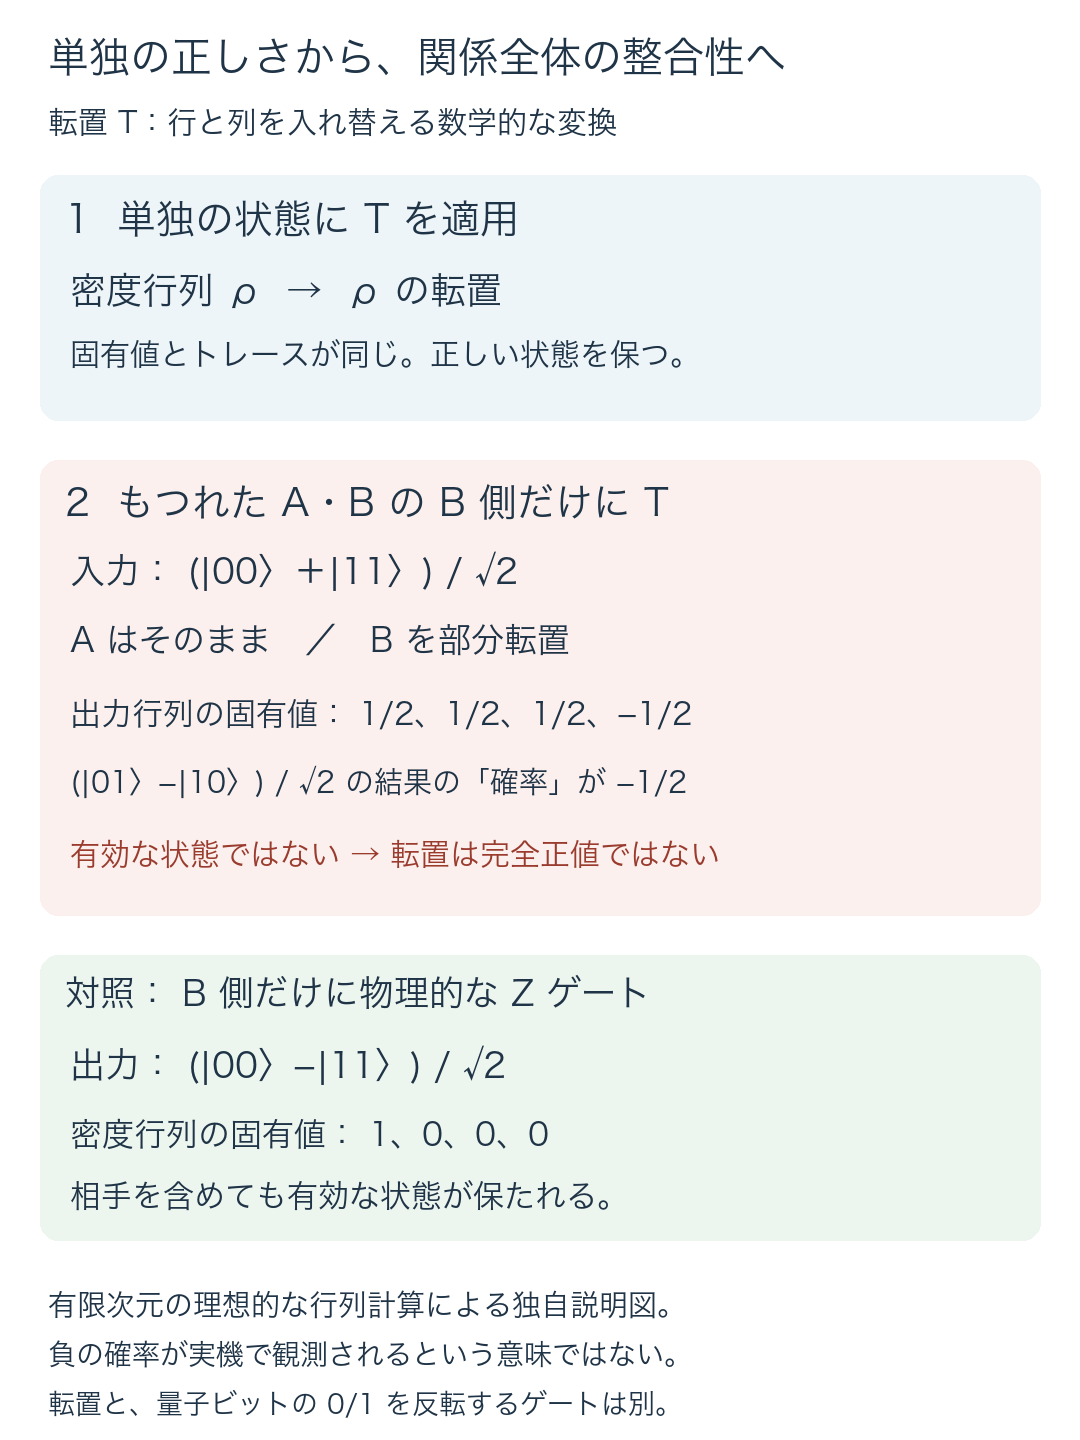
    この行列のトレースは1です。しかし、固有値は 1/2、1/2、1/2、−1/2 になります。負の固有値に対応するのは、|Ψ−〉=(|01〉−|10〉)/√2 です。中央の2行2列が二つの成分を交換するため、符号が逆のこのベクトルには−1/2が掛かります。

    したがって、Mを本当の状態だと仮定すると、〈Ψ−|M|Ψ−〉=−1/2 という測定確率が出てしまいます。これは実験で負の確率が観測されるという話ではありません。転置を、どんな入力にも使える局所的な量子チャネルと仮定したことが破綻する、という反例です。

    単独では正しい状態を保つ転置でも、ベル状態のB側だけに適用すると固有値マイナス2分の1が現れる。対照的にB側のZゲートは正しいベル状態を保つ比較図。
    図1 単独の正値性と、相手を含めた整合性の違い。理想的な行列計算から作成した説明図で、実機の動作図や測定結果ではありません。画像を開くと原寸で確認できます。

    完全正値性は、触らない相手まで含めた条件

    完全正値性では、操作Φだけでなく、任意の有限次元の補助系に何もしない操作idを組み合わせた Φ⊗id も正値であることを求めます。補助系は新しく付け足した測定器に限りません。計算の別のレジスターや、離れた場所にあるもつれの相手も、この考え方で扱えます。完全正値性は、もつれや相関そのものを保存する条件ではなく、出力全体が有効な状態となるための条件です。どちらを左側に書くかは、部分系の並べ方の約束です。[1]

    相手と独立した入力だけでは、この問題は見えません。たとえばρA⊗ρBのB側を転置すると、ρA⊗ρBTとなり、正しい状態にとどまります。積状態を確率的に混ぜた入力でも同様です。今回のベル状態は、そのような混合では表せないもつれを持つため、単独の検査で見逃す矛盾を明らかにできます。

    比較として、B側だけにZゲートを加えてみます。Zは |0〉 をそのままにし、|1〉 の符号を反転するゲートです。全体は (|00〉−|11〉)/√2 という別のベル状態になり、その密度行列の固有値は1、0、0、0です。操作しないAと組み合わせても、有効な状態のままです。転置の反例は、局所操作そのものや、もつれの存在を禁止しているのではありません。

    Choi行列では、正規化と保存条件を分けて読む

    任意の相手を含めると聞くと、無数の入力を試す必要がありそうです。有限次元の線形写像では、Choi(チョイ)行列という一つの行列の正半定値性から、完全正値性を判定できます。入力と同じ次元の参照系との最大もつれを使い、その片側へ写像を作用させたものに対応します。これは数理的な特徴付けであり、一度の実験から未知の装置が完全正値だと証明できる、という意味ではありません。[1]

    ここで注意したいのが、もつれたベクトルを正規化するかどうかです。入力次元をdとし、正規化しない |Ω〉=Σi|i〉|i〉 を使う規約では、Choi行列を J=(Φ⊗id)(|Ω〉〈Ω|) と定義します。出力系を部分トレースした結果が入力系の単位行列Iなら、写像はトレース保存です。そのときJ全体のトレースはdで、1ではありません。

    一方、|Ω〉/√d から作る行列はJ/dです。トレース保存の条件も、出力系を部分トレースした結果がI/dへ変わります。正の定数倍なので完全正値性の判定は変わりませんが、トレース保存を確認する右辺は変わります。2次元なら「Iと比較するか、I/2と比較するか」の差です。

    QuTiPの固定版実装では、iscp がChoi行列のエルミート性と、許容誤差を含む固有値を調べ、istp が部分トレースを単位行列と比べます。行列を手作業で渡すときは、数値だけでなく正規化・入力出力の順序・次元情報をその実装の規約に合わせる必要があります。ここで扱う転置自体はトレース保存です。正規化したベル状態由来の行列を、正規化しないChoi行列の条件へそのまま代入した結果で、その性質を判断してはいけません。[2][3]

    量子操作のモデルを比べるときに確かめたいこと

    ある変換を、入力を限定せず使える量子チャネルとして採用するなら、単独の状態を保つことに加え、完全正値性とトレース保存の両方を確認します。前者はもつれた相手を含む確率の整合性、後者は結果を選別しない操作で確率の合計を保つ条件です。

    測定の特定結果が出た場合だけを取り出す操作では、トレースがその結果の確率になり、1より小さくなることがあります。このような条件付きの枝を、トレースが減るからという理由だけで不正と決めることもできません。チャネル全体を検査しているのか、測定結果の一つを扱っているのかを先に区別します。

    今回の反例は、有限次元の理想的な行列によるものです。ノイズの推定精度や装置の性能を測ったものではなく、非CPの式があらゆる計算で無意味だと言っているわけでもありません。部分転置は、状態の性質を調べる数学的な手段として使えます。ただし、それを入力一般に実行できる装置の操作と同一視しないことが必要です。「単独で成り立つ」と「相手との関係を含めて成り立つ」を分けると、完全正値性が何を守っているのかが見えてきます。

    出典

    1. John Watrous, Theory of Quantum Information, Lecture 5(2011年9月27日更新)。§5.2.2、§5.3、定理5.3・5.4、系5.5。完全正値性、Choi行列、トレース保存の定義と条件。
    2. QuTiP 5.1 User Guide: Properties of Quantum Maps。量子写像と転置の例。保存した版の正規化されたベル状態の例と、固定実装のChoi規約を区別して参照。
    3. QuTiP 5.1.1 qobj.py。iscp、istp、iscptp。固定コミット 7accc77a70a08f965a29fdd13515f79cdcab9703 の実装を参照。