投稿者: SB-admin

  • QUICのストリーム、パケット欠落による待ちを分ける仕組み

    QUICのストリーム、パケット欠落による待ちを分ける仕組み

    Webページを開くとき、文章、画像、スクリプトなど、いくつものデータが並行して届きます。その途中で通信の小さなまとまりであるパケットが一つ失われたら、関係のない画像まで待つのでしょうか。この「どこまで待ちが広がるか」を変えるのが、HTTP/3の土台となるQUICのストリームです。

    QUICは、一つの接続の中に複数のデータの流れを作り、それぞれで順序を管理します。ある流れの欠落を埋めている間も、別の流れでは届いたデータをアプリケーションへ渡せます。ただし、回線の混雑やアプリケーション側の依存関係まで消えるわけではありません。RFC 9000のQUIC v1とHTTP/3の仕様から、分けられる待ちと、なお共有する制約を見ていきます。[1][2]

    簡単にまとめると?

    • QUICはストリームごとにデータの位置を管理するため、一つのストリームの欠落が、別のストリームの順序待ちに直結しません。
    • 同じストリームの中では、欠けた手前のデータを待つ場面が残ります。再送するのは必要な情報であり、失われたパケット全体をそのまま送り直す仕組みではありません。
    • 輻輳制御や接続全体の受信枠は共有します。HTTP/3でもヘッダー圧縮の依存はあり、「パケットが落ちても常に速い」とは言えません。

    HTTP/2では、分かれた要求も一つのTCPの順番に並ぶ

    HTTP/2は、画像Aの応答を全部送り終えてから画像Bへ進むのではなく、複数の要求・応答のデータを一つの接続に交ぜて送れます。これを多重化と呼びます。ただし、その下で使うTCPから見えるのは、一続きのバイト列です。HTTP/2のどの要求に属するかは、TCPの再送処理には見えません。[2][3]

    途中のデータが抜けると、TCPはその穴より後ろのデータを順序通りに渡すために待ちます。後ろに別の要求のデータが届いていても、同じTCP接続上では一緒に足止めされることがあります。これが、転送層でのhead-of-line blocking(先頭の欠落による後続の待ち)です。HTTP/2に多重化がないのではなく、TCPの順序保証が要求の境界を区別しない点が問題になります。

    QUICは「どの流れの、何バイト目か」を別々に管理する

    QUICのストリームは、順序のあるバイト列です。QUICはUDPの上で動きますが、ストリームのデータを単に送り放しにするわけではありません。ストリームIDで流れを識別し、オフセットで、その流れの先頭から何バイト目のデータかを表します。受信側はこの二つを使い、各ストリームのデータを並べ直します。[1]

    HTTP/3では、通常の一組の要求と応答に、クライアントが開始する双方向のQUICストリームを一つ使います。複数の要求を別々のストリームに載せることで、一方の順序待ちをもう一方へ広げずに済みます。ただし、異なるストリーム同士のデータが届く順番は保証されません。処理Bを必ず処理Aの後に行いたい場合は、その依存をアプリケーションが扱う必要があります。[2]

    次の表は、ストリームAとBを同じ接続で受信する仮定の例です。接続とストリームは利用可能で、ここでは受信データを順序通りに渡します。説明のため、Aの最初の1,000バイトだけが失われたとします。

    二つのストリームで異なる待ちが生じる例。数値と到着順は仕様の説明用に設定したもので、実測やHTTP/3メッセージの再現ではありません。
    順番 送受信の出来事 アプリケーションへ渡せるデータ
    1 Aのオフセット0、長さ1,000バイトを含むパケットが失われる Aの0〜999バイトがまだ届かない
    2 Bのオフセット0、長さ1,000バイトが届く Bの0〜999バイトは渡せる。Aの穴埋めを待たない
    3 Aのオフセット1,000、長さ1,000バイトが届く Aの1,000〜1,999バイトは保持し、手前の到着を待つ
    4 Aのオフセット0、長さ1,000バイトが新しいパケットで再び届く Aの0〜1,999バイトがつながり、順序通りに渡せる

    違いは、Aの欠落そのものが消えたことではありません。Aには待ちが残り、Bには同じ待ちを負わせずに済むことです。逆に、AとBのデータを同じパケットへまとめ、そのパケットが失われれば、両方のデータが欠けます。ストリームは別の物理回線ではなく、一つの接続の中で順序を分ける単位です。[1]

    パケットの再送と、データの再送を区別する

    QUICのパケットには、データや制御情報を表すフレームが入ります。ストリームのデータはSTREAMフレームで運ばれ、一つのパケットに複数のフレームを入れることもできます。

    失われたパケットを、QUICが丸ごと同じ形で送り直すわけではありません。必要な情報を新しいフレームに載せ、新しいパケットとして送ります。ストリームがリセットされていなければ、欠けたストリームデータもこの方法で再送されます。受信側にとって大切なのは、「前と同じパケットが戻ったか」ではなく、「そのストリームの必要な位置にデータがそろったか」です。[1]

    このため、パケットの区切りと、アプリケーションが読むデータの区切りを同一視できません。STREAMフレームの境界は、送信、再送、受信側への引き渡しを通して保たれる保証がありません。アプリケーションのメッセージの区切りは、その上のプロトコルで定めます。

    別ストリームでも残る、三つの待ち

    一つ目は、ネットワークの混雑に応じた送信量の調整です。 輻輳制御はストリームごとに独立した送信枠を与える仕組みではありません。通常の同じ経路を使う接続では、各ストリームのデータが同じ制約を受けます。RFC 9002は経路ごとに輻輳制御を行い、損失などを受けて送信量を抑える方法を示しています。Bがすでに受信したデータを渡せることと、Bの次のデータをすぐ送れることは別です。[4]

    二つ目は、受信側が許可するデータ量です。 これは回線の混雑を扱う輻輳制御とは目的が異なり、受信側のバッファーをあふれさせないためのフロー制御です。QUICにはストリーム単位の上限と、接続全体の上限があります。Aだけがストリーム上限に達しても、Bに余裕があり接続全体の枠も残っていれば、Bは新しいデータを送れます。一方、接続全体の枠を使い切ると、別のストリームでも新しいデータを追加できません。[1]

    三つ目は、HTTP/3など上位の処理にある依存です。 HTTP/3のヘッダー圧縮にはQPACKを使います。圧縮されたヘッダーが、別に送られる動的テーブルの更新を参照している場合、その更新を受信・処理するまでメッセージを利用できません。QUICで別々に運べることと、アプリケーションが別々に解釈できることも区別する必要があります。[2]

    比較するときは「何の完了が遅れたか」を見る

    HTTP/2とHTTP/3を比べるなら、平均の転送速度だけでなく、複数の要求のうち、欠落の影響を受けたものと受けなかったものの完了時間を分けると、ストリームの独立性が何に効いたかを考えやすくなります。同じ接続内の話なのか、別接続を並べた結果なのかも確認したい点です。

    例えば、ある画像のデータに欠落が起きても、別の画像を受信して処理できれば、その要求は先へ進めます。しかし、画面表示に必要なスクリプト自体が遅れていたり、ヘッダーの解釈が待ちになっていたりすれば、ページ全体の表示が同じように早まるとは限りません。これは仕様から考えられる条件の整理であり、特定サイトを測定した結果ではありません。

    実際の比較では、同時要求数、データ量、パケット損失や往復時間、サーバー側の処理時間、キャッシュの状態をそろえ、要求ごとの完了時間とページ全体の指標を分けて記録する必要があります。QUICの強みを捉える手がかりは、「待たなくなる」という一語よりも、あるデータの欠落を、無関係なデータの順序待ちへ広げないという仕組みにあります。

    参考資料

    1. RFC 9000, QUIC: A UDP-Based Multiplexed and Secure Transport(2021年5月)。2節・2.2節(ストリームと順序)、4.1節(フロー制御)、12.4節(フレーム)、13.3節(情報の再送)、19.8節(STREAMフレーム)。
    2. RFC 9114, HTTP/3(2022年6月)。1.1〜1.2節(TCPとの違い)、2節・4.1節・6.1節(要求とストリーム)、4.1節・4.2.1節(QPACKによる依存)。
    3. RFC 9113, HTTP/2(2022年6月)。1節(多重化と残るTCPのhead-of-line blocking)。
    4. RFC 9002, QUIC Loss Detection and Congestion Control(2021年5月)。7節(経路ごとの輻輳制御と送信制約)。
  • Fock打ち切り、量子シミュレーションで残す状態数をどう決めるか

    Fock打ち切り、量子シミュレーションで残す状態数をどう決めるか

    量子の振動を計算するとき、「何回測るか」の前に、計算の中へ何段の状態を用意するかを決めることがあります。その数が足りなければ、測定回数を増やしても、計算から抜け落ちた状態は戻りません。

    Open Quantum Design(OQD)の公開エミュレーターには、モードの状態数を指定するfock_cutoffがあります。Fock(フォック)打ち切りとは何を切り、結果をどう変えるのか。固定版のOQDと、その依存先であるQuTiP 5.1.1の実装を読み、小さな独立計算で確かめます。[1][2]

    簡単にまとめると?

    • 保持する状態数をNとすると、数えるのは励起数0からN−1までです。Nは測定回数でも、量子ビット数でもありません。
    • 有限の行列では、最上位から一段上へ移る作用が表せません。確率の合計が1でも、十分な計算範囲を確保できたとは限りません。
    • 状態数を増やし、必要な時刻と観測量で結果の変化を比べます。平均値の一致だけを、全分布や実機モデルの正しさへ広げないことが大切です。

    Fock打ち切りは、計算に残す状態の範囲

    光の一つのモードなどを、量子調和振動子として扱うモデルを考えます。モードは、ここでは独立した一つの振動の自由度です。その励起が0個、1個、2個……と決まった状態をFock状態と呼びます。理想的な振動子には上限がありませんが、コンピューターでは有限の状態数に区切って表す必要があります。

    QuTiPのdestroy(N)やcreate(N)は、N個の状態を持つ行列を作ります。通常の下限0の設定なら、N=4で残るのは0、1、2、3の4状態です。「励起数4まで含む」という意味ではありません。生成演算子は励起を一つ増やす作用、消滅演算子は一つ減らす作用を表します。[2][4]

    確認したOQDの実装は、量子ビットに2次元、モードにfock_cutoff次元を割り当て、それらを組み合わせて初期状態を作ります。モードの生成・消滅演算子も、同じ値をQuTiPへ渡して構成します。引数クラスの既定値は4ですが、これはコードの初期設定であり、どの問題でも4状態で十分という推奨値ではありません。[1]

    行列の最上位には、本来ない境界ができる

    無限に状態を持つ振動子なら、励起数3の状態へ生成演算子を作用させると、励起数4の状態へ進みます。ところがN=4の行列には、その行き先がありません。最上位の3へ同じ作用を与えた結果は、ゼロベクトルになります。これは「真空の状態0に戻る」という意味でも、実物がそれ以上励起されないという意味でもなく、有限の表現に行き先がないということです。

    この違いは、上げる作用と下げる作用を順に行った結果にも現れます。無限系では、その順序を入れ替えた差[a, a†]は単位行列です。一方、N状態へ切った行列では、[a_N, a_N†] = I − N|N−1⟩⟨N−1|となります。ここでIは状態を変えない単位行列、最後の項は最上位の状態だけに作用する項です。N=4なら対角成分は1、1、1、−3となり、境界だけが変わります。これは固定実装の行列から求めた関係です。[2]

    計算した状態が上の方まで広がると、この境界が時間変化へ影響し得ます。そのため、出力が滑らかに見えることや、確率の合計が1であることだけでは、打ち切りが十分かを判断できません。

    確率の合計が1でも、平均値は変わる

    具体例として、最初は励起数0の真空状態を用意し、励起を増減させる一定の駆動を加えます。時間と駆動の強さをまとめた無次元の量をτとし、ħ=1、時間発展を定める行列をH_N=i(a_N†−a_N)と置きます。τは説明用に規格化した時間であり、秒や実機のパルス条件ではありません。この例には環境による減衰を入れていません。

    状態数を制限しない同じモデルでは、τのときに実数振幅α=τのコヒーレント状態となり、平均励起数はτ²です。そこでτ=2、平均励起数4となる場合を、有限の行列で比較しました。有限側は行列の指数関数から状態を計算し、別に組んだ級数計算でも照合しています。OQDやQuTiP本体の実行結果ではなく、公開実装の行列定義に基づく独立した数学的検算です。[2][3]

    保持状態数を増やした比較。τ=2、無限系の平均励起数4を基準とした独立計算。数値は丸めて表示。
    保持する状態数N 励起数の範囲 平均励起数 4との差の絶対値 確率の合計
    4 0〜3 2.563436 約1.44 1.000000
    8 0〜7 3.921905 約0.0781 1.000000
    12 0〜11 3.998949 約0.00105 1.000000
    20 0〜19 4.000000 約8.79×10⁻⁹ 1.000000

    狭い画面では表を横にスクロールできます。N=4では、そもそも励起数3までしか残していないので、平均4を表すことはできません。Nを増やすと、この例では平均値が無限系の値に近づきます。しかし、すべての行で確率の合計は同じように1です。有限行列の時間発展自体は正規化を保つため、抜け落ちた状態の影響は「確率の合計が減る」という形では現れません。

    QuTiPのコヒーレント状態を作る実装も、二つの作り方を区別しています。有限空間の変位演算子で作るoperator方式は正規化を保ちます。一方、無限系の解析式から係数を取り出すanalytic方式では、少ない状態で切ると確率の合計が1にならない場合があります。後者の不足分と、前者の正規化済みの状態のずれを混同しないことが重要です。[3]

    状態数を増やす前後で、何を比べるか

    実際に計算範囲を選ぶときは、最初に必要な観測量と許容する変化の大きさを決めます。平均励起数が必要なら、同じモデル、初期状態、駆動、時刻の範囲を保ち、Nを増やしたときの平均値を比較します。分布そのものが必要なら、各状態の確率も比べます。平均値が合うだけでは、分布全体が合っているとは言えません。

    また、最後の時刻だけでなく、途中の時間変化も確認します。最上位付近の状態に確率が集まっていないかは、境界の影響を疑う手掛かりになります。ただし、その確率が小さいという一つの条件だけで、すべての観測量の誤差を保証できるわけではありません。表のN=20も、このモデルと時刻での結果であり、別の駆動や長い時間に通用する万能の設定ではありません。

    状態数を増やすと、計算で扱う量も増えます。OQDの固定実装ではモードの状態空間を組み合わせるため、量子ビットを含まない2モードならN=4で16次元、N=8で64次元です。これは状態空間の大きさの比較であり、実行時間やメモリー消費が必ず4倍になるという測定結果ではありません。[1]

    測定回数や物理モデルの確認とは分ける

    ショット数は、同じ計算上の確率から何回の模擬測定結果を取り出すかに関わります。Fock打ち切りは、その確率を作る状態空間の範囲に関わります。さらに、環境との相互作用をモデルに入れるか、数値計算の精度をどう設定するかも別の問題です。どれか一つを細かくしても、ほかの不足が自動的に解消するわけではありません。

    今回確認したのは、OQDの固定版が有限次元をどう渡すかと、その行列に生じる境界の一例です。必要な状態数が確保できたとしても、採用した物理モデルが実際の装置に合うかは別途確かめます。まず状態数を変えた比較で数値表現の範囲を点検し、そのうえで標本のばらつきや物理的な仮定を評価する。この順に分けると、計算の何を改善すべきかが見えやすくなります。

    参考資料

    OQDは固定コミット6a086a9843b91d041e76fbd4fed83c5384a14e6e、QuTiPコードは依存版5.1.1の固定コミット7accc77a70a08f965a29fdd13515f79cdcab9703を確認しました。最新版一般の性能を示すものではありません。表と境界式はQuantum Seaによる独立計算です。

    1. Open Quantum Design, oqd-analog-emulator conversion.py、interface.py、pyproject.toml。モード次元、演算子生成、既定値と依存版。
    2. QuTiP, operators.py。destroy、create、displaceの有限行列定義。
    3. QuTiP, states.py。coherent関数のoperator/analytic方式、Fock基底の係数。
    4. QuTiP 5.1 Documentation, Manipulating States and Operators。Fock状態、生成・消滅演算子と数演算子の説明。
  • RISC-Vベクトル拡張、処理する要素数をCPUに合わせる仕組み

    RISC-Vベクトル拡張、処理する要素数をCPUに合わせる仕組み

    配列に並んだ数値を足す、画像の画素を加工する。こうした処理では、一つの命令で複数の値を扱うベクトル演算が役立ちます。ただ、CPUによって一度に扱えるデータの幅が違うと、プログラムは何個ずつ進めればよいのでしょうか。

    RISC-Vのベクトル拡張(RVV)は、処理したい個数を伝え、今回扱う個数をCPUから受け取る仕組みを備えています。レジスタの長さを表すVLENと、今回の処理数を表すvlを分けると、異なる幅のCPUで同じループを動かせる理由が見えてきます。ここでは、公式マニュアル20260120版に収録されたV拡張Version 1.0をもとに整理します。[1]

    簡単にまとめると?

    • VLENはレジスタ1本のビット数、SEWは要素1個のビット数、LMULはレジスタをどうまとめて使うかの設定です。処理できる最大の要素数は、この組み合わせで決まります。
    • ループはCPUが返したvl個だけ処理し、その分だけ配列の位置と残り個数を進めます。幅の違いや最後の端数を、同じ仕組みで扱えます。
    • 大きなレジスタや大きなLMULが、そのまま高速化の倍率になるわけではありません。対応命令、実行器、メモリ供給も確かめる必要があります。

    VLEN・SEW・LMULは、何の大きさなのか

    まず、レジスタはCPUが計算に使う値を置く場所です。RVVには32本のベクトルレジスタがあり、1本の長さをビット数で表したものがVLENです。これはCPUの実装で決まり、vsetvli命令で伸び縮みするものではありません。[1]

    その入れ物をどの幅の値に区切るかが、SEW(Selected Element Width、選択する要素幅)です。たとえば128ビットのレジスタを32ビットの整数に区切れば4個、64ビットなら2個が入ります。同じ入れ物でも、要素の大きさが変われば個数は変わります。

    LMUL(ベクトル長乗数)は、1回の命令で使うレジスタのまとまり方を決めます。LMUL=2なら、通常の同じ幅の演算では2本を一組として扱います。整数の設定は1、2、4、8で、対応条件のもとでは1/2などの分数設定も使えます。[1]

    この組み合わせから求まる最大要素数がVLMAXです。式はVLMAX = LMUL × VLEN ÷ SEW。ビット数ではなく、何個の要素を扱えるかを表します。

    要素幅とレジスタのまとめ方で変わる最大要素数(仕様の式から作成)
    VLEN SEW LMUL VLMAX 読み方
    128ビット 32ビット 1 4個 1本に32ビットの値が4個
    256ビット 32ビット 1 8個 1本が長くなり、8個入る
    128ビット 32ビット 2 8個 2本をまとめ、8個入る
    128ビット 64ビット 1 2個 要素が大きくなり、2個入る

    表の値は、各設定に対応する実装を想定した計算例です。どれも実機の速度測定ではありません。また、256ビットの1本と128ビットの2本は、容量が同じでも、内部で同じように実行されるとは限りません。

    最大容量と、今回扱う個数は別に決まる

    配列に残っている個数など、ソフトウェアが処理したい数をAVL(Application Vector Length)として渡すと、CPUは現在の設定に合わせたvlを返します。ここでのvlは、マスクで要素を除外しない通常のループで、今回処理する個数です。[1]

    たとえばVLMAX=4のとき、残りが3個ならvl=3です。最大4個入るからといって、配列の外まで4個分を処理する必要はありません。

    ただし、vlは常に「残り個数と最大容量の小さい方」になるとは限りません。ここでは基本のV拡張における、通常の要素単位の演算を対象にします。その場合、仕様は次のように選び方を定めています。

    • AVL ≤ VLMAXなら、vl = AVL。
    • AVL ≥ 2 × VLMAXなら、vl = VLMAX。
    • その中間では、AVL ÷ 2を切り上げた値からVLMAXまでの範囲で選べます。

    したがって、最大4個で残り6個なら、最初に4個、次に2個でも、3個ずつ2回でも仕様に適合します。同じ実装で同じAVLとVLMAXを与えたときの結果は決定的ですが、別の実装でも同じ分け方になるとは限りません。プログラムが使うべきなのは、推測した個数ではなく実際に返されたvlです。[1]

    vsetvliで受け取り、その分だけループを進める

    配列を一度に扱える分ずつ切り分ける方法を、ストリップマイニングと呼びます。RVVでは、このループをvsetvli命令で組み立てられます。設定を命令の中に書くvsetvliに対し、vsetvlは要素幅などの設定値を別のレジスタから受け取る命令です。名前は似ていますが、設定の渡し方が違います。[1]

    32ビットの整数配列二つを足す場合、設定命令は次のように書けます。a0に残りの要素数を入れ、返されたvlをt0で受け取ります。

    vsetvli t0, a0, e32, m1, ta, ma

    e32はSEW=32、m1はLMUL=1です。taとmaは、今回の処理対象外となる末尾の要素やマスクで除外した要素の、レジスタ内の値を保持する必要がないことを示します。対象外の値がゼロになるという約束ではありません。この例はマスクを使わず、対象のvl個だけを読み書きします。

    処理全体を、説明用の擬似コードで表すと次のようになります。これは公式の32ビット整数加算例を参考にした手順の説明で、コンパイルできる言語のコードではありません。[2]

    残り個数 = 配列の要素数
    位置 = 0
    残り個数が 0 より大きい間、繰り返す:
        vsetvli で残り個数と e32, m1, ta, ma を渡し、vl を受け取る
        位置から vl 個を読み、対応する要素同士を足して保存する
        位置 = 位置 + vl
        残り個数 = 残り個数 - vl

    実際のメモリアドレスを進めるときは、要素数からバイト数への換算も必要です。32ビットの要素なら1個4バイトなので、入力・出力のアドレスをそれぞれ4 × vlバイト進めます。公式例も、返された個数を残りから引き、バイト数へ換算してポインタを更新しています。

    同じ16個の配列を扱うなら、SEW=32、LMUL=1のもとで、VLEN=128では4個ずつ4回、VLEN=256では8個ずつ2回になります。この場合の回数は、先ほどの仕様の制約から決まります。ソフトウェアが「このCPUは4個ずつ」と埋め込まなくても、同じ手順で全要素を処理できます。

    固定幅SIMDとの違いと、速さを判断する際の注意

    固定幅SIMDでは、たとえば128ビットを扱う命令なら、32ビットの値を4個まとめて扱う、というように命令の幅が基準になります。端数への対応には、命令セットに応じてマスクや別の処理を使います。

    RVVでは、残り個数を渡して処理数を受け取るため、ループを特定のVLENに依存させずに書けます。これがベクトル長に依存しない、vector-length agnosticなコードの考え方です。ただし、必要な要素型と命令を両方のCPUがサポートし、コードも幅を決め打ちしないなどの条件があります。RISC-VのCPUすべてにV拡張が備わる、あるいはどんなベクトルコードでもそのまま移せる、という意味ではありません。[1]

    また、LMULを大きくすると、より多くの要素を一つの命令の対象にできますが、使うレジスタの本数も増えます。32本を8本ずつまとめれば、独立したまとまりは4組です。複数の途中結果を同時に持ちたい処理では、この使い方が制約になります。さらに、命令が対象とする要素を内部の実行器が何サイクルで処理するか、メモリから十分にデータを供給できるかは、最大要素数だけではわかりません。

    CPUやコンパイラの説明を読むときは、まず対応する拡張・要素幅を確認し、次にVLENと実行性能の測定結果を分けて見ます。自分の処理で速さを比べるなら、要素型、配列の長さ、LMUL、メモリ条件をそろえた測定が必要です。本稿の個数とループ回数は仕様からの計算例であり、実行時間の測定値ではありません。

    出典

    1. RISC-V International, The RISC-V Instruction Set Manual, 20260120版、30.1. “V” Standard Extension for Vector Operations, Version 1.0。実装定数、レジスタモデル、SEW・LMUL、vl設定制約、ストリップマイニング。補助照合:固定commitの仕様ソース。
    2. RISC-V International, Vector-vector add example(vvaddint32.s)。上記固定commitの32ビット整数加算例。原資料の利用条件はCC BY 4.0。本文の擬似コードは同例を参考に、変数名・表現を説明用に改めたものです。
  • Lindblad方程式で量子ビットの緩和を読む、確率と位相の違い

    Lindblad方程式で量子ビットの緩和を読む、確率と位相の違い

    量子ビットを0と1で測ると、どちらも半分ずつ出る。しばらく待っても、その割合は変わらない。それだけで、量子状態が保たれていると言えるでしょうか。0と1の重ね合わせでは、結果の割合に加えて、二つの成分の位相の関係も大切です。

    Open Quantum Design(OQD)の公開エミュレーターを調べると、確認した版はQuTiPのsesolveで状態を時間発展させています。そこには、環境による緩和を指定する入力はありません。本稿ではその境界を出発点に、QuTiPが別に備えるLindblad(リンドブラッド)方程式の機能から、モデルに何を加えると何が変わるのかを見ます。OQD自体がこの機能を実装しているという説明ではありません。[1]

    簡単にまとめると?

    • エネルギー緩和と位相の乱れは別の変化です。0・1の割合だけを見ても、重ね合わせの変化を捉えきれません。
    • Lindblad方程式では、ハミルトニアンに加えて、環境から受ける作用とその速さを指定します。
    • 計算できたことと実機を再現できたことは別です。作用の種類、速度の単位、近似の適用条件を確認します。

    閉じた系の計算には、指定していない緩和は現れない

    ハミルトニアンは、量子状態が時間とともにどう変わるかを定めるものです。外部環境とのやり取りを含めずに扱う「閉じた系」では、状態の変化をユニタリーな時間発展として計算します。位相が回転したり、駆動によって0と1の割合が変わったりしても、それ自体が環境による緩和ではありません。[2]

    一方、対象の量子ビットが周囲へエネルギーを失ったり、周囲の影響で位相の関係が乱れたりするなら、その作用をモデルに加える必要があります。Lindblad方程式は、そのような「開いた系」を扱う代表的な形です。状態を密度行列で表し、ハミルトニアンによる変化と、環境による変化を合わせます。[2]

    密度行列は、結果の割合と重ね合わせの関係をまとめた表と考えると読みやすくなります。対角の成分は0・1それぞれの確率、対角でない成分は両者のコヒーレンスを表します。以下では、その非対角成分の大きさを比べます。位相が回転することと、その大きさが減ることは分けて扱います。

    同じ重ね合わせを、三つのモデルで待たせる

    説明用に、0と1を同じ重みで重ねた状態を用意します。最初は1の確率が0.5、コヒーレンスの大きさも0.5です。0を基底状態、1を励起状態とし、0・1を入れ替える外部の駆動は加えません。0と1のエネルギー差は一定とし、その差による位相回転の速さには依らない、非対角成分の大きさを比較します。

    比べるのは、環境の作用なし、1から0へ戻るエネルギー緩和のみ、そして0・1の確率を変えない純粋位相緩和のみ、の三通りです。ここでTは説明用の時間尺度であり、実機の寿命ではありません。後二つのモデルでは、それぞれの速度を1/Tと置きます。Lindbladの散逸項から得た式を、独立に作成した2行2列の行列計算とも照合しました。[4]

    表1 同じ初期状態を時間Tだけ変化させた説明用の計算。Quantum Sea作成。
    モデル 1になる確率 コヒーレンスの大きさ
    環境の作用なし 0.500 0.500
    1から0へのエネルギー緩和のみ 約0.184 約0.303
    純粋位相緩和のみ 0.500 約0.184

    狭い画面では表を横にスクロールできます。QuTiPや量子装置を実行した性能評価ではなく、指定した方程式の独立検算です。

    エネルギー緩和の行では、1の確率は0.5×exp(−t/T)、コヒーレンスの大きさは0.5×exp(−t/2T)で減ります。純粋位相緩和の行では、1の確率は0.5のまま、コヒーレンスだけが0.5×exp(−t/T)で減ります。

    この違いが、何を調べるべきかを変えます。0・1の割合が同じでも、純粋位相緩和がないとは言えません。逆に、1の割合が減るデータを、確率を変えない純粋位相緩和だけで説明することもできません。0・1とは異なる重ね合わせの基底(X、Y)でも測定すると、非対角成分の実部・虚部を調べられます。実機と照合するときは、割合とコヒーレンスに関わる情報を区別し、どの作用を仮定したモデルなのかを揃えます。

    c_opsには、速さだけでなく「何を変えるか」を渡す

    QuTiPのmesolveでは、環境の作用をc_opsという引数へ渡します。各要素はcollapse operatorと呼ばれ、作用を表す演算子に、速度の平方根を掛けたものです。この名前は、途中測定の結果を乱数で一つ選ぶ処理そのものを意味しません。ここでは密度行列の平均的な変化を計算します。[2][3]

    先ほどのエネルギー緩和は、1を0へ移す演算子に√γを掛けます。γは緩和の速度です。純粋位相緩和では、0と1の成分へそれぞれ+1と−1を掛ける演算子Zを使います。これに√(γφ/2)を掛けると、非対角成分の大きさが速度γφで減ります。平方根や2分の1は単なる書き方の違いではなく、計算される減衰速度を変える係数です。[4]

    時間を秒で表すならγとγφは毎秒の単位、たとえばs−1で揃えます。ハミルトニアンも、ℏを1とする表記なら角周波数の単位で揃えます。表のTを特定装置の測定値へ置き換えるには、その装置と条件に対応した速度を別に確かめる必要があります。

    エネルギー緩和だけでも、確率とコヒーレンスの減る速さは異なります。この例で、励起確率の減衰時間をT1と呼べばT1=1/γ、コヒーレンスの減衰時間T2は2/γです。純粋位相緩和も同時に加えると、1/T2=γ/2+γφになります。T1とT2を同じ値だと置く前に、何が減る時間を測ったのかを確認したいところです。これは今の二準位モデルから得た関係で、すべての装置への無条件な当てはめではありません。

    ソルバーの名前より、入力と近似を確かめる

    確認対象はQuTiP 5.1の公式文書と、対応する5.1.1の固定コードです。最新版を評価した記事ではありません。固定実装では、c_opsが空、初期状態が状態ベクトル、ハミルトニアンがsuperoperatorではない、という条件がそろうと、mesolveからsesolveへ処理を渡します。初期状態が密度行列なら、環境の作用が空でも密度行列側の計算経路を使います。関数名だけで「緩和を含めた」とは判断できません。[3]

    さらに、Lindblad形で数値が出ることと、現実の環境にその近似が合うことは別です。公式解説は、初期に系と環境の相関を置かないこと、系と環境の弱い結合を扱うBorn近似、環境の記憶が対象の変化より短いMarkov近似、速く振動する項を除く近似などを説明しています。強い結合や長い記憶を持つ環境へ、同じ単純なモデルをそのまま広げることはできません。[2]

    まず知りたいのは、結果の割合が変わるのか、位相の関係が失われるのか。その問いに合わせて作用と速度を指定し、適用条件を確かめる。そうして初めて、理想的な時間発展と、環境を含む計算の違いが、量子ビットを扱う判断材料になります。

    参考資料

    資料は2026年10月14日に確認。OQDは固定commit 6a086a9843b91d041e76fbd4fed83c5384a14e6e、QuTiPはタグv5.1.1に対応する固定commit 7accc77a70a08f965a29fdd13515f79cdcab9703を参照しています。本文の表と数値はQuantum Seaによる説明用の独立計算です。

    1. Open Quantum Design, oqd-analog-emulator。conversion.pyのQutipOperation処理、interface.py、pyproject.toml。OQDの時間発展処理とQuTiP 5.1.1への依存を参照。固定版の時間発展処理/依存版の指定。
    2. QuTiP 5.1 Documentation「Lindblad Master Equation Solver」。Unitary evolution、Non-unitary evolution、The Lindblad Master equation。状態・環境作用・導出の近似条件を参照。公式解説。
    3. QuTiP 5.1.1、qutip/solver/mesolve.py。c_opsと初期状態による計算経路の分岐。固定版の実装。
    4. QuTiP 5.1.1、qutip/core/superoperator.pyのlindblad_dissipatorとqutip/core/operators.pyのsigmax・sigmay・sigmaz。CρC†−(C†Cρ+ρC†C)/2の形を本稿の2行2列の計算に使用。固定版の散逸項/観測量の演算子/コードの利用条件。
  • QED-Cの量子ベンチマーク、結果の品質と実行時間を同じ条件で比べる

    QED-Cの量子ベンチマーク、結果の品質と実行時間を同じ条件で比べる

    量子コンピューターを選ぶとき、「量子ビットが多い」「計算が速い」という数字だけでは、任せたい計算に向くかは分かりません。同じ問題を解かせたのか、結果はどれくらい理想に近いのか、時間には準備や待ち時間も入っているのか。比較する前に揃えたい条件があります。

    Quantum Economic Development Consortium(QED-C)の研究者らは、用途に近いアルゴリズムを使い、回路の大きさと結果の品質を一緒に見るベンチマークを提案しています。原論文と公開実装から、性能グラフを読むときに何を確かめればよいかをたどります。[1][2]

    簡単にまとめると?

    • 量子ビット数だけでなく、同じ問題・回路の大きさ・結果の品質を揃えて比較します。
    • 「結果の忠実度」は理想的な出力分布との近さを表す指標で、そのまま正解率にはなりません。
    • 回路の変換条件と、どこからどこまでを測った時間なのかを確認してから、用途への適合を判断します。

    答えが分かる小さな計算で、回路を試す

    アルゴリズムの名前が同じでも、入力や問題の大きさが違えば、装置がこなす仕事は変わります。この研究では、問題の大きさごとに回路を選び、入力やパラメーターを変え、結果を集めます。実機が動かせる命令へ変換するコンパイラーも通るので、評価対象にはハードウェアだけでなく、その変換の仕方も含まれます。[1]

    具体例が、量子フーリエ変換(QFT)を使うQFT(1)ベンチマークです。整数を量子ビットに入れ、QFTで別の表現に移し、その表現の中で1を加え、逆QFTで戻します。正しい結果があらかじめ分かるため、得られた出力と比べられます。

    説明用に3量子ビットで考えると、表せる整数は0から7です。入力が3なら結果は4、7なら一周して0になります。この例は原論文の手順を小さい数で確かめたもので、実機の測定結果ではありません。また、答えを確かめやすい回路が動いたことだけで、実務の量子計算まで有利になったとは言えません。論文も、このQFTの入力条件と、一般の用途で必要になる条件を区別しています。[1]

    グラフの位置と色を、一緒に読む

    図1の縦軸は回路が使う量子ビット数、横軸は共通の基準で数え直した回路の深さです。深さは、同時には進められない操作を何段重ねるかに関係します。色は、その位置に集まる回路の「結果の忠実度」の平均です。同じ量子ビット数でも、深い回路まで品質を保てるかを見るための表示になっています。[1]

    三つのアルゴリズム群について、縦軸に回路幅、横軸に回路深さ、色に平均結果忠実度を示すノイズシミュレーターのプロット
    図1 回路の幅・正規化した深さ・結果の忠実度を合わせて示す、ノイズを含むシミュレーターの例。左・中央・右は異なる種類のアルゴリズム群です。灰色の背景は量子ボリュームからの予測であり、各マスの実測値ではありません。Thomas Lubinskiほか「Application-Oriented Performance Benchmarks for Quantum Computing」IEEE Transactions on Quantum Engineering, 4 (2023), 3100332、Fig. 1(出版版p.2)。原論文、CC BY 4.0。出版版PDFから図領域のみ切り出してPNG化。図内の描画・配色・注記は変更していません。 図中の実行日時は2022年10月15日。図は横にスクロールでき、原寸でも開けます。 原寸図を開く。出典[4]

    これはノイズを含むシミュレーターの例です。灰色の背景は、別の総合指標である量子ボリュームから予測した領域で、実行結果を塗った色とは違います。予測と色が合わない場所も、アルゴリズムによって得意・不得意が変わる手掛かりになります。現在の実機の順位表としては読めません。

    横軸にも注意が必要です。論文の「正規化した深さ」は、共通のゲート集合や接続条件へ変換して数えます。一方、実機では量子ビットの接続に制約があり、状態を入れ替える操作などが追加されます。同じ横軸の値でも、実機での操作段数や所要時間が同じとは限りません。変換はコンパイラーの手法にも依存するため、その版や設定を揃える必要があります。[1]

    忠実度0.6を「正解率60%」と読まない

    原論文の指標は、観測した出力分布と理想の分布との近さを求め、一様なランダム出力を基準の0、理想との一致を1とするように尺度を調整します。基準を下回る値は0に丸めます。そのため、表示された値は、単純に正解が出た割合とは異なります。[1]

    たとえば先ほどの3量子ビットのように正解が1種類なら、均等な当てずっぽうで当たる割合は8分の1です。仮に正解が出た割合を60%とすると、この指標は(0.60−0.125)÷(1−0.125)で約0.54になります。これは定義を使った説明用の検算で、装置の性能値ではありません。

    理想の出力自体が一様なら、この尺度の基準を作れません。また、平均値だけでは、特定の入力で悪い結果が出ることを見落とします。論文の付録Bは、指標とアルゴリズムの正解確率が食い違う例を示しています。自分の用途で何を正解とするか、どの入力を含めた平均かを併せて読む必要があります。[1]

    「何秒」の始まりと終わりを揃える

    利用者が結果を得るまでは、回路の作成、実機向けの変換、古典計算とのやり取り、量子回路の実行があります。共有サービスなら、順番待ちも加わります。原論文の時間評価は主に量子回路の実行部分を扱っており、依頼してから結果が戻るまでの全体時間ではありません。提供側APIの時間項目も、範囲が必ずしも同じとは限らないと指摘しています。[1]

    たとえばパラメーターを変えて何度も計算するとき、毎回回路を作って変換し直す方法と、変換済みの回路へ値だけ渡す方法では、準備の負担が変わります。量子回路の実行時間だけが短くても、作業全体が速くなるとは限りません。次の条件を合わせると、比較結果を用途に結び付けやすくなります。

    表1 比較前に揃える条件。原論文を基にQuantum Seaが整理。
    確認するもの 比較で取り違えないために
    問題と入力 同じアルゴリズム、大きさ、回路の選び方と入力条件か
    品質の数え方 何と照合した指標か、何回実行したか、平均の対象やばらつきはどうか
    回路の変換 コンパイラーの版・最適化・接続条件が同じか
    時間の範囲 準備、変換、反復、量子実行、待ち時間のうち何を含むか

    公開コードも、指標の定義と版を確かめる

    QED-Cは実行用のコードを公開しています。ただし、READMEはこれを性能標準ではなく、複数の実行環境で参照用アプリケーションを試すための試作群と位置付けています。確認した固定版のパッケージ表記は2.0.8で、コードのライセンスはApache 2.0です。コードが公開されていること自体は、特定装置で性能を再現できた証拠ではありません。[2]

    実際、この版の指標計算には、測定する量子ビットが16を超える場合、処理の負担を抑えるために一様分布を基準とした再尺度化を省く分岐があります。その場合、同じfidelityという項目名でも、返すのは再尺度化前の分布の近さです。論文の説明とコードの出力を結ぶには、版だけでなく、その条件でどの処理が通るかも必要です。本稿は保存した実装を読んだ範囲であり、このパッケージや実機を実行した評価ではありません。[3]

    自分の仕事に向く量子計算機を探すなら、まず小さい既知の問題で出力を確かめ、回路を大きくしたときの品質と、結果までにかかる時間を追います。そこで得た比較を、別の問題や現在の装置へ広げる前に、入力・指標・変換・時間範囲をもう一度揃える。それが、このベンチマークから得られる実用的な読み方です。

    参考資料

    1. Thomas Lubinskiほか「Application-Oriented Performance Benchmarks for Quantum Computing」。arXiv:2110.03137v3、2023年1月10日投稿版(PDF表紙の日付は1月11日)。本稿は第III節、第V節、付録A・B・CとFig.1を参照。書誌・版/原論文PDF。
    2. QED-C Standards TAC「QC-App-Oriented-Benchmarks」。README、pyproject.toml、LICENSE。2026年10月14日確認。固定版README/版情報/コードの利用条件。
    3. 同リポジトリ qedclib/metrics.py、hellinger_fidelity_with_expected・rescale_fidelity・polarization_fidelity。固定版の指標計算。
    4. 図1の使用版:Thomas Lubinskiほか「Application-Oriented Performance Benchmarks for Quantum Computing」、IEEE Transactions on Quantum Engineering 4 (2023)、論文番号3100332、DOI: 10.1109/TQE.2023.3253761。2023年3月7日公開、出版版の現行版日付は2023年4月19日、全32頁、Fig.1はp.2。出版社DOI/出版社公開PDF/CC BY 4.0。図はこの出版版から採用し、本文の技術説明は参考資料[1]の版を基にしています。

    公開実装の確認コミット:21dfc331ce61a2170b06f88259aa19f901c021bc。本稿の数値例と表はQuantum Seaによる説明用の整理です。

  • Linux PSIで見る処理の待ち、CPU利用率と何が違うのか

    Linux PSIで見る処理の待ち、CPU利用率と何が違うのか

    サーバーのCPU利用率が低いのに、処理が遅い。そんなとき、空いているCPUだけを見ても、仕事が進まない理由はわかりません。処理はCPUの順番を待つこともあれば、メモリを確保するための回収処理や、ストレージとの入出力で足止めされることもあります。

    LinuxのPSI(Pressure Stall Information)は、CPU・メモリ・入出力の資源待ちが、仕事の進行にどれだけ影響しているかを見る仕組みです。CPUを使った時間と、資源が足りず進めなかった時間を並べると、「まだ余裕がある」という判断を一段深く確かめられます。ここではLinux v6.12の公式文書と実装を基に、数値の読み方と監視の注意点を整理します。表示例は説明用に作ったもので、実機の測定結果ではありません。[1][2]

    簡単にまとめると?

    • CPU利用率にPSIを加えると、資源を使った時間と、資源待ちで仕事が進まなかった影響を分けて調べられます。
    • someとfullは待ちの広がりを見る指標ですが、対象範囲が重要です。システム全体のCPUのfull=0を、待ちがない証拠にはできません。
    • 平均値は%、累積値はマイクロ秒です。短い待ちを知らせるトリガーには別の監視窓があり、平均値のしきい値判定と同じものではありません。

    CPUを使った時間と、仕事が待った時間

    CPU利用率は、CPUが何をしていたかを捉える指標です。その基になる/proc/statには、利用者のプログラム、カーネルの処理、アイドルなどに費やしたCPU時間が記録されます。一方、PSIが見るのは、資源の取り合いによって実行の機会が失われる側面です。両者は同じ「負荷」を別名で表示しているわけではありません。[2][3]

    たとえば、処理に必要なデータがストレージから届かなければ、その仕事はCPUを使い続けられません。CPU利用率だけなら余力に見えても、入出力の待ちによって進行が妨げられている可能性があります。逆にCPUがよく使われていても、仕事が順調に進んでいるかは別に確かめる必要があります。

    PSIのシステム全体の情報は、次の三つのファイルに分かれています。

    /proc/pressure/cpu
    /proc/pressure/memory
    /proc/pressure/io

    cpuはCPUの実行機会、memoryはメモリ資源、ioは入出力に関わる待ちを扱います。なお、ファイルが見当たらないことは、待ちがゼロという意味ではありません。カーネルがPSIに対応する設定で構築されているか、有効化されているかを先に確かめます。[1][6]

    someとfullは、対象範囲と一緒に読む

    まず1CPU上の状態で考えると、someは、その資源を待っている仕事が一つ以上ある状態です。ほかの仕事は進めている場合も含みます。fullは、待つ仕事があるうえに、その資源について前進できる仕事が残っていない状態を表します。メモリでは、メモリ回収のために動く処理を、通常の仕事が進んでいる状態と区別しています。[2]

    ここで注意したいのが、複数CPUの集計です。実装はCPUごとの状態を追い、仕事が存在した時間で重みを付けて、全体の圧迫度を近似します。表示されたfullを「サーバーの全CPUが同時に止まった時間」、someを「全スレッドの待ち時間の合計」と読むのは適切ではありません。また、fullの待ちはsomeと重なるため、二つを足して待ちの総量にはできません。[2]

    特にCPUのfullは、システム全体とcgroupで扱いが異なります。cgroupは、関連するプロセスをまとめ、資源の使用量や上限を管理するLinuxの仕組みです。cgroup v2では、対象グループのcpu.pressureなどから、そのグループのPSIを読めます。[1][4]

    Linux v6.12のシステム全体の/proc/pressure/cpuでは、fullは未定義としてゼロが返されます。文書は、Linux 5.13以降に出力されるこの欄を互換性のためゼロにしていると説明しています。このゼロから「すべての仕事が順調だ」とは判断できません。一方、cgroup内では、ほかのグループがCPUを使っていたり、cpu.maxの上限によって実行が抑えられたりすると、CPUのfullが生じ得ます。[1][2]

    平均の%と、累積のマイクロ秒を分ける

    次は、メモリのPSIを説明するための架空の表示例です。totalも含め、実測した値ではありません。

    some avg10=12.50 avg60=4.00 avg300=1.20 total=3250000
    full avg10=2.00 avg60=0.80 avg300=0.25 total=500000

    各欄が表すものを、単位と一緒に整理します。

    PSIの表示欄の読み方(Linux v6.12の文書・実装を基に作成)
    表示欄 単位 わかることと注意点
    avg10 % 10秒を目安とした短期の傾向。直近の変化に比較的早く反応する。
    avg60・avg300 % 60秒・300秒を目安とした、より長い傾向。短い変化の影響はならされる。
    total マイクロ秒(µs) 対象範囲で集計した圧迫時間の累積。差分から任意の観測区間を調べられる。個々の要求の応答時間ではない。

    平均値の「10秒」などは、そこから前を切り捨てる固定区間の単純平均ではありません。Linux v6.12の実装では、過去の値の影響が徐々に小さくなる指数移動平均を使います。したがってavg10=12.50を、「直前10秒のうち、ちょうど1.25秒待った」と言い換えることはできません。短期のavg10が長期のavg300より高ければ、最近の圧迫が強まった可能性を調べる手掛かりになります。[2][5]

    任意の区間を見たい場合は、同じ対象・同じ行のtotalの差を取ります。たとえば上のsomeが、正確に10秒後に4750000へ増えたと仮定します。増分は1,500,000 µs、つまり1.5秒です。観測した10秒で割ると、その区間のPSI圧迫時間の割合は15%と計算できます。これはavg10を逆算した値でも、処理ごとの待ち時間を合算した値でもありません。[1][2]

    差分を取る前には、読み取りの間隔と対象をそろえます。再起動やcgroupの作り直しをまたいで、別のカウンターを引き算しないことも必要です。監視ソフトで扱う場合も、割合と累積時間を同じ系列として混ぜないようにします。

    短い待ちを知らせる監視窓は、avg10とは別

    平均値は傾向を見るのに便利ですが、短い待ちの増加を、別の時間幅で検知したいこともあります。PSIは、そのためのトリガーを登録できます。次は、メモリのsomeに登録する条件の例です。自動実行するコマンドではなく、書き込む設定文字列を示しています。

    some 200000 2000000

    二つの数値の単位は、どちらもマイクロ秒です。意味は「2秒の監視窓に、200ミリ秒の圧迫時間が蓄積したら知らせる」。比率にすれば10%ですが、avg10が10%以上になったら知らせる設定とは違います。2秒は監視する時間幅で、10秒は先ほどの平均値の尺度だからです。ここで選んだ数値は読み方の説明用であり、あらゆるサービスに適した警報値ではありません。[1][2]

    登録には、対象のPSIファイルを開き、そのファイル記述子へ条件を書き込みます。ファイル記述子とは、プログラムが開いたファイルを扱うための番号です。監視プログラムは同じ記述子を開いたまま、poll()などで通知を待ちます。閉じるとトリガーも解除されるため、echoで一度書くだけでは継続監視になりません。複数のトリガーには、それぞれ別のopen()が必要です。[1]

    利用できる監視窓には権限による条件もあります。Linux v6.12では、CAP_SYS_RESOURCE権限を持たない監視の場合、窓は2秒の倍数でなければなりません。上限は10秒です。上の例はこの窓の条件に収まりますが、対象ファイルへの書き込み権限などは別に必要です。また、権限によって監視の集計経路が異なるため、通知が常に同じ間隔や精度で届くとは仮定できません。[1][2]

    トリガーの窓内時間は推定を含み、通知は同じ監視窓の長さにつき最大1回へ制限されます。一つの待ちが発生するたびに届く通知でも、すべての遅延事象を漏れなく記録する仕組みでもありません。実運用では、使っているカーネルの版・設定・権限で監視が成立することを確かめてから、サービス側の遅延と照合します。[2]

    PSIを、原因を絞る次の観測につなげる

    PSIの価値は、一つの値でサーバーの良否を決めることよりも、次に何を調べるかを選びやすくする点にあります。システム全体の数値と、遅い処理が属するcgroupの数値を、同じ時間帯で見比べます。全体では目立たない圧迫が、特定のグループに集中している可能性もあるからです。

    cgroupのCPU圧迫が高ければ、CPUの取り合いに加えて、そのグループの上限も確認します。cpu.maxは利用可能なCPU時間の上限と期間、cpu.statのnr_throttledやthrottled_usecは、CPUコントローラーによる実行抑制を調べる材料です。PSIだけを見て、CPUを増設すれば解決すると結論づけるのは早計です。[2][4]

    メモリや入出力の圧迫が高い場合も、処理の応答時間、メモリ回収、ストレージの状態を突き合わせます。なお、CPU統計のiowaitはPSIのioと同じ指標ではありません。公式文書もiowaitの算定上の限界を説明しているため、同じ値になることを前提に比較しないようにします。[3]

    PSIが低くても、アプリケーション内部の処理や外部サービスの応答まで良好だと保証されるわけではありません。PSIはCPU・メモリ・入出力の資源圧迫を見る手掛かりです。「CPUはどれだけ使われたか」に「どの範囲の仕事が、何を待っていたか」を重ねることで、余力の判断も、遅さの切り分けも具体的になります。

    出典

    1. The Linux Kernel documentation, “PSI – Pressure Stall Information”、Linux v6.12。表示形式、システム全体とcgroupの対象範囲、トリガーの利用方法。監視窓の下限について文書と同版実装に差があるため、本文の例は両方で確認できる2秒の窓としています。
    2. Linux v6.12, kernel/sched/psi.c。some/fullのモデル、複数CPUの集計、平均値、CPU fullの出力、トリガーの条件・集計・通知制限。
    3. Linux v6.12, “The /proc Filesystem”、/proc/statの節。CPU時間の区分とiowaitの制約。
    4. Linux v6.12, “Control Group v2”、CPUインターフェースの節。cpu.max、cpu.stat、cpu.pressure。
    5. Linux v6.12, include/linux/sched/loadavg.h。PSIの平均値計算から呼ばれるcalc_load()の式。
    6. Linux v6.12, init/Kconfig、PSI・PSI_DEFAULT_DISABLED。構築時設定と有効化条件。資料確認日:2026年10月14日。
  • OQDの量子エミュレーターで読む期待値、1回の測定や100回の集計との違い

    OQDの量子エミュレーターで読む期待値、1回の測定や100回の集計との違い

    量子計算のグラフに「期待値0.5」と表示されても、1回の測定で0.5が出るとは限りません。何を測り、その結果にどんな数を割り当てたかで、グラフの読み方は変わります。

    Open Quantum Design(OQD)が公開する量子エミュレーターには、その違いをコードから追える小さな例があります。量子状態の時間変化を古典コンピューターで計算し、そこから期待値を求める処理と、確率に従って測定結果を取り出す処理を分けています。単一の量子ビットを例に、何が計算値で、何が測定の集計なのかを見ていきます。[1][2]

    簡単にまとめると?

    • 期待値は、起こりうる結果を確率で重み付けした平均で、1回に出る結果とは異なります。
    • OQDのZ期待値は数値状態から計算され、Measure命令の有限回の模擬測定とは別の出力です。
    • ショット数を増やすことと、モデルや数値計算の誤りを小さくすることは別に確かめる必要があります。

    0と1の測定結果に、Zではプラスとマイナスを割り当てる

    ここでは、量子ビットを0と1で読み分ける測定を考えます。Zという観測量では、0の結果を+1、1の結果を−1として数えます。期待値は、この数をそれぞれの確率で重み付けして足したものです。

    たとえば0になる確率が75%、1になる確率が25%なら、Zの期待値は「+1×0.75+(−1)×0.25=0.5」です。一方、1回の測定で出るのは0か1であり、Zの値としては+1か−1です。0.5という途中の値が1回の結果になるわけではありません。

    同じ状態を用意する試行を100回繰り返した場合も、必ず75回と25回に分かれるとは限りません。仮に80回が0、20回が1なら、その標本平均は0.6です。これは説明用の仮の集計で、OQDや量子装置の実測値ではありません。

    表1 同じ確率から、異なる種類の値を読む。Quantum Sea作成。100回の欄は説明用の仮例です。
    対象 この例での値 分かること
    1回の測定 0または1。Zとしては+1または−1 個々の試行で起きた結果
    モデルのZ期待値 +1×0.75−1×0.25=0.5 確率で重み付けした平均
    100回の仮の集計 0が80回、1が20回ならZの標本平均0.6 有限回の結果から求める平均

    狭い画面では表を横にスクロールできます。

    期待値の曲線と、ショット数が使われる場所

    OQDのREADMEには、状態を反転させる作用を持つXをハミルトニアンに指定し、Zの期待値を時間に沿って表示する例があります。ハミルトニアンは、状態が時間とともにどう変わるかを定めるモデルです。ここでは離散的なXゲートを1回実行するのではなく、Xを使った連続的な時間発展を計算します。[1]

    実装は回路と観測量の次元が合っているかを検査し、数値計算ライブラリQuTiPへ渡します。単一量子ビットなら初期状態は0で、時間発展後の数値状態からZの期待値を求めます。READMEの例にショット数100と書かれていても、描かれるZ期待値は100個の測定結果を平均した値ではありません。[2]

    ショット数が使われるのはMeasure命令の処理です。計算した状態から0と1の確率を求め、乱数で指定回数だけ結果を選び、その個数をcountsへまとめます。READMEの最小例自体には、このMeasure命令はありません。期待値の曲線があることだけでは、測定結果を100回集計した証拠にならないのです。[1][2]

    小さな検算で、0.5の意味を確かめる

    先ほどの75%と25%は、READMEと同じXによる時間発展からも作れます。初期状態を0、ハミルトニアンをXとし、係数と時間の単位を規格化すると、0の確率はcos²t、1の確率はsin²tになります。t=π/6を選ぶと、それぞれ3/4と1/4になり、Z期待値は0.5です。ここでのtは秒や実機のパルス時間を指定した値ではありません。

    この例は、2行2列の行列による時間発展と三角関数の式を別々に計算して照合した、説明用の数学的検算です。OQD本体を実行して性能を測った結果ではありません。同じ理想状態を独立に100回測る場合、Zの標本平均の標準偏差は約0.087になります。回数が有限なら、平均が0.5の周りでばらつくことを数で捉えられます。

    回数、時間の出力点、モデルの範囲を分けて選ぶ

    何を確かめたいかによって、見直す設定も変わります。模擬測定の集計がばらつくならショット数が関係します。今回の独立試行の例では、回数を4倍にすると標本平均の標準偏差は半分になります。ただし、誤ったモデルが回数を増やすだけで正しくなるわけではありません。

    時間変化を細かく見たい場合は、別の設定であるdtを確認します。この版ではdtを使って出力する時刻の点数を作り、QuTiPのソルバーへ渡しています。dtそのものを内部計算の固定刻みとして指定しているわけではなく、小さくすれば数値誤差が必ず減るという保証にもなりません。[2]

    実装上の対象範囲も重要です。この版のMeasureは結果を集計しますが、測定で決まった状態へ置き換える処理はありません。ここで説明した最後の測定の集計から、途中で測定し、その結果で後続操作を変える計算まで正しく再現できるとは広げられません。期待値についても、本稿は単一のZを対象にしており、任意の複雑な観測量の動作を検証したものではありません。[2]

    確認した公開コードはバージョン表記0.1.0、開発段階はAlphaです。量子コンピューターの実機性能を示す測定結果ではなく、モデルから数値を得る実装として読みます。グラフを見るときは「どんな状態を計算したか」「何を結果として返したか」「何回の標本に基づくか」を揃えると、期待値と測定集計を取り違えずに比較できます。[3]

    参考資料

    以下は2026年10月14日に確認した固定コミット 6a086a9843b91d041e76fbd4fed83c5384a14e6e(2025年9月10日)の資料です。本文の検算例はQuantum Seaによる独立計算です。

    1. Open Quantum Design, oqd-analog-emulator README。単一量子ビットのRabi flopping例と、エミュレーターの位置付け。 固定版を読む
    2. Open Quantum Design, qutip_backend.py / conversion.py / interface.py / passes.py。次元検査、初期状態、期待値、模擬測定、時間発展の実装。 固定版を読む
    3. Open Quantum Design, pyproject.toml。版0.1.0、Alpha、QuTiP 5.1.1への依存。 固定版を読む
  • 太陽電池セルシートの銀回収、電気パルスで酸が届く構造へ

    太陽電池セルシートの銀回収、電気パルスで酸が届く構造へ

    使い終えた太陽電池から銀を取り出すとき、銀を溶かす薬品だけを考えても、回収は進みません。銀の細い配線が樹脂やシリコンに覆われたままでは、薬液が触れられる場所が限られるからです。化学処理の前に、材料をどのように分けるかが効いてきます。

    東京大学・早稲田大学のTakaya氏らが2024年に報告した研究は、ガラスなどを外した太陽電池のセルシートへ短い電気パルスを加え、その後の酸浸出を調べました。パルス処理を経た二つの試料では、7日後に銀が溶液へ移った割合が約95%、処理せず粉砕した試料では85%でした。この差が何を示し、工程全体の評価には何が足りないのかを見ていきます。[1]

    簡単にまとめると?

    • 電気パルスでセルシートの銀配線を分離し、酸に触れる状態を変える前処理の研究です。
    • 濃度60%の硝酸、25℃での比較では、7日後の銀の浸出率がパルス処理ありで約95%、なしで85%でした。
    • 数字は試料中の銀が溶液へ移った割合です。パネル全体から製品として銀を回収する効率や、省エネルギー性を示す値ではありません。

    銀を溶かす前に、封止材との接触を変える

    結晶シリコン太陽電池には、発生した電気を集める細い銀の配線があります。フィンガー電極と呼ばれるこの配線は、電流をまとめる銅のバスバーとつながっています。セルの周囲を保護する封止材のEVA(エチレン酢酸ビニル共重合体)などと密着しているため、銀だけを取り出すには、この複合した構造を解く必要があります。

    研究で使ったのは、JA Solar製の結晶シリコン太陽電池からアルミニウムの枠とカバーガラスを取り除き、セル1枚に相当する156 mm角に切ったシートです。ガラスは加熱した刃で、その直下のEVA層を切って外しています。完成したパネルを丸ごと電気パルスで処理した実験ではありません。

    このシートを水中に置き、銅のバスバーの対角位置に電極を当てて、各試料に5回のパルス放電を行いました。電流が通る領域の銀配線を微粒子として分離する一方、銅のバスバーは形を保ったまま取り出します。ただし、銀配線はすべて一度に外れるわけではなく、シートにも一部が残ります。

    銀が集まった粒子と、銀が残るシートを分けて調べる

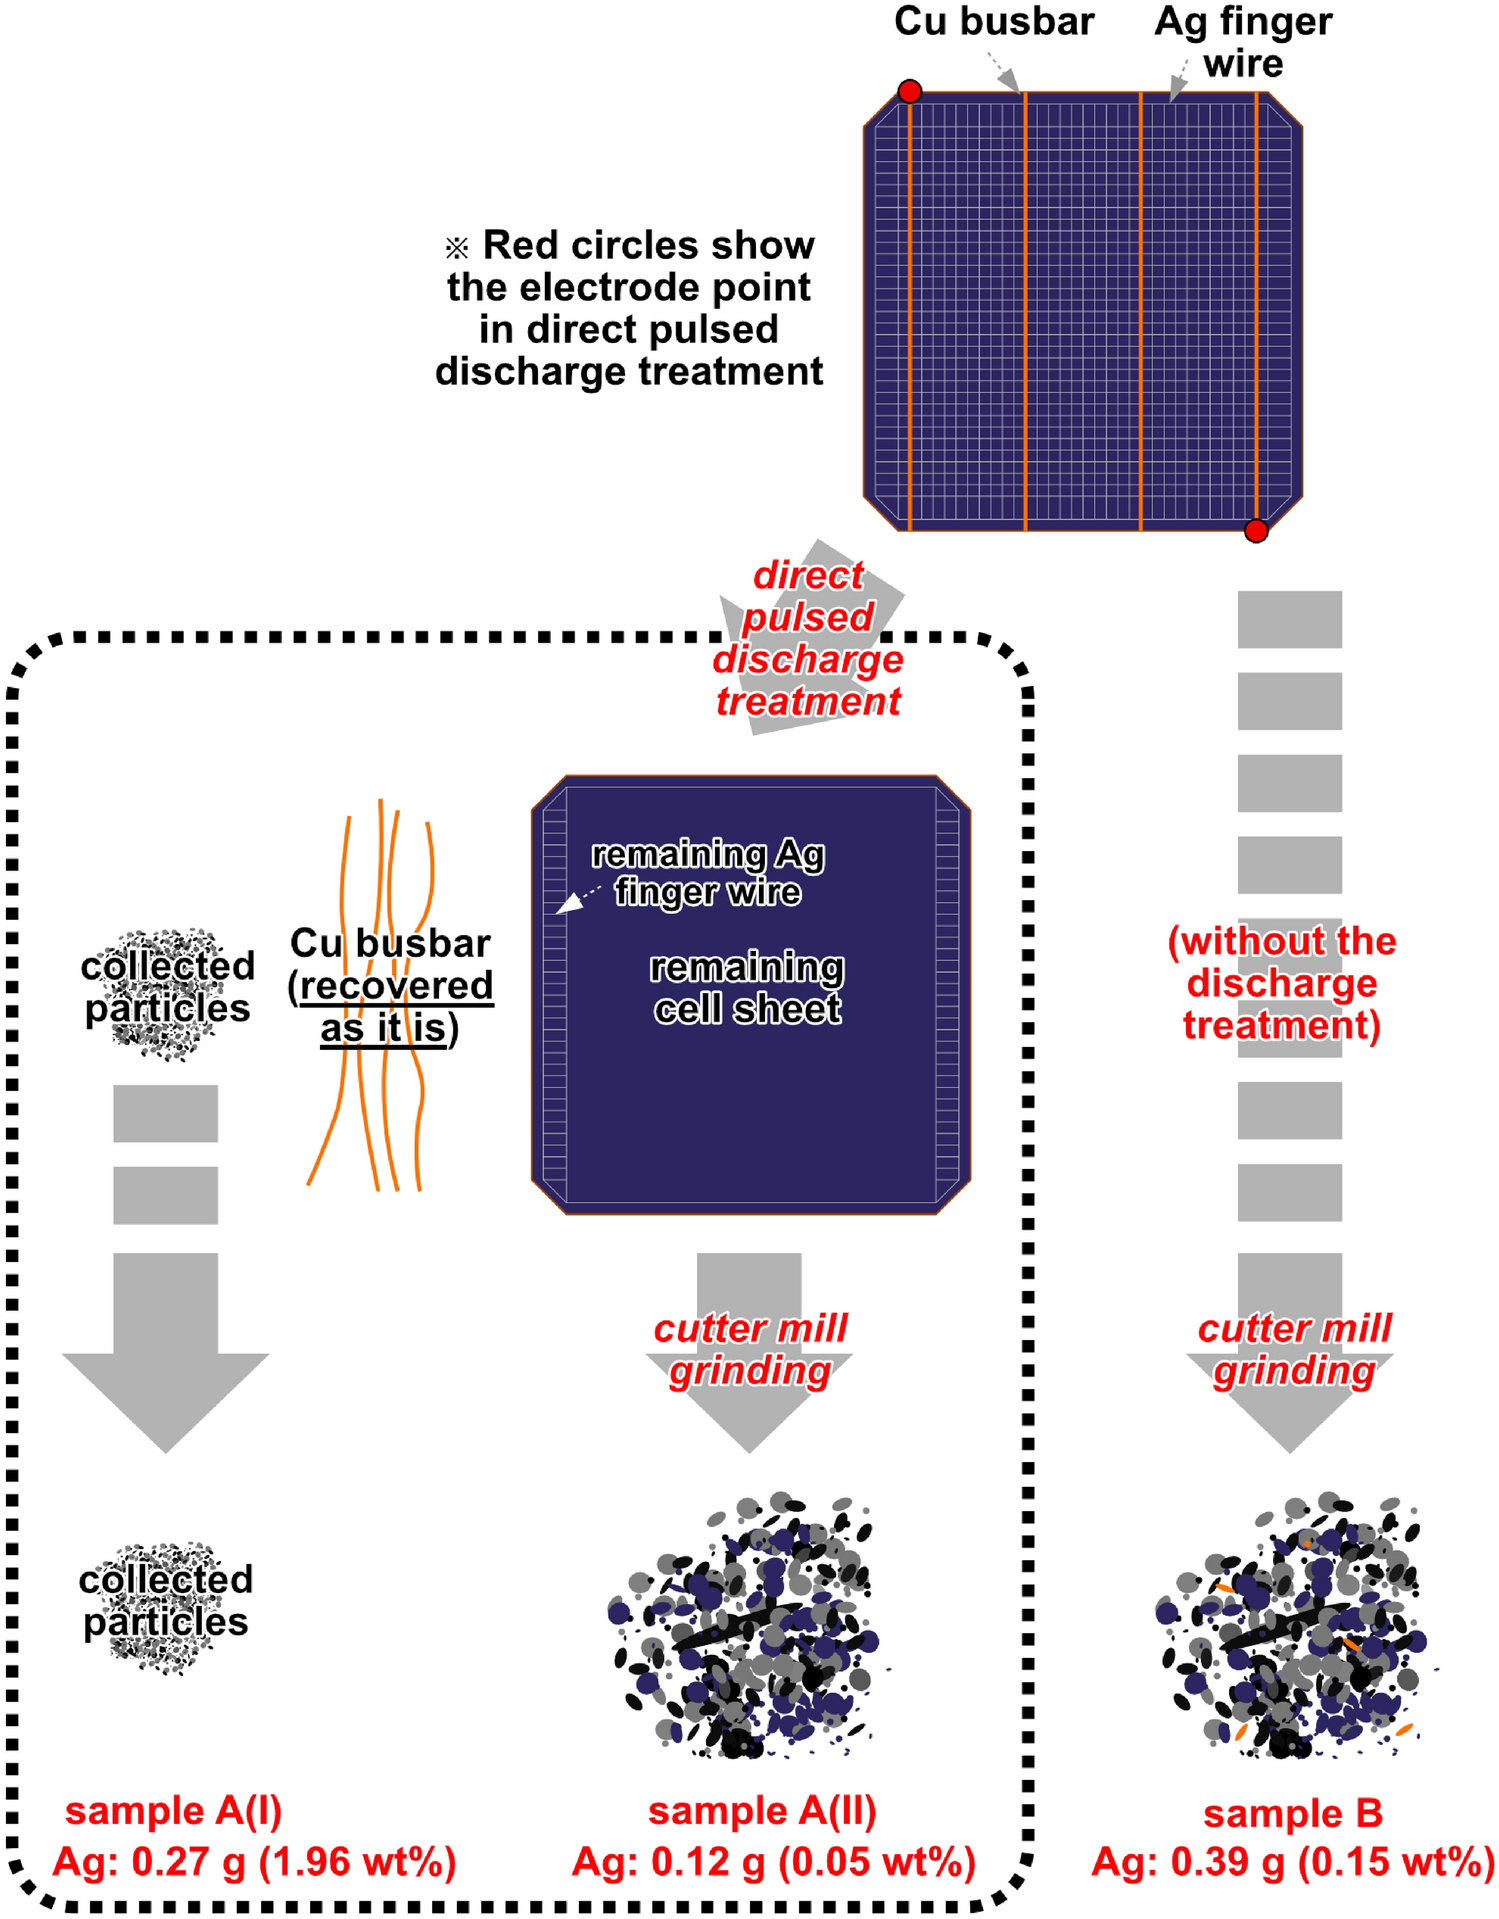
    下の原図は、酸に入れる前の試料づくりを示しています。左側の点線で囲まれた経路がパルス処理あり、右側が処理なしです。処理後に分かれた粒子と残ったシートを、同じものとして扱わないことが比較の出発点になります。

    銀回収の試料調製を示した原著Figure 2。パルス処理から粒子A(I)と残ったシートの粉砕物A(II)へ分かれる経路と、パルスなしで粉砕するBの経路を比較する。
    図1 浸出試験に使う三つの試料のつくり方。赤丸は電極位置、下段のgは156 mm角のシート1枚に由来する各試料中の銀量、wt%はその試料の銀濃度です。画像を開くと拡大できます。出典:Takaya, Y.ほか(2024)、p.2593、Figure 2。© The Author(s) 2024、CC BY 4.0。原図は無改変。

    パルス処理で得た1.18 mm未満の粒子がA(I)です。銀濃度は1.96 wt%、シート1枚に由来する銀量は0.27 gでした。残ったシートを粉砕したものがA(II)で、銀濃度は0.05 wt%、銀量は0.12 g。比較対象のBは、パルスを加えずシートを粉砕したもので、銀濃度は0.15 wt%、銀量は0.39 gです。

    A(II)とBには、刃で切り刻むカッターミルを同じ条件で使っています。A(I)の高い銀濃度は、銀が粒子側へ集まったことを示しますが、粒子が純銀になったという意味ではありません。また、シート側に残った銀を捨てれば、その分は取りこぼします。銀を濃い試料へ集めることと、そこから銀を薬液へ取り出すことは、別の段階です。

    7日後の約95%は、酸に溶け出した銀の割合

    次に、三つの試料をそれぞれ10.00 gずつ、濃度60%の硝酸100 mLに入れて比較しました。温度は25℃、かき混ぜる速さは毎分180回転です。固体に含まれる成分を溶液へ移す操作を浸出といい、この研究では薬液を採取して、溶け出した銀を分析しています。

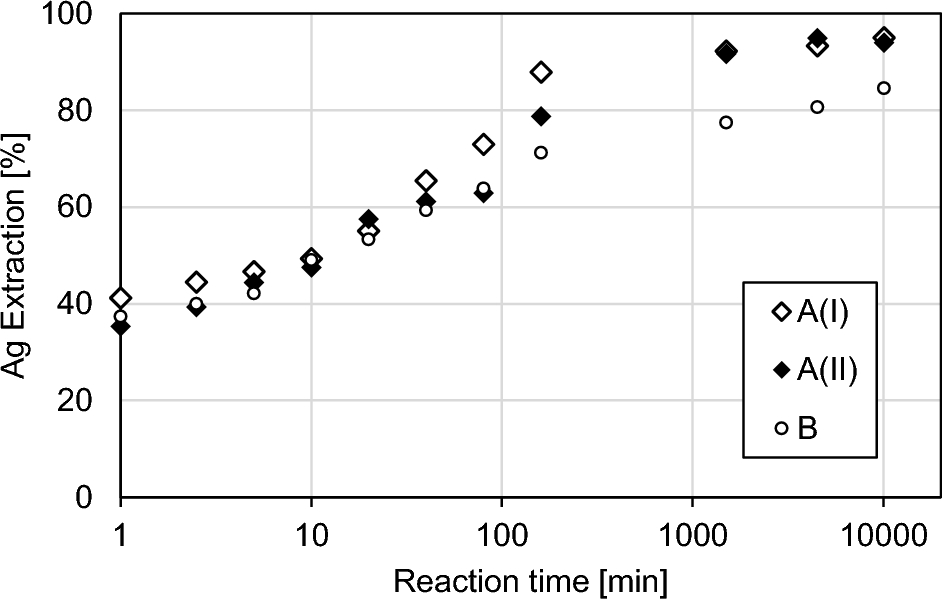
    原図の縦軸は銀の浸出率、横軸は反応時間です。横軸は1、10、100、1,000、10,000分と10倍ごとに区切った対数目盛になっています。右端の10,080分は7日間に相当し、その時点でA(I)とA(II)は約95%、Bは85%でした。差は約10パーセントポイントです。

    三試料の銀の浸出率と時間を比較した原著Figure 3。横軸は分単位の対数目盛。10,080分でパルス処理を経たA(I)とA(II)は約95%、未処理で粉砕したBは85%に達する。
    図2 各試料から溶液へ移った銀の割合。白いひし形が粒子A(I)、黒いひし形が残りのシートを粉砕したA(II)、白丸がパルスなしのBです。百分率の基準は各試料に含まれる銀で、パネル全体の質量ではありません。出典:Takaya, Y.ほか(2024)、p.2594、Figure 3。© The Author(s) 2024、CC BY 4.0。原図は無改変。

    ここで約95%は、それぞれの試料に含まれていた銀のうち、試験中に溶液へ移った割合です。元のパネルから販売できる金属銀を95%回収した結果ではありません。さらに、試料の重さと酸の量をそろえても、銀濃度が違うため、銀1 g当たりの酸の量まで同じになるわけではありません。

    曲線には途中の進み方にも違いがあります。ある時刻での浸出率と、7日後に到達した値は分けて読む必要があります。今回の結果から、処理時間を問わず常に95%になる、あるいはそれが永続的な回収上限だと考えることはできません。

    樹脂を剥がした別試料で、銀の露出の効果を確かめる

    研究チームは、なぜ差が出るのかを調べるため、EVAを手で剥がしたモデル試料もつくりました。シリコン上の銀配線が露出した試料では、最初の1分で銀の55%が溶け出し、7日後には99%に達しました。剥がしたEVA側に銀が包まれた試料では91%、剥がしていないシートでは82%でした。[1]

    この比較は、銀が周囲の材料にどう覆われているかによって、浸出の速さや到達する割合が変わることを示しています。ただし、99%は手で剥がして銀を露出させた別試料の結果です。パルス処理の試料にそのまま当てはめたり、先ほどの約95%と足し合わせたりはできません。

    著者らは、銀が完全に露出している状態、シリコンに付着した状態、EVAなどに覆われた状態、壊れていないシート内にある状態の四つを仮定し、実測の浸出曲線に合うよう、その割合を推定しています。これはモデルによる説明で、顕微鏡ですべての銀を数えて求めた割合ではありません。

    実際、粒子A(I)の顕微鏡像と元素分布には、銀とシリコンが集まった構造も見られます。著者らは、放電で生じた銀とシリコンが水中で急に冷え、凝集して銀の表面を覆った可能性を挙げています。樹脂から外せば必ず全面が酸に触れるとは限らず、分離後にできる粒子の状態も考える必要がある、という示唆です。

    工程を選ぶには、浸出率と薬品・時間・電力を並べる

    この研究で得られる判断材料は、酸浸出の前に電気パルス処理を組み合わせると、銀の分かれ方と溶け出し方が変わる、という点です。一方、25℃で約95%に達したという結果には、濃度60%の硝酸を使い、7日間反応させた条件が伴います。室温で試験したことだけを根拠に、短時間で省エネルギーの工程が完成したとは言えません。

    浸出を扱うこの論文には、パルスの電圧や1回当たりの投入エネルギーは示されておらず、放電方法の詳細は先行研究に委ねられています。枠やガラスを外す工程、放電、粉砕、酸の処理まで含めた消費電力の比較も、ここでは示されていません。酸中へ移した銀を分離・精製し、金属として得る工程の歩留まりも別に確認が必要です。

    したがって、実用的な処理方法を比べる際は、対象がパネル全体なのか分離済みシートなのかをそろえ、銀の浸出率とともに、必要な酸の量、到達までの時間、前処理を含む電力、最後に得る銀の純度と量を見る必要があります。銀を溶かす化学だけでなく、酸が働ける状態を前処理でどこまでつくるか。その設計を検討するための実験として読むと、今回の成果と残る課題がつながります。

    出典

    1. Takaya, Y., Imaizumi, Y., Koita, T., Cordova Udaeta, E. M., Tokoro, C. “Effect of electric pulse treatment on silver recovery from spent solar panel sheet by acid-leaching.” Journal of Material Cycles and Waste Management 26, 2591–2598(2024年4月22日公開)。DOI: 10.1007/s10163-024-01951-5。原著PDF。
  • PEM水電解のイリジウムを減らす、TiO₂@IrOₓ触媒と電極の厚み

    PEM水電解のイリジウムを減らす、TiO₂@IrOₓ触媒と電極の厚み

    水素をつくるPEM水電解では、酸素が発生する側の電極にイリジウム系の触媒を使います。希少な金属を減らせれば設備を広げやすくなりますが、触媒を薄く塗るだけでは、電気の通り道まで途切れることがあります。減らしたいのは金属の量であって、電極として働く場所ではありません。

    ユーリヒ研究センター、エアランゲン・ニュルンベルク大学などのDarius Hoffmeister氏、Selina Finger氏らが2024年に報告したのは、酸化チタンの粒子を薄いイリジウム酸化物の層で覆う「TiO₂@IrOₓコアシェル触媒」です。少ないイリジウムでも電極の厚みを確保する設計を、材料単体の試験と5 cm²の電解セルの両方で確かめています。[1]

    簡単にまとめると?

    • TiO₂の芯を薄いIrOₓの殻で覆い、イリジウムを減らしながら、触媒粒子の電気的なつながりと電極の厚みを保つ設計です。
    • 80℃・常圧の5 cm²セルでは、Ir量0.22 mg/cm²の試料が、0.30 mg/cm²の市販対照より2 A/cm²で50 mV低いセル電圧を示しました。
    • 200時間のセル試験では市販対照より劣化が速く、初期性能の改善と長期耐久性の達成は分けて読む必要があります。

    イリジウムの「割合」と「電極に載せる量」は違う

    PEMはプロトン交換膜のことです。水を分解して水素を得るセルの中で、この膜が水素イオンを通します。酸素をつくる陽極では、酸性で高い電位という厳しい環境に耐えながら反応を進める必要があり、イリジウム系の材料が使われます。

    論文の「Ir 40 wt.%」は、触媒粉末の質量に占めるイリジウムの割合です。一方、「0.22 mgIr/cm²」は、電極の面積1 cm²あたりに載せたイリジウムの量を表します。粉末の組成を比べる数字と、セルに使う金属量を比べる数字なので、同じものとして扱えません。

    今回の触媒は、比較対象のUmicore製IrO₂/TiO₂触媒「Elyst Ir75 0480」の約75 wt.%に対し、約40 wt.%のIrを含みます。残りの多くを酸化チタンの芯が担うため、同じIr量でも、触媒層をより厚くつくれるのが狙いです。

    薄い殻で電気をつなぎ、厚みで断絶を避ける

    酸化チタンはこの用途では電気を通しにくい材料です。芯の表面に反応する粒子を点々と置いても、それぞれが電気的につながっていなければ、電極全体を十分に使えません。そこで研究チームは、光析出、イソプロパノールによる還元、熱処理という3段階で、粒子表面に連続したIrOₓの殻を形成しました。

    殻の厚さは電子顕微鏡で2.1±0.4 nm。表面にはさらにIrを含むナノ粒子があります。殻は反応に関わる表面であるとともに、粒子間へ電気をつなぐ役割を持ちます。ただし、結晶性や酸化状態は一様ではなく、すべてが完全に酸化したIrO₂という意味ではありません。

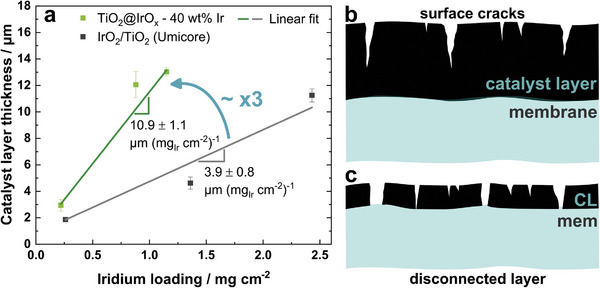
    電極の厚さをIrの担持量で割った「厚み係数」は、試料で10.9±1.1、Umicoreの対照で3.9±0.8 µm/(mgIr/cm²)でした。同じIr量に対して、前者は約2.8倍の厚みを確保できます。低担持量0.22 mgIr/cm²なら、論文が示す試料の層厚は約2.4 µmです。

    原論文Figure 6。左にIr担持量と触媒層厚さの関係、右に厚い層と薄い層で亀裂が入ったときのつながりの模式図。
    原論文Figure 6。左(a)の緑はTiO₂@IrOₓ、灰色は市販対照で、同じIr担持量でも得られる層厚が異なります。各断面5点の平均と標準偏差を示します。右(b、c)は、厚みの違いが亀裂による層の断絶にどう関わるかを説明する模式図です。運転中の亀裂を直接撮影した図ではありません。
    Darius Hoffmeister et al., Advanced Science 11, 2402991 (2024), Figure 6. © 2024 The Author(s). Wiley-VCH. 原論文 / CC BY 4.0。JPEGからPNGへ容器形式のみ変換。画素・構図・ラベルは変更していません。

    膜や触媒層中のイオノマーは、水を含むと膨らみます。薄い層に亀裂ができると、集電部につながらず反応に使えない領域が生じるおそれがあります。著者らは、試料で確保した厚みがこの断絶を抑え、低担持量でも性能を保つ一因になったと説明しています。これは構造や抵抗の測定を合わせた解釈であり、「厚いほどよい」という結論ではありません。厚くしすぎると、電子やイオンが通る距離が長くなり、抵抗も増えます。

    材料試験の好成績だけで、セル性能は決まらない

    材料の評価には、回転ディスク電極(RDE)という、小さな電極を回転させながら反応を調べる方法を使っています。室温、アルゴンで脱気した0.1 M過塩素酸、Ir担持量50 µg/cm²の条件で、試料の質量活性は233±18 A/gIrでした。評価電位は可逆水素電極(RHE)を基準とする1.6 Vです。

    この1.6 Vは、完成した水電解セルの両端にかける電圧ではありません。またRDEでは薄い触媒層を導電性の高い電極上に置くため、実セルで重要になる層内の電気的なつながりが、結果に表れにくい場合があります。材料単体で反応が速いことと、膜・触媒層・集電部を組み合わせたセルで低い電圧を実現することは、別の確認です。

    5 cm²のセルでは、どの条件で差が出たか

    セル試験では、膜の両側に触媒層を設けた触媒被覆膜(CCM)を使い、これを輸送層などと組み合わせています。膜電極接合体を含む単セルの試験であり、大面積の電極を何枚も積んだ実用スタックの実証ではありません。

    原論文の低担持量セル試験の比較(Figure 7b、Experimental Section)。数値は同論文内の比較です。
    項目 TiO₂@IrOₓ試料 Umicore市販対照
    陽極のIr担持量 0.22±0.01 mgIr/cm² 0.30±0.03 mgIr/cm²
    2 A/cm²でのセル電圧 1.77 V 1.82 V
    セルの有効面積 5 cm² 5 cm²
    温度・圧力 80℃・常圧 80℃・常圧
    膜 Nafion NR212、約51 µm 同左
    陰極のPt担持量 0.19±0.08 mgPt/cm² 同左

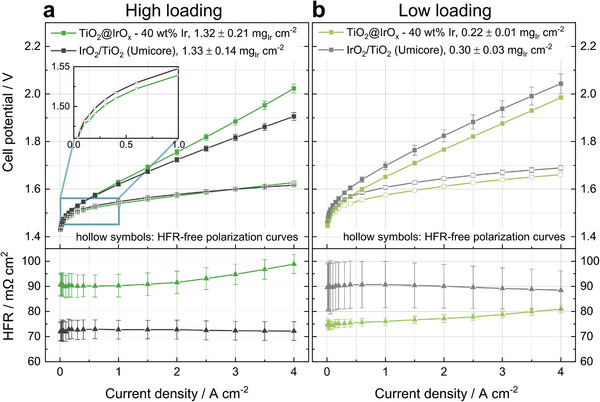
    電圧は高周波抵抗(HFR)の分を差し引いていない、セル全体の値です。試料は、対照より約27%少ないIrで、同じ電流密度のときに50 mV低い電圧を示しました。5 cm²の面積に換算すると、陽極に使うIrは約1.1 mgと約1.5 mgです。いずれも掲載された平均担持量からの計算で、装置全体の貴金属量ではありません。

    共通条件として、陽極には白金を被覆したチタン繊維の多孔質輸送層(PTL)を使い、そこにも平均0.035±0.025 mgPt/cm²の白金があります。陽極へ脱イオン水を100 mL/分で送り、陰極へは水を供給していません。白金や膜、輸送層の条件が違うセルへ、この電圧差をそのまま当てはめることはできません。

    原論文Figure 7。高担持量と低担持量で、TiO₂@IrOₓ試料とUmicore対照のセル電圧、高周波抵抗を比較したグラフ。
    原論文Figure 7。左(a)は高担持量、右(b)は低担持量の比較です。緑がTiO₂@IrOₓ、灰色が市販対照。上段の塗りつぶした記号はセル電圧、白抜きはHFR補正後の値で、下段はHFRを示します。新品のCCMと輸送層を用いた3回の試験の平均と標準偏差を表示。担持量の±は最小・最大のずれであり、電圧の誤差棒とは意味が異なります。
    Darius Hoffmeister et al., Advanced Science 11, 2402991 (2024), Figure 7. © 2024 The Author(s). Wiley-VCH. 原論文 / CC BY 4.0。JPEGからPNGへ容器形式のみ変換。画素・構図・ラベルは変更していません。

    同じ触媒でも、Irを多く載せた約1.3 mg/cm²の条件では、試料のほうが対照より抵抗が高く、セル全体の性能は劣りました。低担持量で得られた利点を、高担持量や別の電極設計まで一般化しないことが大切です。

    測定は電流密度0.01〜4 A/cm²を段階的に変え、各点を5分保持して最後の15秒を平均しています。新品のCCMで3回繰り返した結果です。この短い性能測定と、一定電流で長時間動かす耐久試験も分けて読む必要があります。

    200時間の結果は、耐久性が完成したことを意味しない

    論文は、2 A/cm²で200時間保持する単セル試験も報告しています。試料のコアシェル構造は試験後にも観察されましたが、セル電圧の劣化速度はUmicoreの対照より高くなりました。粒子の形が残っていることと、電圧が安定していることは同じではありません。

    著者らは、試験中に触媒がさらに酸化した可能性を挙げ、より長く試験すれば劣化速度が下がるのではないかと考察しています。これは予測であり、長期間の安定運転を示した実測結果ではありません。今回の成果は、少ないIrでセルの初期性能を引き上げる設計を示した段階で、長寿命や大面積化を含む実用条件の達成とは区別できます。

    次の研究を比べるときに見るところ

    低イリジウム触媒の報告を読むときは、まず粉末中のIrの割合と電極面積あたりの量を分けます。そのうえで、セル面積、膜、温度、圧力、輸送層の貴金属被覆をそろえて比べる。電圧が抵抗補正前か補正後か、短時間の性能測定か長時間の劣化試験かも確認したい点です。

    今回の論文が教えてくれるのは、貴金属を減らす研究を、材料の反応の速さだけでは評価できないということです。少ないIrをどこに置き、電極の厚みと電気の通り道をどう保つか。その設計がセルで働くことを確かめ、さらに劣化まで追うことで、比較できる技術になります。

    参考資料

    1. Darius Hoffmeister et al. (2024). Photodeposition-Based Synthesis of TiO₂@IrOₓ Core–Shell Catalyst for Proton Exchange Membrane Water Electrolysis with Low Iridium Loading. Advanced Science, 11(30), 2402991. DOI: 10.1002/advs.202402991 / PMC公開全文(補足資料への案内を含む)。
  • 有機太陽電池の二重フィブリル構造、混ぜ方と塗り方で発電効率が変わる

    有機太陽電池の二重フィブリル構造、混ぜ方と塗り方で発電効率が変わる

    有機太陽電池では、光を吸収する材料を選ぶだけでなく、薄い膜の中で材料がどう並ぶかが発電効率を左右します。光から生まれた電荷を分け、その電荷を電極まで運ぶには、性質の異なる二つの材料が接しながら、それぞれ連続した経路をつくる必要があるためです。

    武漢理工大学のChen Chen氏らが2024年に報告した研究は、第三の成分を加えて両方の材料に細い繊維状の構造をつくり、塗り方も変えることで、この両立を図りました。著者が測った最高効率は20.1%、論文に記載された第三者認証値は20.0%。数字の違いと測定面積を分けながら、何を変えた研究なのかを見ていきます。[1]

    簡単にまとめると?

    • 電子を渡す材料と受け取る材料の両方に、細く連続したフィブリル構造を整える研究です。
    • 第三成分を一度に混ぜる方法より、二つの溶液へ別々に加えて順に塗る方法で、効率の改善が大きくなりました。
    • 20.1%は著者測定の最高値。認証報告書は20.02%と記録し、論文では20.0%と表示しています。大面積パネルの効率や長期寿命を示す数字ではありません。

    電荷を分ける界面と、運ぶ経路を両方つくる

    光を吸収した有機半導体では、電子と、電子が抜けた正孔が引き合った状態で生まれます。これを励起子と呼びます。電子を渡す側のドナーと受け取る側のアクセプターの界面で電荷を分け、その後は電子と正孔をそれぞれの材料の経路に沿って電極へ運びます。

    二つの材料が離れすぎれば、電荷を分ける界面に届きにくくなります。一方で、細かく混ざっていても運ぶ経路が途切れていれば、分かれた電荷が再び出会って失われる再結合が問題になります。そこで目指すのが、細い繊維状の集まりであるフィブリルを、両方の材料で連続させる構造です。電気を流す金属の配線を埋めるのではなく、有機半導体そのものの集まり方を整えます。

    第三成分を加えるだけでなく、溶液を分けて順に塗る

    研究チームは、アクセプター材料のL8-BOと、ドナー材料のPM6またはD18を組み合わせました。そこへ加えた第三成分が、新たに合成したL8-ThClです。L8-ThClとの分子間の相互作用によって、ドナーとアクセプター双方の分子配列やフィブリルの形成を調整する狙いがあります。

    ただし、三成分を同じ溶液に入れて一度に塗ると、L8-ThClは相性のよいL8-BO側へ取り込まれやすく、ドナー側の構造改善が十分に進みませんでした。そこで、ドナーとL8-ThClを混ぜた溶液、L8-BOとL8-ThClを混ぜた溶液を別々につくり、前者、後者の順に塗る逐次成膜(layer-by-layer deposition)を使いました。

    一度に混ぜて塗る方法は、膜の内部で二つの材料が接するバルクヘテロ接合(BHJ)をつくります。逐次成膜で得た膜は、混ざり合う領域に加えて、厚さ方向に各成分の割合が変わる構造を持つp-BHJです。「順に塗る」は、完成後も二枚の純粋な層がはっきり分かれたまま、という意味ではありません。

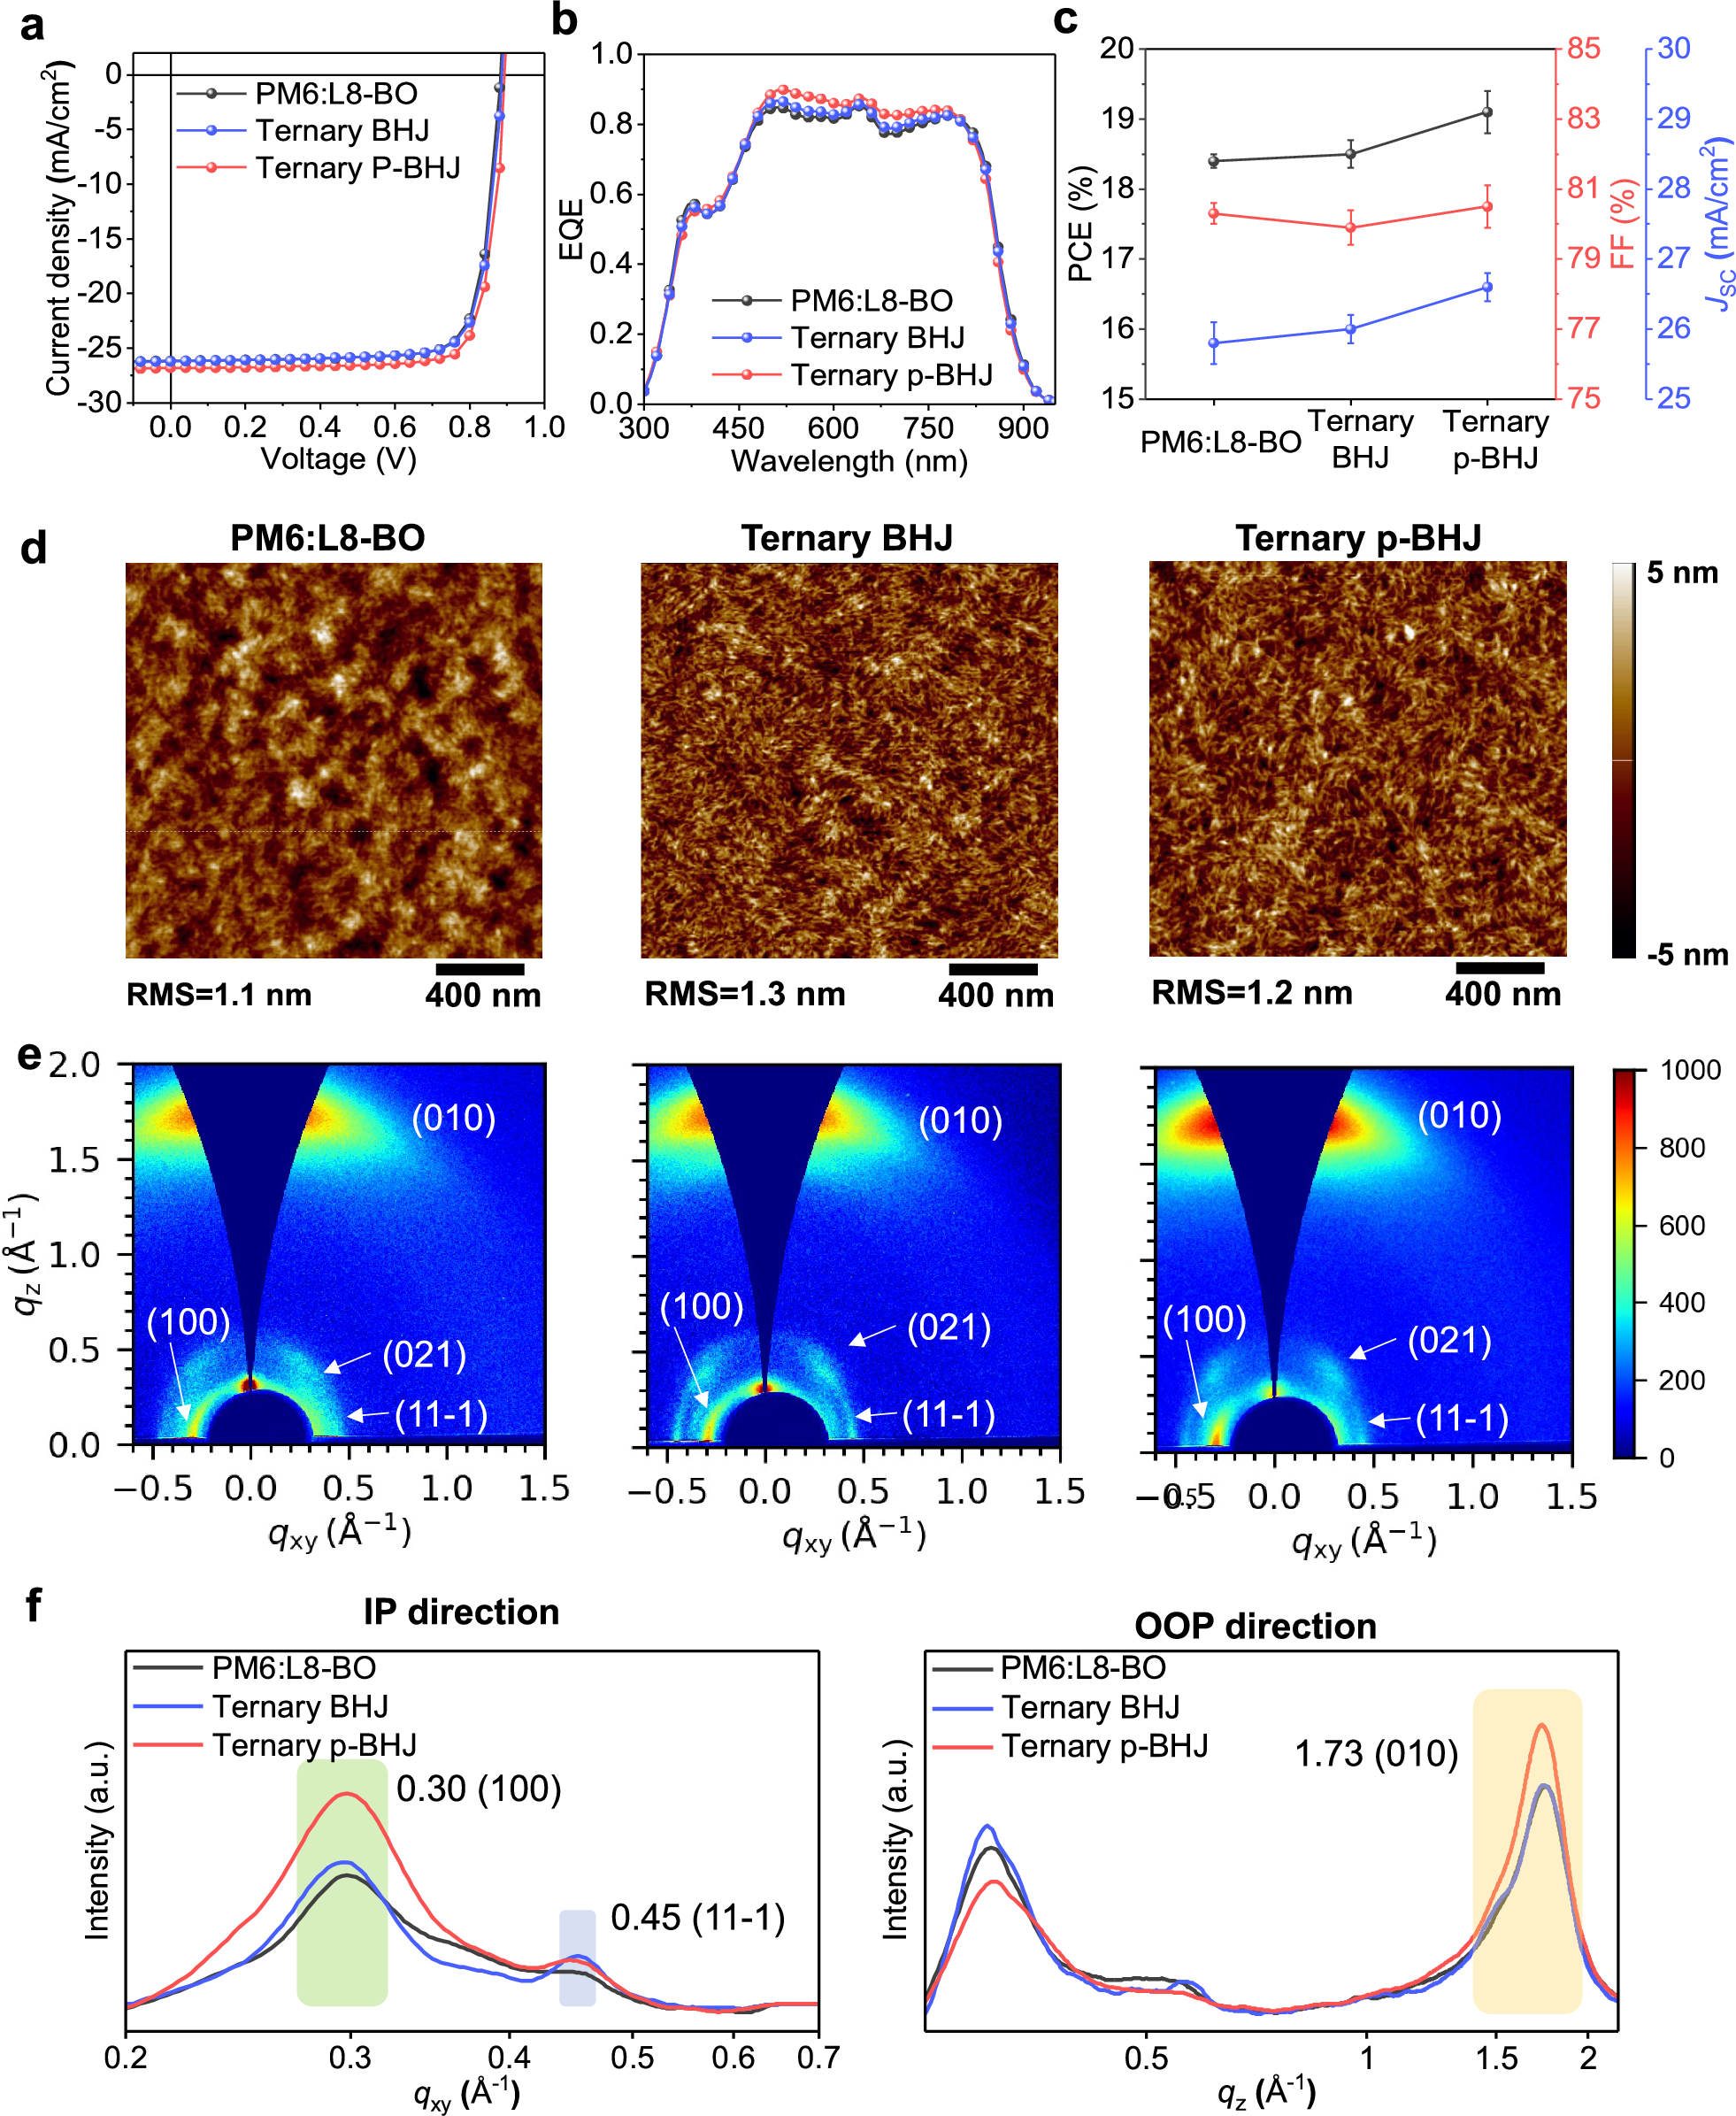
    下の原図は、PM6をドナーとした試料の比較です。まずdの顕微鏡像を見ると、第三成分を加えた中央と右で、細い筋状の構造が現れています。ただし、この表面像だけで、どの筋がドナーでどれがアクセプターかを断定することはできません。研究チームはe・fのX線散乱も使い、分子の並び方を調べています。

    PM6系有機太陽電池の一括混合と逐次成膜を比較した原著Figure 3。上段に電流電圧・量子効率・発電指標、中央に400 nmスケールのAFM像、下段に分子配列を調べたX線散乱を示す。
    図1 PM6系の発電特性と膜構造。aは電流–電圧特性、bは波長ごとの外部量子効率、cは発電指標、dは表面のAFM像、e・fはX線散乱。Ternary BHJが三成分の一括混合、Ternary p-BHJが逐次成膜です。dのスケールバーはいずれも400 nm。画像を開くと拡大できます。出典:Chen, C.ほか「Molecular interaction induced dual fibrils towards organic solar cells with certified efficiency over 20%」Nature Communications 15, 6865(2024)、p.5、Figure 3。© The Author(s) 2024。原図は無改変。原著のライセンス:CC BY-NC-ND 4.0。

    fでは、逐次成膜の赤線でドナーに対応する配列のピークも強くなっています。論文は、アクセプターだけでなくドナー側の構造も整ったと解釈しています。a〜cの発電測定を合わせて見ると、細い筋が見えること自体ではなく、両方の材料で電荷を運びやすい配列を保つことが重要だと分かります。図cのPCEは平均値で、後の表に示す最高値とは区別しています。たとえばPM6系の逐次成膜は、平均19.1%に対して最高19.4%です。なお、この図はPM6系の結果で、20%に達したD18系の測定図ではありません。

    20.1%と認証20.0%は、どちらの測定値か

    同じ研究内の比較を、原著Table 1から整理すると次のようになります。PCEは、入射した光のエネルギーのうち電力へ変換できた割合です。表の数値は著者測定の最高値で、全試料の平均や第三者認証値とは区別しています。

    作り方 PM6系のPCE D18系のPCE
    ドナーとL8-BOの二成分を一括成膜 18.5% 19.3%
    L8-ThClも加えた三成分を一括成膜 18.7% 19.5%
    L8-ThClを各溶液へ加えて逐次成膜 19.4% 20.1%
    出典:[1] Table 1をもとに測定事実を整理。二成分の質量比は1:1.2、三成分の一括混合は1:1:0.2。逐次成膜はドナー:L8-ThClとL8-BO:L8-ThClを、それぞれ1:0.2で調製しています。成膜工程だけを単独で変え、膜中の組成を完全に一定にした試験ではありません。

    D18系の逐次成膜では、20素子の平均PCEは19.8%、標準偏差は0.3ポイントでした。最高値20.1%だけを見るより、平均とばらつきを合わせて読む方が、試作で得られた性能をつかみやすくなります。

    このD18系の素子について、第三者機関のNational Photovoltaic Product Quality Inspection & Testing Centerが出した報告書は、PCEを20.02%、測定面積を0.0408 cm²と記録しています。論文本体の20.0%は小数第1位の表示です。認証報告書の試料数は1点で、著者が20素子から求めた平均値とは別の測定です。[2]

    著者測定では、電極が重なる面積は6.675 mm²ですが、光を通すマスクで4 mm²(0.04 cm²)に限定しています。面積の異なる数字を取り違えると、効率を比較する前提が変わります。光の条件はAM1.5G、強度100 mW/cm²。認証報告書にも同等の光強度と25±1℃の条件が記されています。

    大面積化と長く発電する性能は、これから別に確かめる

    この研究が示したのは、ガラス基板上に作った小面積の単接合セルで、材料の相互作用と逐次成膜を組み合わせると発電効率を改善できるという結果です。薄く柔らかい製品や建材へ応用できるかを考える際には、基板を変えた試験や、大面積で均一に膜をつくる検証がさらに必要です。

    また、認証報告書の電流–電圧測定は、最大出力を長時間保てることや製品寿命まで認証したものではありません。本文と補足資料では、この素子を長時間動かして性能の低下を追う耐久試験や、最大出力点を追跡した安定化出力の提示は確認できませんでした。論文にある「キャリア寿命が長い」という説明も、電荷が失われるまでの時間を指しており、太陽電池を何年使えるかとは別の話です。

    次に似た研究を比較するときは、「どんな材料を足したか」に加え、どの成分の構造が変わったか、どう塗ってそれを保ったか、どの面積と測定方法で効率を出したかを一緒に見ると、数字の背景を追いやすくなります。この研究の価値は、効率の数字だけでなく、二つの材料をそれぞれ整える設計と成膜工程をつないだ点にあります。

    出典

    1. Chen, C., Wang, L., Xia, W.ほか「Molecular interaction induced dual fibrils towards organic solar cells with certified efficiency over 20%」Nature Communications 15, 6865(2024年8月10日)。本文、Methods、Figure 3、Table 1。原著全文/DOI
    2. 同論文 Supplementary Information。pp.15–17の認証報告書(Supplementary Figures 28–30)、p.18のキャリア測定、pp.25–27のD18系測定条件。補足資料PDF