サービスのメモリー使用量に上限を設けても、上限へ近づいたときの挙動は一つではありません。処理は動き続けるのに応答が遅くなる場合と、プロセスが終了する場合では、調べるべき点が違います。Linuxのcgroup v2では、この区別を考える入口がmemory.highとmemory.maxです。
ここでは二つの設定の役割を押さえ、架空の観測値を使って、どの記録から何を判断できるかを整理します。設定値の推奨や実機の性能測定ではありません。
簡単にまとめると?
memory.highは、超過したグループへ回収圧力をかけ、処理を抑制する境界です。これを超えたこと自体でOOM killerを呼ぶ設定ではありません。memory.maxでは、上限に達してメモリーを減らせない場合にグループ内でOOM処理が起きます。ただし一時的な超過や、OOM killerを呼ばない割当失敗もあります。- 使用量だけで原因を決めず、イベント数の差分、対象の階層、応答時間、終了記録を同じ時間帯で照合します。
highは回収の圧力、maxは最後の上限
cgroupは、プロセスをグループにまとめて資源を管理する仕組みです。memory.highを超えたグループでは、処理の抑制と強いメモリー回収が行われます。回収とは、使い続ける必要のないページなどを解放して、利用できる容量を取り戻すことです。highの超過そのものはOOM killer、すなわちメモリー不足に対応してプロセスを終了させる仕組みを起動しません。[1]
memory.maxは、使用量がそこへ達し、回収でも減らせないときに、グループ内でOOM処理へ進む境界です。「どんな瞬間も使用量がこの数値を超えない」という計器上の保証ではなく、一時的に超える場合があります。また、すべての割当失敗がプロセス終了になるわけでもありません。[1]
6 GiBと8 GiBの設定を、観測例で考える
例として、あるサービスのhighを6 GiB、maxを8 GiBに設定したとします。1 GiBは2の30乗バイトです。この数値は説明のために選んだもので、どのサービスにも適した設定ではありません。
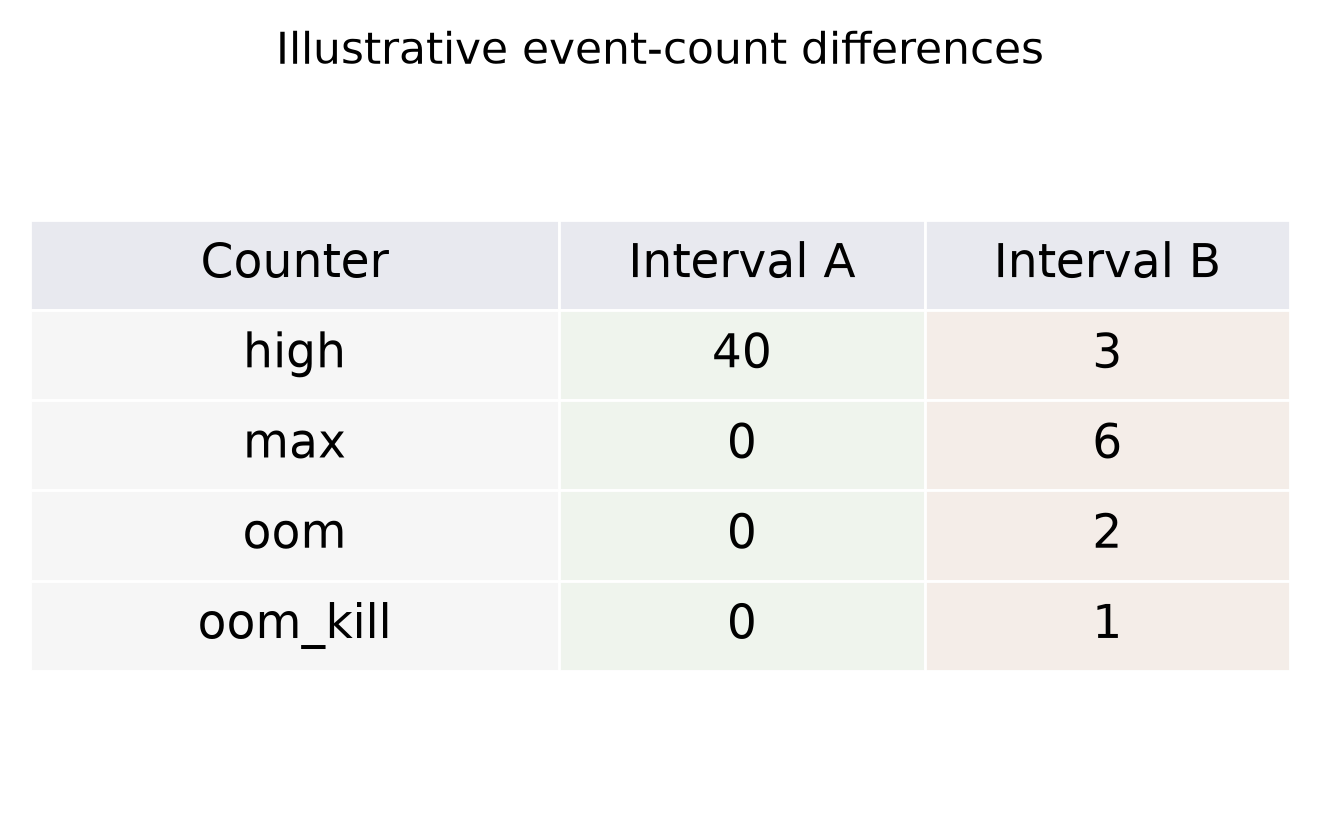
観測時点Aで使用量が5.5 GiB、1分後のBで6.3 GiBだったとします。同じ間にmemory.eventsのhighが12から52へ増え、max・oom・oom_killは変わっていません。図の左側は、この仮定を差分にしたものです。highの40という増加は、40 GiBの超過量でも、40秒の遅延でもありません。境界超過により抑制と直接回収へ回されたイベントの回数です。[1]
この例で応答時間も長くなったなら、メモリー回収による負担を調べる理由にはなります。しかし、highの増加だけで遅延の全原因を確定することはできません。同じ時間帯に処理件数や入力サイズが増えたのか、別の待ちが起きたのかも合わせて確認します。
max、oom、oom_killは、同じカウンターではない
図の右側では、別の観測区間Bにhighが3、maxが6、oomが2、oom_killが1増えたとします。maxは境界を超えそうになった回数、oomは割当失敗へ近づいた状況の回数、oom_killはOOM killerに終了させられた所属プロセス数です。各値は一対一で進む段階表ではありません。特にoom_killは、種類を問わずOOM killerによる終了を数えます。[1]
したがって、「maxが6だから6個のプロセスが終了した」「oomが2なので2回ともこのグループのmaxが直接の原因だった」とは読めません。この仮想例から分かるのは、その区間に異なる種類の出来事が記録されたことまでです。終了したプロセス、カーネルの記録、親グループやホスト全体の状況を調べて、事象を結び付ける必要があります。
例えば、親グループの下にサービスAとBがあるとします。親のカウンターが増えた時刻にAが遅くても、Bで起きた出来事を親が数えている可能性があります。通常のmemory.eventsは子階層を含み、memory.events.localはそのグループ自身の出来事を扱います。取得したファイルと階層を記録せずに数値だけを並べると、対象を取り違えます。[1]
設定を変える前に、比較の条件をそろえる
調べ方としては、まず同じグループの使用量、設定値、イベント値、取得時刻を組にして残します。次の取得値との差を出し、その間の応答時間や処理件数と並べます。カウンターが減った場合は負のイベントとして計算を続けず、グループの作り直しや観測対象の変更を疑い、比較を区切ります。
highを上げて回収の負担が減ったとしても、それだけで問題が解決したとは限りません。例の6 GiBを7 GiBに変えたなら、他のサービスが使える余地や、8 GiBのmaxに達する頻度も比較対象になります。逆にmaxだけを下げて終了が増えたなら、再起動の負担や未完了の処理も評価に含めます。どちらも、同じ処理量と時間帯で結果を残して初めて比較できます。
この説明は、2026年10月22日に取得したLinux公式のcgroup v2文書に基づきます。サイト表示の版は7.3.0でしたが、固定版URLではありません。利用環境のカーネル版、メモリーコントローラーの有効化、親階層の制約、マウント設定を確認してから当てはめてください。特にmemory_localeventsの指定がある環境では、memory.eventsの子階層集計の扱いが変わります。
二つの境界を分けて読む利点は、遅延を調べる場面と、割当失敗や終了を調べる場面を切り分けられることです。使用量の折れ線だけで判断せず、何を数えた値なのかまで合わせて読むと、次に確認する対象が明確になります。
参考資料
- [1] Linux kernel documentation, Control Group v2。Memory Interface Filesのmemory.high、memory.max、memory.events、memory.events.local、およびMount Optionsを参照。2026年10月22日取得。図と観測例は定義を説明するための独自の架空例です。