ファイルから読んだデータを、ヘッダー用と本文用の別々のメモリ領域へ置きたい。こうしたときに使えるのが、複数のバッファを一度に指定するreadvです。ただし、バッファを3個渡したことは、3個とも埋まったことを意味しません。戻り値はバッファの個数ではなく、実際に読み取れたバイト数です。
簡単にまとめると?
- readvは、アドレスと長さの組を並べた配列を受け取り、その順にデータを入れます。先頭のバッファを埋めてから次へ進みます。
- 成功しても全領域が埋まるとは限りません。実際に読めた長さから、どの領域のどこまでが有効かを計算します。
- バッファの境目は、ファイル形式の境目を自動判定する機能ではありません。形式の解析、終端・エラー処理、性能評価は別に必要です。
離れたメモリ領域を、一つの並びとして渡す
通常のreadは、読み取り先として1つのバッファとその長さを指定します。readvは iovec という要素の配列を渡します。各要素は、書込み先のアドレスであるiov_baseと、その領域へ入れられるバイト数であるiov_lenの組です。配列の要素数をiovcntとして指定します。[1、2]
たとえば、4バイトの領域A、3バイトの領域B、5バイトの領域Cを用意します。メモリ上では離れた場所でも構いません。readvはA、B、Cの順に扱い、Aの4バイトを満たしてからBへ、Bの3バイトを満たしてからCへ進みます。12バイト取得できれば、入力の最初の4バイトがA、次の3バイトがB、残る5バイトがCに入ります。
この「一続きの入力を複数の置き場所へ分ける」形を分散入力、scatter inputと呼びます。逆向きのwritevは、複数の領域の内容を配列順に書き出す収集出力、gather outputです。readvが渡されたアドレスの先へ書き込むため、各領域には指定長以上の有効な書込み可能領域が必要です。アドレスと長さを並べただけでメモリが確保されるわけではありません。
6バイトしか読めなかったら、どこまでが有効か
先ほどのA=4、B=3、C=5バイトに対し、readvの戻り値が6だったとします。成功した6バイトは順に配置されるので、Aには4バイト、Bには2バイト、Cには0バイトが入りました。Bの残り1バイトとCの5バイトを、今回の入力として読むことはできません。そこに以前の値や初期値が残っていても、受信した新しいデータにはなりません。
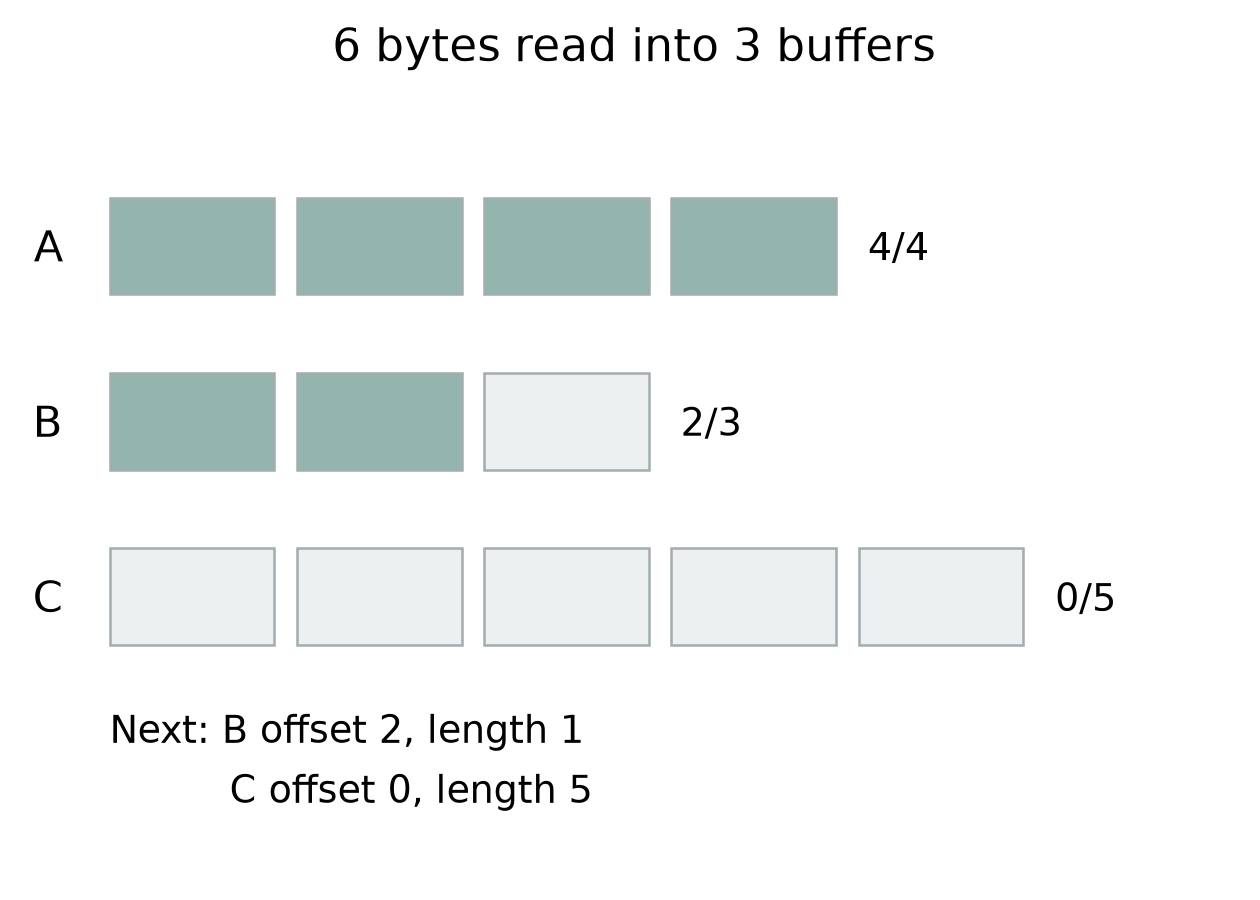
続けて同じ論理的な12バイトをそろえたい場合、次回の配列を「Bの先頭から2バイト進んだ場所、長さ1」と「Cの先頭、長さ5」に組み直します。Aはすでに埋まっているので外します。元の配列をそのまま再び渡すと、次の入力をAの先頭から入れてしまい、まだ必要な部分を埋める操作にはなりません。
計算は、戻り値nを配列の先頭から各領域の長さだけ差し引いていく、と考えると整理できます。領域を全部使い切った分は次回の対象から外し、途中で止まった領域はアドレスをその消費分だけ進め、長さをその分だけ減らします。元の領域を後で参照する必要があるなら、元の配列と進捗を表す配列を分けて管理します。
短い読み取りは、失敗とは限らない
Linux man-pages 6.19は、readvが要求した量より少ないバイト数を正常に返すことを認めています。正の戻り値は今回取得した総バイト数、エラー時は−1です。通常のファイル読取りで0が返れば終端を扱います。エラーの詳しい条件はreadと共通する部分があるため、対象の種類や開き方に応じた処理が必要です。[1]
12バイトを一つのレコードとして読む処理なら、まだ6バイトしかそろっていない段階で完成したレコードとして渡さないようにします。終端で不足した場合は不完全なレコードとして扱うのか、更新される入力を待つ設計なのかを決めます。正の戻り値が得られたことと、アプリケーションが必要とする単位が完成したことは別です。
また、各呼び出しが正しく領域を埋めても、複数回の呼び出しをまとめて同じ内容の版として固定するわけではありません。更新中のファイルを複数回に分けて読むなら、書き手との調整や版の確認なども別の問題になります。
ヘッダーと本文を自動で見分ける道具ではない
バッファの境界は、呼ぶ側が長さを指定して決めます。readvは入力を見て「ここまでがヘッダー、ここからが本文」と判断しません。たとえば、固定長4バイトのヘッダーの後に固定長8バイトのデータがあると分かっていれば、4と8の領域を指定できます。
一方、ヘッダーを読んで初めて本文の長さが分かる形式では、まだ分からない長さをreadvが補ってくれることはありません。まずヘッダーをそろえて長さを検証し、その後に本文を読むなど、形式に合わせた段取りが必要です。長さフィールドをそのまま信用して巨大な領域を確保せず、形式上の上限や実装上の上限も確認します。
ソケットなどへ応用する場合も、iovecの境界を相手が送ったメッセージの境界と同一視しないことが大切です。特にバイトストリームでは、アプリケーションのメッセージ長をどう決めるかは別に設計します。この記事の図は、既知の順序のバイト列を指定領域へ配置する例に限っています。
使いどころは、配置の手間を減らせる場合
入力の置き場所が最初から複数に決まっているとき、readvなら、1つの大きな一時領域へ読んでから各領域へ分けてコピーする処理をアプリケーション側で省ける場合があります。複数のread呼出しを1つにまとめられる構成もあります。ただし、これを「カーネル内部でもコピーが一切ない」「必ず速い」と読み替えることはできません。入出力先、領域の数や大きさ、キャッシュの状態などで結果は変わります。
配列の要素数にも上限があります。man-pagesはIOV_MAXやsysconf(_SC_IOV_MAX)で上限を確認する方法を示し、現代のLinuxでは1024と説明しています。別の環境へ持ち出す実装なら固定値を前提にせず、対象環境の上限と総バイト数を確認します。[1、NOTES]
導入前には、置き場所と各容量が事前に決まるか、短い読取り後の進捗を正しく持てるか、必要な入力単位の完成を判定できるかを点検します。readvの利点は、複数領域への配置を一回の呼び出しで指定できることです。読み取りの完了条件まで自動になるわけではありません。
出典・参考資料
- [1] Linux man-pages 6.19 — readv(2):DESCRIPTION、RETURN VALUE、NOTES。2026年2月22日表記。配置と進捗の数値例は独自計算。
- [2] Linux man-pages — iovec(3type):メモリアドレスと長さを表す構造体。