HTTP応答のContent-Lengthには147と書かれているのに、展開した本文は31,000バイトある。これは、長さの表示が必ず間違っているということではありません。gzipなどで圧縮された応答では、圧縮された形の長さと、利用する前に展開した長さが異なります。
Content-Encodingは、表現へ施した符号化を伝えるヘッダーです。Content-Type、Content-Lengthと合わせて読むことで、「どんなデータか」「どの処理で元の形式へ戻すか」「どの段階の長さか」を区別できます。RFC 9110の定義と、ローカルHTTP通信の小さな実験を対応させます。[1]
簡単にまとめると?
- Content-Encoding: gzipは、表現がgzipで符号化されていることを伝えます。Content-Typeが示す元のデータ形式とは別の情報です。
- 通常のGETの200応答で圧縮した本文を送る例では、Content-Lengthは圧縮後のバイト数です。展開後のバイト数や文字数とは一致しません。
- 圧縮による通信量の減少だけで、所要時間やメモリー使用量まで決まりません。受信、展開、文字への変換を分けて観測します。
種類、符号化、長さを別の欄で読む
例えば、応答にContent-Type: text/plain; charset=utf-8とContent-Encoding: gzipが付いているとします。前者はプレーンテキストというメディア型と文字の符号化方式を示し、後者はその表現へgzipを適用したことを示します。
利用するまでの流れは、gzipのバイト列を展開し、その後に得られたバイト列をUTF-8として文字へ変換する、という順序です。圧縮データを展開することと、文字コードを解釈することは同じ処理ではありません。gzipの列をそのままUTF-8の文章として読もうとしても、正しい本文にはなりません。
Content-Encodingを付けることで、元のメディア型を保ったまま圧縮した表現を送れます。[1、8.4節] 一方、gzipファイルそのものを配る場合など、圧縮がそのメディア型に本来含まれるなら、同じ処理をContent-Encodingへ重ねて書くとは限りません。ファイル名の末尾だけで処理を決めず、応答が宣言する型と符号化を確認します。
31,000バイトの文章を、二通りで送る
実験用の本文は「量子の状態を比べる。」と改行を1,000回繰り返した文字列です。Pythonで数えた文字数は11,000、UTF-8へ変換した長さは31,000バイトでした。日本語の文字は、この例ではUTF-8で一文字3バイト、改行は1バイトになるため、文字数とバイト数が一致しません。
同じ本文を、符号化せず送る応答と、gzipで圧縮して送る応答に分けました。ローカルホスト127.0.0.1だけで動く小さなHTTPサーバーを用い、どちらも200応答としてContent-Typeをtext/plain; charset=utf-8にしています。gzip側にはContent-Encoding: gzipを付け、両方とも実際に送る本文の長さをContent-Lengthへ入れました。
クライアントは、Content-Encodingを自動で展開しないPythonのhttp.clientで応答本文を読み、そのバイト数を記録しました。その後、gzip側だけを明示的に展開し、両方の結果が元のUTF-8バイト列と一致することを照合しました。
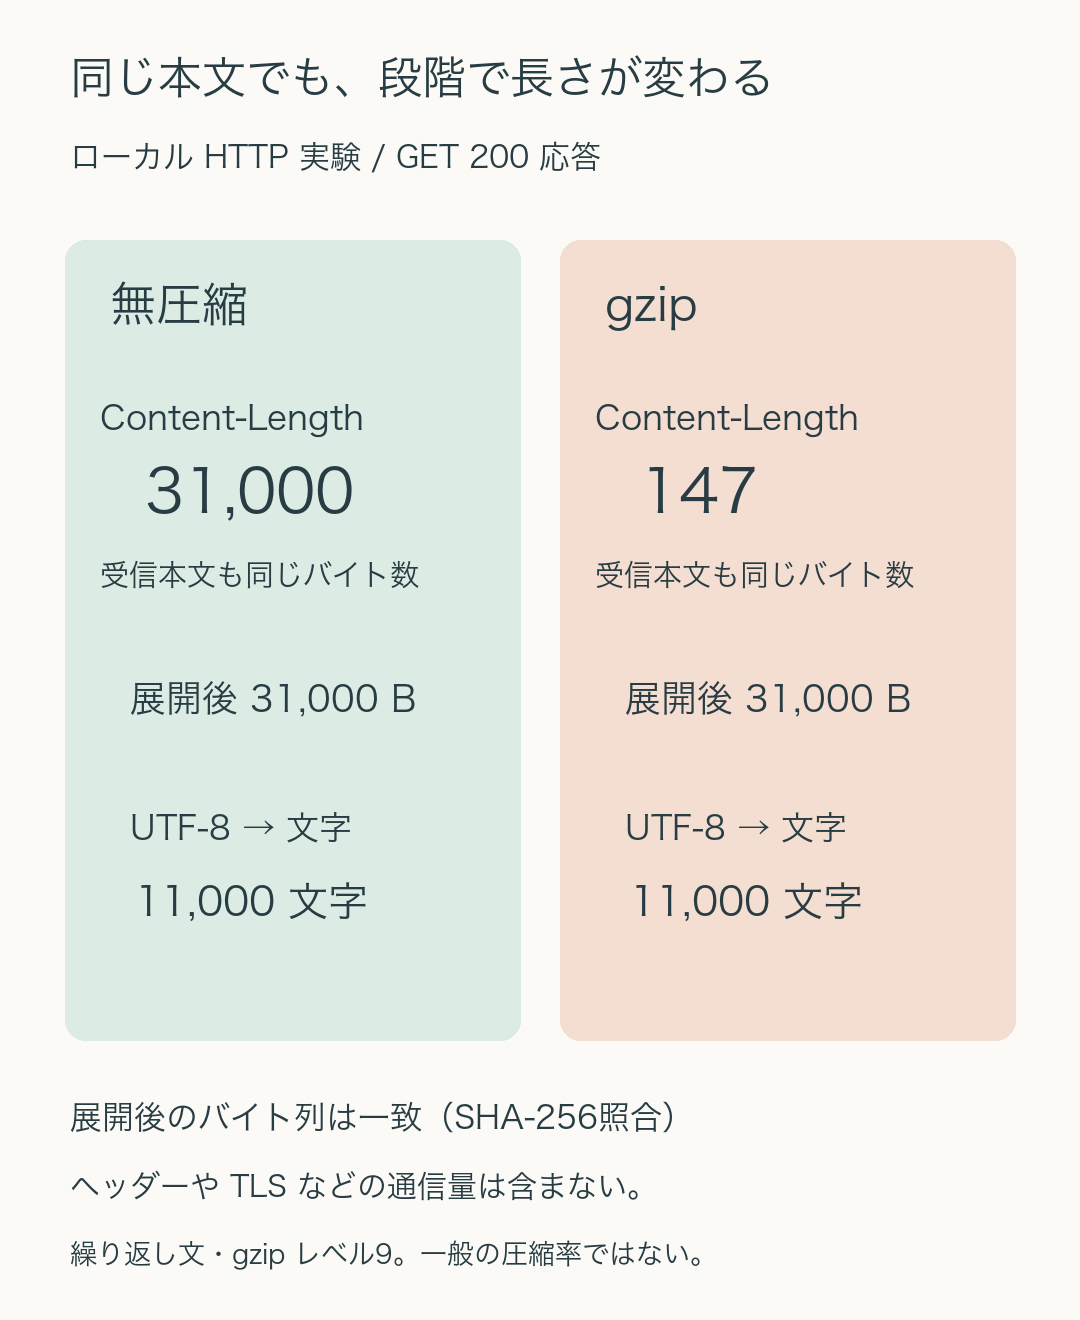
無圧縮側はContent-Lengthが31,000で、受信本文も31,000バイトでした。gzip側はContent-Lengthが147で、受信本文も147バイトです。展開後は両方31,000バイトとなり、SHA-256も一致しました。違っていたのは送る表現の形であり、展開後に利用する文章ではありません。
この147という値は、指定した繰り返し文、圧縮設定、実行環境の組み合わせに対する結果です。一般の日本語ページが同じ比率まで縮むという測定ではありません。繰り返しの多い入力を使ったことで、段階ごとの長さの違いを見やすくしています。
Content-Lengthと、アプリが受け取る長さが違う場合
RFC 9110では、Content-Encodingは表現の特性であり、特に別の定義がない限り、表現のメタデータは符号化された形について述べます。Content-Lengthはオクテット、すなわち8ビットの単位で表した長さです。[1、8.4・8.6節] このGET実験では、gzipを展開する前の147バイトが該当します。
ところが、HTTPクライアントのライブラリーが自動展開する場合、アプリが読み取れるバッファはすでに31,000バイトかもしれません。その値と圧縮後のContent-Lengthを比較して「データが余分に届いた」と判断する前に、ライブラリーがどの段階のデータとヘッダーを渡しているかを確認します。製品や設定を越えて、常に同じ挙動だと仮定しません。
逆に、自動展開済みの本文をもう一度gzip展開しようとすると、処理の段階を取り違えます。保存するなら圧縮されたバイト列を残すのか、展開した本文を残すのかを決め、その内容を説明するメタデータと対応させます。生の応答とライブラリー処理後の応答を、同じものとしてログへ混ぜないことが大切です。
なお、この比較は本文を送る通常のGETの200応答に限定しています。HEADや304ではContent-Lengthの値があっても同じ量の本文を送るとは限らず、別の規則があります。また、Content-LengthはHTTPヘッダー、TLS、TCPなどを含む通信経路全体の総バイト数ではありません。
受け入れられる方式と、実際に届いた方式を照合する
要求のAccept-Encodingは、受け入れられる内容符号化とその選好を伝えます。応答のContent-Encodingは、実際に適用した方式を伝えます。gzipを受け入れると知らせたから、応答が必ずgzipになるとは限りません。[1、12.5.3節]
実験では要求値をgzipかidentityの二通りに限定し、サーバーで対応する応答を選びました。identityは符号化を施さないことを示す要求側の指定です。品質値qやワイルドカードを含む一般的な交渉処理を実装した試験ではありません。
実際の仕様では、Accept-Encodingがない場合と、値が空の場合も違います。ヘッダーがなければ任意の内容符号化を受け入れ可能と扱い、空の値なら応答に内容符号化を求めないことを意味します。q=0で特定の方式を受け入れ不可にする場合もあります。単に「ヘッダーにgzipという文字があるか」だけで、すべての要求を処理する実装にはできません。
小さく送れたことと、速く処理できたことは別
圧縮は必ず入力を短くするとは限りません。同じ環境で一文字Aの1バイトをgzipへ変換すると21バイトになりました。短い入力では形式上の付加情報が相対的に大きくなり、圧縮後の方が長くなる例です。すでに圧縮されたデータなどでも、文章の繰り返し例と同じ削減を期待できません。
また、受信量が小さくても、展開後の保持や文字への変換には別の領域が必要です。今回も147バイトだけを見て本文用バッファの必要量を判断すれば、31,000バイトへ展開されることを見落とします。本稿では処理時間やピークメモリーを測定していないため、圧縮で全体が何倍速くなる、どれだけ省メモリーになる、といった結論は出していません。
比較するときは、送った符号化、受信本文のバイト数、展開後のバイト数、文字への変換後の長さを別々に残します。さらに必要なら、圧縮・展開の時間と実際の通信時間を測ります。ヘッダーの数字を読む段階と、アプリケーションの性能を評価する段階を分けることで、サイズの食い違いを不具合と早合点せず、必要な処理を追えます。
出典
- RFC 9110, HTTP Semantics — Content-Encoding(2022年6月、STD 97)、8.4節。併せて8.6節 Content-Length、12.5.3節 Accept-Encoding。本文の具体的なバイト数と図は、明示したローカル実験の観測です。