大きな一覧からキーを探すとき、「見つからない」と分かるだけでも役に立ちます。ディスク上のファイルを一つずつ調べる前に、対象が入っていないファイルを省ければ、詳しい検索に進む回数を減らせるためです。この入口の判定に使われるデータ構造が、ブルームフィルタです。
ブルームフィルタの返事は対称ではありません。基本形では「入っていない」と「入っているかもしれない」を区別します。後者を、そのまま存在の証明として扱わないことが、使い方の中心になります。
簡単にまとめると?
- 登録したキーから複数のビット位置を決め、そこを1にします。照合時に一つでも0があれば、そのキーは登録されていません。
- すべて1でも、別のキーが立てたビットの組合せかもしれません。「あるかもしれない」と出たキーは、必要に応じて元のデータで確認します。
- 誤検出率1%は、肯定されたキーの99%が本物という意味ではありません。問い合わせに本物がどれほど含まれるかでも、返事の内訳が変わります。
キーの本体を保存せず、複数の位置に印を付ける
基本形は、最初にすべて0にしたビット列を使います。キーを一定の手順で数値へ変換するハッシュを用いて、見る位置を複数決めます。登録するときは、それらの位置を1にします。照合するときも同じ手順で位置を求め、どこか一つでも0なら未登録、すべて1なら「登録されている可能性あり」と返します。このビット列を使う方式は、Bloomの1970年の原論文でMethod 2として説明されています。[1]
この説明では、登録後にビットを消さず、登録と照合で同じ手順・同じビット列を使い、更新漏れや破損がないとします。登録したキーが見る位置は、登録時にすべて1にしたはずです。その後も1のままなら、登録済みなのに「ない」と答えることはありません。この性質を、偽陰性がないと表現します。
一方、ビットには「誰が1にしたか」が残りません。別のキーが同じ位置を使うことがあり、いくつかの登録キーが立てた印を、未登録のキーがまとめて指す場合があります。これが偽陽性、つまり誤検出が生じる入口です。
16個のビットで、誤検出が起きる場面を追う
独自の説明例として、0番から15番までの16個のビットを用意します。ここでは計算の流れを見せるため、ハッシュから得た位置をあらかじめ指定します。実装のハッシュ品質や誤検出率を測る実験ではありません。
キーAは1・4・7番、キーBは4・9・12番を使うとします。この二つを登録すると、1になる位置は1・4・7・9・12番です。4番は共有されていますが、同じビットをもう一度1にしても、2にはなりません。
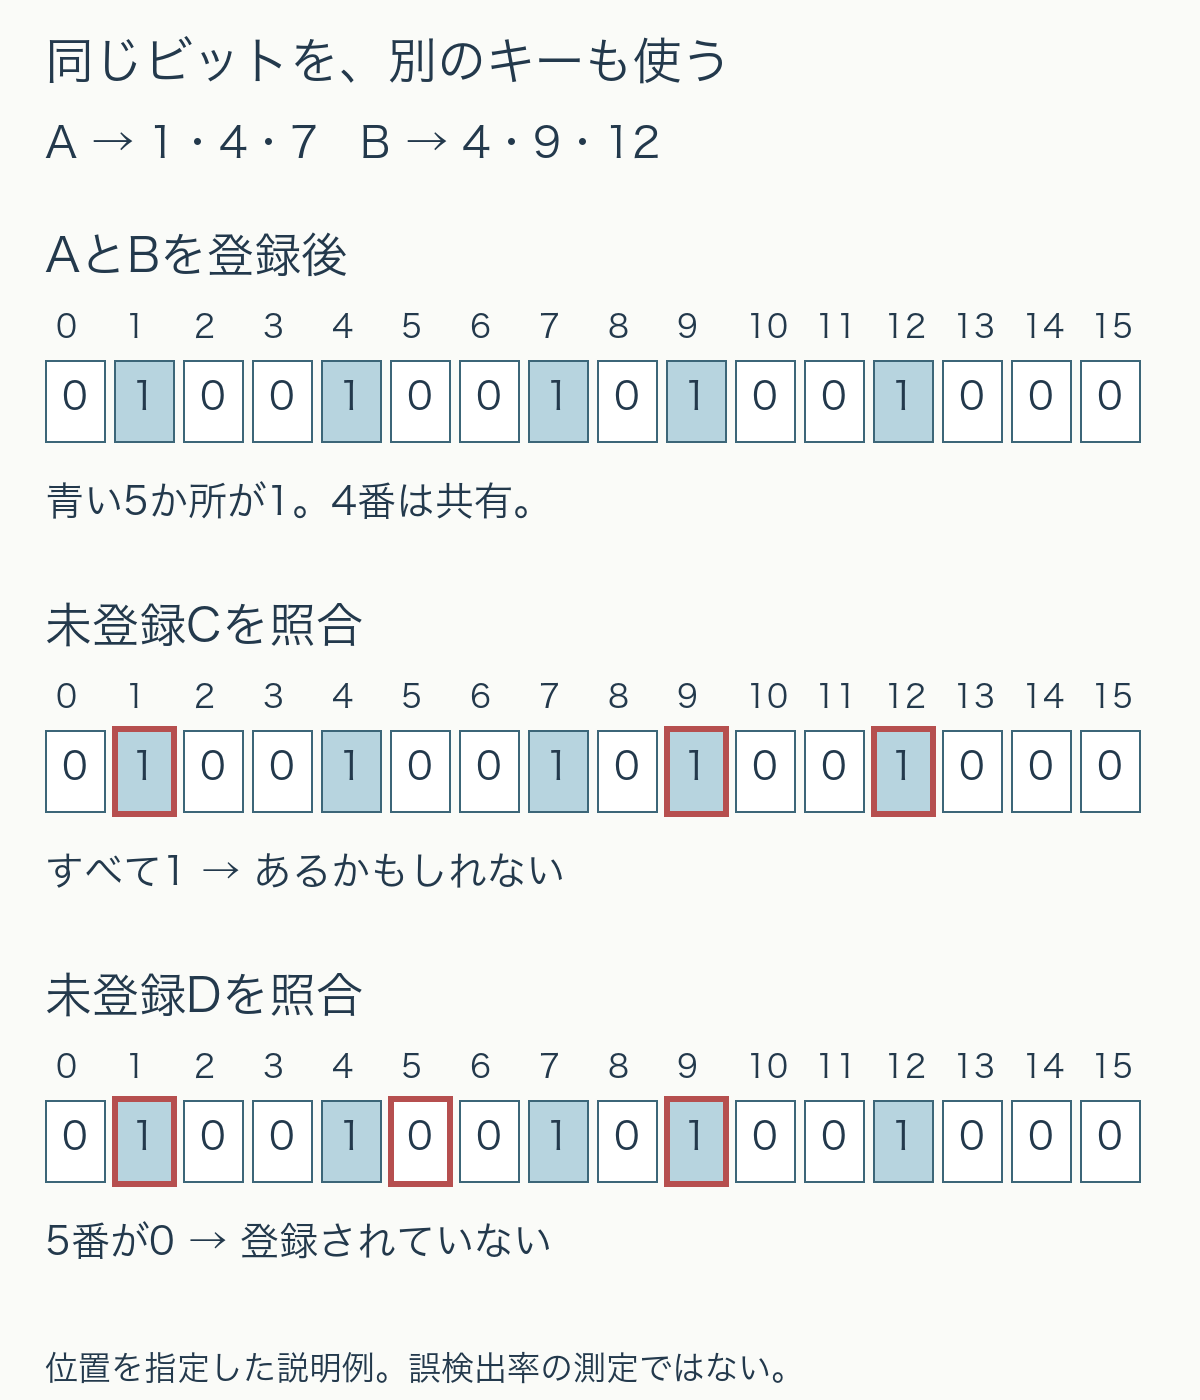
未登録のキーCが1・9・12番を調べると、すべて1です。フィルタはCを「あるかもしれない」と判定します。しかし、実際に登録したのはAとBだけなので、元の一覧で確認すればCは見つかりません。ここではフィルタの誤検出が、後段の余分な検索として現れます。
もう一つの未登録キーDが1・5・9番を調べる場合、5番は0です。Dを登録していたなら5番も1になったはずなので、Dは登録されていないと分かります。すべての位置を最後まで見る前に、0を見つけた段階で判定を終える実装も考えられます。
誤検出率は、未登録の問い合わせを分母にする
「誤検出率1%」という値は、通常、登録されていないキーを問い合わせたときに、誤って肯定する割合を指します。肯定の返事を受け取った後で、そのキーが本当に存在する確率とは分母が違います。[1]
そこで、1万件の問い合わせを処理する仮定の例を計算します。うち1000件が登録済み、9000件が未登録で、未登録に対する誤検出率を1%とします。登録済みの1000件はすべて肯定され、未登録からは平均90件の誤検出が加わります。肯定の合計は平均1090件、そのうち本当に登録されている割合は約91.7%です。
同じ1%でも、登録済みの問い合わせが100件、未登録が9900件なら、肯定は平均100+99=199件となります。本当に登録されている割合は約50.3%です。フィルタの設定が同じでも、問い合わせの内訳が違えば、肯定の返事の信頼度は変わります。これらは指定した割合から求めた期待値であり、個々の1万件の処理で必ずこの件数になるという意味ではありません。
後段の正確な検索を、肯定されたキーだけに行うとすれば、二つの例の検索回数はそれぞれ平均1090回と199回です。ただし、フィルタ自身を調べる計算時間やメモリの費用は、この回数には含めていません。検索回数が減った比率を、そのままアプリ全体の高速化率と呼ぶことはできません。
メモリと、余分な検索のどちらへ費用を寄せるか
実用例としてApache Cassandraは、要求されたパーティションが含まれないSSTableを読み取り対象から省くためにブルームフィルタを使います。SSTableはディスク上のデータファイルです。公式文書は、誤検出を減らすためにメモリを多く使う選択と、メモリを抑えて余分な入出力を許容する選択を説明しています。[2]
判断するときは、登録件数に見合った領域か、未登録の問い合わせが多いか、後段の検索がどれほど重いかを分けて確かめます。もともと全件を順に走査する処理では、キーごとの存在確認を省く仕組みが役立つ範囲も変わります。本文の16ビット例から、本番の適切な容量やハッシュ回数を決めることはできません。
同じビット列へ登録を追加していくと、0の位置は減っていきます。極端にすべて1になれば、どの問い合わせにも「あるかもしれない」と答え、検索を省く役割を果たせません。誤検出があることだけで欠陥と判断せず、避けられた検索と余分に残った検索を、メモリ使用量と一緒に測る必要があります。
削除と、実データとの同期を別に考える
単純なビット列では、Aを消したいからといって1・4・7番を0へ戻すと危険です。4番はBも使っています。4番を消した後にBを照合すると、登録済みのBへ「ない」と答えてしまいます。先ほどの偽陰性がないという説明は、こうした単純な消去を行わない条件付きです。削除を扱う拡張方式は、別の仕組みとして検討します。
また、元のデータにキーを追加しても、対応するフィルタへ反映されていなければ、アルゴリズムの性質だけでは読み落としを防げません。「何の集合を表すビット列か」と「いつ更新されたか」をそろえることが必要です。Cassandraの公式文書でも、誤検出率の設定変更は既存SSTableへ直ちに反映されず、再生成の時点を区別しています。[2]
ブルームフィルタは、存在を完全に証明する台帳ではなく、詳しい確認へ進む前に不在を選別する入口として考えると使いどころが明確になります。肯定されたものをどう確認するか、何を安全に省けるか、その判断にどの版のフィルタを使うかまでを一組にして設計します。
参考資料
- Burton H. Bloom, Space/Time Trade-offs in Hash Coding with Allowable Errors, Communications of the ACM, 13(7), 1970, pp.422–426。Method 2(p.423)、誤検出割合の定義(p.424)を参照。大学公開の原論文写し。
- Apache Cassandra Documentation, Bloom Filters。表示版5.0、用途・メモリと入出力の比較・Changing節を参照。実装の性能測定結果ではありません。ウェブ資料は2026年10月23日確認。