計算の答えは1,001程度なのに、途中で「大きすぎて扱えない」と止まってしまう。指数関数と対数を組み合わせる計算では、そんなことが起こります。代表例がlog-sum-exp(ログ・サム・エクスプ)です。
入力をそれぞれ指数関数に通し、足し合わせ、最後に対数を取る関数で、機械学習の正規化などに使われます。最終結果だけを見て計算精度を選ぶと、途中の値が表現範囲を超える問題を見落とします。最大値をいったん取り除く工夫が、なぜ答えを変えずにこの問題を避けられるのかを確かめます。
簡単にまとめると?
- log-sum-expの結果が有限でも、先に計算する指数関数が桁あふれしたり、極端に小さくなって0へ丸められたりします。
- 各入力から最大値を引くと、指数関数へ渡す値は0以下になります。最後にその最大値を足し戻せば、数学的に同じ結果が得られます。
- 桁あふれ対策と丸め誤差の対策は別です。小さな補正にはlog1pを使う工夫があり、無限大・NaN・負の重みなどは追加の扱いが必要です。
対数を取る前の値が、先に限界へ達する
有限の実数 x1, …, xn に対して、log-sum-expを次のように定義します。本稿の log は自然対数です。
LSE(x)=log(exp(x1)+…+exp(xn))
たとえば入力が [1000, 1001] なら、答えは約1001.313262です。ところが、通常の倍精度浮動小数点数で exp(1000) を先に作ろうとすると、その時点で表現範囲を超えます。これがオーバーフロー、つまり桁あふれです。
対数には大きな値を小さな桁数に圧縮する働きがありますが、後から取る対数は、すでに表現できなくなった中間結果を救えません。数式として等しい書き方でも、有限の桁しか持たない計算機では計算順序が結果を左右します。[1]
最大値を外に出し、差だけを指数関数へ渡す
入力の最大値を m=max(x) とします。各指数関数から共通の exp(m) をくくり出すと、対数の性質によって次の式へ書き換えられます。[1]
LSE(x)=m+log(Σ exp(xi−m))
ここでのポイントは、exp(m)を実際には計算しないことです。共通因子を数式の上で対数の外へ出し、最後に m を足す形にします。
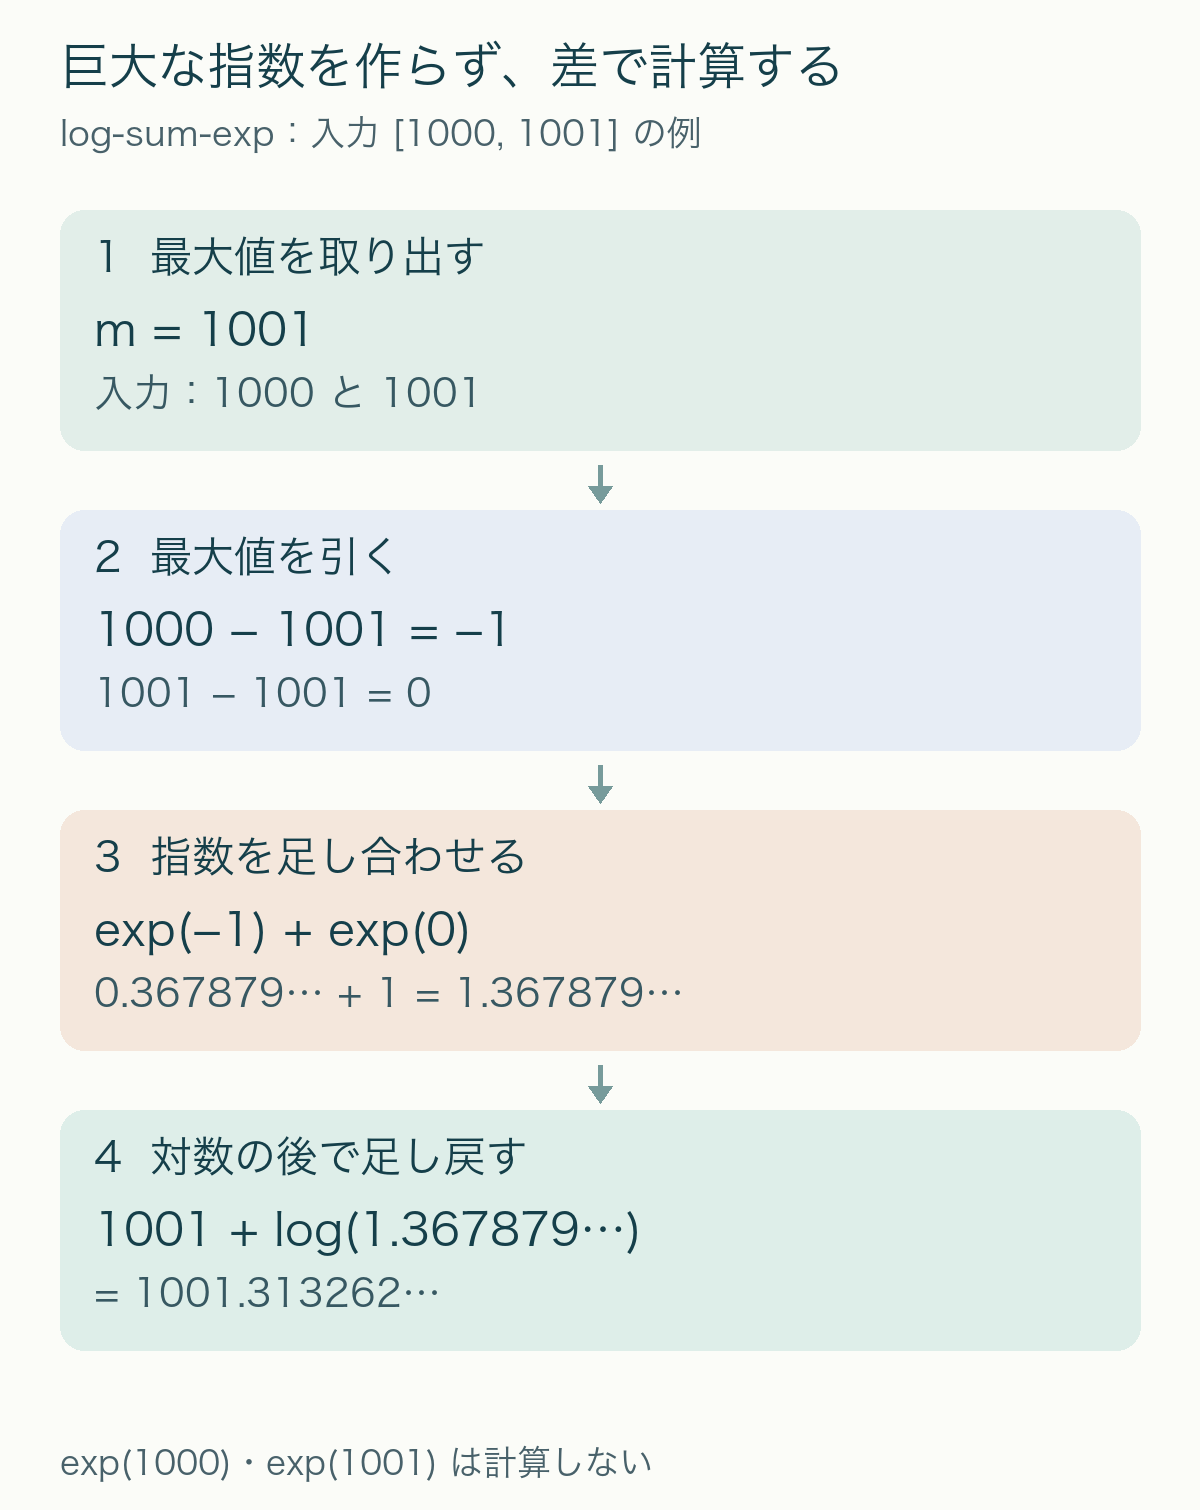
m は最大値なので、すべての xi−m は0以下です。指数関数の値は1以下となり、少なくとも最大値に対応する一つは exp(0)=1 になります。指数の計算が巨大化せず、和が全部0になることも避けられます。
先ほどの [1000, 1001] なら、1001を引いて [−1, 0] にします。指数の値は約 [0.367879, 1]、その和の対数は約0.313262です。最後に1001を足すと、約1001.313262になります。
大きな負の値でも、同じ工夫が役立つ
逆に入力が [−1000, −999] の場合、指数の値は極端に小さくなります。今回の倍精度計算では両方が0に丸められ、直接式は log(0) を計算しようとして失敗しました。これは小さすぎる値を扱えなくなるアンダーフローの影響です。
最大値の−999を引けば、やはり [−1, 0] になります。したがって結果は −999+0.313262、約−998.686738です。
| 入力 | 指数を先に作る直接式 | 最大値シフト後 |
|---|---|---|
| [1000, 1001] | expで桁あふれ | 1001.313262 |
| [0, 1] | 1.313262 | 1.313262 |
| [−1000, −999] | 指数が両方0、logで失敗 | −998.686738 |
表はPython標準ライブラリの math と倍精度の float で確認したものです。直接式では上段が OverflowError、下段が ValueError になりました。別の数値ライブラリでは例外ではなく無限大や警告で知らせる場合もあるため、失敗の表示と数学的な原因を分けて見ます。シフト後の値は、80桁精度の十進計算による直接式とも照合しました。
最大値を引けば、丸め誤差までなくなるわけではない
最大値シフトは中間値の大きさを抑えますが、有限精度であること自体は変えません。たとえば [0, −40] では、指数の和は 1+exp(−40) です。小さい項は約 4.25×10⁻¹⁸ で、倍精度で先に1へ足すと、その差が丸められて1になりました。その後に対数を取ると0です。
この場合は、log1p(s)、つまり「1+sの対数」を小さな s にも配慮して計算する関数が役立ちます。最大の項一つを和から取り出すと、次の形にできます。[1]
LSE(x)=m+log1p(Σi≠k exp(xi−m))
k は最大値を取る位置の一つです。
最大値が複数あっても、取り出すのは一つだけです。たとえば [0, 0] なら、残る項も1なので答えは log(2) です。最大の項をすべて捨てると、異なる計算になってしまいます。
[0, −40] では log1p(exp(−40)) により、約 4.25×10⁻¹⁸ の補正を残せました。ただし、最後に大きな m へ足す段階で微小な差が丸められる場合など、残る精度の限界はあります。
softmaxでは、共通の大きさが分母と分子で消える
softmaxは、各入力の指数を指数の総和で割り、合計1の値へ変換する関数です。こちらも分子と分母から同じ exp(m) を除けます。
softmax(x)i=exp(xi−m) / Σ exp(xj−m)
[1000, 1001] なら、結果は約 [0.268941, 0.731059]。入力の両方へ同じ数を足しても、差は変わらないのでsoftmaxの値は変わりません。一方、log-sum-expの結果は、その共通の数だけ移動します。この違いは、正規化された比率が必要なのか、正規化に使う量の対数が必要なのかを整理するときに役立ちます。
実装では、入力の範囲と集計する軸も決める
仕組みを確かめるため、今回の計算では次の関数を使いました。空でない、有限実数の一次元列に対象を絞っています。
import math

def lse_finite(x):
    x = list(x)
    if not x or not all(math.isfinite(v) for v in x):
        raise ValueError("nonempty finite input required")
    k = max(range(len(x)), key=x.__getitem__)
    m = x[k]
    s = math.fsum(math.exp(v - m)
                  for i, v in enumerate(x) if i != k)
    return m + math.log1p(s)
実際の配列処理では、専用関数の対象範囲も確認します。SciPyの scipy.special.logsumexp は安定した計算を提供し、axis で集計する軸、keepdims で次元を残すかを指定できます。[2] 複数のサンプルを並べた配列なら、各サンプル内で合計したいのか、配列全体を合計したいのかを先に決めます。
負の重みを付けた指数の和は、項が打ち消し合い、和が負になる可能性もあります。また、入力にNaNや無限大があると、単純な「最大値を引く」だけでは扱えません。本稿の有限・重みなしの例と分けて、専用関数の仕様を確認する範囲です。
途中の値が表現範囲に収まるか、収まっていても小さな差が丸められないか。この二つを分けて点検すると、答えだけを見ていたときには気づきにくい数値計算の失敗を見つけやすくなります。
出典
- Pierre Blanchard, Desmond J. Higham, Nicholas J. Higham, Accurately Computing the Log-Sum-Exp and Softmax Functions(本文記載の版:2020年1月31日。式1.3・1.4、4節・Algorithm 4.1)。
- SciPy v1.18.0 Manual, scipy.special.logsumexp(パラメーターと計算対象の説明)。