量子コンピューターで予測モデルを動かすとき、シミュレーション上の精度だけでは実機での振る舞いは分かりません。同じ6量子ビットの計算でも、チップのどこに配置するかによって、読み出した値が変わるからです。
スロバキアのコシツェ工科大学の研究チームは、自動車保険の翌日の請求件数を予測する量子リザバーを、IBM Kingstonで繰り返し評価しました。2026年11月2日公開のプレプリントは、予測が現実にどれだけ合うかと、実機が理想計算をどれだけ再現するかを分け、後者を確かめて配置を選ぶ方法を示しています。
簡単にまとめると?
- 6量子ビットの予測回路を、実機の校正情報と訓練用データによる短い試行で配置しました。
- 21回の組比較では、提案配置の予測誤差はQiskitの比較設定より小さく、ランダム配置で見られた大きな崩れも避けられました。
- 古典的なリッジ回帰が予測誤差では最良でした。今回の焦点は量子優位性ではなく、同じ量子モデルを実機へ移す際の安定性です。
入力の履歴を、量子状態の変化に通す
リザバー計算は、入力を一定のルールで変化する系へ通し、その状態を読み出して予測につなげる方式です。量子リザバーでは、この変化を量子回路で作ります。今回の回路は、当日の物損請求件数、契約件数、翌日の曜日、翌日が祝日か、という四つの入力を4量子ビットに入れ、残る2量子ビットを過去の入力の影響が残る部分として使いました。
量子回路の測定値を、そのまま請求件数とするわけではありません。複数の測定値に重みを掛けて足し合わせる古典的なリッジ回帰が、最後の予測を作ります。この読み出しの重みは、理想シミュレーションの訓練データで学習した後に固定し、実機では学習し直していません。したがって、実機で測定値がずれると、そのずれが同じ重みを通って予測へ現れます。
また、測定は量子状態を乱します。各予測を作る前に最近の入力列を再び与え、履歴に対応する状態を作り直しました。長い履歴を毎回入れ直す設計ほど回路が深くなるため、記憶を長くすることと、雑音に耐えることの両方を考える必要があります。
「当たったか」と「同じ計算になったか」は別
予測誤差には、実際の請求件数と予測値の差を使います。論文の主指標は二乗平均平方根誤差(RMSE)で、単位は1日当たりの件数です。一方、実機への移行で生じるずれには、実機の予測値と、同じモデルの理想シミュレーションの予測値の差を使います。こちらも二乗平均平方根でまとめていますが、比較相手が違います。
例えば、実際の請求が20件の日に、理想計算が17件、実機が19件と予測したとします。実機の方が現実には近くても、理想計算からは2件分ずれています。この一例だけで、実機が量子計算を正確に再現したとは言えません。論文でも、一部のモデルでは、もともとの過小予測と実機による上向きのずれが部分的に打ち消し合っていました。
この区別は配置選びにも使われます。テスト期間の正解に合わせて配置を選ぶのではなく、訓練期間の入力を使って、理想計算からのずれが小さい配置を選びました。
校正情報で絞り、短い実機試行で選ぶ
研究チームは、チップに元からある接続で回路を組める配置を列挙しました。量子ビットを入れ替えるSWAP操作を増やさずに済む候補です。その中から、ゲートや読み出しの校正誤差と実際の操作回数を使って6候補へ絞り、雑音を含むシミュレーションで2候補を選びます。
最後に、訓練期間の100時点の入力を実機で試し、理想予測からのずれが小さい方を採用します。個々の部品の誤り率だけで決めず、組み上げた予測回路で何が起きるかを短く確かめる段階を加えた形です。
| 配置方式 | 選び方 | 今回の比較で見る点 |
|---|---|---|
| ハードウェアを考慮した提案方式 | 校正情報、雑音シミュレーション、訓練用入力による実機試行 | 選択に追加費用が掛かる代わりに、回路全体の予測のずれを見て選ぶ |
| ランダムな接続適合配置 | 故障扱いの量子ビットを避け、接続に合う配置から選ぶ | 良い配置も引けるが、結合器の品質では順位を付けない |
| Qiskitの配置 | 最適化レベル1で選ばれた配置を固定 | 今回の比較対象。Qiskitの全設定やすべての配置手法を代表するものではない |
大きな崩れを減らせたが、常に最良ではない
実験では5種類の量子リザバーを固定し、5日間で21回の組比較を行いました。各回に3方式を試すため、全体で63回の実機評価です。使う回路は6量子ビットで、156量子ビットを持つKingston全体を一つの予測モデルとして使ったわけではありません。
提案方式は、21回すべてでQiskitの比較設定より予測RMSEが小さく、理想計算からのずれも18回で小さくなりました。ずれの最大値は提案方式が7.59件/日、Qiskitが11.84件/日でした。ただし、ランダム配置との比較では、提案方式の予測RMSEが小さかったのは12回です。良いランダム配置が同等以上に働く場合もあります。
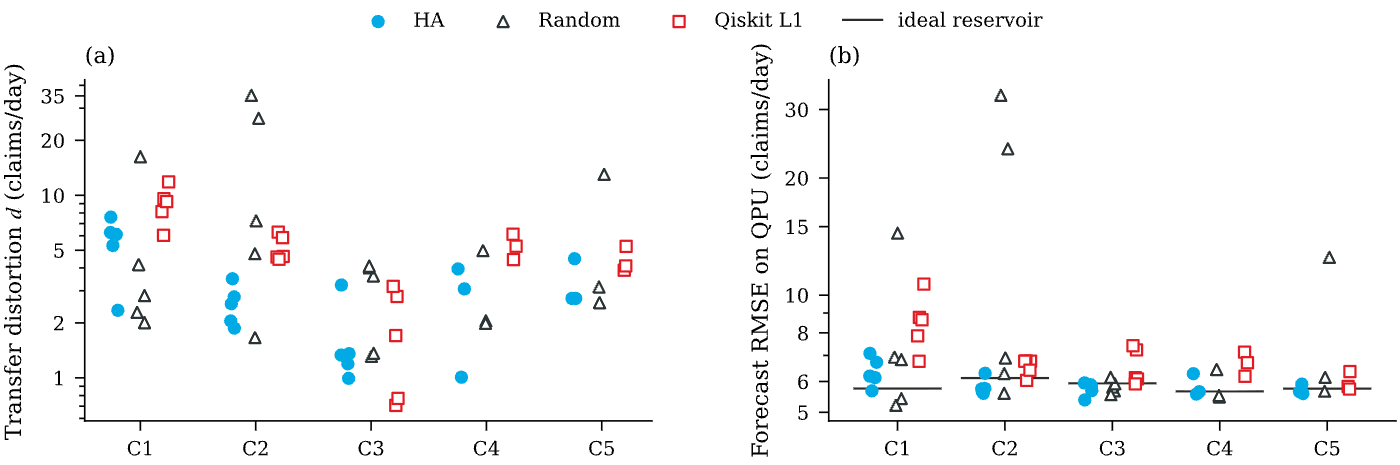
図で目を引くのは、ランダム配置の一部で大きなずれが出ることです。4回の深刻な例では、理想予測からのずれが約13〜35件/日に達しました。これらには、校正で大きな誤差が報告された結合器が含まれていました。今回の提案方式の価値は、毎回の平均的な予測を大幅に良くすること以上に、このような配置による大きな崩れを避けた点にあります。
古典モデルとの比較と、追加の実行費用
テストは2026年1月1日から8月20日までの232日で、訓練は2022〜2024年、モデル選択用の検証は2025年と、時間順に分けています。理想的な量子リザバーのRMSEは5.66〜6.12件/日で、古典的なリッジ回帰の5.36件/日が最良でした。5候補中4候補は、論文のブロック・ブートストラップによる95%信頼区間でリッジとの差が有意とは判定されませんでしたが、これは同じ性能が証明されたという意味ではありません。
実機では時間も掛かります。232日分の評価に要したQPU時間の中央値は、短い履歴の候補で約256〜264秒、長い履歴の候補で約476秒または725秒でした。これは待ち行列を含まない値で、提案方式の配置選択にはさらに実機試行と古典計算が必要です。実機試行だけでもQPU時間を約11%増やしています。予測が安定したという結果と、古典計算より速い・安いという結果は分けて読む必要があります。
次の実装でも確かめたいこと
今回のデータは一つの保険契約集団で、テスト期間も1年に届きません。実機比較は一つのプロセッサーで各候補3〜5回に限られ、配置選択から実行までの間に校正が変わった評価も63回中40回ありました。提案方式は実機試行の後に投入されるため、比較方式と完全に同時刻の測定でもありません。結果を一般化するには、別のデータや装置でも調べる必要があります。
予測モデルを実機へ移す際には、現実に対する予測誤差、理想モデルからのずれ、配置を選ぶ費用を別々に記録することが役立ちます。短い実機試行で「どの配置なら、意図した予測を保ちやすいか」を確かめる発想は、その比較を具体的にします。
実験で使われた量子計算基盤の提供企業については、CyclewaveのIBMの企業解説も参考になります。