AIの計算では、掛け算や足し算を速くするだけでなく、計算に使う値をメモリーから運ぶ時間とエネルギーも問題になります。そこで、値を保存する場所に計算の一部を近づけるのが、インメモリー・コンピューティング(IMC)です。
国立陽明交通大学(NYCU)のTuo-Hung(Alex)Hou氏は、OCP APAC 2026の講演で、メモリーを高密度化する技術と、メモリーの中で計算する技術を紹介しました。ここでは、その中のアナログIMCに注目します。SRAMに保存した重みを使って並列に計算する研究から、データ移動を減らせる理由と、回路のばらつきが新たな課題になる理由が見えてきます。[1]
簡単にまとめると?
- 運ぶデータ量に対して計算が少ない処理では、計算器よりメモリーとのやり取りが性能を制約しやすくなります。
- アナログIMCは、メモリーに保存した重みと電流などの物理量を使い、掛け算と足し算をまとめて進めます。
- 紹介された512kbのSRAMマクロは三値の重みを使うCNN向けの研究で、サーバー全体や任意のAIモデルの効率を示すものではありません。
- 回路のばらつきや数値の丸め方を含め、ハードウェアと学習モデルを一緒に設計する必要があります。
計算量だけでなく、データを何度使えるかを見る
メモリーから取り出した値を、何度も計算に使える処理と、一度使って次の値を取りに行く処理では、必要な仕組みが違います。この違いを見る目安が「演算強度」です。講演では、データを何バイト転送する間に何回の浮動小数点演算を行うか、という比率で説明しています。[1]
演算強度が低いと、計算器が速くても、値が届くのを待ちやすくなります。反対に、取り出した値を多くの計算に使い回せれば、計算器の能力が制約になりやすくなります。講演のルーフラインモデルは、演算器の上限と、メモリー帯域に演算強度を掛けた上限のうち、低い方で性能が制約されると整理しています。
例に挙げられるのは、行列同士を掛けるGEMMと、行列とベクトルを掛けるGEMVです。前者は値を再利用しやすく、後者は計算に対して運ぶ重みが多くなりやすい、という違いがあります。LLMでも、入力をまとめて処理するプリフィルと、次のトークンを生成していく処理では、計算と転送の釣り合いが変わります。
ただし、演算の名前だけで実際の律速は決まりません。行列の大きさ、数値の精度、同時に処理する件数、どこに値が保持されているかで再利用の程度は変わります。IMCを考える入口は、「AIだから有効」と決めることではなく、対象の処理でどのデータ移動が負担なのかを確かめることです。
SRAMに保存した重みを、その場の計算に使う
IMCのうち、アナログIMCは電流などの連続的な物理量を計算に使います。AIで繰り返し現れる積和演算、つまり入力と重みを掛けて、その結果を足し合わせる処理を、メモリーの配列で並列に進める考え方です。[1]
講演は、その具体例として、ITRIとNYCUなどの研究者による2021年のSRAM内演算回路を紹介しています。SRAMは、電源が入っている間、回路の状態として値を保持するメモリーです。この研究では512kbのSRAMマクロ、すなわちチップ内でひとまとまりになったメモリー回路を用い、三値の重みを使う畳み込みニューラルネットワーク(CNN)を対象にしています。三値は重みを三つの値に絞る表現で、任意の浮動小数点数をそのまま扱う方式ではありません。[1][2]
次の図では、保存した重みを表すWPとWN、入力DIN、電流IPとIN、そして二つの電流を比較するCSAが一つの回路として描かれています。下部の「IP > IN = 1」は、比較結果を二値の出力に変える動作を示します。重みを外の演算器へ一つずつ取り出すのではなく、保存場所にある回路の応答を使う点が、データ移動を減らす仕組みにつながります。
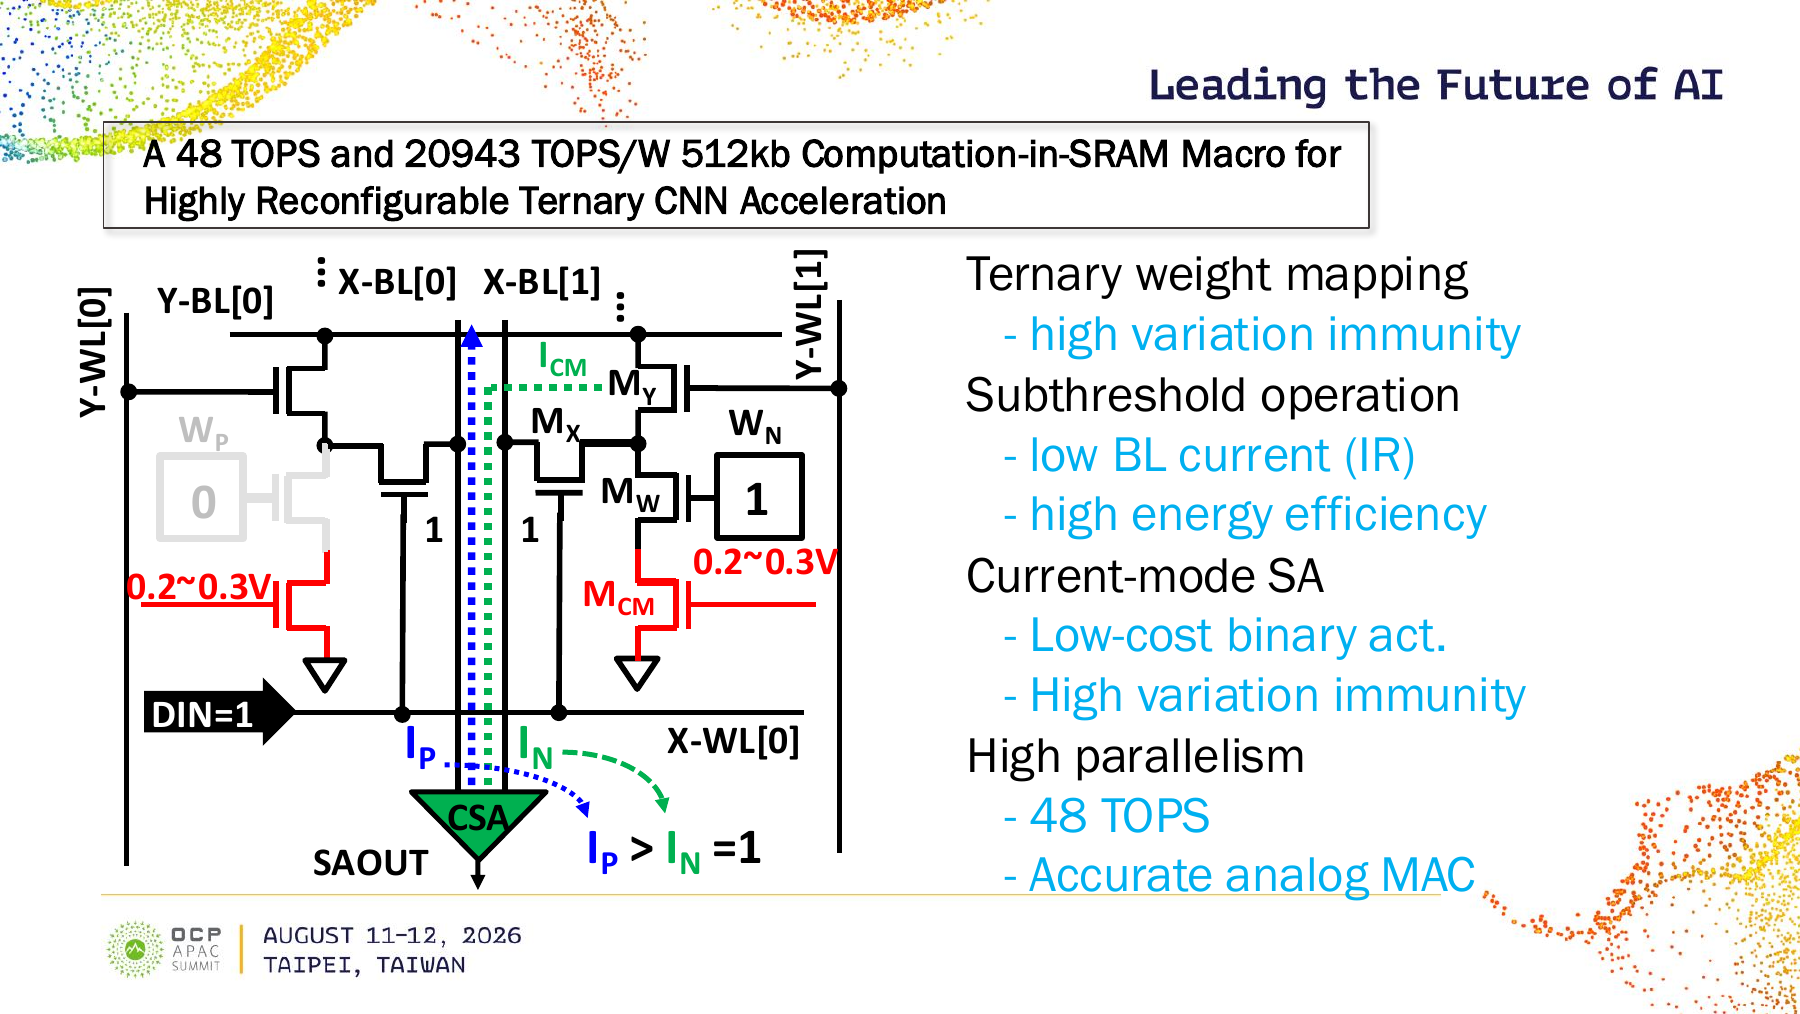
図の右側は、三値の重みへの割当て、弱い電流を使うサブスレッショルド動作、電流型センスアンプ、並列性を、それぞれの設計上の狙いと結び付けています。サブスレッショルドは、トランジスタを強くオンにする領域よりも低い電圧側の動作を利用することです。センスアンプは小さな電流や電圧の違いを読み取る回路で、ここでは電流を比較して二値の活性化出力を作ります。図中の0.2〜0.3Vは示された回路部分の動作説明であり、システム全体の電源条件には読み替えられません。
大きな効率の数値には、計算の条件が付いている
講演は、この512kbマクロを28nmの10トランジスタSRAMとして紹介し、論文題名には48TOPSと20,943TOPS/Wが掲げられています。TOPSは毎秒の演算回数を兆回単位で表し、TOPS/Wは消費電力当たりの演算性能を表す指標です。[1][2]
ここで評価の対象になっているのは、三値の重みを使う特定の研究マクロです。周辺の制御、データの入出力、モデル全体の処理まで含むサーバーの効率ではありません。また、講演に並ぶ二つの数値が同じ動作点で同時に得られると仮定して、消費電力を逆算することもできません。
これらの数値は、メモリー配列内で多くの演算を並列に進める可能性を示します。ただし、精度や演算の数え方が異なるGPUの指標と、そのまま大小を比べるのは適切ではありません。自分のモデルに使えるかを見るには、必要な数値精度と認識精度を保てるか、周辺処理を含めてどれだけデータを運ぶかを、同じ条件で確かめる必要があります。
回路の誤差を、学習モデルの設計にも戻す
デジタルの値をアナログ回路に対応させると、素子ごとのばらつきが計算結果に影響します。講演は、製造ばらつき・電源電圧・温度をまとめたPVT、配線の抵抗による電圧降下、アナログとデジタルをつなぐ変換回路のばらつきなどを、アナログIMCで考慮する項目に挙げています。[1]
同時に、メモリーの配列の大きさは有限です。モデルの重みをどう配列へ割り当てるか、数値を何ビットで表すか、どの処理を配列の外に残すかによって、回路の利用率や精度が変わります。積和演算だけが速くなっても、その前後の処理や配列間の転送が重ければ、モデル全体の改善は小さくなります。
このため、講演が示すのは、回路だけを作って最後にモデルを載せる方法ではなく、ハードウェアとソフトウェアの協調設計です。例えば、回路に生じるばらつきを学習時の条件にも取り込み、数値の表し方やモデルの構成を合わせて考えます。これは誤差が消えるという意味ではなく、実際の回路で許容できる精度を得るための設計です。
アナログIMCの価値は、計算の場所を変えることで、従来のメモリーと演算器の往復を減らせる点にあります。その一方で、計算結果を物理量に託す難しさも引き受けます。今回の研究を読むときは、回路内の高い並列性と、モデル全体で必要な精度・転送・周辺処理を、一続きの条件として見ることが大切です。
参考資料
- Tuo-Hung(Alex)Hou, Intelligent Memory: The Green Evolution of Silicon, OCP APAC 2026。参照箇所:pp.10–13, 27–31, 37。図1はp.30。公開情報:OCP公式講演資料一覧。
- Chih-Sheng Linほか, A 48 TOPS and 20943 TOPS/W 512kb Computation-in-SRAM Macro for Highly Reconfigurable Ternary CNN Acceleration, A-SSCC 2021。著者・題名・DOIは国立清華大学の書誌記録で照合。本文の回路説明と図の直接の参照元は[1]の公開講演資料。