タグ: データセンターネットワーク

  • MetaのIceCubeは102.4 Tb/sへ、IcePackで進めるネットワークの液冷化

    MetaのIceCubeは102.4 Tb/sへ、IcePackで進めるネットワークの液冷化

    AI向けのデータセンターでは、計算する装置だけでなく、その間でデータを運ぶネットワークにも熱が集まります。通信の容量を増やすとき、スイッチを何台置けるかに加え、その熱をどう外へ運ぶかが設計の条件になります。

    Metaが2026年10月12日のOCP Global Summitに合わせて紹介したIcePackとIceCubeは、この変化を表す組み合わせです。IcePackは液体冷却を使うネットワーク用ラック、IceCubeはその中に収めるスイッチの装置です。Metaの従来の51.2 Tb/s世代に対し、IceCubeは102.4 Tb/sへとスイッチ容量を倍増させています。通信を増やす変化と、それを支える冷却の変化を組み合わせた発表です。

    簡単にまとめると?

    • IcePackはラック、IceCubeはスイッチです。Metaはネットワーク機器にも液体冷却を取り入れる構成を示しました。
    • IceCubeの102.4 Tb/sは、800 Gb/sの通信128系統に相当するスイッチ容量です。AIの学習速度そのものではありません。
    • 導入の比較では、通信容量と、電力・冷却・保守の条件を組み合わせて確認します。

    スイッチの発熱も、ラック全体で受け止める

    ネットワークスイッチは、到着したデータを行き先に応じたポートへ送り出す機器です。AI計算を多数の装置で分担すると、その間で結果や途中のデータを交換します。計算装置を増やすだけでなく、その交換を支える経路も用意する必要があります。

    通信容量と機器密度を高めれば、ラックに収める機器の電力や発熱も確認の対象になります。たとえば、同じ床面積により多くの通信装置を置けても、施設側で熱を受け取れなければ、その配置をそのまま運用できるとは限りません。これは設計条件を説明する例で、IcePackの実測値を示したものではありません。

    Metaの発表では、IcePackはORv3-HPR v1を基にした同社初の液体冷却ネットワークラックとされています。ORv3は、機器を収める枠と給電を共通化するOpen Rack V3の系統です。HPRは高い電力を扱う構成に当たり、スイッチ単体の容量だけでなく、ラック側の受け入れ条件も関わります。

    102.4 Tb/sは何を表すのか

    IceCubeについて、Metaは800 Gb/sの通信128系統に相当する、102.4 Tb/sのノンブロッキングなスイッチ容量を示しています。十進の単位で計算すると、128×800 Gb/sは102,400 Gb/s、つまり102.4 Tb/sです。ここでのbはビットで、ファイル容量などに使うバイトとは異なります。

    ノンブロッキングという説明は、対応するポート構成の通信をスイッチ内部で扱える容量に関わります。ただし、これだけで通信経路全体に混雑が起きないと保証されるわけではありません。複数の送信元が同じ受信先へ集中した場合には、その先のリンクや受信装置にも制約があります。

    たとえば、各リンクが800 Gb/sの構成でも、1台の受信装置へ同時に集まる通信は、その装置につながる経路や処理能力に左右されます。スイッチ全体の容量を、一つの通信や一つのAIジョブが自由に使える速度として読むと、比較を誤ってしまいます。

    熱を受け取る板と、液体を分ける配管

    冷却の考え方を追う手掛かりとして、Metaはネットワーク機器の公開要求書も示しています。その液冷の項では、スイッチASICという通信処理用の半導体と、光信号を扱う光モジュールをコールドプレートで冷やすことを求めています。コールドプレートは、部品から受け取った熱を内部の冷却液へ移す板状の部品です。

    各装置からの配管は、ラック側のマニホールドにつながります。これは液体を各装置へ分配し、戻ってきた液体を集める配管です。要求書では、装置を差し込む動作で背面の接続部が合うブラインドメイト式の接続と、装置ごとに独立した冷却・給電を挙げています。通信ケーブルだけでなく、冷却液の往復経路と交換作業までラック設計に含めるわけです。

    これはMetaの機器を受け入れるための共通要求であり、IceCubeの全項目が試験済みだと示す成績表ではありません。また、他の部品には空冷を選べるため、液冷スイッチという名称だけからファンのない装置を想像するのは早計です。

    冷やせることと、仕事が速くなることを分ける

    液体冷却の導入は、密度が高い場所から熱を運び出すための設計の一部です。それだけで、あるAIの仕事が何倍速くなるかは決まりません。計算装置の処理、通信の頻度と分布、データの受け取り、ソフトウェアによる待ち合わせなどが、完了までの時間に関わるからです。

    比較の際には、まず同じ仕事を同じ完了条件で動かすことをそろえます。そのうえで、通信が混雑しているのか、計算装置が待っているのか、電力や温度の条件で動作が制限されているのかを分けて調べます。スイッチ容量の増加が役立つ場面と、別の条件が先に制約になる場面を見分けるためです。

    ラックを受け入れる側では、冷却液の供給と戻り、流量や入口温度、接続方法、保守時の取り外し方が判断材料になります。たとえば、同じ通信容量の装置を比べる場合でも、施設から供給できる液温や流量に合わなければ、ラック以外の設備にも変更が必要になります。

    新しい発表から読み取れる変化

    IcePackとIceCubeの発表から読み取れるのは、AI基盤を支えるネットワークも、通信装置とラック設備をまとめて設計する対象になっていることです。通信容量が増えたという数字と、その容量を収めるための熱・電力の条件を一緒に見ると、何が新しく、何を追加で確認すべきかが見えます。

    今回の発表はMetaによる設計の紹介です。特定の業務での速度や消費電力の優位を立証した、独立した比較試験とは分けて扱います。導入判断に使う場合は、公開仕様、実際に選べる構成、施設との接続条件、同じ負荷での測定をそろえることが次の段階になります。

    Metaが広告事業から得た収益をAI基盤へ振り向ける背景は、CyclewaveのMetaの企業解説でも紹介しています。

    出典

  • CiscoのScheduled Fabric、出口で詰まる通信を入口で待たせる仕組み

    CiscoのScheduled Fabric、出口で詰まる通信を入口で待たせる仕組み

    GPUクラスターの通信が遅いとき、回線を増やす前に切り分けたいことがあります。宛先が受け取り切れないのか、それとも空いている経路があるのに、一部の経路へ通信が偏っているのか。この二つでは、必要な対策が変わります。

    CiscoのOCP Korea 2026講演は、通信を複数の経路へ分散し、出口で順序を戻す「Schedule Fabric」を図示しています。本稿では、その背景にあるScheduled Ethernetの公式解説を合わせて読み、どの通信を、どこで待たせる設計なのかを確かめます。[1][2]

    簡単にまとめると?

    • 経路が空いていても、宛先の出口が満杯なら送信量の調整が必要です。入口の待ち行列を宛先別に分けると、待つべき通信を区別できます。
    • Scheduled Ethernetは、入口での送信許可、複数経路への分散、出口での順序復元を組み合わせます。
    • 物理的な出口容量やバッファの上限は残ります。導入時は、混雑していない宛先への通信が巻き添えになるかを比較することが有用です。

    経路の偏りと、宛先の容量不足を分ける

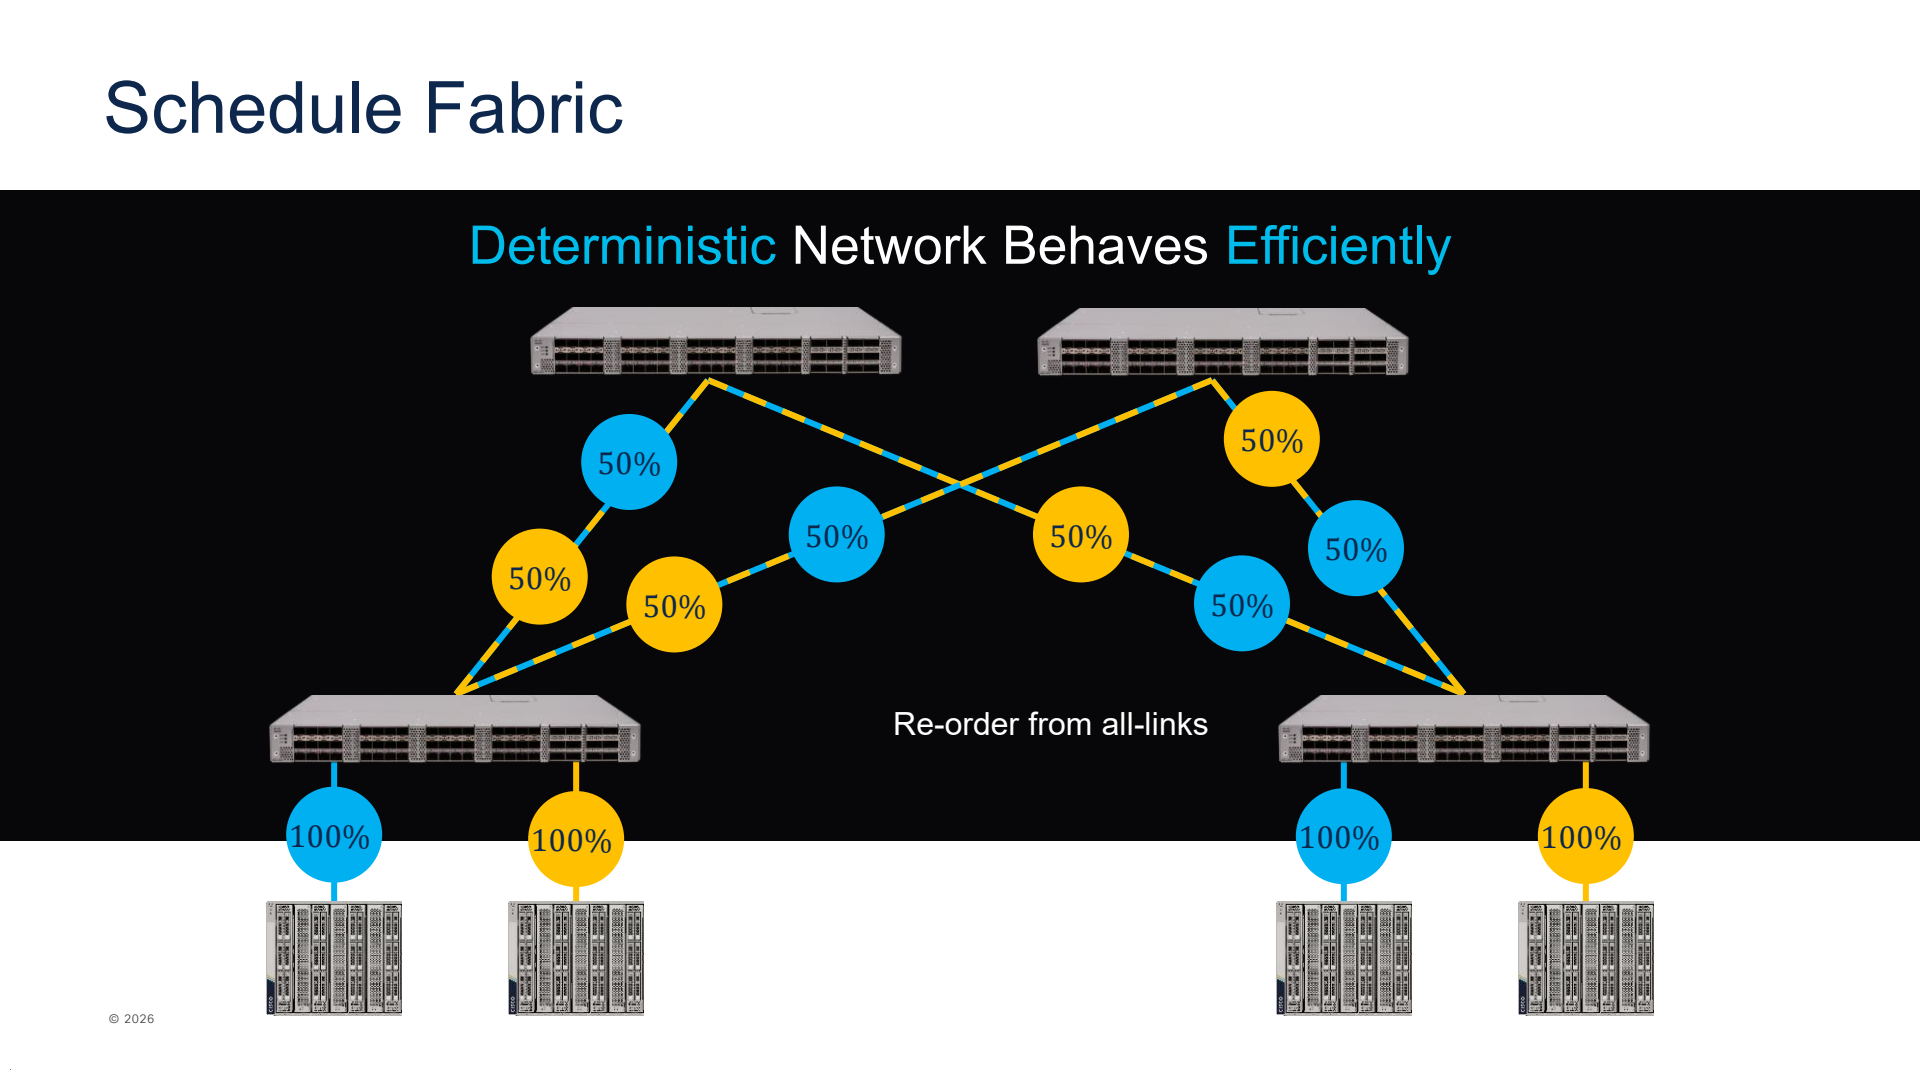
    通常のECMPは、同じ通信フローのパケットを同じ経路へ振り分けることで、順序を保ちやすくします。ただし、別々の大きなフローが同じ経路を選ぶと、他の経路に余裕があっても局所的な混雑が生じます。Ciscoの講演資料17ページは、この偏りを青と黄色の通信で表しています。[1][2]

    この場合、経路を均等に使えれば改善の余地があります。一方、複数の送信元が同じ一つの出力ポートへ、そのポートの容量を超えて送り続ける場合は別です。途中を何本に分けても、最後の出口を通れる量は増えません。両者を同じ「ネットワークが遅い」という観測だけで扱うと、増設する場所や試験条件を誤りかねません。

    出口別の待ち行列に、送信許可を出す

    公式解説でScheduled Ethernetを構成する要素の一つが、入口スイッチのVOQ(Virtual Output Queue、仮想出力キュー)です。宛先の出力ポートと通信の優先度区分ごとに、パケットの待ち行列を分けます。キューにデータが入ると送信を要求し、スケジューラーが帯域と優先度の方針に基づいて許可を返します。混雑している出口へ向かうパケットは、許可が出るまで入口に残ります。[2]

    仕組みを考えるため、二つの送信元A・Bが出口Xへ集中し、別の送信元Cは出口Yへ送る例を置きます。Xが処理し切れない通信まで途中の共用リンクへ流すと、同じリンクを通るCの通信も影響を受けます。X向けを入口で待たせ、受け入れ余地があるY向けには送信機会を与えれば、この巻き添えを抑える方向に制御できます。これは説明用の例であり、特定装置で測定した結果ではありません。

    着目するのは、X向けの待ち時間を消すことではなく、Xの混雑を理由にY向けまで待たせる範囲を小さくすることです。同じ入口に到着しても行き先別にキューが分かれている意味が、ここにあります。

    経路を分けた後は、出口で順序を戻す

    送信を許可されたパケットは、フロー単位の経路固定に頼らず、利用可能な複数の経路へ分散します。経路ごとの遅延が異なるため、出口側では同じフローのパケットを並べ直します。講演資料18ページの原図では、青と黄色の通信が双方の中継スイッチを通り、右側で合流する構成になっています。[1][2]

    Cisco講演のSchedule Fabric図。青と黄色の通信を二つの中継経路へ分け、出口側で順序を復元する。図中の50%と100%は説明用の配分。
    図1 青と黄色の通信を経路へ分散し、出口側で順序を戻す模式図。図中の50%・100%はこの図の配分を表し、一般的な実測値や性能保証ではありません。出典:Chih-Tsung Huang(Cisco)「Mixture of AI Factories: Open, Scalable, Efficient」、OCP Korea 2026、p.18。原資料の表記・著作権表示を保持。図を拡大。小さい画面では図を横にスクロールできます。講演資料。

    この図だけでは、入口にある待ち行列や送信許可のやり取りは見えません。経路分散と順序復元の図に、前節のVOQと送信許可を合わせることで、空いた経路を使う制御と、混雑した出口へ送り過ぎない制御を区別できます。

    導入判断では、混雑の「巻き添え」を測る

    評価するなら、まず同じ装置間構成と通信量で、出口ごとの負荷に余裕がある条件を比べます。ここで通信完了が遅れるなら、経路の偏りが候補になります。次に一つの出口へ通信を集中させ、別の出口への小さな通信も同時に流します。後者の完了時間がどれだけ延びるかを見ると、合計スループットだけでは隠れる干渉を確かめられます。これは本稿からの試験設計上の提案です。

    入口のキューに待ちが移る以上、待機量、あふれによる損失、送信元への制御も合わせて見る必要があります。出口の需要が容量を超え続ける状況を、スケジューリングだけで解消することはできません。Ciscoの解説も、入口から中継側へ出る合計帯域の条件を置き、パケット損失が生じ得る場所として入口を挙げています。[2]

    さらに、VOQ・送信許可・順序復元が対象機器と構成で一体として動作することが前提です。2024年更新の公式解説では、そこで扱うScheduled Ethernetの構成に、単一クラスター内のベンダー間相互接続の制約が示されています。現在の候補機器で同じ制約があるかは、対応モードや接続条件として確かめる必要があります。一般のEthernetスイッチへ、同じ制御をそのまま追加できるとは限りません。[2]

    Scheduled Fabricを選ぶ際の問いは、「速い方式か」だけでは足りません。経路の偏りを減らしたいのか、混雑した宛先の影響を他へ広げたくないのか。その課題と、入口で待つ量・出口の容量・機器構成の条件が合っているかで判断することができます。

    参考文献

    1. Chih-Tsung Huang(Cisco)「Mixture of AI Factories: Open, Scalable, Efficient」、OCP Korea 2026、全21ページ。本文では主にpp.17–18を参照。イベント公式資料一覧。
    2. Cisco「Evolve your AI/ML Network with Cisco Silicon One」、2024年5月8日更新。「Scheduled Ethernet」「Comparing interface options」ほか。講演図の機構を補う公式解説として参照し、モデル比較の速度倍率は本稿の性能予測に用いていません。
  • AcrylのGPUBaseとPeRF、短いRDMA通信の待ち時間を抑える仕組み

    AcrylのGPUBaseとPeRF、短いRDMA通信の待ち時間を抑える仕組み

    複数の利用者でGPUクラスターを共有するとき、応答を急ぐ処理と、大量のデータを送り続ける処理が同じネットワークを使うことがあります。ジョブの優先順位を高くしても、その先にある通信装置で順番を待つなら、応答の遅さは残ります。計算資源を割り当てる順番と、データを送る機会は、別々に考える必要があります。

    AcrylはGPU管理ソフトウェアGPUBaseについて、ジョブの実行管理、ネットワーク内の制御、ホスト側の通信装置という三つの層で優先度を扱うと説明しています。そのうちホスト側で挙げるのがPeRF(Preemption-enabled RDMA Framework)です。講演資料と、同社などの研究者による2024年の原論文から、通信の待ち時間に介入する仕組みと条件を確かめます。[1][2]

    簡単にまとめると?

    • ジョブの優先順位を決めるだけでは、すでに通信装置へ渡した転送の順番までは変わりません。
    • PeRFは大きな転送を小分けにし、通信キューを停止・再開することで、別の処理へ送信機会を渡します。
    • 短い通信の遅延、長い転送の速度、CPU負荷を一緒に比較します。対応する通信機器・ドライバーや、ネットワーク内の混雑は別途確認が必要です。

    GPUの割り当ての先にも、通信の順番がある

    RDMAは、相手側のメモリーへデータを直接読み書きするための通信方式です。アプリケーションが通信要求をキューへ渡すと、RDMA対応のネットワーク装置であるRNICが転送を進めます。この送受信キューの組をQP(Queue Pair)、キューに入れる処理要求をWR(Work Request)と呼びます。[2]

    問題は、利用者ごとに使うQPの数や、送るデータの大きさが違うことです。論文で調べたRNICは、QPを順に巡って処理します。同じ利用者が多数のQPを使えば送信機会を多く得やすく、大きなデータを送る処理と短い通信をする処理が混在すると、短い通信にも待ち時間が生じます。GPUの使用割合だけでは見えない、共有通信装置での干渉です。[2]

    たとえば論文の基本実験は、1MBのメッセージを連続送信する処理と、16Bの短いメッセージを送る処理を組み合わせています。これは通信の干渉を調べる人工的な負荷であり、16BがLLMの応答全体を表すわけではありません。比較したいのは、同居する長い転送を止めずに、短い通信の完了をどこまで早められるかです。[2]

    長い転送の途中に、別の通信が進める区切りを作る

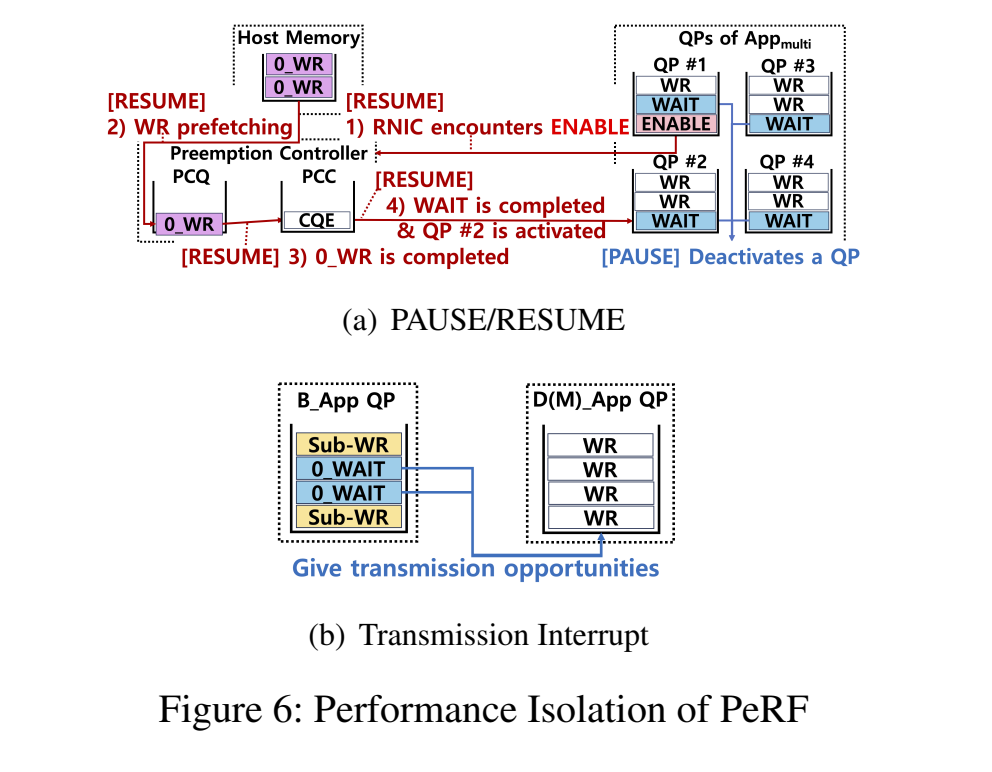
    PeRFの一つ目の操作は、大きな通信要求を複数の小さな要求へ分け、その間に0_WAITという制御要求を挟むことです。論文の標準設定では分割単位を16KBとしています。RNICが0_WAITへ到達すると、その制御要求は直ちに完了し、現在のQPから別のQPの処理へ移ります。名前にWAITとありますが、一定時間眠らせる仕組みではありません。[2]

    図1の下段では、大きな要求がSub-WRに分けられ、間に入る0_WAITから、右側の短い通信へ送信機会が渡ります。長い転送を最後まで一続きに扱う代わりに、他の通信が進める区切りを作る、という考え方です。すでに回線へ出たパケットを取り戻したり、学習ジョブを最初からやり直したりする操作ではありません。

    PeRFの二つの操作。上段はWAITとENABLEによるQPの停止と再開、下段は大きなWRを分割し0_WAITを挟んで別QPへ送信機会を渡す。
    図1 PeRFの原論文Figure 6。上段は通信キューの停止・再開、下段は大きな転送を分けて別のキューへ送信機会を渡す操作。出典:Sugi Leeほか「PeRF: Preemption-enabled RDMA Framework」、USENIX ATC ’24、p.213、Figure 6。著作権は著者に帰属。 原論文/図を拡大。

    二つ目は、QPを多く使う利用者に対して、同時に動くQPの数を調整する操作です。図1の上段にあるWAITとENABLEを組み合わせ、一部のQPを停止させ、停止中のQPを順番に再開します。QPを増やした利用者が、その数だけ通信装置を占有しやすくなる状況を抑えます。単に全利用者の送信を強く絞るのではなく、装置が処理できる量も見ながら動くQP数を調整する設計です。[2]

    細かく切り替えるほどよい、とは限らない

    分割単位を小さくすれば、他の通信へ機会を渡しやすくなります。一方で、扱う要求が増えるためCPU側の処理負担が増し、転送速度を落とす場合があります。逆に分割単位を大きくしすぎると、切り替えの間隔が長くなり、短い通信の遅延や処理速度が変動しやすくなります。論文の付録は、この調整を性能とCPU効率のトレードオフとして説明しています。16KBをすべての環境に適した推奨値と読むことはできません。[2]

    導入前の比較では、同じ機器、同じQP数、同じ通信サイズで、単独実行、混在実行、制御を有効にした混在実行を並べると、この違いを確かめやすくなります。短い通信は平均だけでなく、遅い側の応答も見ます。同時に、大容量転送が一定時間に運べた量とCPU使用量を測れば、待ち時間の改善にどの程度の負担を払ったかを判断できます。これは論文の分離した負荷実験と調整項目を、自分の環境の比較へ置き換える考え方です。[2]

    アプリの改修不要でも、導入条件は残る

    PeRFの論文実装は、ユーザー空間のRDMAドライバーlibmlx5へ変更を加えています。著者が公開する実装の検証環境は、Ubuntu 20.04、NVIDIA Mellanox ConnectX-4/5/6、MLNX_OFED 4.9系です。アプリケーションのコードを変更しない設計と、現在の装置やドライバーでそのまま使えることは区別する必要があります。[2][3]

    また、PeRFが調整するのはホスト側のRNIC資源です。スイッチを含むネットワーク内で混雑が起これば、その待ち時間まで消えるわけではありません。論文は既存の輻輳制御と組み合わせる位置づけを示し、混雑下では遅延が増えることも報告しています。[2]

    通信機能の対応範囲にも注意が要ります。2024年の論文では、使用するWAITとENABLEがUDというデータグラム方式では使えず、対応を今後の課題に挙げています。これは当時の研究実装の制約です。現在のGPUBaseがどの構成まで対応するかは、製品側の確認と、自分たちの通信方式での検証が必要になります。[2]

    GPUBaseの講演資料は大きな性能改善値を掲げていますが、今回確認した資料だけでは、自分の学習・推論処理で同じ効果が得られるとは判断できません。PeRFの論文は通信制御の仕組みと試験条件を確かめる材料であり、GPUBaseを導入したLLMサービス全体の応答時間を保証する試験ではありません。[1][2]

    GPUを追加する前に、待っているのが計算の開始なのか、ホストからの送信なのか、ネットワーク内の転送なのかを分ける。そのうえで、短い通信を早めながら、大きな転送も必要な速度で進められるかを比べる。PeRFは、GPU共有の評価に「同居する通信同士の待ち方」を加えるための、具体的な手がかりになります。

    検証環境に登場するNVIDIAの事業や製品領域については、CyclewaveのNVIDIA企業ガイドで紹介しています。

    参考文献

    1. Ikjun Yeom / ACRYL Inc.「Beyond GPU Management: Optimizing GPU Cluster Networks with GPUBase」、OCP Korea Tech Day 2026。公開講演資料(PDF全22頁)、特にPDF 6、7、11、19–20頁。公式講演一覧。
    2. Sugi Lee、Mingyu Choi、Ikjun Yeom、Younghoon Kim「PeRF: Preemption-enabled RDMA Framework」、2024 USENIX Annual Technical Conference。原論文PDF、特に§2–5、Figure 6、Appendix A・D。著者・書誌情報。
    3. PeRF著者公開実装、acryl-aaai/perf README、Tested Environment、Configuration。2026年10月12日確認。
  • gNMIで異常を捉え、IOAMで経路を調べる――WooriNetの連携案

    gNMIで異常を捉え、IOAMで経路を調べる――WooriNetの連携案

    AIの学習を複数の拠点で動かすとき、一部の通信が遅れて処理の完了を待たされることがあります。回線の平均使用率を見るだけでは、遅い通信がどの経路を通り、どこで待っていたのかまで分からない場合があります。

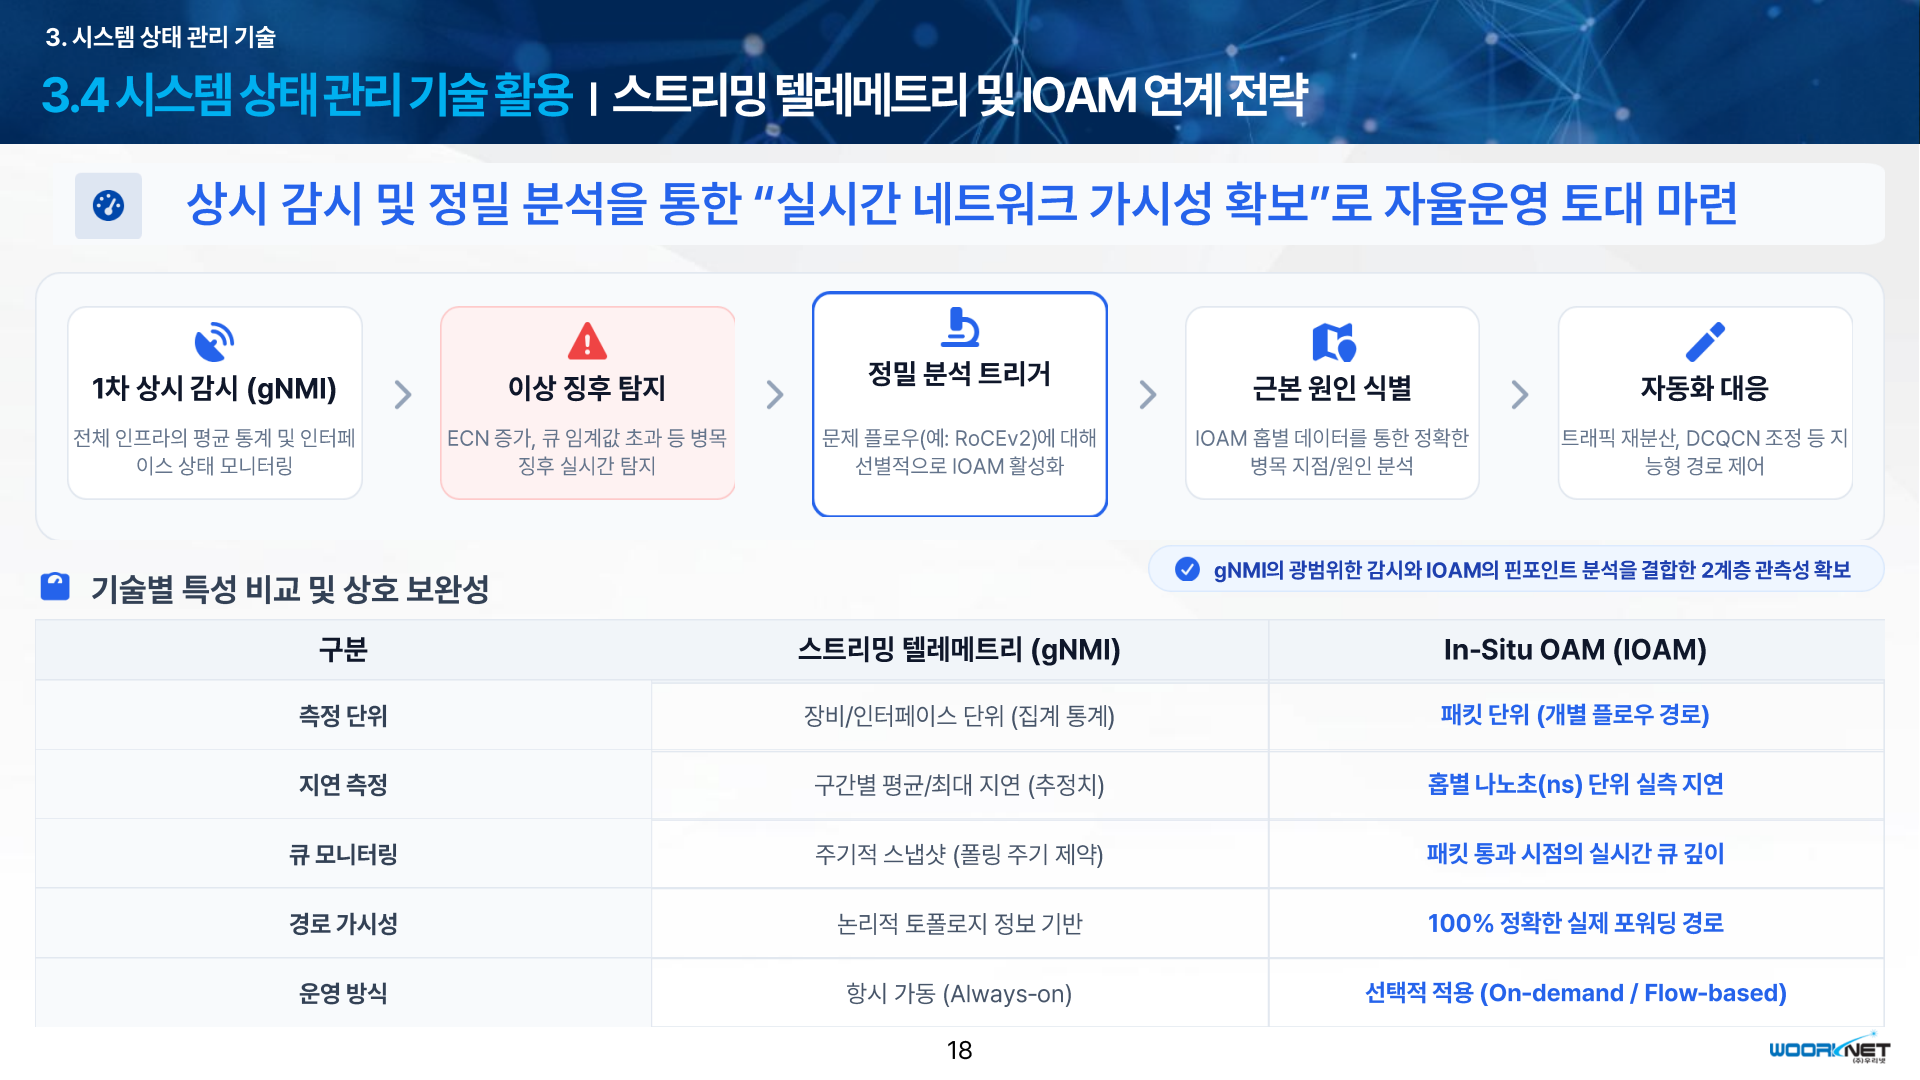
    2026年のOCP Korea Tech Dayで、WooriNetのSunghyuk Park氏は、データセンター間を結ぶScale-Acrossの技術を紹介しました。その中にあるのが、機器の状態を集めるgNMIと、パケットの通過情報を記録するIOAMを組み合わせる案です。広く異常を見つける観測と、対象を絞って詳しく調べる観測を、どう使い分けるのでしょうか。[1][4]

    簡単にまとめると?

    • gNMIによる機器・ポートの統計と、IOAMによる対象パケットの通過記録では、分かることが異なります。
    • 異常を見つけてから対象フローを詳しく調べる案ですが、過去に通過したパケットの記録を後から取り戻すことはできません。
    • 使える機器、取得間隔、時刻と単位、追加する情報の負荷を確かめて、観測する範囲を決めます。

    gNMIで、いつ・どの機器に変化があったかを見る

    gNMI(gRPC Network Management Interface)は、機器の設定や状態をやり取りするための仕組みです。WooriNetの案では、ポートの状態やキューの量などを継続して集め、ECNの増加やキューの閾値超過を異常の手がかりにします。キューは、転送を待つパケットの待ち行列。ECNは、ネットワークの混雑をパケットに付けた印で知らせる仕組みです。[1]

    ただし、gNMIを使えば何でも細かく測れるわけではありません。値が変わったときに送る方法や、指定した周期で送る方法などがあり、機器が対応する項目と間隔を選びます。周期を細かく設定しても、機器が対応できなければ、その要求は受け付けられません。[3]

    この段階で得たいのは、調査の範囲を絞る手がかりです。あるポートで混雑の印が増えたとしても、その集計値だけで「遅い通信がここを通った」とは確定できません。通信ごとの経路を知るには、別の情報が要ります。

    IOAMで、対象のパケットが通った場所を調べる

    IOAM(In Situ Operations, Administration, and Maintenance)は、実データのパケットに観測用の情報を加える技術です。対応する途中の機器が、ノードや入出力ポートの識別情報、時刻、キューの状態などを記録します。別に送ったPingなどの調査用パケットが、実際の通信と違う扱いを受ける場合を補う方法です。[2]

    見る対象が、機器全体の統計から、そのパケットが通過したときの状態へ変わります。全体の混雑と、調べたい通信が経験した混雑を結びつけるための情報です。もっとも、途中にIOAMへ対応しない機器があれば、そこから記録は得られません。記録のない部分を「問題なし」と読まないことが大切です。[2]

    常時監視から、必要な通信だけの詳細観測へ

    図1の上段は、gNMIによる常時監視から始まり、異常の兆候を受けて、問題のあるフローにIOAMを選択的に有効にする流れです。フローは、一連の通信を識別してまとめた単位です。WooriNetは、AI向け通信に使うRoCEv2のフローなどを例に挙げています。[1]

    gNMIで常時監視し、異常の兆候から対象フローのIOAMを有効にして各ホップを調べる、WooriNetの連携案。下段は二つの観測方法の比較。
    図1:WooriNetが示す常時監視と詳細観測の連携案。上段は左から、監視、異常の検知、IOAMの選択的な有効化、原因の調査、対応へ進みます。下段の「100%」「ns」などは発表資料の表現で、対応機器や測定条件を合わせて読む必要があります。出典:Sunghyuk Park/WooriNet「AI 데이터센터간 Scale-Across 전송 기술 동향」、p.18。原資料 / 図を拡大する

    この分担の利点は、詳細な記録を取る範囲を絞れることです。IOAMは追加の情報を運ぶので、パケットが長くなり、機器での処理も増えます。常時すべてを詳しく測るか、対象を限定するかは、観測したい現象と許容できる負荷で決めます。別の調査用パケットを送らないことと、観測の負荷がゼロであることは同じではありません。[2]

    図の下段にある「100%」や「ns」という表現にも条件があります。全経路が見えるかは途中の機器の対応範囲に左右され、時刻の細かさがそのまま測定の正確さになるわけではありません。異なる機器の時刻を引き算するなら、時計のずれも考慮する必要があります。[2]

    二つの経路の一方だけが遅いとしたら

    ここからは、仕組みを理解するための例です。拠点AとBの間に複数の経路があり、ある学習ジョブの通信だけが遅くなったとします。まずgNMIで集めた記録から、その時間帯にどのポートでECNやキューの量が増えたかを探します。これで、詳しく調べたい機器と時間帯を絞ります。

    次に、同じ通信で現象が続く、または繰り返すときに、対象フローへIOAMを適用します。パケットが実際に通ったノードと、その通過時のキューや時刻を突き合わせれば、疑っていた経路を通っていたか、途中のどこに待ちがあったかを調べやすくなります。集計値からの推測を、対象パケットの記録で確かめる順序です。

    この方法で、すでに終わった現象を必ず再現できるわけではありません。IOAMを有効にする前のパケットには、その記録がありません。短時間で消える異常を対象にするなら、普段から残す統計の細かさと、詳細観測を始める条件を先に設計しておく必要があります。これは、異常を見つけた後に観測を始める方式の限界です。

    導入前に合わせる四つの条件

    どちらの方式を使うかに加えて、取得した値を比較できるかを確認します。たとえば同じ「キューの量」でも、装置が使う単位や測る位置が違えば、大小をそのまま比べられません。IOAMの仕様も、キューや共通バッファーの情報を扱う際に、実装ごとの意味を考える前提です。[2]

    確認すること 判断のために見る点
    機器と観測範囲 どの機器・ポートが値を返し、IOAMの途中記録を残せるか。記録のない区間を明らかにする。
    時間と取得周期 現象の長さに対して取得周期は足りるか。機器間の時刻を比べるなら、同期状態と測定位置をそろえる。
    値の意味と単位 キューの量が何を数えた値か、共通バッファーの占有量と区別されているかを確認する。
    パケット長と処理負荷 情報を追加しても経路のMTUに収まるか。MTUは一度に運べるパケットの大きさの上限。対象フローと記録項目を絞れるかも見る。

    表は、WooriNetの連携案とIOAM・gNMIの仕様を基に、導入時の確認事項として整理したものです。通信相手までの全区間を自分たちで管理できない場合は、とくに観測の境界を明らかにしておく必要があります。IOAMは、管理する範囲を定めて運用する技術として設計されています。[2][3]

    原因を絞ることと、自動で直すことを分ける

    WooriNetの図は、観測の先に、通信の再分散や送信速度を調整するDCQCNの設定変更も置いています。ただし、この資料は、変更を選ぶ具体的な条件、変更後の確認方法、失敗時に戻す手順までを示した運用実証ではありません。末尾には、2026年から2030年にかけての伝送システムと運用体制の研究開発計画が示されています。[1]

    この発表から持ち帰れるのは、監視を細かくすれば自動的に通信が速くなるという話ではなく、調査の順序です。まず広い範囲で変化を捉え、次に対象の通信が通った場所を確かめる。自分たちが必要とする判断に対して、どこまでの記録があれば足りるかを決めることが、gNMIとIOAMを組み合わせる出発点になります。

    光通信機器を中心とするWooriNetの事業については、cyclewaveの企業解説で紹介しています。

    WooriNetの企業解説を読む

    参考資料

    2026年10月10日確認。発表資料にある技術の説明と研究開発計画を扱い、商用導入の効果や性能値を検証した記事ではありません。

    1. Sunghyuk Park/WooriNet「Trends in Scale-Across Transfer Technology Between AI Data Centers」 — 全22頁。pp.16–18:gNMI・IOAMと連携案、pp.20–21:研究開発計画。
    2. IETF「RFC 9197: Data Fields for In Situ Operations, Administration, and Maintenance (IOAM)」 — 1・3・4.4・5節:観測範囲、データ項目、負荷、時刻の形式。
    3. OpenConfig「gRPC Network Management Interface (gNMI)」 — 3.5節、とくに3.5.1.5.2:購読方式と取得周期。
    4. Open Compute Project「2026 OCP Korea Tech Day」 — 公式の講演・発表資料一覧。
  • Eriduが示す高radixスイッチ、接続数を増やしてGPU網の階層を減らす構想

    Eriduが示す高radixスイッチ、接続数を増やしてGPU網の階層を減らす構想

    GPUを増やすと、計算を分担する相手も増えます。その相手とデータを交換する道が複雑になれば、計算装置だけを速くしても待ち時間はなくなりません。AI向けネットワークでは、回線一本の速さに加え、一台のスイッチでいくつの接続先を受け持てるかが大切になります。

    2026年7月28日のOCP Educational Webinarでは、この接続数を表す「radix」を大きくする方法が取り上げられました。Eriduが示した640基のGPUの比較例をもとに、スイッチの接続数とネットワークの階層がどう結びつくのかを見ていきます。[1・2]

    簡単にまとめると?

    • 同じ800Gの接続でも、スイッチのradixが大きいほど、一台で受け持てる接続先を増やせます。
    • 640基のGPUをつなぐ講演の構成例では、64接続のスイッチを使う2層30台と、640接続を持つ単層1台が比較されています。
    • 階層を減らすには半導体だけでなく、入出力・バッファ・電源・冷却・ソフトウェアを合わせた設計が必要です。電力や費用の削減値は、講演で示された条件付きの主張として読みます。

    速さと接続数を分けて考える

    スイッチは、入ってきたデータを必要な接続先へ送り分ける装置です。ここでいうradixは、一定の速度で使える接続数を指します。たとえば「64 × 800G」なら、800Gbpsの接続を64本持つ構成です。接続一本の速さが同じでも、本数が変われば直接つなげる範囲が変わります。[1、12–14頁]

    ただし、すべての接続口をGPU向けに使えるとは限りません。複数のスイッチを組み合わせると、スイッチ同士を結ぶためにも接続口が必要になります。下位のリーフと上位のスパインという2層で組む場合、リーフの接続口をGPU側とスパイン側へ振り分けます。[1、12頁]

    640基のGPUを、2層30台と単層1台で比べる

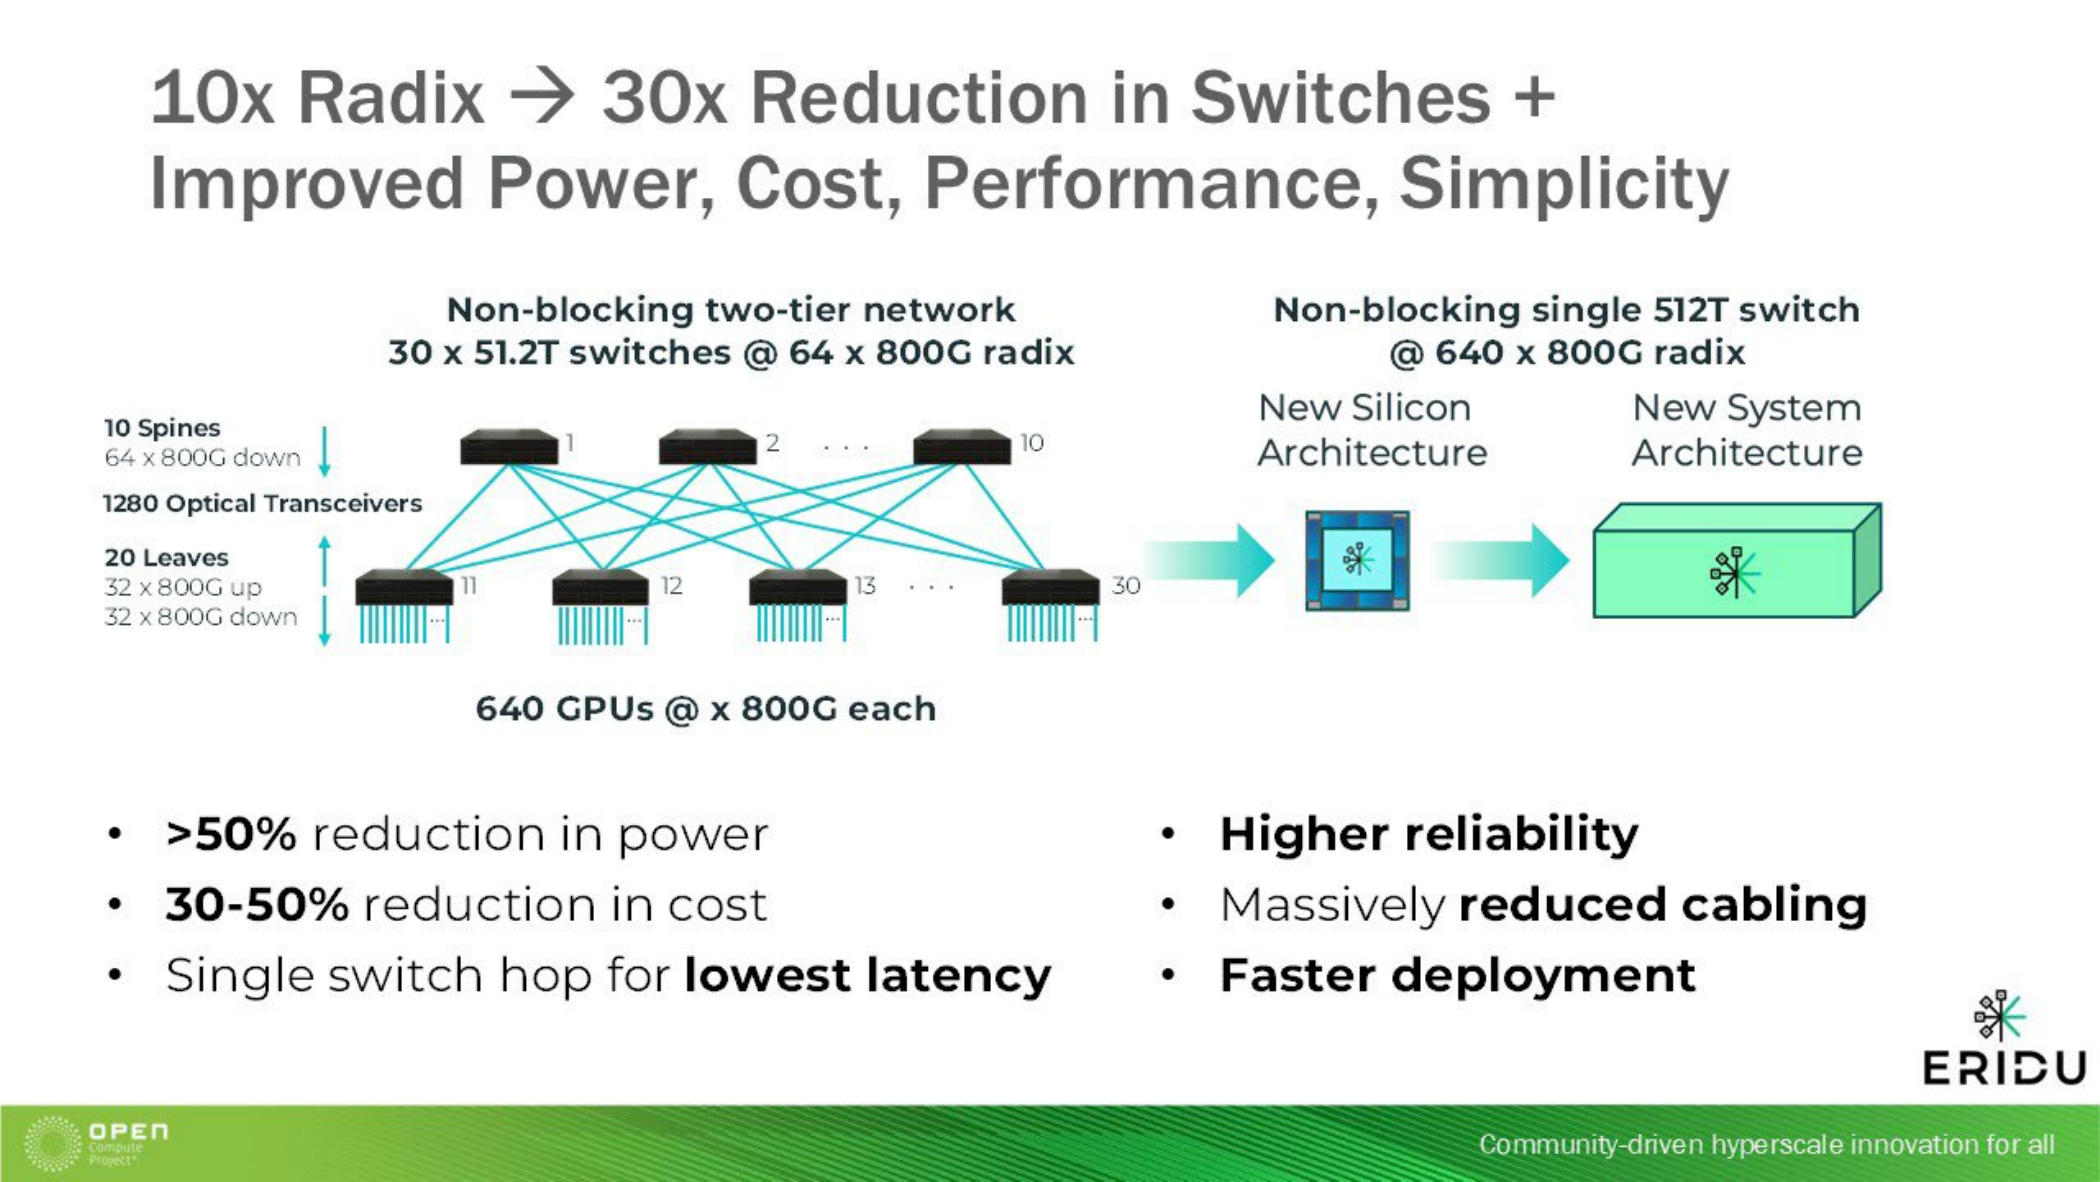
    講演の比較例は、各GPUに800Gの接続を一本ずつ用意した640基の構成です。2層側は、51.2Tbps・64 × 800Gのスイッチを使います。リーフ20台はそれぞれ32接続をGPUへ、残る32接続を上位へ向け、スパイン10台と組み合わせます。GPU側の帯域合計は640 × 800Gbps=512Tbpsです。[1、12頁]

    一方、図の右側は640 × 800Gを受け持つ512Tbpsの単一スイッチです。この構成なら、640基を収容するためのリーフとスパインの間の接続が不要になります。接続数は64から640へ10倍ですが、装置数は30台から1台へ変わります。上位へ集約するための装置も省けるため、接続数と装置数の倍率がそのまま一致しないのです。[1、13頁]

    Eriduの構成比較。左は640基のGPUを、51.2Tbps・64接続のスイッチ30台による2層で接続。右は512Tbps・640接続の単一スイッチ。両側の接続速度は800G。下部にはEriduが提示する電力・費用などの効果が並ぶ。
    図1 640基のGPUを接続する構成比較。Eridu(登壇者:Promode Nedungadi、Jay Gill)「Breaking Through the AI Network Wall with High-radix Switching」、OCP Educational Webinar Series、2026年7月28日、13頁を引用。下部の効果の数値は講演側の提示。 出典[1] · 図を全体表示

    図1の左側ではGPU間の経路が同じリーフ内に収まる場合と、スパインを経由する場合があります。右側では、この例のGPU間通信を一台のスイッチで中継します。講演が狙うのは、接続数を増やしてネットワークを浅くし、装置間の配線や通過箇所を減らすことです。ここで比べているのは、いずれも接続帯域を確保するノンブロッキング構成です。どんな通信でも混雑や待ち時間が消える、という意味ではありません。[1、12–13頁]

    大きなスイッチには、装置全体の設計が要る

    接続先を増やすには、入口だけを増やせばよいわけではありません。多数のデータを送り分ける処理と、転送を待つデータを蓄えるバッファ、それらを結ぶ入出力が必要です。Eriduは半導体側の課題として、バッファ構成、I/O密度、接続技術、電力、冷却を挙げています。[1、16頁]

    装置側にも、前面に多数の接続口を収める密度、内部の接続技術、システム全体の電源と冷却、ソフトウェアという課題があります。講演では、半導体・システム・ソフトウェアを一緒に設計する方針が示されています。高radix化は、チップの仕様表にある帯域の数字だけで完成するものではないのです。[1、16・28頁]

    構成の効果と、実測された結果を混ぜない

    図1には電力を50%超、費用を30–50%削減するという記載もあります。これはEriduがこの講演で掲げた効果です。この頁には測定環境や費用の明細が示されていないため、あらゆるクラスタで同じ削減率になる数値とは読めません。装置数の構成比較と、実際の消費電力・費用の評価は分ける必要があります。[1、13頁]

    別の頁では、5,120基のGPUを想定した学習のシミュレーションも紹介されています。大きなscale-up領域と、72基単位のscale-upにscale-outを組み合わせた構成を比べたもので、資料はパケット単位のシミュレーションと明記しています。実機を測って得た結果ではなく、前提を置いた検討です。[1、25頁]

    この講演の比較から考えられるのは、AIネットワークを見るときに「何Tbpsか」だけでなく、「その速度でいくつつながり、何層を通るのか」を確かめることです。radixを増やす価値は、その接続数を使ってネットワーク全体をどう組み直せるかにあります。

    Eriduの事業や資金調達については、企業解説で紹介しています。

    参考資料

    1. Cliff Grossner(OCP Foundation)、Alan Weckel(650 Group)、Promode Nedungadi・Jay Gill(Eridu)『Breaking Through the AI Network Wall with High-radix Switching』。OCP Educational Webinar Series、2026年7月28日。本文参照:12–16・25・28頁。
    2. Open Compute Project『OCP Educational Webinar: Breaking Through the AI Network Wall with High-radix Switching』。開催日・登壇者・公開スライド案内。
  • MetaのBAG、AIネットワークを建物間でつなぐ集約層の仕組み

    MetaのBAG、AIネットワークを建物間でつなぐ集約層の仕組み

    AIの学習に使うGPUを増やすと、計算機を置く場所だけでなく、GPU同士をどう結ぶかも変わります。一つの建物に収まっていた通信を、別の建物やデータセンターまで広げると、距離による遅延や故障時の経路変更が学習に響いてきます。

    MetaのJalpa Patel氏とAnkur Singh氏は、OCP APAC 2026の講演資料で、AI基盤を広域につなぐBAG(Backend Aggregation)を紹介しました。高速な回線を用意するだけでは足りず、ネットワークの制御と学習処理の両方を合わせる必要があることが見えてきます。[1]

    簡単にまとめると?

    • MetaのBAGは、複数のネットワークをEthernetでつなぐ集約層です。
    • 故障後の通信は、残った経路の帯域に応じて振り分けます。
    • 拠点間の遅延に合わせ、GPUの集団通信や学習側の調整も必要です。

    一つの建物から、複数の拠点へ

    資料では、Prometheusを1ギガワット級のクラスターとして説明し、通常のデータセンター棟に加え、屋外の耐候性テントや隣接するコロケーション施設も使う構成を示しています。この規模の説明はMetaの資料に基づくもので、ここから全設備の稼働状態まで分かるわけではありません。

    資料がNSFと呼ぶネットワーク構成では、一つのIslandに72ラック、5,184基のGPUをまとめます。その内側にあるバックエンドのPodはノンブロッキングとされる一方、Islandをまたぐ部分には3対1のオーバーサブスクリプションがあります。接続された全GPUが、あらゆる相手へ同時に最大速度で通信できる構成ではない点に注意が必要です。

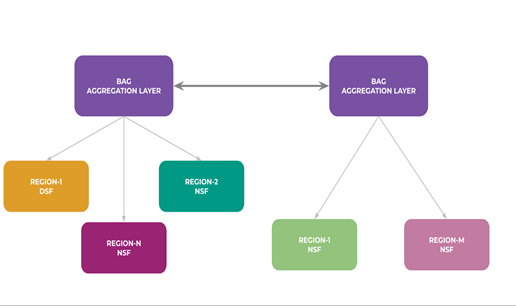
    BAGは、その上位で複数のネットワークをつなぐ、Ethernetベースの集約層です。役割を分けて見ると、どこまでの通信を扱っているか整理しやすくなります。

    図1の下段に並ぶ各Regionのネットワークは、上段のBAG集約層に接続されています。BAG同士を結ぶ線まで一緒に見ると、個々のネットワークを集約層を介して結ぶ構成だと分かります。図が表すのは接続関係であり、すべての組み合わせで同じ帯域が得られることを示すものではありません。

    上段の二つのBAG集約層が相互につながり、下段の各RegionのDSFまたはNSFネットワークがそれぞれのBAGへ接続する構成図。
    図1 BAGが複数のネットワークを結ぶ構成(原図引用)
    Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」、OCP APAC 2026、p.5。出典の講演資料。スライド内の図部分を掲載。
    図は横にスクロールできます。図の画像を開く
    表1 講演資料に基づく通信範囲の整理。資料[1]pp.4–5をもとにQuantum Sea作成。
    範囲 資料で示される特徴
    バックエンドのPod内 ノンブロッキングの接続
    Island間 3対1のオーバーサブスクリプション
    BAGによる集約 複数のデータセンターや地域のネットワークを接続

    距離が延びると、止めた後にもデータが届く

    混雑した受信側から送信を一時停止するよう伝えても、その通知が届くまでには時間がかかります。その間に届くデータを受け止める余裕が必要です。優先度ごとに送信を抑えるPFC(Priority Flow Control)を使う場合、ケーブルが長いほど、この余裕として確保するバッファー量も大きくなります。

    Metaは、FBOSSを使って信号の往復時間からケーブル長を推定し、最長距離を一律に仮定する代わりに、実際の長さに沿って余裕を割り当てる方法を示しました。距離の違いを測ることが、限られたメモリーの使い方にも関わります。

    資料はさらに、複数のキューからDRAMへ同時にデータを移すと競合が起き、SRAM側の余裕がなくなり、PFCの影響が全ポートへ広がる危険も挙げています。容量が大きいメモリーを備えるだけで解決する問題ではなく、そこへデータを出し入れする過程も設計の対象です。[1]

    故障後は、残った帯域に合わせて分ける

    通信経路の一部が故障すると、経路ごとに残っている帯域が違ってきます。それでも均等にデータを流すと、細くなった経路に混雑が集まります。

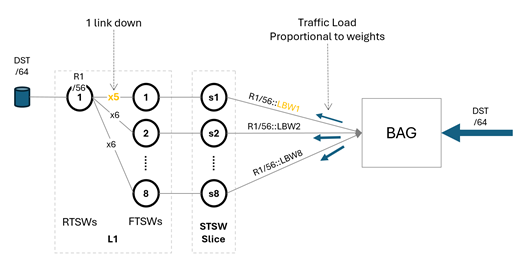
    BAGでは、BGPで経路の帯域情報を伝え、UCMPという、経路の能力に応じて割合を変える分散方法を使います。一方で、小さな帯域変化のたびにネットワーク全体の経路情報が揺れ続けないよう、更新を抑える仕組みも組み合わせています。故障に追従する速さと、制御を安定させることの両立が課題になります。

    図2では、左側のリンク束の一つに「1 link down」とあり、経路ごとの帯域情報がLBWとして右側のBAGへ伝わる様子が描かれています。BAGへ入った通信は、青い矢印のように各経路の重みに応じて振り分けられます。故障で減った帯域を分配に反映する点が、この図の要点です。

    左側のリンク束の一つに1 link downと×5の表示があり、経路の帯域情報LBWが右側のBAGへ伝わる。BAGへの入力通信は青い矢印で各経路の重みに応じて振り分けられる。
    図2 リンク故障後の帯域を反映するUCMP(原図引用)
    Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」、OCP APAC 2026、p.7。出典の講演資料。スライド内の図部分を掲載。
    図は横にスクロールできます。図の画像を開く

    回線の先にある学習処理まで合わせる

    通信が届けば学習の効率も保たれる、とは限りません。資料では、一つのBAGを経由するL2ネットワーク間の遅延を、L2内のおよそ3倍としています。これは資料内の構成の比較であり、別の設備にもそのまま当てはまる値ではありません。

    GPU間の集団通信に使うNCCLについても、プロトコルの選択がネットワーク遅延を考慮していないことを課題に挙げています。遠い相手との通信に合わせた調整に加え、BAG層を通る通信のうち、計算で隠せず待ち時間として現れる部分を小さくすることが求められます。

    今後の課題として示されるのは、異なる構成のクラスターへの対応や、数十・数百・数千キロメートル離れた地域間での学習です。これらは講演時点の取り組みの方向で、すべてが実現済みという意味ではありません。Metaの事例が示すのは、AI基盤を広げる際には、回線、バッファー、経路制御、学習ソフトウェアを一続きで考える必要があるということです。

    Metaを企業全体から見る

    Metaのサービス事業やAI基盤への投資を含む企業全体の説明は、cyclewaveの記事にまとめています。

    参考資料

    1. Jalpa Patel / Ankur Singh(Meta)「Scaling AI Infrastructure using BAG」。OCPの掲載題名は「Scaling AI Infrastructure Across DC and Beyond: Meta’s Journey with NSF and BAG」。OCP APAC 2026、pp.3–13。講演資料
    2. Open Compute Project「2026 OCP APAC Summit」公式資料一覧。公式カタログ