複数の利用者でGPUクラスターを共有するとき、応答を急ぐ処理と、大量のデータを送り続ける処理が同じネットワークを使うことがあります。ジョブの優先順位を高くしても、その先にある通信装置で順番を待つなら、応答の遅さは残ります。計算資源を割り当てる順番と、データを送る機会は、別々に考える必要があります。
AcrylはGPU管理ソフトウェアGPUBaseについて、ジョブの実行管理、ネットワーク内の制御、ホスト側の通信装置という三つの層で優先度を扱うと説明しています。そのうちホスト側で挙げるのがPeRF(Preemption-enabled RDMA Framework)です。講演資料と、同社などの研究者による2024年の原論文から、通信の待ち時間に介入する仕組みと条件を確かめます。[1][2]
簡単にまとめると?
- ジョブの優先順位を決めるだけでは、すでに通信装置へ渡した転送の順番までは変わりません。
- PeRFは大きな転送を小分けにし、通信キューを停止・再開することで、別の処理へ送信機会を渡します。
- 短い通信の遅延、長い転送の速度、CPU負荷を一緒に比較します。対応する通信機器・ドライバーや、ネットワーク内の混雑は別途確認が必要です。
GPUの割り当ての先にも、通信の順番がある
RDMAは、相手側のメモリーへデータを直接読み書きするための通信方式です。アプリケーションが通信要求をキューへ渡すと、RDMA対応のネットワーク装置であるRNICが転送を進めます。この送受信キューの組をQP(Queue Pair)、キューに入れる処理要求をWR(Work Request)と呼びます。[2]
問題は、利用者ごとに使うQPの数や、送るデータの大きさが違うことです。論文で調べたRNICは、QPを順に巡って処理します。同じ利用者が多数のQPを使えば送信機会を多く得やすく、大きなデータを送る処理と短い通信をする処理が混在すると、短い通信にも待ち時間が生じます。GPUの使用割合だけでは見えない、共有通信装置での干渉です。[2]
たとえば論文の基本実験は、1MBのメッセージを連続送信する処理と、16Bの短いメッセージを送る処理を組み合わせています。これは通信の干渉を調べる人工的な負荷であり、16BがLLMの応答全体を表すわけではありません。比較したいのは、同居する長い転送を止めずに、短い通信の完了をどこまで早められるかです。[2]
長い転送の途中に、別の通信が進める区切りを作る
PeRFの一つ目の操作は、大きな通信要求を複数の小さな要求へ分け、その間に0_WAITという制御要求を挟むことです。論文の標準設定では分割単位を16KBとしています。RNICが0_WAITへ到達すると、その制御要求は直ちに完了し、現在のQPから別のQPの処理へ移ります。名前にWAITとありますが、一定時間眠らせる仕組みではありません。[2]
図1の下段では、大きな要求がSub-WRに分けられ、間に入る0_WAITから、右側の短い通信へ送信機会が渡ります。長い転送を最後まで一続きに扱う代わりに、他の通信が進める区切りを作る、という考え方です。すでに回線へ出たパケットを取り戻したり、学習ジョブを最初からやり直したりする操作ではありません。
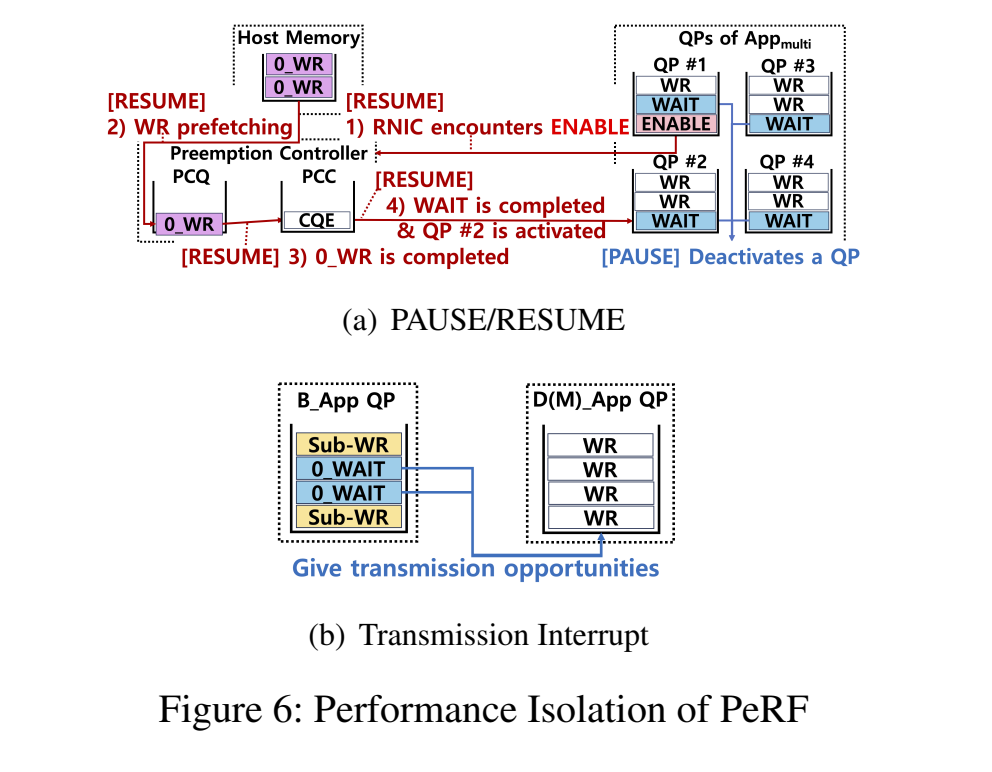
二つ目は、QPを多く使う利用者に対して、同時に動くQPの数を調整する操作です。図1の上段にあるWAITとENABLEを組み合わせ、一部のQPを停止させ、停止中のQPを順番に再開します。QPを増やした利用者が、その数だけ通信装置を占有しやすくなる状況を抑えます。単に全利用者の送信を強く絞るのではなく、装置が処理できる量も見ながら動くQP数を調整する設計です。[2]
細かく切り替えるほどよい、とは限らない
分割単位を小さくすれば、他の通信へ機会を渡しやすくなります。一方で、扱う要求が増えるためCPU側の処理負担が増し、転送速度を落とす場合があります。逆に分割単位を大きくしすぎると、切り替えの間隔が長くなり、短い通信の遅延や処理速度が変動しやすくなります。論文の付録は、この調整を性能とCPU効率のトレードオフとして説明しています。16KBをすべての環境に適した推奨値と読むことはできません。[2]
導入前の比較では、同じ機器、同じQP数、同じ通信サイズで、単独実行、混在実行、制御を有効にした混在実行を並べると、この違いを確かめやすくなります。短い通信は平均だけでなく、遅い側の応答も見ます。同時に、大容量転送が一定時間に運べた量とCPU使用量を測れば、待ち時間の改善にどの程度の負担を払ったかを判断できます。これは論文の分離した負荷実験と調整項目を、自分の環境の比較へ置き換える考え方です。[2]
アプリの改修不要でも、導入条件は残る
PeRFの論文実装は、ユーザー空間のRDMAドライバーlibmlx5へ変更を加えています。著者が公開する実装の検証環境は、Ubuntu 20.04、NVIDIA Mellanox ConnectX-4/5/6、MLNX_OFED 4.9系です。アプリケーションのコードを変更しない設計と、現在の装置やドライバーでそのまま使えることは区別する必要があります。[2][3]
また、PeRFが調整するのはホスト側のRNIC資源です。スイッチを含むネットワーク内で混雑が起これば、その待ち時間まで消えるわけではありません。論文は既存の輻輳制御と組み合わせる位置づけを示し、混雑下では遅延が増えることも報告しています。[2]
通信機能の対応範囲にも注意が要ります。2024年の論文では、使用するWAITとENABLEがUDというデータグラム方式では使えず、対応を今後の課題に挙げています。これは当時の研究実装の制約です。現在のGPUBaseがどの構成まで対応するかは、製品側の確認と、自分たちの通信方式での検証が必要になります。[2]
GPUBaseの講演資料は大きな性能改善値を掲げていますが、今回確認した資料だけでは、自分の学習・推論処理で同じ効果が得られるとは判断できません。PeRFの論文は通信制御の仕組みと試験条件を確かめる材料であり、GPUBaseを導入したLLMサービス全体の応答時間を保証する試験ではありません。[1][2]
GPUを追加する前に、待っているのが計算の開始なのか、ホストからの送信なのか、ネットワーク内の転送なのかを分ける。そのうえで、短い通信を早めながら、大きな転送も必要な速度で進められるかを比べる。PeRFは、GPU共有の評価に「同居する通信同士の待ち方」を加えるための、具体的な手がかりになります。
検証環境に登場するNVIDIAの事業や製品領域については、CyclewaveのNVIDIA企業ガイドで紹介しています。
参考文献
- Ikjun Yeom / ACRYL Inc.「Beyond GPU Management: Optimizing GPU Cluster Networks with GPUBase」、OCP Korea Tech Day 2026。公開講演資料(PDF全22頁)、特にPDF 6、7、11、19–20頁。公式講演一覧。
- Sugi Lee、Mingyu Choi、Ikjun Yeom、Younghoon Kim「PeRF: Preemption-enabled RDMA Framework」、2024 USENIX Annual Technical Conference。原論文PDF、特に§2–5、Figure 6、Appendix A・D。著者・書誌情報。
- PeRF著者公開実装、acryl-aaai/perf README、Tested Environment、Configuration。2026年10月12日確認。