GPUクラスターの通信が遅いとき、回線を増やす前に切り分けたいことがあります。宛先が受け取り切れないのか、それとも空いている経路があるのに、一部の経路へ通信が偏っているのか。この二つでは、必要な対策が変わります。
CiscoのOCP Korea 2026講演は、通信を複数の経路へ分散し、出口で順序を戻す「Schedule Fabric」を図示しています。本稿では、その背景にあるScheduled Ethernetの公式解説を合わせて読み、どの通信を、どこで待たせる設計なのかを確かめます。[1][2]
簡単にまとめると?
- 経路が空いていても、宛先の出口が満杯なら送信量の調整が必要です。入口の待ち行列を宛先別に分けると、待つべき通信を区別できます。
- Scheduled Ethernetは、入口での送信許可、複数経路への分散、出口での順序復元を組み合わせます。
- 物理的な出口容量やバッファの上限は残ります。導入時は、混雑していない宛先への通信が巻き添えになるかを比較することが有用です。
経路の偏りと、宛先の容量不足を分ける
通常のECMPは、同じ通信フローのパケットを同じ経路へ振り分けることで、順序を保ちやすくします。ただし、別々の大きなフローが同じ経路を選ぶと、他の経路に余裕があっても局所的な混雑が生じます。Ciscoの講演資料17ページは、この偏りを青と黄色の通信で表しています。[1][2]
この場合、経路を均等に使えれば改善の余地があります。一方、複数の送信元が同じ一つの出力ポートへ、そのポートの容量を超えて送り続ける場合は別です。途中を何本に分けても、最後の出口を通れる量は増えません。両者を同じ「ネットワークが遅い」という観測だけで扱うと、増設する場所や試験条件を誤りかねません。
出口別の待ち行列に、送信許可を出す
公式解説でScheduled Ethernetを構成する要素の一つが、入口スイッチのVOQ(Virtual Output Queue、仮想出力キュー)です。宛先の出力ポートと通信の優先度区分ごとに、パケットの待ち行列を分けます。キューにデータが入ると送信を要求し、スケジューラーが帯域と優先度の方針に基づいて許可を返します。混雑している出口へ向かうパケットは、許可が出るまで入口に残ります。[2]
仕組みを考えるため、二つの送信元A・Bが出口Xへ集中し、別の送信元Cは出口Yへ送る例を置きます。Xが処理し切れない通信まで途中の共用リンクへ流すと、同じリンクを通るCの通信も影響を受けます。X向けを入口で待たせ、受け入れ余地があるY向けには送信機会を与えれば、この巻き添えを抑える方向に制御できます。これは説明用の例であり、特定装置で測定した結果ではありません。
着目するのは、X向けの待ち時間を消すことではなく、Xの混雑を理由にY向けまで待たせる範囲を小さくすることです。同じ入口に到着しても行き先別にキューが分かれている意味が、ここにあります。
経路を分けた後は、出口で順序を戻す
送信を許可されたパケットは、フロー単位の経路固定に頼らず、利用可能な複数の経路へ分散します。経路ごとの遅延が異なるため、出口側では同じフローのパケットを並べ直します。講演資料18ページの原図では、青と黄色の通信が双方の中継スイッチを通り、右側で合流する構成になっています。[1][2]
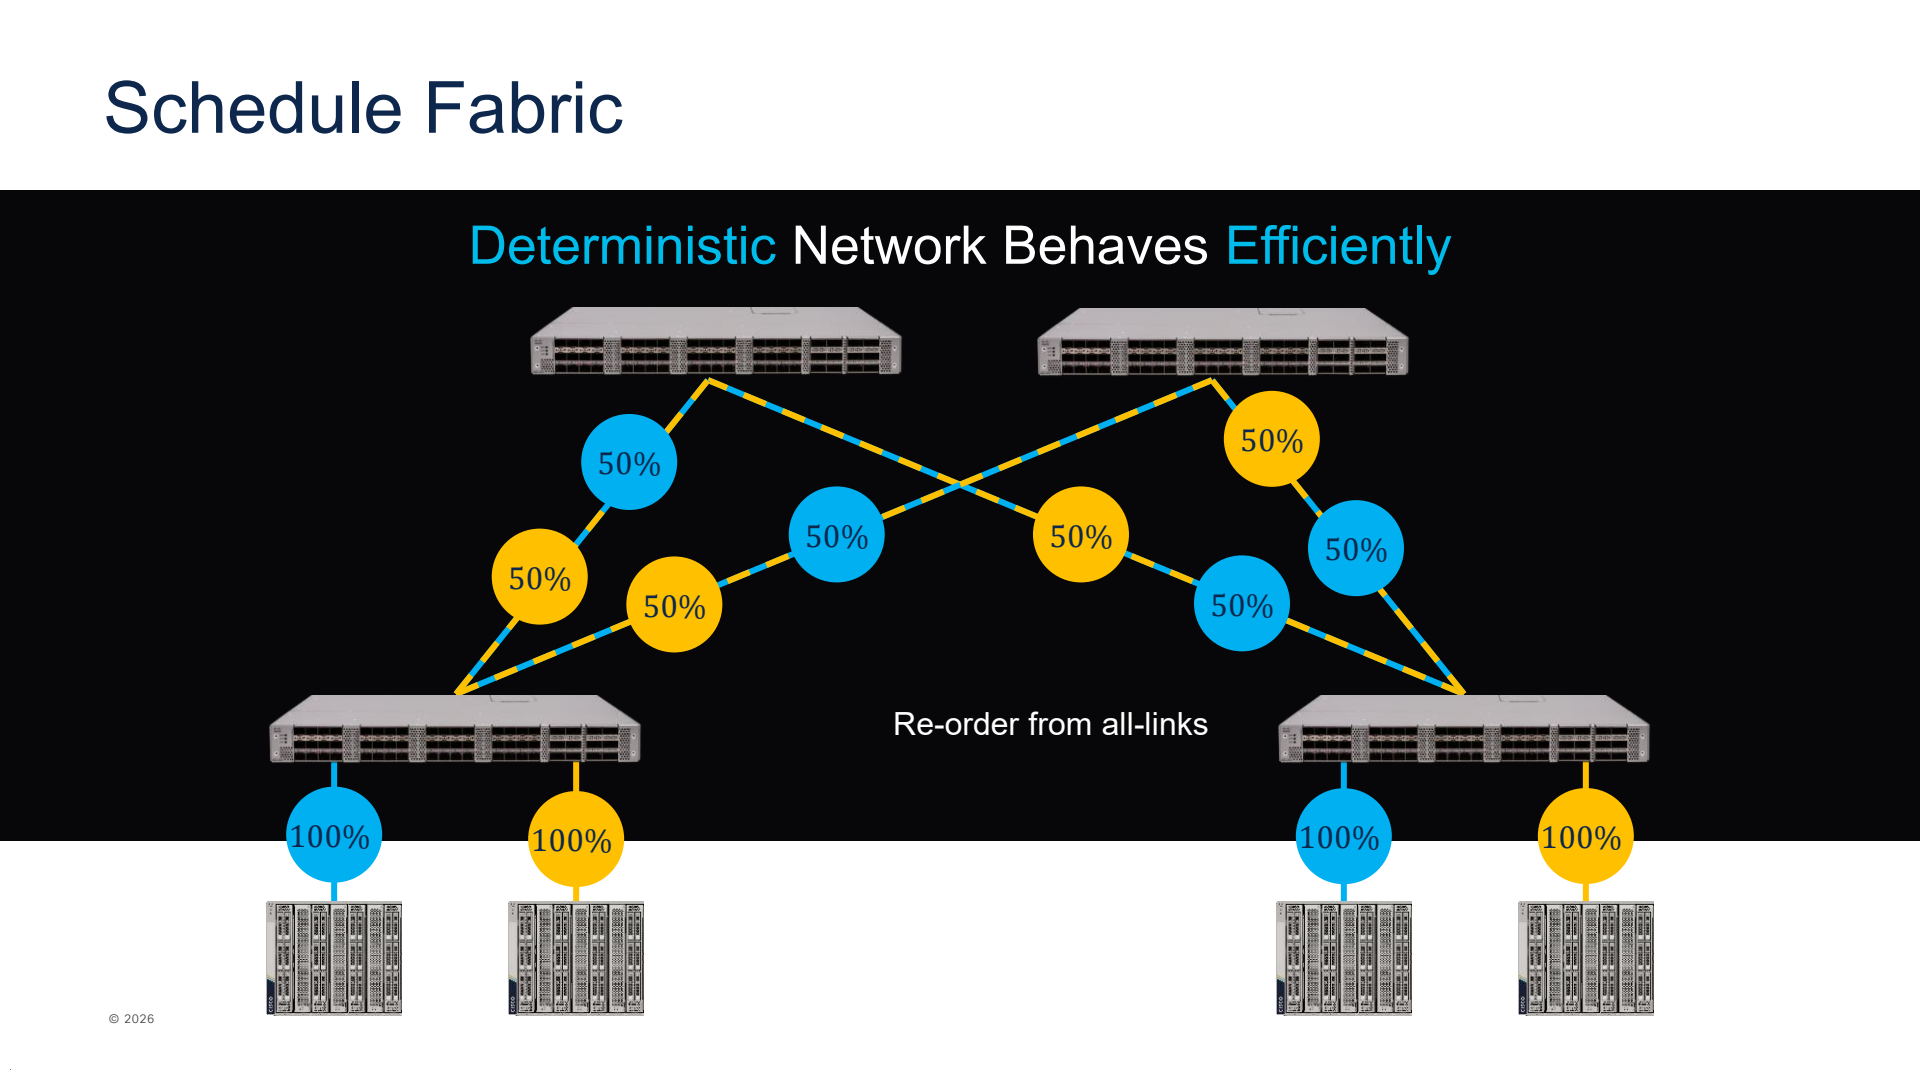
この図だけでは、入口にある待ち行列や送信許可のやり取りは見えません。経路分散と順序復元の図に、前節のVOQと送信許可を合わせることで、空いた経路を使う制御と、混雑した出口へ送り過ぎない制御を区別できます。
導入判断では、混雑の「巻き添え」を測る
評価するなら、まず同じ装置間構成と通信量で、出口ごとの負荷に余裕がある条件を比べます。ここで通信完了が遅れるなら、経路の偏りが候補になります。次に一つの出口へ通信を集中させ、別の出口への小さな通信も同時に流します。後者の完了時間がどれだけ延びるかを見ると、合計スループットだけでは隠れる干渉を確かめられます。これは本稿からの試験設計上の提案です。
入口のキューに待ちが移る以上、待機量、あふれによる損失、送信元への制御も合わせて見る必要があります。出口の需要が容量を超え続ける状況を、スケジューリングだけで解消することはできません。Ciscoの解説も、入口から中継側へ出る合計帯域の条件を置き、パケット損失が生じ得る場所として入口を挙げています。[2]
さらに、VOQ・送信許可・順序復元が対象機器と構成で一体として動作することが前提です。2024年更新の公式解説では、そこで扱うScheduled Ethernetの構成に、単一クラスター内のベンダー間相互接続の制約が示されています。現在の候補機器で同じ制約があるかは、対応モードや接続条件として確かめる必要があります。一般のEthernetスイッチへ、同じ制御をそのまま追加できるとは限りません。[2]
Scheduled Fabricを選ぶ際の問いは、「速い方式か」だけでは足りません。経路の偏りを減らしたいのか、混雑した宛先の影響を他へ広げたくないのか。その課題と、入口で待つ量・出口の容量・機器構成の条件が合っているかで判断することができます。
参考文献
- Chih-Tsung Huang(Cisco)「Mixture of AI Factories: Open, Scalable, Efficient」、OCP Korea 2026、全21ページ。本文では主にpp.17–18を参照。イベント公式資料一覧。
- Cisco「Evolve your AI/ML Network with Cisco Silicon One」、2024年5月8日更新。「Scheduled Ethernet」「Comparing interface options」ほか。講演図の機構を補う公式解説として参照し、モデル比較の速度倍率は本稿の性能予測に用いていません。